
允中、凹非寺より
量子位 | 公式アカウントQbitAI
Agentに週報を書かせたり、提案を分析させたりすることは、すでに多くの人の日常になっています。しかし毎回始める際、ユーザーは資料を探して背景を説明しなければならず、エージェントも検索、読解、整理など複数のステップを経てからでなければ、実際にタスクを開始できません。タスクが変われば、この一連の流れをまた最初からやり直すことになります。すでにある資料を繰り返し処理することは、時間の浪費になるうえ、tokenの消費も増やします。資料が多いほど、ステップが長いほど、情報の見落としやズレが生じやすくなり、タスク完成の正確性に影響します。
これらの問題を解決するために、WorkSwarmが初めて個人知識スペースをネイティブでサポート。
「個人知識スペース」は、ユーザーが設定した複数の資料ソースに基づいてコンテンツを自動収集し、ルール処理、ルールと大規模モデルの混合処理、またはエージェント処理を通じて、資料を目録があり、関連性があり、出典がある個人知識に整理し、プログレッシブ・ディスクロージャーの形でエージェントに提供して利用させます。
WorkSwarmは個人の資料を長期的に再利用可能な個人知識へと整理し、「一度収集すれば、繰り返し使える」ことを実現することで、エージェントが関連情報を見つけて活用しやすくし、タスク完成の正確性を高めると同時に、タスクの準備時間を短縮し、tokenの消費を削減します。
openJiuwen個人知識スペース:パーソナライズされた多ソースの知識を自動収集し、オフィス・エージェントが必要に応じて使用
個人知識スペースは、ソース、収集、処理、使用の4層を中心に、ユーザーが日常的に蓄積した個人資料を、持続的に再利用可能なタスクの背景知識へと変換します。
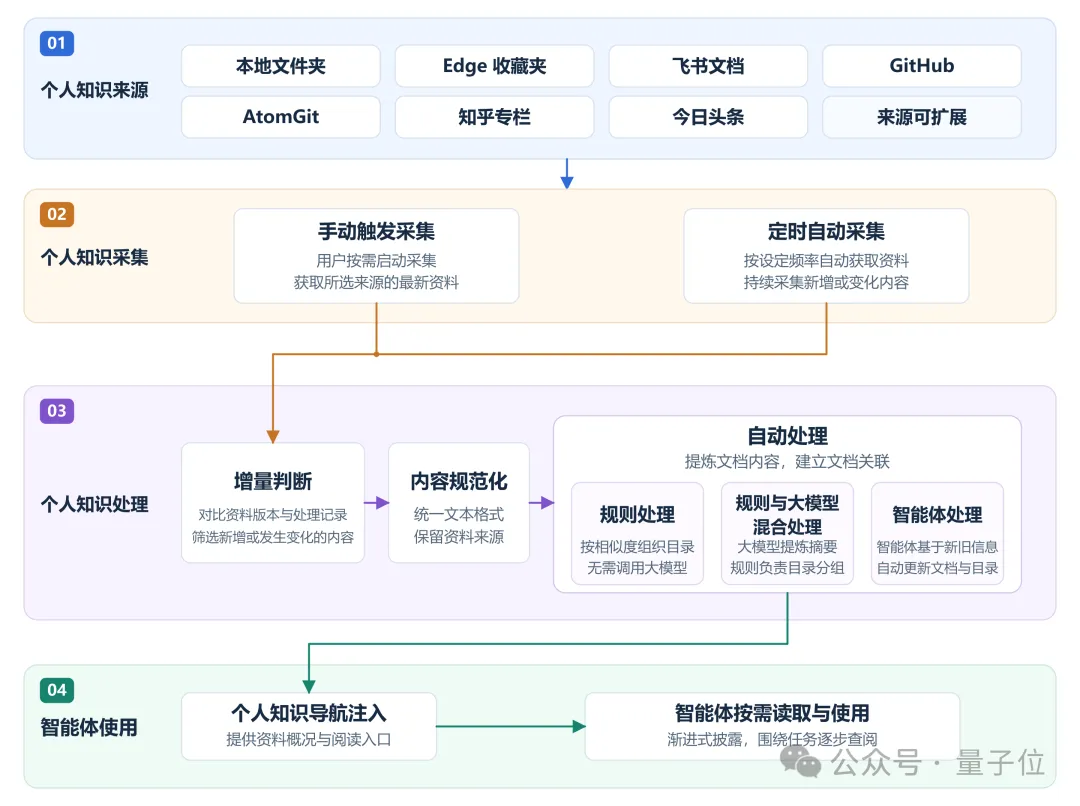 △個人知識スペースの4層フロー。多ソースの資料設定、手動・定時収集、3種類の処理方式、およびエージェントによる必要に応じた使用を表示
ユーザーはまず個人の知識ソースと収集範囲を選択すると、システムが必要に応じてまたは定時にコンテンツを取得します。収集された資料はフォーマットの統一と増分判定を経て、今回処理すべき新規コンテンツと変更点を識別し、その後、設定に応じてルール、ルールと大規模モデルの混合、またはエージェント方式を選択して、トピック目録とMarkdownページに整理し、ドキュメント間の関連と出典を維持します。目録構造と出典引用のチェックが通過した後、整理結果はユーザーが閲覧できます。
ユーザーがタスクでの使用を有効にすると、システムは個人知識の概要と読み取り入口をエージェントに提供し、エージェントが現在の問題に沿って関連ページを順次読み取ることで、既存の知識がタスク完成の背景となります。
個人知識スペースの設定と収集:個人の知識ソースを自由に選択でき、手動/定時の増分収集に対応
「設定」の「知識」ページで個人知識スペースを有効にすると、ユーザーはローカルフォルダ、Edgeのお気に入り、知乎コラム、今日頭条、飛書ドキュメント、GitHub、AtomGitなどのソースを追加できます。各ソースはそれぞれ個別に設定でき、どの個人資料を個人知識スペースに入れるかはユーザーが自主的に決定します。
設定完了後、ユーザーは手動で収集を開始して個人知識スペースを能動的に更新することもできれば、定時自動収集を設定して、設定した頻度でコンテンツを継続的に取得することもできます。システムはソース識別子、バージョン、収集進捗を組み合わせて新規または変更された資料を識別し、既存の個人知識と組み合わせて、新規または変更された資料を処理します。
ソース管理ページでは収集の進捗と直近の状態が表示され、ユーザーは更新頻度を調整したり、今回の結果を確認したり、進行中の収集を停止することもできます。
「設定」の「知識」ページで個人知識スペースを有効にし、次に「知識」ページの「ソース管理」に入ります。動画では今日頭条を例に、作者のホームページリンクを追加し、手動で収集を開始し、ソースの実行状態を確認します。
個人ナレッジ処理:3つの整理方式を提供し、分散した資料を再利用可能なナレッジに変える
ウェブページ、ドキュメント、コードはそれぞれ構造が異なり、同一テーマの内容が複数のソースに分散していることもあります。個人ナレッジ空間はまず資料の形式を統一し、次に内容を精錬して、テーマごとに目录やページへと整理します。これにより、エージェントがまず概要を把握し、その後関連内容を段階的に読み込めるようになり、同時に元のドキュメントへのリンクと出所も保持されます。
新しい資料を採集した後、システムは既存の個人ナレッジと組み合わせて補足・更新を行い、ナレッジが同一のプレーンテキストファイル群の中で持続的に蓄積されていきます。
ユーザーは「設定」の「ナレッジ」ページで、資料の特徴や整理のニーズに応じて、以下の3つの処理方式から選択できます:
- ルール処理:BM25の項目重みと内容の類似度を利用して、関連ページをテーマごとに分類し、目录とページ間のリンクを管理します。生成モデルの呼び出しは不要です。
- ルールと大規模モデルのハイブリッド処理:まず大規模モデルが新しい資料のタイトル、要約、キーワードを抽出し、次にルールがテーマのグループ化と目录の構成を行い、最後に大規模モデルが目录のタイトルと紹介文を生成して、理解や参照を容易にします。
- エージェント処理:エージェントが新しい資料と既存の個人ナレッジの関係を分析し、既存のテーマページの更新または統合を優先し、必要に応じて新しいドキュメントを追加するとともに、目录の説明とドキュメント間の相互参照も併せて管理します。
後者の2つの方式を採用する場合、ユーザーは資料の整理に使用するモデルを設定できます。整理が完了すると、システムは目录構造と出所の引用をチェックし、チェックを通過した内容はユーザーの閲覧やエージェントの利用に供されます。
ユーザーはまた、ファイルツリー、グラフ、または検索を通じて関連内容を探し、ドキュメントを開いて本文を読み、「出所」の注記から元の資料をたどることができます。
採集が完了すると、「jev」関連の内容がすでに採集されています。ユーザーは「ナレッジ」ページでjevを検索し、右側で整理された本文を読むことができ、グラフから関連ノードとその関連性を確認することもできます。
必要に応じた利用:プログレッシブディスクロージャーにより、エージェントが既存のナレッジを持って作業を開始できるようにする
資料が個人ナレッジに整理された後、ユーザーはタスク入力エリアの「+」メニューを通じて、エージェントを個人ナレッジ空間に接続できます。ユーザーの入力を受け取ると、エージェントはまず個人ナレッジ空間の資料概要と閲覧入口を取得して既存ナレッジの範囲を把握し、次に現在のタスクに応じて目录やドキュメントのリンクをたどりながら段階的に参照し、必要な背景情報を補充します。
このプログレッシブディスクロージャーの方式は、仕事を引き継ぐ際にまず目录やプロジェクトの紹介を見てから関連ドキュメントをめくるのと似ており、毎回のタスクで必要に応じて既存のナレッジを読み込めるようにします。
収集とタスクでの使用は、それぞれ個別に制御できます。ユーザーはシステムに資料の収集と整理を継続させ、必要なときにエージェントでの使用をオンにすることができます。タスクでの使用をオフにした後も資料の収集は継続し、ユーザーは既存のドキュメントを直接閲覧・検索することもできます。
どの資料を個人ナレッジスペースに入れるか、そしてエージェントがいつそれを使用できるかは、ユーザーが決定します。タスクを開始する際は、今回解決すべき問題に集中するだけでよく、既に蓄積されたナレッジが、エージェントがタスクを理解し完了するための背景となります。
個人ナレッジスペースをオンにした後、「jevについて紹介して」と入力して送信します。WorkSwarmはその後、個人ナレッジスペース内のJevドキュメントを参照し、コアメカニズムや導入事例などの内容を含む紹介を生成します。
効果の比較:タスクの合格率を向上させ、タスクの所要時間とtoken消費を削減
個人ナレッジスペースを有効化すると、エージェントはまず既存資料の範囲を把握し、その後関連ドキュメントを特定して読み込むため、タスク中に元資料を繰り返し検索・整理する作業が減ります。
チームはまず2件の対比テストを通じて、この変化がタスクの完了効果、所要時間、token消費に与える影響を観察しました。
対比から分かるように、個人ナレッジスペースがあれば、WorkSwarmは顧客ファイル、プロジェクト資料、作業計画を組み合わせて、具体的なプロジェクトのまとめと次のステップの計画を整理できます。関連する個人ナレッジがない場合は、エージェントが何度も検索してもプロジェクトの背景を得られず、汎用的な会議準備のフレームワークを提示するしかなく、ユーザーに資料の補充を求めることになります。
対比から分かるように、個人ナレッジスペースをオンにすると、WorkSwarmはユーザーのブラウザのお気に入りや知乎(Zhihu)コラムなどのソースから蓄積したナレッジを活用し、より速くタスクを完了できます。
さらに、openJiuwenチームは25問のテストセットを独自に構築しました。ローカルの論文、ブラウザのお気に入り、飛書(Feishu)ドキュメント、GitHub、AtomGit、知乎、頭条(Toutiao)の7種類のソースの資料に基づき、単一ソース検索、横断的な統合、問題変更時の再利用、欠落した事実、無関係なタスクなどのシナリオをカバーし、各問題に事前に検収ポイントを設定しました。テスト結果では、個人ナレッジスペースを有効化した後:
- タスクの合格率が32%向上しました。個人ナレッジスペースにより、エージェントが必要な資料をより容易に特定し、異なるソースの個別化された情報を組み合わせて回答できるため、資料が見つからない、あるいは情報を見落としてタスクを完了できない状況が減ります。
- タスクの総所要時間が76.2%減少しました。資料が事前に収集・整理されているため、タスク中は関連ドキュメントを直接参照でき、その場での元資料の検索・読解・整理の手順が減ります。
- タスク段階のtoken総消費が84.1%減少しました。整理済みのナレッジは異なるタスクで再利用でき、エージェントはタスクに応じて関連コンテンツを必要に応じて読み込むため、元資料の重複した整理や無関係なコンテンツの入力によるtoken消費が減ります。
今回の実験ではエージェントによる処理方式を採用しました。前処理段階でもtokenが消費されますが、このコストは、資料整理に適した低価格のモデルを選択することで制御でき、整理結果が複数のタスクで繰り返し使用されるにつれて徐々に償却されます。
おわりに
openJiuwenの個人ナレッジスペースは、分散していた個人の資料を、持続的に再利用可能なナレッジへと整理します。ユーザーが自らソースを選択し、システムが継続的に収集・更新することで、資料は閲覧しやすくなるだけでなく、エージェントが必要に応じて読み込むこともでき、さまざまなタスクに背景を提供します。
今後、openJiuwenの個人ナレッジスペースは、ユーザーの使用履歴と組み合わせて作業目標とナレッジの不足を識別し、能動的に資料を補充することを計画しています。ナレッジの蓄積を実際のニーズに一層近づけ、オフィスエージェントが使用するほどあなたをより理解できるようにします。
個人ナレッジスペースが、あなたが蓄積した資料を、次回のAgent協働の出発点にします。
個人ナレッジスペースはWorkSwarmで既にリリースされています。興味のあるユーザーは公式サイトからワンクリックでダウンロードし、すぐに体験できます:
WorkSwarm公式サイト:https://openjiuwen.com/workswarm
GitHubリポジトリ:https://github.com/openJiuwen-ai/jiuwenswarm
AtomGitリポジトリ:https://atomgit.com/openJiuwen/
*本文は量子位の許諾を得て掲載したものであり、見解はすべて原作者に帰属します。