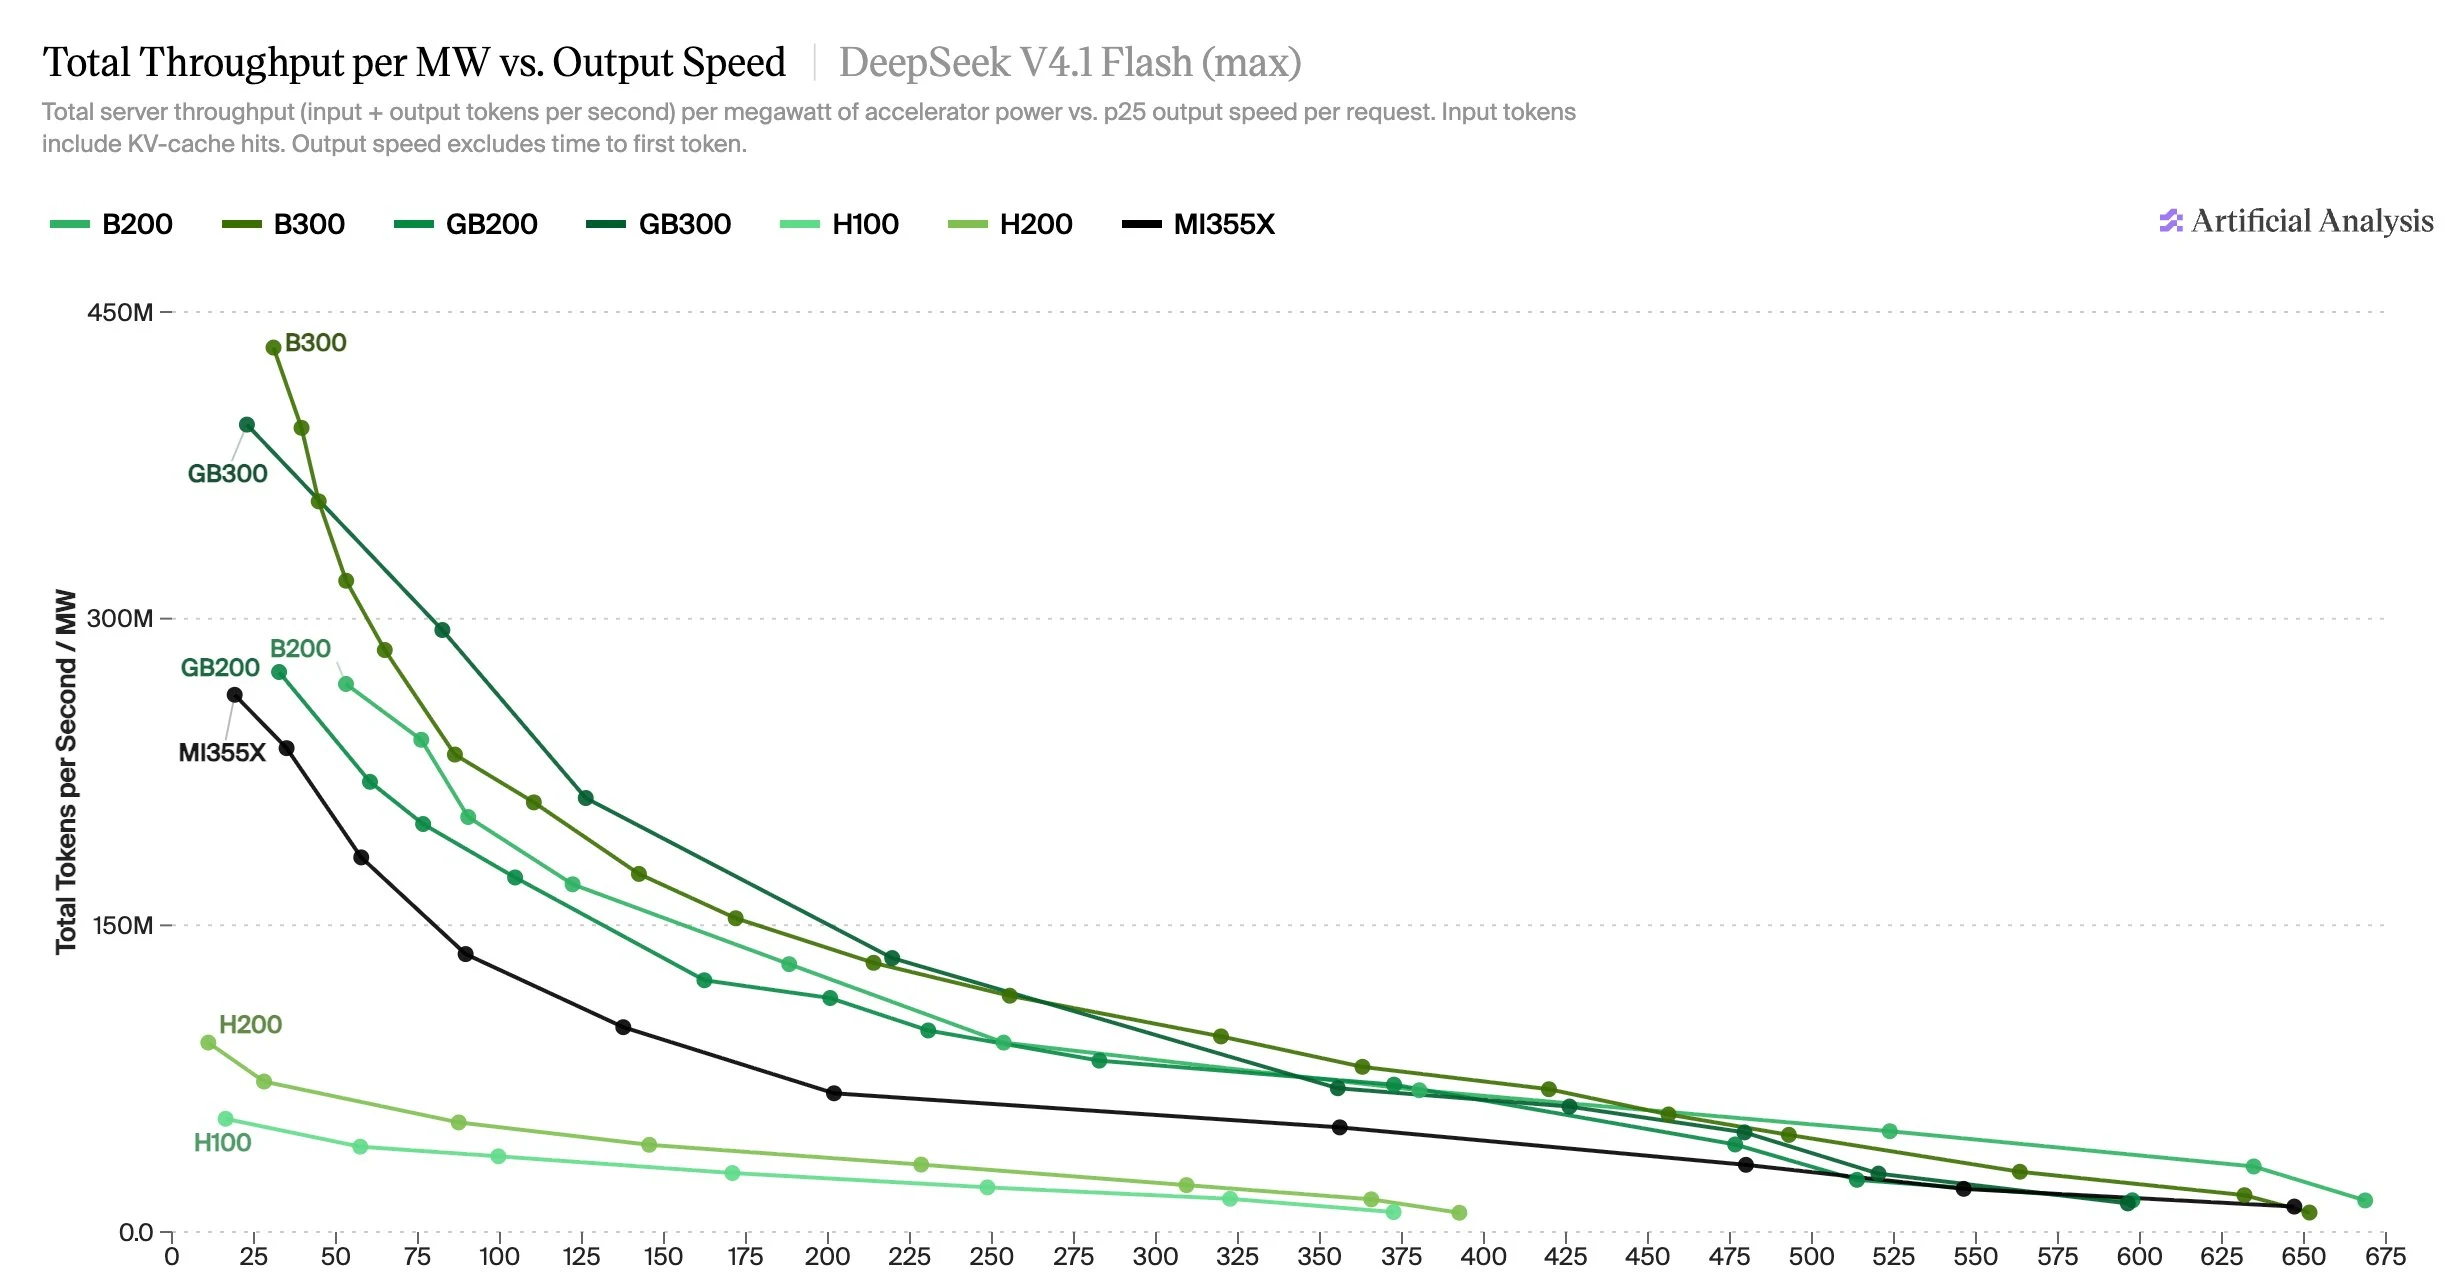
DeepSeek V4.1 Flash を AA-AgentPerf に追加し、NVIDIA および AMD ハードウェアでの結果を公開しました。ユーザーあたり 100 tokens/s のとき、NVIDIA GB300 は、MW あたり最大 261M tokens/s のスループットで 1 位となっています。
AA-AgentPerf は、私たちのエージェント型推論性能ベンチマークです。実際のエージェント型コーディングセッションを再生し、プロンプトキャッシングやツール呼び出しの遅延も含めることで、日々のエージェント型ワークロードにおける推論性能を現実的に測定します。実行電力 1 メガワットあたりのシステム全体のスループットと、さまざまな同時実行レベルでのエージェントあたり出力速度を測定し、システム利用率と個々のユーザー体験のトレードオフを示します。
本日、DeepSeek V4.1 Flash がリーダーボードに参加しました。これにより、リーダーボードは DeepSeek V4 Pro 0813、Kimi K3、GLM-5.2/5.3 に加わり 4 つの注目モデルとなりました。私たちは人気の新しいオープンウェイトモデルのリリースに合わせて注目モデルを更新しており、今後の主要リリースについては day-0 の結果を掲載する予定です。
DeepSeek v4.1 Flash の背景:
➤ Artificial Analysis Intelligence Index で 39 を獲得し、DeepSeek の従来の V4 Pro 0813 の 36 を上回ります。パラメータ数は約 3 分の 1 です(552B の「バックボーン」と 16B アクティブに対し、従来は 1.6T と 49B)
➤ 新しいアーキテクチャに基づいて構築されており、入力トークンあたり 8B、出力トークンあたり 16B のパラメータを活性化する因果的エンコーダ・デコーダ設計を採用しています。さらに、アクセラレータ上ではなくホストメモリに置くこともできる 196B パラメータの Engram n-gram メモリと、従来の V4 Flash モデルのトークンあたり KV キャッシュの約 4 分の 1 で済む圧縮スパース注意機構を使用しています
➤ これにより、ウェイトがより少数の GPU に収まり、小さな KV キャッシュが GPU あたりより多くの同時実行エージェントの余裕を生むため、提供がはるかに効率的になります
DeepSeek V4.1 Flash の初期 AA-AgentPerf 結果:
➤ V4.1 Flash はわずか 2 GPU で動作するため、ラックスケールシステムは B300 のような 8 GPU シングルノードに対する優位性が小さくなります。B300 は曲線全体を通じてラックスケールの GB300 NVL72 の約 20% 以内に留まり、両端ではリードしています
➤ ユーザーあたり 100 tok/s では、GB300 が MW あたり約 261M tokens/s でリードし、B300(約 220M)、B200(約 193M)、GB200(約 178M)、MI355X(約 128M)を上回っています
➤ すべての Blackwell システムと MI355X は、単一エージェント(つまりバッチサイズ 1)で約 600 から 670 tok/s の出力速度に到達できます。一方、H100 と H200 では 372 から 392 tok/s です
➤ V4.1 Flash は V4 Pro 0813 より知能が高く、提供コストもはるかに低く、ユーザーあたり 100 tok/s での MW あたりスループットは、より大規模な兄弟モデルと比較して約 1.3 倍(GB300)から約 6.2 倍(B200)に達します