
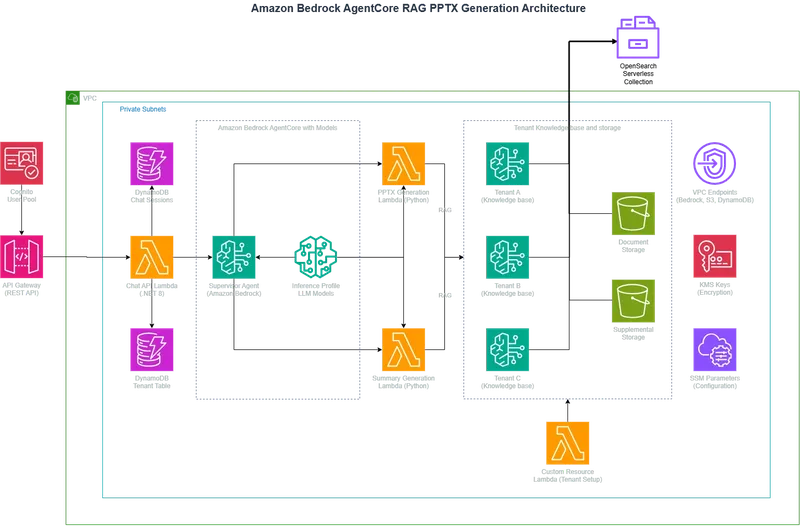
金融サービスチームは、四半期レポート、コンプライアンス文書、市場分析から顧客向け PowerPoint プレゼンテーションを手作業で作成することに、毎週多くの時間を費やしています。各プレゼンテーションには、数百ページの読解、重要なデータポイントの抽出、スライドの構成、補助ビジュアルの生成が必要です。この記事では、このワークフローを自動化する AI エージェントシステムを構築する方法を解説します。そのために使用するのが Amazon Bedrock AgentCore であり、社内テストでは 90 秒以内に完了します。このアプローチにより、コンテンツをソースドキュメントに根拠づけながら、プレゼンテーション作成時間を短縮できます。このソリューションは、Amazon Bedrock AgentCore の機能である AgentCore ランタイム上にスーパーバイザーエージェントをデプロイし、 Strands Agents フレームワークを使用してドキュメント生成ツールと要約ツールをオーケストレーションします。Anthropic Claude Sonnet 4.6(Amazon Bedrock で利用可能)がコンテンツ作成を担当し、Amazon Titan Text Embeddings v2 がベクトル検索を支え、Stability AI Stable Image Inpaint(Amazon Bedrock で利用可能)がスライド画像を生成します。この記事には、コード資産を含む公開リポジトリが付属しています。
ソリューション概要
このソリューションは、Amazon Bedrock AgentCore ランタイム上に単一のスーパーバイザーエージェントをデプロイし、ユーザーのリクエストに応じてドキュメント生成ツールと要約ツールを選択します。検索拡張生成 (RAG) パイプラインは、Amazon OpenSearch Serverless を使用して、マルチモーダルコンテンツ全体のベクトル保存とセマンティック検索を行います。
このソリューションには、.NET 8 minimal APIs で構築された REST API が含まれており、標準的な HTTP 呼び出しを通じて既存のエンタープライズアプリケーションと統合できます。AWS Lambda は、PowerPoint 生成用のコンテナ化された関数を含むサーバーレスコンピューティングを提供します。このソリューションは、 Amazon Virtual Private Cloud (Amazon VPC) による分離、 AWS Key Management Service (AWS KMS) による暗号化、そして AWS Identity and Access Management (IAM) による最小権限アクセス制御で実装を保護します。
主要な概念
このセクションでは、このソリューションに適用される AgentCore ランタイム、RAG、コンテンツ安全性ガードレールについて説明します。
Amazon Bedrock AgentCore によるエージェントオーケストレーション
大規模なナレッジベースからドキュメントを生成する単一の AI エージェントは、コンテンツの取得、アウトラインの構成、テキストの生成、画像の作成、ファイルの組み立てを行う必要があります。これらの競合する責務をモノリシックな関数で実装するのではなく、このソリューションではスーパーバイザーエージェントがリクエストを専門ツールにルーティングするツールベースのアーキテクチャを使用します。
Amazon Bedrock AgentCore ランタイムは、あらゆるフレームワークやモデルを使用して、スケールに合わせてエージェントを構築、接続、最適化するためのプラットフォームを提供します。エージェントコードは、セッション管理、組み込み ID、可観測性を備えた分離されたコンテナで実行されます。このソリューションは、スーパーバイザーロジックの実装に Strands Agents フレームワーク(AI エージェント構築用のオープンソース SDK)を使用します。
スーパーバイザーエージェントは 2 つのツールを公開します:
- generate_pptx: PPTX Generator Lambda 関数を呼び出して PowerPoint プレゼンテーションを作成します。この関数は、ナレッジベースからコンテンツを取得し、スライドのアウトラインを生成し、AI 画像を作成し、最終的なドキュメントを組み立てます。
- generate_summary: RAG を使用してナレッジベースから情報を抽出・統合し、正確で根拠のある回答を提供します。
エージェントは、リクエストがドキュメント生成、コンテンツ要約、あるいはその両方を必要とするかを判断し、適切なツールを呼び出します。エージェントコードに新しいツールを定義することで、既存のツールを変更せずに新しい機能を追加できます。
エンタープライズナレッジのための検索拡張生成 (RAG)
RAG は、AI システムにおける根本的な課題、すなわちモデルの学習データだけに頼るのではなく、エンタープライズデータに根拠づけられた正確で最新の情報を提供するという課題に対応します。この実装では、 Amazon Bedrock Knowledge Basesを使用します。これは、ベクトル検索と大規模言語モデル (LLM) を組み合わせて、応答を生成する前に関連するコンテキストを取得します。
RAGパイプラインは次のように動作します。
- エンタープライズドキュメントを Amazon Simple Storage Service (Amazon S3).
- にアップロードします。システムはドキュメントをチャンク化して解析し、表、グラフ、画像などのマルチモーダルコンテンツに対して特別な処理を適用します。
- Amazon Titan Text Embeddings v2 が各チャンクを意味的な内容を捉えた高次元ベクトルに変換します。
- Amazon OpenSearch Serverless がベクトルを保存し、検索可能なベクトルデータベースを作成します。
- クエリ実行時、システムはユーザーのリクエストを埋め込みに変換し、類似性検索を実行して関連するドキュメントチャンクを取得します。
- 取得されたチャンクは言語モデルにコンテキストを提供し、言語モデルはソース資料に基づいた応答を生成します。
このアプローチは、生成されるドキュメントをエンタープライズナレッジベースのソース情報に基づかせることで、ハルシネーション(幻覚的コンテンツ)を低減するのに役立つよう設計されています。
注: Amazon OpenSearch Serverless コレクションのデータプレーンは、Amazon Bedrock Knowledge Bases がカスタマーの VPC エンドポイント経由ではなく AWS 管理のインフラストラクチャから Amazon OpenSearch Serverless にアクセスするため、公開アクセス可能なままにしておく必要があります。IAM データアクセスポリシーがコレクションを保護し、VPC のみのアクセスでは Amazon OpenSearch Serverless ダッシュボードが制限されます。
コンテンツ安全性のための Amazon Bedrock Guardrails
エンタープライズAIアプリケーションでは、組織の基準およびコンプライアンス要件を満たすためにコンテンツモデレーションが必要です。 Amazon Bedrock Guardrails ドキュメント生成パイプライン全体に統合された、内蔵のコンテンツフィルタリングおよび安全メカニズムを提供します。
ガードレールは複数の段階で動作します:
- 入力処理: ユーザーのリクエストをフィルタリングし、インジェクションの問題や不適切なコンテンツの防止に役立ちます。
- 出力生成: モデルの出力を監視し、コンテンツポリシーへの準拠を確認します。
- 個人情報(PII)の取り扱い: PIIを検出し、匿名化またはブロックします。
この実装は、以下を通じてカスタムガードレールを作成します。 AWS Cloud Development Kit(AWS CDK)、エンタープライズドキュメント作成に合わせて調整された特定のポリシーで構成されています。このエージェントはモデル呼び出しレベルでガードレールを適用し、デプロイごとの手動設定を必要とせずに一貫したコンテンツの安全性を提供します。
ソリューションアーキテクチャ
次の図は、エージェントベースのドキュメント生成システムを示しています。
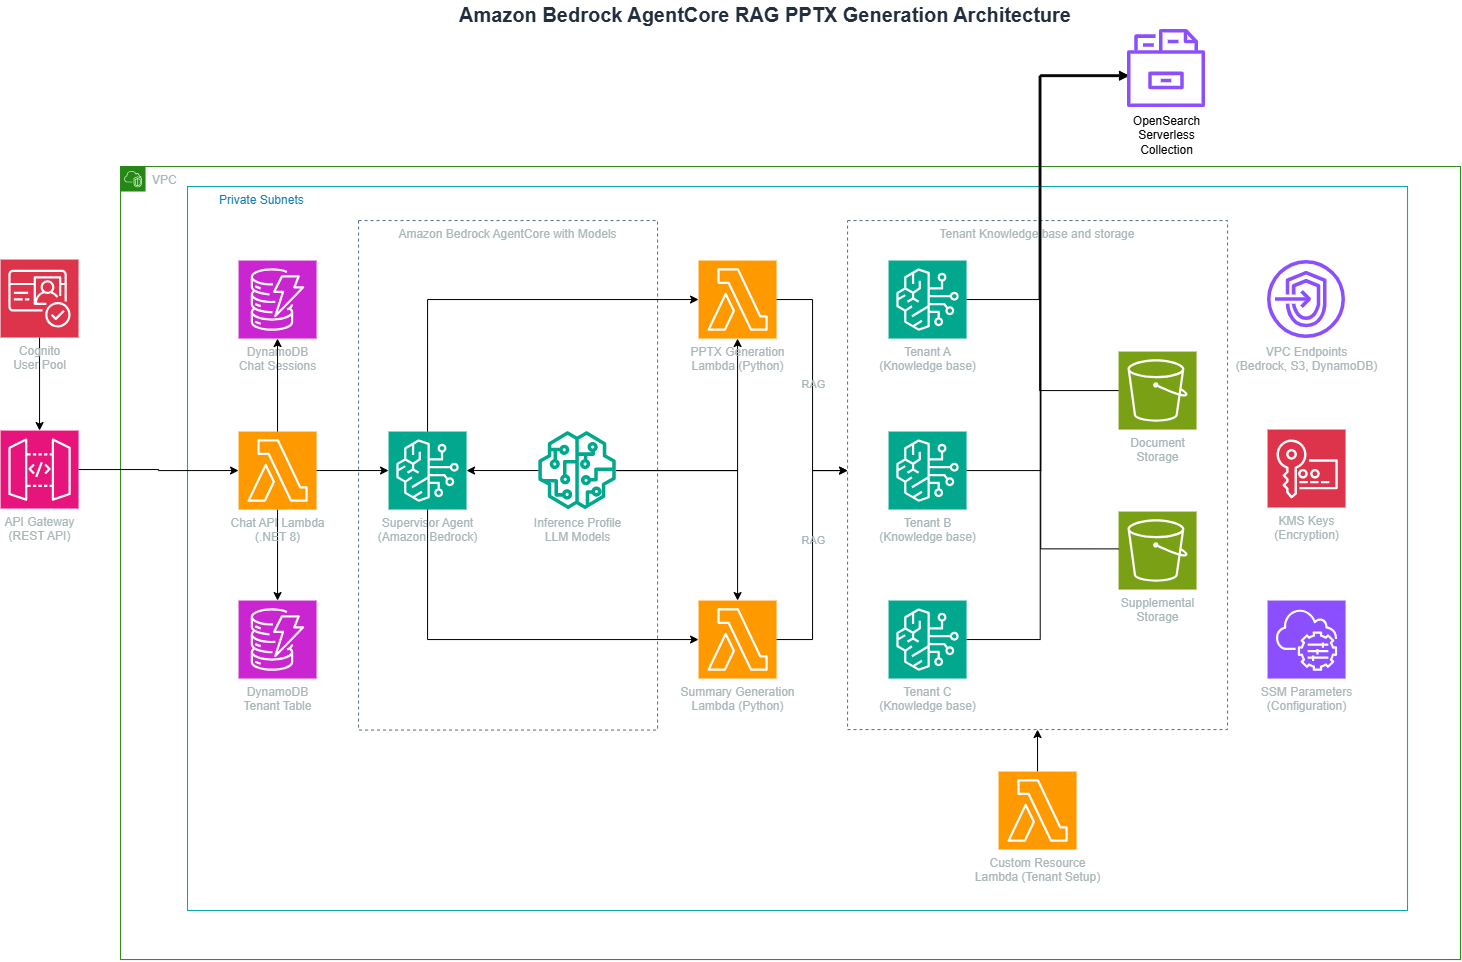
図1: Amazon Bedrock AgentCore を使用したRAGプレゼンテーション生成システムのアーキテクチャ
データフローは、次を経由して届くユーザーリクエストから始まります Amazon API Gateway「、そこから .NET ベースの Chat API にルーティングされます。この API は」 AWS Lambda。このAPIは会話状態を以下に保持します: Amazon DynamoDB。その後、Amazon Bedrock AgentCoreランタイム上でホストされているスーパーバイザーエージェントを呼び出します。
スーパーバイザーエージェントはリクエストを分析し、適切なツールを選択します。ドキュメント生成の場合は、PPTX Generator Lambda(コンテナ化されたPython関数)を呼び出します。要約の場合、スーパーバイザーはSummary Generator Lambdaを呼び出し、このLambdaはナレッジベースを通じて照会を行います。 retrieve_and_generate API。
このシステムは、Amazon S3 に保存されたドキュメントを Amazon Titan Text Embeddings v2 を使用して処理、チャンク分割、埋め込み化します。Amazon OpenSearch Serverless が埋め込みをインデックス化し、高速なセマンティック検索を実現します。ツールがナレッジベースに問い合わせると、Amazon OpenSearch Serverless が関連するチャンクを取得し、それらが根拠に基づいた応答を生成するためのコンテキストとして Anthropic Claude Sonnet 4.6(Amazon Bedrock 上)に供給されます。
このシステムは生成されたドキュメントをAmazon S3に保存し、安全なダウンロードのためにpresigned URLを返します。セキュリティ対策には以下が含まれます:
- AWS WAF 「Amazon API GatewayのマネージドルールセットおよびIPベースのレート制限と組み合わせて使用されます。」
- Amazon Cognito 「Plus機能プランおよび脅威保護のための高度なセキュリティモードが含まれます。」
- 一貫したコンテンツフィルタリングのために、AWS CDK経由でプロビジョニングされたAmazon Bedrock Guardrails。
- ポイントインタイムリカバリ、削除保護、およびカスタマーマネージドのAWS KMS暗号化を備えたAmazon DynamoDB。
- バージョニング、サーバーアクセスロギング、およびパブリックアクセスブロックが有効化された Amazon S3 バケット。
- AWS X-Ray 分散デバッグのためのLambda関数上のトレーシング。
- 正規表現によるテナントIDおよびセッションIDの検証を用いた入力バリデーション。
- テナント分離による AWS Security Token Service (AWS STS) テナントごとのロール引き受け。
前提条件
デプロイの前に、環境に以下のツールとアクセスを設定しておく必要があります。
- AWS 環境:
- インフラストラクチャをデプロイするための権限を持つ有効な AWS アカウント。
- 認証情報が設定されたAWS Command Line Interface (AWS CLI)。
- 適切なサービスアクセスポリシーを備えたIAMロール。
- 開発ツール:
- .NET SDK 8 Amazon.Lambda.Tools がグローバルにインストールされていること。
- Python 3.12 以降 「AWS CDKおよびLambda関数向け。」
- Node.js および AWS CDK CLI インフラの展開のため。
- Docker または Finch コンテナイメージのビルド用(ARM64サポートが必要です)。
- AWSサービスへのアクセス:
- Amazon Bedrock(Anthropic Claude Sonnet 4.6、Amazon Titan Text Embeddings v2、Stability AI Stable Image Inpaint のモデルアクセスが可能、Amazon Bedrock 経由で利用可能)。リージョンごとのモデル提供状況については、次を参照してください Amazon BedrockにおけるAWSリージョン別のサポート対象モデル.
- お客様のアカウントでAmazon Bedrock AgentCoreへのアクセスが有効になっていること。
- Amazon API Gateway のリージョン REST API 統合タイムアウトが 300 秒以上に設定されています。デフォルトは 29 秒です。詳細については、以下を参照してください。 API Gatewayのクォータ.
- プライベートサブネットを持つ既存のAmazon VPC。
- デプロイアーティファクト用の Amazon S3 バケット。
ソリューションをセットアップする
セットアッププロセスには、デプロイパラメータの設定とAWS CDK環境の初期化が含まれます。
- リポジトリをクローンする そしてプロジェクトディレクトリに移動します:
git clone https://github.com/aws-samples/sample-generating-powerpoint-presentations-with-amazon-bedrock.git - 設定ファイルを作成する
pipeline-params.iniリポジトリのルートで:environment=dev awscliprofile= ContainerRegistry=lambda-pptx-gen AgentContainerRegistry=agentcore-supervisor BucketDev=<amzn-s3-demo-bucket> VpcId=<your-vpc-id> ParsingInferenceProfileId=us.anthropic.claude-haiku-4-5-20251001-v1:0 AgentInferenceProfileId=us.anthropic.claude-sonnet-4-6 EmbeddingModelId=amazon.titan-embed-text-v2:0 ImageGenerationModelId=stability.stable-image-inpaint-v1:0 PPTXGenImageTag=latest AgentImageTag=latestセット
awscliprofileAWS CLI プロファイル名に置き換えてください。環境変数の認証情報を使用する場合は空のままにします。 - Bootstrap AWS CDK (アカウントとリージョンごとに1回のみ):
cdk bootstrapこれにより、 AWS CloudFormation AWS CDK デプロイメントに必要な CDKToolkit スタック。
- ビルドスクリプトを実行可能にします:
chmod +x ./pipeline-build.sh
chmod +x ./pipeline-deploy.sh
chmod +x ./deploy-agentcore.sh
ビルドとデプロイ
このデプロイは、アーティファクトのビルド、インフラストラクチャのデプロイ、AgentCoreランタイムエージェントのデプロイという3つのフェーズで構成されています。
ビルドフェーズ
ビルドフェーズではアプリケーションコードをコンパイルし、デプロイ用アーティファクトをパッケージ化します。ビルドスクリプトを実行してください:
./pipeline-build.shこのスクリプトは .NET プロジェクト(Chat API)をコンパイルし、Lambda デプロイパッケージとしてパッケージ化します。Docker または Finch を使用して PPTX Generator のコンテナイメージをビルドし、 Amazon Elastic Container Registry(Amazon ECR)。その後、コンテナイメージをプッシュし、ビルド成果物を次の場所に保存します: asset-output ディレクトリ。
インフラのデプロイフェーズ
インフラストラクチャのデプロイはAWSリソースを作成し、サービス統合を構成します。デプロイスクリプトを実行してください:
./pipeline-deploy.shこのデプロイでは、依存関係の順に4つのAWS CloudFormationスタックを作成します。
- VPCEndpointsStack: Amazon Bedrock AgentCore を含む AWS サービス向けの Amazon VPC エンドポイントを設定します。
- OpenSearchスタック: ベクトルストレージ用のAmazon OpenSearch Serverlessコレクションをプロビジョニングします。
- AgentCoreStack: ガードレール、Lambda 関数、IAM ロールを作成し、設定を以下に保存します AWS Systems Manager Parameter Store.
- ChatApiStack: Amazon API Gateway と Chat API Lambda をデプロイします。
AgentCore ランタイムのデプロイ
インフラストラクチャスタックをデプロイした後、supervisor agent を AgentCore runtime にデプロイします:
./deploy-agentcore.shこのスクリプトはスーバーバイザーエージェントのコンテナ(ARM64)をビルドし、Amazon ECR にプッシュし、AgentCore のランタイムとエンドポイントを作成し、エンドポイントの Amazon Resource Name(ARN)で Systems Manager のパラメータを更新します。Chat API はこのエンドポイント ARN を参照して、リクエストをエージェントへルーティングします。
デプロイ後、AWS CloudFormation の出力には、Amazon API Gateway のエンドポイント URL とリソース識別子が含まれます。
構成
このソリューションには、いくつかの構成ポイントがあります:
エージェントへの指示
編集 agent/app.py スーパーバイザーエージェントのシステムプロンプトと動作を修正します。このエージェントは、Strands Agents を使用し、次で定義される2つのツールを備えています。 agent/tools.py:
- generate_pptx: ドキュメント作成のためにPPTX Generator Lambdaを呼び出します。
- generate_summary: ナレッジベースクエリのためにSummary Generator Lambdaを呼び出します。
モデル選択
で pipeline-params.ini、モデル識別子を調整します:
ParsingInferenceProfileId: ナレッジベースドキュメント解析用モデル(コスト効率の観点からAnthropic Claude Haiku 4.5を推奨)。AgentInferenceProfileId: エージェントの推論に使用するモデル(Anthropic Claude Sonnet 4.6 を推奨)。EmbeddingModelId: ベクトル検索用の埋め込みモデル(Amazon Titan Text Embeddings v2)。ImageGenerationModelId:「スライド画像生成のモデル(Stability AI Stable Image Inpaint)。」
直接のモデルIDではなく推論プロファイルを使用すると、リクエストはより広範なマルチリージョン容量プールを利用でき、スループットが向上し、負荷がかかった状態でも一貫したパフォーマンスを維持しやすくなります。
Lambda 設定
スタックファイル内のコンピュートリソースを調整します:
- Chat API: メモリ128 MB、タイムアウト29秒、予約済みコンカレンシー100(
api.py). - PPTXジェネレーター: 「900 MBのメモリ、300秒のタイムアウト、50の予約済み同時実行数(」
pptx_gen.py). - 要約ジェネレーター: 512 MBのメモリ、300秒のタイムアウト、50の予約済み同時実行数(内
sum_gen.py).
結果
90ページの Amazon 2024 Annual Report PDFを用いた内部テストにおいて、このソリューションは以下のパフォーマンス指標を示しました:
- プレゼンテーション生成時間: エンドツーエンドで70~90秒(ナレッジベースの検索、コンテンツ生成、画像作成、ファイルの組み立てを含む)。
- スライド数: タイトル、箇条書き、画像+テキスト、画像のみ、要点という形式を含む6枚のスライド。
- 画像生成: Stability AI Stable Image Inpaint を使用してプレゼンテーションごとに2枚のAI生成画像。
- 1回の生成あたりのコスト: 執筆時点の us-east-1 でのモデル呼び出しコストは約 $0.04(テキスト生成と画像生成を含み、画像生成がコストの大部分を占める)。
- ナレッジベースの取り込み: 1.3 MB のPDFドキュメント1件あたり2分未満。
PowerPoint プレゼンテーション
以下の図は、生成されたプレゼンテーションのスライド例を示しています。
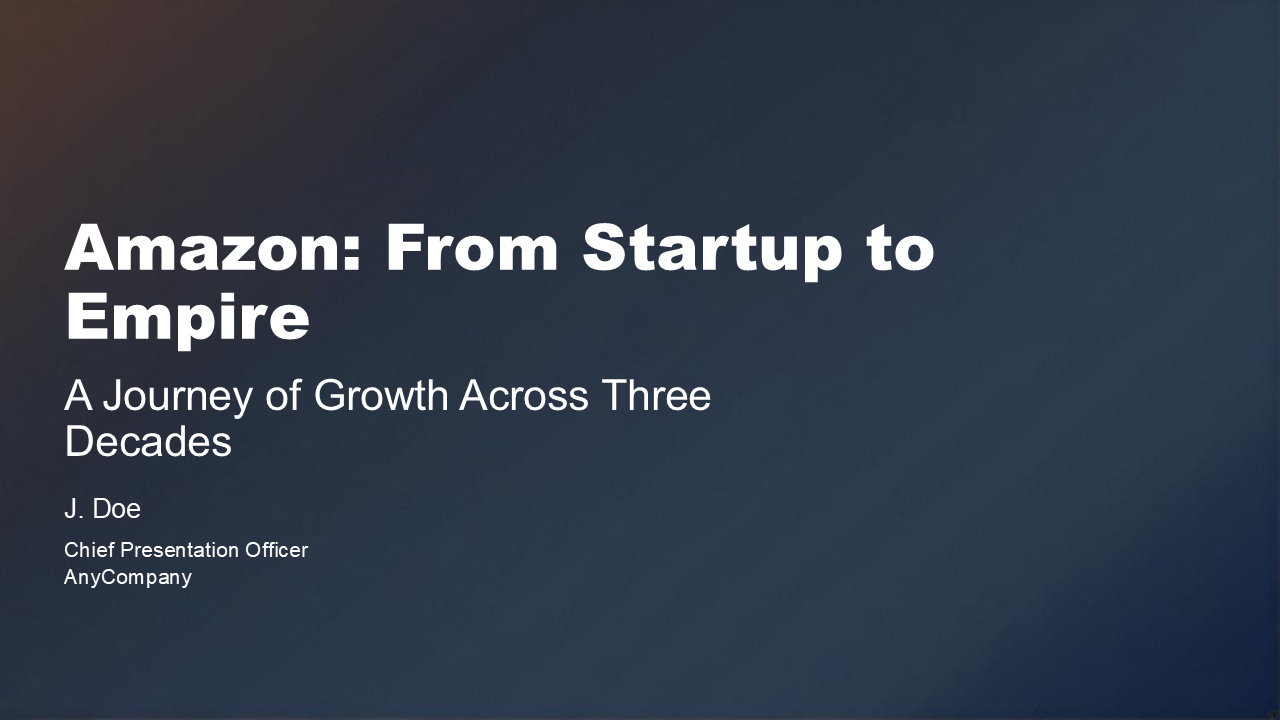
図 2: カスタマイズ可能なブランディングを備えた生成されたタイトルスライド
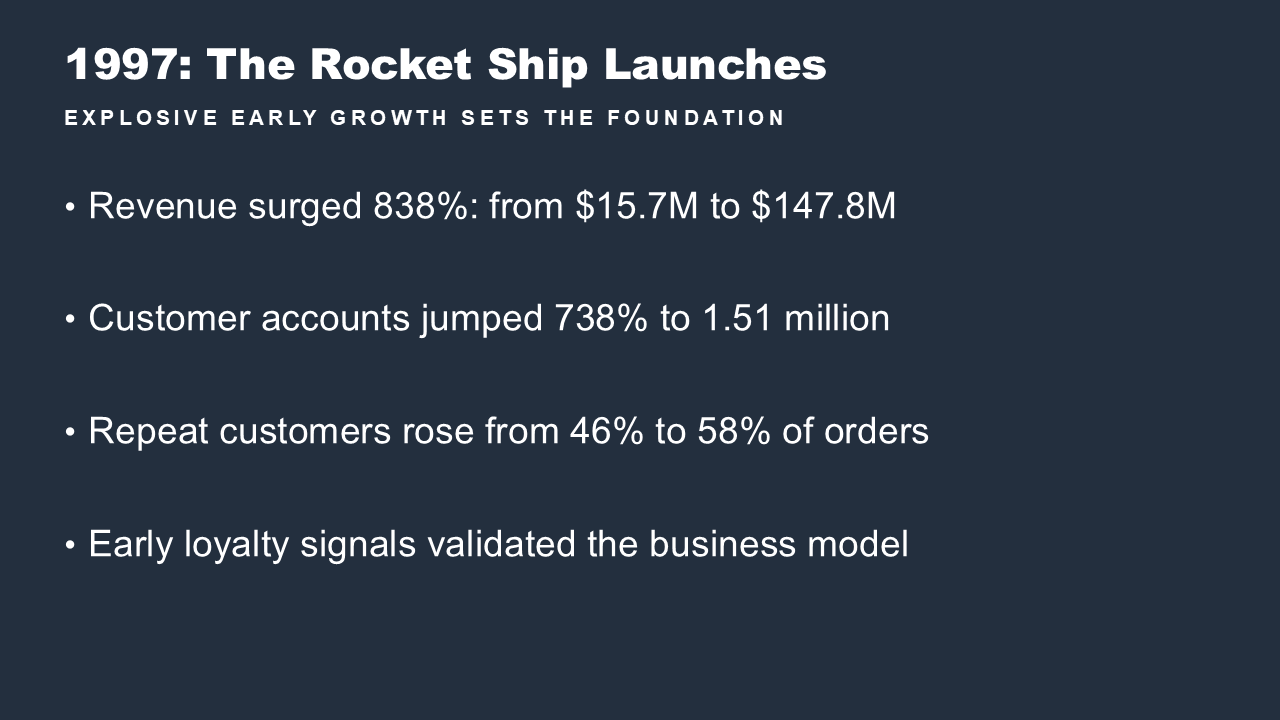
図 3: 箇条書きを含む生成されたコンテンツスライド
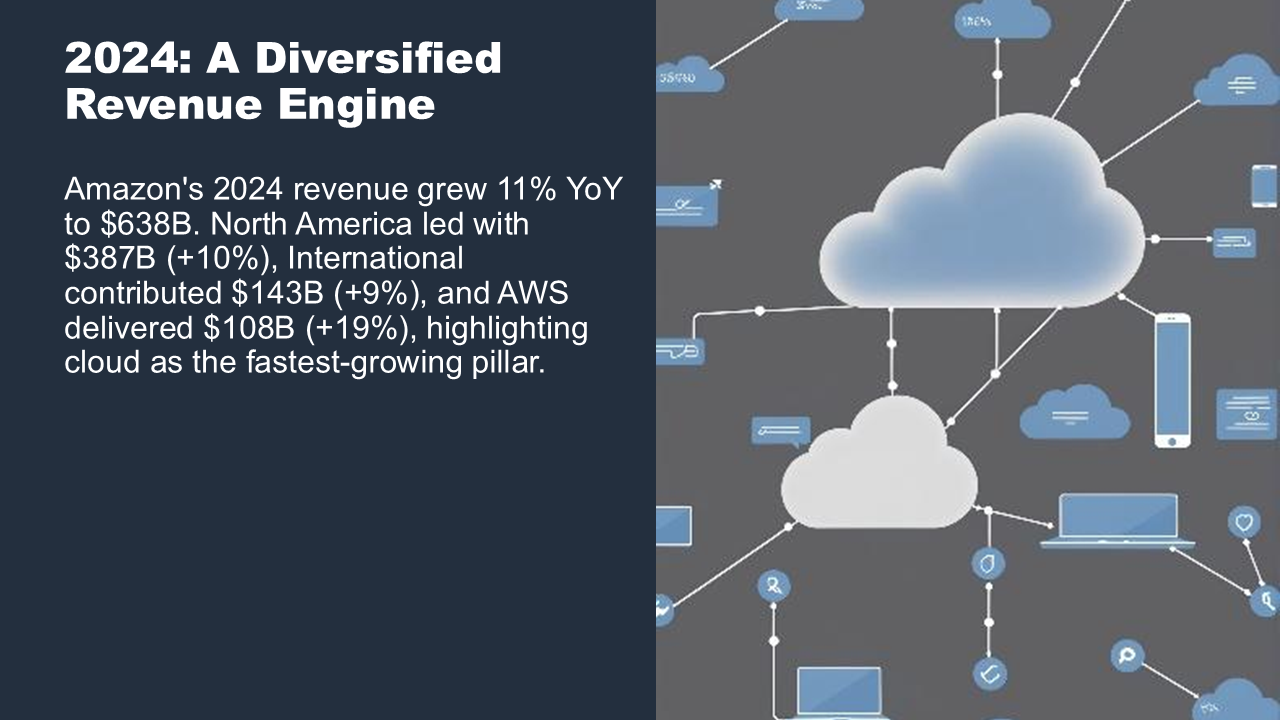
図 4: テキストとAI生成画像を組み合わせた生成されたスライド
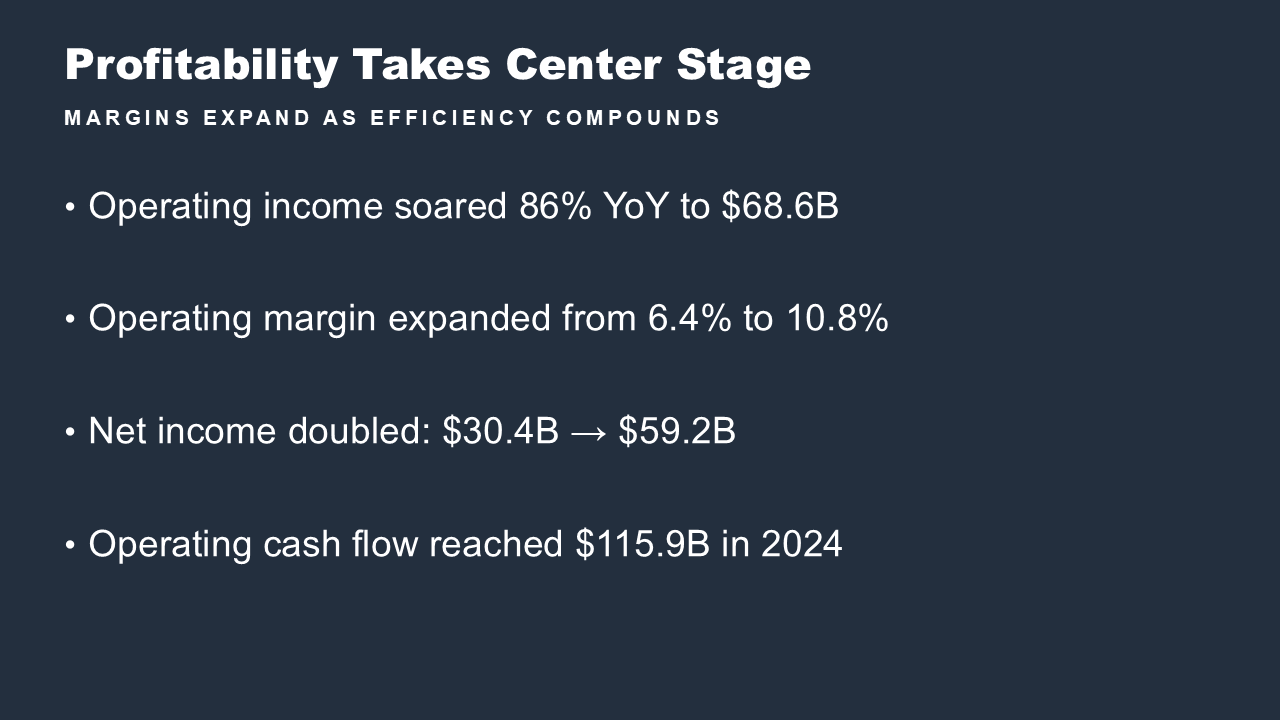
図 5: 収益性の指標をまとめた生成されたコンテンツスライド
図 6: AI生成のビジュアルを用いた生成された画像のみのスライド
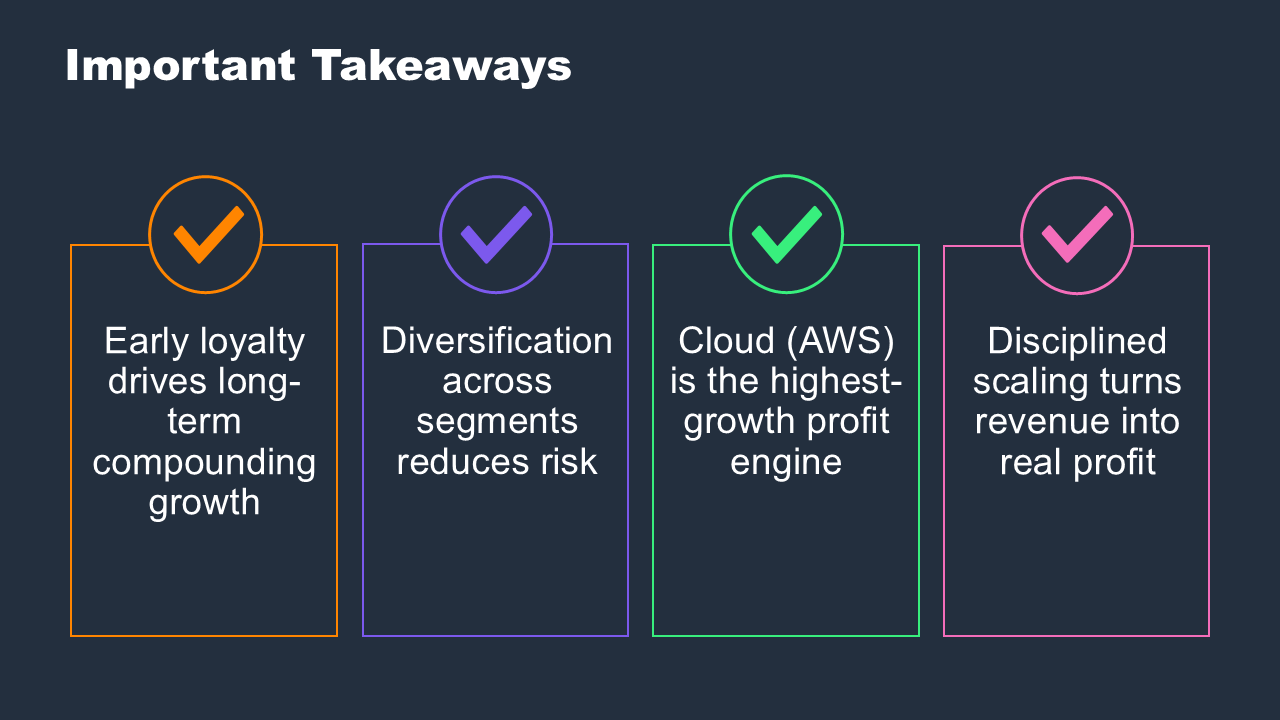
図7:生成された要点スライド
生成されたプレゼンテーションには以下が含まれます:
- カスタマイズ可能なブランディングを備えたタイトルスライド。
- 箇条書きと構造化されたテキストを含むコンテンツスライド。
- Stability AIのStable Image Inpaint(Amazon Bedrock上)によるAI生成ビジュアルを使った画像スライド。
- プレゼンテーションのガイダンスを含むスピーカーノート。
- 社内テンプレートに基づく一貫した書式設定。
要約
ナレッジベースに提供される要約出力には、以下が含まれます:
- ナレッジベースコンテンツの簡潔な合成。
- 出典文書への引用の追跡。
- 重要ポイントを強調した構造化された形式。
APIレスポンス
Chat APIは以下を返します:
- リアルタイムのユーザーフィードバックのためのストリーミング応答。内部テストで、プレゼンテーションの生成に70~90秒かかることが判明したため(デフォルトのAmazon API Gatewayの29秒の統合タイムアウトを超過)、Chat APIは非同期呼び出しパターンを使用しています。同期REST呼び出しで待機するのではなく、ストリーミングまたはポーリングを使用して最終結果を受け取ってください。
- 複数ターンにわたる会話コンテキストの維持。
- ドキュメントダウンロード用のAmazon S3 presigned URL(有効期限5分)。
生成コンテンツは、配信前にコンテンツポリシーへの準拠を確認するため、Amazon Bedrock Guardrails による検証を受けます。
クリーンアップ
継続的な課金を避けるため、デプロイしたリソースを削除してください:
- AgentCoreランタイムを削除する およびエンドポイント:
aws bedrock-agentcore-control delete-agent-runtime-endpoint \ --agent-runtime-id <runtime-id> \ --agent-runtime-endpoint-id <endpoint-id> aws bedrock-agentcore-control delete-agent-runtime \ --agent-runtime-id <runtime-id> - Amazon DynamoDBの削除保護を無効にする (スタック削除前に必要):
aws dynamodb update-table --table-name chat-sessions-dev --no-deletion-protection-enabled aws dynamodb update-table --table-name tenant-table-dev --no-deletion-protection-enabled - AWS CloudFormation スタックを削除する 依存の逆順で:
aws cloudformation delete-stack --stack-name ChatApiStack aws cloudformation delete-stack --stack-name AgentCoreStack aws cloudformation delete-stack --stack-name OpensearchStack aws cloudformation delete-stack --stack-name VPCEndpointsStack - 空のAmazon S3バケット 削除前(AWS CloudFormation は空でないバケットを削除できません):
aws s3 rm s3://amzn-s3-demo-bucket --recursive - Amazon ECR リポジトリの削除 コンテナイメージを含む:
aws ecr delete-repository --repository-name lambda-pptx-gen --force aws ecr delete-repository --repository-name agentcore-supervisor --force - テナントナレッジベースのサブスタックを削除する (テナントプロビジョナーによって作成されたもの):
aws cloudformation delete-stack --stack-name bedrock-kb-<tenant-id>
セキュリティに関する考慮事項
このソリューションでは、モデル ID、Amazon S3 バケット名、ガードレール ID などの設定値に Lambda 環境変数を使用しています。これらは機密情報ではなくリソース識別子です。本番環境へのデプロイでは、API キーやデータベース認証情報などの機密性の高い設定値には AWS Secrets Manager を使用してください。
AgentCore ランタイムエージェントは、セッションレベルの分離を備えた分離されたコンテナ内で実行されます。各ユーザーセッションは専用の環境で動作し、セッション間のデータ混濁を防ぐのに役立ちます。
まとめ
この記事では、Amazon Bedrock AgentCore を使用して、エンタープライズドキュメント生成を自動化する AI エージェントシステムを構築しました。AgentCore ランタイムにデプロイされたスーパーバイザーエージェントは、リクエストをドキュメント作成および要約用の専用ツールにルーティングし、社内テストではプレゼンテーションの作成を約 90 秒に短縮しました。
RAG パイプラインにより生成コンテンツがソースドキュメントに根ざし、Amazon Bedrock Guardrails がコンテンツのコンプライアンスを検証します。このアーキテクチャは、金融サービスにおけるレポートの自動生成、エンジニアリングチーム向けの技術ドキュメント、営業組織向けの提案書作成などに適用できます。
始めるには、 GitHubリポジトリ をクローンし、セットアップ手順に従ってください。使用されているサービスの詳細については、 Amazon Bedrock AgentCoreドキュメント, Strands Agents SDK、および AWS CDK Developer Guide.