
IDC の調査 によると、文書に関する課題により組織は情報従業員 1 人あたり年間 19,732 ドルのコストを負担し、生産性が 21.3 パーセント低下しています。何百ものサプライヤーから請求書を受け取る組織では、レイアウトが発行元ごとに異なり、予告なしに変更されることがよくあります。この規模では、テンプレートベースのシステムは絶え間ないメンテナンスを必要とします。スタッフは時間の最大 30 パーセントを文書関連のタスクに費やす可能性があり、手動でのデータ入力のエラー率は 1~4 パーセントに及びます。従来のインテリジェントドキュメント処理(IDP)ソリューションはこの負担の一部を解決しますが、文書フォーマットごとに大規模な事前設定が必要であり、ベンダー間でレイアウトが異なると動作しなくなります。
この記事では、最小限の人間の介入でビジネス文書を分類、抽出、検証、学習するエージェント型 IDP システムを Amazon Bedrock AgentCore を使って構築する方法を学びます。Amazon Bedrock AgentCore は、あらゆるフレームワークやモデルを使用して、大規模にエージェントを構築、接続、最適化するためのプラットフォームです。エージェントは、サプライヤーの請求書、発注書、保険請求、ローン申込書などの新しい文書フォーマットを自動的に処理します。この記事を読み終える頃には、次のことができるようになります:
- マルチエージェント IDP システムを、多くの場合 20 分以内にデプロイする。
- 手動のテンプレート設定なしで新しい文書タイプを処理する。
- エージェントが新しい文書フォーマットごとに自己学習し、学習した内容を再利用できるようにする。これにより、そのタイプの以降の文書は再学習なしで直接抽出に進む。
ルールベースの文書処理における課題
多くの IDP パイプラインでは、すべての文書フォーマットについてテンプレート、抽出ルール、検証ロジックを事前に定義する必要があります。新しいベンダーが異なるレイアウトの発注書を送ってくると、パイプラインが機能しなくなります。これにより、3 つの主要な課題が生じます:
- テンプレートの硬直性: 新しい文書フォーマットごとに手動設定が必要であり、わずかなレイアウト変更でも抽出が失敗する可能性があります。
- 学習の欠如: システムが以前の修正から知識を保持しないため、同じ抽出エラーが類似した文書で繰り返されます。
- スケーリングの負担: 新しいベンダーや文書バリアントが増えるたびにメンテナンス作業が倍増し、何百ものソースから文書を処理する組織は継続的な運用コストに直面します。
エージェント型のアプローチはこれらの課題に対処します。静的なテンプレートの代わりに、AI エージェントが各文書を分析し、抽出指示を生成し、結果を検証し、修正から自動的に学習します。時間の経過とともに、システムは文書フォーマットのナレッジベースを構築し、類似した文書を最小限の追加設定で処理できるようになります。
ソリューション概要
このソリューションでは、8 つの専門エージェントが、Amazon Bedrock AgentCore 上で実行される 2 つのグラフベースのワークフローにわたって連携します。
次の図は、AI エージェントを構築するためのオープンソース SDK である Strands Agentsを使用して構築されたマルチエージェントワークフローグラフを示しています。
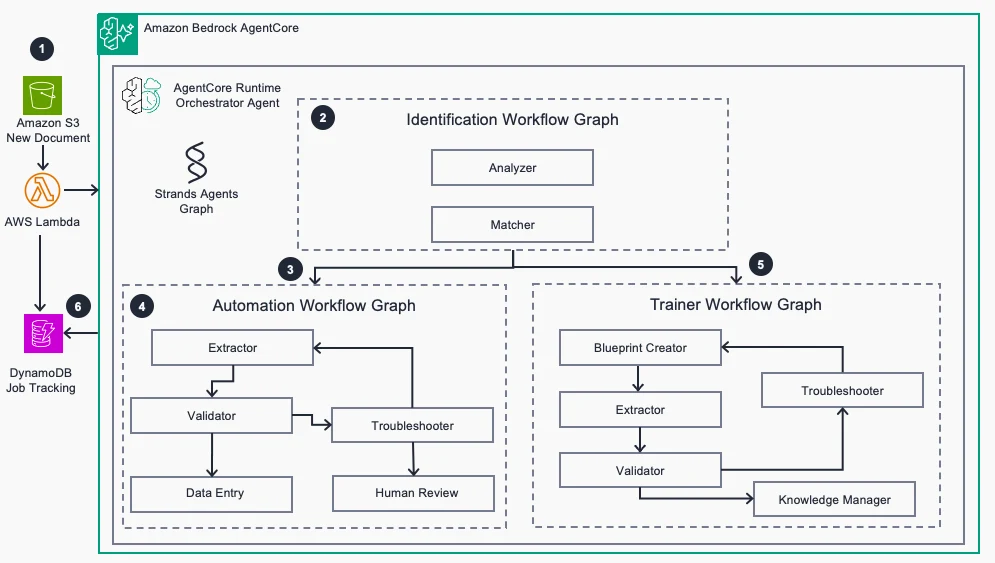
図 1: マルチエージェントオーケストレーションワークフローグラフ
- 識別ワークフロー: Analyzer エージェントが Amazon Textract を使用してテキストを抽出し、文書タイプと送信者を識別します。Matcher エージェントはベクトル類似性を使用して類似文書を検索します。 Amazon S3 Vectors(Amazon Simple Storage Service (Amazon S3) の機能)。
- トレーニングワークフロー (新しいドキュメントタイプ): 一致するものが見つからない場合、Instructions エージェントが抽出プロンプトを生成し、Extractor エージェントが構造化データを抽出し、Validator エージェントが Amazon Aurora DSQL内のスキーマおよびビジネスルールに照らして結果を検証します。検証に失敗した場合、Instructions Fixer エージェントがプロンプトを修正して再試行します。成功した場合、Save Instructions エージェントが指示を永続化して再利用できるようにします。
- 自動化ワークフロー (既知のドキュメントタイプ): 一致が見つかった場合、Extractor エージェントは既存の指示を使用します。検証に失敗した場合、Troubleshooter エージェントが指示を変更せずに抽出データを直接修正します。
仕組み
次の図は、このソリューションのインフラストラクチャアーキテクチャを示しています。
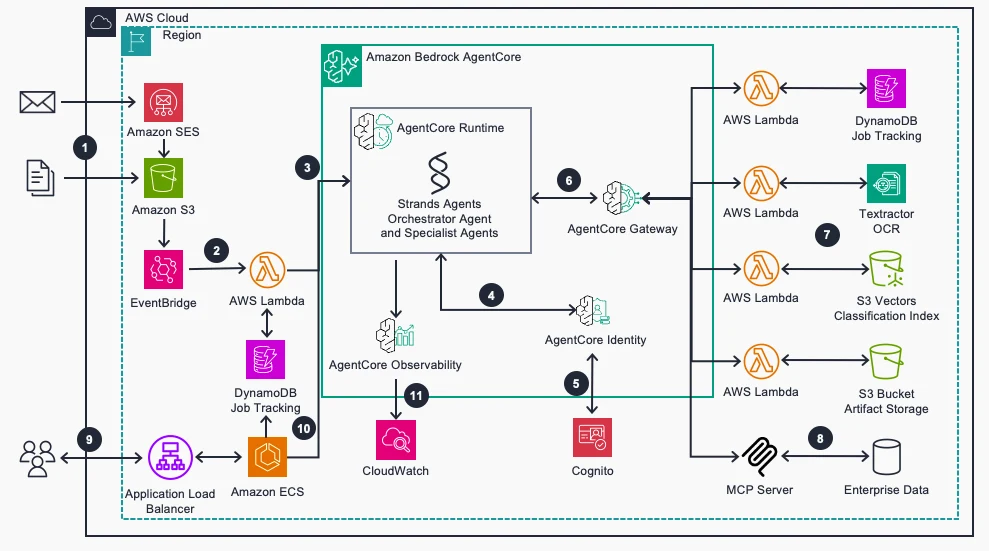
図 2: AWS 上の Agentic IDP インフラストラクチャアーキテクチャ
- ビジネスドキュメントは、 Amazon Simple Email Service (Amazon SES)に到着するか、Amazon S3 に直接アップロードされます。
- Amazon EventBridge が AWS Lambda 関数をトリガーし、この関数が Amazon DynamoDB 内にトラッキングジョブを作成し、Amazon Bedrock AgentCore の機能である AgentCore runtime を呼び出します。
- AgentCore runtime は、Strands Agents を通じてドキュメント処理をオーケストレーションします。
- エージェントは、Amazon Bedrock AgentCore の機能である AgentCore Identity が管理するマシン間認証情報を通じて、AWS リソースにセキュアにアクセスし、 Amazon Cognito.
- Lambda 関数は、Amazon Bedrock AgentCore の機能である AgentCore Gateway の Model Context Protocol (MCP) インターフェースを通じて、エージェント互換のツールになります。
- エージェントは Amazon Textract を使用してテキストを抽出し、S3 Vectors のベクトル埋め込みを使用してドキュメントを分類し、Aurora DSQL のビジネスルールに照らしてデータを検証します。
- エージェントは MCP サーバーを通じてエンタープライズデータにアクセスし、抽出したコンテンツをビジネスルールに照らして検証します。
- ステータスの監視や問題のトラブルシューティングは、 Amazon Elastic Container Service (Amazon ECS) 上でホストされているチャット対応ダッシュボードから行えます。
- エージェントのパフォーマンスの可視化は、Amazon Bedrock AgentCore の機能である AgentCore Observability と、 Amazon CloudWatch のテレメトリーを通じて行えます。
ソリューションのデプロイ
以下の手順に従って、ソリューションのインフラストラクチャと Web UI を AWS アカウントにデプロイします。
前提条件
このソリューションをデプロイするには、以下が必要です:
- AWS アカウント Amazon Nova および Anthropic (Claude) モデルが有効化された.
- Amazon Bedrock へのアクセス。AWS リージョンごとのモデルの可用性については、 Amazon Bedrock での AWS リージョン別サポートモデル を参照してください。.
- Amazon Bedrock AgentCore(Runtime、Gateway、Identity)、S3 Vectors、および Amazon Aurora DSQL へのアクセス。 での Amazon Bedrock AgentCore (Runtime、Gateway、Identity)、S3 Vectors、Amazon Aurora DSQL へのアクセス。.
- インストール済みの AWS Cloud Development Kit (AWS CDK) v2。
- インストールされ実行中の Docker (コンテナイメージのビルドとデプロイに必要)。
- Python 3.11+ および Node.js 18+。
- S3 バケット、Lambda 関数、DynamoDB テーブル、Cognito ユーザープール、Amazon Elastic Container Registry (Amazon ECR) リポジトリ、Amazon ECS サービスを作成するための AWS Identity and Access Management S3 バケット、Lambda 関数、DynamoDB テーブル、Cognito ユーザープール、Amazon Elastic Container Registry(Amazon ECR)リポジトリ、および Amazon ECS サービスを作成するための (IAM) 権限。
- リポジトリ をクローンします 環境をセットアップします:
git clone https://github.com/aws-samples/agenticidp-guidance.git cd agenticidp-guidance uv venv source .venv/bin/activate uv pip install -r requirements.txt cd ui/orchestrator npm install cd ../.. - スタックをデプロイします:
uv run deploy.py --admin-email your-email@example.com
このコマンドは6つをデプロイします AWS CloudFormation stacks: コア (S3、Cognito、DynamoDB)、ゲートウェイ (Lambdaツール、AgentCore Gateway)、Aurora (Amazon Aurora DSQL)、エージェント (AgentCoreランタイム、コンテナ)、UIオーケストレーター (APIエンドポイント)、そしてモダンUI (Reactアプリを搭載) Amazon CloudFront)。デプロイには約15〜20分かかります。
- 各スタックが以下のように表示されることを確認してデプロイメントを検証します
CREATE_COMPLETECloudFormation コンソールで。
ファイルを処理して結果を確認する
デプロイ後、CloudFrontのURL、ユーザー名、および一時パスワードを記載したメールが届きます。
ドキュメントを処理する
- Web UIにサインインして、選択します プロセス文書.
- 次からのサンプル発注書をアップロードしてください。
infrastructure/sample_data/purchase_orders/training/. - 文書がエージェントのワークフローに入ります:
- Analyzerエージェントはテキストを抽出し、送信者とドキュメントの種類を識別します。
- Matcherエージェントはベクトルストア内で類似ドキュメントを検索します。
- 新しいドキュメントタイプの場合、トレーニングワークフローは抽出指示を生成し、データを抽出して検証した後、その指示を将来の利用のために保存します。
- 既知のドキュメントタイプの場合、自動化ワークフローは既存の指示を使用してデータを抽出し、検証します。
- レビューの結果は次のとおりです。 ジョブと手順の確認 抽出データ、検証結果、生成された指示を確認するタブです。
例: 新しいドキュメントタイプ(トレーニングワークフロー)
新しい小売業者である Two Wheel Store からの最初の発注書をアップロードしたとします。Matcher エージェントはベクトルストアを検索し、類似するドキュメントが見つからないため、そのジョブをトレーニングワークフローに振り分けます。
Analyzer エージェントは Amazon Textract を使用してドキュメントの生テキストを抽出します:
# PURCHASE ORDER
FROM: Two Wheel Store
Order #: PO-2026-0102-2584
Date: 2026-01-02

## Items Ordered
AC-021  Advanced Computer     Qty: 1   $75.61
        Colors: cr4321        @ $75.61
...
SB-004  Folding Classic       Qty: 8   $9634.32
        Colors: cb8901 I Sizes: S     @ $1204.29

TOTAL: $14931.54
Instructionsエージェントがスキーマから抽出プロンプトを生成し、Extractorエージェントが構造化されたJSONを生成します:
{
  "po_number": "PO-2026-0102-2584",
  "retailer_name": "Two Wheel Store",
  "order_date": "2026-01-02T00:00:00Z",
  "line_items": [
    { "sku": "AC-021", "product_name": "Advanced Computer", "quantity": 1, "unit_price": 75.61, "line_total": 75.61 },
    { "sku": "SB-004", "product_name": "Folding Classic",   "quantity": 8, "unit_price": 1204.29, "line_total": 9634.32 }
  ],
  "order_total": 14931.54
}
Validatorエージェントは、スキーマに照らして結果を検証します。 失敗する:
validation_status: INVALID
error: 'SB-004' does not match '^AB-[A-Z]{2}-\d{3}$'ベンダーのSKU形式(SB-004)はAcme Bikesの内部フォーマット(AB-SB-004)。Instructions Fixer エージェントはこの不一致を診断し、抽出プロンプトに明示的な SKU 変換ルールを追加します。ベンダーの SKU の前に接頭辞を付ける AB-。2回目のパスでは、7つの項目が正常に検証され、Save Instructionsエージェントが洗練されたプロンプトをベクターストアに保存します。この最初の実行のエンドツーエンドの所要時間:3分49秒。
例: 既知のドキュメントタイプ(オートメーションワークフロー)
Two Wheel Storeから2回目の発注書が届くと、Matcherエージェントは1回目の実行で保存された指示を信頼度スコア3.946(しきい値:3.7)で検出し、そのジョブを自動化ワークフローに振り分けます:
- Extractor エージェントは保存された指示を直接適用するため、オーケストレーターはプロンプト生成を省略します。トレーニング中に学習された SKU 変換ルールは自動的に適用されます(
EL-002→AB-EL-002,HB-071→AB-HB-071,PD-002→AB-PD-002). - 3つの明細項目は最初のパスで検証を通過し、注文合計は$5,979.19となりました。
- エンドツーエンドの処理は1分30秒で完了し、初回実行時の3分49秒から短縮されました。
インタラクティブチャットを使う
ダッシュボードには、トラブルシューティング用のチャットインターフェースが含まれています:
- 質問
what tools do you have利用可能なエージェントの機能を確認してください。 - 質問する
list instructions保存された抽出指示を表示します。 - 質問
what is the status of job XXXX処理の進行状況を確認します。 - 質問する
what went wrong with job XXXX, how can we update the instructions?障害を診断します。
精度が時間とともにどのように向上するかを理解する
このシステムは2つのフィードバックループを通じて時間とともに向上します:
- 訓練ループ: 検証失敗後にInstructions Fixerエージェントが抽出プロンプトを改善する際、改善された指示は保存され、類似のドキュメントに再利用されます。
- 処理ループ: Troubleshooterエージェントが抽出エラーを修正する際、ドキュメント形式のばらつきにおけるパターンの特定に役立つ詳細な分析が提供されます。
モデルを変更する際は、 AgentCore Evaluations(Amazon Bedrock AgentCore の機能の 1 つ)を使用して、抽出品質が許容範囲に留まっていることを確認します。このソリューションはすでに AgentCore Observability を使用しているため、必要な計測機能は備わっています。
推定コスト
このソリューションはアイドルコストのないサーバーレスおよびオンデマンドのリソース上で動作するため、使用した分だけ支払います。米国東部(バージニア北部)リージョンで毎月 10 件のトレーニングドキュメントと 1,000 件の処理済みドキュメントというワークロードの場合、推定コストは月額約 $58 です。Amazon Bedrock を経由する基盤モデル(FM)の推論が総コストの約 85 パーセントを占め、ドキュメントあたり約 $0.055 です。実際のコストは、各エージェントに割り当てられたモデルに大きく依存します。モデルの選択は agents/orchestratorgraph/utils/config.pyで一元管理されているため、単純なタスクには低コストのモデルを、必要な場所にはより強力なモデルを使用できます。詳細な料金については、 Amazon Bedrock の料金 ページを参照してください。
ユースケースに合わせてソリューションをカスタマイズする
合成自転車企業のデータセット、事前構築済みの JSON スキーマ、モック ERP データベース内の製品およびベンダーレコードに対して抽出データを検証する Lambda 検証関数を備えた発注書処理のユースケースが提供されます。独自のドキュメントを処理するには、含まれているスキーマと検証ロジックを独自のものに置き換える必要があります。
ドキュメントスキーマを定義する
ドキュメントタイプごとに抽出するフィールドを定義する JSON スキーマを作成します。 agents/orchestratorgraph/doc_schema/purchase_order_schema.json のサンプル発注書スキーマが参考になります。スキーマには、フィールド名、データ型、および各フィールドがドキュメントに明示的に記載されているものか、文脈から推論されるものかを指定する必要があります。
検証プロセスを構築する
含まれているバリデータは、Aurora DSQL 内の合成ベンダーテーブルおよび製品テーブルに対して発注書データを検証します。本番環境での実装には、ビジネスルールに合わせた検証プロセスが必要です。例:
- 請求書バリデータは、ベンダー ID を買掛金システムと照合し、明細項目の合計が請求書合計と一致することを確認することがあります。
- 契約書バリデータは、ドキュメントに必要な条項が含まれていること、および日付と当事者名が記録と一致することを確認することがあります。
- クレームバリデーターは、保険証券番号、補償限度額、および請求者情報を、お客様のポリシー管理システムと照合してチェックできます。
新しいバリデーターを追加するには、抽出されたJSONを受け取り、詳細なエラーメッセージ付きの合否結果を返すLambda関数を作成し、それをAgentCore Gatewayにツールとして登録します。実装パターンについては、 gateway/tools/po_validator_tool/ を参照してください。
エージェントプロンプトの更新
のエージェントプロンプトは、 agents/orchestratorgraph/prompts/ 発注書の用語を参照しています。これらのプロンプトを、お客様のドキュメントタイプと抽出要件に合わせて更新してください。Orchestratorエージェント、Validatorエージェント、およびInstructionsエージェントのそれぞれに、ドキュメントタイプ固有の文言が含まれているため、適宜調整してください。
ベストプラクティス
アジェンティックIDPシステムのトレーニングと運用を行う際には、以下の推奨事項を念頭に置いてください。
- 代表的なサンプルから始める: トレーニング中にドキュメントタイプごとに5~10件のドキュメントをアップロードし、フォーマットのバリエーションを含むエッジケースも取り入れて、信頼性の高い抽出命令を構築します。
- ビジネスルールによるバリデーションを使用する: バリデーターをAurora DSQL内の参照データ(ベンダーリスト、製品カタログなど)に接続し、抽出エラーを早期に検出します。
- エージェントのパフォーマンスを監視する: AgentCore ObservabilityとCloudWatchを使用して実行パスを追跡し、ボトルネックを特定し、時間の経過に伴う抽出精度を測定します。
- ドキュメントタイプを段階的に追加する: 新しいドキュメントタイプごとにJSONスキーマと対応するバリデーションLambda関数を作成します。残りの処理はエージェントが担当します。
- 本番環境向けにガードレールを追加する: Amazon Bedrock Guardrailsを適用して、エージェントの出力に対するコンテンツフィルタリングとグラウンディングチェックを実施します。保険請求やローン申請など、機密性の高いドキュメントタイプを処理する場合には、これが特に重要です。
- OWASP Top 10 for LLMsを確認する: 大規模言語モデル(LLM)を使用するアプリケーションを構築する際のセキュリティ上の考慮事項については、 OWASP Top 10 for LLMs and Generative AI Apps を参照してください。
クリーンアップ
重要: クリーンアップを実行する前に、保持したいデータをエクスポートしてください。この destroy.py スクリプトは、処理済みドキュメント(S3)、ジョブ履歴(DynamoDB)、バリデーションデータ(Aurora DSQL)、および学習済みの抽出命令(ベクトルストア)を完全に削除します。
継続的な課金を避けるために、デプロイされたリソースを削除します:
uv run destroy.pyコンソール上で、AgenticIDP-Core-Dev、AgenticIDP-Gateway-Dev、AgenticIDP-Aurora-Dev、AgenticIDP-Agent-Dev、AgenticIDP-UIOrchestr-Dev、およびAgenticIDP-ModernUI-Devの6つのCloudFormationスタックが削除されていることを確認します。
まとめ
この記事では、Amazon Bedrock AgentCoreを使用して自己改善型のドキュメント処理システムを構築する方法を学びました。このシステムでは、専門化されたAIエージェントが協働してビジネスドキュメントの分類、抽出、検証、および学習を行います。このアジェンティックなアプローチにより、新しいドキュメントフォーマットに自動的に適応し、フィードバックループを通じて時間とともに精度が向上し、手動のテンプレート設定に代わって自律的な学習が実現されます。
次のステップとして:
- このソリューションの サンプルソリューション そして同梱の発注書サンプルでテストしてください。
- JSON スキーマとバリデーションルールを作成して、独自のドキュメントタイプを追加できます。
- 抽出したデータを ERP、CRM、コンテンツ管理ツールなどの下流システムと統合する方法を確認してください。
この記事で使用されているサービスやパターンについて詳しくは、以下のリソースを参照してください:
- このソリューションで使用されているエージェントフレームワークについて詳しく知るには、次を参照してください Strands Agents SDK: エージェントアーキテクチャとオブザーバビリティに関する技術的深掘り.
- AgentCore Gateway が API をエージェント互換のツールに変換する仕組みを理解するには、次を参照してください Amazon Bedrock AgentCore Gateway の紹介: エンタープライズ AI エージェントツール開発の変革.
- Model Context Protocol の背景と AWS サービスとの統合方法については、次を参照してください Unlocking the power of Model Context Protocol (MCP) on AWS.
- エージェントがセッションをまたいでコンテキストを維持する方法については、次を参照してください Amazon Bedrock AgentCore Memory: Building context-aware agents.
- Amazon Bedrock AgentCore の機能の詳細については、以下を参照してください Amazon Bedrock AgentCore documentation.
ドキュメント処理ソリューションの構築に関する専門的なガイダンスについては、 AWS Professional Services および AWS Partners がお手伝いします。