
vLLM は、大規模言語モデル(LLM)向けのオープンソースの推論・サービングエンジンです。LLMの推論には、入力プロンプトを処理してキー・バリュー(KV)キャッシュを構築するプレフィル(prefill)と、そのキャッシュを使ってトークンを1つずつ生成するデコード(decode)という、性質の異なる2つのフェーズがあります。これらのフェーズは、計算、メモリ、スケーリングの特性がそれぞれ異なります。 プリフィル・デコード(P-D)分離 それぞれ別のエンジンインスタンス上で実行し、各フェーズが独立してスケールし、最適化できるようにします。これにより、負荷がかかった状態でのリソース利用率、スループット、レイテンシを改善できます。ただし、トークン生成を開始する前にプレフィルインスタンスからデコードインスタンスへKVキャッシュを転送する必要があるため、効率的なKV転送がtime-to-first-token(TTFT)の鍵となります。
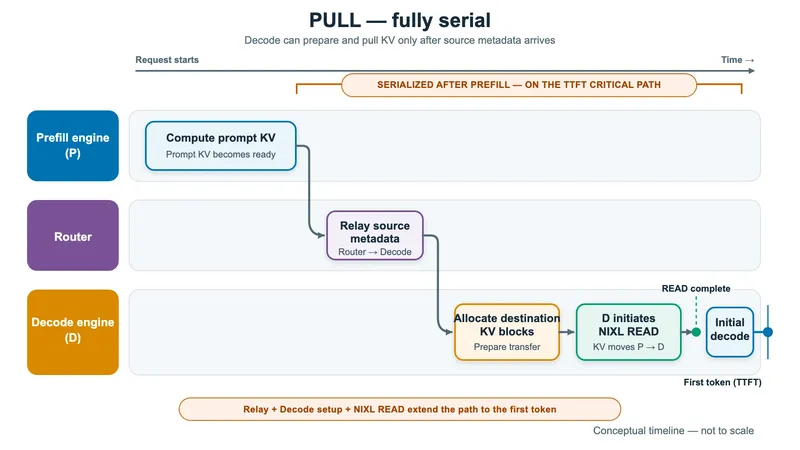
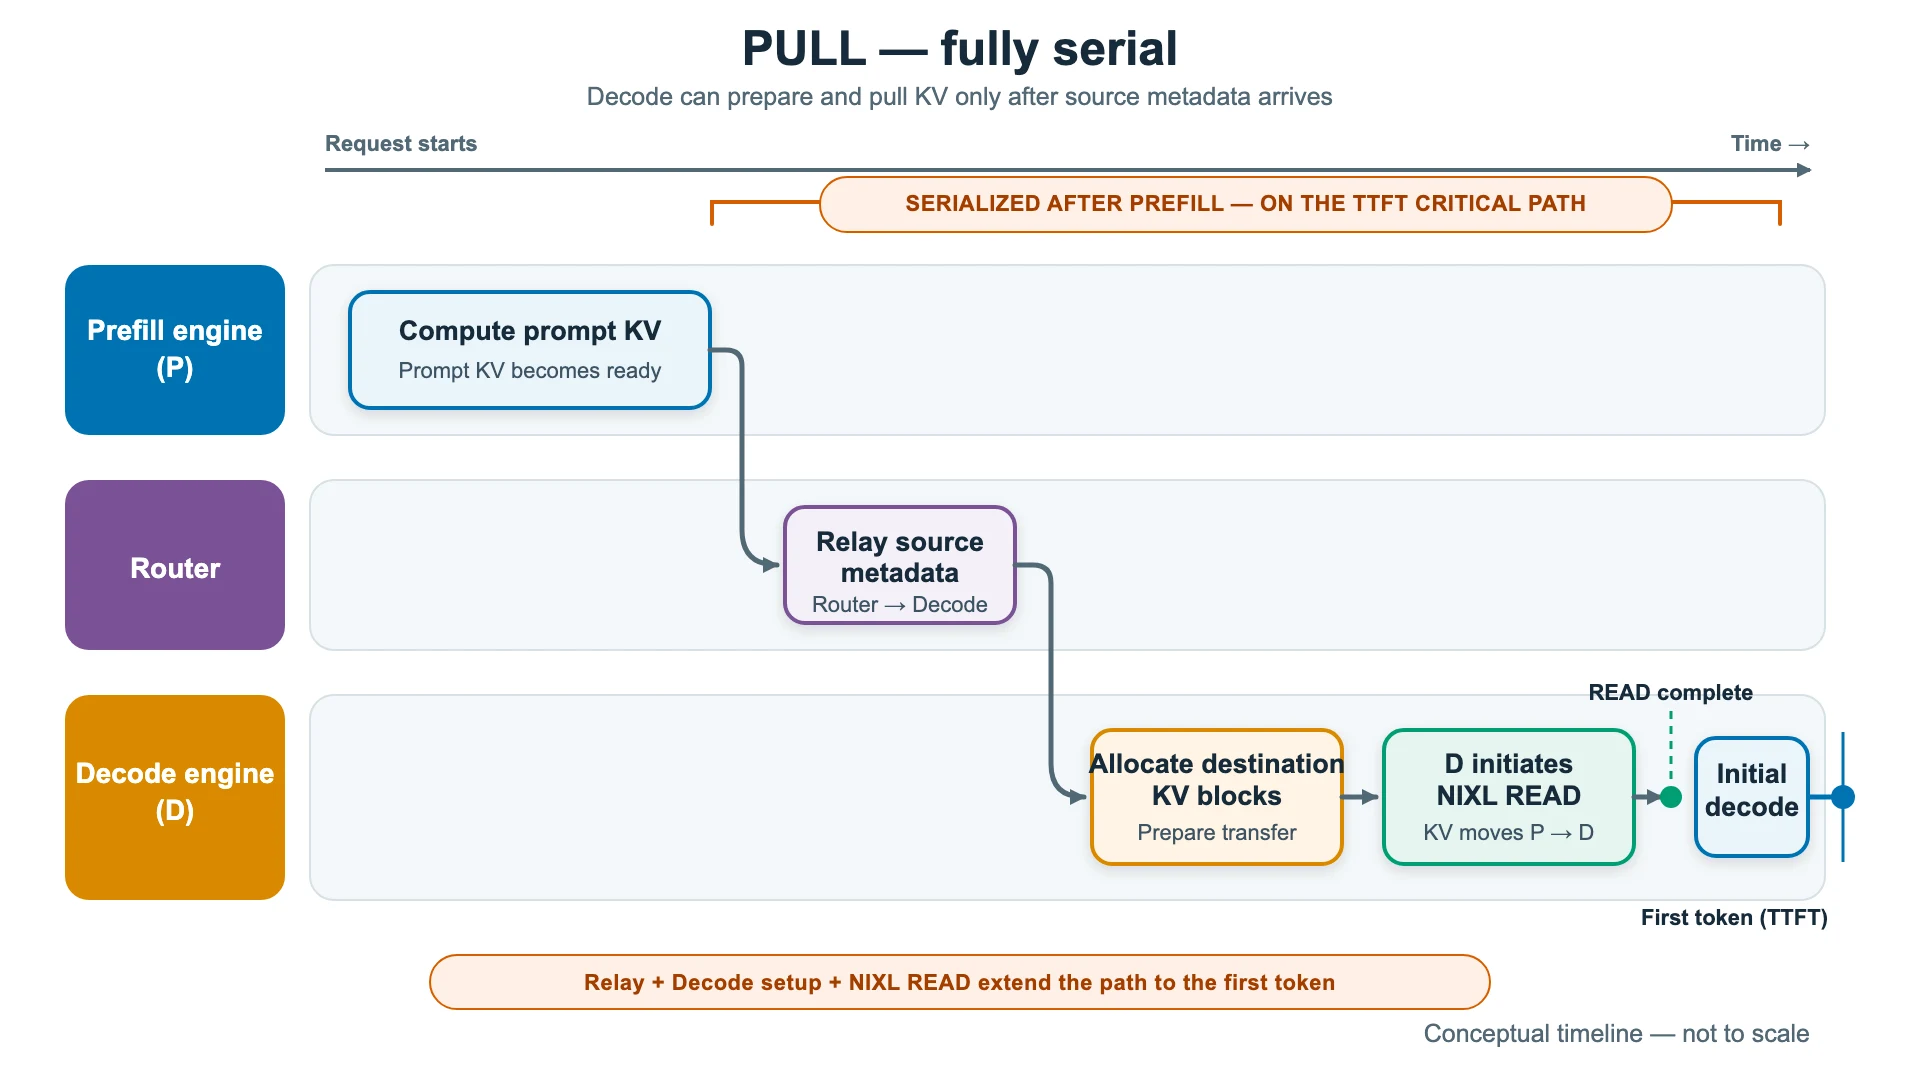
vLLM がこの転送を行う方法の 1 つは、NVIDIA Inference Xfer Library(NIXL)を使用することです。 コネクタ「AWS Elastic Fabric Adapter(のようなRDMA対応インターコネクト上でKVブロックを移動するものであり、AWS EFA(AWSのサーバー間で使用される低レイテンシRDMAネットワーク)。その サポート対象のインスタンスタイプ, AWS EFAはGPUDirect RDMAとNeuron Direct RDMAをサポートしており、NIXLはホストメモリを経由せずにGPUまたはTrainiumデバイスメモリ間でKVブロックを直接転送できます。NIXLコネクタのデフォルトモードは プルベース: プリフェルインスタンスがプロンプトのKVキャッシュの計算を終えると、ルーターはプリフェルブロックIDを含むソースメタデータをデコードインスタンスに中継します。デコードインスタンスはその後、転送先ブロックを割り当て、NIXL転送を準備し、NIXL READを開始してプリフェルインスタンスからKVブロックを取得します。これらの調整およびセットアップのステップは、プリフェルの後、デコードを開始できるようになる前に逐次実行されるため、次のタイムラインに示すようにTTFTのクリティカルパスが延びることになります。
この記事では、 プッシュ型 prefill後の転送の調整とセットアップをクリティカルパスから外して処理するNIXLコネクタ。vLLMで分離型のprefill/decode推論を実行する顧客にとって、これによりTTFTとTPOTが削減され、特に高リクエストレート時にアプリケーションの応答性が向上する可能性があります。
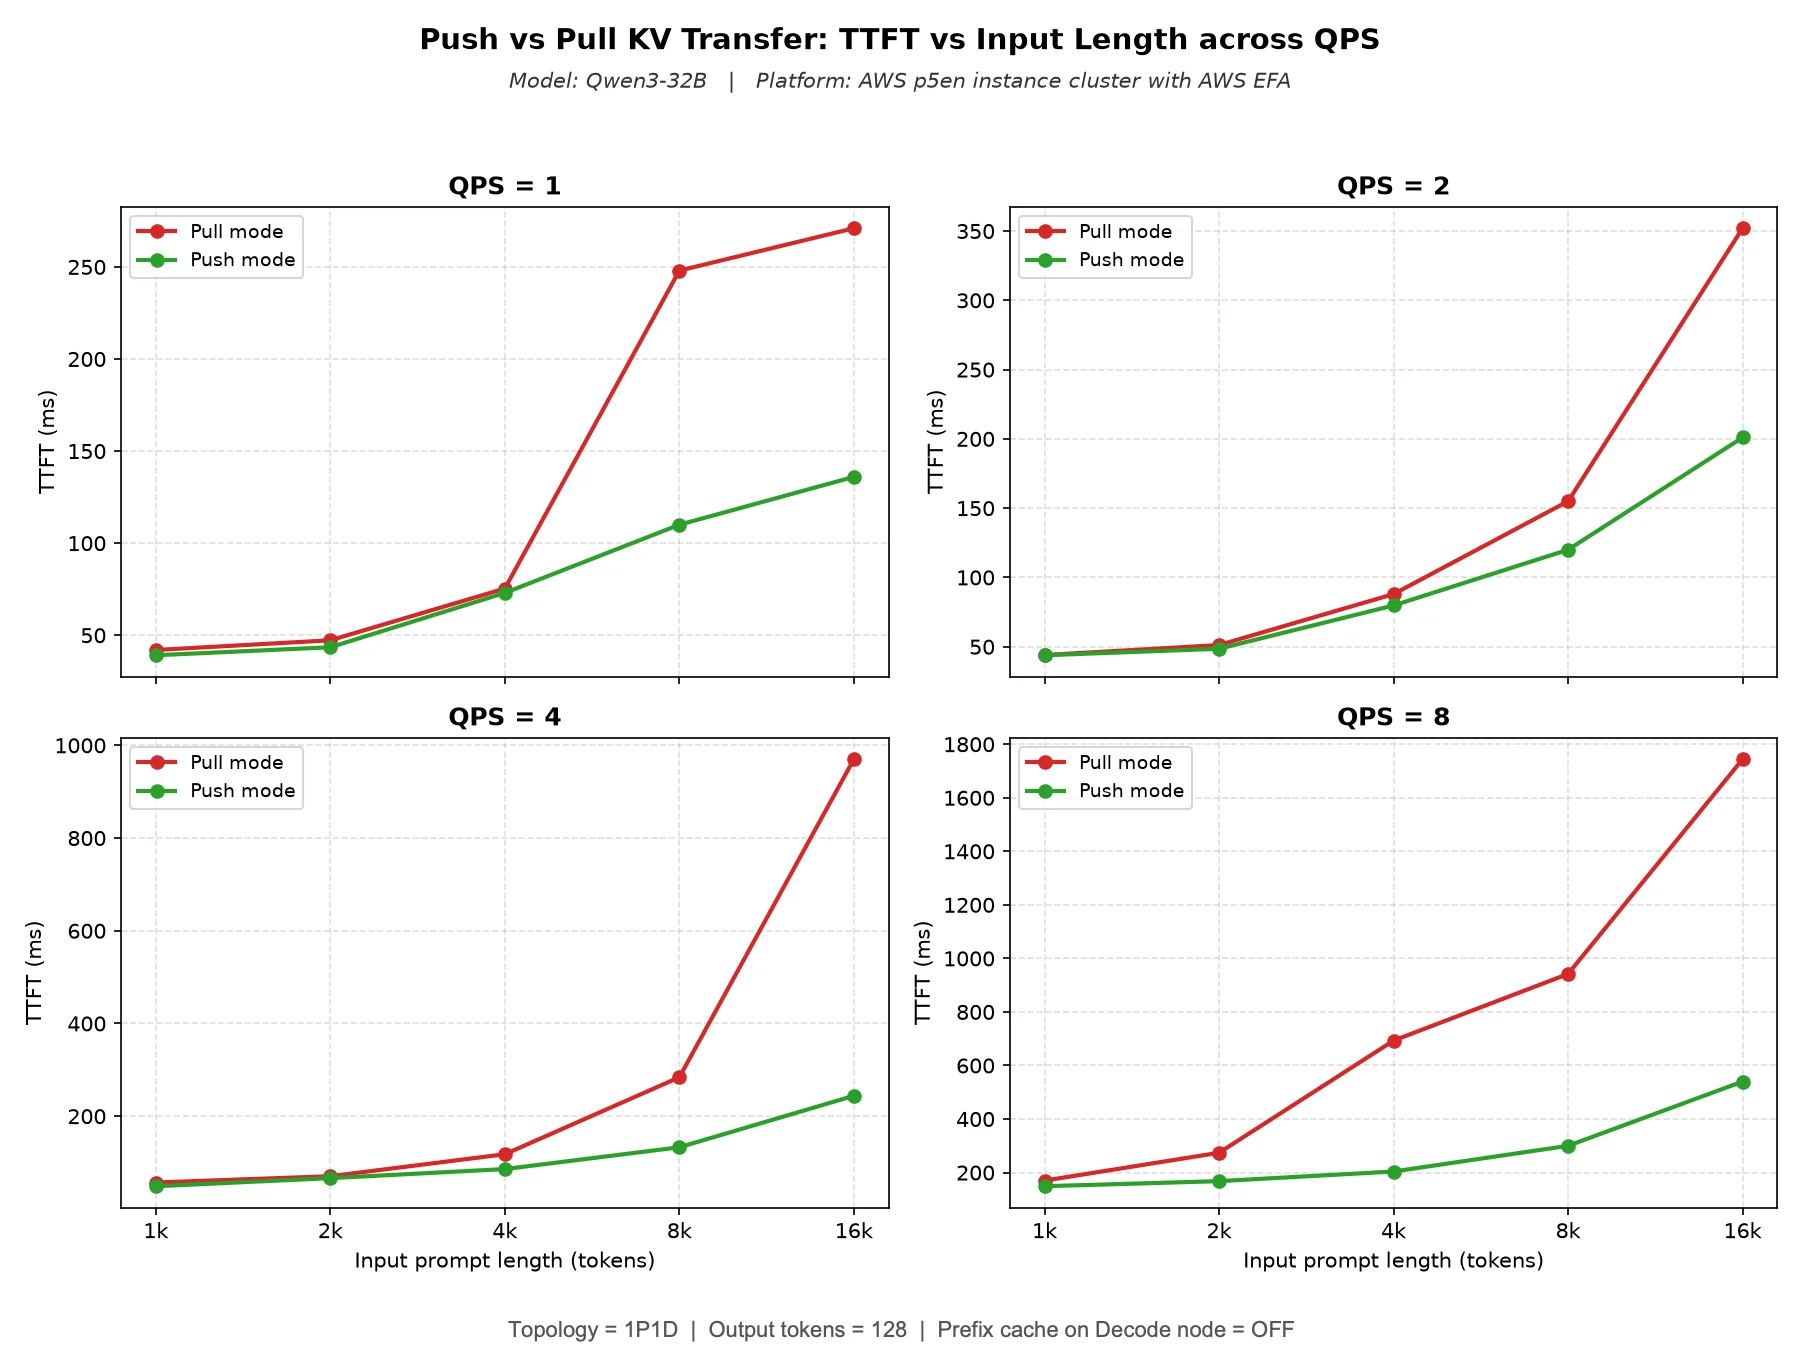
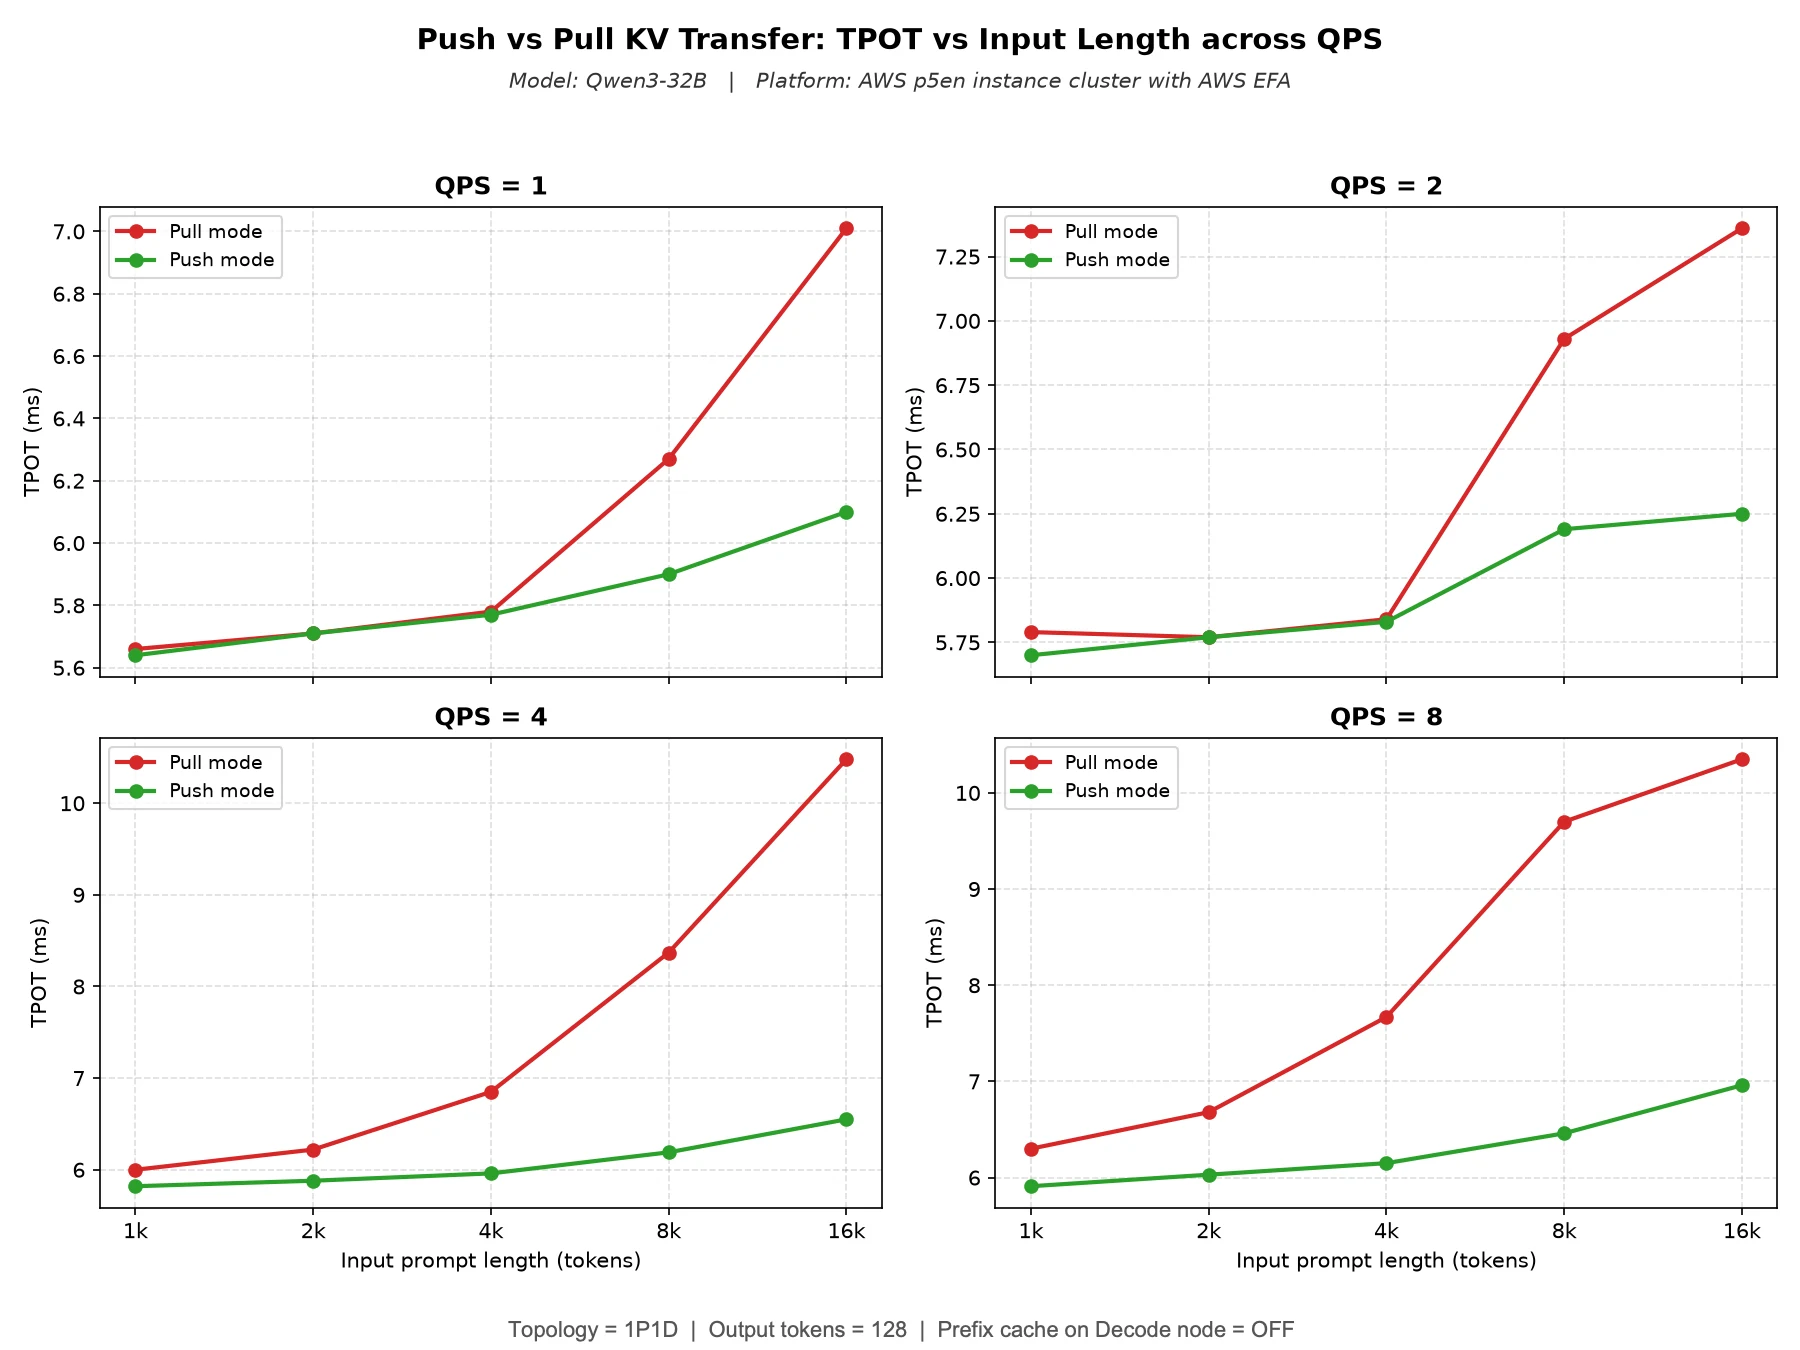
EFAで接続されたAmazon EC2 P5enインスタンスを用いた1P1Dデプロイメントのベンチマークでは、プッシュモードはプルモードと比較して、TTFTで最大3倍、出力トークンあたりの時間(TPOT)で最大30%の改善を示しました(「 パフォーマンスデータ Qwen3-32Bモデル向けのセクション)。結果はワークロードおよび構成に依存します。
私たちはこの機能を、EFAで接続されたAWS Trainiumインスタンスクラスタ上で構築・検証し、その後、アクセラレータに依存しない機能としてvLLMにコントリビュートしました。ここに示す結果は、EFAを備えたAWS p5en(GPU)クラスタによるもので、この利得がGPUにもそのまま及ぶことを示しています。本投稿では、プッシュベースのアーキテクチャ、転送フロー、スレッディングモデル、パフォーマンス結果、そしてベンチマークを再現する方法について説明します。
プッシュ型KV転送
アーキテクチャの概要
プッシュ型の転送は、次の2つの理由によりTTFTとデコードスループットを向上させます:
- プルモデルのシリアル化を解除します 生産者と消費者の処理をオーバーラップさせることで実現されます。デコードインスタンスは、生産者がまだKVを計算している間に、そのターゲットブロックを事前に登録します。その後、転送は、消費者側で識別子を検出するラウンドトリップを待つのではなく、生産者のブロックが準備でき次第すぐに開始されるため、最初のトークンまでの経路からそのラウンドトリップが取り除かれます。
- 転送セットアップ時間をデコードのタイミングから切り離します。 その仕組み(NIXLディスクリプタの準備と転送の送信)はプレフィル側でバックグラウンドスレッド上で実行されるため、デコードインスタンスはレイテンシが重要となるトークン生成フェーズの間にそのサイクルを消費せずに済みます。
正味の効果として、デコードインスタンス上でTTFTが低減され、出力トークンのスループットが向上します。
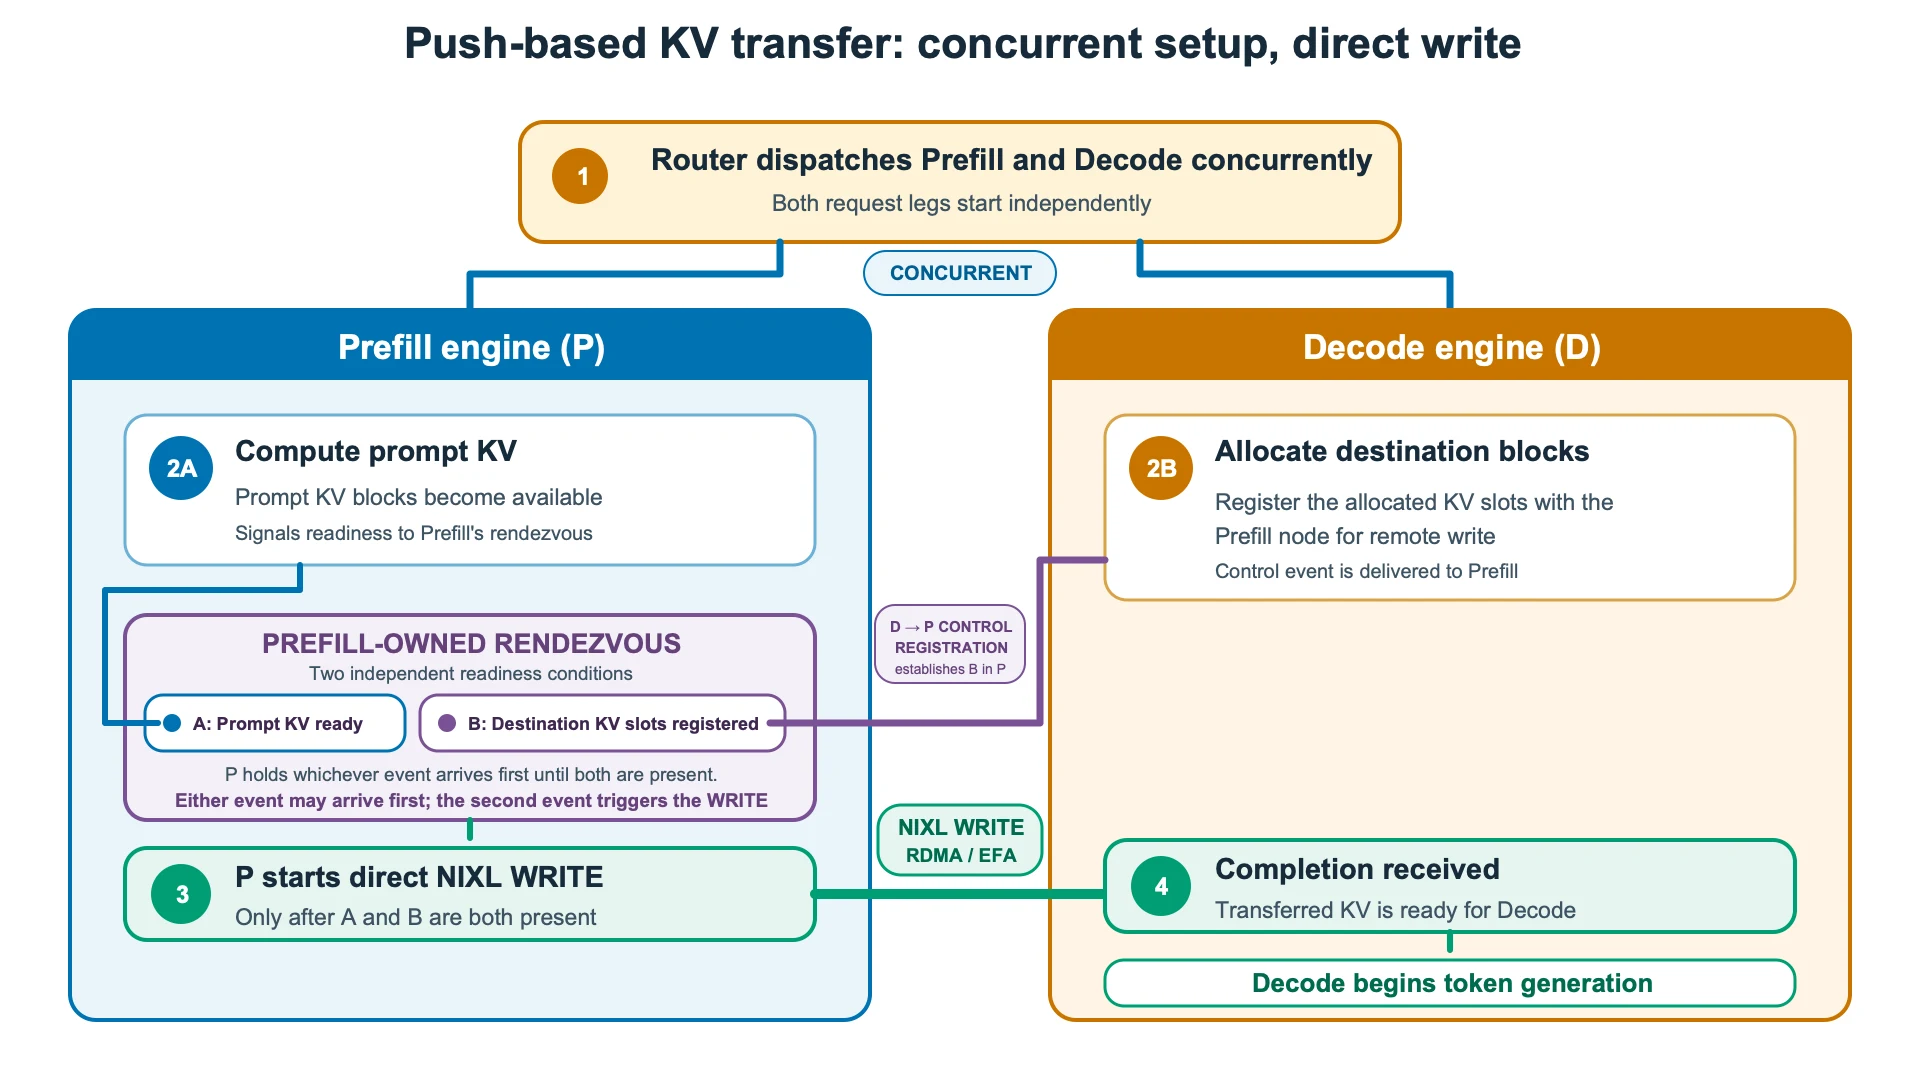
プッシュ型コネクタは3つの主体を協調させます。あらかじめ対象ブロックを登録するデコードインスタンス、各リクエストをマッチングして転送を発行するプリフィルインスタンス、そしてKV書き込みをエンジンのフォワードパスループから切り離して担う専用のバックグラウンドスレッドです。次の図は、これらの要素がどのように組み合わさるかを示しています。
実装の詳細
このプロトコルには3つの論理ステップがあります。
1. 登録(デコード側)。 リモートプレフィルを必要とするリクエストのためにデコードインスタンスがローカルブロックを割り当てる際、プレフィルインスタンスがどこにKVを書き込むべきかを記述する登録を作成します。これは、自身の識別情報と、直前に確保したブロック位置から構成されます。同一のエンジンステップ内で、ワーカーはこの登録をNIXL通知としてプレフィルインスタンスに送信します。登録は割り当て時に行われるため、コネクタはプレフィルインスタンスがプレフィルを完了する前に宛先ブロックを把握できます。
2. ランデブー(プレフィル側)。 デコーダーからの登録と、プロデューサー側でのプレフィルの完了は、どちらの順序で到着してもよく、コネクタは両方に対応します。登録が先に到着した場合、プロデューサーは自身のプレフィルが完了するまでそれを保持します。プレフィルが先に完了した場合、プロデューサーは登録が到着するまでリクエストのブロックを保持します。2番目に発生したイベントが転送を起動します。コネクタは識別子によってリクエストをペアリングし、このマッチングは再発行されたリクエストも考慮するため、横取り(プリエンプト)されたリクエストや再試行されたリクエストも正しく関連付けられます。
3. 転送(プレフィル側)。 リクエストがマッチングされると、プロデューサーはデコードインスタンスへの接続を確立し(まだ存在しない場合)、NIXL WRITEを発行してKVブロックをデコーダーの登録済みメモリへ直接コピーします。各宛先のテンソル並列ランクごとにアドレス指定します。プロデューサーとコンシューマーは異なる内部ブロックレイアウトを使用しても構いません。各側は転送時にブロック位置を自身の物理レイアウトにマッピングするため、両側で異なるブロックサイズを許容できます。各WRITEは完了通知を伴い、NIXLはデータが到着した時点でその完了通知をデコードインスタンスに配信します。デコーダーはこれらの通知をカウントします(書き込みを行うプロデューサーの各ランクにつき1つ)。期待されるすべての通知が到着した後にのみKVを受領済みとみなし、その時点でリクエストはデコードへ進みます。
スレッドモデル
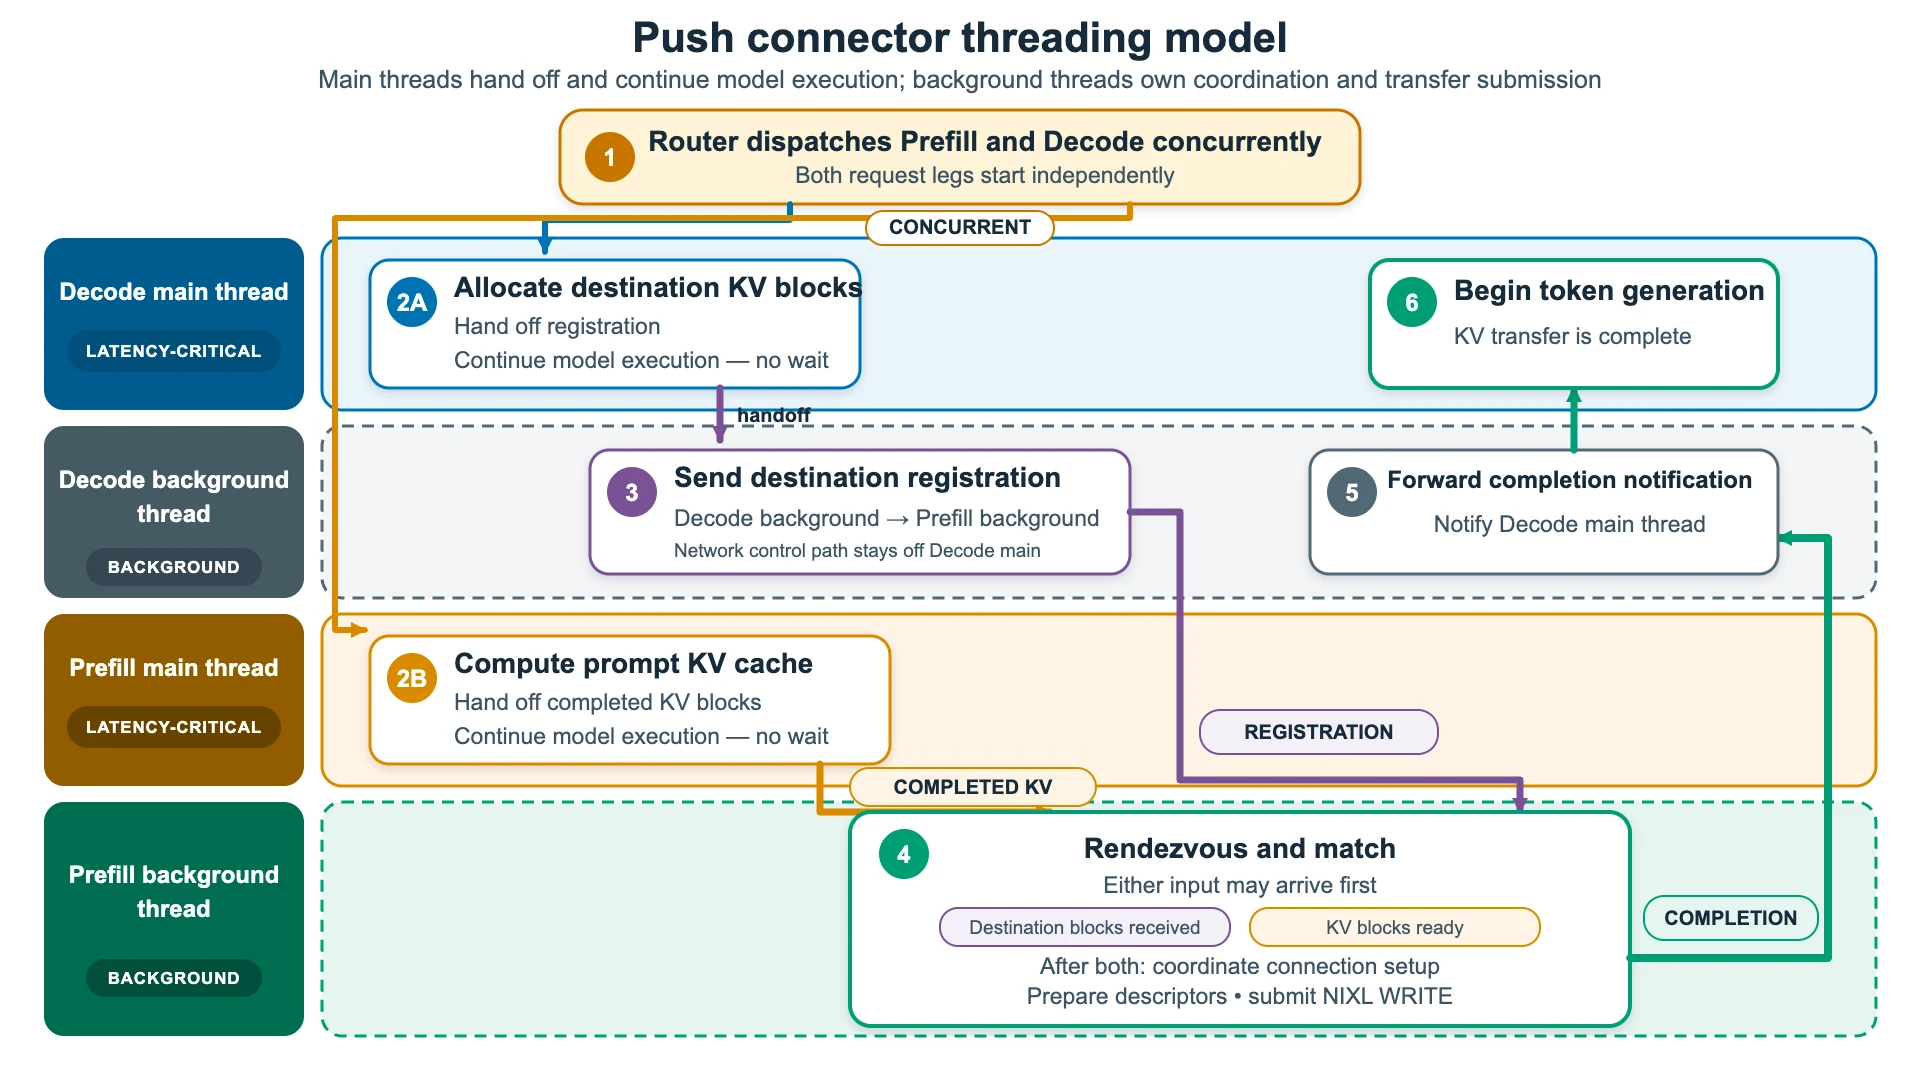
プッシュコネクタは、各プレフィルワーカーに専用のバックグラウンド転送スレッドを使用することで、モデル実行をKV転送の準備から分離します。リクエストの開始時に、デコードのメインループは宛先KVブロックを割り当ててプレフィルインスタンスに登録し、一方プレフィルのメインループはプロンプトKVキャッシュを計算します。宛先登録とプロンプトKVの両方が準備できると、プレフィルのメインループはKVブロックをバックグラウンドスレッドに引き渡し、すぐにモデル実行へ戻ります。
バックグラウンドスレッドはNIXL接続を確立または再利用し、リクエストのKVブロックIDをメモリディスクリプタにマッピングし、連続するブロックをより大きな転送リージョンに統合し、NIXL WRITEをデコードインスタンスに提出します。NIXLが転送を完了すると、デコードインスタンスに完了通知が送られ、デコードインスタンスはトークン生成を開始します。ディスクリプタの準備と転送の提出をレイテンシが重要なメインループの外に置くことで、このリクエストごとの作業がモデル実行を遅らせることを防ぎます。次の図は、単一のリクエストにおけるこれらのメインループとバックグラウンドスレッド間の引き渡しを示しています。
タイミング比較:プル vs プッシュ
次の図は、前のセクションで説明したプルとプッシュの転送フローをまとめ、TTFTへの影響を示しています。両モードとも同じNIXLとEFA/RDMAのデータパスを使用しますが、プルはプレフィル後にメタデータ中継とデコード側のセットアップを実行するのに対し、プッシュはデコード側のセットアップをプレフィルとオーバーラップさせます。その結果、プッシュはこれらの操作をプレフィル後のクリティカルパスから取り除き、デコードをより早く開始できるようにします。
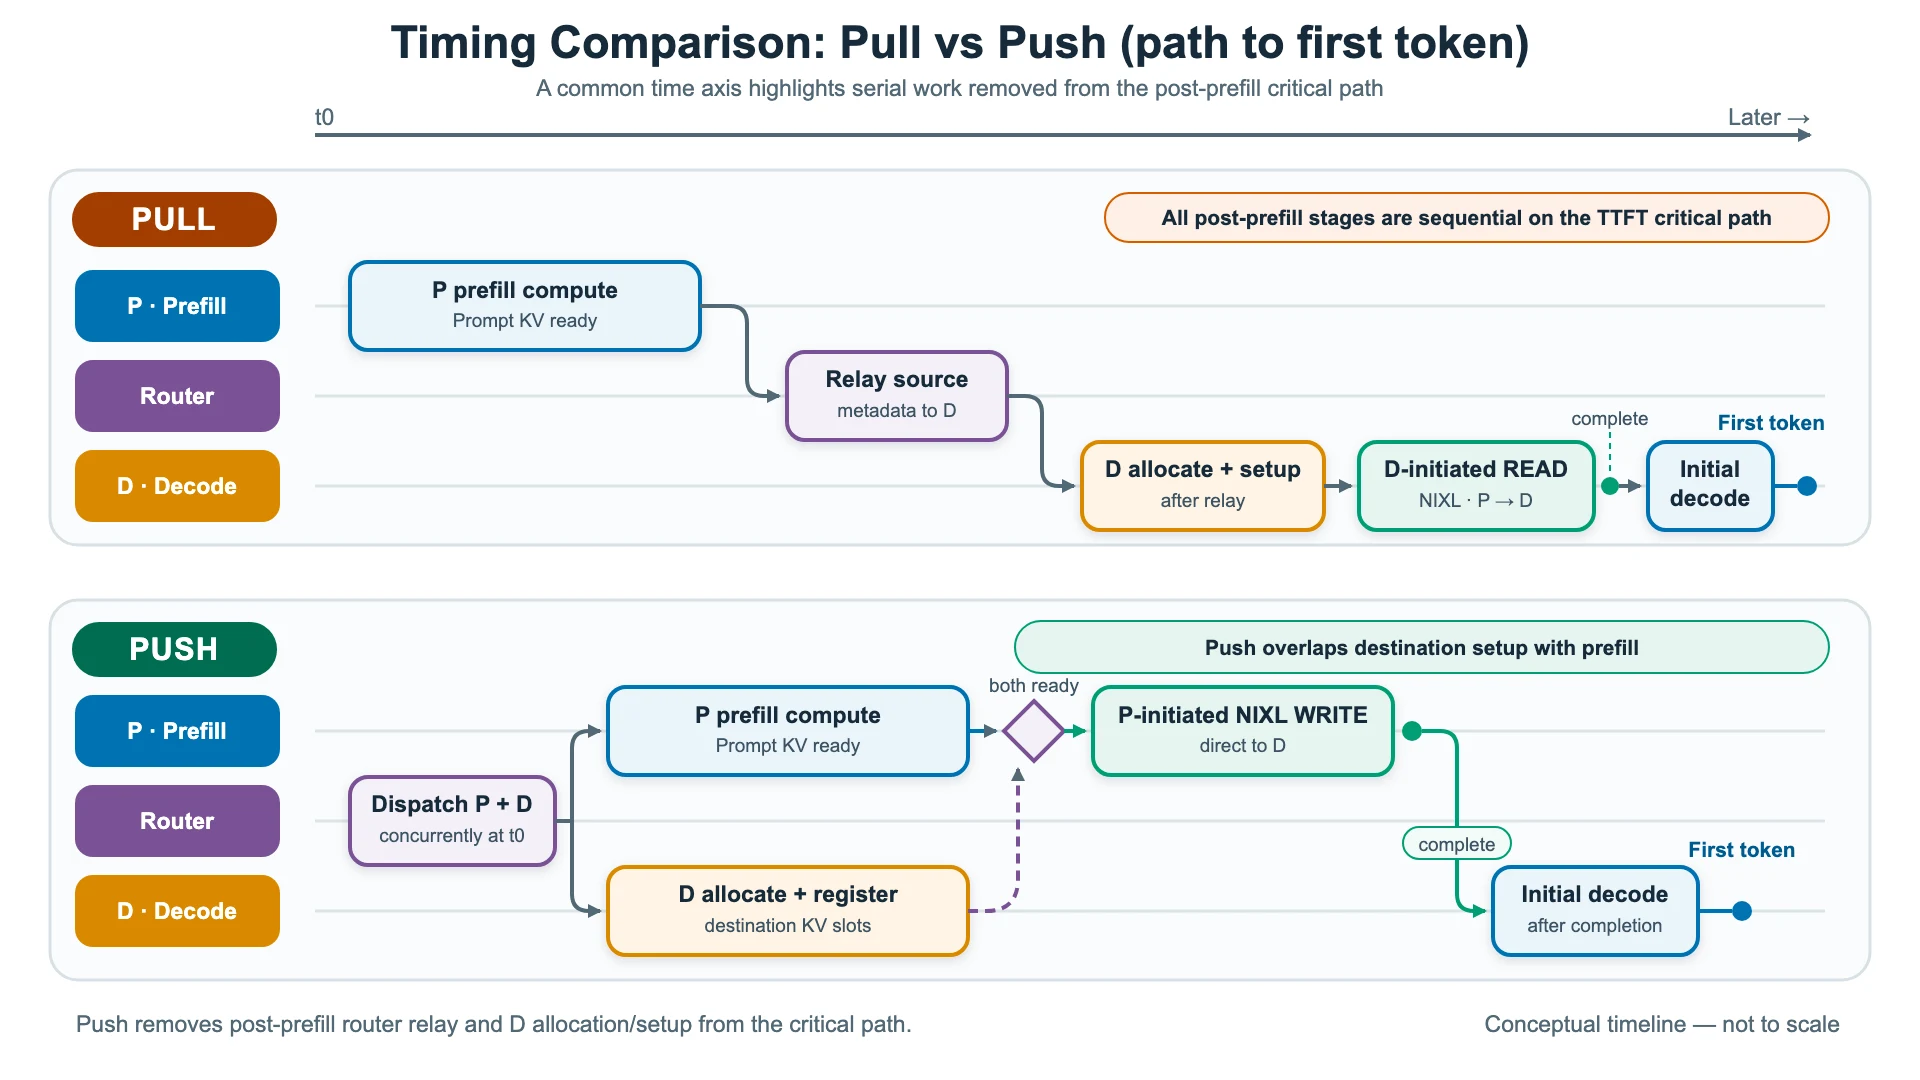
2つのモードにはルーティングのトレードオフもあります。プルモードでは、プレフィル完了後にルーターがデコードインスタンスを選択できるため、負荷認識型ルーティングやサービス品質管理の柔軟性が高まります。プッシュモードはデコード側のセットアップをプレフィルとオーバーラップさせるために、より早くデコードインスタンスを選択します。その見返りとして、同程度の負荷条件下では、プロンプトKVと宛先登録の両方が準備でき次第すぐに転送が開始されるため、プレフィルインスタンスはKVブロックをより早く解放できます。
パフォーマンスデータ
評価には、EFAで接続されたAmazon EC2 P5enインスタンス上の1P1DデプロイメントでQwen3-32Bモデルを使用しました。P→D転送性能を分離するため、ベンチマークを設定して --no-enable-prefix-cachingを指定しプレフィックスキャッシュを無効化しました。この設定により、デコードノードはすべてのリクエストについてプレフィルノードからKVキャッシュ全体を取得します。そうしない場合、重複するプロンプトがデコードノードのローカルキャッシュを再利用して転送をバイパスし、誤解を招く比較結果が生じる可能性があります。
次のチャートは、プッシュとプルのKV転送におけるTTFTを比較したものです。入力長1k〜16k、リクエストレート1〜8 QPSをスイープしました。低負荷かつ短いプロンプトでは、2つのモードはほぼ同一の性能を示します。QPSと入力長が増加するにつれ、プルモードは急激に劣化し、8 QPSかつ16kで約1,744 msに達します。プッシュモードは約540 msとはるかに低く抑えられ、約3xの削減です。この差が生じるのは、プルモードがNIXLディスクリプタをデコードワーカー上でインラインで、エンジンループ内で同期的に発行するためであり、その作業がトークン生成を停滞させます。プッシュモードはこれをバックグラウンドスレッドに移し、クリティカルパスから外します。
このチャートは同じ条件下でのTPOTを示しています。パターンはTTFTと一致しています。軽負荷時はプッシュとプルが近く、約5.6〜5.8 msです。負荷と入力長が増加するにつれ、プルは4〜8 QPSかつ16kで約10.4 msまで上昇しますが、プッシュは7 ms近辺を維持します。その理由は、プッシュがデコードワーカーから記述子の準備と転送サブミットをオフロードするためです。トークン生成が決して飢餓状態にならないため、高同時実行数や長いコンテキストでもトークンあたりのレイテンシは一定に保たれます。
ベンチマークの実行方法
EFAで接続されたAmazon EC2 P5enインスタンスを用いて、1つのプレフィルノードと1つのデコードノードからなる当社の1P1Dベンチマーク構成を再現するには、 Reproducing our results ガイドの詳細な手順を参照してください。このガイドでは、環境設定、vLLMプレフィルサーバーとデコードサーバーの起動、ベンチマークの実行、結果の収集について説明しています。この機能は他のサポートされた構成でも実行できますが、パフォーマンス結果はハードウェア、モデル、ワークロード、およびネットワーク構成によって異なります。
結論
この記事では、プッシュベースのKVコネクタがプレフィル計算をデコード側のブロック割り当ておよび登録とオーバーラップさせ、プレフィル後のルーターの往復とデコード側の転送セットアップをクリティカルパスから取り除く方法を示しました。これにより、特に高いリクエスト率においてTTFTとTPOTが削減されます。EFAで接続されたAmazon EC2 P5enインスタンスを用いた1P1DデプロイでのQwen3-32Bベンチマークでは、プッシュモードはプルモードと比較してTTFTで最大3倍の改善、TPOTで30%の改善を提供しました。結果はワークロードと構成によって異なります。プッシュモードを使用するには、プレフィルサーバーとデコードサーバーの両方を、 NixlPushConnector の代わりに NixlConnector.
を使用するように設定してください。デコードノードの早期選択が許容でき、低いTTFTが優先される場合は、プッシュベースのコネクタを選択してください。プルベースのコネクタは、双方向のKV転送が必要な場合や、ロードアウェアなルーティングのためにデコードインスタンスの選択をプレフィル後まで延期するワークロードには引き続きより適しています。vLLMはプッシュベースとプルベースの両方のKVコネクタをサポートしており、ユーザーは自分のデプロイに最も適したアプローチを選択できます。
今後の改善として、私たちはバックグラウンドのNIXLスレッディングモデルをプルモードのコネクタに導入し、NIXLセットアップをクリティカルパスから外すことで、プルモードのワークロードも同じ最適化の恩恵を受けられるようにすることを検討しています。この検討のためにプルリクエスト(#45211)をオープンしています。
関連リソース
謝辞
この機能の維持へのご支援に対し、vLLMコミュニティに感謝いたします。
付録: 結果の再現
トポロジは、EFAを有効にした2つのp5en GPUノード(プレフィルは :8100、デコードは :8200)と、プロキシとベンチマーククライアントを実行する3つ目のより小さなノードで構成されます。この記事には3つのスクリプトが付属しています: serve_pd.sh はどちらのモードでもどちらの側でも起動し、 run_sweep.sh はスイープを実行し、 cleanup.sh はすべてを破棄します。 plot_push_vs_pull.py は結果のJSONから上記の2つの図を再描画します。
テスト環境
両方のGPUノードは同一の構成でした:
| インスタンスタイプ | p5en.48xlarge (8x NVIDIA H200)、1つはプレフィル用、1つはデコード用 |
| リージョン / AZ | ap-south-1 (ムンバイ)、 ap-south-1b (AZ ID aps1-az3): 同じAZ内の両ノード |
| 配置 | クラスタープレイスメントグループなし。両インスタンスとも対象指定のOn-Demand Capacity Reservationにデフォルトテナンシーで起動 |
| AMI | Ubuntu 24.04 x86_64向けのAWS ParallelCluster 3.14.2公開イメージ、 aws-parallelcluster-3.14.2-ubuntu-2404-lts-hvm-x86_64-202602121713 (ami-0133f195033a4baae in ap-south-1。AMI IDはリージョンごとに異なります)。このイメージにはカーネル 6.14.0-1018-aws、NVIDIAドライバー570、CUDA 12.8が同梱されているため、ドライバー、CUDAツールキット、EFAインストーラーを以下のバージョンにアップグレードしてください。 |
| OS / カーネル | Ubuntu 24.04.4 LTS、 6.14.0-1018-aws |
| NVIDIAドライバー / CUDA | ドライバー 580.126.16 (CUDA 13.0ドライバーAPI)。CUDAツールキットは13.0 |
| EFAインターフェース | インスタンスあたり16個、ネットワークカードごとに1個(カード0〜15、すべてインターフェースタイプ efa)、各200 Gb/sで合計3.2 Tb/s。8個のインターフェースが各NUMAノードに配置され、各GPUはそのうち2個とPCIeスイッチを共有しています。 |
| EFAソフトウェア | EFAインストーラー 1.50.0、EFA カーネルモジュール 3.3.0g, libfabric 2.6.0amzn1.0、rdma-core 64.0amzn0 |
NIXLによるEFAデバイスの選択。 LIBFABRIC バックエンドは、すべての 16 個の EFA デバイスをレールとしてオープンし、 efa 各GPUのKVキャッシュを、そのGPUのPCIeスイッチを共有する2つのレールにのみ登録します。これにより、すべての転送がPCIeローカルに留まります。NIXLやlibfabricのデバイスオーバーライドは設定されておらず、これはデフォルトの選択です。自身のノードで確認するには、サーバーを以下のように起動します NIXL_LOG_LEVEL=DEBUG そして登録行を確認します:
grep -E "Created rail [0-9]+ \(device=|mapped to rail" server.log1. ノードをプロビジョニングする
両方のGPUノードにEFAユーザースペーススタックをインストールし、プロバイダーが存在することを確認します。インストーラーには次を使用しました 1.50.0:
curl -O https://efa-installer.amazonaws.com/aws-efa-installer-1.50.0.tar.gz
tar -xf aws-efa-installer-1.50.0.tar.gz && cd aws-efa-installer
sudo ./efa_installer.sh -y
fi_info --version         # libfabric 2.6.0amzn1.0
fi_info -p efa            # verify the EFA provider is present
2つのGPUノードが相互に到達できなければなりません。対象は次の通りです。 8100/8200 NIXL側チャネル(5600).
2. vLLM と NIXL のインストール
両方のGPUノードで:
python3.12 -m venv ~/vllm_env && source ~/vllm_env/bin/activate
pip install --upgrade pip
pip install vllm==0.29.0      # any build that includes the NIXL push connector
pip install nixl==1.4.1       # NIXL with the libfabric/EFA backend
プロキシノード上で(GPUランタイムは不要):
pip install vllm aiohttp fastapi uvicorn pandas datasets3. モデルをダウンロードする
export HF_HOME=/shared/huggingface     # a large shared volume
hf download Qwen/Qwen3-32B
4. P/Dペアを起動する
実行 serve_pd.sh GPUノードごとに1回。2つのモードの唯一の違いは kv_connector: NixlConnector プル用の、 NixlPushConnector プッシュ用です。ポート、エンジンID、ロール、ランクは変更されません。
# on the prefill node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=prefill MODE=pull ./serve_pd.sh
# on the decode node
PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> ROLE=decode  MODE=pull ./serve_pd.sh
プリフィル側では次のように展開されます:
vllm serve Qwen/Qwen3-32B --served-model-name Qwen --dtype bfloat16 \
  --tensor-parallel-size 8 --max-model-len 32768 --max-num-seqs 8 --port 8100 \
  --kv-transfer-config '{"kv_connector":"NixlConnector","kv_buffer_device":"cuda",
    "kv_role":"kv_producer","engine_id":"prefill-engine-001","kv_rank":0,
    "kv_parallel_size":2,"kv_connector_extra_config":{"backends":["LIBFABRIC"]}}'
デコードサーバーは追加します --no-enable-prefix-caching「, which forces every request to fetch full KV from prefill — exactly what we are measuring.」— キャッシュが有効な場合、重複するプロンプトがデコードノードのローカルキャッシュにヒットして P->D 転送をスキップし、誤解を招く数値が得られる可能性があります。両方を待機してください /health ベンチマークの前にエンドポイントが 200 を返すようにします。
5. スイープを実行する
ベンチマークスクリプトは以下にあります: #57567; 動作モードに一致するプロキシを選択します(disagg_proxy_demo.py プルの場合、 disagg_proxy_pushconnector_demo.py (プッシュ用)であり、それを次の要素で駆動する vllm bench serve.
git clone https://github.com/vllm-project/vllm.git ~/vllm && cd ~/vllm
git fetch origin pull/57567/head:pd-bench && git checkout pd-bench
export VLLM_SRC=~/vllm

VLLM_SRC=~/vllm PREFILL_IP=<PREFILL_IP> DECODE_IP=<DECODE_IP> \
  MODE=pull ./run_sweep.sh
次に両方のサーバーを停止し、ステップ 4 を以下のコマンドで再起動します。 MODE=push 各ノード上で、スイープを次の設定でもう一度実行します: MODE=push「Pushモードではさらに、プリフィルインスタンスのNIXL座標(PREFILL_ENGINE_ID, PREFILL_KV_HOST, PREFILL_SIDE_CHANNEL_PORT, PREFILL_TP_SIZE, PREFILL_PP_SIZE)、プロキシがデコードノードに登録先を伝えられるようにします; run_sweep.sh 上記のデフォルト値を使ってこれらを埋めます。Keep QPS_LIST, INPUT_LENS、そして OUTPUT_LENS 2つの実行間で同一であることを確認し、 PREFILL_TP_SIZE プリフィルサーバーの実際のテンソル並列サイズと一致している必要があります。
results/ 保持する <mode>_qps<q>_in<in>_out<out>_iter<i>.json (加えて .log) には実行ごとの TTFT、ITL、スループット、およびエンドツーエンドのレイテンシが含まれます。図を再描画するには:
python plot_push_vs_pull.py --results-dir ./results --metric ttft
python plot_push_vs_pull.py --results-dir ./results --metric tpot
トラブルシューティング
- 最初のリクエストの直後にサーバーがクラッシュする ——モードがコネクターと一致していません。プルには
NixlConnector; pushが必要NixlPushConnector、PとDの両方において。 Backend 404: model ... does not exist—SERVED_MODEL_NAMEサーバーのものと一致しません--served-model-name(Qwen).- プロキシの準備がタイムアウトしました — 選択したモードのプロキシが以下の下に存在することを確認します
$VLLM_SRC/examples/disaggregated/disaggregated_serving/、およびPとDの双方が/healthreturn 200. - NIXLのハンドシェイクまたは転送エラー 「— EFAを確認する(
fi_info -p efa)、サイドチャネルポート(5600P と D の間で開いており、そのPREFILL_TP_SIZEプリフィルサーバーのテンソル並列サイズと一致します。
クリーンアップ
./cleanup.sh proxy      # on the proxy / benchmark driver node
./cleanup.sh server     # on each GPU node
次に、AWS EC2 ユーザーガイドに従ってインスタンスを終了してください。