
重要なポイント
- 「コンテキストの腐敗(Context rot)」は、長時間稼働するエージェントがモデルが保持できる量を超えるコンテキストを蓄積したときに発生し、精度の低下をもたらします。
- LangChainのオープンソースエージェントハーネスであるDeep Agentsは、コンテキストを移動させるために5つのテクニックを使用します アウト アクティブウィンドウの(削除はせずに)内容を退避させて、コンテキストの劣化を防ぎます。
- Deep Agentsにおけるエージェントの記憶は、ユーザーが管理するストレージ内のプレーンなファイルとして保存されるため、これまで学習した内容を保持したままモデルやプロバイダーを切り替えることができます。
試験前夜に一夜漬けをしたことがあれば、この感覚は分かるでしょう:勉強すればするほど、最初の章の内容がどんどん抜け落ちていくのです。
エージェントにも同じ問題があります。より長いタスクを担うにつれ、取り扱う情報(指示、ツールの結果、ファイルなど)がどんどん増えていき、やがて処理しきれないほど多量になります。 文脈 モデルの に快適に収まるように コンテキストウィンドウモデルが履歴、ノイズ、ツール出力を多く抱え込むほど、その精度と推論能力は低下しがちです。
エージェントエンジニアリングの世界では、これをこう呼びます コンテキストロットこのブログでは、エージェントのコンテキストウィンドウを管理する手法と、Deep Agentsハーネスがミドルウェアと呼ばれる概念を使ってそれらをエージェントの実行に注入する方法について解説します。
コンテキストエンジニアリングの手法を理解する
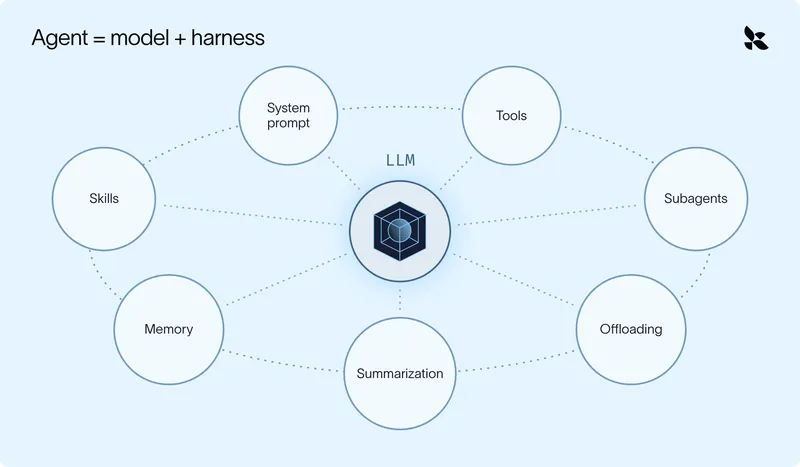
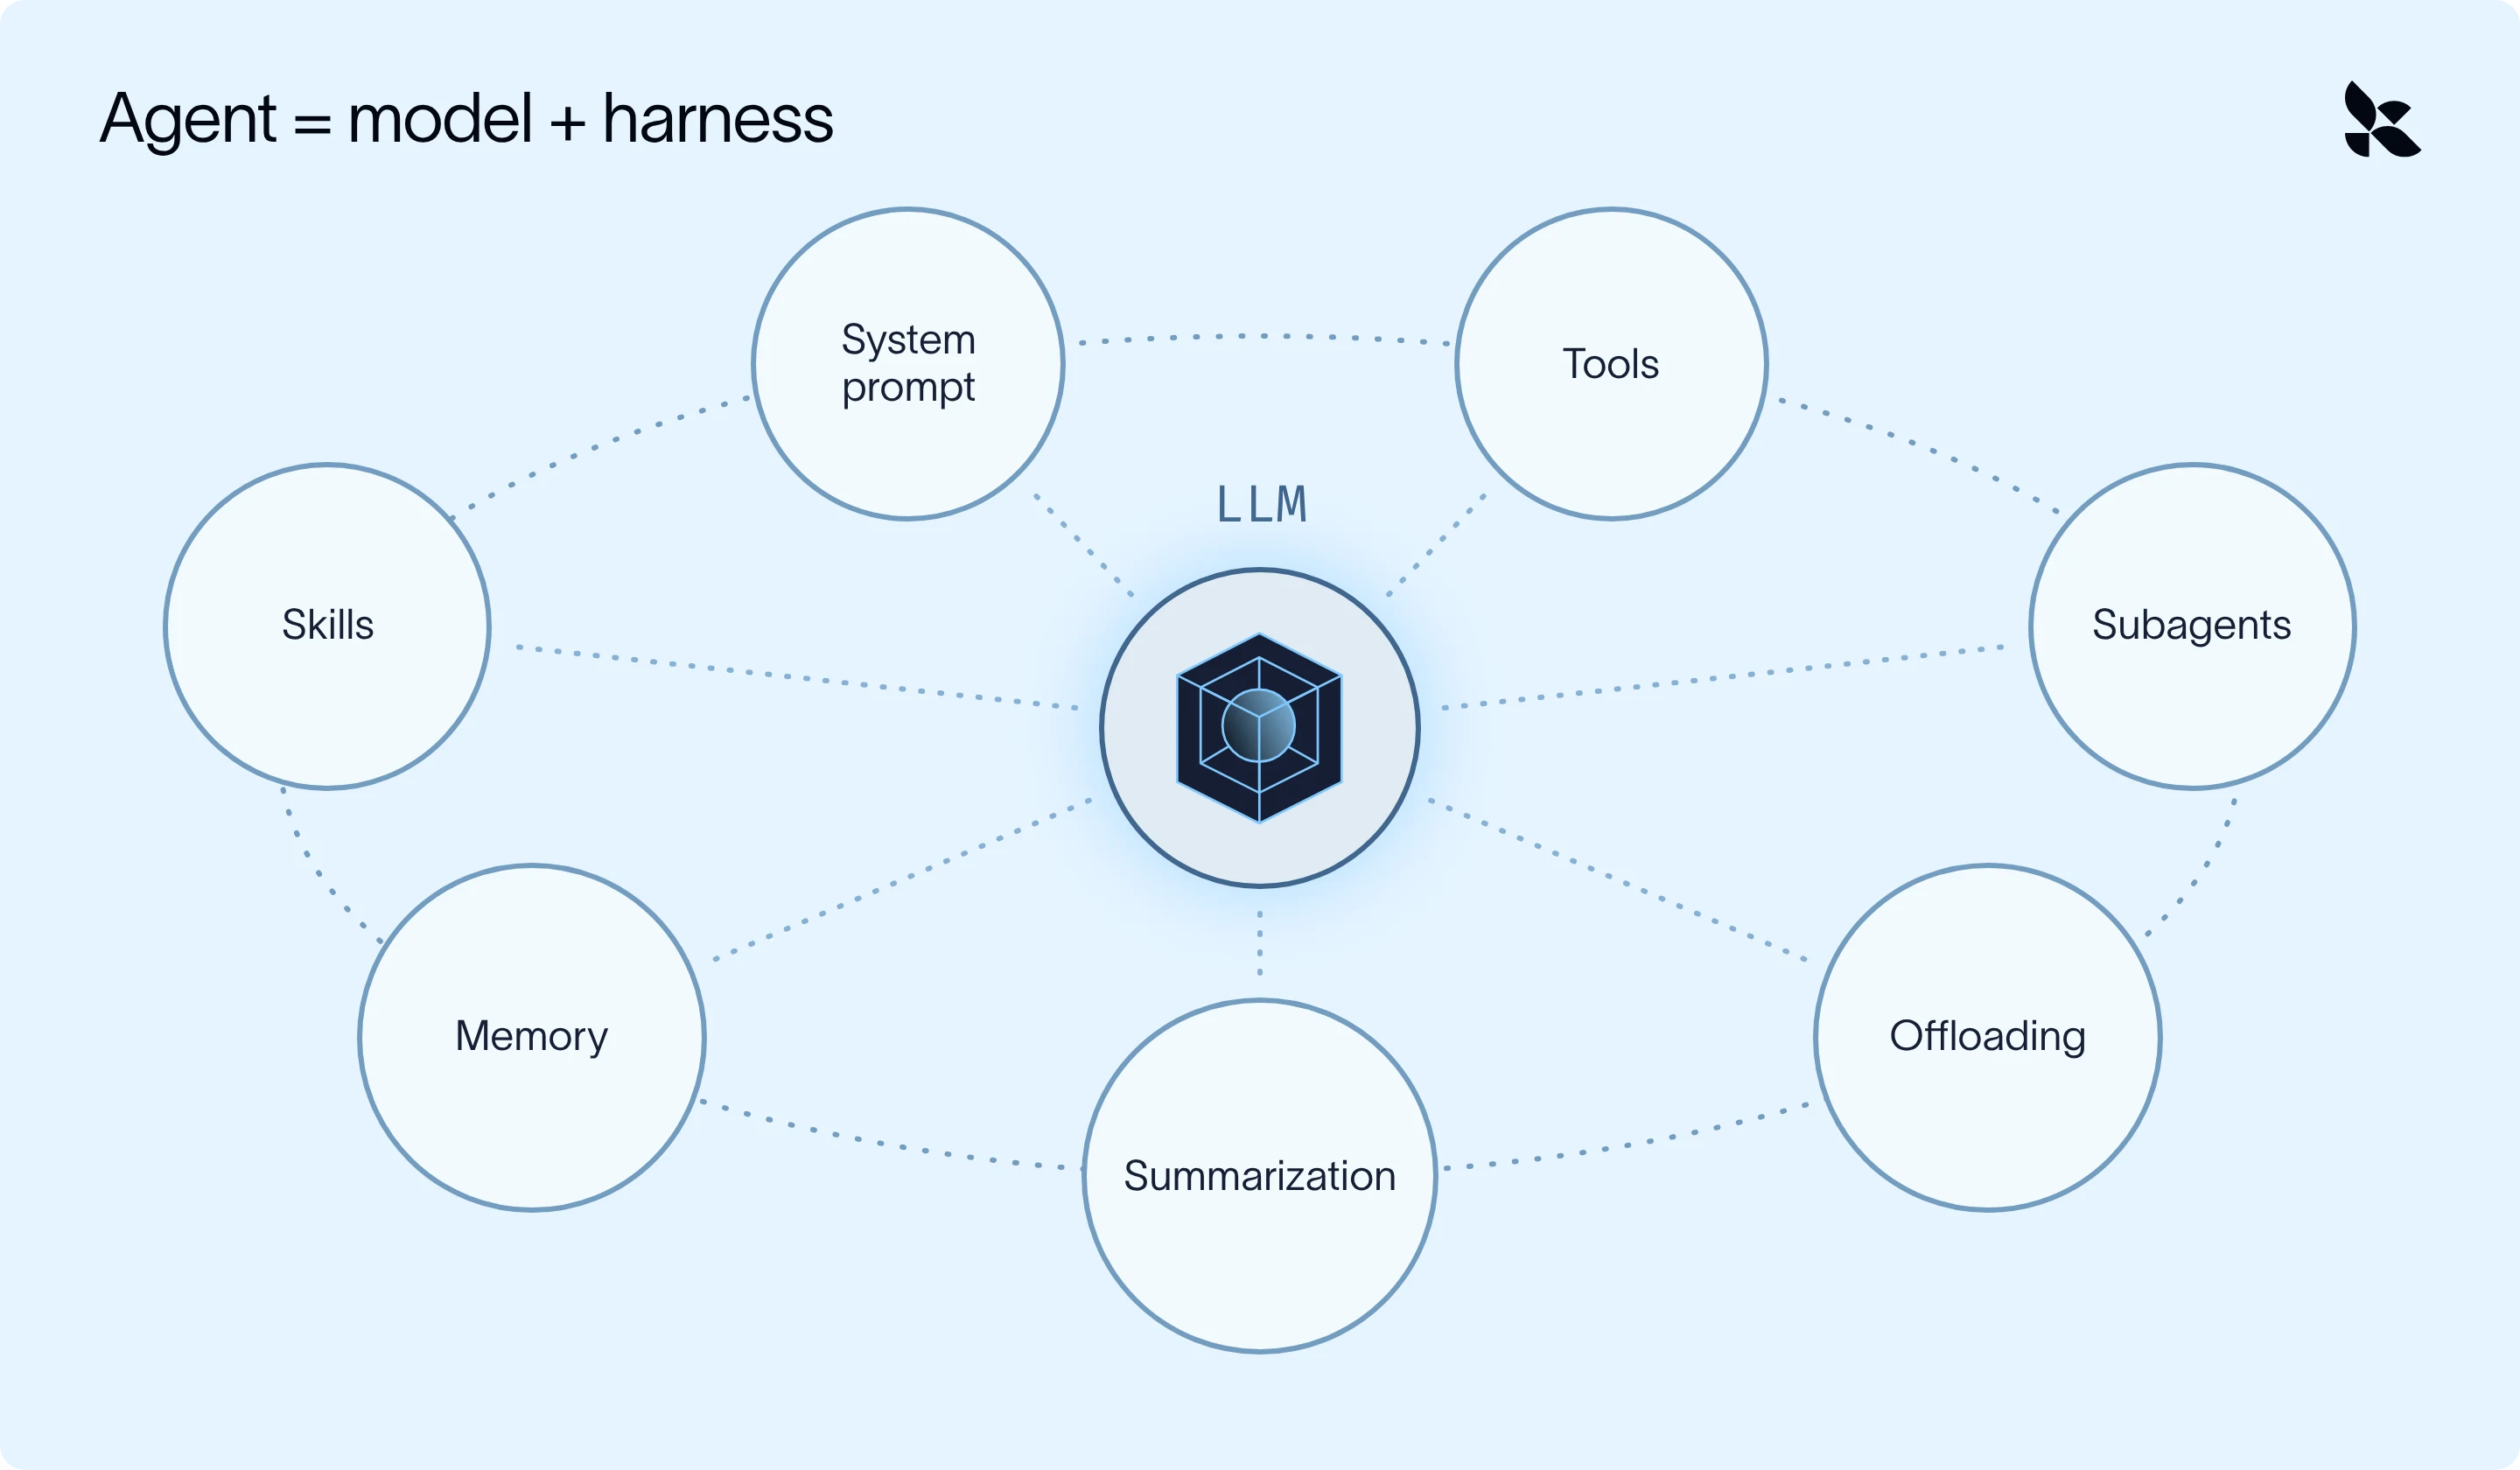
簡単に言えば、エージェントとは、モデルをハーネスで包んだものにすぎません。
コンテキストロートに対処するためにエージェントが利用できるコンテキストエンジニアリングの手法は、主に次の2つのカテゴリに分けられます。
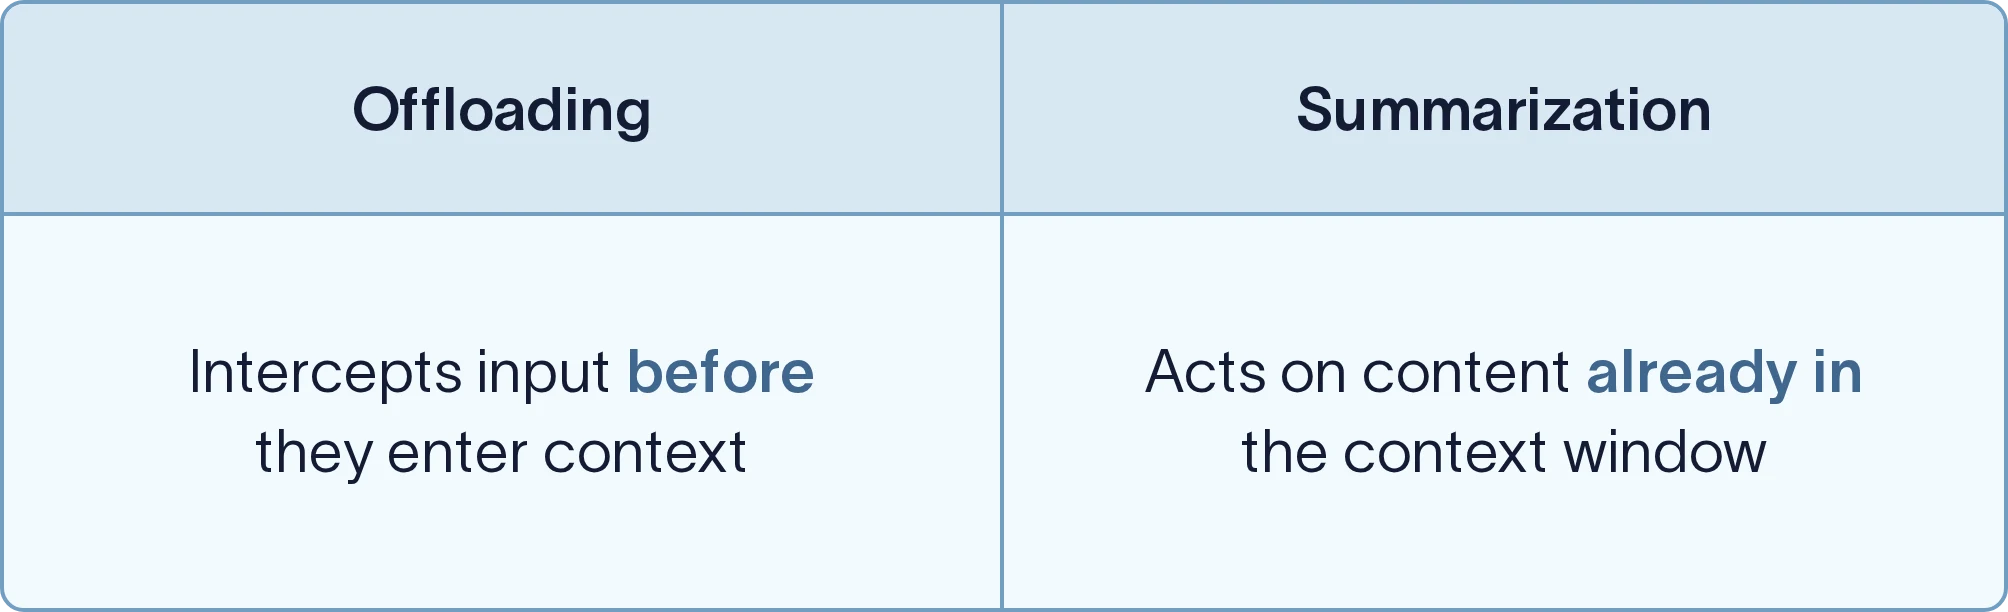
- 不要な情報を 入る コンテキストウィンドウ
- 何を管理しフィルタリングするか—— すでに存在する コンテキストウィンドウ内の情報です
ハーネスはこれらの手法を戦略的に適用し、モデルに 与えられたタスクにとって適切なコンテキストを適切なタイミングで 提供します。
次は、これを うまく行うハーネスの構築方法です 口で言うのは簡単ですが、多くの作業を必要とします(前夜に試験勉強を詰め込むタイプの人には、多すぎる作業になるかもしれません)。
Deep Agents はLangChainのオープンソースハーネスです。選択したモデルを、コンテキストをアクティブなウィンドウから 外へ 移動させる手法(ファイル、要約、または別のエージェントへ)でラップし、メインのエージェントが必要なものだけを持ち運び、必要になった later に元データを復元できるようにします:
- Offloading(オフロード): 大きなツール結果やユーザーメッセージはファイルシステムに保存され、モデルにはプレビューが表示されます。
- Summarization(要約): 会話がコンテキスト上限に近づくと、古いメッセージは要約に凝縮されます。
- Skills(スキル): タスクのノウハウは、モデルが関連があると判断したときにのみ読み込まれます。
- Subagents(サブエージェント): ノイズの多い作業は別のコンテキストウィンドウで実行され、結果だけが返ってきます。
- Long-term memory(長期記憶): エージェントが学習したことはファイルに保存され、次の会話に引き継がれます。
一般的なユースケースへのコンテキストエンジニアリングの適用
上記の手法を実際のユースケースにどう適用できるか見てみましょう。競合分析エージェントです。このエージェントは毎週月曜日に5社の競合を調査し、チームのテンプレートに従ってレポートを書きます。1回の実行は次のようになります:
- Company Aの市場データエクスポートを取得する(数万行)
- ニュースを検索し、いくつかの記事を読んでメモを取る
- Company BからCompany Eまで繰り返す
- レポートを起草し、あなたのフィードバックに基づいて修正し、フォーマットする
ステップ 4までに、エージェントは5つの生のエクスポート、何十もの検索結果、そして2つの古い下書きをすべてのモデル呼び出しに通して運んできています。その大部分は最終レポートのフォーマットには無関係です。
検索手法(RAGやファイルシステム検索)は、エージェントが 必要なものだけ を取り込むのに役立ちますが、それでも問題の半分しか解決しません。どれほど正確なエージェントでも、不要なメッセージ、ツール結果、中間作業が蓄積されるため、ハーネスはコンテキストウィンドウの内側および周辺にすでにあるものも管理しなければなりません。
これらの手法の実装方法:ミドルウェア
エージェントはループ内で動作します。モデルが何をすべきかを決め、ツールを呼び出し、結果を読み、タスクが完了するまでこれを繰り返します。 ミドルウェア とは、そのループ内の特定のポイント(エージェントの開始前、各モデル呼び出しの前後、各ツール呼び出しの前後など)に差し込まれるコードです。
- 各ポイントで、コンテキストを読み取り、次のステップが実行される前に変更することができます。
- この記事で扱うすべてのコンテキストエンジニアリング技法は、これらのポイントのいずれかにフックされたミドルウェアの一部です。
- その大部分は組み込み済みのため、これらの技法を使うためにミドルウェアを自分で書く必要はありません(特定の部分をカスタマイズしたい場合を除く)。
オフロード: コンテキストウィンドウの外に追い出す
エージェントは、すべてのツール呼び出しや人間のメッセージから返される すべての データ、特に大量のデータを常に見る必要があるわけではありません。
たとえば、各pull_market_reportツール呼び出しは完全なデータエクスポート(数千行)を返しますが、エージェントはそのうちのいくつかの数値だけを必要とするため、モデルはそれらの行のみを見るように制限できます。
FilesystemMiddlewareは、ツールが呼び出されるたびに実行されます。
- ツールの結果が約20,000トークンを超えると、完全な結果が会話に入る前に/large_tool_results/{tool_call_id}に書き込まれます。
- モデルが見るのは短いプレビュー(最初と最後の数行)とファイルパスだけです。
- エージェントが後で企業Bの四半期売上を必要とする際には、read_fileでそのファイルを読み進めます。
貼り付けられた通話の書き起こしなどの特大のユーザー/人間のメッセージは、より高い閾値(50,000トークン)で同じ処理が行われ、/conversation_history/に保存されます。
要約: すでにあるものを圧縮する
冗長なツール呼び出しをオフロードしようとしても、長時間の実行ではコンテキストは徐々に積み上がっていきます(例: 5社分の検索、メモ、下書き)。要約を使用すると、エージェントのコンテキストウィンドウ全体を、これまでの経過の要約に圧縮し、調査タスクを続行できるようにできます。
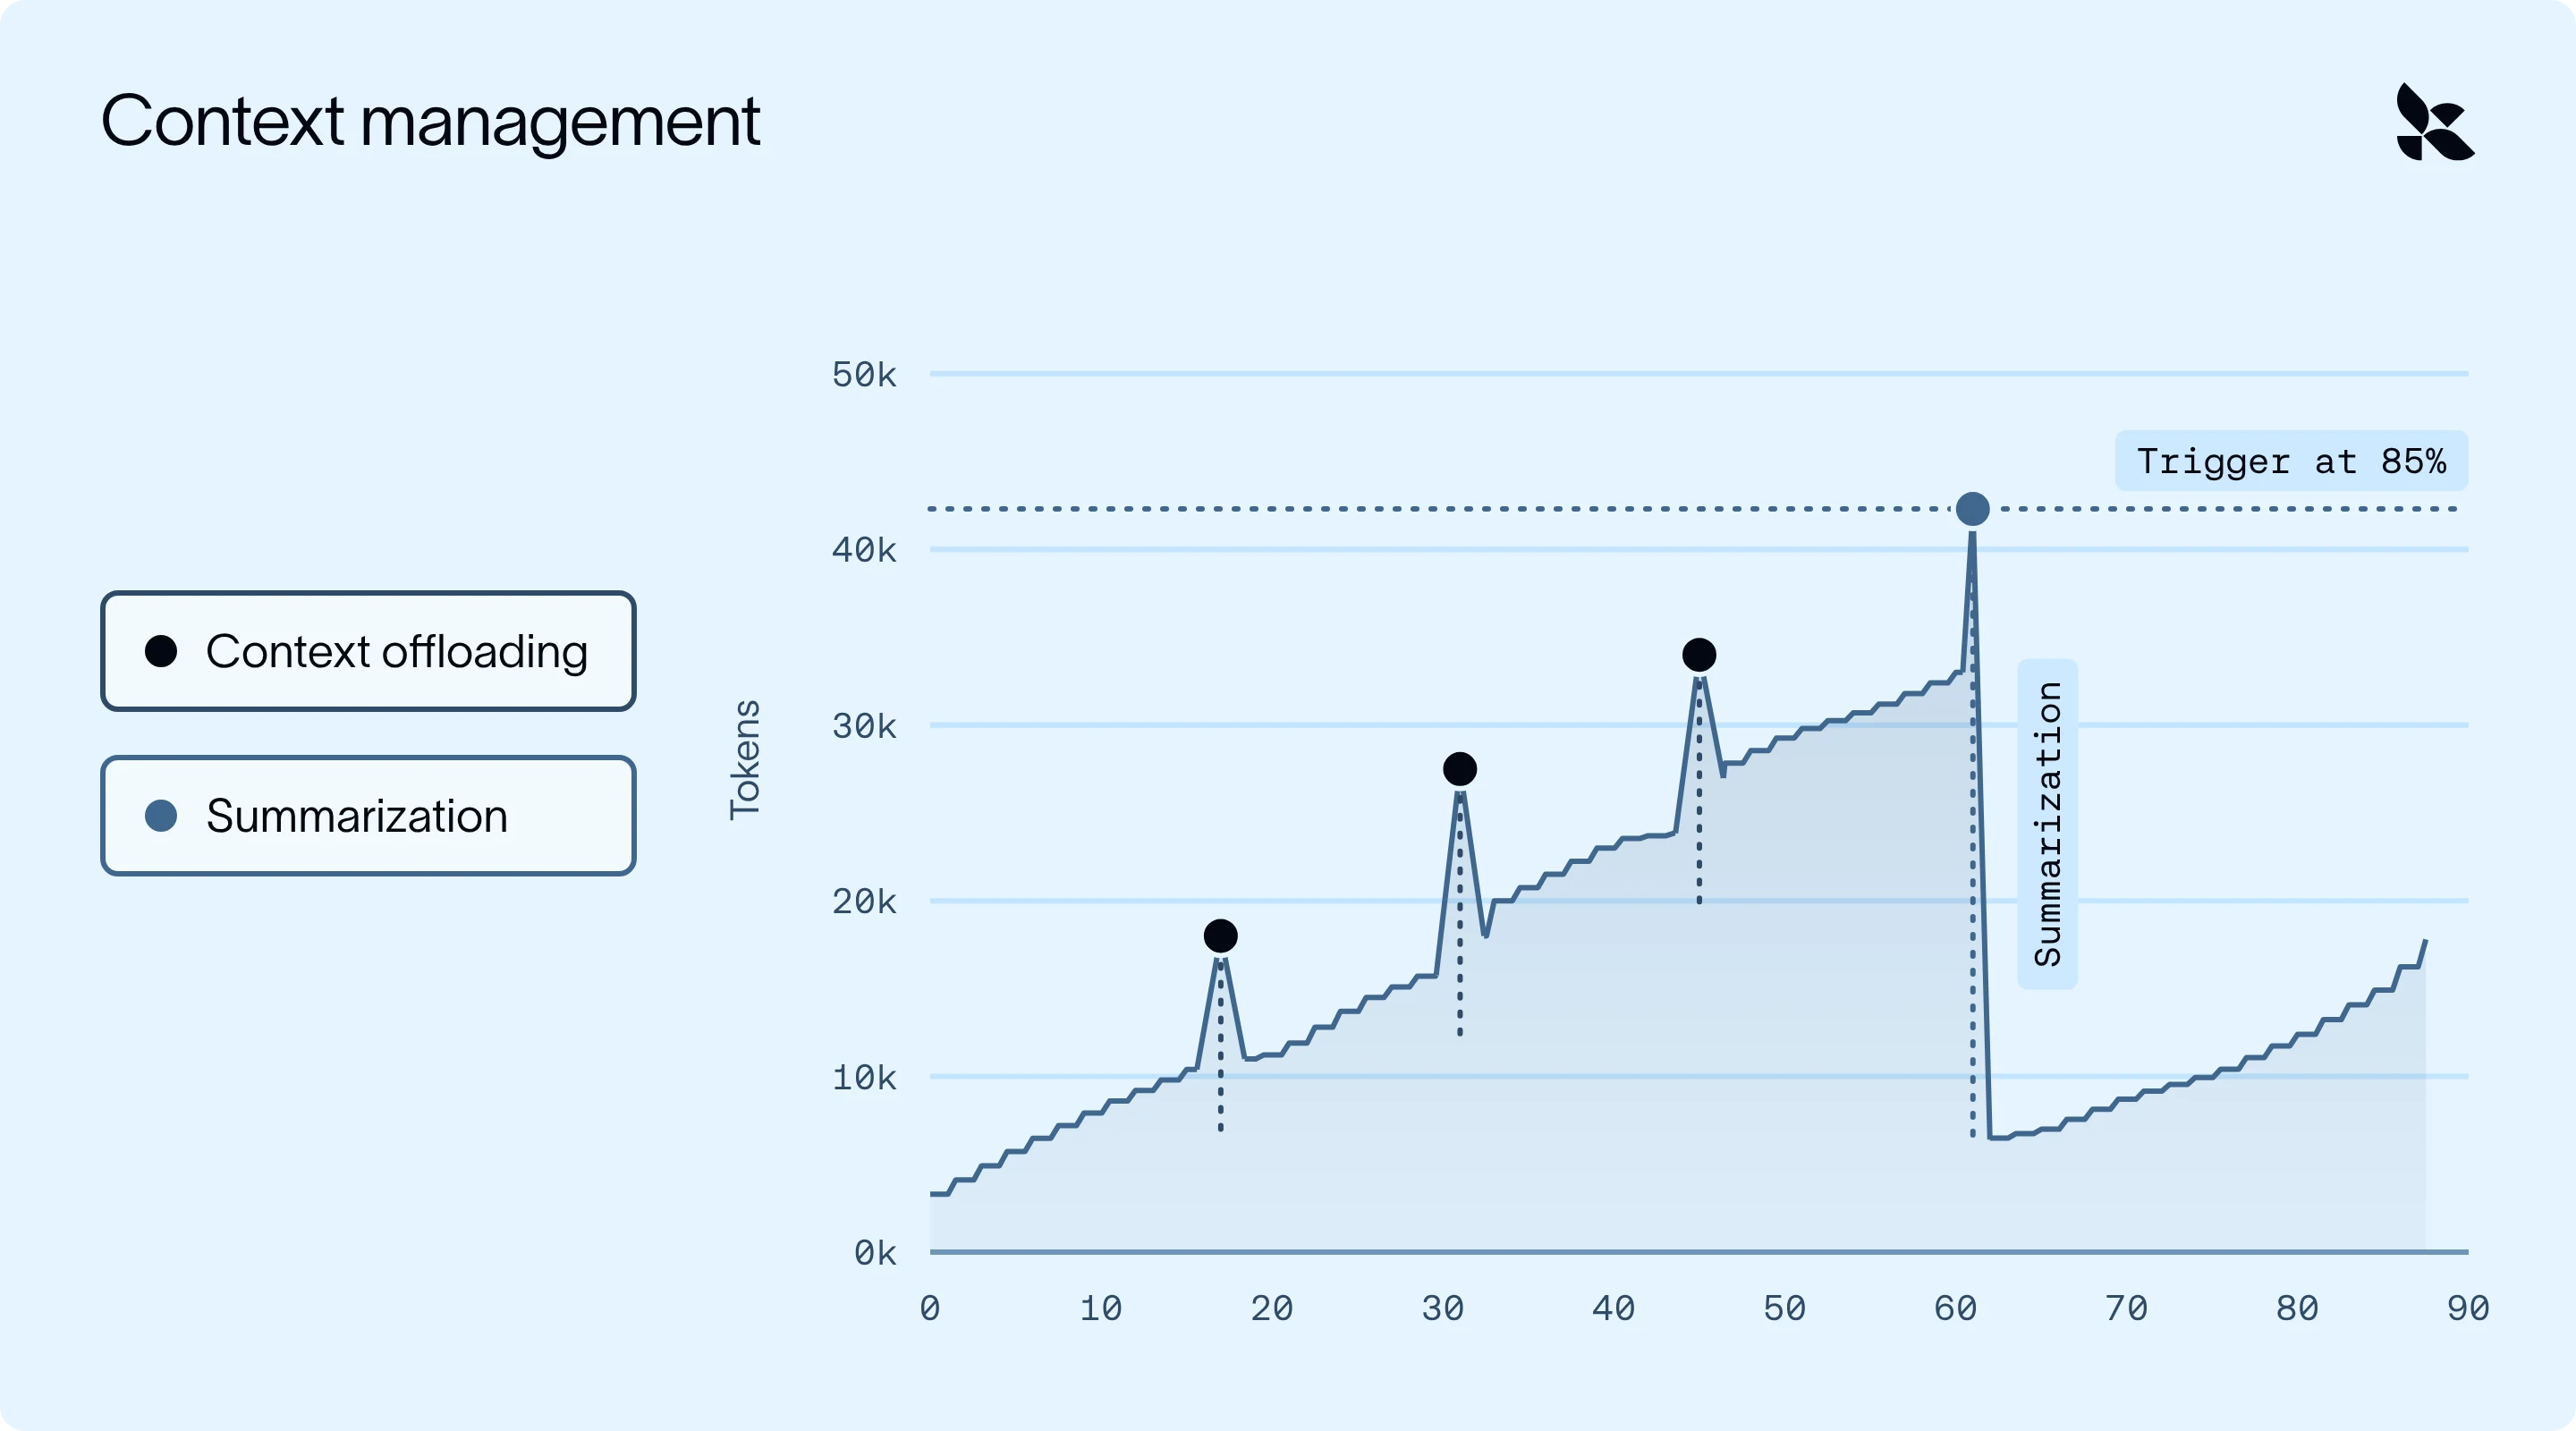
- スパイクは到着する大きなツール結果/人間のメッセージです。オフロードは、モデルがそれを見る前にそれぞれを短いプレビューに置き換えるため、コンテキストはほんのわずかしか増加しません。
- 要約はゆっくりとした上昇に対応します。使用率が85%に達すると、古いメッセージが要約に圧縮され、コンテキストは再び下がります。
SummarizationMiddlewareは、各モデル呼び出しの直前にトークン使用量をチェックします。
- 使用率が閾値を超えると(デフォルトではモデルのコンテキストウィンドウの85%)、別のLLM呼び出しによって古いメッセージが単一の要約に圧縮されます
- 古いメッセージはコンテキストウィンドウから削除され、最新のメッセージはそのまま逐語的に保持されます。
- モデルは最初に要約を見て、その後に最近のメッセージを見ます(そのため、最近の内容が言い換えられることはありません)。
重要な詳細が2つあります。
- 復元可能です。 要約されたメッセージは/conversation_history/{session_id}.mdに書き込まれます。エージェントが下書きの作成中に企業Aの調査の詳細を必要とすれば、それを読み戻すことができます。
- 繰り返し動作します。 実行が続くと使用率は再び上昇し、次の要約には前の要約が含まれます。
トピックが変わったときに要約することもできます特定のトークンのしきい値だけでなく、すべてにおいて。要約プロンプトをカスタマイズすると便利な場合があります。
当社の記事「 Deep Agents のコンテキスト管理 」で、両方についてさらに詳しく説明しています。
スキル:必要な時にのみ情報を読み込む
営業チームに四半期事業レビュー(QBR)用の特定のフォーマットがあるとします。エージェントはその手順を四半期に一度しか必要としないため、それをシステムプロンプトに入れておくと、呼び出しごとにそのコスト(トークンと応答時間)を支払うことになります。代わりに、この情報をスキルとしてパッケージ化できます。
スキルとは、手順(オプションでスクリプトやリファレンスドキュメントを含む)をまとめたフォルダーであり、専門的なタスクに必要なものをエージェントに提供します。
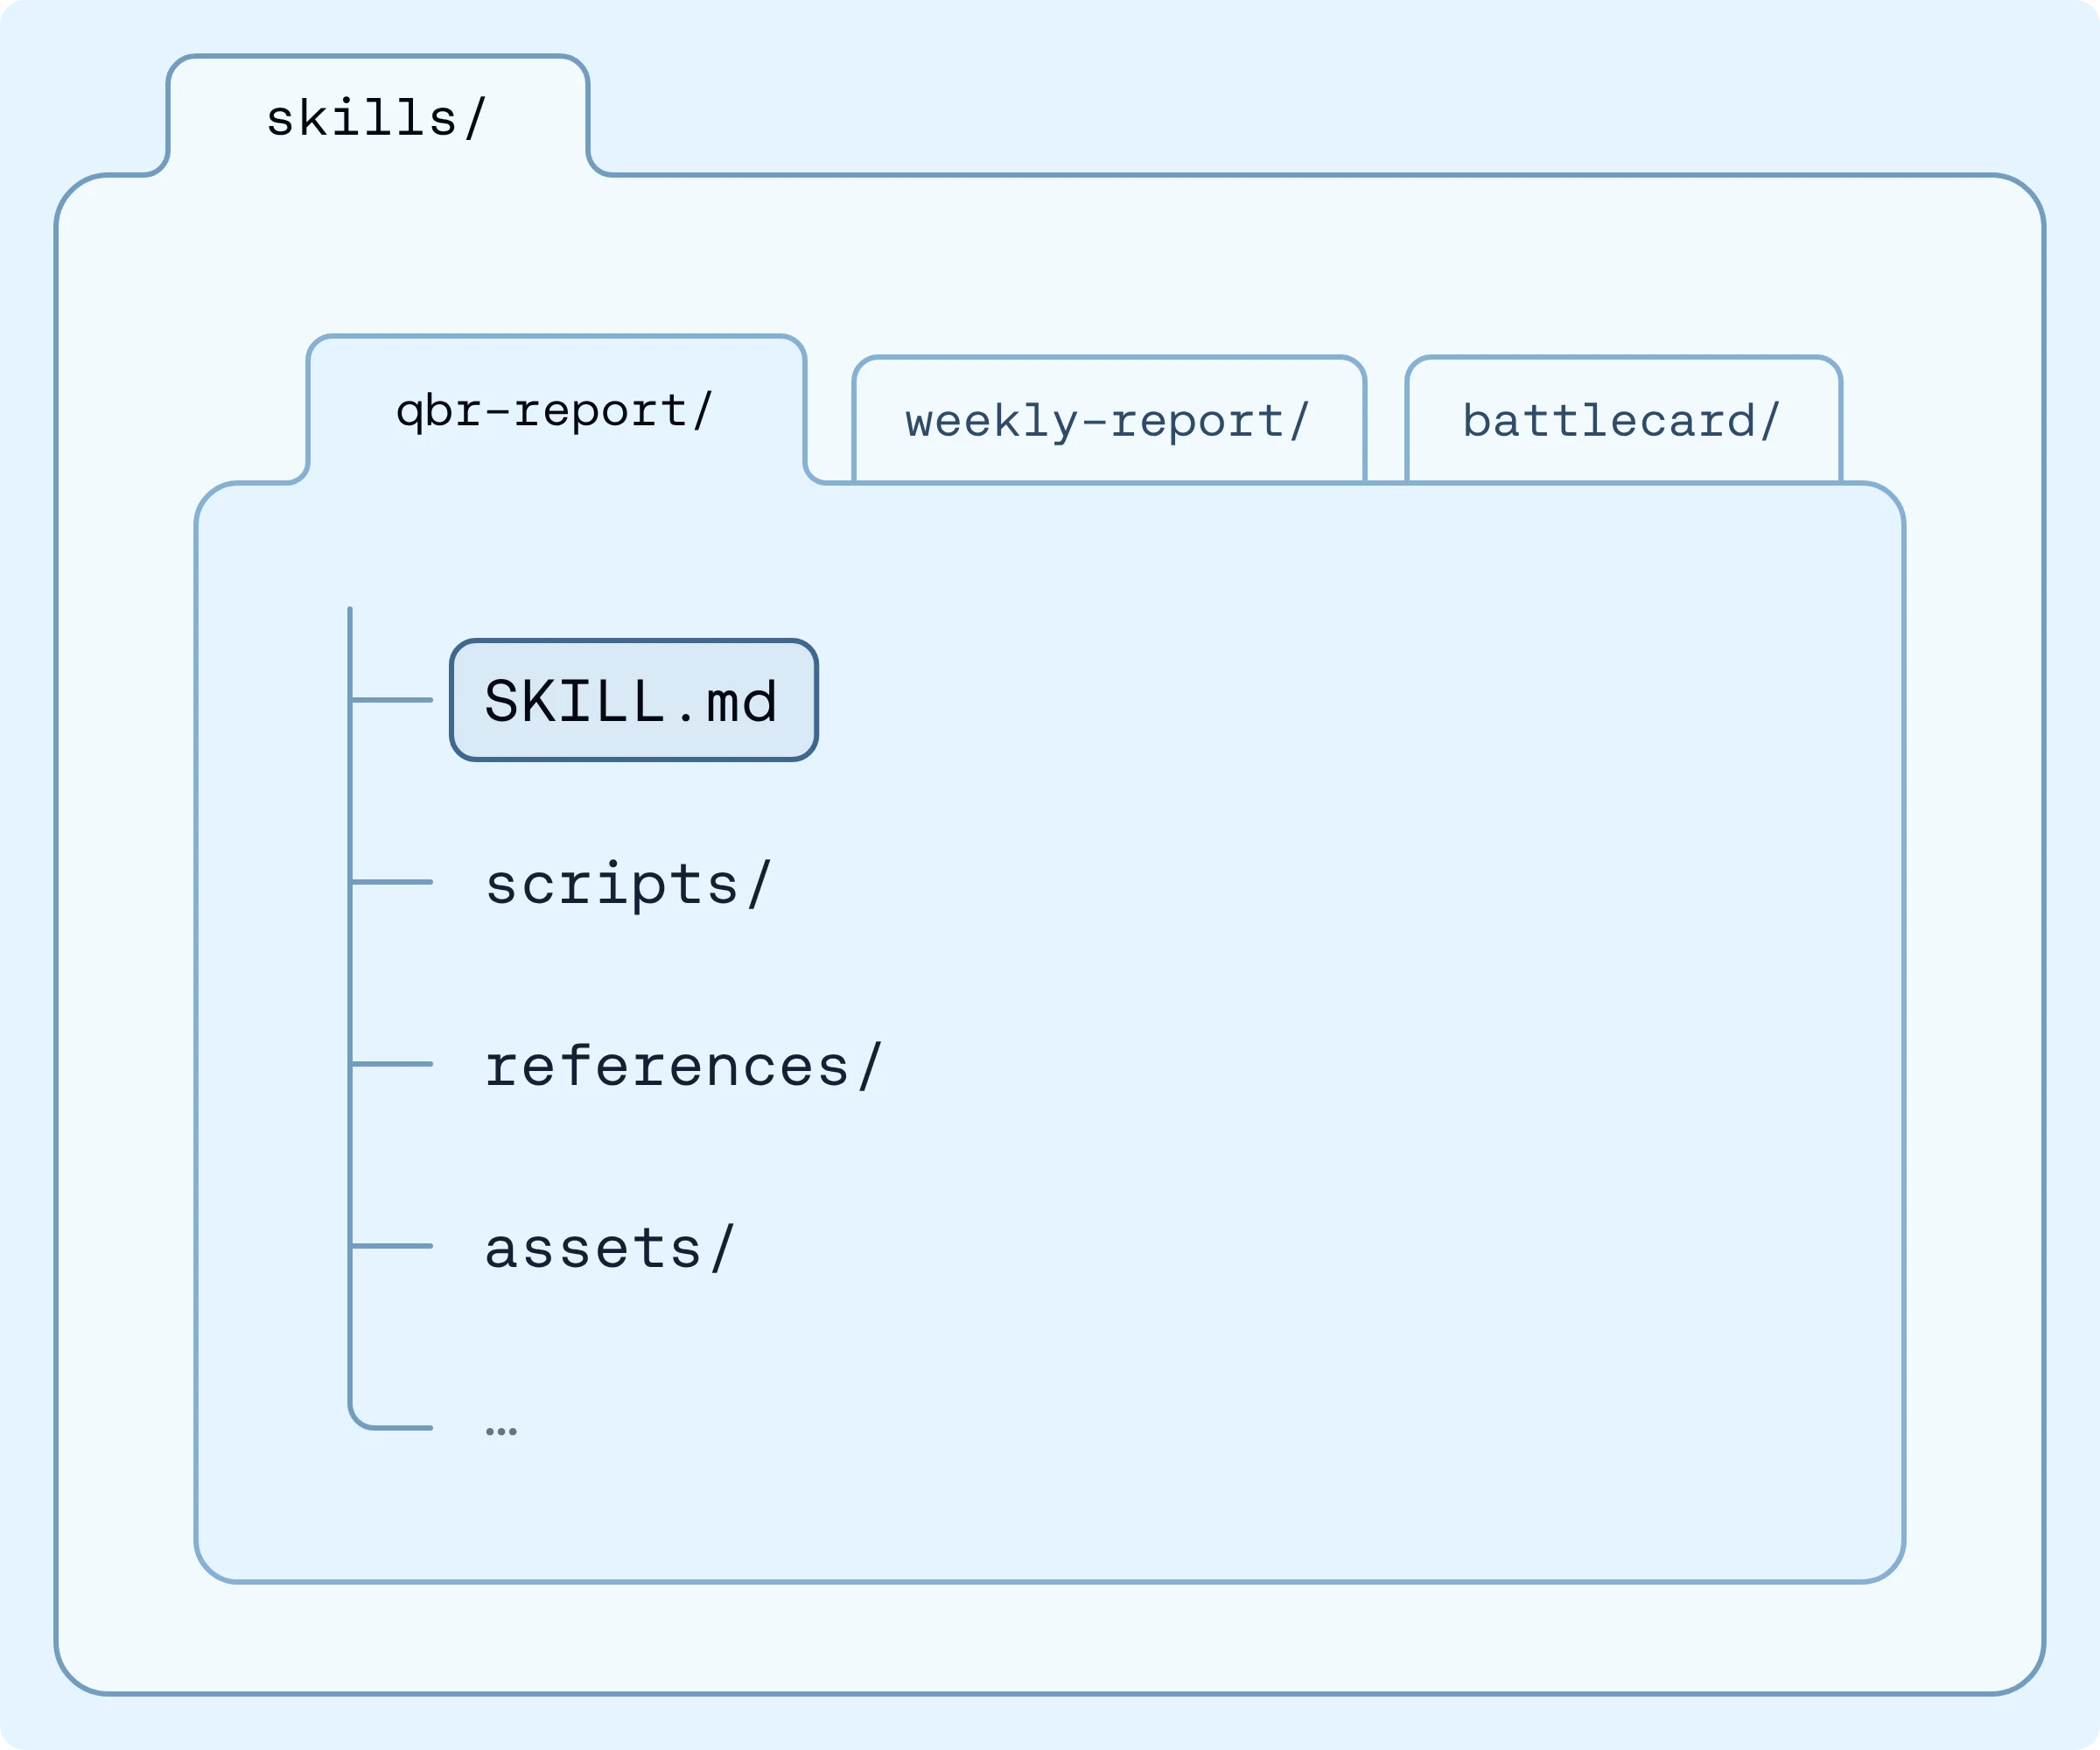
エージェントは最初に短い説明を目にし、qbr-report の完全な手順は QBR が実際に来た時にのみ読み込みます(他のタスクではこれらを一切抱え込みません)。
スキルはコンテキストをレイヤーごとに読み込むため、実際に関連性が生じるまではウィンドウが小さいまま保たれます。これはプログレッシブディスクロージャー(段階的開示)と呼ばれるもので、モデルは最初に「メニュー」を目にし、必要になった時点で完全なレシピを読み込みます。そのため、10個のスキルが持つコンテキストコストは、10行の一行説明とほぼ同じ程度に抑えられます。
エージェントをあなたのスキルに向ければ、SkillsMiddlewareは2つのフックを使用します。
- エージェントは開始前にskillsフォルダをスキャンし、各SKILL.mdのヘッダーのみを読み込みます。
- モデルを呼び出すたびに、それらの名前と説明をシステムプロンプトに追加します。
スキルの完全な指示は、モデルがそのスキルが関連していると判断した場合にのみ(read_fileツールを使って読み込んだときに)コンテキストに入るため、私たちのエージェントはテンプレートなしで調査を行い、QBRをフォーマットする段階になって初めてそれを読み込みます。
サブエージェント: ノイズの多い作業を切り離す
オフロードは過大な結果への対策として効果的ですが、サブエージェントはすでに手元にある作業にとっても良い設計上の選択肢です。 知る ノイズが多くなります(例:数十回の検索やページにわたって1つの企業について調べる場合)。サブエージェントはその作業を独自のコンテキストウィンドウ内で行い、最終結果だけを返すため、メインエージェントはその「ノイズ」を目にすることはありません。
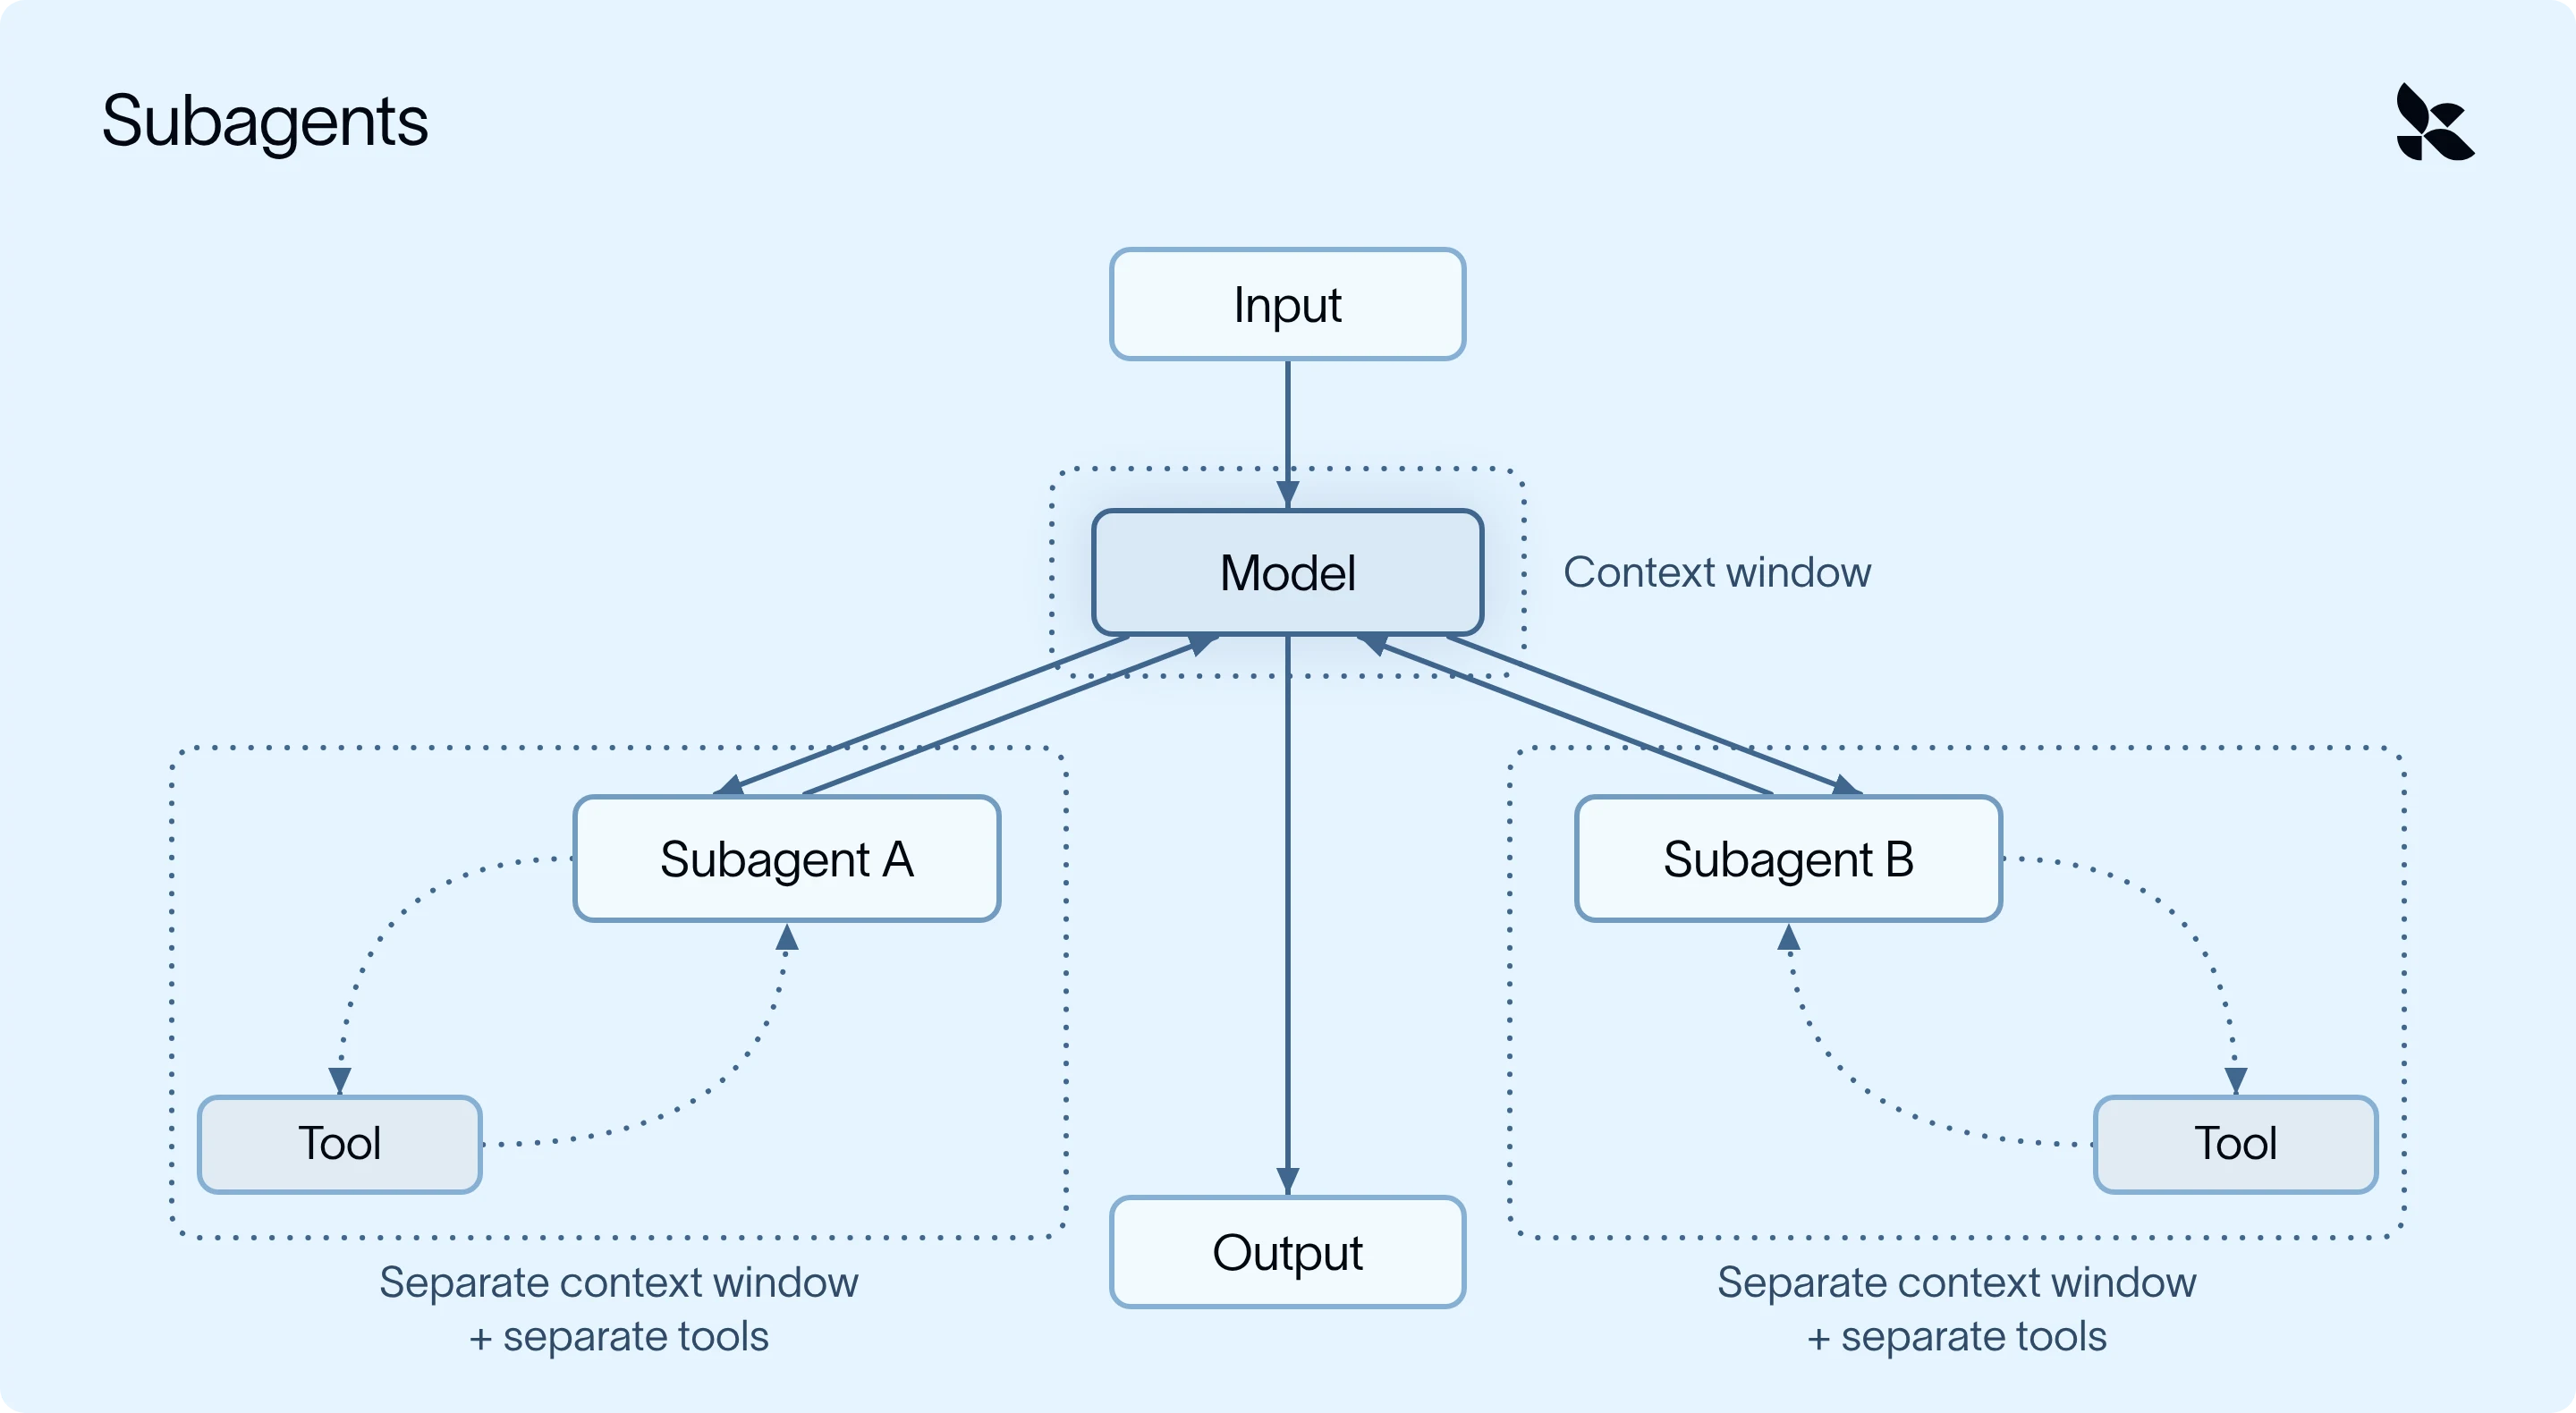
SubAgentMiddleware を使うと、サブエージェントに与えるシステムプロンプトや利用可能なツールをカスタマイズできます。
market_researcher = {
    "name": "market-researcher",
    "description": "Researches a company and returns the 3 most notable developments.",
    "system_prompt": "Use pull_market_report, then return 3 short bullet points. Do not return the raw report.",
    "tools": [pull_market_report],
}

agent = create_deep_agent(model=model, subagents=[market_researcher])
私たちのケースでは、メインエージェントが各企業をmarket-researcherサブエージェントに引き渡します。
リサーチャーのサブエージェントは、自身のコンテキスト内で完全なレポートを読み、たった3つの箇条書きだけを返します。そのため、メインエージェントにはこれら3つの箇条書きしか見えません(生のレポートのプレビューすら見えません)。さらに、サブエージェントのタスクは小さく範囲が明確なものになりがちなので、多くの場合、より安価なモデルで並行して実行できます。
長期メモリー:会話をまたいで保持する
読み終わる頃には、あなたのエージェントは多くのことを学んでいるでしょう。有用なこともあれば、そうでないこともあります。
エージェントに「要約には段落ではなく箇条書きを使って」と伝えたとしましょう。メモリがなければ、これを毎週繰り返すことになるかもしれません。Deep Agentsでは、長期メモリはマークダウンファイルです。引数を1つ渡してエージェントにそのファイルを指定すれば、あとはMemoryMiddlewareが処理してくれます:
- 負荷: 実行の開始時にファイルが読み込まれます。
- 注入: その内容は、モデルを呼び出すたびにシステムプロンプトに追加されます。
- 更新: エージェントが、フォーマットの好みのように保存する価値のあることを学ぶと、そのファイルを更新します。
モデルを交換しても、メモリはそのまま
Deep Agentsはプロバイダーに依存しない設計で、その考え方はメモリにも及びます。メモリは自分のストア内の単なるファイルであり(プロバイダーが保持するものではない)ため、同じバックエンドを別のモデルに向けることができます。
agent = create_deep_agent(
    model="openai:gpt-6",  # different provider, same memory
    memory=["/memories/AGENTS.md"],
    backend=backend,
    store=store,
)
来週には、別のモデルが同じファイルを読み込み、同じように箇条書きで要約を書くかもしれない。
心に留めておきたいコンテキストエンジリングの戦略
Deep Agents上に構築する場合でも、別のハーネスを使用する場合でも、自身で構築する場合でも、注意すべき点をいくつか紹介します。
- 大きな入力は切り捨てるのではなく、オフロードすべきです。 切り詰めは不可逆的な損失ですが、オフロードすれば後から取り出し可能なまま保たれます。
- コンパクションはリカバリ可能であるべきです。 要約後でも、エージェントは必要な詳細を取り戻すことができます。
- ノウハウはオンデマンドで読み込まれるべきである。 システムプロンプト内のすべてのタスクの指示は、毎回の呼び出しでコンテキストを消費します。
- ノイズの多い作業は分離すべきです。 それぞれ独自のコンテキストを持つサブエージェントが、メインエージェントの集中力を維持します。
- メモリは自分で所有すべきです。 自分が管理するストレージ内のメモリは、モデルやプロバイダーの切り替え後も残ります。
- デフォルトはカスタマイズ可能であるべきです。 あるタスクに適したしきい値が、すべてのタスクに適するとは限りません。
試してみる
uv add deepagentsライブインストラクターからさらに学びたい方は? 私は11月3日にこの内容を取り上げます: 登録 こちら!
コンテキストエンジニアリングをさらに深く学びたい方は、無料の自己ペース型の LangChain AcademyのDeep Agentsコースをご覧ください。