
すべての企業には、独自のワークフロー、ツール、エッジケース、そして成功の定義があります。 (新しいウィンドウで開きます)Third Moment Research(新しいウィンドウで開きます) は、最良のエージェントとはその特定の仕事に非常に長けており、使用されるほど能力が向上するべきだと考えています。
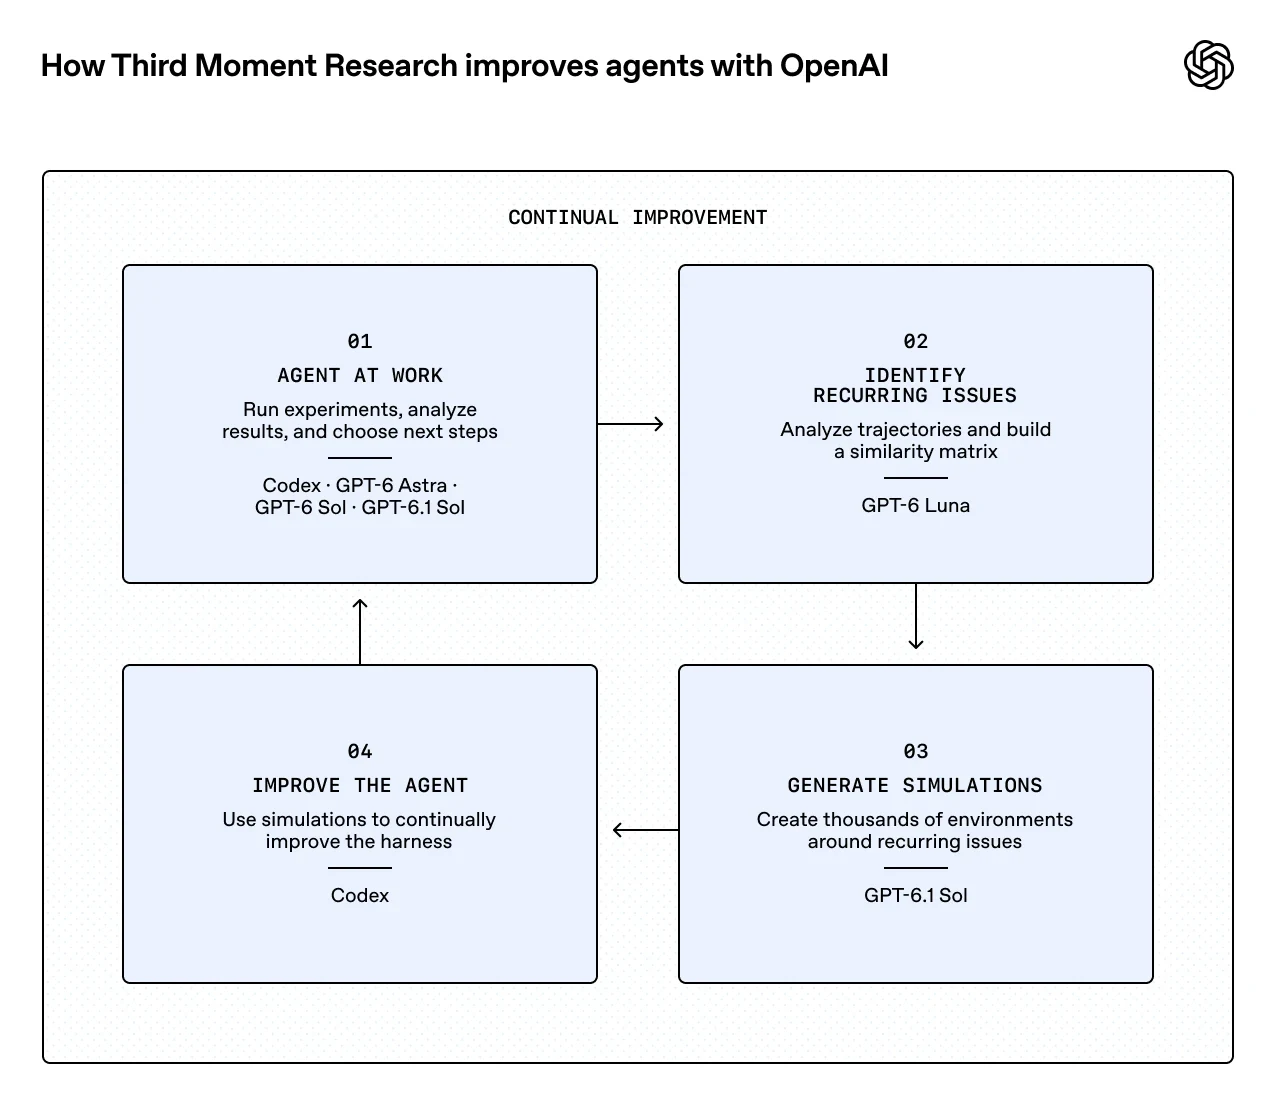
同社はこの考えをもとに、自己改善型のAIシステムを構築しています。OpenAIの最新モデルを使用してエージェントの挙動を理解し、繰り返し現れる弱点を特定し、それらの問題を中心に何千もの合成シナリオを自動的に作成します。チームはそれらのシナリオを使ってエージェントを改善し、新たな問題が現れるたびにこのプロセスを繰り返します。
Codex、GPT‑6 Astra、GPT‑6 Sol、GPT‑6.1 Solがこのシステムの研究と計算作業を支え、Third Momentは36〜48時間にわたる調査を10,000のエージェントで同時に実行することを可能にしています。同社はまた、エージェントが作業する環境のセキュリティをテストするためにDaybreakも使用しています。
「1回のセッションで、GPT-6.1 Solは何日にもわたる計算研究の一貫した糸を、筋道を見失うことなく維持することができます。」—Adam Khakhar、Third Moment Research 共同創業者
Codexによるランタイムとトークンの無駄の削減
Third Momentの初期の応用分野のひとつは、成功の指標が明確であることから、定量ファイナンスの分野です。この領域は、エージェントがどのように機能し、どこで苦戦するかを研究するための具体的な環境を提供します。チームはCodexを使用して、研究環境における問題を発見し対処しています。
ある事例では、当時の最新のGPTモデルであったGPT‑5.6とCodexを組み合わせて、タイムスタンプやコードベースと併せて、何千件もの記録されたシミュレーションの軌跡(エージェントの行動と環境の応答)を分析しました。
Codexはボトルネックを発見しました。1年分の米国株式の注文レベルのデータにわたって取引戦略をバックテストするのに数時間かかっていたのです。待っている間、エージェントは完了を何度もポーリングし、トークンを無駄にし、ステータス確認でコンテキストを埋めていました。
バックテストをプロファイリングし、その入力と使用状況を分析した後、Codexはキャッシングの最適化とメモリパッキングの手法を特定しました。ソリューションを実験し、その修正を本番環境に展開することで、バックテストを約3時間から約3〜5分に短縮しました。これによりトークンの使用量とコンテキストの汚染が減り、さらなる実験のためにエージェントのトークン予算のより多くを解放しました。
CodexとGPT‑6でエージェントをタスクに集中させる
Third Momentは、各エージェントに特定の仕事に必要なツール、情報、環境を与えます。定量研究では、チームはDocker化された環境の中でデフォルトのCodexハーネスを実行します。エージェントには1テラバイトのデータ、ドキュメント、そして特徴量エンジニアリング、GPU対応のモデルトレーニング、取引戦略、シミュレーション用のモジュールを備えた研究リポジトリが与えられます。
GPT‑6 Astra、GPT‑6 Sol、GPT‑6.1 Solが推論を担い、Codexハーネスがエージェントに行動、計画の作成、目標の設定、サブエージェントの生成、作業の進行に応じたコンテキストの圧縮を行うためのツールを提供します。
タスクを完了せずに停止するエージェントに対処するため、Third MomentはCodexを、GPT‑6 SolまたはGPT‑6.1 Solを基盤とする外部ハーネス内のサブエージェントとして扱っています。外部ハーネスは、タスクが未完了のまま残されたときに軌跡を調べ、再試行するか、ジョブを終了するか、人間によるレビューにエスカレートするかを判断します。
「Codexハーネスは非常に汎用性が高く、多くの異なる分野での利用を可能にします。」—Adam Khakhar、Third Moment Research 共同創業者
その研究環境において、エージェントはThird Momentのエンジニアが構築したベースラインの取引システムの改善に取り組みます。彼らは歴史的データ上で取引戦略をテストし、その改善が意味のあるものかノイズかを評価し、各結果を次の実験の選択に活かします。Adamによれば、彼らの作業によりベースラインの取引システムは改善されています。
より高いトークン効率でより長期の研究を持続させる
GPT‑5.5以前は、モデルはユーザーが指示した実験のみを実行できるとAdamは言います。GPT‑5.5とGPT‑5.6では、Codexハーネスと組み合わせたモデルが結果を利用して後続の実験を設計できるようになりました。そして現在、GPT‑6 Astra、GPT‑6 Sol、GPT‑6.1 Solにより、エージェントはサブエージェントと並行して実行される何百もの実験を通じて根本原因を調査できるようになっています。
この進歩により、エージェントはチームが予想していなかった研究の方向性を探究できるようになりました。あるセッションで、GPT‑6.1 Solは、それらの取引が予想外に大きな出来高の割合を占めていた取引所において、非表示取引が及ぼす影響を特定しました。「これは私たちの研究チームが当初考慮していなかった、自明ではない結果でした」とAdamは言います。
Third Momentは、最適化、機械学習システム、定量研究の各分野でモデルを評価しています。フロンティアリリースを最高の推論設定でテストし、リポジトリの操作、効率的なコードの記述、そして調査の持続能力を評価します。現在のテストにはGPT‑6 Lunaも含まれています。
「GPT-6.1 Solはそのトークン効率の高さから、現在最も使用しているモデルです。GPT-6 Astraと同程度のパフォーマンスを発揮しながら、最も少ないトークンでタスクを完了します。」—Jeffrey Yan、Third Moment Research 共同創業者
あるベンチマークでは、エージェントに、出力を維持しながらライブのスコアボードサービスの更新レイテンシを削減することが求められます。チームは、正確性を条件として、専門家が作成したソリューションの平均実行時間を同じハードウェア上でのモデルのソリューションの実行時間で割ることで、高速化の度合いを測定します。Adamによれば、GPT‑6 Astraが最大の高速化を実現しました。
シミュレーションシステムにおける特定のセキュリティ脆弱性のチェックなど、対象を絞った作業では、チームはGPT‑5.6 Terraのようなより効率的なモデルを使用しています。深い研究については、Adamはより強力な推論能力が高いコストを正当化できると考えています。「クオンツ金融の分野では、興味深いシグナルを見つけることの価値は極めて高いのです。」
Daybreakによるセキュリティテストの自動化
10,000のエージェントが自律的に稼働しているThird Momentには、研究環境のセキュリティを大規模にテストする方法が必要です。チームはDaybrekサイバーセキュリティプラットフォームを使用して、シミュレーションの起動前にそのテストを自動化しています。
テストでは、エージェントが研究環境から脱出してより広いネットワークにアクセスできるかどうかを確認します。「Daybreakを使うことで、エージェント自身にシミュレーションへのペネトレーションテストを行わせ、そのインフラとセキュリティをテストできるようになりました」とAdamは言います。
「Daybreakがなければ、これを大規模に自律的にテストすることはできなかったでしょう。」—Adam Khakhar、Third Moment Research 共同創業者
数十万人規模の協働エージェントへの前進
Third Momentの野心は、企業が日常的に行う専門業務にまで及びます。小売業者にとっては、在庫が不足したりサプライヤーが遅延したりした際に、より良いサプライチェーンの意思決定を行うことを意味します。エンジニアリングチームにとっては、大規模なコードベースにおけるパフォーマンスのボトルネックを見つけることを意味します。文書の多いビジネスにとっては、ある文書でのコミットメントが別の文書に記録された結果と一致しない箇所を特定することを意味します。
GPT‑6 Astra、GPT‑6 Sol、GPT‑6.1 Solの推論能力をベースに、Third Momentは個別の調査から数十万人規模で協働するサブエージェントへの拡大を計画しています。そのロードマップでは、数十の依存する実験の連鎖を支える数兆トークンを見込んでおり、新たな課題が生じた際にその研究を活用してエージェントを自律的に改善することを目標としています。
Adamにとって、これにより人々はエージェントの学び方や働き方を形作るためのより大きな力を得ることになります。「人間ははるかにレバレッジの効いた立場になり、実際に研究を行うのではなく、研究の進め方や研究そのものの最適化について考えることができるようになります。」