
TL;DR
コンフィデンススコアリングは、すべてのドラフトモデルベースのspeculatorタイプでサポートされるようになりました。コンフィデンスヘッドがない場合、 オンラインフィッティングされる推定器 がdrafterのロジットから特徴量を導出し、ターゲットモデルがそのトークンを受理する確率を予測します。この確率は、Adaptive Verification用のコンフィデンススコアとしてそのまま使用されます。推定器の係数は継続的にフィッティングされ、流入するデータトラフィックに適応します。この機能はPR #52228でマージされ、コンフィデンスヘッドを持たないドラフトモデルに対しては enable_adaptive_verification で有効化されます。
背景
vLLMの Adaptive Verification (AV)は、speculative decodingの際に、ドラフトされたトークンの一部のみを検証することを可能にします。受理確率の低いドラフトトークンは、ターゲットモデルのフォワードパスを実行する前にバッチから取り除かれ、計算量を節約します。この最適化は、特に大きなバッチサイズをサービングする場合に有益です。その状況ではGPUが計算バウンドになるためです。詳細については このvLLMのブログ記事 を参照してください。
AVにはトークンごとの受理確率の推定値が必要なため、これまではDSpark drafterのみをサポートしていました。DSparkモデルは多くの場合、コンフィデンスヘッドを搭載しています。これはdrafterの各位置の隠れ状態に対する小さな線形層で、「ターゲットはこのトークンを受理するか?」を予測する二値分類器として学習されたものです。
問題
EAGLE、MTP、DFlash、一部のDSparkチェックポイントなど、コンフィデンスヘッドを持たないドラフトモデルは、AVをまったく利用できませんでした。AVを使用するには、これらのdrafterにはトークンごとの受理確率の推定値が必要であり、コンフィデンスヘッドを追加するということはdrafterの再学習を意味します。既に多くの人がサービングしている既存のチェックポイントにとって、これは現実的な選択肢ではありません。
先行研究
drafter自身のコンフィデンスを受理確率の代理指標として使う手法は、確立されたものです。 EAGLE-2 は、EAGLEのドラフト確率が受理率と密接に対応することを示し、それを動的なドラフトツリーの成長と再ランキングに使用しました。 Draft & Verify およびいくつかの後続研究では、drafterの確率が固定された閾値を下回った時点でドラフトを停止します。 SpecDec++ は、DSparkのコンフィデンスヘッドに思想が近い、専用の受理予測ヘッドを学習します。いずれの場合も、ドラフトコンフィデンスから受理確率への写像は、そのまま使うか、オフラインで学習されます。
AVには良いランキング以上のものが必要です。AVの予算決定は予測された受理確率を合計し、実測されたコストと照らし合わせて重み付けするため、予測はサービング対象の具体的なモデルペアとワークロードに対してキャリブレーションされている必要があります。これを次のセクションで説明するオンラインフィッティングされた推定器が実現します。
解決策:オンラインフィッティングされる受理推定器
我々は、ドラフト分布から導出される単一のスカラー値、すなわちdrafterの最も確率の高いトークンのlog-oddsから、各ドラフトトークンの受理確率を推定する軽量なロジスティック回帰を追加しました。このモデルは共有の傾斜を1つと、ドラフト位置ごとの切片を1つ持ち、そのため Kトークンのdrafterには合計で K + 1 parameters. これらのパラメータは、通常の検証の際にターゲットモデルがすでに生成している accept/reject の判断からオンラインでフィッティングされます。既存のどのドラフトcheckpointでも、追加コストなしでAVを利用できます。
このセクションの残りの部分では、設計の2つの側面について説明します。推定器がスコアリングする対象となる量と、提供時(serving)にその係数がどのようにフィッティングされるかです。
分布の採点
特定のドラフトトークンに対する信頼度スコアは、位置ごとのロジスティック回帰を用いて推定されます。
ここで ω はすべてのドラフト順位で共通の当てはめられた傾きであり、βi は位置ごとに推定された切片であり、 q ドラフト分布です。対数オッズの別形はこの関係を明確に示します:
logit(qmax) は推定量の特徴量、はドラフトの最も可能性の高いトークンの対数オッズです。直感的には、ドラフトモデルがその予測に対してどの程度自信を持っているかを表します。これは係数 ω および β によって線形に変換されますi ターゲットモデルによるドラフトの採用のログオッズを予測する。そのシグモイドは p、AVの信頼スコアとして使用される推定合格率です。
その他の検討された機能
いくつかの代替機能が検討されましたが、それぞれ何らかの理由で却下されました。機能を評価する際に私たちが最も重視した4つの主要な軸は以下の通りです:
- 可逆性 — スペキュラティブデコーディングの際に、この機能が出力分布に偏りを生じさせるかどうか。
- 曲線下面積(AUC) — 無作為に選ばれた受理済みドラフトが、無作為に選ばれた却下されたドラフトより高いスコアを取る確率。これは以下を測定します 差別 受け入れられるべきドラフトと拒否されるべきドラフトを区別する能力を示します。値が高いほど識別能力が優れていることを意味し、0.5 は無作為な推測に相当します。
- ログ損失 — 予測された受理確率の平均負対数尤度であり、自信過剰な誤答にペナルティを課し、較正の良さに報酬を与えます。値が低いほど、与えられたドラフトの真の受理確率を予測する能力が優れていることを示します。
- Expected Calibration Error(ECE) — 各ドラフトを予測受け入れ確率に基づいてビン分けし、各ビン内で平均予測値と平均観測頻度の誤差を、ビンの占有率で重み付けて測定します。これは キャリブレーションを測定しており、値が低いほど、類似のスコアを持つドラフト間での実際の頻度と一致する確率をドラフトに割り当てる能力が優れていることを示します。
無損失性は、これらの特徴量が備えるべき譲れない性質です。そうでなければ、speculative decodingの根本的な保証、すなわちターゲットモデルの分布と正確に一致する出力を壊してしまいます。AUCとECEはどちらもAVのトリミング決定において重要ですが、その仕方は異なります。AUCが重要なのは生存確率の 局所的な順序 です:
survival = confidence_probs[idx_mapping].cumprod(dim=1)
...
winners = flat.topk(draft_budget).indices
AUCは、受け入れられやすいドラフトトークンが、そうでないトークンより先に採用されることを保証します。一方、ECEは 大域的な 予算決定において重要です:
num_tokens_to_estimated_accepted_tokens = np.concatenate(
    ([num_sampling_requests], num_sampling_requests + np.cumsum(scores))
)
costs = draft_cost_ms[...] + verify_cost_ms[...]
...
draft_budget = int(np.argmax(num_tokens_to_estimated_accepted_tokens / costs))
確率は合計され、測定されたコストテーブルで割られます。ECEは、推定された受け入れトークン数が現実と一致することを保証します。
以下は、実験された様々な特徴量と、4つのカテゴリにおけるスコアをまとめた表です。これらは、AVなしで、DeepSeek-V4-Flash + DSpark(temp=1、top-p=0.95、conc=64)の提供過程で収集された約4.5M個のラベル付きドラフトについて、SPEED-Bench 2k low/high-entropy、GSM8K、HumanEval、MT-Benchの5つのデータセットにわたって測定されました。最後の2行は、フィッティングされた特徴量ではなく参照値です。1つはドラフターの qmax をフィッティングなしで受け入れ確率としてそのまま使用したもの、もう1つは訓練されたconfidence headのスコアです。
| 特徴量 | 無損失 | AUC | log-loss | ECE |
|---|---|---|---|---|
| log(qmax) | はい | 0.8069 | 0.4813 | 0.0592 |
| log(qmax) − log(q2nd)(top-2マージン) | はい | 0.8156 | 0.4437 | 0.0105 |
| H(q) (エントロピー) | はい | 0.8321 | 0.4577 | 0.0638 |
| −log(−log(qmax)) | はい | 0.8336 | 0.4289 | 0.0103 |
| logit(qmax) (出荷版) | はい | 0.8336 | 0.4284 | 0.0100 |
| logit(qsampled) | いいえ | 0.8553 | 0.4040 | 0.0152 |
| −log(−log(qsampled)) | いいえ | 0.8554 | 0.4075 | 0.0193 |
| qmax (フィットせず、確率としてそのまま使用) | はい | 0.8259 | 0.4880 | 0.0736 |
| 訓練されたconfidence head | はい | 0.8191 | 0.4449 | 0.0052 |
logit(qsampled) および −log(−log(qサンプリングされた)) はAUCの点で表内で選択された特徴量を明確に上回るが、これらに基づくトリミングは出力分布に偏りを生じさせるため使用されなかった。Both read qサンプリングされた、drafterが実際に抽出したトークンの確率。この値の関数に基づいてドラフトを切り詰めると、位置 i で検証するかどうかの決定が xi 自体に依存するようになり、切り詰めを生き残ったドラフトはもはや qの分布に従わなくなります。標準的な棄却サンプリングは、確率 min(1, p/q) でトークンを受け入れ、 q がドラフトトークンのサンプリング元の分布であることを期待します。しかし、 qsampled に基づく切り詰めは、出力される分布をdrafterの確信度の高いトークンへと偏らせてしまいます。1
EAGLE-2がドラフトツリーを構築する際にdrafter自身の確率を直接使用するのとは異なり、なぜフィットを行うのかという理由は、 qmax 「no fit」の行は、EAGLE-2がドラフトツリーを構築する際に行っているように、drafter自身の確率を直接使用するのではなく、そもそもなぜfit(学習)を行うのかを示しています。直接使用した場合、drafterのトップトークン確率は、訓練されたconfidence headよりも実際にはドラフトのランク付けに優れています(0.8259 対 0.8191 AUC)。しかし、その較正は十分ではありません。ラベル付きドラフト全体での平均予測値は0.784であるのに対し、観測された受理率は0.723であり、そのECEは出荷されているlogit(の7倍悪くなっています。qmax) 特徴量の7倍悪い値です(0.0736 対 0.0100)。drafterのトップトークン確率は、drafterが自身の予測にどれだけ自信を持っているかのみを反映しており、ターゲットモデルが同意するかどうかは反映していません。この一致度は、サンプリング設定やワークロードにもさらに影響されます。オンラインでのフィットは、ターゲットの受理/棄却の決定からこのマッピングを直接学習し、より良い較正をもたらします。予算の決定が依存しているのはまさにこの較正なのです。
最終的には、logit(qmax) 特徴量を採用しました。これは妥当なコストでAUCとECEの良いバランスを持っています。また、推定しようとしていた量と対数オッズのスケールおよび分解能の両方を共有していたため、自然な選択でもありました。
訓練されたConfidence Headとの比較
上の表に示されているとおり、DeepSeek-V4-Flash + DSpark では、推定量は AUC と対数尤度損失の両方で confidence head を上回るものの、ECE では下回っています。以下の表はその差をまとめたものです:
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| 推定量 logit(qmax) | 0.8336 | 0.4284 | 0.0100 |
| 訓練済み confidence head | 0.8191 | 0.4449 | 0.0052 |
| Δ (estimator − head) | +0.0146 | −0.0166 | +0.0048 |
しかし、最初のドラフトを平均から除外すると、状況は大きく変わります:
| AUC ↑ | log-loss ↓ | ECE ↓ | |
|---|---|---|---|
| 推定量 logit(qmax) | 0.8352 | 0.4420 | 0.0103 |
| 訓練済み confidence head | 0.8075 | 0.4743 | 0.0090 |
| Δ (estimator − head) | +0.0278 | −0.0323 | +0.0013 |
head と推定量は、キャリブレーションではほぼ互角になりました。位置ごとの AUC の内訳が、その理由を説明するのに役立ちます:
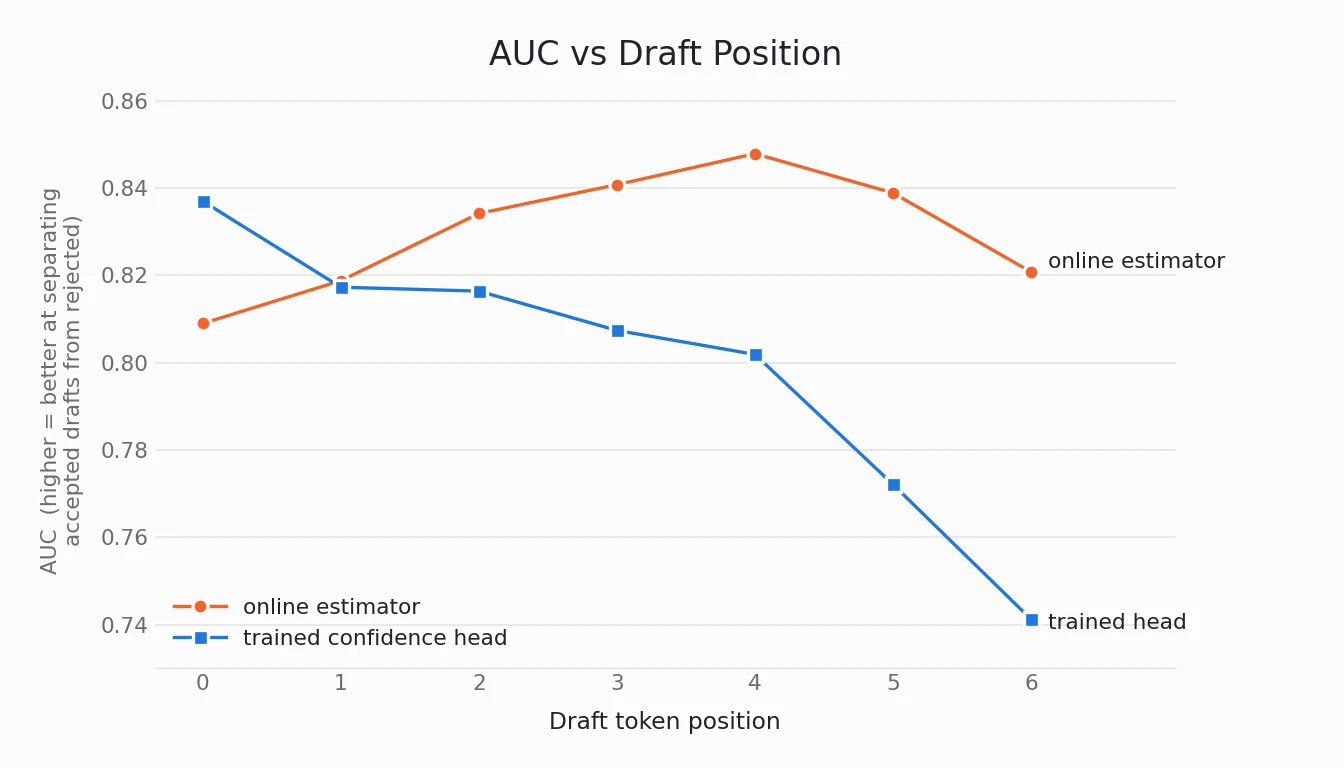
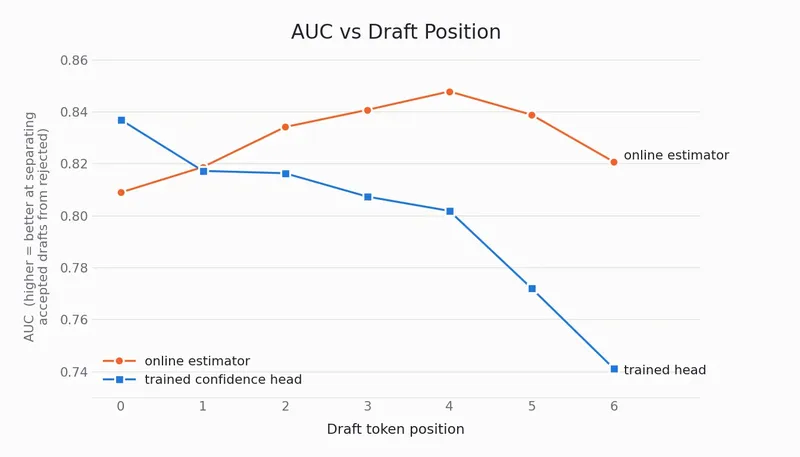
confidence head は最初のドラフト位置ではより優れた予測器ですが、推定量は 2 番目の位置以降でリードします。この差は深さとともに広がり、最後の位置では推定量が 0.08 AUC 分リードします。また、両方の予測器とも 5 番目の位置を過ぎると低下します。これはおそらく、DSV4-Flash の DSpark がブロックサイズを 5 と宣言しており、drafter がそれを超えて訓練されたことがないため、ドラフト自体がそこで劣化するからです。
survival は連乗であり、最初のドラフト位置は常にリクエストで最も高いスコアを持つため、予算によって切り詰められるトークンになることは比較的少ありません。推定量の優位性はまさにトリミングが行われる位置にあり、それが推定量がエンドツーエンドの性能で confidence head に匹敵できる理由を説明しています。
係数のフィッティング
係数 ω と βi は、リクエストのライブサービス中に継続的に再フィッティングされます。前の decode ステップで提案されたドラフトトークンは、次の decode ステップでターゲットモデルによって検証されます。最初の拒否まで(あれば)のドラフトトークンのみが訓練の対象となります。これは、ターゲットモデルがそれらを明示的にラベル付け(accept または reject)しているからです。
予測とラベルの対数尤度損失を最小化するために、Iteratively Reweighted Least Squares (IRLS) を使用します。この最小化は、対数尤度損失の 2 次のテイラー近似を用いて行われます。ω と βi の最適化ステップは、連立方程式を解くことで得られます
ここで Δθ は、共有の傾き ω と位置ごとの切片 β に対する差分ですi, H は損失関数のヘシアンで、形状は (K + 1) × (K + 1) であり、 g は損失関数の勾配で、サイズは K + 1.
固定の N デコードステップごとに再フィットが行われます。その区間の各デコードステップでは、そのラウンド中に収集された係数、特徴量、ラベルから導かれるヘシアンと勾配の値を蓄積します。これにより、メモリはラウンド全体で O(K²) に抑えられ、生のラベルを代わりに収集した場合の O(N × B × K) とは対照的です。ラウンドの最後のステップで連立方程式が解かれ、係数が更新されます。
予想どおり、深いドラフトは浅いドラフトよりも受け入れられる頻度が低くなります。その結果、ラウンド中に深いドラフト位置はラベルを欠乏させることがあります。この影響を再フィット処理において緩和するため、2つの設計上の決定がなされました:
- Shared Slope: 傾きはすべてのドラフト位置で共有されます。これは、深さ方向でデータが薄くなることによるノイズの多い更新を防ぐためです。予測は切片の誤差よりも傾きの誤りにはるかに敏感であるため、共有によってニュートンステップが適切に定まります。さらに、実測によれば、傾きを共有しても精度面のコストは事実上ゼロです(AUCでわずか 0.0002、log-lossで 0.0003)。
- Step Damping: 各係数の更新は、サポートする証拠の量に応じてスケーリングされます。その式は n / (n + constant) であり、ここで n は評価済みドラフトの数です。これにより、ラベルの少ない深い位置ほど保守的に動き、ノイズに基づく更新が防止されます。
Slope vs Intercept Roles
複数のモデル/データセットの組み合わせにわたってフィットされた係数を追跡したところ、2種類のパラメータは非常に異なる挙動を示しました。
モデルのペアを固定し、ワークロードを変える5つのワークロードそれぞれに対してDSV4-Flash + DSparkを個別にフィッティングすると、傾きはほとんど動かず(0.51から0.55)、ワークロードの難易度と相関しない(平均ドラフトエントロピーに対して r = −0.08)。切片は逆の動きをする:最初のドラフト位置の切片はドラフトエントロピーと r = −0.89 で相関し、予測しやすいワークロードでは約0.5〜0.6だったものが、最も予測しにくいワークロードでは0未満まで下がる。
| データセット | 受理率 | 平均ドラフトエントロピー | 傾き ω | 切片 β0 |
|---|---|---|---|---|
| gsm8k | 0.781 | 0.562 | 0.5365 | +0.478 |
| humaneval | 0.751 | 0.669 | 0.5135 | +0.486 |
| speed-bench 2k low-entropy | 0.755 | 0.703 | 0.5087 | +0.610 |
| mt-bench | 0.714 | 0.800 | 0.5495 | +0.181 |
| speed-bench 2k high-entropy | 0.642 | 1.077 | 0.5197 | −0.089 |
次にモデルペアを変えてみます: 傾きはペア間で 0.45 から 0.59 の範囲にありますが、各ペア内では狭い範囲に収まっています。切片もペア間で異なっており、したがって傾きとは異なり、切片は一方の軸だけの性質ではありません。
| モデル | nspec | 傾き ω | ω sd | 切片 β0 |
|---|---|---|---|---|
| DeepSeek-V4-Flash + DSpark | 5 | 0.5013 | 0.0250 | +0.279 |
| MiMo-V2.5-Pro-FP4 + DFlash | 8 | 0.5197 | 0.0415 | −1.000 |
| Inkling-NVFP4 + MTP | 8 | 0.5859 | 0.0349 | −0.572 |
| Muse-Glimmer-30B + DFlash2 | 7 | 0.4450 | 0.0323 | +0.167 |
この2つの表を併せて読むと、分担関係が見えてきます。傾きは、ドラフトモデルが自分が正しいことをどれだけ正確に把握できているかを測る指標です。これはターゲット/ドラフトのペアとドラフトサンプリング方法の性質であり、だからこそワークロードだけを変えてもほとんど変動しません。残りは切片が吸収します。それは各ドラフト位置におけるベースの受理率であり、深さが増すにつれて低下し、予測しにくいコンテンツではさらに大きく下がります。このベースの受理率はモデルペアとワークロードの両方に依存するため、切片は両方の軸に沿って動くのに対し、傾きは一方の軸に沿ってしか動きません。
ベンチマーク
我々は、これまでまったく AV を利用できなかった 3 つのチェックポイント(MiMo-V2.5-Pro-FP4 + DFlash、Inkling-NVFP4 + MTP、Muse-Glimmer-30B + DFlash2)に加え、リファレンスとして DSV4-Flash + DSpark + 推定器、および DSV4-Flash + DSpark + 信頼度ヘッドをベンチマークしました。以下の利得は、AV オフとオンの比較、temperature 1.0、top-p 0.95、同時実行数 64 の条件で、4 つのデータセット上で計測したものです。
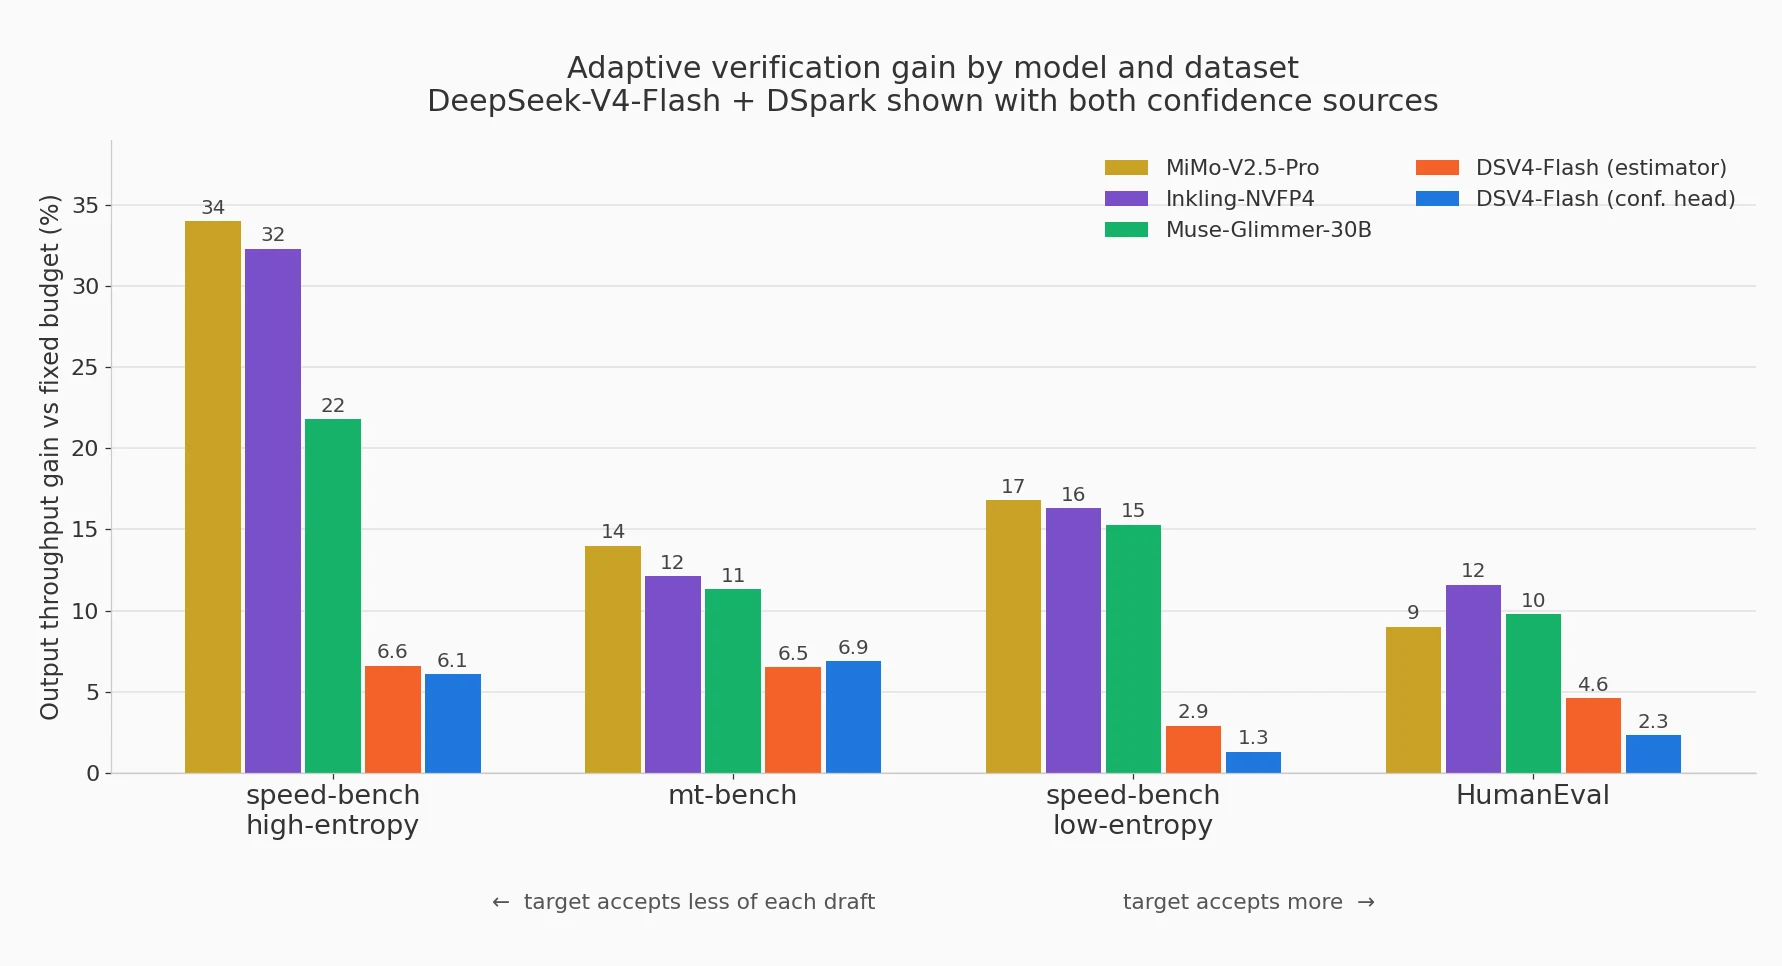
固定検証と比較すると、同じスペキュレーティブ長でのオンライン推定器は、ベンチマークしたすべてのデータセットで優位です。ただし、この利得だけでは全体像はわかりません。多くの場合、特定の同時実行数においては、最大スペキュレーティブ長の AV よりも優れた性能を示す、より小さい固定長が見つかることがあります。以下のパレート曲線は、DSV4 + DSpark について、固定スペキュレーティブ長のスイープと最大スペキュレーティブ長での AV を比較して計測したものです:
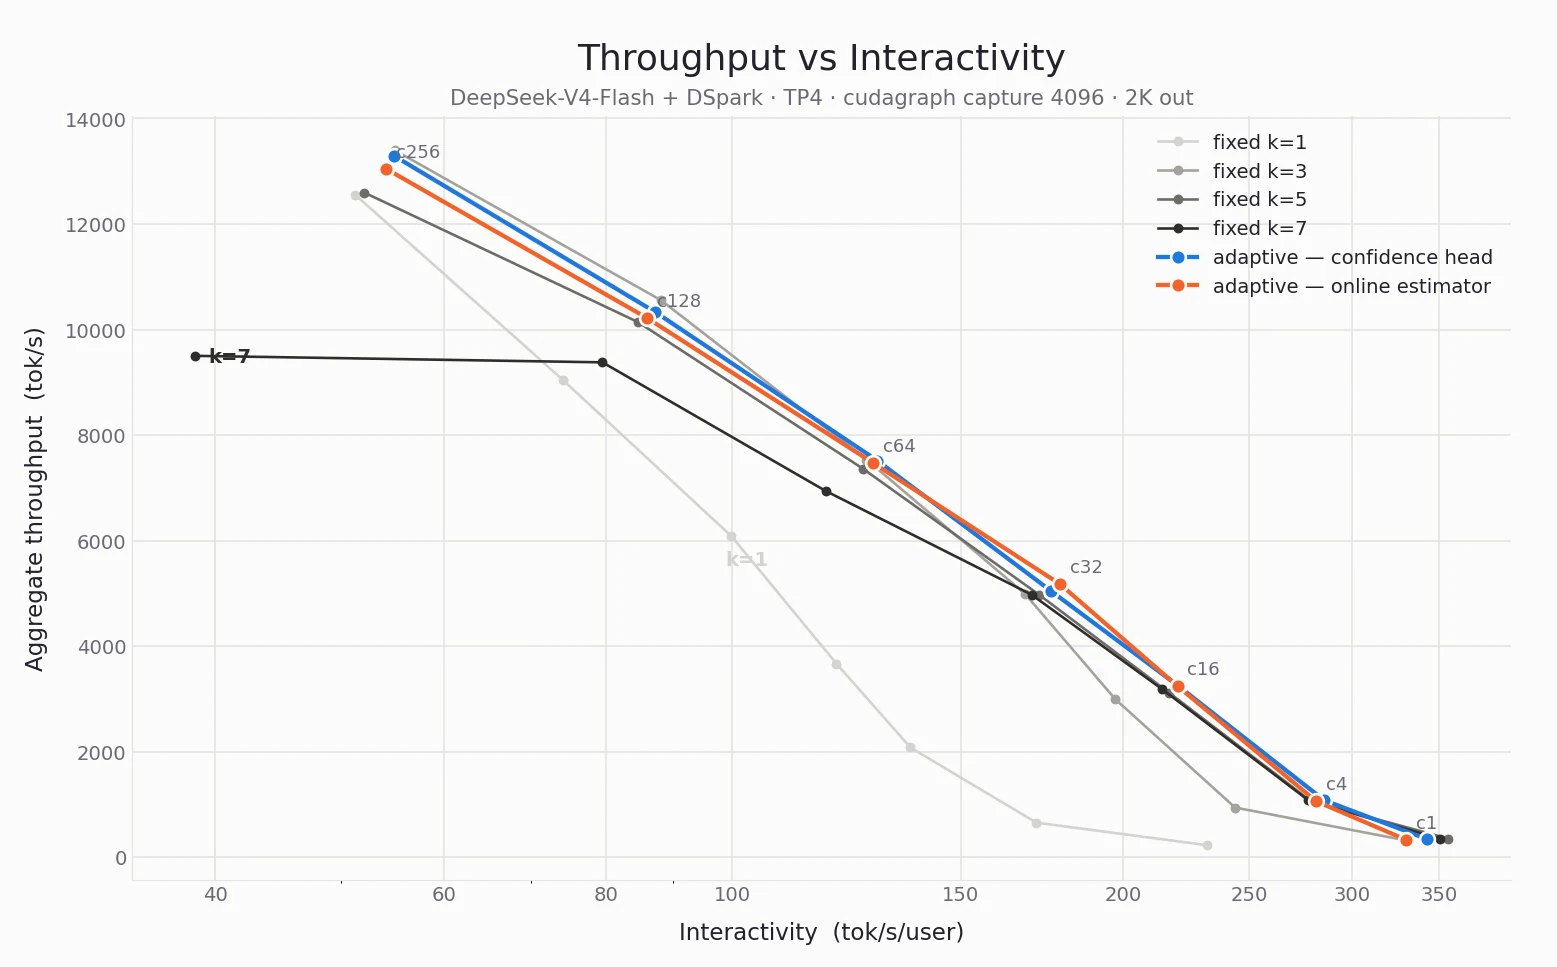
オンライン推定器と信頼度ヘッドは、測定したすべての同時実行数において、性能面でおおむね同等です。ただし、オンライン推定器は信頼度ヘッドの代替として意図されたものではなく、信頼度ヘッドが存在しない場合のドロップイン代替です。現在信頼度ヘッドを持たないモデルペアでどのように機能するか見てみましょう。以下は、MiMo-V2.5-Pro-FP4 + DFlash について、固定スペキュレーティブ長のスイープと AV を比較したパレート曲線です:
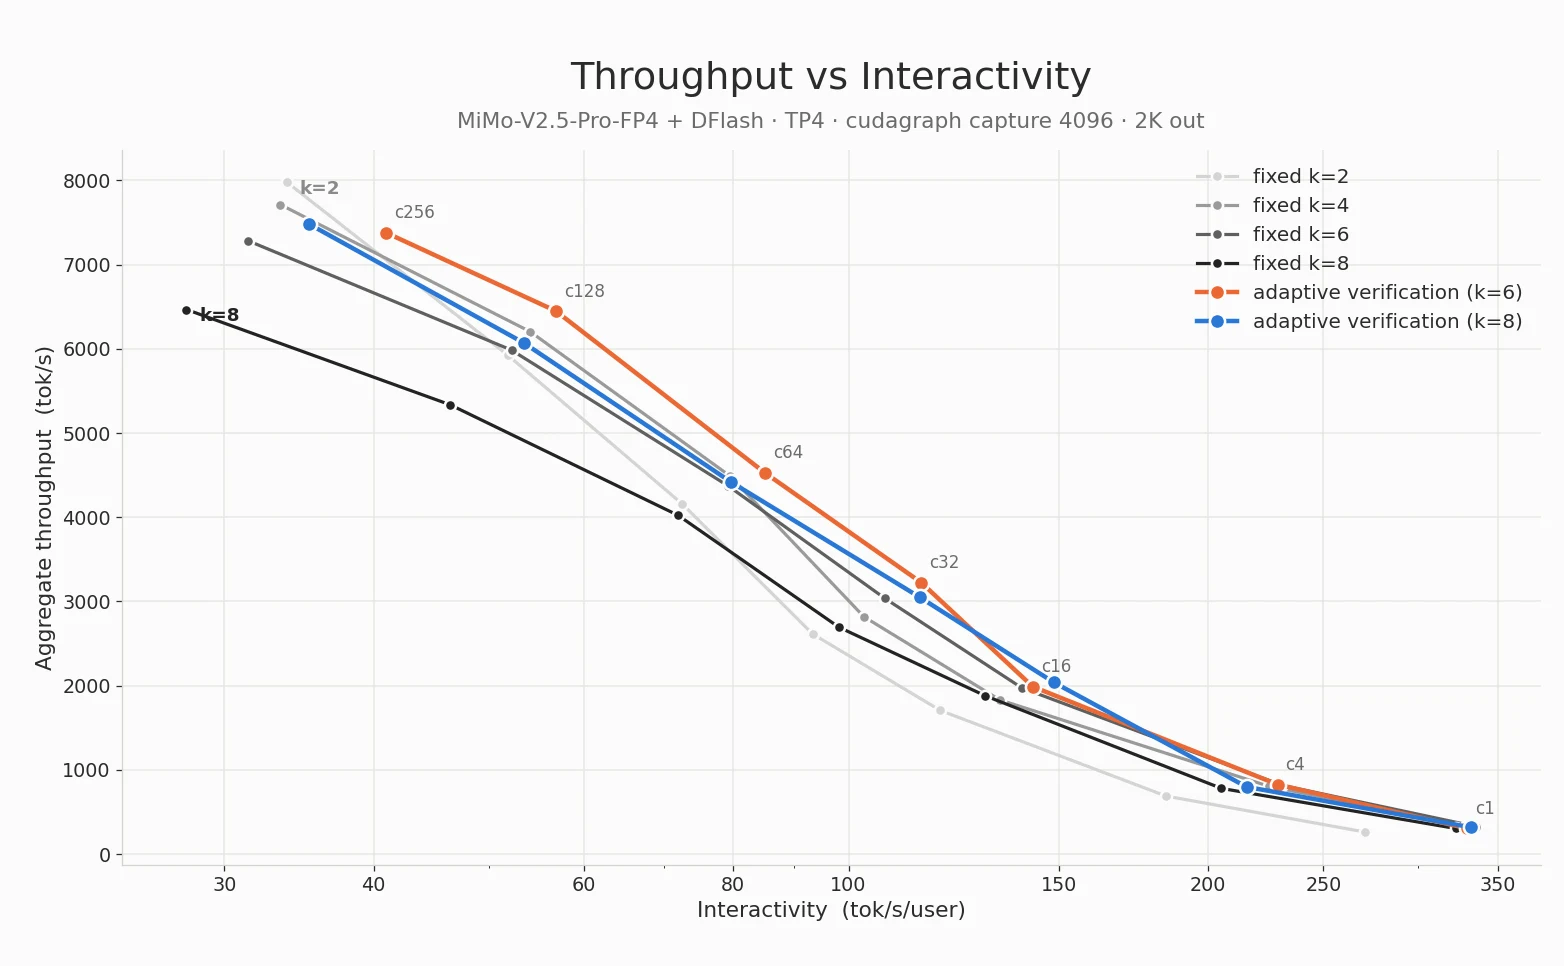
AV は 7 つの同時実行数のうち 5 つで、スループット-インタラクティビティフロンティア上に位置しています。
制限事項
- ターゲットモデルのアテンションバックエンドが可変長検証をサポートしている必要があります。これは DSpark AV がすでに持っているのと同じ前提条件です。
- MTP と EAGLE は、DFlash や DSpark ほど AV の恩恵を受けません。これは、これらの自己回帰型スペキュレータでは、検証前に切り詰められる可能性のあるトークンのドラフトに、相対的に大きなコストがかかるためです。
vLLM での使用
AV は speculative config を通じて有効化されます。(1) 信頼度ヘッドを持たず、かつ (2) すべてのバックエンドで可変長アテンションをサポートするドラフトモデルでは、オンライン推定器が自動的に選択されます:
vllm serve <target_model> \
  ...
  --speculative-config '{
    "model": "<draft_model>",
    "method": "<method>",
    "num_speculative_tokens": <num_speculative_tokens>,
    "draft_sample_method": "probabilistic",
    "enable_adaptive_verification": true
  }'
謝辞
この研究は Giancarlo Delfin(Inferact)によって行われたものであり、Lucas Wilkinson(Red Hat)および Benjamin Chislett(NVIDIA)による Adaptive Verification を直接基盤としている。
脚注
-
単純な2トークンの語彙 [a, b] を用いた例で、このバイアスを説明できる。 p = [0.5, 0.5], q = [0.2, 0.8] とし、ドラフトトークンが検証で除去される条件を q(x) < 0.5 とする。 a を引くと除去され、ターゲットは自身の分布 p(x) からトークンをサンプルする。一方、 b を引くと検証となる:トークンは min(1, p(b)/q(b)) = 0.625 の確率で受理され、そうでなければ拒否され、残差分布 norm(max(0, p − q)) = [1, 0] から再サンプルされ、 aが得られる。棄却サンプリング中に得られるのは pout(a) = q(a)·p(a) + q(b)·(1 − 0.625) = 0.4 であり、 pout(b) = q(a)·p(b) + q(b)·0.625 = 0.6 となります。これはターゲットの分布 [0.5, 0.5] とは異なり、推測的デコーディングのロスレス保証に違反します。 ↩