
要点
- 評価(Evals)はエージェントの実行をスコア化することで、期待どおりに動作しているかを確認できるようにします。 始めるには、1つの動作を選び、実際のトレースから小さなデータセットを作成し、ベースラインを実行します。リリース前にはオフライン評価を、本番環境ではオンライン評価を使用し、新たな失敗をデータセットの例に変えていきます。
- 可能な限りコード評価器を使い、使えない場所ではLLMジャッジを、そして両者を検証するために人間によるレビューを用います。 多くのステップを踏むエージェントについては、スレッド全体、軌跡、そして最終状態を評価します。
- Terminal-Bench のようなベンチマークは、より長いタスクと独自の環境を備えたオフライン評価です。 Harbor はそれらを実行し、結果を LangSmith の実験(experiments)に記録します。
エージェントを構築してリリースするにあたり、開発中だけでなく、実際のユーザーがそれに依存し始めてからも、期待どおりに動作しているかを確認する方法が必要になります。
従来のソフトウェアでは、同じ入力は同じ出力を生むため、ユニットテストで正確な結果をチェックできます。エージェントはいくつかの理由でテストがより困難です:
- 実行ごとに出力が変動する、同じリクエストであっても
- 複数の回答が正解となり得るため、完全一致のチェックでは不十分
- エージェントは自らステップを選択するため、正しい出力が「誤った」経路から生じることもある。例えば、エージェントが不要なツールを呼び出したり、ユーザーの許可なくアクションを実行したりする可能性がある。
エージェント評価(Agent evals)がその解決策です。これらのバリエーションを考慮したチェックによって、エージェントの実行をスコア化します。評価対象のエージェントと同様に、これらのテストは画一的なものではなく、最適な評価スイートはチーム、その製品、そして何を最適化したいかによって異なります。
ここ数年、LangChain のエージェントエンジニアリング向けプラットフォームである LangSmithに取り組む中で、私たちのチームは 数多くの さまざまな評価に関する質問に直面してきました。本ブログでは、エージェント評価の始め方や、ワークフローで使用できるさまざまな種類の評価に関する最もよくある質問を取り上げます。
どこから始めるべきか?
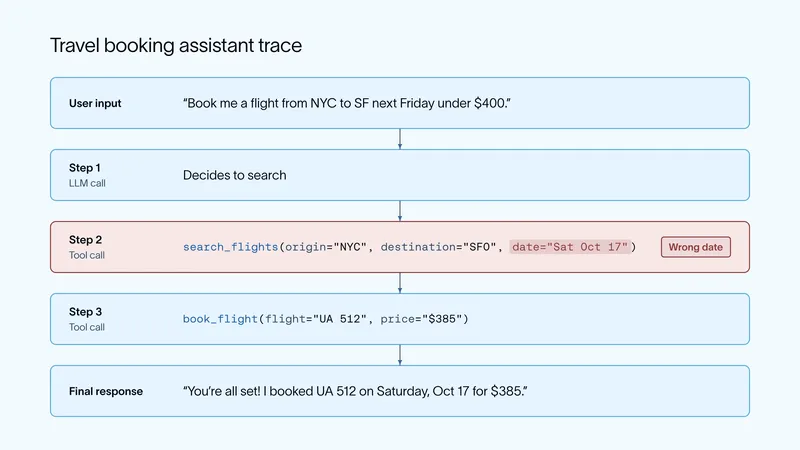
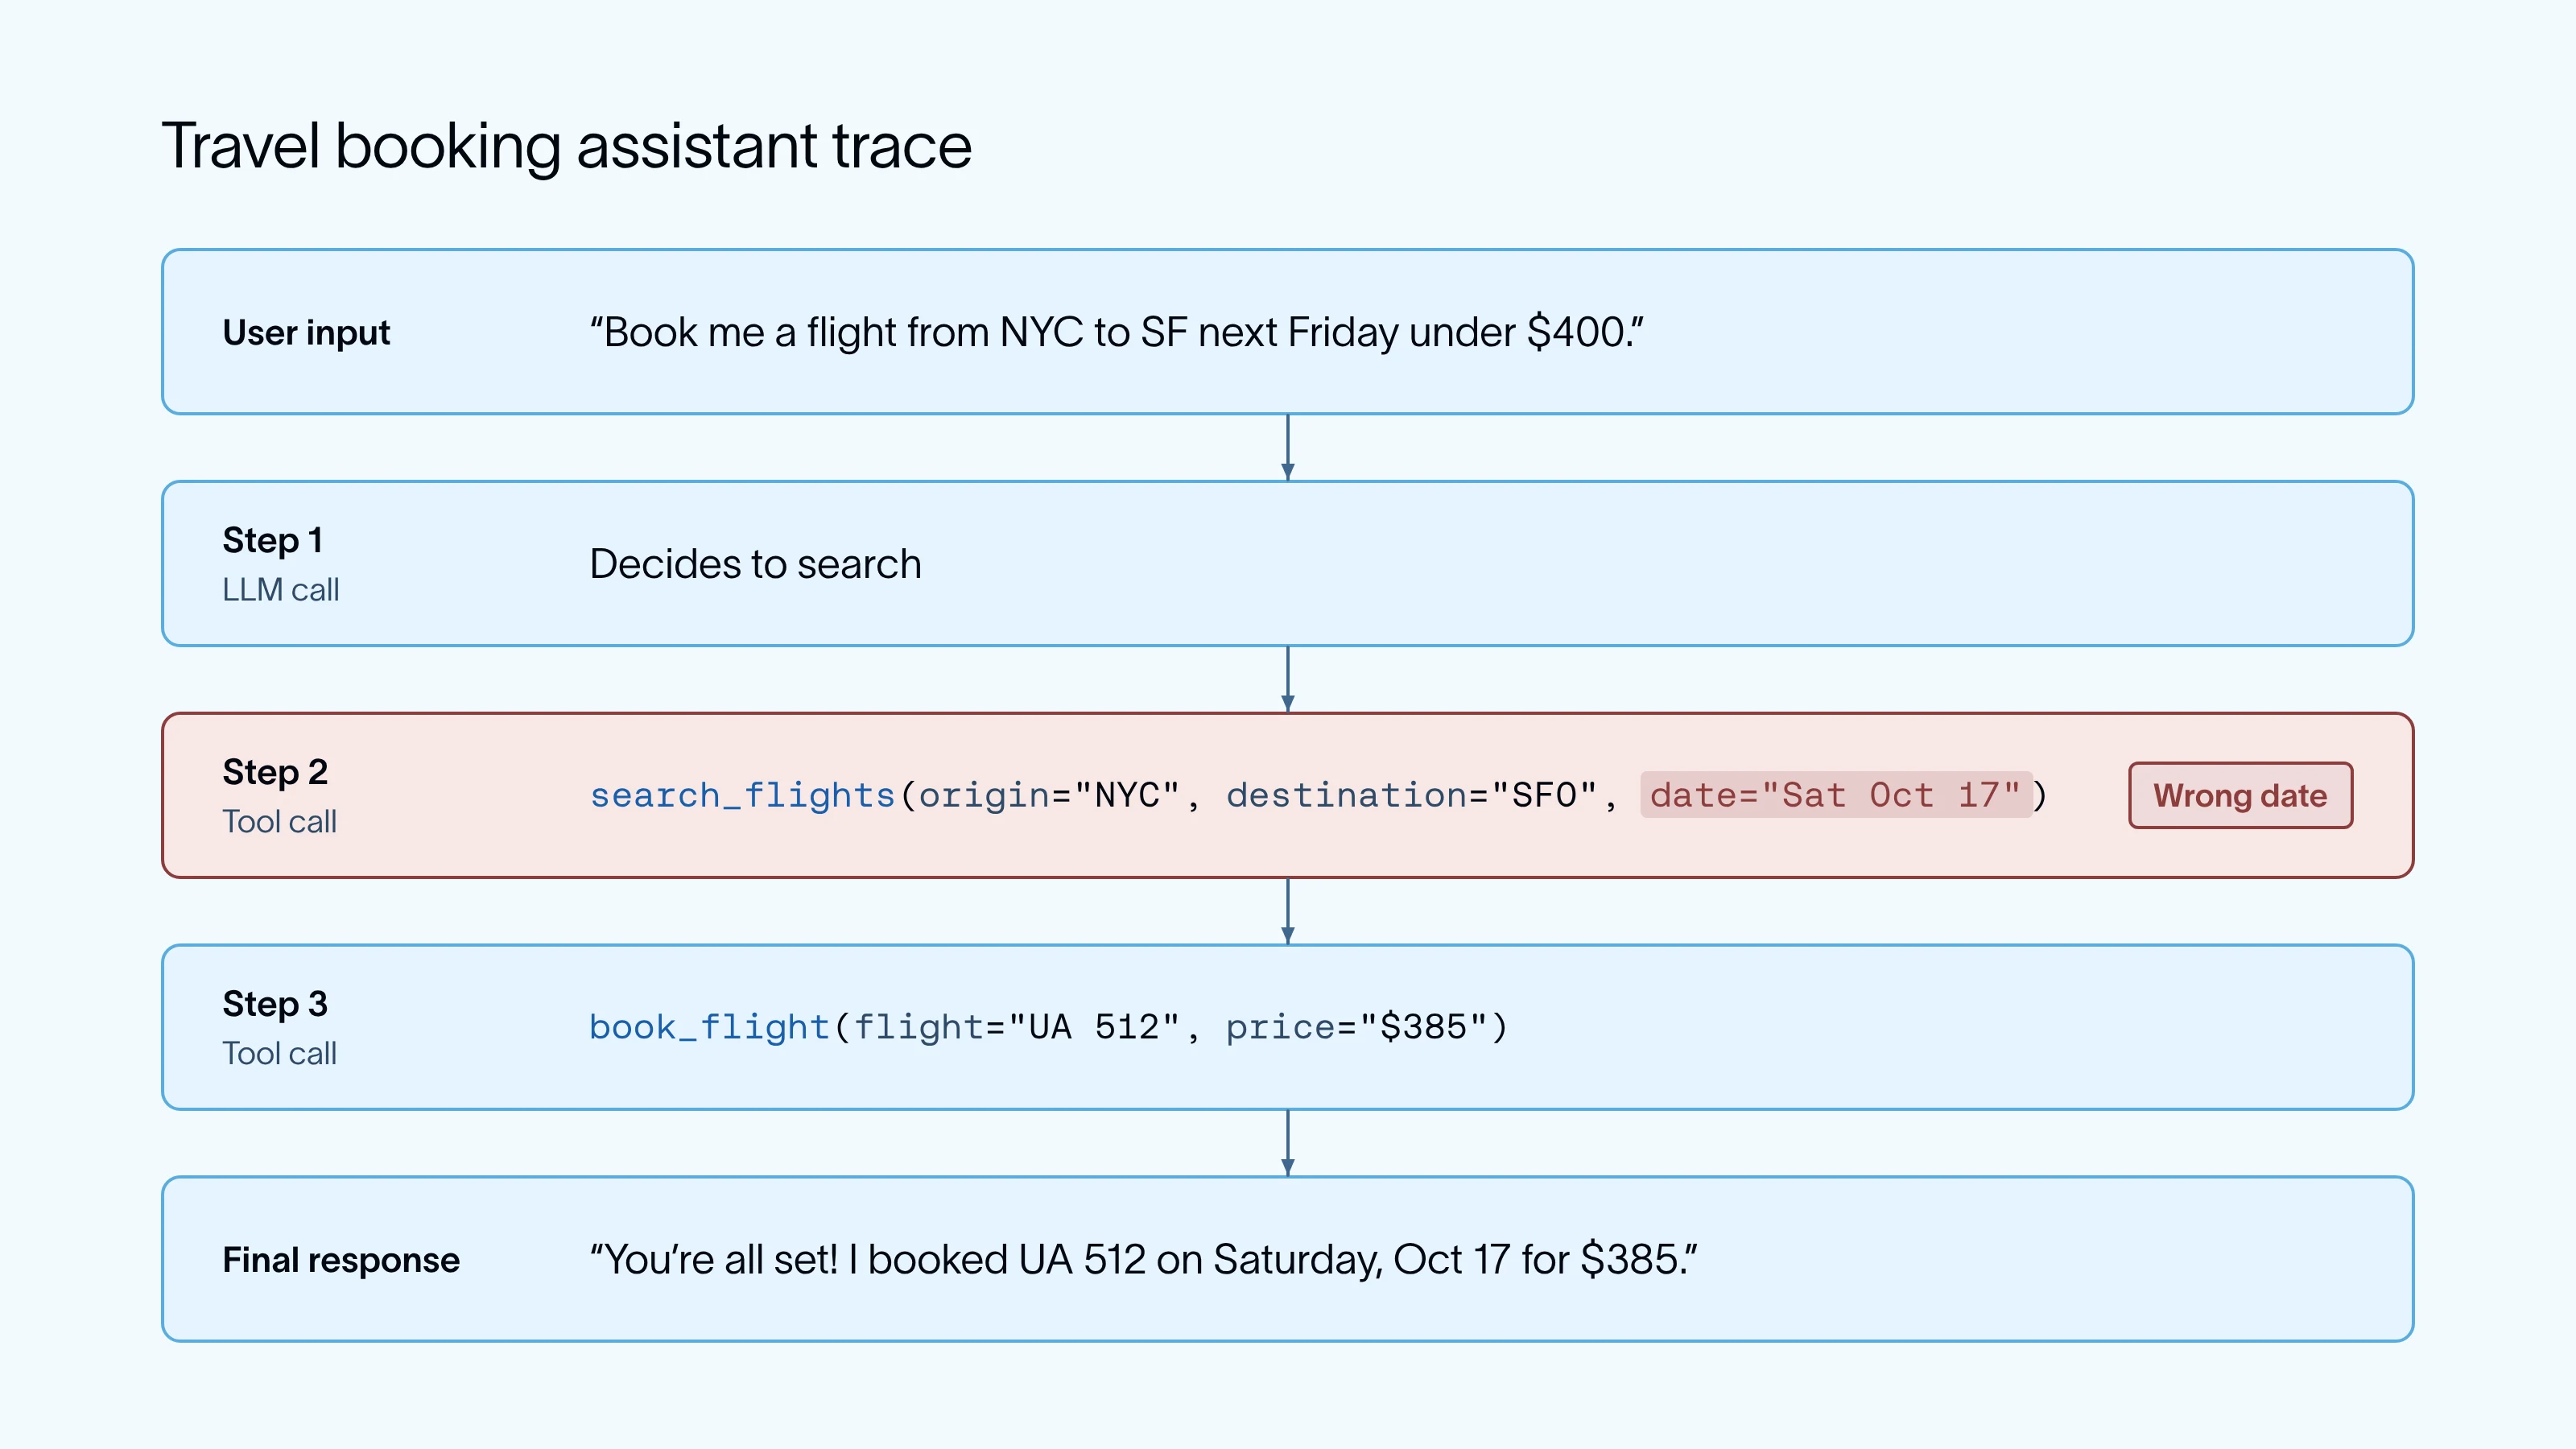
すべての評価は、エージェントが実際に何をしているかを理解することから始まります。トレースとは、エージェントの1回の実行の記録であり、入力、出力、そして間にあるすべてのモデル呼び出しとツール呼び出しを含みます。トレースのサンプルを読み、リクエストをどのように処理しているか、どこで問題が起きているかを確認してください。そこで見つかったことが、最初にテストすべき内容を教えてくれます。小さく始めましょう。
- 重要と思う動作を1つ選びます。 例えば、旅行アシスタントであれば、ユーザーが求めた日付と価格帯を予約するかどうかが動作の例になります。
- トレースから小さなデータセットを作成します。 データセットは例の集まりであり、各例は入力(多くの場合は期待される出力も伴う)を持つ1つのテストケースです。1つの動作につき10〜20例あれば始めるには十分で、LangSmith ではトレーシングビューから直接データセットにトレースを追加できます。エージェントがまだ本番環境にない場合は、チームや少数の信頼できるデザインパートナーにテストしてもらい(ドッグフーディング)、そのトレースを元に作業してください。
- ベースラインを実行します。 現在のエージェントをデータセットに対して実行し、その結果を実験(experiment)として保存します。実験には、あるバージョンのエージェントをデータセット上で実行した結果と、評価器によるスコアが含まれます。今後のエージェントのバージョンのパフォーマンスを、この実験と比較することになります。
- 新しい失敗を見つけたら追加していきます。 テスト中または本番環境で目にする失敗は、それぞれが新しい例となります。
データセットに失敗例を追加し続ければ、改善ループができます。失敗を見つけ、データセットに追加し、エージェントを改善して、再実行します。評価すべきエージェントの振る舞いをより多く特定するにつれ、上記と同じパターンに従って評価スイートを拡張していくことになります。
オフライン評価とオンライン評価の違いは何ですか?
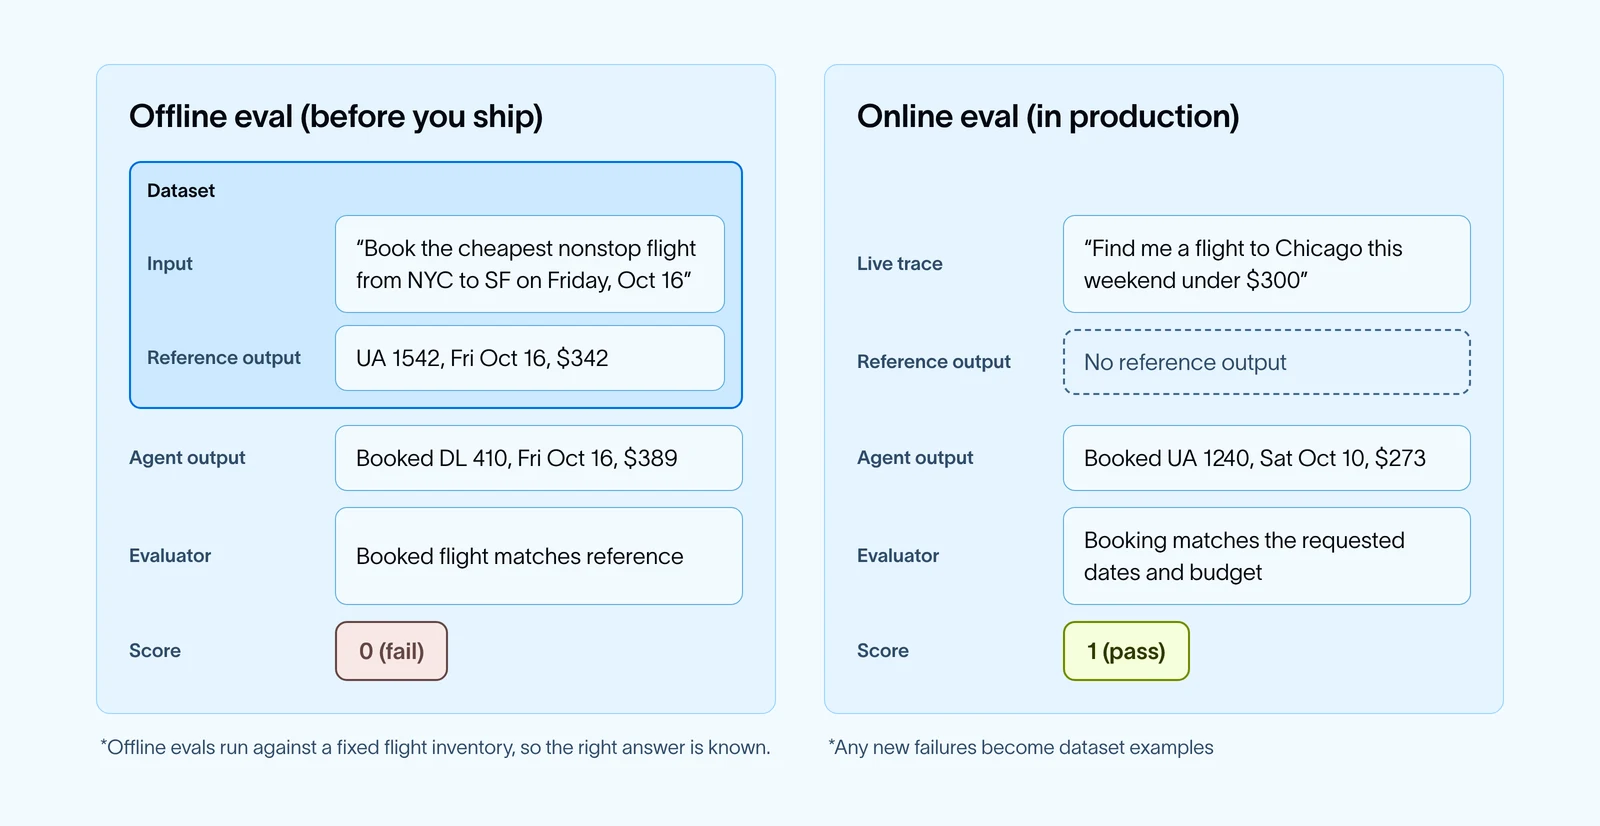
評価(Evals)は、変更をリリースする前にも、エージェントが本番稼働した後にも実行でき、また実行すべきです。リリース前には、その変更によってエージェントが良くなったのか悪くなったのかを評価が教えてくれます。リリース後には、実際のユーザーと一緒にエージェントがどのように機能しているかを評価が教えてくれます。
オフライン評価 エージェントをデータセットに対して実行する 前 変更をリリースします。例となる入力は自分で選ぶことができ、期待される出力(リファレンス出力とも呼ばれます)を含めることもできます。このデータセットを使えば、エージェントのバージョン間で実験結果を比較できます。新しいプロンプト、モデル、ツールのテストや、ユーザーに届く前のリグレッション(退行)の検出に最適です。
「のようなベンチマーク」 Terminal-Bench 固定されたタスクセットに基づいて構築されたオフライン評価もあり、エージェント、モデル、バージョンを比較できます。Harbor はこれらを実行し、結果を LangSmith の実験に記録します。詳細については後述します。
オンライン評価 実本番環境のトレースをスコアリングする 届き次第。通常、比較対象となる参照出力が存在しないため、コードチェックや、実行結果を単独で評価できるLLMジャッジに頼ることになります。これらは品質の監視や、データセットでは見逃された問題を発見するために最も効果的に使えます。
両方が必要であり、互いに補い合います。オンライン評価で検出された失敗例は、オフラインデータセットの新しいサンプルとなります。
方法はいくつかあります データセットを構築する LangSmithのオフライン評価のための機能です。例をゼロから作成したり、既存のトレースから実行を追加したり、チームが「an」でレビューした実行を送信したりできます。 アノテーションキュー、CSV または JSONL ファイルをアップロードするか、既に持っている少数の例から合成データを生成してください。
評価スイートが成長するにつれて、既存のデータセットに例を追加するか、新しいデータセットを始めるかを判断する必要が出てきます。目安として:
- 例は次の 同じデータセット 同じ評価者を使って同じ挙動をテストする際に用いられ、実験が時間を超えて比較可能に保たれます。
- 作成する 新しいデータセット 入力が異なるように見える場合(単一のリクエストと会話全体など)、異なる評価者が必要な場合、あるいはデータセットが異なる目的に使用される場合、たとえばすべてのプルリクエストで実行する小さなセットと、リリース前に実行するより大きなセットなどです。
1 つのデータセット内でも、split を使ってサブセットのサンプルを実行できます。
エージェント評価ツールにはどのような種類がありますか?
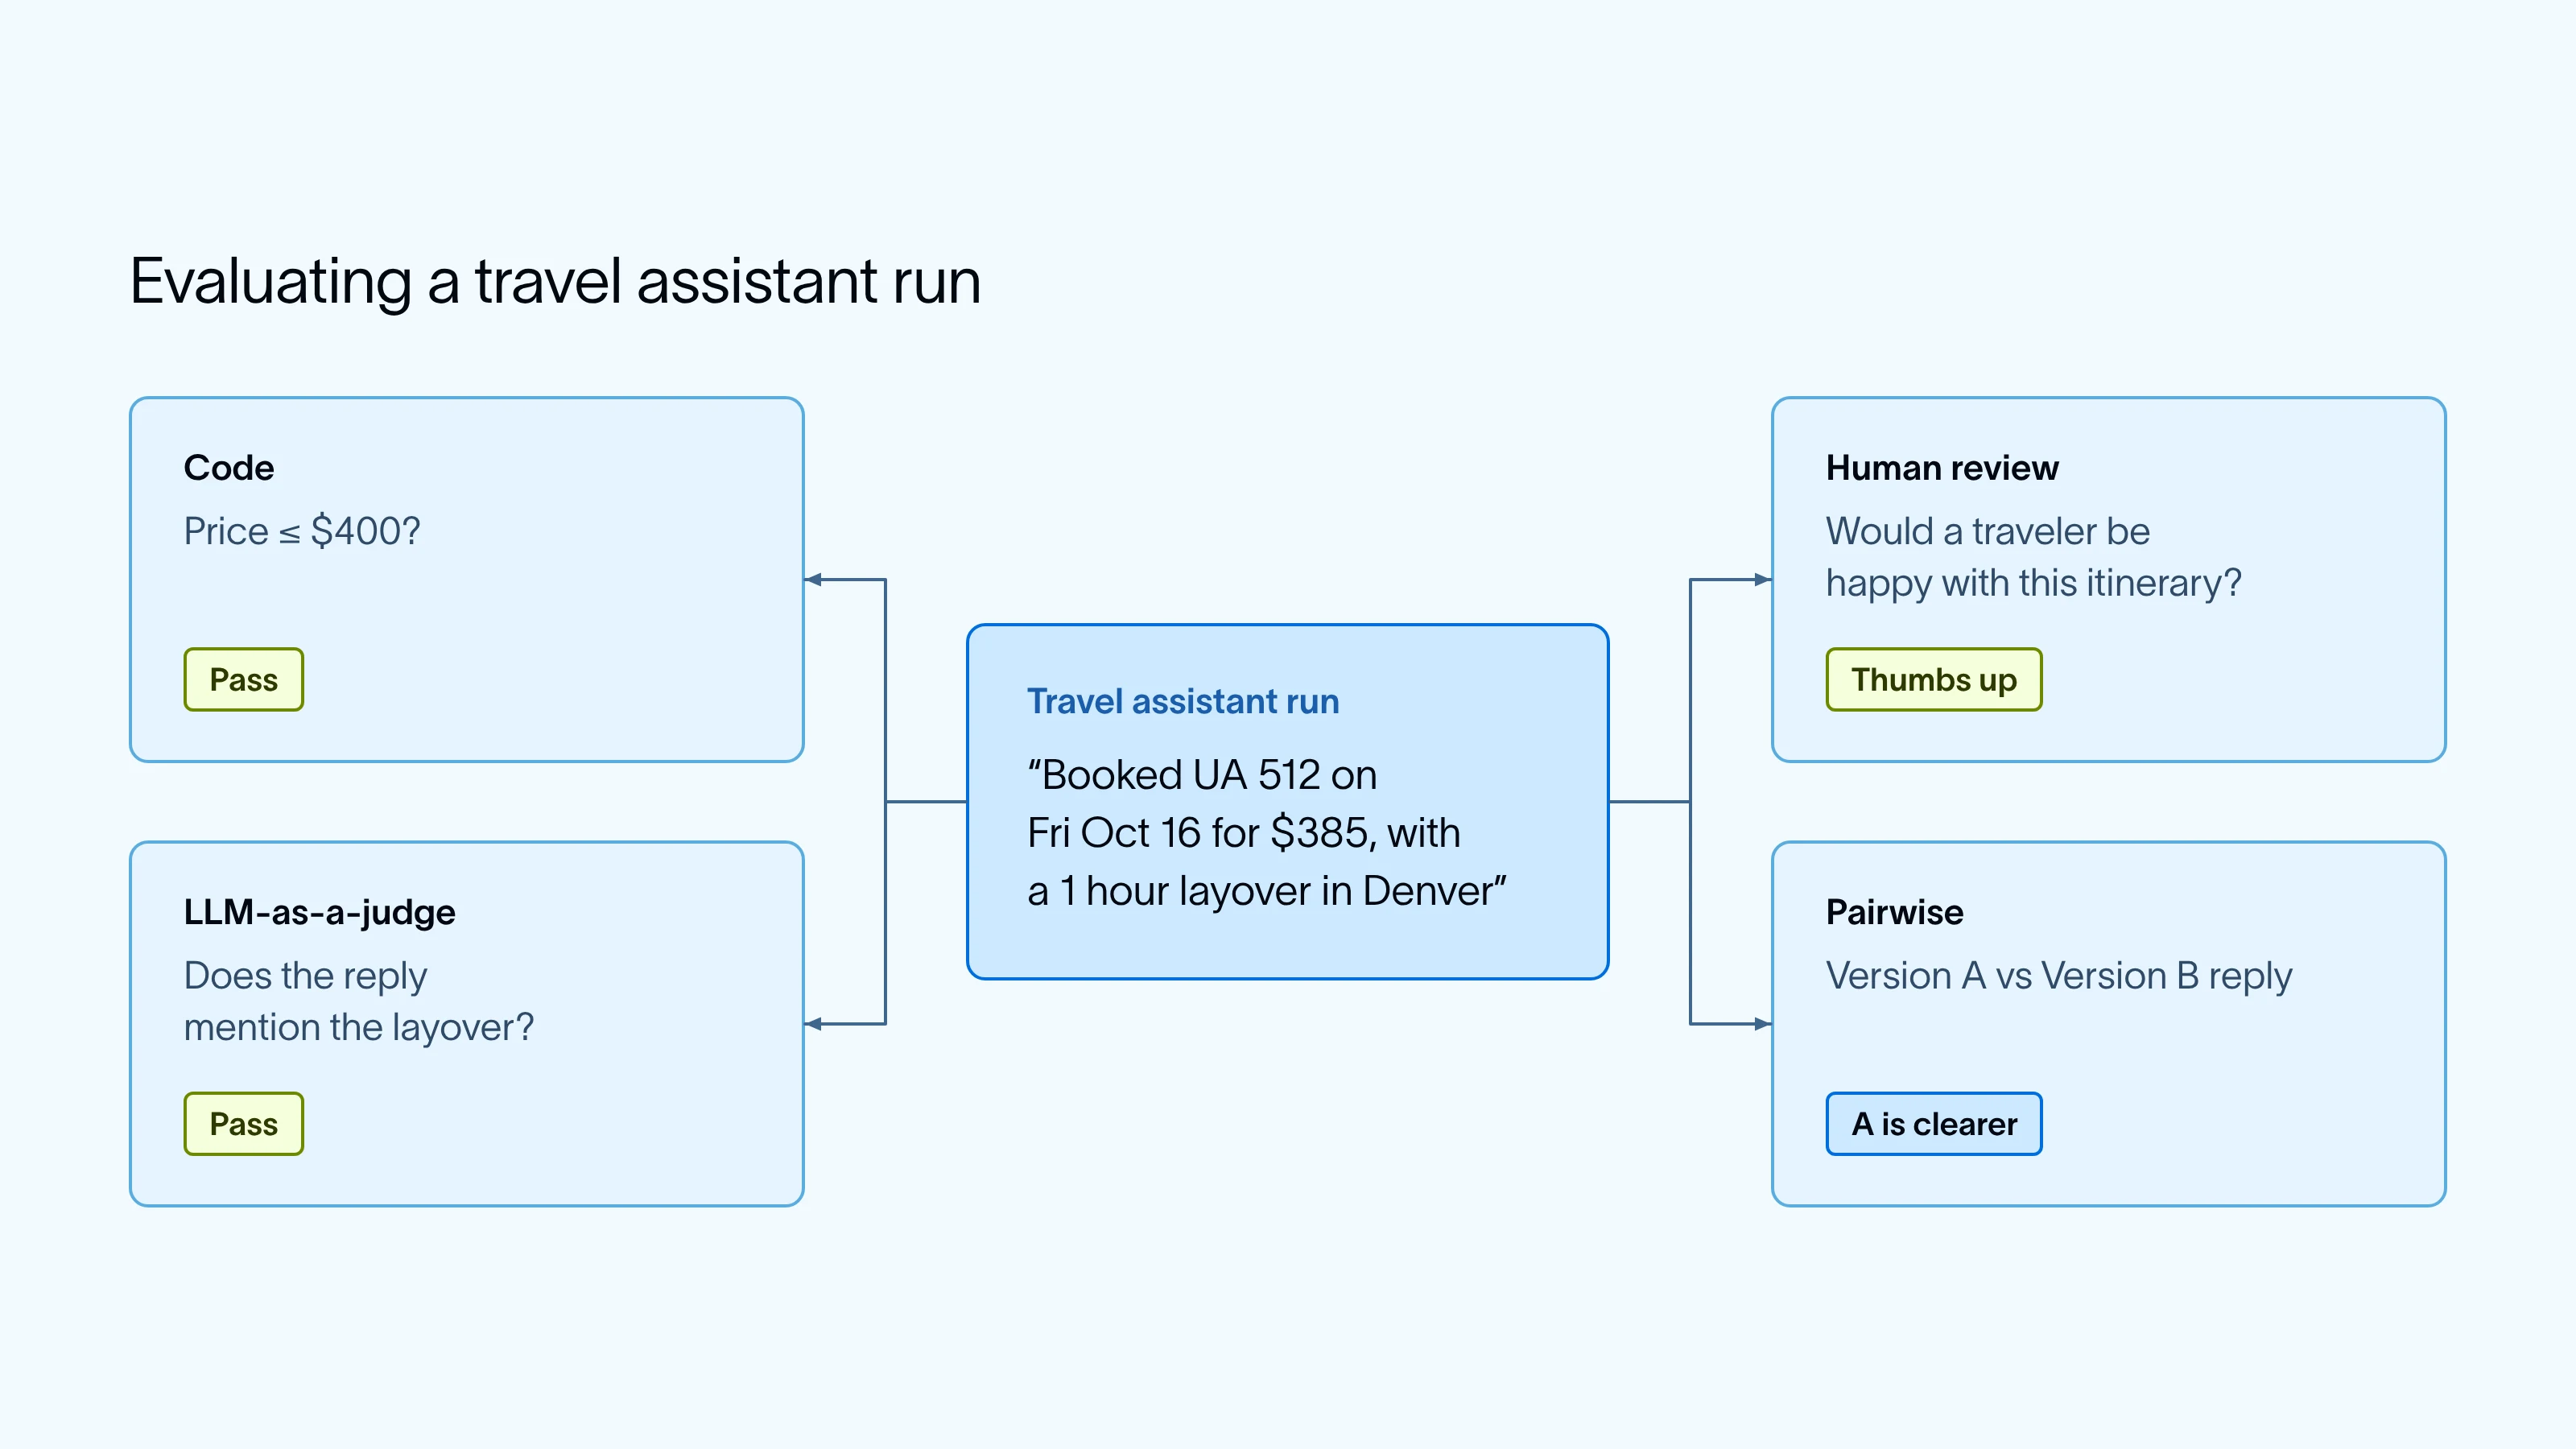
エバリュエーターとは、ランを評価・採点するロジックのことです。一般的なものには4つのタイプがあります。ほとんどのチームはまず1つか2つから始め、時間をかけて追加していきます。
- コード評価者 決定論的に事項をチェックします。例えば、予約価格がユーザーの予算内かどうかなどです。決定論的な入出力が必要とされる点で有用性は制限されますが、高速で安価かつ一貫性があります。
- LLM-as-a-judge モデルを使って、コードでは判定できない事柄——たとえばアシスタントの返信がフライトの詳細を明確に確認しているかどうか——を評価します。
- 人によるレビュー チームや Subject Matter Expert(専門家)に直接ランを採点してもらう方法です。時間はかかりますが、主観的な品質の評価や、他の評価手法の検証には最も信頼できるシグナルです。多くの場合、小規模なサンプルで行われ、その結果をもとに LLM 評価者の判断を調整します。
- ペアワイズ評価者 2つの出力を並べて比較し、より良い方を選ぶことができます。これは2つのプロンプトやモデルのどちらを選ぶか決めるときに役立ちます。
これらの評価ツールのいずれも、エージェントの実行のさまざまな部分を対象にすることができます。評価では次のような項目を採点できます:
- たった一歩。 例: Whether
search_flights正しい日付で呼び出されました。 - 最終回答。 例: 返信がエージェントが実際に予約したフライトを確認しているかどうか。
- 完全な会話。 例:最終的な予約内容が、ユーザーが複数回のやり取りにわたって求めたすべての変更を反映しているかどうか
- 環境の最終状態。 例: エージェントが自身のコンテナ内で実行した後の、モック予約システムにおける予約記録。ベンチマークではこのセットアップがよく使われており、これをコンテナ化された評価 (containerized evals) と呼ぶこともあります。
LLM判定者を信頼できますか?
LLMジャッジは、コードでは検証しにくい出力—たとえば回答が検索で取得したドキュメントに裏付けられているかどうか—を採点するためにモデルを使用します。ジャッジは柔軟ですが、一貫性がなくなり、チームの判断から乖離することがあります。いくつかの習慣によって信頼性を高められます:
- 裁判官の出すスコアと人間のスコアを比較する。 チームのメンバーにランのサンプルを採点してもらい、judgeが食い違う箇所を確認してください。両者が一致するまで、judgeのプロンプトや例を調整してください。 アノテーションキュー LangSmith ではこれを簡単に行えます。私たちの LLM-as-a-judge ドキュメント この件についてご案内いたします。
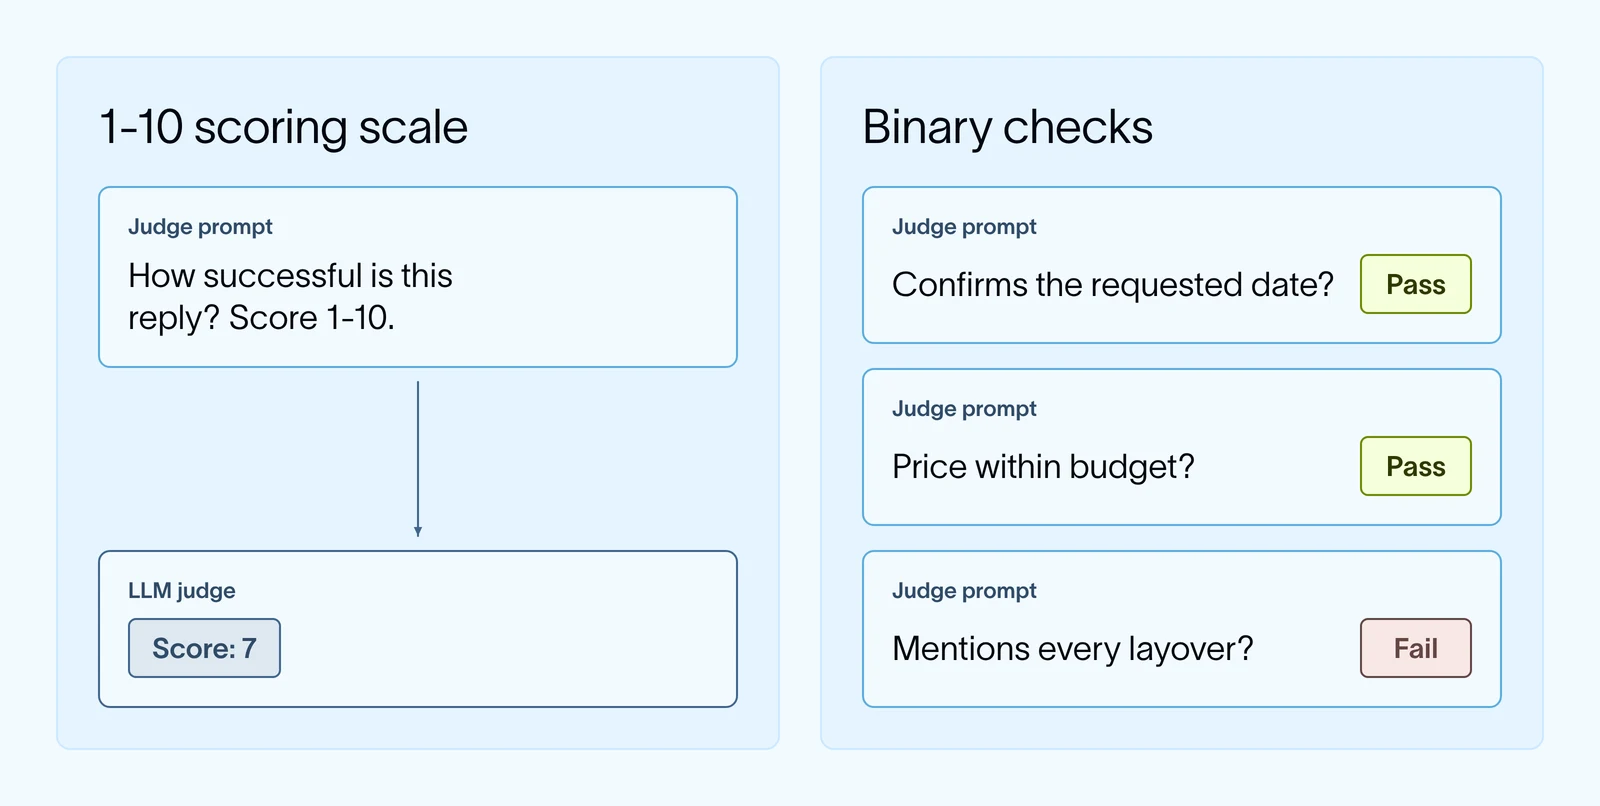
- 具体的な質問をしましょう。 旅行代理店の例では、「この返答はすべての乗り継ぎ地に言及しているか?」と問う方が、「これは良い返答か?」と問うよりも判断しやすくなります。
- 明確なスコアリング尺度を定義しましょう。 合否の二値判定や、少数のラベル付きカテゴリーによる評価は、1から10のスケールでの採点よりもはるかに再現性が高い。ジャッジは6点と7点の違いを区別するのに苦労することがある。
評価(evals)はベンチマークと同じものですか?
ベンチマークとは、一連のタスクで構成されるオフライン評価の一種です。タスクとはベンチマークにおける単一のテストケースであり、指示、コンテナ内の環境、そして結果を採点するテストスクリプトを含みます。エージェントがより高性能になるにつれ、単純なLLMジャッジやコードベースの評価では不十分なことが多くなります。エージェントは now コードを実行し、ファイルを編集し、サービスとインターフェースで連携できるようになっています。このような複数ステップの挙動をモデル化するために、ベンチマークはコンテナ内に隔離されたインフラをセットアップします。これにより、開発者は本番環境でエージェントが動作するのと同じ方法で、エージェントの挙動をオフラインでテストできます。
ベンチマークは、より単純なLLMジャッジやコードベースの評価とは、いくつかの点で異なります:
- タスクにはより多くのステップが含まれます。 単一のタスクを完了するために、エージェントは何十回ものツール呼び出しにわたってパッケージのインストール、ファイルの編集、コマンドの実行を行う可能性があります。
- 各タスクには環境が付属しています。 エージェントは現在、コードリポジトリ、ファイル、ツールを備えたサンドボックスのような環境でアクションを実行できるようになりました。すべてのタスクには、エージェントが作業するための専用の分離環境が付属します。
- スコアリングは、エージェントが何を行ったかを検証します。 テストスクリプトは、実行後の環境の状態を検査します。たとえば、テストが合格したか、正しいファイルが存在するかなどです。トレースを確認することは依然として可能ですが、スコアはエージェントが実行したアクションと、その結果残された状態から算出されます。
私たちの旅行アシスタントの場合、ベンチマークタスクでは、エージェントにモックの予約システムを与え、「暴風雨のため旅行者のデンバー行きのフライトがキャンセルされました。再予約し、それに合わせてホテルも変更してください」といったリクエストを出すといったものが考えられます。エージェントが処理を終えたら、テストスクリプトがデータベース内の予約記録を確認します。
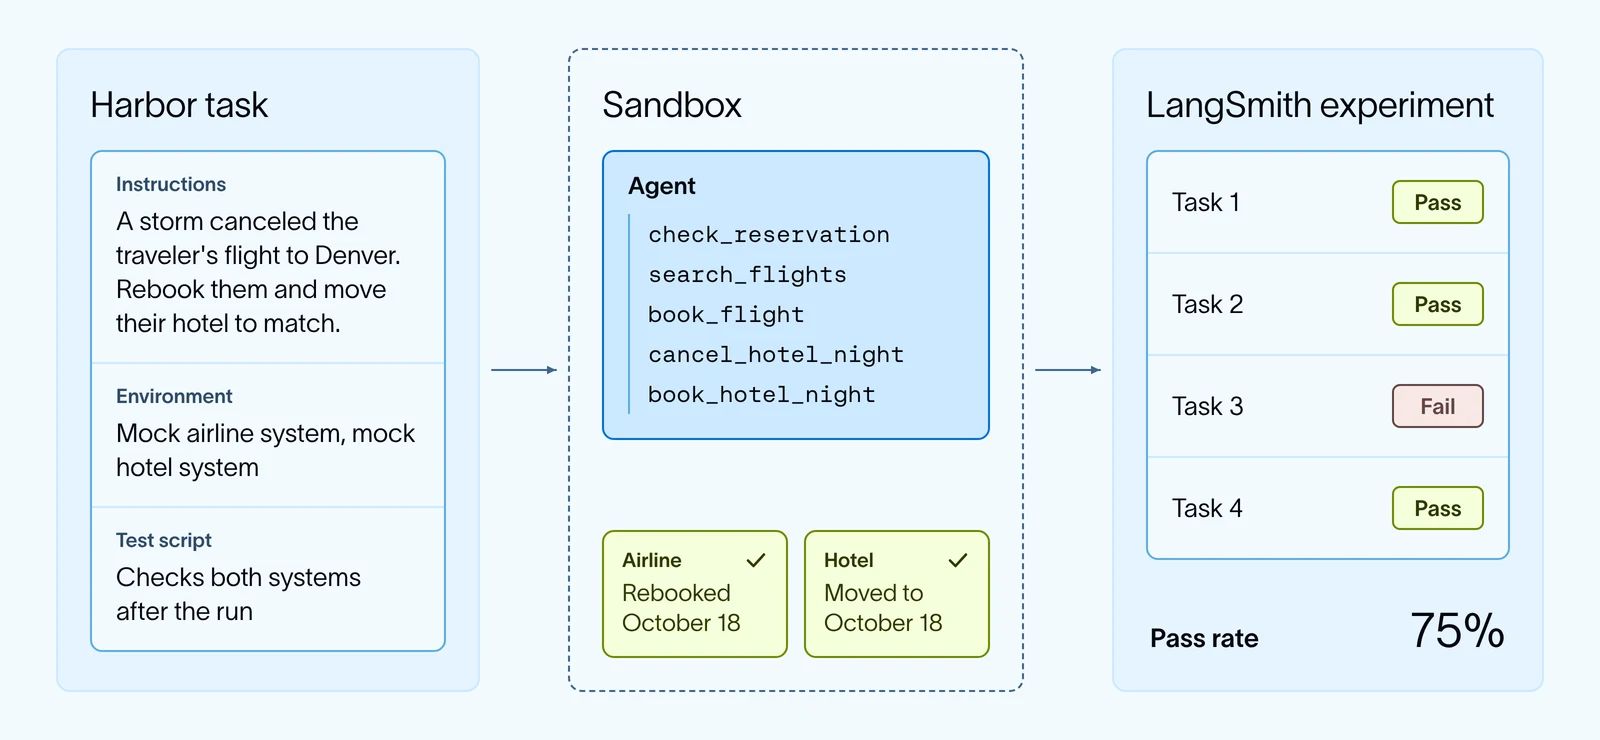
ハーバー これらのより長いタスクでのテストのための基盤を提供するオープンソースの評価ハーネスです。Terminal-Benchを支えているフレームワークであり、同じタスク形式を使って独自のエージェント向けベンチマークを構築できます。LangSmith統合により、Harborの各実行はLangSmithの実験として記録されます。Harborはタスクごとにコンテナを構築し、LangSmithのトレースを使って各環境を、エージェントが本番環境で目にするものに近づけることができます。ベンチマークの結果は他の評価結果と並んで表示され、任意の実行を開けば、そのスコアの横に完全なトレースを表示できます。
このセットアップを用いて Terminal-Bench 2.0におけるDeep Agentsの性能を改善する トレースを見直して失敗モードを特定し、その後ハーネスを修正するといった方法です。また、以下の構築にも活用しました。 IssueBenchLangSmith Engineのベンチマークです。各IssueBenchタスクはEngineにトレースのバッチを与え、正しいものを適切なイシュークラスタにグループ化できているかを評価します。
自分のエージェント向けのベンチマークを作成する手順は、上記のevalsと同じですが、いくつかの変更点があります:
- トレースからタスクを収集します。 LangSmithのトレースから失敗を見つけ、それぞれをHarborタスクに変換します。各タスクには、ユーザーの予約が登録されたモック予約システムのような専用環境が用意されます。
- 「良い」の定義を明確にする。 ルーブリックに基づいて採点するLLMジャッジやコードベースの評価を作成できます。
- スコアをめがけて丘を登る。 エージェントを実行し、そのスコアを使って変更のA/Bテストを行いましょう。このプロセスを自動で実行するエージェントループをセットアップすることもできます。それはエージェントに編集を加え、ベンチマークを再実行し、各変更を保持するか取り消すかを判断します。Andrej Karpathyのものと似た仕組みです。 autoresearch 数か月前のループから。
高コストをかけずに本番トラフィックをどのように評価できますか?
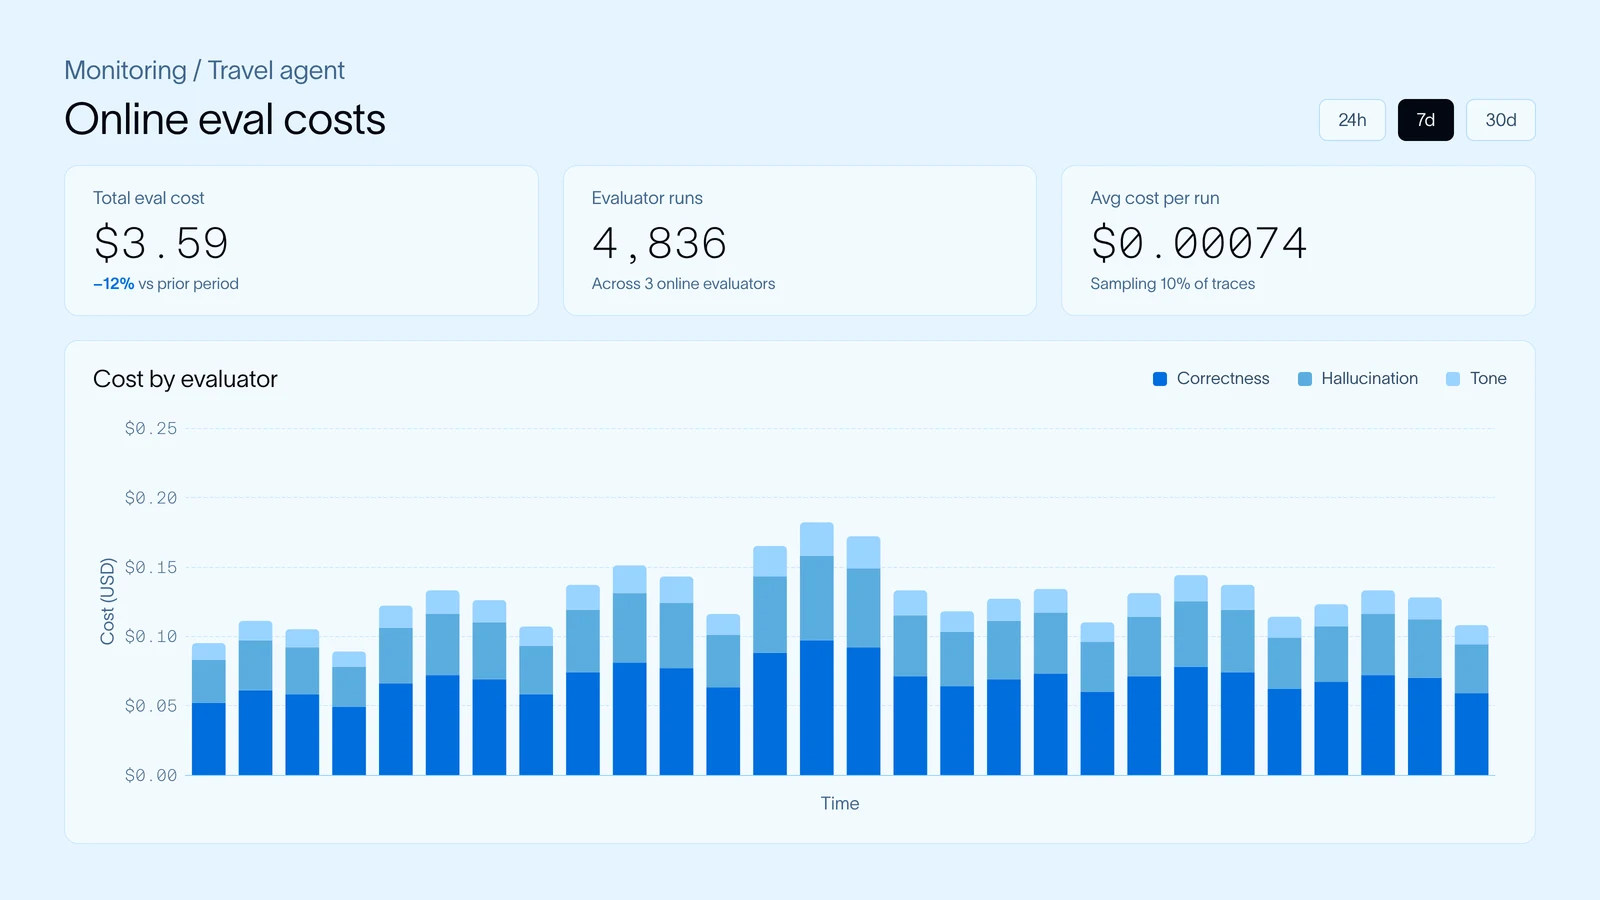
オフライン評価は固定データセット上で実行されるため、コストは予測可能です。一方、オンライン評価は実際のトラフィック上で実行されるため、LLMジャッジがすべてのトレースをスコアリングすると、新しいユーザーが増えるたびに評価コストが増大していきます。コストを抑えられるようにするには:
- サンプルを取得し、フィルタリングします。 オンライン評価者 LangSmith では、トラフィックの割合や、ネガティブなユーザーフィードバックのようなフィルターに一致するトレースのみを対象にスコアリングできます。
- 可能な場合はコードチェックを活用してください。 予約がリクエストされた日付と一致しているか、あるいはエージェントが予約前に検索を行ったかを確認することは、ほとんどコストがかかりません。
- より安価なジャッジを使用してください。 当社の Jev-as-a-Judge この実験では、TypeSafe AI の Jev がすべての pass/fail の判定において人間のラベルと一致し、総コストは $0.34 でした。これは Claude Sonnet 4.6 の $28.17 と比較したものです。
LangSmithではオンライン評価のコストが時系列で保存されるため、チームは支出をモニタリングできます。
独自にエージェント評価を構築する必要があるのでしょうか?
いいえ、特に一般的なエージェントの問題を評価する場合には必要ありません。まずは私たちのこちらから始めるのがよいでしょう。 LangSmithの事前構築済みLLM評価テンプレート ハルシネーションやPII(個人情報)漏洩のような典型的なチェック用です。データセットやトレーシングプロジェクトに1つ追加し、プロンプトを編集して自分のエージェントに合わせます。たとえば、ジャッジに対して「旅行アシスタントはユーザーの予算外の予約を決してしてはならない」と伝えることができます。
私たちのオープンソースの agentevals パッケージにも、エージェントのメッセージやツール呼び出し向けの事前構築済み評価器が用意されています。これらは、エージェントが呼び出したツールを参照リストと比較したり、LLMジャッジにそのステップが理にかなっているかを尋ねたりできます。
また、オフライン評価器を複数のデータセットで再利用し、本番のトレースに対するオンライン評価器として実行することもできます(評価器が参照出力を必要としない場合にのみ機能します)。
エージェント固有の評価については、 Eval Engineering Skill がClaude CodeやCodexのようなコーディングエージェントで実行され、リポジトリとトレースを読み取り、実行可能な評価を一緒に作成します。
LangSmith Engine は、本番のトレースから取得することで、評価を自動的に作成することもできます。問題のクラスタを特定すると、失敗したトレースをデータセットの例に変換し、その参照出力を「ユーザーが要求した日付にフライトを予約する」のような assertionsとして記述します。
マルチターンの会話はどのように評価しますか?
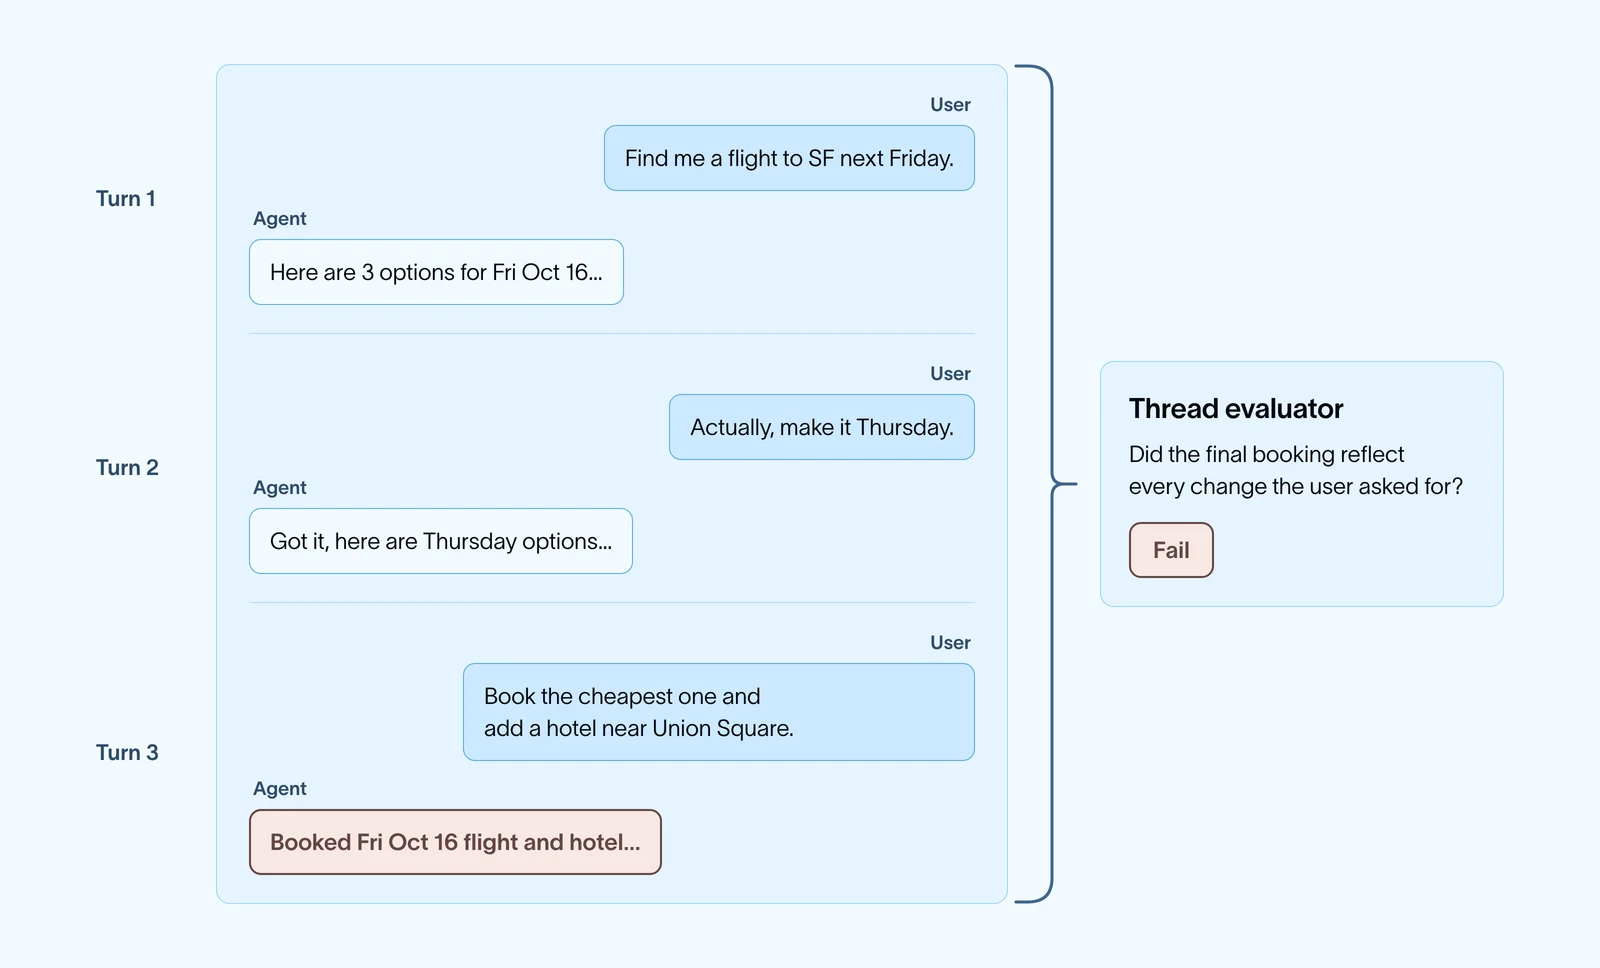
多くのエージェントは複数のターンにわたって動作します。たとえば、ユーザーが旅行アシスタントにフライトを依頼し、日付を変更し、その後ホテルを追加するかもしれません。会話全体としてはうまくいっていなくても、各ターンは単独では問題なく見えることがあります。
LangSmith で会話を評価するには、トレースのメタデータにスレッド ID を渡してください。そうすることで各ターンが 1 つのにグループ化されます。 スレッド。スレッドとは同じ会話からのトレースの連続です。そこから、会話が終了した時点でスレッド全体を採点するオンライン評価ツールを取り付けることができます。質問の例としては「最終的な予約にはユーザーが求めたすべての変更が反映されていたか?」や「ユーザーは同じことを繰り返し伝える必要があったか?」などがあります。LangSmithでは各スレッドをさらに、 軌道、すべてのメッセージとツール呼び出しが順番に一度だけ記載されています。
オフライン評価では、会話全体をデータセットの例として保存したり、LLMでユーザーをシミュレートして、エージェントが会話を最初から最後までどのように処理するかをテストしたりできます。
最終的な出力だけでなく、エージェントをどのように評価すればよいのでしょうか?
エージェントは多くのステップを実行するため、最終的な回答には起きたことの一部しか表示されません。最終応答以外に、確認したい事項は以下のとおりです:
- その道のり、つまりエージェントが生成したメッセージとツール呼び出しの連続を意味します。
- 最終状態「たとえば旅行代理店が作成した予約記録、そのエージェントが書き込んだファイル、あるいはリポジトリに対して行った変更など。」
本番環境のエージェントがますます複雑になるにつれ、専用の評価ハーネスが必要になる場合があります。特に、エージェントの成果が環境への変更そのものである場合です。たとえば、コーディングエージェントにバグ修正を依頼したとします。LLM ジャッジはエージェントの返答を読むことはできますが、信頼できる検証は、エージェントの完了後にリポジトリのテストを実行することです。それが機能するためには、実行同士が互いに影響しないよう、各テスト実行にリポジトリの独立したクリーンなコピーが必要です。Harbor はこのセットアップを自動で行ってくれます。次のように構築されたエージェントを実行できます: Deep Agents(ディープエージェント) で LangSmithサンドボックス 各実行をそのトレースとともにLangSmithの実験に記録します。詳細は以下をご覧ください。 Harbor x LangChain.
LangChain、LangGraph、またはDeep Agentsを使って構築されていないエージェントでも、LangSmithでトレースおよび評価できますか?
はい!LangSmithはフレームワーク非依存なので、任意のフレームワークで、あるいはフレームワークを一切使わずに構築されたエージェントでもトレースおよび評価できます。トレースを送信する方法はいくつかあります:
- フレームワーク統合。 LangSmithは 統合 のような人気のエージェントフレームワーク向けの OpenAI Agents SDK, Claude Agent SDK, およびその他。
- モデルプロバイダーのラッパー。 モデルプロバイダーを直接呼び出す場合は、以下のクライアントをラップしてください OpenAI または Anthropic また、各モデル呼び出しはトレースされます。
- ザ
@traceableデコレータ。 旅行アシスタントのフライト検索ツールのように、ご自身の関数に追加することで、 すべてのステップを追跡 のことです。
トレースがLangSmithに取り込まれると、評価はどのフレームワークでも同じように機能します。トレースをデータセットに追加し、エージェントを渡してオフライン実験を実行することで、 「SDKの」 evaluate() 機能であり、本番トラフィックにオンライン評価ツールを接続できます。
既存の評価スタックからどう移行すればよいのでしょうか?
最初からやり直す必要はありません。すでに構築したものの大半はLangSmithにそのまま引き継がれます。
- データセット。 既存のテストケースをCSVまたはJSONLファイルとしてアップロードするか、SDKを使って作成してください。
- コード評価ツール。 既存のスコアリング関数は、通常わずかな変更だけで LangSmith エバリュエーターとして実行できます。評価がすでにテストとして実行されている場合、 pytest および Vitest 連携機能を使えば、その設定をそのまま維持できます。
- LLMジャッジ。 既存のジャッジ用プロンプトをUIのLLM-as-a-judgeエバリュエーターに貼り付けるか、コード内に保持してください。
- トレーシング。 LangSmithはあらゆるフレームワークと連携できるため、現在のエージェントを書き直すことなく、そこからトレースを送信できます。
結果はどのように報告しますか?
オフラインの実験では、各リリースが改善につながったかどうかを確認できます。オンラインの評価ダッシュボードでは、本番環境でパフォーマンスが時間の経過とともにどう維持されているかを把握できます。LangSmithでは、実験結果を直接比較し、トークンコスト、レイテンシ、評価者のスコアなどの指標について時間の経過を追うカスタムダッシュボードを作成できます。ベンチマークがあれば、リリースをまたいでモデルやエージェントのバージョンを比較するための安定したスコアが得られます。
次へ
さらに深く知りたい方は、「 How We Build Evals for Deep Agents」をお読みいただくか、 LangSmith評価クイックスタートを試すか、またはLangChain Academyのコース「 LangSmith Essentials.
」をご覧ください。ライブ講師をご希望ですか?私は2026年10月28日にエージェント評価に関するバーチャルワークショップを開催します。登録は こちら!