
要点
- 問題: 高性能RLにおける推論側の最適化は数値を変えてしまうため、学習はサンプリングを行ったポリシーとは別のポリシーを最適化することになります。DeepSeek-V4-Flashでは、高性能ベースラインのtrain-inference KLが2e-3から29.9に上昇し、報酬は低下しました。
- アプローチ: トレーニング時のフォワードパスは vLLM の推論カーネルを直接呼び出し、それらの高性能カーネルを修正することで、ロールアウトとトレーニングがサンプリングされたすべてのトークンについてビット単位で同一の logprobs を生成するようにしています(diff = 0)。
- 結果: DeepSeek-V4-Flash の100以上の学習ステップにおいて、diffは毎ステップ0で、ベースラインの91.3%のロールアウトスループットを実現しました。Nemotron(Mambaハイブリッド+NVFP4)でも結果は一貫しており、一貫実行のSWE-bench Proスコアは維持される一方、ベースラインは0.56から0.22に低下しました。
- オープンソース: このプロセスはエージェントスキルとしてパッケージ化され、レシピおよびコードと共に公開されており、新しいモデルでこれを行うコストを下げています。
- 進行中: DeepSeek-V4.1 は差分0に到達しました。パフォーマンス関連の作業は最終調整中で、専用の記事が公開される予定です。
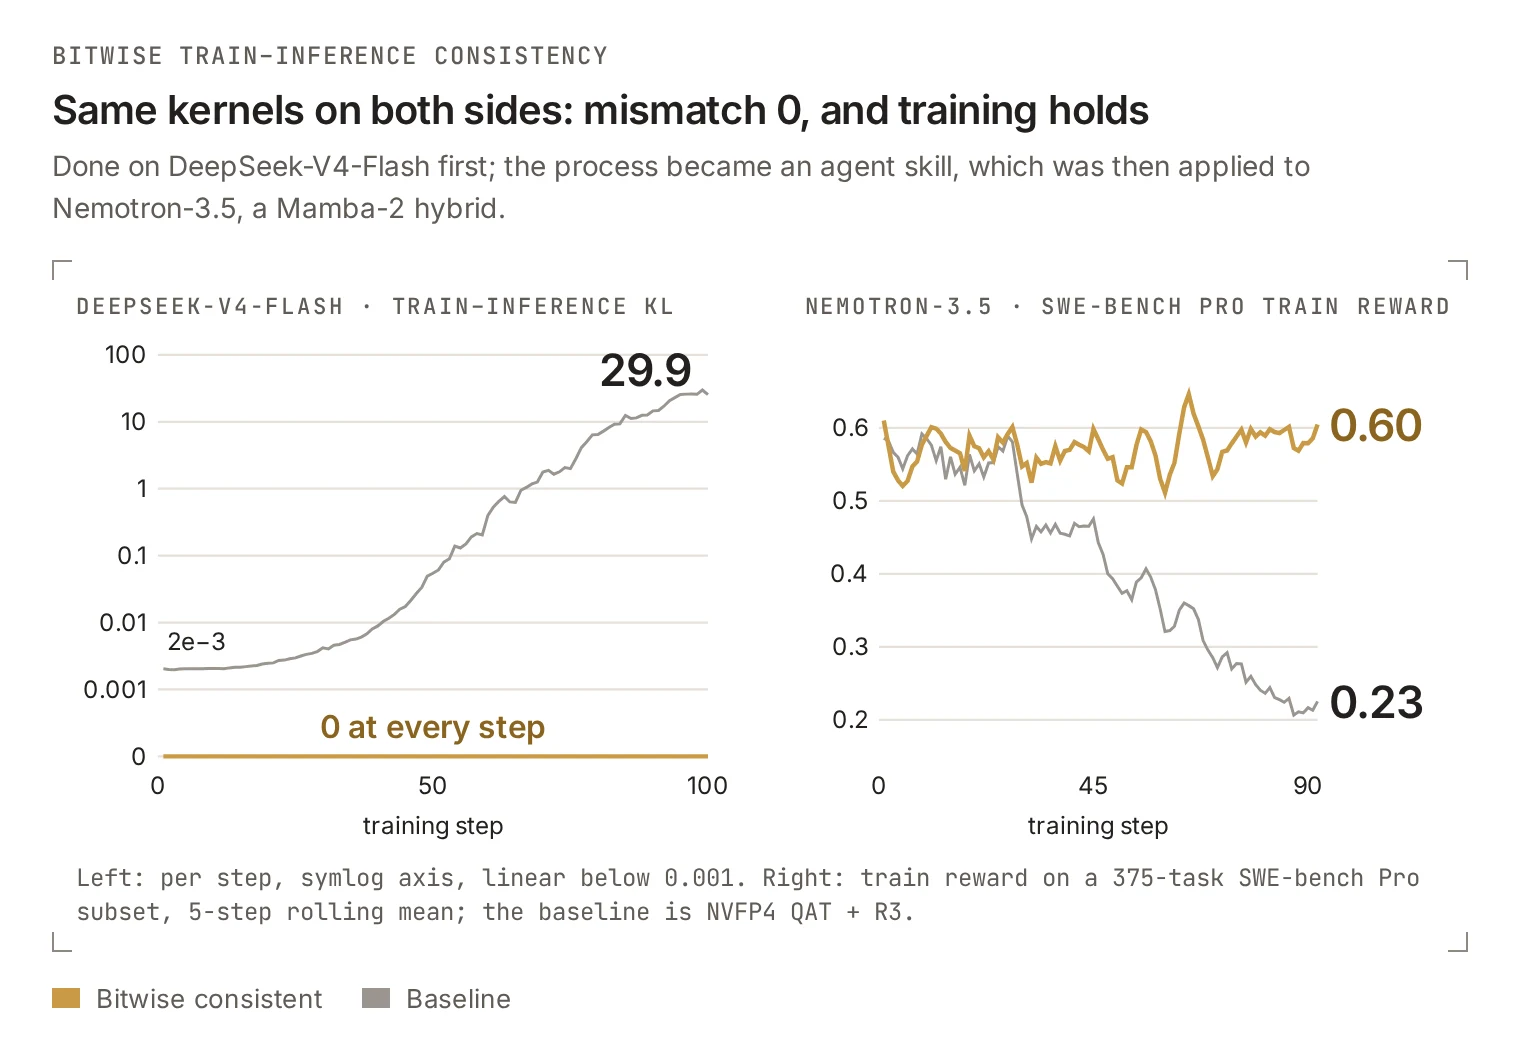
DeepSeek-V4-Flashが最初に0 diffに到達した。そのプロセスはエージェントスキルとなり、その後Nemotron-3.5(Mamba-2ハイブリッド)に適用された。左: DeepSeek-V4-Flashのtrain-inference KL。ベースラインは2e-3から29.9まで上昇するが、consistent実行では毎ステップ0を保つ。右: SWE-bench ProにおけるNemotron-3.5のtrainスコア(5ステップ移動平均)。consistent実行は約0.6を維持する一方、ベースラインは0.23まで低下する。
ロールアウトがRL学習時間の大半を占めるため、学習システムは低精度compute、低精度KV cache、通信およびカーネルの最適化を採用しています。これらは推論側の数値計算を変えます。推論エンジンが応答を生成し、学習エンジンがその確率を再計算してモデルを更新します。同一の重みであっても、両側は同じトークンに対して異なる確率を割り当てるため、学習はサンプリングを行ったポリシーとは別のポリシーを最適化することになります。このギャップは更新とともに拡大し、学習を不安定化させ得ます。私たちのDeepSeek-V4-Flash-Base実験(TISのようなアルゴリズム的な補正なし)では、高性能ベースラインのtrain-inference KLは2e-3から29.9に上昇し、報酬は後退しました。
訓練の不安定さは、クラッシュ、ロールバック、再実行の増加、有効な訓練の割合の低下、そして同じ結果に到達するまでの総時間の増加を意味します。私たちの目標は 効果的な強化学習(RL)トレーニングをより早く完了する: クラッシュや再実行を削減することで、エンドツーエンドの所要時間を短縮して結果に到達します。
当社のアプローチ:高性能な数値パスにおいて、トレーニングと推論はaを生成します。 ビット単位で同一 サンプリングされたすべてのトークンについて学習側の logprob と推論側の logprob の差が 0(厳密な定義は Section 2 で示します)となる、真のオンポリシー RL を実現します。そのために、学習時のフォワードパスから vLLM の推論カーネルを直接呼び出し、その高性能カーネルを修正して、バッチ構成、prefill か decode かのフェーズ、並列レイアウトのいずれによっても結果が変わらないようにしました(Section 3 および 4)。さらに、エージェントスキルにより、新しいモデルでこれを行うコストを下げ、プロセスを転用可能にします。このスキルは、両者の結果が最初に乖離する演算子を見つけ、最小の再現コードに縮小し、修正してリグレッションを再実行するまでの手順をエージェントに指示します。DeepSeek-V4-Flash では、高性能ベースラインのロールアウトスループットの 91.3% で差 0 を達成し、この手法を NVFP4 を用いる Mamba ハイブリッドである Nemotron にも持ち込みました。
本稿では数値の一貫性、学習曲線、ロールアウスループットを測定する。エンドツーエンドの利得は、クラッシュや再実行の減少によるものであり、それは長時間の実行でのみ現れる。その実時間での比較は後日に回す。また、どちらのベースラインも徹底的にチューニングや探索が行われたわけではない。それぞれ単一の構成で、R3はあるもののTISやMISといったアルゴリズム的な補正はなしで実行された。ここで示されているベースラインの崩壊は、そのレシピのみを反映したものである。チューニングを行えば、ベースラインはそれほど簡単には崩壊しない可能性がある。
1. 既存のアプローチ:3つの要素をどうトレードオフしているか
効果的な強化学習(RL)トレーニングをより速く完了させるには、次の3つの特性を同時に満たす必要があります。
- A、高性能: 高速なロールアウトと学習に対応し、低精度計算、低精度KVキャッシュ、通信最適化をすべて利用可能。
- B、高い一貫性: 同じ重みに対して学習と推論が同一のポリシーを計算すること。
- C、低コストと汎用性: 新しいモデル、精度、またはハードウェア上でAとBを達成するのに、許容可能な開発時間しかかからないこと。
これらはめったに両立しません。Bを捨てると最適化は自由になりますが、学習が不安定になるリスクを負います。Aを捨てると一貫したカーネルを使えますが、推論が大幅に遅くなります(下の表の数値を参照)。AとBの両方を維持するには、モデルごと、演算子ごとの整合を取る必要があり、その結果Cが成り立ちません。
学習と推論の不一致自体は新しい問題ではなく、既存の手法はA、B、Cの間で異なるトレードオフを行っています:
| アプローチ | 維持するもの | 犠牲にする・支払うもの |
|---|---|---|
| アルゴリズムによる補正: TIS、MIS、FlashREINFORCE、Score Centering | AとC:推論エンジンには手を加えず、モデル非依存で、導入コストが低い | B:数値の差は残り、更新への影響が限定されるだけです。コストとして、バイアス、廃棄されるサンプルがあり、低精度が差を広げるほど補正が難しくなる |
| R3 (replay rollout expert routing) | A、およびMoEルーティングに関するB | ルーティングの反転のみを除去し、その他の数値の差は残る |
| QAT (学習時のフォワードパスがデプロイ時の量子化をシミュレートする) | A: ロールアウトは低精度を安全に使用できる。量子化に起因する差分の部分を縮小する(Bを改善) | 学習は量子化をシミュレートする必要があり、backward は straight-through estimator(STE: backward では量子化を恒等写像として扱う)を使用する。重みのみのシミュレートでは、 activations、KV、カーネル、reduction からの差分が残る |
| 厳密な数値アライメント (Thinking Machines、slime、IsoExec、本記事) | B | A または C: 汎用的な batch-invariant カーネルは A を犠牲にする(Thinking Machines のワークロード: 26 秒から 55 秒へ、改良された attention カーネルで 42 秒)。高性能パス上でアライメントすれば A を維持でき C を犠牲にする(slime、IsoExec、本記事: モデルごと、演算子ごとのアライメントと検証) |
アルゴリズム的補正は複数のメカニズムをカバーする:
- TIS (Truncated Importance Sampling、 Yao et al.): 勾配を学習/ロールアウト確率比で重み付けし、上限で打ち切ることで、わずかなバイアスと引き換えに分散を有限に抑える;
- MIS (Masked Importance Sampling、 When Speed Kills Stability): 打ち切りなし。シーケンスレベルの確率比が閾値を超えるシーケンス全体を除外する;
- FlashREINFORCE (Hu, Zhang et al.): 非同期の agentic RL 向け。軌跡レベルのドリフトフィルタリング(sequence trust region)により、あまりに大きく逸脱した軌跡を除去する;
- Score Centering (Marek & Ryabinin): 各更新で蓄積される学習-推論ドリフトを加法的な補正項で相殺する。importance sampling と併用可能。
これらの手法はミスマッチの影響を軽減するが除去はしない。ミスマッチは on-policy 学習を off-policy 学習に変える(Yao et al.); ミスマッチが大きく複数の発生源を持つ場合、トークンレベルの importance sampling はバイアスを持ち、学習は崩壊しやすい(Li & Liu)。 P1-VLでは、truncated importance sampling は崩壊を遅らせただけだった。R3(Rollout Routing Replay、 Ma et al.)はロールアウトのエキスパートルーティングを記録し学習時にそれをリプレイすることで、ルーティング反転の部分のみを除去する。
最後の行では、Thinking Machines Lab が batch-invariant カーネルによる真の on-policy RL を達成している(Defeating Nondeterminism in LLM Inference) は表における推論時コストの内訳であり、その多くはまだ十分に最適化されていないFlexAttention統合によるものです。 vLLM と TorchTitan は訓練時にvLLMのforwardカーネルを再利用しており、ビット単位で一貫した実行はより少ないステップでより高い報酬に到達しました。 slime はGLM-5アーキテクチャ(MLA + DSA、DeepSeek-V3.2と同じ構造)でlogprobを整合させています。さらに IsoExec はAlexander Jiang氏とSkyRLチームによるもので、linear attentionを扱っています(第6節)。
これらのアプローチの多くは重ね合わせ可能です。あるものは同一の重みバージョンにおけるエンジン間の数値差を対象とし、別のものは重みバージョン間のポリシー差を対象とします。非同期訓練では、古い重みによるoff-policyは依然としてTIS、MISまたはScore Centeringに渡されますが、それらの重み上でエンジンを数値的に整合させることは可能であり、ビット単位で一貫した実行がそのような補正を測定するためのベースラインとなります。QATも厳密な整合に属します。低精度のrolloutと訓練がビット単位で一致するのは、訓練側のforwardが同じ量子化を適用する場合のみであり、我々のbackwardはSTEを使用しています。
我々はAを維持する最下行の経路を採用しており、Aに対する基準は以下の通りです。 rolloutスループットが同等に最適化された高性能ベースラインの70%以上 (rolloutはRL訓練で最も時間のかかる部分であり、訓練側のオーバーヘッドは別途測定していません。3.2を参照)。Cがこの経路の弱点であり、第5節でAgent + skillがそれをどう補うかを扱います。
2. train-inference一貫性に求められるもの
この記事では、diffとは、同じ重みバージョンとトークン接頭辞を用いる各更新の前に、rollout側の各有効トークン(応答マスク内のサンプリングされたトークン)のlogprobと訓練側で再計算したold-logprobとの差を指します。合格条件は、トークンごとの差 |p_rollout − p_train| の最大値・平均・標準偏差、およびk3 KLが、すべて厳密に0であることです。これは閾値ではなく厳密な等価であり、各更新の前に検証されます。ミニバッチ更新はいずれにせよポリシーを変えるため、この定義からは除外されます。これは、我々が受け入れたタスク(数学推論、マルチターンのツール呼び出し)および並列レイアウト(両側で異なるレイアウトを含む)で成立します。
"訓練と推論は同じことを計算している"という主張は、4つの次元と共通の数値契約に分解されます。
train-inference consistency ⇐ kernel determinism + batch independence + phase consistency + cross-GPU consistency + same numerical contract on both sides
カーネルの決定論性(単一GPU)。 同じカーネルは同じ入力に対して常に同じ出力を返すこと。GPUはデフォルトではこれを保証しません。一例がsplit-K行列乗算です。蓄積の順序が異なると、浮動小数点加算は結合法則を満たさないため結果が変わります。
バッチ独立性。 あるリクエストの結果が、同じバッチ内の他のリクエストに依存してはならない。推論時、エンジンはスループットのためにバッチを動的にマージ・分割する。訓練時も、マイクロバッチサイズ、パッキング、エキスパートごとの MoE トークン数が計算経路を変える。さまざまな最適化(バッチサイズによるカーネル選択、動的分割数など)により、あるリクエストが同じバッチの他のリクエストに依存してしまう。
フェーズ一致性。 あるトークンは、prefill(多数のトークンを一括処理)でも decode(1トークンずつ)でも同じ結果を得なければならない。推論エンジンは各フェーズに最速のカーネルを与えるため、共有経路を強制することが、一致性バージョンの速度低下の主因であり、最適化の焦点となる。
GPU 間一致性。 GPU 間のリダクション(AllReduce、reduce-scatter、および MoE all-to-all 後のエキスパート出力のマージ)も固定しなければならず、そのレベルは2つある。
- 両側で 同じ並列レイアウト の場合、通信結果はタイミングやスケジューリングによって変わってはならない(通信ライブラリのアルゴリズム、リダクションのチャンク分割と精度、エキスパートのマージ順序を固定する)。
- 並列レイアウトが 異なる 場合(例:TP/EP 次数の違い)、並列度が変わっても結果が同じであり続けなければならず、これにはリダクションツリーの固定が必要で、より高いコストがかかる。DeepSeek-V4 のレシピでは、代わりに GPU 間リダクションを比較対象の経路から外す(4.5)。
各ディメンションは、2つの根本原因のいずれか一つを防ぐ。すなわち、演算順序の違い(並列の加算やリダクションの順序がスケジューリングに従う)か、計算経路の違い(両側、あるいは異なるバッチ形状が、異なるカーネルや分岐を実行する)である。diff 0 を達成するには、まず静的な差異を取り除き、次に動的な経路選択を固定して負荷を無視するようにする。
これら4つのディメンションに加え、diff = 0 の達成にはさらにいくつかの要件がある:
- 両側で同じ数値契約:同じ量子化と丸め、同じ加算精度、同じカーネル演算。2つのエンジンが4つのディメンションすべてを満たしていても、計算方法が異なれば結果が一致しないことがある。
- 同じ離散的選択:Top-K と MoE ルーティングは、浮動小数点数の最終桁における 1 ulp の上流差異を、異なるトークン集合やエキスパートの組み合わせに変えてしまう。上流が一致したら、タイブレーク、出力順序、マージ規則も一致させなければならない。
- 1ステップ1回の更新(ステップバッチ=ミニバッチ):1ステップに複数回のミニバッチ更新を行うと、2回目以降は訓練時の重みがサンプリング時の重みと異なり、これは diff = 0 ではカバーされないため、訓練は厳密なオンポリシーではなくなる(1ステップ4回更新の数学タスクでは、各更新後におよそ7%のトークンがエキスパートの組み合わせを切り替えた)。
- 正しい backward とリストア:4つのディメンションが与えるのは一致性のある forward だけである。backward は依然として正しくなければならず、チェックポイント復元後の最初のステップも一致していなければならない。
Section 4 の主要なオペレータはそれぞれこれらの要件の一つを満たす:dense GEMM はカーネル選択を固定してバッチ独立性を実現する(4.1);FP8 KV cache は prefill と decode の読み出しを統一してフェーズ一致性を実現する(4.2);Top-K はタイと順序を固定して離散的選択を一致させる(4.3);エキスパート GEMM は2つのレイアウトにわたって一つの数値契約を維持する(4.4);そして GPU 間リダクションは比較対象の経路から外して GPU 間一致性を実現する(4.5)。
diff = 0 は両側が同じものを計算していることを意味するだけで、それが訓練に適していることを意味しない:1ステップに複数回の更新がある場合、diff = 0 は成立していても、更新間でルーティングがドリフトする。diff = 0 は我々のエンジニアリング目標であり、訓練品質の十分条件ではない。訓練品質は別途、受け入れ検証が必要である。
3. リファレンスレシピ:DeepSeek-V4-Flash
DeepSeek-V4-Flash は低精度計算、スパースアテンション、マルチノードのエキスパート並列を組み合わせており、難易度の高い構成である。FP8 ベースから、GB200 上で 2 つの 100ステップ実行を訓練した。最適化された高性能ベースラインと、diff = 0 の一致性バージョンである。
タスク:DAPO 形式のデータによる数学推論、GRPO、および過長ペナルティ付きの報酬(負になる可能性がある)。各実行は 8 台のマシン(32 GPU)、ステップあたり 128 プロンプト × 8 レスポンス、1ステップ1回の更新(ステップバッチ=ミニバッチ)を使用する。いずれの実行も TIS、MIS などの補正を使用しておらず、エンジン間の差異がそのまま現れる。
並列化:DP データ、EP エキスパート、CP コンテキスト(シーケンス分割)、TP テンソル。一致性バージョンのロールアウトは 4 つの vLLM エンジンを実行し、それぞれ DP8/EP8、TP=1;訓練は EP32、CP4、TP=1 を使用する。 両側は異なる並列レイアウトを使用する (4.5).
関連する構造: MLA (KVをキャッシュ前に圧縮するマルチヘッド潜在アテンション); DSA (DeepSeek スパースアテンション: 軽量なインデクサが履歴位置にスコアを付け、Top-K で最大 2048 件を保持し、MLA はその位置のみにアテンションする); および CSA コンプレッサ (履歴 KV をより少数の行に圧縮する); mHC (残差ストリーム間の混合で、混合行列は Sinkhorn 反復により正規化); さらに 43 層の MoE 層。SM100 は Blackwell(ここで使用するのは GB200)、SM90 は Hopper である。
3.1 中核的な決定: 推論カーネルが値を定義し、訓練は backward を追加する
2 つのエンジンを一致させる最も簡単な方法は同じコードを実行することだが、問題はどちら側が適応するかである。ロールアウトは RL 時間の大半を占め、すべての演算子がスループット向けにチューニングされており、訓練側を基準にすればこれらの最適化を放棄することになる。したがって、 推論カーネルが数値の基準となる: 訓練の forward は同じ vLLM カーネルを呼び出して値を取得し、訓練は backward を追加するだけである。 推論も汎用のバッチ不変カーネルに切り替えるわけではない: 高性能なデプロイ用カーネルを維持したまま、第 2 節の要件を満たすよう修正を加える。第 4 節のすべての演算子はこのトレードオフに従う。
この決定における課題は、推論カーネルには backward が存在せず、FP8 量子化は微分可能ではない点です。そのため、forward と backward は別々に処理され、forward の値は常に vLLM カーネルから取得されます。各モジュールはカーネルをカスタムでラップしています。 autograd.Function その逆伝播はBF16のマスター重みに対して微分を行い、FP8量子化は恒等写像(ストレート・スルー推定法、STE)として扱われます。逆伝播は主に既存のカーネルを再利用します。線形層とエキスパートGEMMにはTransformer EngineのBF16 GEMM、疎注意機構にはcuDNNフロントエンドのDSA backward、all-to-allにはDeepEPのbackwardを使用し、mHC、RMSNorm、SwiGLUなどの小規模な演算子のみが手書きのFP32微分を持っています。一部の融合カーネルは、この方法では微分できない出力を持ちます(attentionのq/k、圧縮KV、ルーティング重み、最終的なlogprob)。これらについては、勾配を得るためだけにPyTorchで同じ計算を再実行し、カーネルの値を保持します: visible + (graph - graph.detach())。各 backward は、forward 以降マスターの重みが変更されていないことを最初にチェックするため、再計算や非同期更新によって重みのバージョンが混在することはありません。
すべてのコストは訓練にかかり、2種類に分けられます。 エンジニアリングおよび検証: 勾配は代理であり、量子化された演算子の正確な微分ではないため、ビット単位で同一のフォワードは勾配について何も証明しない。そこでこのスキルはバックワードを独立したリファレンスに対して検証する(Section 5)。バックワードは決定的である必要はなく、正しければよい。各レイアウトのエントリーポイント(例:4.4 の masked / contiguous)にも、それぞれ固有の検証が必要である。 パフォーマンスとメモリ: training の forward では、backward のために inference kernels の入出力を保存しておく必要があります。このメモリ負荷こそが、このレシピが forward を 2 回実行する完全な再計算を有効にしている理由です。
3.2 結果と支払い者
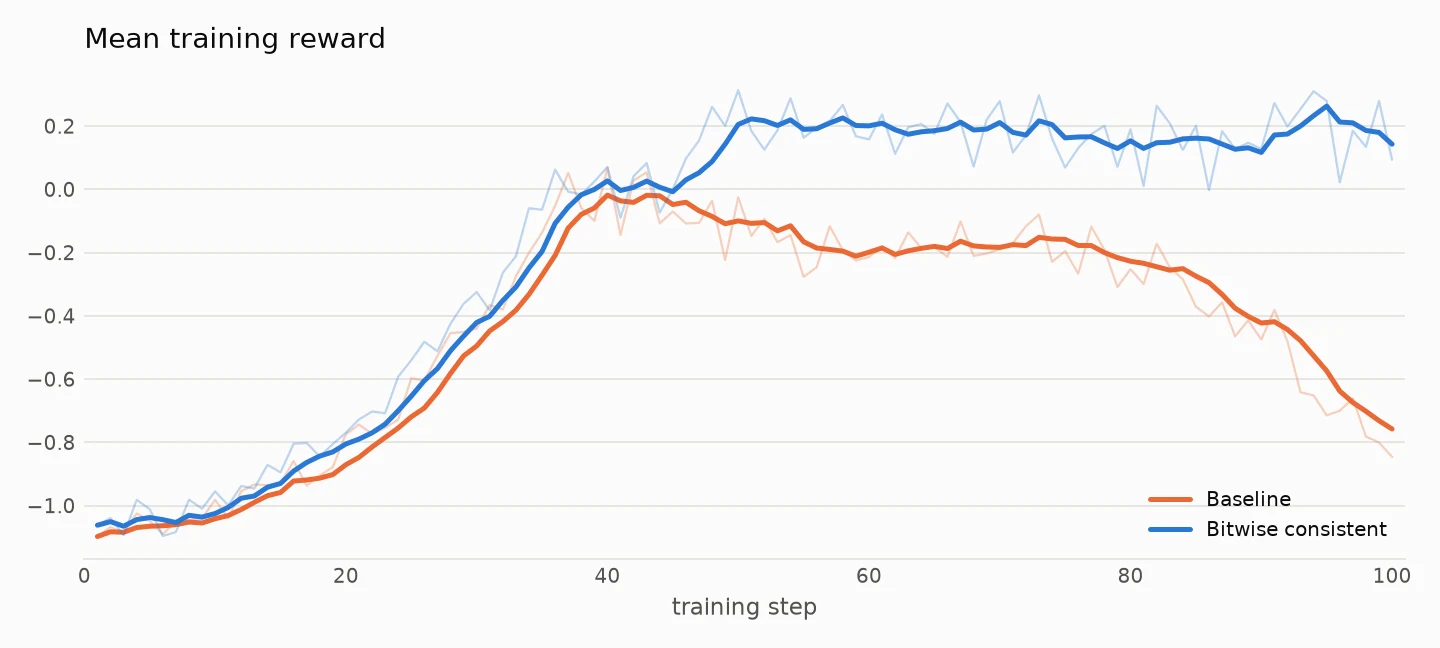
ステップごとの学習報酬。オレンジ:ベースライン、青:一貫バージョン。太線:現在および直前の4ステップの移動平均、細線:生の値。
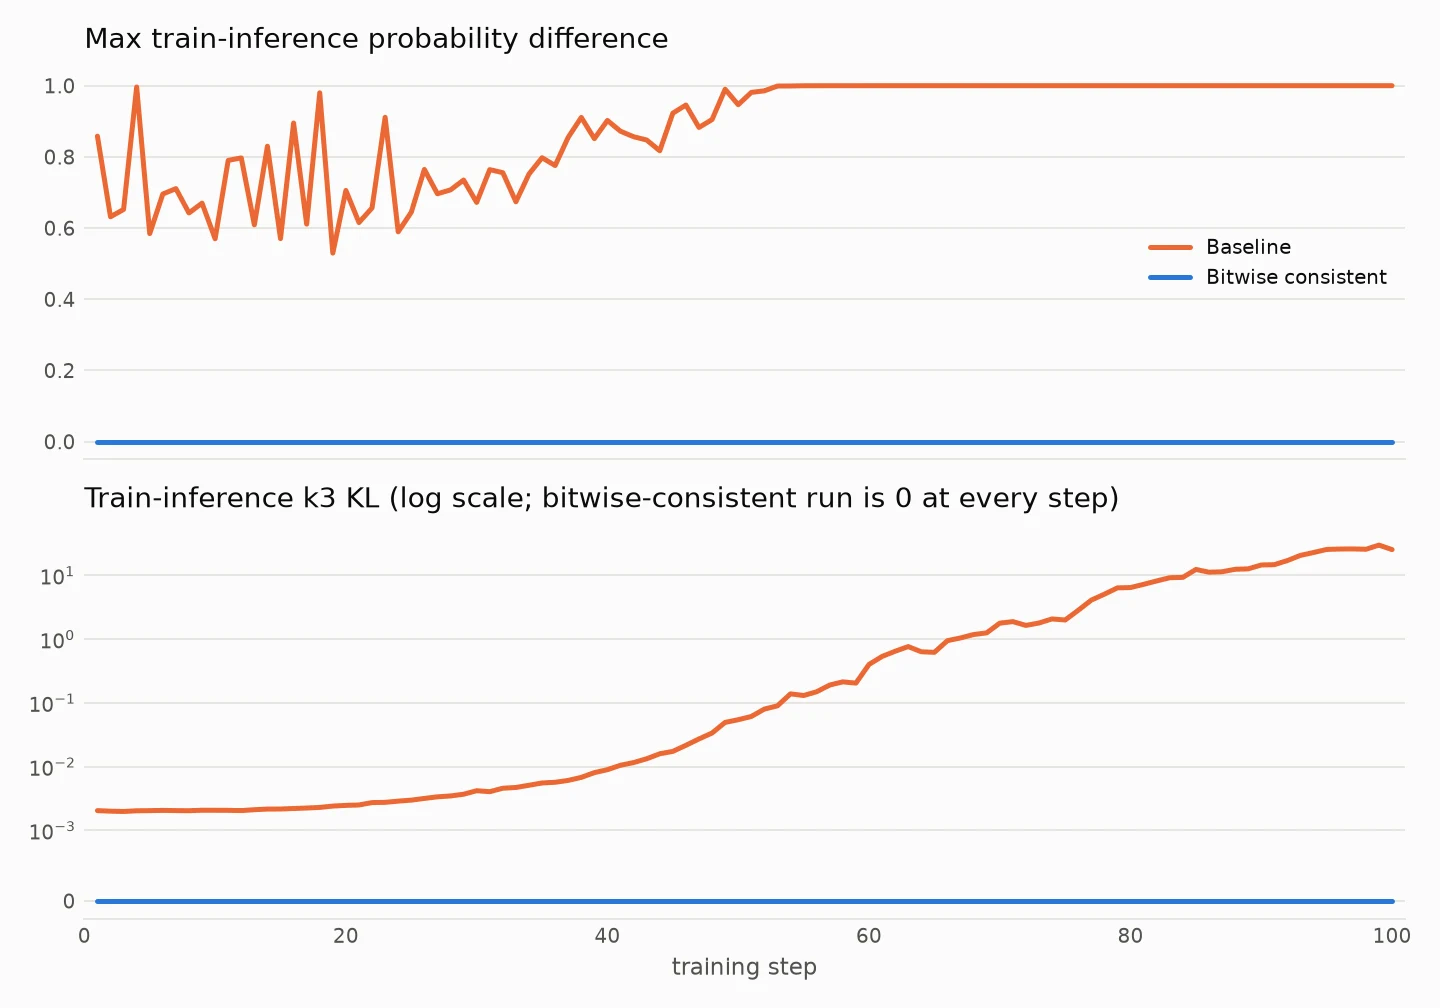
上段:ステップごとの学習時と推論時の確率差の最大値;下段:学習時と推論時のKL(k3推定量 r − 1 − log r、全体を通じて使用;対称logスケール、ゼロ付近は線形)。最大差は1回のルーティング反転やTop-Kの入れ替わりにも反応するため、ベースラインのステップ1から相当な大きさになる;KLは全体の水準を示す。オレンジ:ベースライン;青:一貫性のあるバージョン。一貫性のあるバージョンの両指標はすべてのステップで0。
100 ステップにわたり、一貫バージョンのロールアウトは平均 24.22 token/ms、ベースライン (26.53) の 91.3% となります:
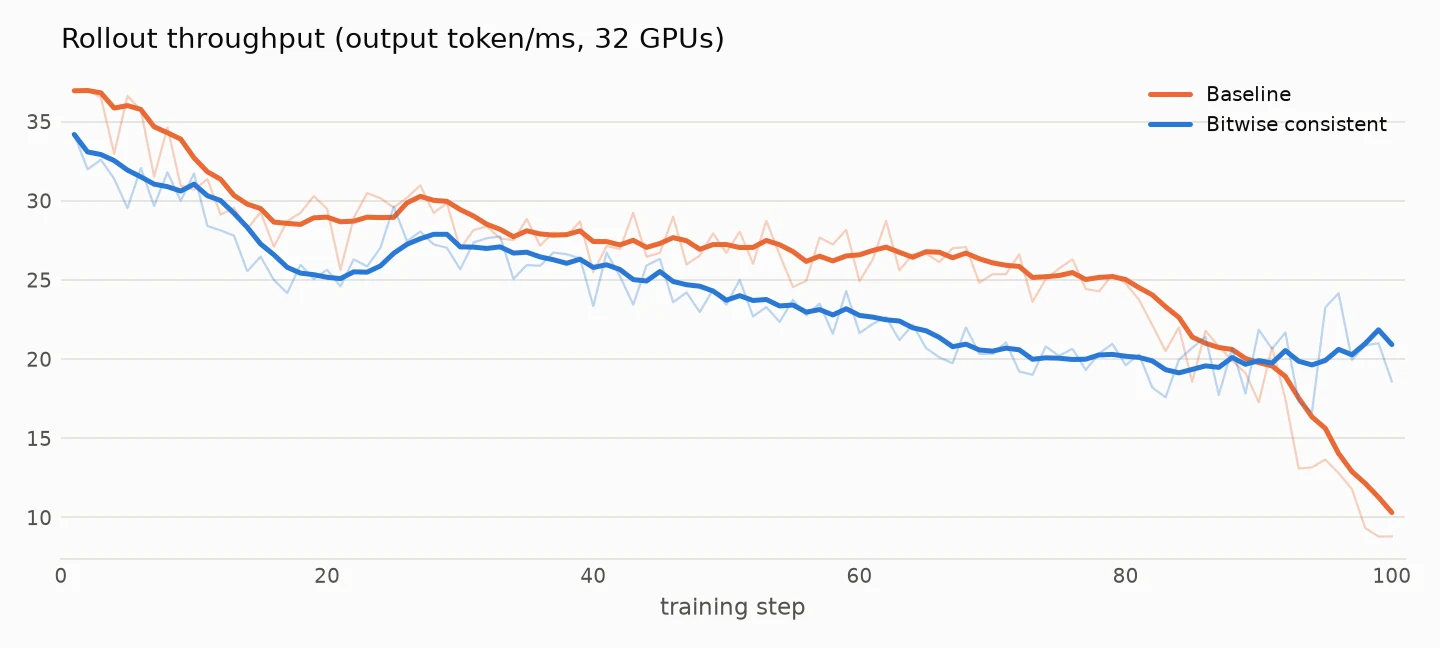
ステップごとのロールアウトスループット(出力 token/ms、32 GPU の合計)。オレンジ: ベースライン、青: 一貫バージョン。太線: 現在および直前の 4 ステップの移動平均、細線: 生の値。
基底のtrain-inference KLは増加し(2e-3から29.9)、その報酬は後退します。一方、一貫性のあるバージョンはdiff 0を維持し、報酬も保たれます。もう一つの潜在的な利点は、フォワードパスが1回少なくて済むことです。私たちはdiffを測定するためだけに各ステップでold-logprobを再計算していますが、承認後はrolloutのlogprobを代わりに使って学習できます。
ロールアウト側、この実行で測定した結果:平均スループットはベースラインの91.3%(約9%低い)で、セクション1の70%という下限を上回っています。ステップ90以降、ベースラインのスループットが低下するため比率が押し上げられます。同じステップ範囲で、その平均応答長は約3,000から約1,600トークンへ減少しています。最初の89ステップでは88.6%となります。2つの実行の応答長はトレーニング全体を通じて異なるため、この比率はエンジンの違いだけでなく、ワークロードの違いも反映しています。
このギャップはまだ演算子に起因付けられていない。Section 4では、MoE LL通信およびバックエンド、attention gather、非量子化、そしてリクエストごとの起動が指摘されている。
トレーニング側、個別には計測されていない:Section 4によれば、オーバーヘッドは毎フォワード時のFP8重みの再量子化、リクエストごとの逐次アテンションとTop-K、ルーティングメタデータの1回の追加ディスパッチ、および完全な再計算(3.1)であり、フォワードを2回実行することになる。
32基のGB200 GPU上でのverlレシピPRプレビューの別の報告では、エンドツーエンドで約10%のオーバーヘッドが示されています。ロールアウトはほぼ同等で、差の大部分は学習側にあります。次は学習側の最適化が課題です。
4. オペレーターごとに見る:DeepSeek-V4レシピにおける技術的選択
各小節では、何が保持され、何が手放され、速度をどう回復し、どのコストが残るかを扱います。どちら側が各オペレーターでどのカーネルを使うか、およびbackwardの書き方は、以下にあります。 スキル.
オペレーターごとのマスターテーブル
コストの大半はMoEの通信とバックエンド(4.4、4.5)にあり、次いでアテンションのギャザーと逆量子化(4.2、4.3)、denseは安価である。
| モジュール | 保持された | 断念 | 費用 |
|---|---|---|---|
| 高密度GEMM(4.1) | W8A8とDeepGEMMのデプロイ、出力ごとに1つの累積順序 | M<32でのFlashInfer分岐、小バッチgateカーネル、融合mHCカーネル | rollout:より高速な小バッチカーネルなし;training:毎フォワードで重みを再量子化 |
| FP8 KVキャッシュ(4.2) | FP8ストレージ | FP8を直接読み取るDecodeカーネル | rollout:decodeで追加のgatherと逆量子化;training:1つのプライベートキャッシュ |
| Top-K(4.3) | DSA sparse attention | デフォルトの Top-K タイブレークと出力順序 | 各サイドでソートが 1 回追加、フュージョンで回復。リクエストごとの prefill 起動が複数回。トレーニング: attention と Top-K がリクエストごとに直列 |
| Expert GEMM (4.4) | FP8 grouped GEMM。ルーティングは構造上一致し、R3 は不要 | FlashInfer TRT-LLM MoE | ロールアウト: スループット面の主要なギャップ。トレーニング: アライメントのパディング |
| Cross-GPU reduction (4.5) | トレーニングとロールアウトで異なる並列レイアウト | TP>1 | ロールアウト: LL 通信が計算とオーバーラップできない。トレーニング: ルーティングメタデータのディスパッチが 1 回追加 |
| CUDA Graph (4.6) | Graphs | 性能のみを目的としたショートカット分岐 | ワークスペースが上限値で確保されている |
| その他(embedding、RMSNorm、o_proj、lm_head + logprob) | 既存のカーネル、固定されたリダクション順序 | — | 小さい |
4.1 Dense GEMM: FP8 を維持し、すべての M に対して 1 つの加算順序を使用
維持した。 DeepSeek-V4-Flash-Base は block-FP8 で提供され、デプロイメントパスは DeepGEMM を使った W8A8 です。一貫バージョンでは両側でこれを使用します。各トレーニングフォワードパスは、デプロイルールに従って BF16 のマスター重みを block FP8 に量子化し、推論 GEMM を呼び出します。BF16 ロールアウトは計算と帯域幅のコストがかかり、MXFP8 のようなトレーニング側で別のスキームはデプロイされた数値に近づくだけです。これはセクション 1 の QAT 行の限界です。
断念した。 推論エンジンは形状によってカーネルを選択します。FP8 線形層は M<32 のとき FlashInfer を、それ以外では DeepGEMM を使用します。ルーターゲートは 16 トークン以下でスモールバッチカーネルに切り替わり、mHC の分割数はトークン数に応じて増加します。浮動小数点の加算は結合法則が成り立たないため、それぞれがリクエストの結果を隣接リクエストに依存させます。一貫バージョンではこれらの分岐を除去します。FP8 線形層は常に batch-invariant モードで DeepGEMM を使用し、ルーターゲートはすべてのバッチサイズで FP32 出力の GEMM を 1 つ使用し、小さな BF16 matmul は固定の加算順序を持つ Triton カーネルを使用し、mHC の分割は 1 に固定されます。FlashInfer ではなく DeepGEMM に統一するのは、DeepGEMM が batch-invariant モードを持ち、すでにデプロイカーネルであり、トレーニングの M が大きいからです。
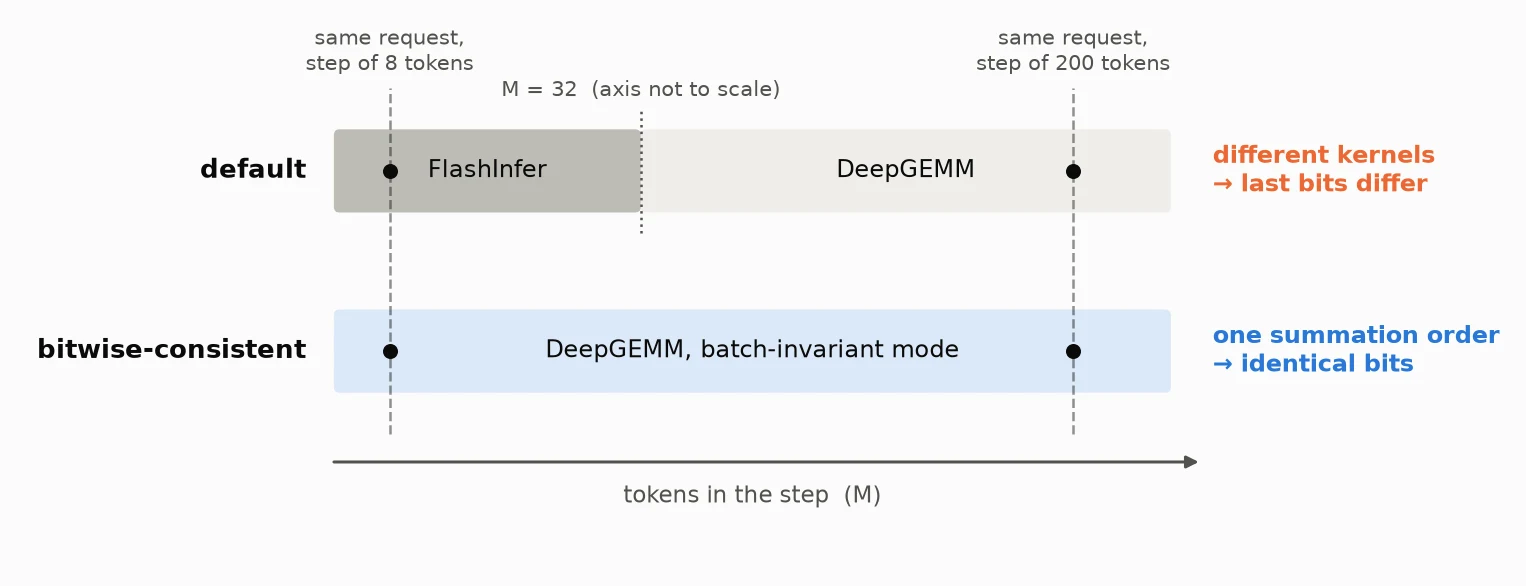
横軸: ステップあたりのトークン数(模式図)。デフォルトパスは 32 でカーネルを切り替えるため、同じリクエストが 8 トークンのステップと 200 トークンのステップでは FlashInfer と DeepGEMM を通過し、最下位ビットが異なります。batch-invariant モードでは加算順序が 1 つです。
コスト。 ロールアウトはより高速なスモールバッチカーネルと 1 つの mHC フュージョンを失いますが、Tensor Core は使用され続けます。トレーニングは再計算を含め、毎回のフォワードで重みを再量子化します。FP8 重みをキャッシュすれば、もう 1 つの常駐コピーを犠牲にしてその時間を節約できます。
4.2 FP8 KV cache: FP8 ストレージを維持し、読み取りパスを統一
維持した。 KV キャッシュは FP8 で保存され、BF16 の約 57% であり、これが同時実行数を直接決定します。両方の実行は書き込みパスを共有します。
断念した。 デフォルトのデコードは FP8 を直接読み取り、バッチごとに作業を分割する FlashMLA カーネルを使用します。prefill は BF16 に逆量子化し、sparse attention を実行します。2 つのフェーズは異なるアルゴリズムを実行し、デコードの分割はそのバッチに依存します。一貫バージョンではデコードを prefill パスにルーティングします。選択された KV を逆量子化して BF16 ワークスペースに集め、その後同じ flash_mla_sparse_fwd. ワークスペースはリクエストごとに割り当てられ、サイズはモデルの上限によってのみ制限されます。このデコードカーネルは明示的に選択する必要があり、consistency スイッチだけでは切り替わりません。
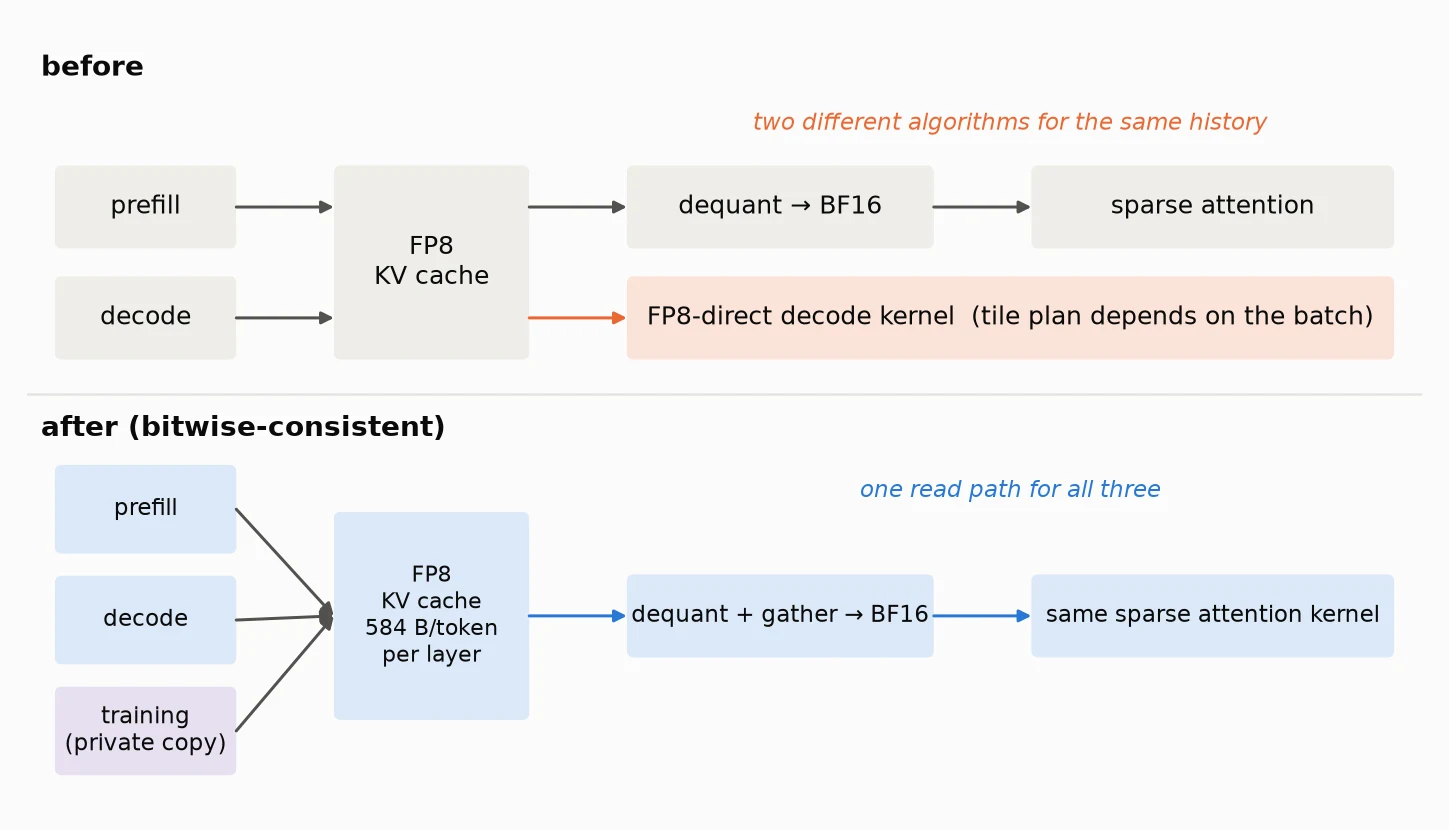
上: 変更前は、prefill と decode が2つのアルゴリズムで同じ FP8 の履歴を読み出し、decode のパーティションはバッチに依存します。下: prefill、decode、training(専用のキャッシュコピーを使用)が1つの読み出しパスを共有します。
Training には実際のキャッシュはありませんが、K は同じ FP8 のラウンドトリップを経る必要があります。同じ融合カーネルが専用の FP8 キャッシュに書き込み、同じ逆量子化がそれを読み戻します。
コスト。 Decode は gather と逆量子化を追加し、training はキャッシュを追加します。これがフェーズ一貫性の代償であり、ストレージの精度は変更されません。現在、各リクエストは1ステップにつき1トークンを生成します。multi-token prediction(MTP)と speculative decoding は対象外です。
4.3 スパースアテンションにおける Top-K: 同順位と順序の修正
問題。 DSAインデクサーはすべての履歴位置をスコアリングし、Top-Kは最大2048個をアテンション用に選択する。この離散的な選択が、上流の1 ulpの差を異なるコンテキストへと変えてしまう。スコアリングはまず整合される:インデクサーは同じDeepGEMMカーネルを使用し、prefillは連続的なKVを読み、decodeはページ化されたKVを読み、この2つの読み出しはビット単位で同一である。
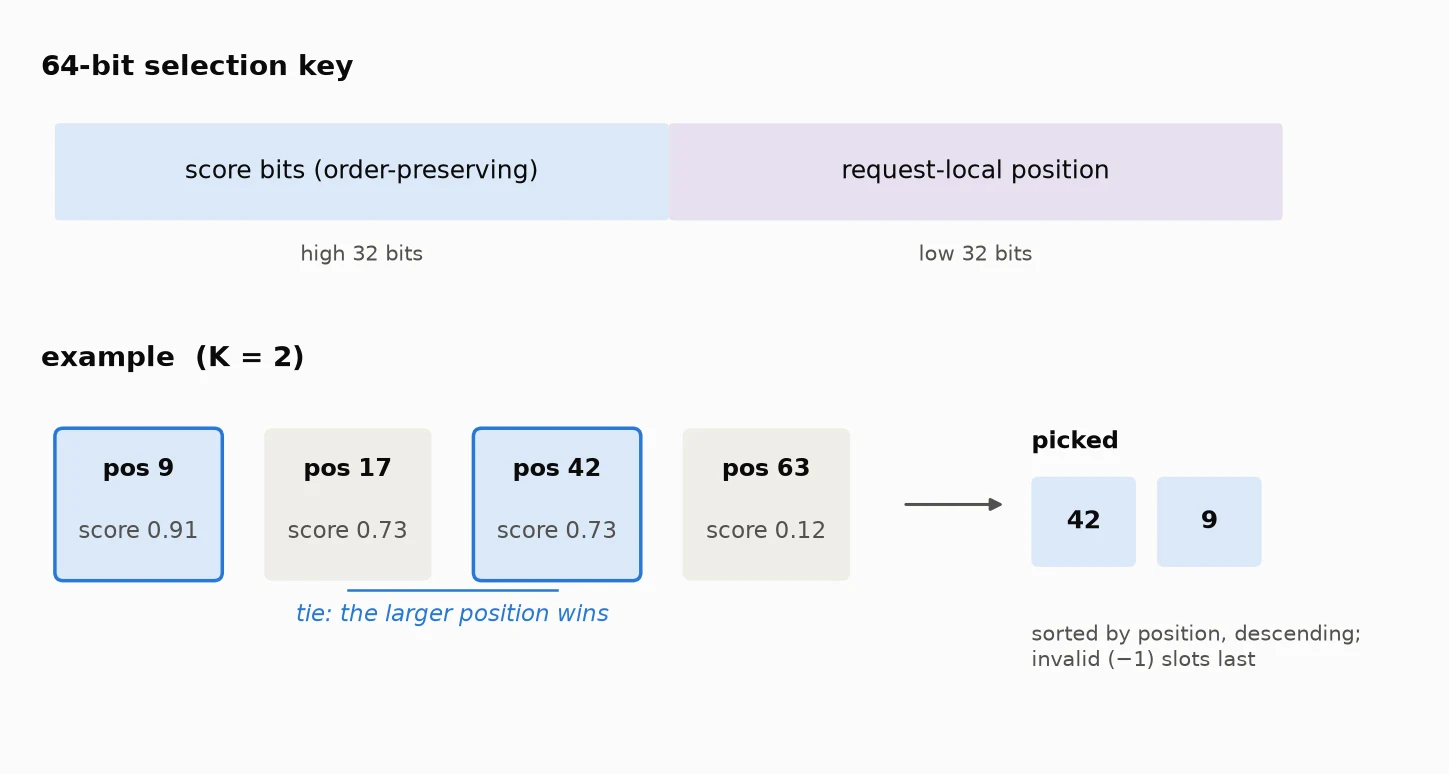
上:64ビット選択キーのレイアウト。下:K = 2の例。位置17と42が同点となり、キー内の位置ビットが42を選択する。選択された位置はその後、位置の降順でソートされ、無効なエントリは最後に置かれる。
選択と順序の修正。 デフォルトのTop-Kは同点の解決をスレッドスケジューリングに依存する。整合版はスコアとリクエスト内位置を一意なキーに結合し、同点の場合は大きい位置の方を採用する。これはグローバルなバッチ位置ではなくリクエスト内位置を使用する。そうしないと、バッチ内でリクエストを移動させた場合に同点の結果が変わってしまう。同じ集合では十分ではない:インデックス順序がアテンションの累積順序を決めるため、選択されたインデックスは位置の降順でソートされ、無効なエントリは最後に置かれる。
R3スタイルの代替案は、ロールアウトのインデックスを記録し訓練時にそれを再生するが、これはトークン・レイヤーあたり最大2048個のインデックスとなり、長い応答ではシーケンスあたりGB規模になる。
訓練側。 訓練のフォワードパスは同じスコアリングとTop-Kで同じ位置を選択するが、インデクサーは訓練されない。主に簡潔さのためである。これは既存の慣行と一致している: DeepSeek-V3.2 はDSAの訓練時にインデクサーの入力をdetachするため、RL損失はインデクサーに到達せず、また GLM-5 はRLにおいてデフォルトでインデクサーを凍結する。
コストと回復。 各側でソートが1回追加される。決定論的Top-Kは1回あたり約5.9 µsかかる。これをインデックスソートと融合すると、整合版の推論ベンチマークのスループットが6.7%向上する(構成は4.4参照)。残りのコストはprefillにおけるリクエストごとの複数回のカーネル起動である。
4.4 エキスパートGEMM:2つのレイアウト、同じ行結果
維持対象。 ルーティングされたエキスパートのFP8グループ化GEMMがMoEレイヤーを支配しており、2つの側は異なるレイアウトでこれに入力する。ロールアウトはDeepEP低レイテンシ(LL)モードを使用する(理由は4.5)。これはエキスパートごとにチャンク化され、チャンクあたり固定容量のマスクレイアウトをもたらす。訓練はDeepEPノーマルモードで多くのトークンを処理し、エキスパートごとにパックされた連続レイアウトをもたらす。
バックエンドの選択。 整合された両側はバッチ不変モードでDeepGEMMを使用する。これはオープンソースであり、バッチ不変モードを持ち、高性能なデプロイ用カーネルである。ベースラインのFlashInfer TRT-LLM MoEは事前コンパイルされたcubinとして出荷されるため、修正することもバッチ不変かどうか検証することもできない。cutlassはblock-FP8を欠き、tritonはバッチ不変性を宣言しないバッチ実装に落ちてしまう。1回のエキスパートGEMMにかかる時間は両側でほぼ同じである。ベースラインが速いのは、TRT-LLM MoEがマルチストリームパイプラインで通信と計算をオーバーラップさせるためである。
2つのレイアウトから同じ行結果。 3つの条件が満たされなければならない:
- エキスパートは同じFP8入力を受け取る。 LLはディスパッチ時に量子化し、ノーマルモードはその後に行う。当初は丸めが異なっていたが、両方を要素ごとのround-to-nearestに統一した。
- 各行の結果はレイアウトに依存しない。 量子化はトークンごとであり、バッチ不変のDeepGEMMは各行を固定された方法で累積するため、行の結果は隣接行に依存しない。ビット単位のルーター+MoEテストでこれを確認している。
- 活性化は1回だけ丸められる。 2つのGEMMの間のSiLU(gate) × upはFP32で計算され、積のみがBF16に丸められ、その後FP8に量子化される。乗算の前にSiLUをBF16に丸めると1 ulpの差が生じる可能性があり、これがFP8量子化によってコードの反転に増幅される。
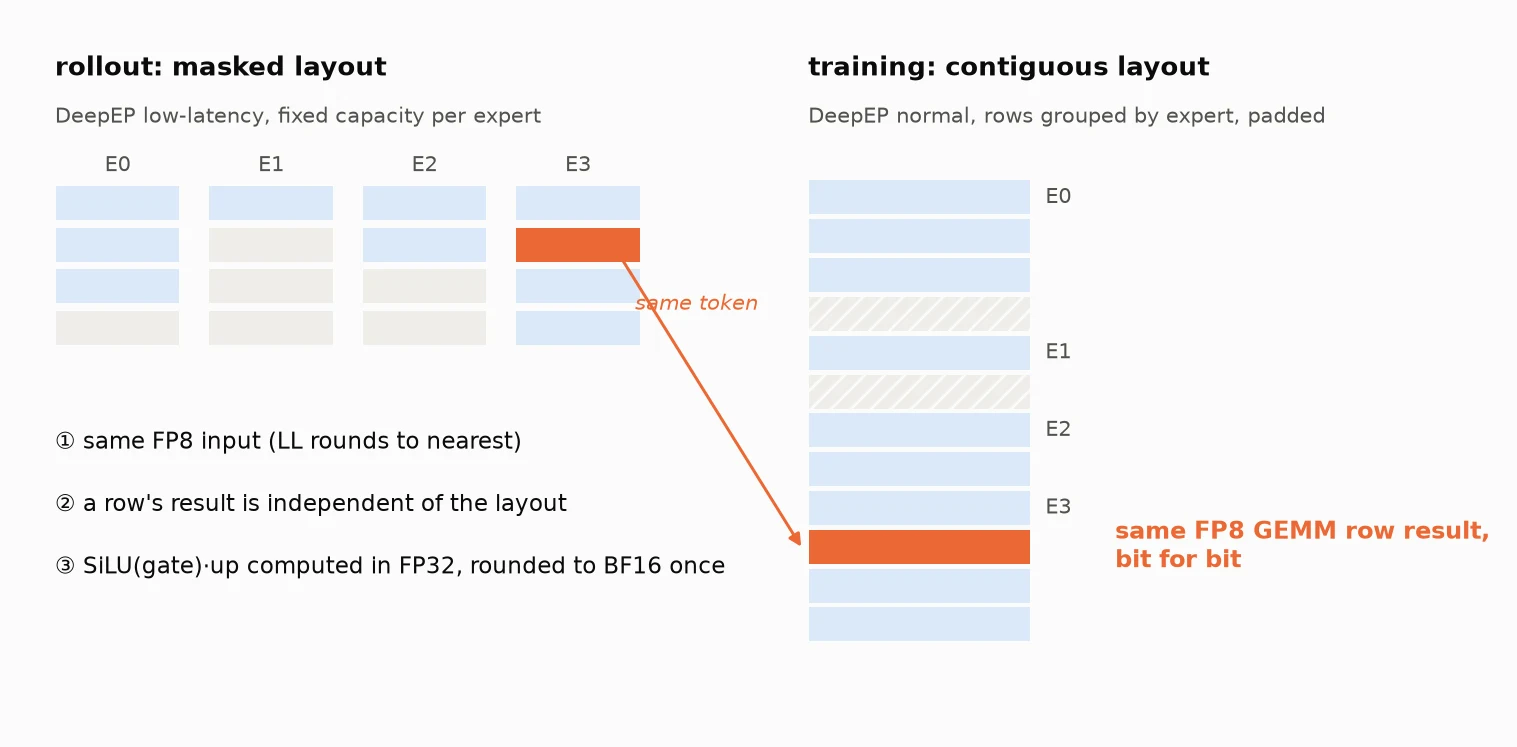
同じトークン(オレンジ)がロールアウトのマスクレイアウトと訓練の連続レイアウトで異なる位置に置かれているが、3つの条件によりそのエキスパートGEMMの結果はビット単位で同一となる。グレー:空きスロット。斜線:アライメント用パディング。
R3は不要。 ルーターのスコアリングGEMMは、ビット単位で同一の入力に対してすべてのバッチサイズで単一のFP32出力カーネルを使用するため、再計算されたルーティングはロールアウトと一致する。これは1ステップあたり1更新を前提とする(第2節)。
コスト。 RolloutはTRT-LLM MoEを諦めているが、GEMMは差額の大半ではない。推論ベンチマーク(GB200、DP8/EP8、256並行、リクエストあたり入力150/出力3000)では、一貫性のあるバージョンはベースラインより33%遅くスタートし、その約83%がオーバーラップできないLL通信によるものである(4.5)。学習は逆伝播のために中間結果を保存し、各エキスパートの行をパディングする。以下の推論ベンチマークの数値は最適化の異なる段階のものであり、同じ文の中だけで比較すること。
性能を比較する前に、ベースラインがどのカーネルを実行しているかも確認すること:vLLMは共有ライブラリが存在する限りバッチ不変のSiLU·mul·量子化カーネルを有効にし、一貫性スイッチを無視するため、そのライブラリを含むイメージはベースラインでもそれを実行する。
4.5 クロスGPUリダクション:比較対象のパスの外へ
問題。 Rolloutは低レイテンシを求めDP8/EP8を使う;学習は長系列のアクティベーションに対応する必要があり、EP32にCP4を組み合わせる。第2節で述べたように、異なるレイアウトでは並列度に対して不変な結果が必要で、通常は固定された高コストなリダクションツリーによって実現される。
選択。 このレシピは、 クロスGPUリダクションを比較対象の数値パスの外に置き、残りの通信は値を変えずにデータを移動する:
- TP=1。 線形層にはall-reduceがない。vLLMのall-reduceはメッセージサイズによってアルゴリズムを選ぶため、TPを使うとその依存性が戻ってくる;このレシピは起動時にTP>1を拒否する。
- EPマージはローカルで行われます。 all-to-allはデータの移動のみを行います。エキスパートの出力はトークンを所有するランクに戻され、EP=8と32の違いやどのランクが先に応答したかに関係なく、top-kスロット順にFP32で加算されます。
- CPはリダクションを行いません。 隣接ランク間では境界の隠れ状態のみを交換し、圧縮されたKVはCPグループ内でall-gatherされます。これは連結であって加算ではありません。
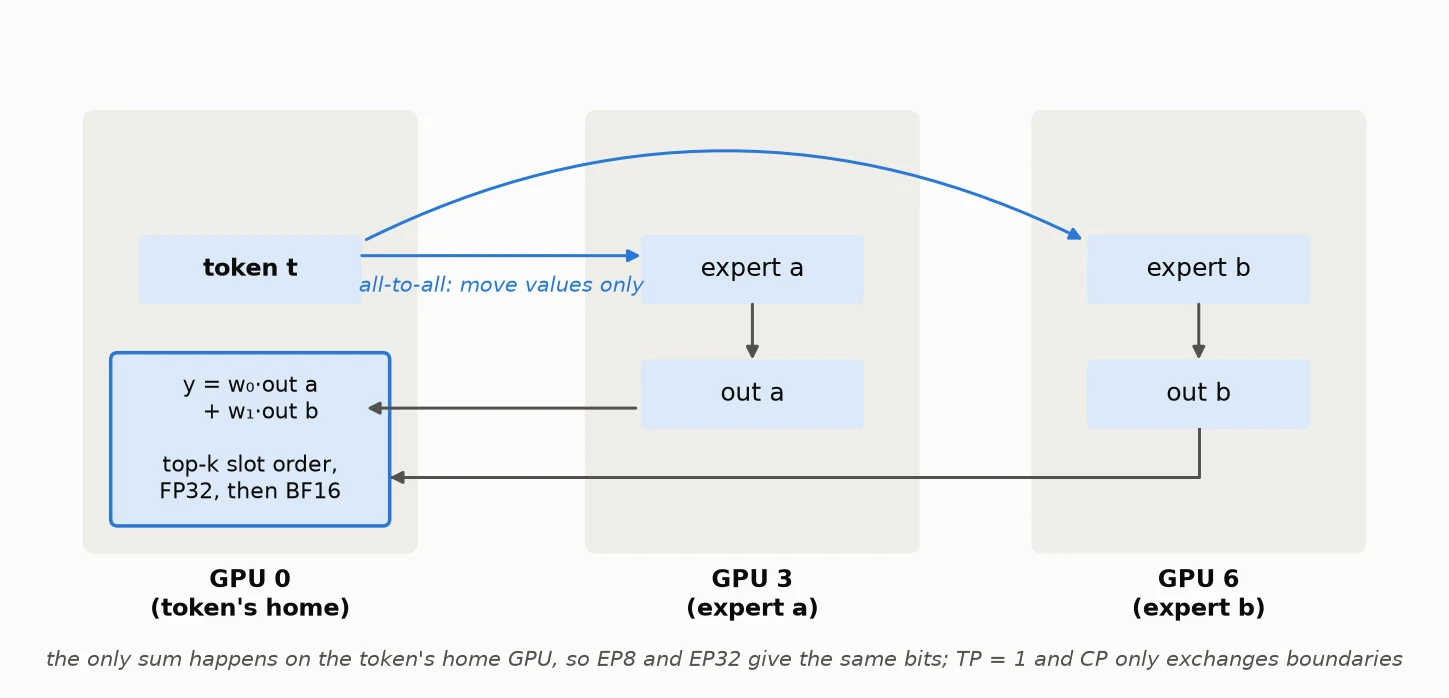
1つのトークンの経路: all-to-allはデータの移動のみを行い、加算はトークンを所有するGPU上で、top-kスロット順にFP32で行われるだけなので、EP8とEP32は同じ結果になります。
データ移動を決定論的にする。 ロールアウトでは、各ランクは1回の呼び出しあたり最大固定数のトークンを送信し、全ランクが足並みを揃えてセグメント化するため、通信の形状は固定されます。これを実装しているのはLLのみであり、DeepEPの通常モードはDP>1のときCUDA Graphを無効化するため、ロールアウトはLLを使う必要があります。訓練では、通常モードには固定された到着順序がないため、ルーティングメタデータをもう一度ディスパッチし、ビット単位のハッシュで各エキスパート出力をそのトークンとスロットに照合します。
コストとリカバリー。 LLモードでは、1ステップあたり43層 × 2 = 86回の直列all-to-allが発生し、これらは計算とオーバーラップできません。試した層間オーバーラップ方式は、入力の準備が整う前に計算をしてしまい、バッチ独立性を壊します。2つのマイクロバッチをインターリーブする方式(DBO)は39%遅くなりました。各層のエキスパート重みを2回読み込むことになり、重みの読み込みだけでHBM帯域の84%を既に使用しているためです。
最終的に、推論ベンチマーク上の通信ギャップを解消しました。まず両方の実行が同じトランスポートを使っていることを確認してください。私たちは、スクリプトが一貫性バージョンのDeepEPをEthernet RDMA(RoCE)に固定していた一方、ベースラインがるるかに高速なMNNVLを使っていたため、2日を失いました。トランスポートを揃え、共有エキスパートを補助ストリームに置いたところ、一貫性バージョンはベースラインより3.2%速くなりました(16834 vs 16313 tok/s)。
TP>1とデコードコンテキスト並列は、比較対象の経路上にクロスGPUリダクションを戻すことになるため、現時点ではサポートされていません。
4.6 CUDA Graph: グラフを維持し、一貫性と共存させる
なぜ維持するのか。 デコードでは1リクエストあたり1トークンの状況で、1層・1ステップあたり数十の小さなカーネルが実行されるため、起動オーバーヘッドが支配的になってしまいます。性能目標を達成するためにCUDA Graphを維持しています。グラフは3箇所でビット単位の一貫性と衝突します。
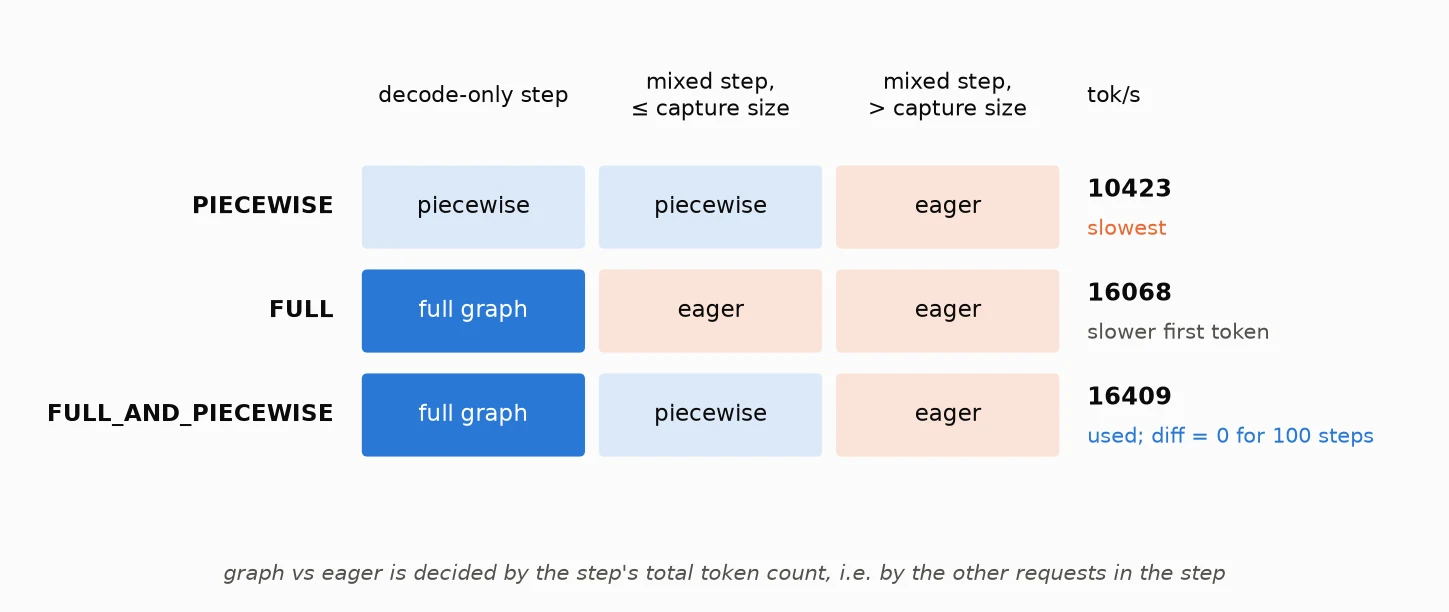
3種類のステップについて各モードが取る経路。右側に推論ベンチマークのスループットを示します。リクエストはバッチに応じてグラフとイーガーの間を切り替えるため、両方の経路がビット単位で同一である必要があります。
衝突1: グラフかイーガーか。 ステップの合計トークン数が最大キャプチャサイズに収まる場合はグラフで実行され、そうでなければイーガーで実行されます。これはステップ内の他のトークンに依存するため、2つの経路はビット単位で同一でなければなりません。これが最初の不一致でした。インデクサーの短コンテキストショートカットが、キャプチャ時にダミー入力の長さに基づいてグラフに焼き込まれていたのです。判定を静的な上限のみに依存させることで修正しました。
モードの選択も重要です。PIECEWISEはアテンションをキャプチャせず、DeepSeek-V4上のFULLは純粋なデコードステップのみをキャプチャします。推論ベンチマークではFULL_AND_PIECEWISEが16409 tok/s、FULLが16068、PIECEWISEが10423です。FULLはすべてのステップをイーガーのプレフィルと混在させて実行するため、最初のトークンまでの時間が764 msから1792 msに増加します。私たちはFULL_AND_PIECEWISEを使います。純粋なデコードステップにはフルグラフ、混在ステップにはピースワイズキャプチャを使用し、100ステップの実行を通じて差分は0のままです。
衝突2: グラフ内にホスト同期やバッチ依存の形状を置かない。 これは一貫性と整合しており、多くの設計が両方に対応します。MoEスケジューリングのヒントでは、エキスパートごとのトークン数をホストに読み返す代わりに静的な容量を使い(4.4)、LLは通信形状を固定し(4.5)、ワークスペースはモデルの上限のみでサイズが決められ、キャプチャ前に確保された後ロックされます。性能のみを目的としたショートカット分岐はキャプチャ時に無効化されます。
衝突3: グラフはアドレスをキャプチャするが、重みは毎ステップ変わる。 ロールアウトでは、新しい重みを元のストレージにコピーし、重みから導出されるパラメータをインプレースで再計算しなければなりません。グラフが古いアドレスのままになるような新しいメモリの割り当てはできません。最初のステップで一致するだけでは不十分なため、スキルは更新・エクスポート・リロードの後にも再度比較します。
コスト。 上限値で確保されたワークスペースはいくらかのメモリを消費します。その他の速度リカバリー(不要なデバッグパディングの除去、ロールアウトからのコールドスタートの除去、より高速なKVキャッシュのゼロ化)は両方の実行に適用されます。ベースラインにも同じ対策を適用しなければ、性能低下の数値は無意味になります。
5. Agent + skillによるエンジニアリングコストの削減
AとBは共存できますが、セクション4のマスター表とその中の重要な選択には専門家の判断が必要です。どのバックエンドがバッチ不変か、離散的な選択には同点の整列と順序が必要なこと、異なる通信モード間で量子化とマージ順序をどう整合させるか、そして通信ギャップはまずトランスポートの違いを排除する必要があること。新しいモデル、精度、ハードウェアでは最初からやり直しになるため、Cは成り立ちません。
DeepSeek-V4-Flashの後、この作業の大部分は2つのカテゴリに分類され、それぞれ測定可能な目標を持つことが分かりました。
- 差分を0にする。 重みと入力を固定し、両側が食い違う最初の演算子を見つけ、最小の再実行可能な再現コードに縮小し、修正し、その後実訓練で検証します。出力は直接比較されます。
- 差分を0に保ったまま性能を最適化する。 プロファイルのホットスポットを特定し、A/Bで単一のオペレーターを比較し、変更のたびに一貫性を再検証すること。結果が変わってしまう高速化や、実際のロールアウトではなくマイクロベンチマークでのみ効果が現れるものはカウントしません。ベースラインを遅くして差を狭めることも認められません。
コードを読み、呼び出しチェーンを追い、不一致の箇所を特定し、再現コードを書き、カーネルを変更してリグレッションを再実行するのは長時間に及ぶ作業であり、エージェントに適しており、成功は一貫性の比較とパフォーマンスの測定によって判定されます。
私たちはこれを以下としてパッケージ化しました。 train-inference-consistency スキル: エージェントに何をどの順番で行うか、そして各ステップが合格するために何を達成しなければならないかを指示するため、そのプロセスを他のモデルにも引き継ぐことができる。
このスキルには明示的な合格条件を備えた11個のゲート(C0–C10)があります。コールドスタートを高速化するため、私たちは まずフルモデルからいくつかの層を切り出して小さなモデルを作り、そこで問題の大部分を解決してから、フルモデルに移行します。5つのステップ:
- ターゲットとベースライン(C0–C1)を設定します。 モデルの各モジュールを精度および並列化とともに一覧表示してください。通常の一貫性なしバージョン(ベースライン)を、人間によるレビューに適した標準的な高パフォーマンスに調整してください。これが「一貫性ありバージョンがどれだけ遅いか」の分母となります。
- 小規模モデル(C2–C4)で推論を自己整合的にする。 小型モデル(通常はフルモデルから選んだ4〜6層)は、すべての演算子クラスを含み、隣接層間の相互作用を保ち、層ごとのサイズと量子化を一致させる必要がある。そうすることで、局所的な数値問題のほとんどを再現できる。フルモデルについては、十分な深さ、長いコンテキスト、マルチGPU構成、メモリ逼迫りを引き続き受け入れなければならない。まず、推論エンジンを内部的に一貫したものにする。すなわち、単独実行時とバッチ実行時でリクエストが同じ結果を返すこと、入力全体を一括処理した場合がトークンごとの処理と一致することを確認する。それと同時に、一貫したバージョンの速度を落とすことになる構造的な問題を探す。
- 接続訓練(C5–C7)。 学習では推論と同じ演算子を呼び出し、推論で生成されたデータを再計算してトークンごとに比較し、不一致があった場合には、最初に食い違いが生じた層を特定するために層ごとに比較します。その後、逆伝播を追加し、テスト対象のコードに依存しないリファレンス実装と勾配を照合します。順伝播に一貫性があっても、勾配が正しいとは限りません。
- RLを実行し、その後フルモデルに切り替えます(C8~C9)。 小規模モデルでは、実際の学習フレームワーク内で2回連続してアップデートを実行し、それぞれの前後を同じ重みバージョンで比較します。人間によるレビューの後、フルモデルに切り替えて段階的にスケールアップし、チェックポイント復元後の最初のステップの確認も含めます。
- 性能を回復する(C10)。 最もコストのかかる演算子を1つずつ最適化し、そのたびに整合性を再確認します。その後、配信イメージ上でベースラインとのペア比較を実行します。
最も重要な設計は2つあります。第一に、 2つのエージェントがベースラインと整合性を並行して進めます。1つはベースラインを高速化し、もう1つは整合バージョンを構築します。チューニング済みのベースラインは人間レビューのために凍結されるため、エージェントが意図的に遅くして差を縮めることはできません。第二に、 私たちの落とし穴がプロセスに書き込まれています: 実行中のプログラムが読んでいるソースと一致していること、チェックポイントは保存だけでなく復元後の最初のステップを検証すること、すべての性能の結論には公平なベースラインと追跡可能な生データが必要なこと、通信ボトルネックを比較する前に両方の実行が同じトランスポートを使っていることを確認すること(4.5からの教訓)。
このスキルはローカライズとリグレッションのコストを下げます(ここでは削減額はまだ定量化されていません)。人間の判断を置き換えるものではありません。人間は引き続きベースライン、精度のトレードオフ、レシピをレビューします。一例が、1ステップに複数回のアップデートがある場合のルーティングのドリフトです。エージェントが症状から小規模な再現コードを作り、判別実験を実行して仮説を排除し、1ステップ1アップデートに移行するかどうかを人間が決定しました。
6. 転移:Nemotron、Mambaハイブリッドアーキテクチャ + NVFP4
次に、この参照レシピとスキルを、構造的に大きく異なるモデルでテストしました。
Nemotron-3.5-Lightning-30B-A3B(NVFP4) は、GB200上のMamba-2 / attention / MoEハイブリッド(NVFP4 W4A16のrouted experts、FP8のMambaプロジェクション、attention用のFP8 KVキャッシュ)です。ベースラインはNVFP4 QAT学習(量子化ルールとエクスポートはNVIDIA ModelOpt)+ R3ルートリプレイを使用し、整合バージョンはルートリプレイなしでvLLMのフォワードを共有します。両方の実行はBF16のマスター重みと1ステップ1アップデートを使用します。
再帰構造には先例があります。vLLMコミュニティでは、Alexander JiangとSkyRLチームが、Qwen3.5-35B-A3BのGated DeltaNet(GDN)のためにchunkwise-parallel recurrent(CPR)を IsoExec Qwen3.5-35B-A3B の Gated DeltaNet(GDN)について:これは再帰形式を保ちながらチャンク並列で計算するため、学習、prefill、decode が1つの丸め順序を共有し、その 統一モデル により学習と推論が1つのモデル定義と1組の整列済みカーネルを共有します。IsoExecの「ゼロ不一致」はその実行コントラクト内で成り立ちます。エンドツーエンドでは、本投稿の「ビット単位で同一」とは異なり、ごくわずかな非ゼロのlogprob差(平均絶対差は約1e-7)が依然として報告されています。Mamba-2は同じ種類の線形漸化式です。私たちは、decodeが独自の単一ステップ漸化式ではなくprefillのチャンク化された演算を正確にリプレイするようにし、学習は統一モデルと同様に推論と同じ演算子をインポートします。この整列をエージェント+スキルが行いました。
vLLMでは、バッチ構成に依存する可能性のあるすべての演算子にバッチ不変な実装が用意されており、学習側(軽量なMegatron-LMフォーク)がそれらをインポートします:
| オペレーター | 一貫したバージョン |
|---|---|
| Mamba-2 SSD スキャン | decode は prefill のチャンク演算を正確に再現、固定 autotune 設定、fp32 状態 |
| Attention | 固定 split-KV を用いた FlashAttention、分割数はバッチに依存しない |
| ルーティング experts(NVFP4 W4A16:4 ビット重み、16 ビット活性化) | CuTe-DSL grouped GEMM、単一 tactic、split-K なし、slot 順の fp32 マージ |
| MoE all-to-all | 片側通信、固定マージ順序 |
| Router GEMM | バッチ不変の persistent matmul、fp32 出力 |
| Norm / FP8 量子化 | 統一されたバッチ不変カーネル。値を変える融合は禁止 |
結果:SWE-bench Pro での学習
SWE-bench Pro に対してリモートサンドボックス上でエージェンティック強化学習(エージェンティック RL)を実行します:1 ステップあたり 32 タスク × 8 トレジェクトリ、トレジェクトリあたり平均約 57K トークン、GRPO、1 実行につき 8 GB200 ノード。トレーニングセットは、ベースモデルの 4 回のサンプリング試行がすべて正解でもすべて不正解でもなく、かつゴールドパッチが当社のサンドボックスで通過する 375 の SWE-bench Pro タスクです。したがって、以下のスコアはこのサブセット上でのトレーニング報酬です。両方の実行は同じイメージとレシピを使用し、TIS や MIS などの修正は行っていません。ステップあたり 1 回の更新では、更新前のロールアウト logprobs とトレーニング側の再計算との間の KL が、そのステップの train-inference KL となります。
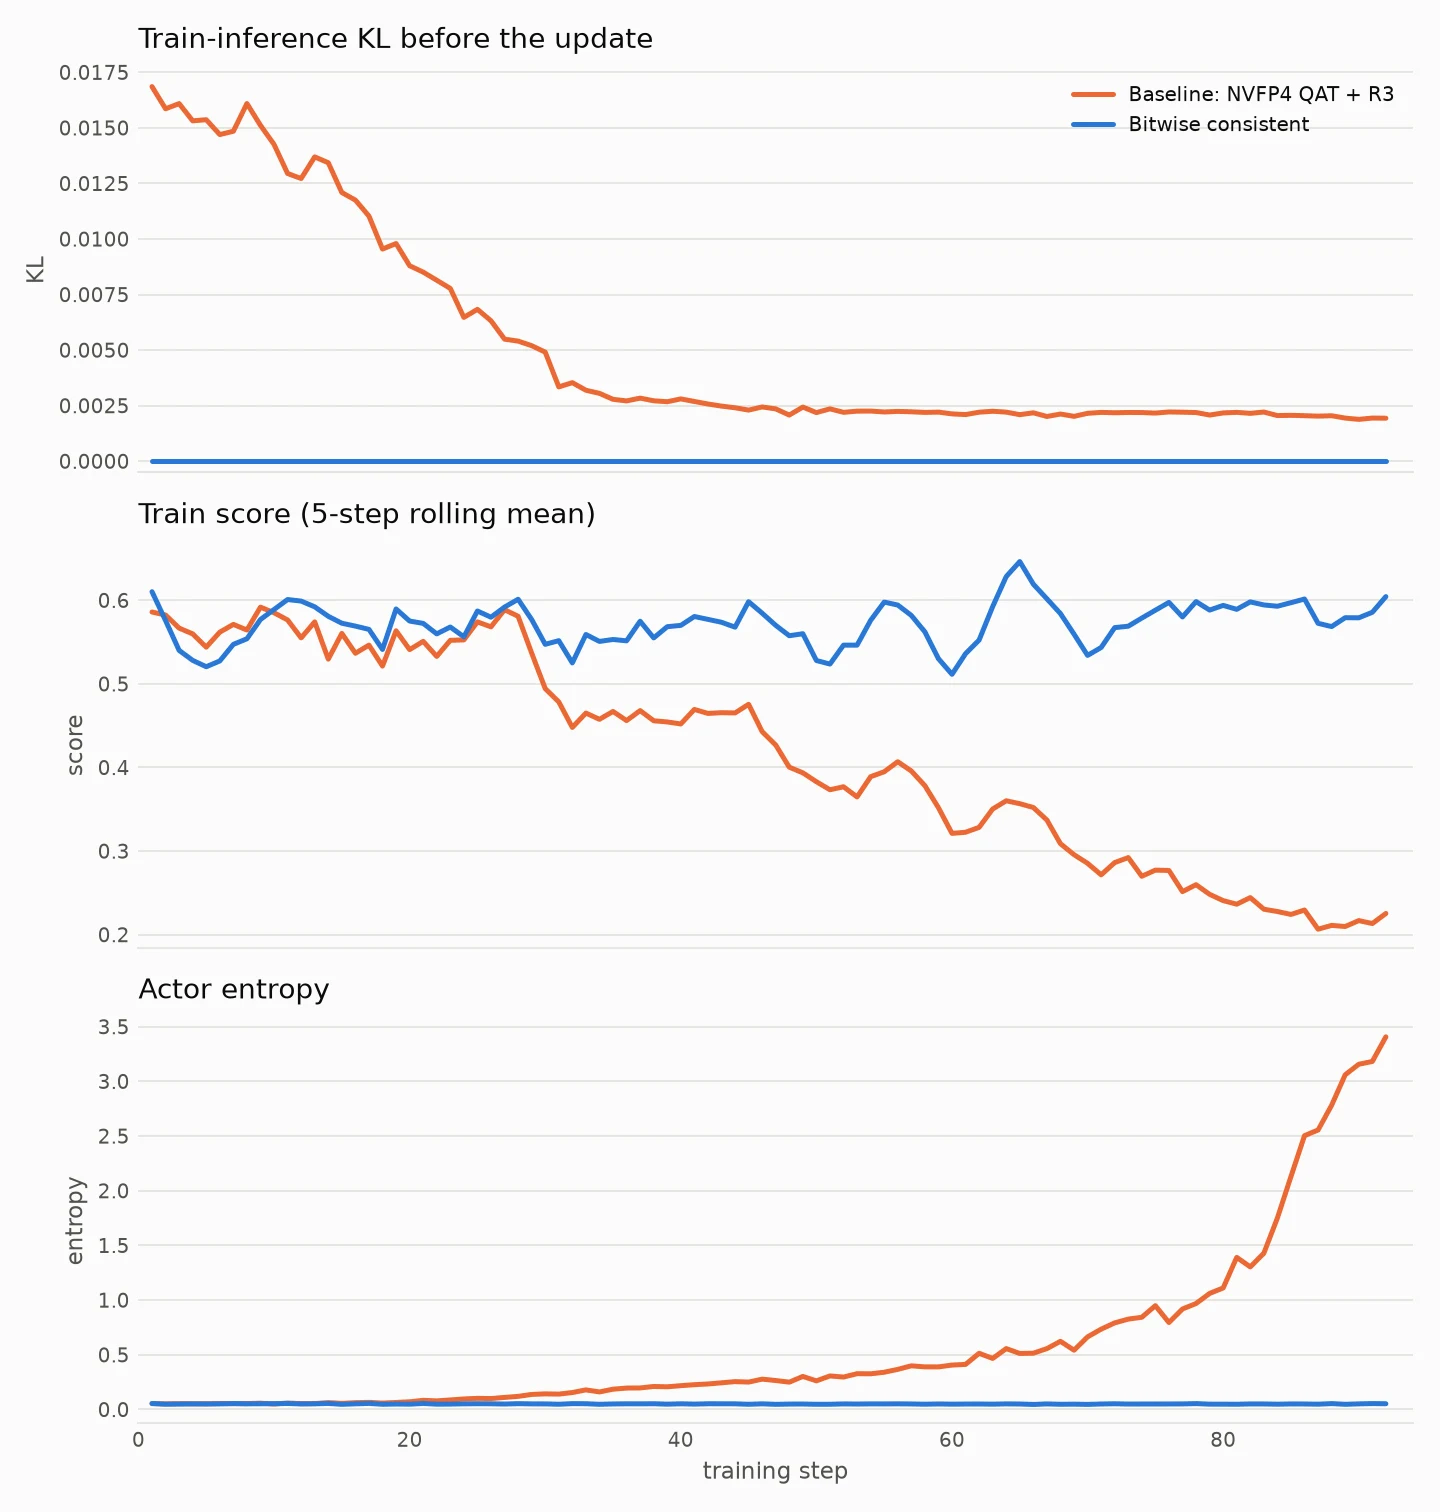
上段:ステップごとの train-inference KL。中段:トレーニングスコア(現在と直前 4 ステップの移動平均)。下段:アクターのエントロピー。オレンジ:ベースライン、青:consistent 版。consistent 版のステップ 10 ではサンドボックスから戻ってきたトレジェクトリがほんの数本しかなかったため、そのスコアは除外しています。
- Consistent 版:train-inference KL は毎ステップ正確に 0 であり、エントロピーは約 0.05 で推移し、スコアは 0.56(最初の 10 ステップ)から 0.59(最後の 10 ステップ)へと、低下はありません。
- ベースライン:train-inference KL は約 0.015 から約 0.002 へ低下しますが、エントロピーは 0.05 から 2.6 へ上昇し、スコアは 0.56 から 0.22 へ低下します(最初の 10 ステップと最後の 10 ステップの比較)。
- ロールアウト速度:最初の 30 ステップの間、両方の実行が健全な状態である間、consistent 版のロールアウトスループットはベースラインの 87.5% で、わずか 12.5% の低速です。
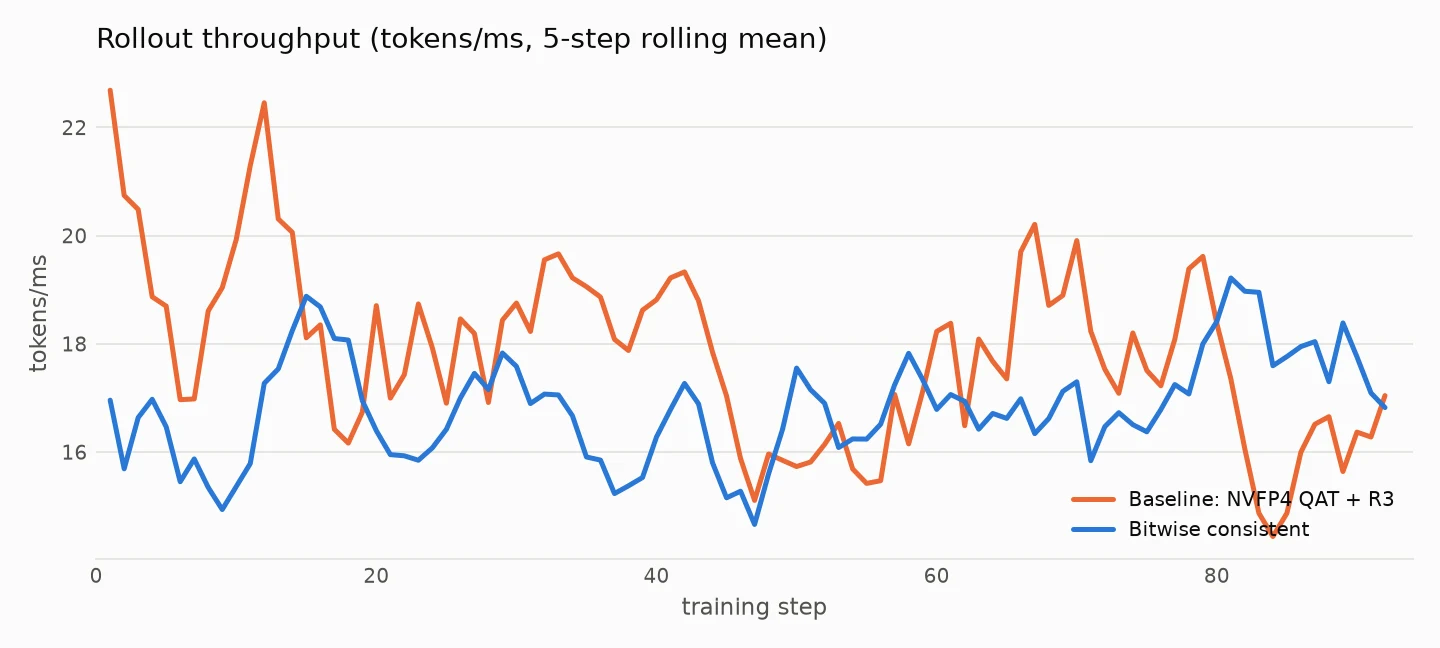
ステップごとのロールアウトスループット(token/ms、現在と直前 4 ステップの移動平均)。オレンジ:ベースライン、青:consistent 版。
7. オープンソース
この成果をオープンソースとして公開するのは、他の皆さんが、演算子を一つずつ上級エンジニアが確認することへの依存を減らし、スキル、既成のコード、そして自身のモデル上のエージェントを使って train-inference の一貫性を達成できるようにするためです。リリース内容:
- train-inference-consistency スキル:完全なワークフロー(C0–C10)、10 本のガイド、および logprob 比較や勾配クロスチェックなどの主要なプラクティス;
- DeepSeek-V4:Megatron と vLLM 上で diff 0 を達成する真のオンポリシー RL レシピ、 verl-project/verl#7688;
- Nemotron-3.5-Lightning-30B-A3B (BF16 のマスター重みを、トレーニングの forward 時と重み同期時にデプロイ用の NVFP4 へ量子化):
- トレーニングと整合した vLLM のビット単位一貫推論: aoshen02/vllm#85;
- vLLM と整合したトレーニングアクター: aoshen02/Megatron-LM#7;
- verl への 2 つの変更: aoshen02/verl#11;
- train-inference 一貫性レシピと統一イメージの Dockerfile: aoshen02/verl#12.
自分のモデルでこのスキルを使った際の Issue、PR、フィードバックを歓迎します。
次:DeepSeek-V4.1 の train-inference 一貫性は diff 0 に到達済みです。パフォーマンス最適化は進行中で、別の記事として公開予定です。
謝辞
以下の方々に感謝します(組織名はアルファベット順):