
私たちの最新リリースである Apertus 1.5 は、8B および 70B の Apertus 1.0 モデルを、画像・音声理解、オプションの思考モード、4倍に延長されたコンテキストウィンドウ、向上した指示追従性、そしてより優れたツール利用によって拡張したものです。更新された 8Bおよび70Bのモデルウェイト は、2026年7月24日にApache 2.0ライセンスの下でHugging Faceに公開されました。詳細はプロジェクトから入手できます 技術レポート、以下に要約する。
Apertus 1.5 は第一世代モデルの継続事前学習です。8B モデルには 4 兆トークンのテキストおよびマルチモーダル学習データを追加し、70B モデルには 2 兆トークンを追加して、それぞれ合計 19T と 17T となりました。すべての Apertus リリースと同様に、モデルは完全にオープンです:オープン 重み, オープン データ、開く 値「、および完全なトレーニング」 詳細.
主な強化点
- ネイティブ・マルチモーダル理解: Apertus 1.5はテキストに加えて画像と音声を受け付け、文書、図表、写真を会話に取り込むことができます。モデルは話し言葉も処理できますが、これは依然として実験的な機能です。
- 思考モード: これらのモデルは思考モードに切り替えることができ、回答前に 入力について推論することで、推論問題における性能が向上します。
- 長いコンテキスト: コンテキストウィンドウは262,144トークンに拡大し、Apertus 1.0の4倍の増加です。
- 指示追従性の向上: Apertus 1.0 よりも指示への遵守力が高く、より予測可能で正確な応答を実現します。
- ツール利用の改善: これらのモデルは、より優れたツール統合を目的として訓練されており、外部ツールやAPIをより効果的に利用できます。
- Open Values: モデルの価値観と原則を透明化するApertus憲章の、より強固な遵守。
トレーニングプロセス
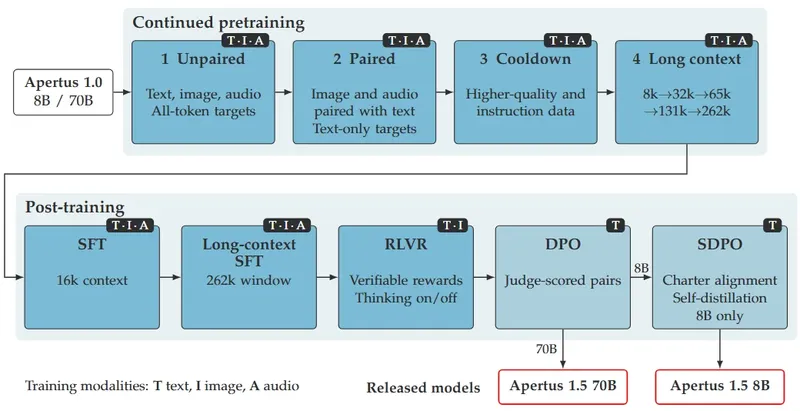
 Apertus 1.5の完全な学習パイプライン
トークナイザーによるマルチモーダリティ
v1.5モデルにマルチモダリティを早期融合(early-fusion)方式で導入しました。これは、画像と音声を、別個のビジョンエンコーダーを使うのではなく、テキストトークンと同じシーケンス内の離散トークンとしてApertusに入力する方式です。画像は次の方法でトークン化されます。 Emu3.5 トークナイザ(512×512の画像は1,024トークンになる)と、音声は WavTokenizer (毎秒40トークン)を使用します。語彙を拡張するだけで、アーキテクチャは変更されず、学習はテキストのみの場合と同じ速度で実行されます。モデルは画像と音声を理解しますが、生成はテキストのみです。

事前学習
Apertus 1.0を出発点として、4つの段階で事前学習を継続します:
- 非ペア: テキストに加えて単体の画像と音声を用い、モデルに新しいモダリティを学習させます。
- ペア: 画像–キャプションおよび音声–文字起こしのペアを用い、言語と対応付けます。
- クールダウン: 数学とコードを増やした、より高品質なデータを使用します。
- 長文脈: コンテキストウィンドウを8kから262kトークンへ段階的に拡大します。
全体として、学習トークンの半分以上はテキストのみであり、これによりApertus 1.0の言語能力が維持されます。テキストデータは FineWeb2-HQ+、FinePDFs、Nemotron-CCなどのソースで更新されています。マルチモーダルを含むすべての新規データは、以前と同じ基準を満たしています:公開されていること、許容的なライセンスであること、そしてrobots.txtによるオプトアウトが遡及的に尊重されていること。すべてのソースは apertus-data-transparency.
に一覧されています。
事後学習 事後学習は5つの段階で実行されます:.
- SFT → 長文脈SFT → RL → DPO → チャーター整合(SDPO) 3.7M件のテキストサンプルに画像および音声データを加えたデータでSFTを実施します。推論トレースは、モデルがそれなしではまだ解けないプロンプトにのみ追加されます。ツール使用データは実行検証済みの軌跡に限定されます。Hugging Faceで使用した テキストSFTミックス を公開します。
- 長文脈SFT を最大の262kウィンドウで実施し、短い文脈のSFTで損なわれる長文脈能力を回復させます。
- 検証可能な報酬を用いたRL(RLVR) を、約350k件の数学、コード、指示追従、多言語、ビジョンのプロンプトで、thinkingのオン・オフを混ぜて実施します。
- DPO 審判による選好ペアを用いた学習により、チャットの品質、ツール使用、安全性が向上します。我々は 優先投票プール および 学習ペア.
- SDPO モデルを以下のものと整合させる Apertus 憲章 審査員のフィードバックと自己蒸留を通じて。
評価結果
拡張されたモデルの能力に加えて、評価の範囲も大幅に拡大しました。Apertus 1.0で使用していた従来のテキストベースの評価に加え、マルチモーダル評価(画像・音声)や思考モード評価を追加しました。
マルチモーダル評価は、以下を通じて行われます MLLM-eval-suite 2つの主要なマルチモーダル評価フレームワークを統合するパイプライン lmms-eval および VLMEvalKitまた、一連のテキストベースのベンチマークに加え、翻訳および多言語能力、安全性、ツール使用に関する拡張ベンチマークも追加しました。これらは弊社のポストトレーニングでご覧いただけます 評価リポジトリに基づく lm-evaluation-harness fork.
フロンティアのオープンウェイトモデルにはまだ及ばないものの、今回の新リリースはコーディングおよび指示追従能力のパフォーマンスも大幅に向上しており、Apertus 1.5 8Bは同等サイズのオープンウェイトモデルをIFおよび多言語タスクで上回っています。Thinkingモードにより、AIMEのような推論が重い難易度の高いベンチマークでのパフォーマンスがさらに向上します。モデルのマルチモーダル性能は、 Gemma 4 12B およびその他の現在のオープンウェイトモデル。Apertus 1.5のマルチモーダル性能は、空間理解においてはオープンウェイトモデルの中で、文書・チャート理解においてはオープンソースモデルの中で競争力があります。
また、Apertusの能力の効率的なベンチマーク評価にご協力いただいた共同研究者および外部評価者の方々にも感謝申し上げます。特に、Apertus 1.5はスイスの法律関連タスクにおいて優れたパフォーマンスを示し、主要なオープンウェイトモデル(ブログ, コード)。さらに、Last Translation Benchmark において、Apertus 1.5 8B は匹敵する機械翻訳能力を示しています。 GPT-OSS-20B や、以下のようなモデルを上回ります。 Claude Haiku 4.5 または Google 翻訳 (リーダーボード, 論文).
Evaluation Cards: Apertus ❤️ EvalEval
Apertus は EvalEval Coalition と協力し、完全に透明性があり再現可能なベンチマーク評価を実現しています。Apertus 1.5 の結果は、 Every Eval Ever (EEE) スキーマで公開しています。これは、スコアだけでなく、誰が評価を実行したか、モデルにどのようにアクセスしたか、生成設定、そして各指標をどのように解釈すべきかを記録する共通フォーマットです。こうした詳細はリーダーボードでは通常欠落しており、似たようなスコアが異なる理由をしばしば説明するものです。
結果は以下の Eval Card に示されています。これは実行データをベンチマークおよびモデルのメタデータと組み合わせ、1 つの解釈可能なレコードにまとめたものであり、 Hugging Face Community Evalsからも入手できます。これは UK AI Security Institute が評価を公開的に発表するために使用しているのと同じインフラストラクチャです。テキスト評価は lm-evaluation-harness の公開フォーク上で実行されており、EEE が専用のコンバータでこれをサポートしているため、誰でも同じ設定のもとで再実行し、その数値を私たちの結果と比較することができます。
構造化された評価レポートは、研究の枠を超えて重要です。EvalEvalは Evaluation CardsをAIガバナンス要件にマッピングした(EU AI法第55条やGPAI行動規範などを含む)を調べ、EEEスキーマがこれらのフレームワークが求める60の評価報告要素のうち56を表現できることを確認しました。これは、私たちがすでにApertusを公開している方法とも合致しています。モデルに加えて、私たちは 公開要旨 トレーニングコンテンツの、および自主的に、 行動規範 文書。機械可読な評価記録は自然な次のステップです。規制当局、展開者、研究者がモデルの裏付けとなる証拠を見つけ、解釈し、比較しやすくするためです。
私たちはEval CardsとEEEスキーマを通じて再現可能で透明性のある評価を推進することに取り組んでおり、他のモデル開発者にも同じ方法で結果を報告することを奨励し、スコアをモデルや組織を横断して比較できるようにしています。
Apertus 1.5 再現性
すべてのレシピ、アブレーション、およびデータ混合については以下に文書化されている。 技術レポート。私たちはv1.5の学習プロセスを公開し、誰でもアクセスできるようにすることで、オープンモデル開発の普及を目指しています。中間チェックポイントは私たちの Apertus 1.5 Hugging Faceコレクション、ベースの重み、SFT、RLVR、DPOを含み、さらに私たちが厳選したトレーニングデータのミックス/カスタムデータセットも含まれます。 Apertus 1.5 データセットコレクション。これらを共有することで、研究者は各段階がモデルの挙動をどう変化させるかを調査できる。
レポートでは、異なるステージにおけるポストトレーニングデータの影響について多数のアブレーションを取り上げており、その中で、SFT中にテキストデータと一緒にマルチモーダルデータを混ぜることで、すべてのモダリティにわたって性能が向上することが観察されました。また、マルチモーダル推論トレースの効果は、その後のテキストのみの強化学習でも維持されることが分かりました。マルチモーダルトレースで学習したSFTチェックポイントから開始した場合、テキストのみのチェックポイントから開始した場合よりも、RLによる数学の向上が大きく、推論タスクにおける優位性はトレーニング全体を通じて持続します。
| モデル | 8B | 70B |
|---|---|---|
| 事前学習(長コンテキスト・ベースモデル) | Apertus-v1.5-8B-base | Apertus-v1.5-70B-base |
| 教師ありファインチューニング(SFT) | Apertus-v1.5-8B-SFT | Apertus-v1.5-70B-SFT |
| 強化学習(RLVR) | Apertus-v1.5-8B-RLVR | Apertus-v1.5-70B-RLVR |
| 嗜好アライメント(DPO) | Apertus-v1.5-8B-DPO | Apertus-v1.5-70B (最終版) |
| 憲章との整合性(SDPO) | Apertus-v1.5-8B (最終) | – |
| ステージ | データ | コード / レシピ |
|---|---|---|
| 事前学習: ステージ 1~2 (ペアワイズなし、ペアワイズあり) | バージョンとライセンスを含むすべてのソースは apertus-data-transparency; ビジョンおよびオーディオ処理のレシピ(〜内の) マルチモーダルデータ | Megatron-LM、起動スクリプトを pretrain-code, apertus-omni-tokenizer, benchmark-image-tokenizer, benchmark-audio-tokenizer (音声とテキストを組み込むビルダーを含む) |
| 事前学習: ステージ3 (クールダウン) | apertus-data-transparency;厳選された画像データセット NASA, Our World in Data, Smithsonian, swisstopo | Megatron-LM、起動スクリプトは pretrain-code |
| 長コンテキスト拡張 | apertus-data-transparency;合成長コンテキストタスクは LongContextQA | Megatron-LM、起動スクリプトは pretrain-code |
| SFT | Apertus-v1.5-SFT-mix (マルチモーダルSFTミックスはレポートに記載) | posttraining-data, Megatron-LM (SFT起動スクリプト) |
| 長コンテキストSFT | SFTミックスのサブセット(レポートに記載)に加えて LongContextQA タスク | Megatron-LM |
| RL (RLVR) | ミックスはレポートに記載 | verl, verl-recipe |
| DPO | Apertus-v1.5-Preference-Pool (注釈付きの補完)、 Apertus-v1.5-Preference-Data (ペア) | ポストトレーニング, verl |
| SDPO (charter整合性、8Bのみ) | gretelai/gretel-safety-alignment-en-v1 | 自己蒸留 |
モデルの提供状況
Proton Lumo および Infomaniak Euria は、最近Apertus 1.5を統合した、広く利用されている2つのアプリです。これらの展開は、以下の コミュニティショーケース など - これを参照 ディスカッションスレッド プレビューをご覧ください。
開発者向けのAPIとしてのApertus 1.5へのアクセスは、以下を含む複数のプロバイダーから提供されると発表されています。 Swisscom(スイスコム), Infomaniak, Phoeniqs、および弊社の に記載されている他の企業 一般提供ガイド。「また、このレポートでは、モデルのテストと準備のために外部の評価者とどのように連携しているかについても詳しく説明しています。」
モデルの実行に関する技術的な手順は、Hugging Face で公開されている Apertus リリースのモデルカードおよび私たちの クイックスタートガイド.
参加方法
このブログ記事をお読みいただき、コミュニティの一員となってくださりありがとうございます!Hugging Faceのアナリティクスで先ほど5,000,000ダウンロードを達成したばかりで 🤗、勢いは止まりません。先日の AI+Xサミット チューリッヒで、私たちのチームはのロードマップを発表しました Apertus 2.0: スパース/MoEアーキテクチャ、合計約600Bパラメータ、延長されたトレーニングスケジュールで、エージェント、数学、コーディングを優先事項とする。
まとめとして、レポートをお読みいただき、モデルをダウンロードし、中間チェックポイントを探索し、重みをファインチューニングし、評価を再現していただくようご案内します。 弊社の出版物 や ウェブサイトのFAQ でまだ扱われていないご質問はいつでも歓迎します。また、今後の深掘り記事に役立つトピックについて、コミュニティにとって最も有用なものをぜひお聞かせください。
Apertus を利用・活用される場合は、ぜひ ショーケースフォームにご記入いただき、 コンタクトページの選択肢からご連絡ください。皆さまの取り組みをさらに紹介し、何を構築されているかを知り、Apertus の改善点を伺えることを楽しみにしています!
引用
Project Apertus ほか「Apertus 1.5: From Open Text Models to Open Multimodal Reasoners」arXiv:2610.15542。プレプリント、arXiv、2026年10月11日。 https://doi.org/10.48550/arXiv.2610.15542.
@misc{apertus2026apertus15opentext,
      title={Apertus 1.5: From Open Text Models to Open Multimodal Reasoners},
      author={Project Apertus and Yixuan Xu and Yassine Turki and Vinko Sabolčec and Valentina Pyatkin and Tommy Chu and Sven Najem-Meyer and Sean F. Carroll and Robert Smith and Raphael Kreft and Oscar Alessandro Tazza and Oleg Lavrovsky and Nicola Irmiger and Matteo Santelmo and Marian Schneider and Juan García Giraldo and Hanna Yukhymenko and Eduard Ďurech and Davit Melikidze and Dani Tamayo and Bettina Messmer and Aryan Ahadinia and Anunay Yadav and Allen Huang and Ahmad Fraij and Alessandro Bombarda and Alex Padula and Alexander Hägele and Alexander Sternfeld and Anna Hedström and Anna Kosovskaia and Arthur Wuhrmann and Arundhati Balasubramaniam and Badr Al Mahouri and Barna Pasztor and Bartosz Szostakiewicz and Bich Ngoc Doan and Bryan Schmid and Burak Sezen and Camille Challier and Clément Charmillot and Dana Shayakhmetova and Daniel Perruchoud and David Brüggemann and David Isztl and Elia Palme and Emma Anastassova and Fabian Bösch and Faruk Zahiragić and Fawzi Roberto Mohamed and Fiona Panicali and Florian Kolly and Flynn Guerra and Francesco Monti and Frederike Lübeck and Gennaro Oliva and Haofeng Yang and Haoliang Shang and Helen El Khoury and Henrique Mendonça and Jannis Vamvas and Jérome Landolt and Jessica Lam and Jingchun Xiao and Jonathan Coles and Joshua Oyebanji and Khanh Nguyen and Konstantinos Pitas and Lasse B. Strand and Li Mi and Loïc Deslarzes and Lorenzo Baggi and Lorenzo Noci and Luca Baumann and Luca Sartori and Lukas Drescher and Marco De Negri and Marco Passerini and Mark Klein and Marko Stojanovic and Martin Majsec and Matin Ansaripour and Mattea Busato and Mauro Pellonara and Max Neuwinger and Michael Graber and Michal Tešnar and Michelle Wastl and Miguel Gila and Mikolaj Boronski and Morgane Magnin and Moritz Reihs and Mukhammadali Sayfiddinov and Nathan Ranchin and Nicolas Cuveillier and Oscar Wohlfahrt and Qianqian Zou and Rada Kamysheva and Rita Sevastjanova and Roman Machacek and Sebastian Keller and Simon Matrenok and Simon Pierre and Stefano Schuppli and Suei-Wen Chen and Szabina Horváth-Mikulas and Taliesin Perez and Thilo Spinner and Thomas Kleine Buening and Tim Robinson and Tymoteusz Kwiecinski and Vilém Zouhar and Vinzenz Thoma and Xiaozhe Yao and Yannick Metz and Yuhei Fukuhara and Yusif Askari and Zixuan Chen and Alexander Ilic and Ana Klimovic and Andreas Krause and Andrei Kucharavy and Elliott Ash and Joost VandeVondele and Martin Rajman and Mennatallah El-Assady and Thomas Schulthess and Timo Kehrer and Torsten Hoefler and Antoine Bosselut and Martin Jaggi and Imanol Schlag},
      year={2026},
      eprint={2610.15542},
      archivePrefix={arXiv},
      primaryClass={cs.CL},
      url={https://arxiv.org/abs/2610.15542},
}