
思考
概要
Timestral は Mistral 初の時系列基盤モデルファミリであり、わずか 209M パラメータで最先端の確率的・多変量予測を実現し、過去および将来の共変量をサポートしながら、主要なベンチマークにおいてより大きなモデルを上回る性能を発揮します。5M から 209M パラメータまでの4つのサイズで提供され、精度と効率のバランスを取り、CPU 上で効率的に動作し、多様なドメインにおけるゼロショット予測に優れています。このモデルは合成データによる事前学習、共変量を考慮したアテンション、および長コンテキスト学習を組み合わせており、Mistral Forge を介したドメイン適応のためのファインチューニングオプションも備えています。
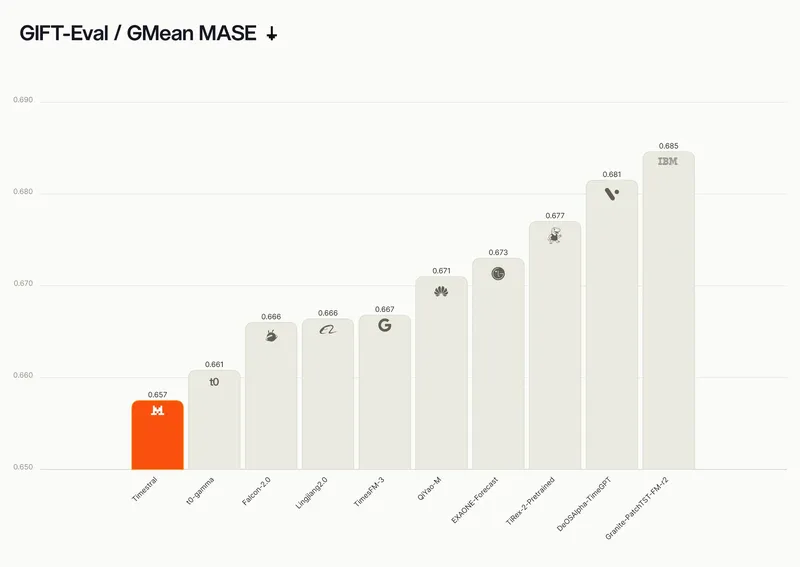
本日、私たちは初の時系列基盤モデルファミリである Timestral をリリースします。最大のモデルはわずか 209M パラメータでありながら、この分野の主要な公開ベンチマーク3つ、GIFT-Eval、TIME、fev-bench のすべてで第1位にランクインし、従来の最先端モデルを、その3分の2のパラメータ数で上回りました。
Timestral は確率的・多変量予測を提供し、過去のみの共変量と既知の将来共変量をサポートします。私たちのモデルファミリは予測精度とモデルサイズのパレートフロンティア上に位置し、各サイズで最高水準の性能を発揮します。結果は GIFT-Eval と TIME のリーダーボードに提出済みです。
時系列基盤モデル(TSFM)
時系列は、センサーのテレメトリからオブザーバビリティメトリクスまで、企業における最も一般的なデータタイプの一つです。時系列に基づく予測は、キャパシティプランニング、エネルギー、サプライチェーン、リスク、メンテナンスにおける意思決定を支えています。
工場では、生産スケジュールに基づいてプロセスセンサーを予測し、設備が故障する前にドリフトを検知し、数千の資産にわたってキャパシティと予備部品を計画します。財務チームは、数千のアカウントにわたるポジション、ヘッジ、資金管理に役立てるため、フロー、出来高、ボラティリティを予測します。
ARIMA や線形回帰といった古典的なモデルは、時系列予測の確立されたツールであり続けています。これらのモデルは通常、単一の時系列に適合され、その系列の履歴のみから学習します。
PatchTST などの深層学習モデルは、多くの関連する系列にまたがる非線形パターンを学習する能力を追加しますが、それでも通常は各データセットに対してゼロから学習されるため、学習した内容は新しいドメインに持ち越されません。
時系列基盤モデルは、事前学習のアプローチを時系列にもたらします。大規模で多様なコーパスで学習された私たちのモデルは、系列をまたいで転移するパターンを学習し、见过したことのないデータに対してゼロショットで予測を行います。データが希少なドメインでも同様です。
ベンチマーク結果
私たちは Timestral を、主要な公開予測ベンチマーク3つ、GIFT-Eval、TIME、fev-bench で評価しました。事前学習済みのゼロショットモデルの中で、5つの指標すべてで第1位にランクインしています。これらの結果は単一のチェックポイントによるもので、アンサンブルは使用していません。
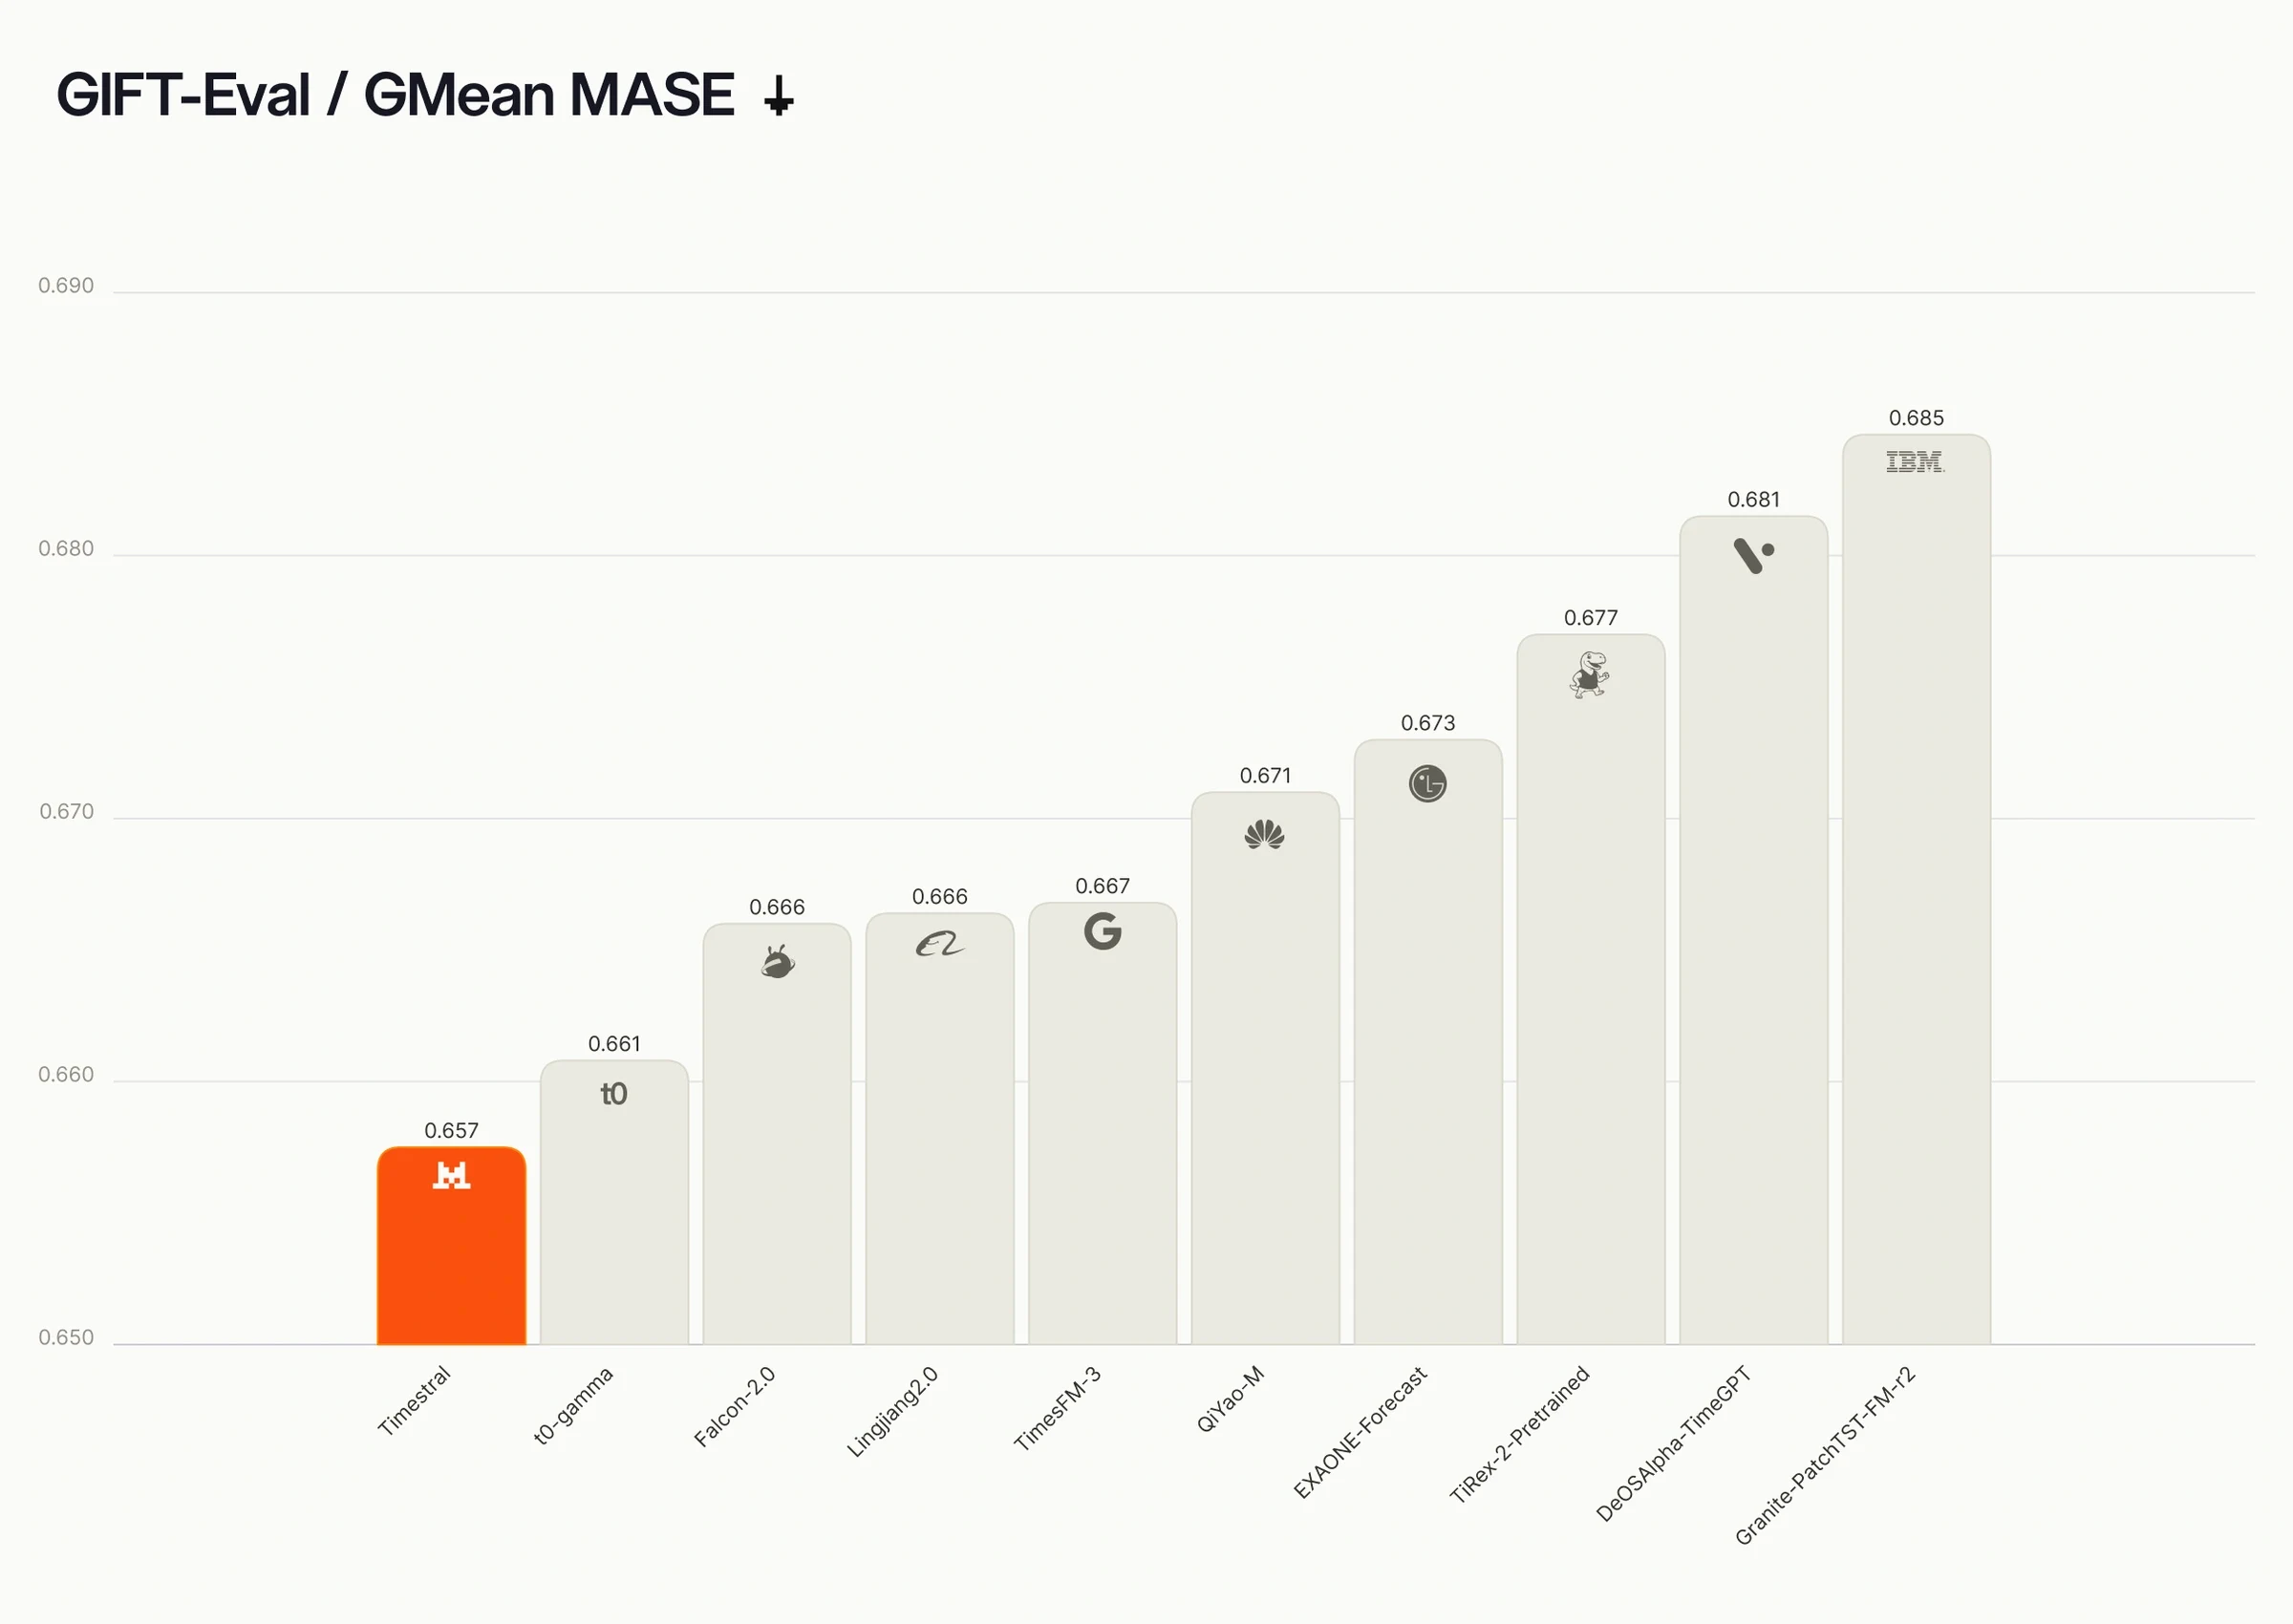
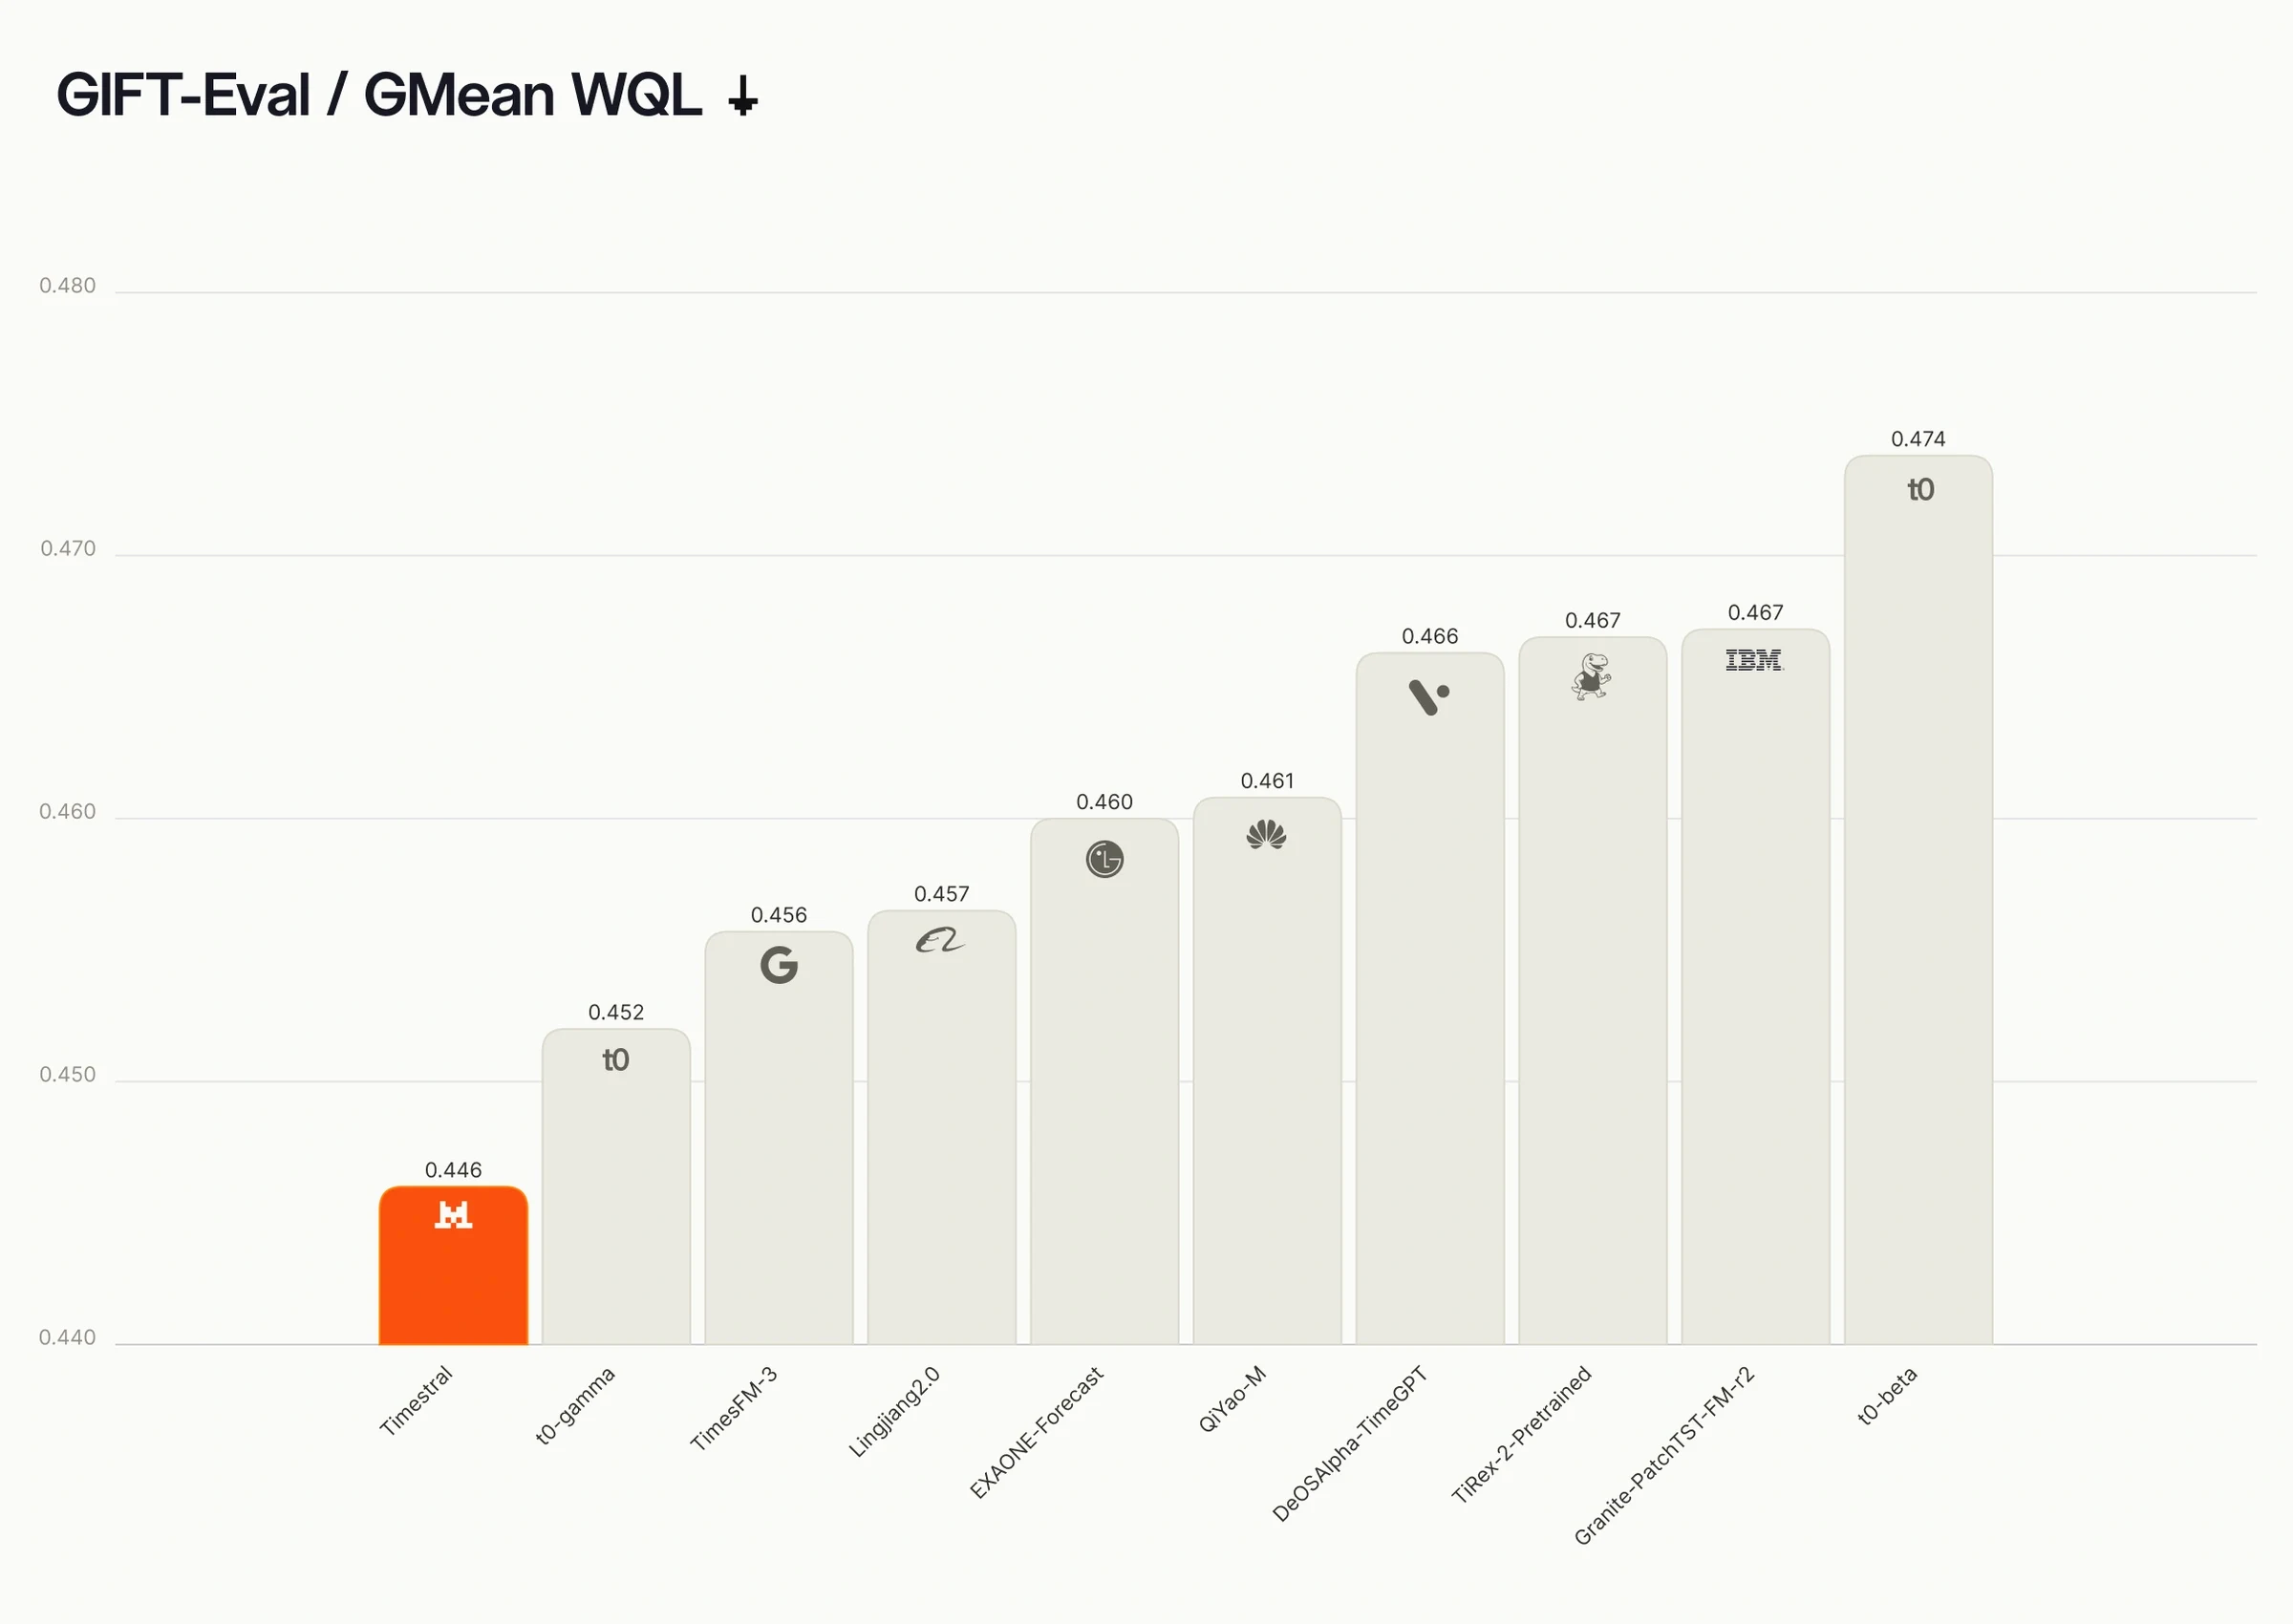
GIFT-Eval、83件の比較可能な事前学習済み・ゼロショットエントリのトップ10。数値が低いほど良い。
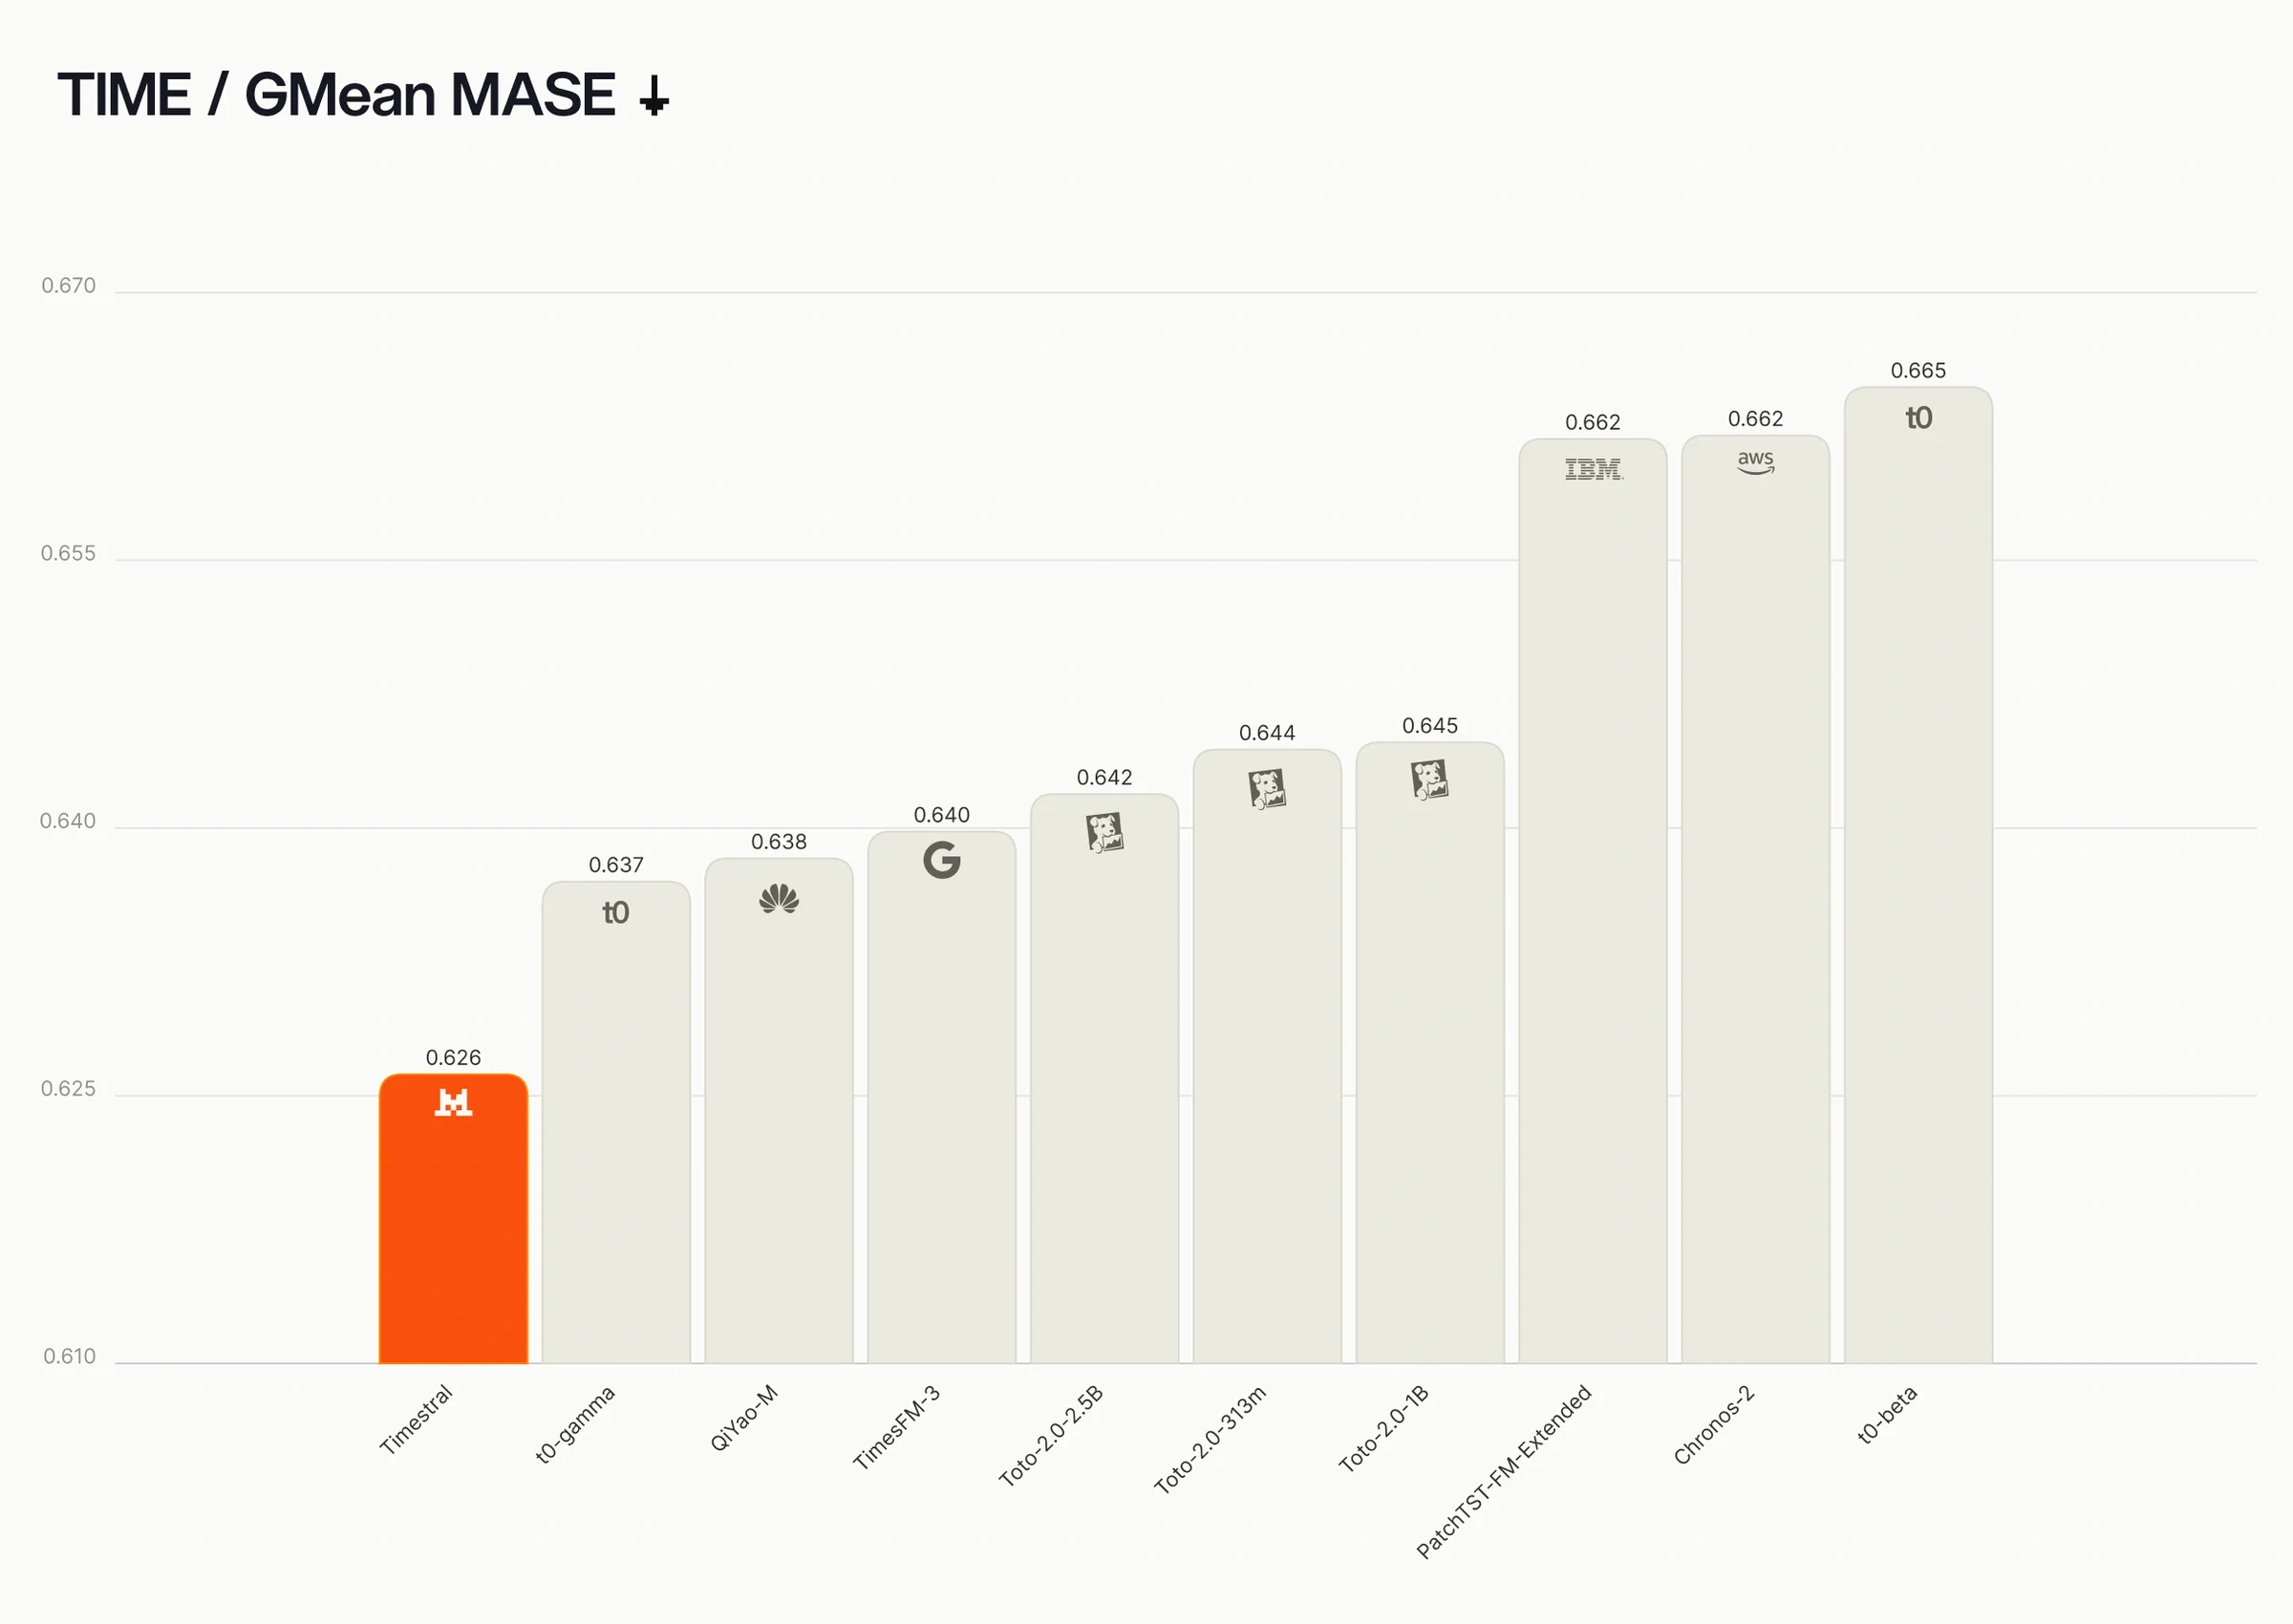
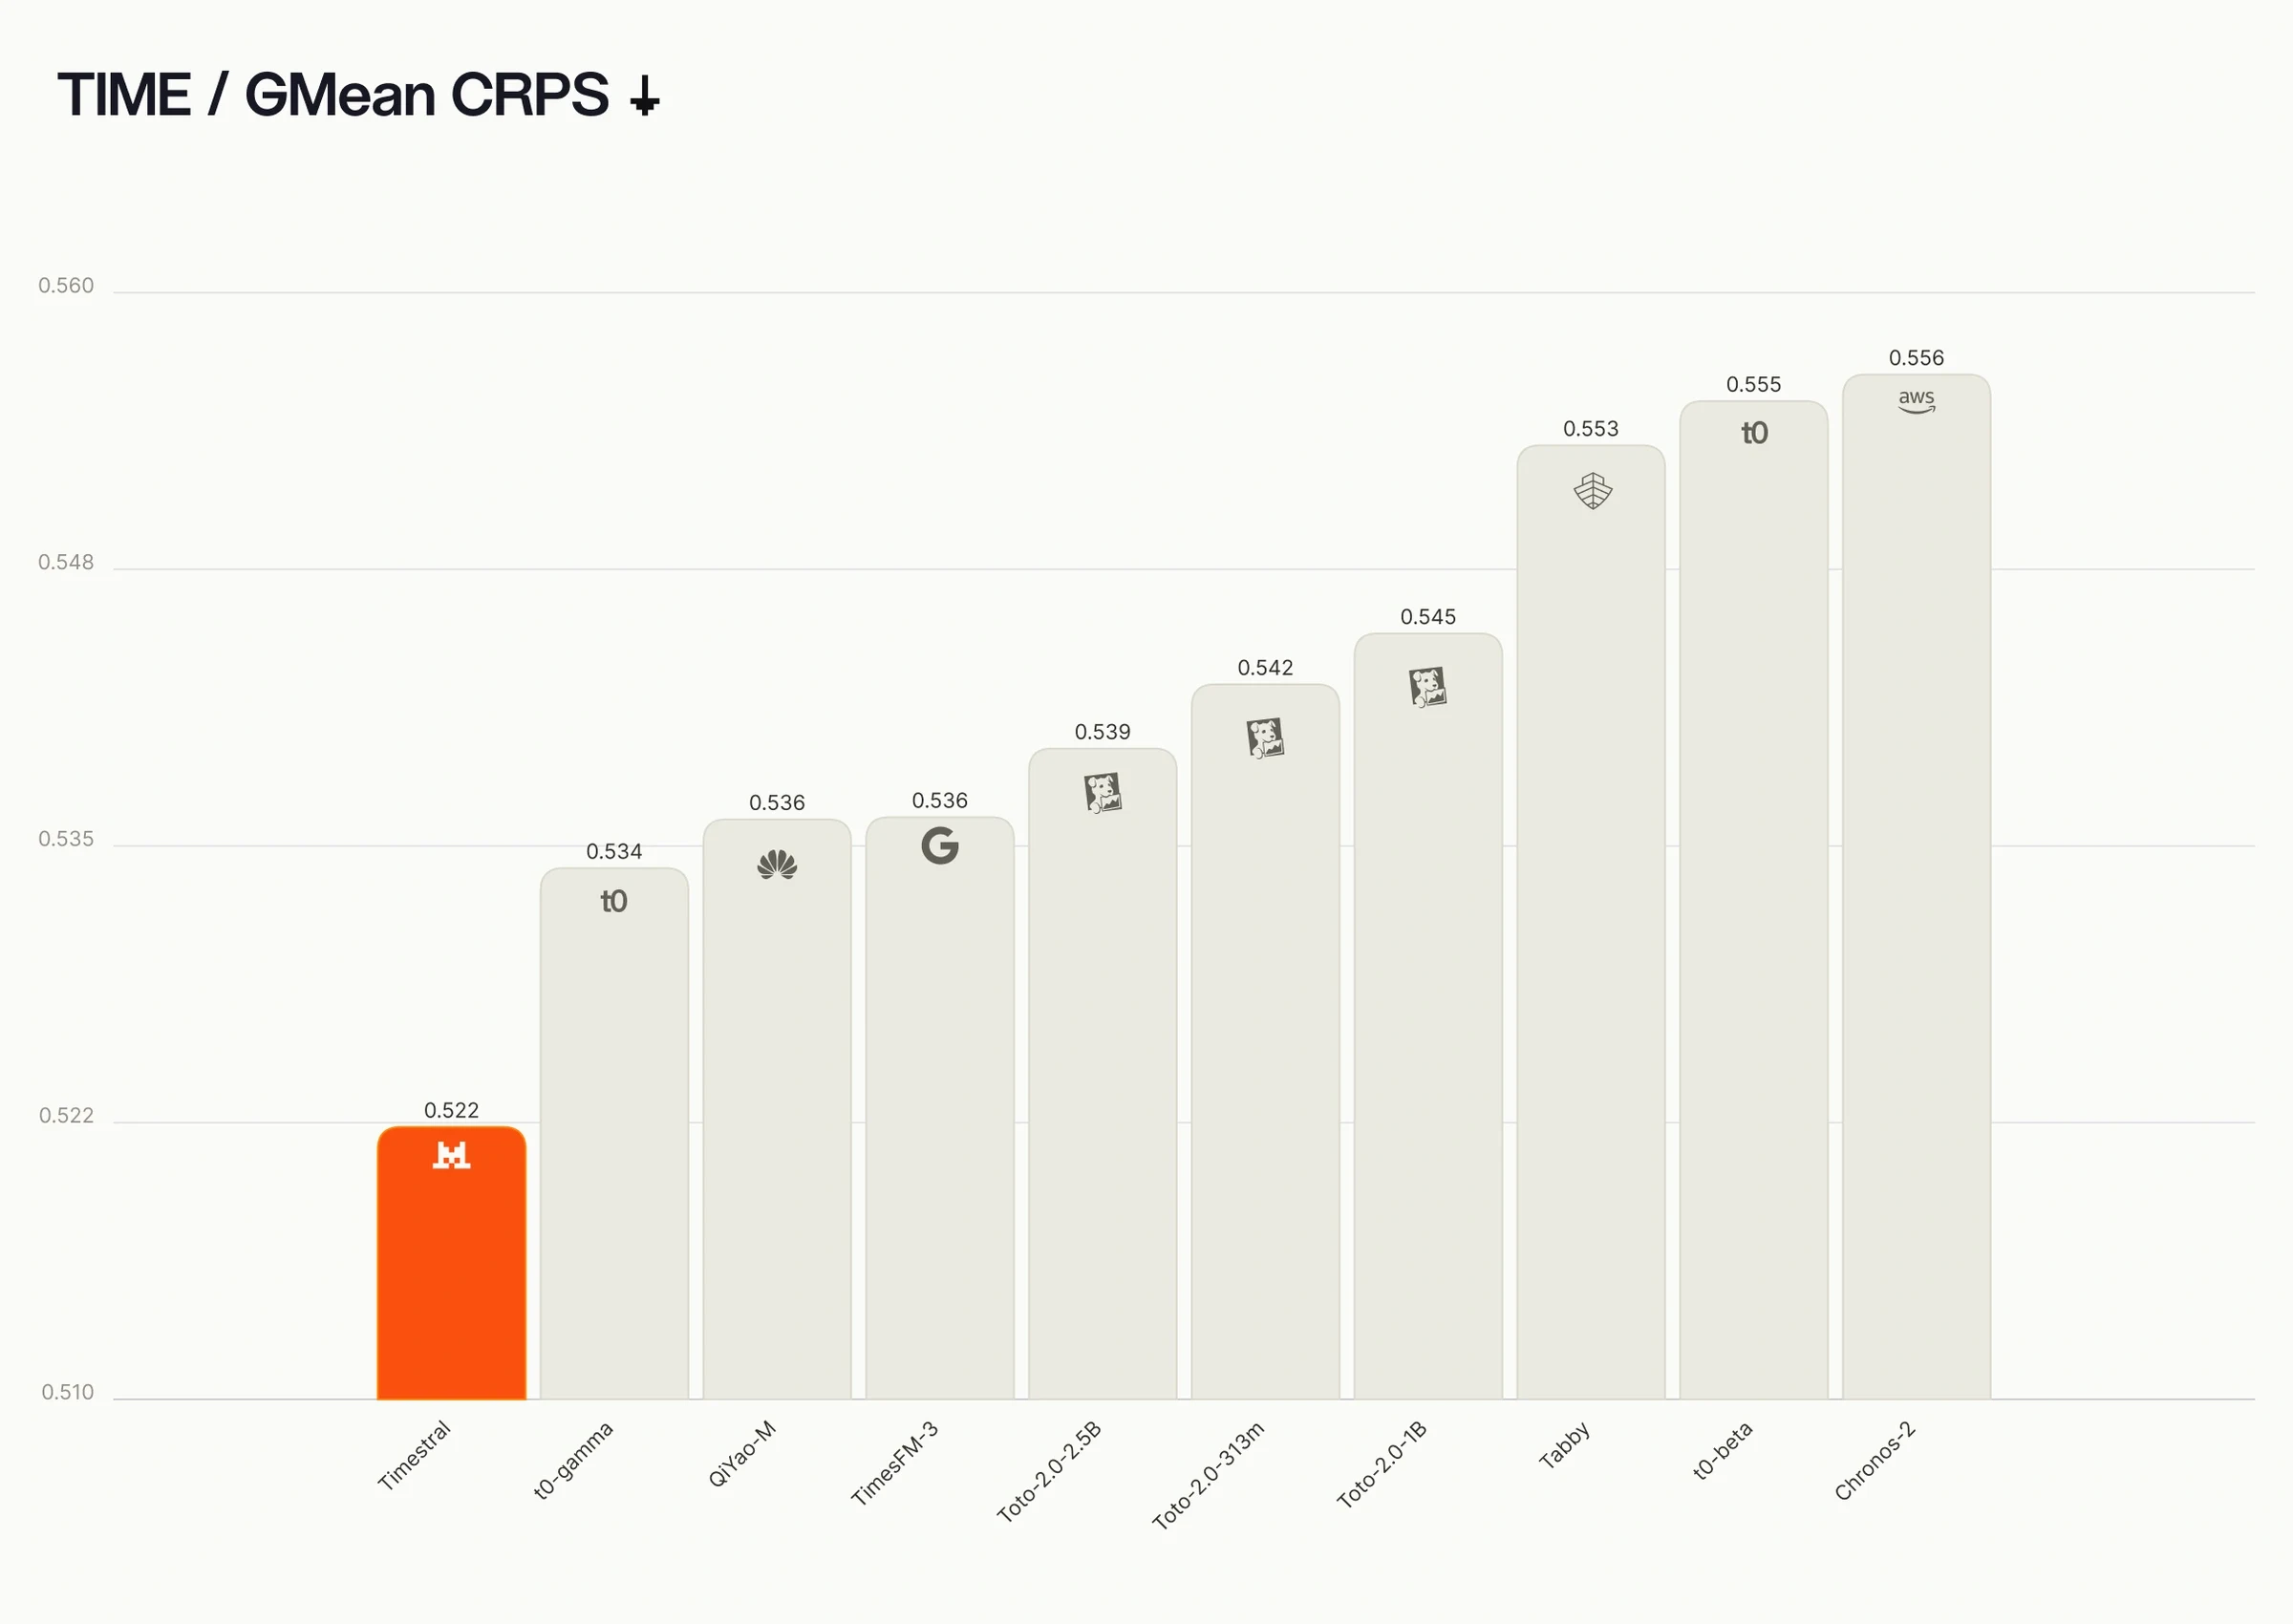
TIME、リーダーボードの35エントリのトップ10。両方の指標で数値が低いほど良い。
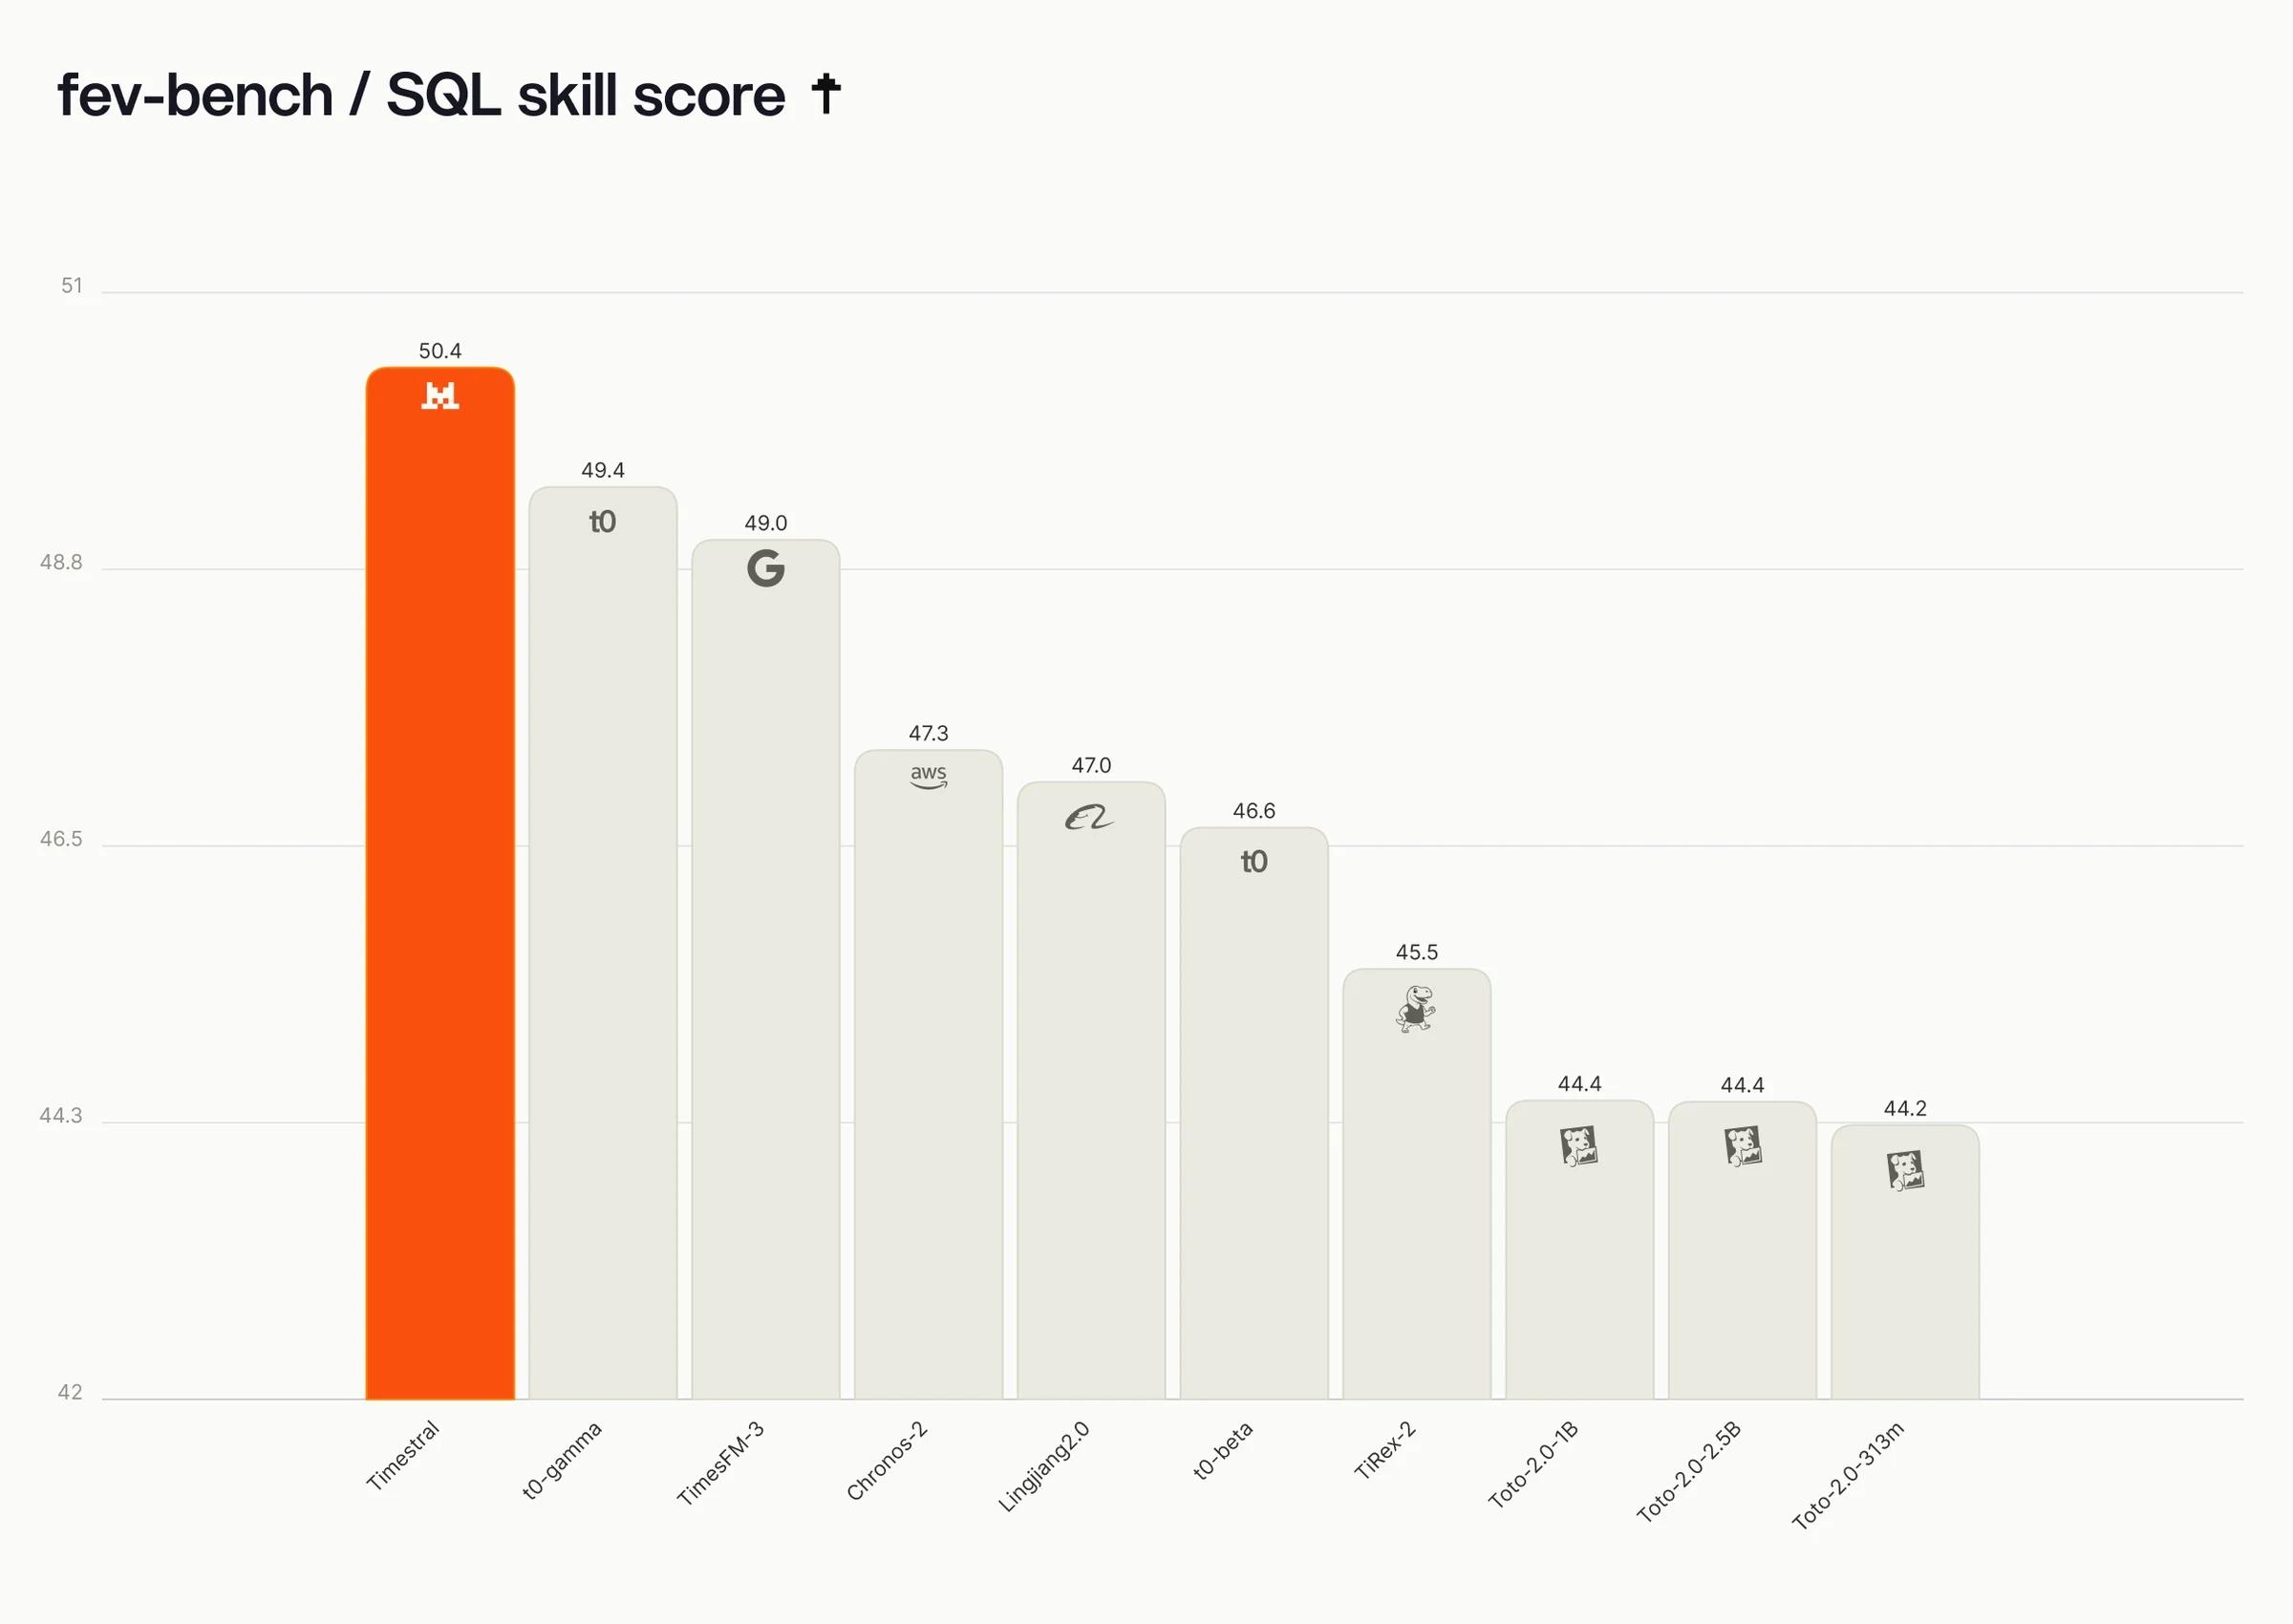
fev-bench、リーダーボードの37エントリのトップ10、SQL スキルスコア順。数値が高いほど良い。
あらゆる仕様に最適化されたモデルファミリ
Timestral は、5M、28M、123M、209M パラメータの4モデルのファミリとして最適化されました。 larger モデルは予測性能を向上させ、 smaller モデルはより高速かつ低コストです。4つすべてが同じアーキテクチャと学習レシピを共有しています。すべてのサイズが精度とモデルサイズのパレートフロンティア上にあります。つまり、各モデルサイズにおいて、それより優れた予測を行う公開モデルは存在しません。
GIFT-Eval、TIME、fev-bench におけるスコアとモデルサイズの関係(1 − スキルスコアとして表示)。数値が低いほど良い。私たちの 28M モデルは、約4倍のサイズである Chronos-2 を GIFT-Eval と TIME で上回りました。私たちの 209M モデルは、より少ないパラメータで TimesFM-3 と Falcon-2.0 を上回りました。
Timestral は推論に GPU を必要としません。8スレッドの標準的なサーバー CPU で、3週間分の 15分足の履歴から1日先を予測するのに、5M モデルでは 10 ms、209M モデルでは 140 ms かかります。 smaller モデルはある程度の精度を速度と引き換えにします。28M モデルは 209M モデルの5倍高速であり、123M モデルは 209M のスコアに 0.2% 以内で迫りながら、そのレイテンシは4分の3です。
産業分野の例
設備全体に数千のセンサーが設置された工場を考えてみましょう。Timestral は、そのデータの予測をいくつかの方法で改善できます。
多変量予測。 ポンプの振動、温度、圧力は独立して動くわけではありません。一方の上昇は、他方の変化を説明したり、引き起こしたりすることがよくあります。Timestral は関連する系列を共同でモデル化するため、各センサーを個別に予測するのではなく、それらの依存関係を活用できます。
確率的予測。 単一の予測値では全体像が見えない場合があります。Timestral は分位点の完全なセットを予測するため、チームは不確実性の幅を確認し、それを反映したアラート閾値を設定し、単一の数値ではなくリスクに基づいてメンテナンスを計画できます。
カテゴリカル共変量。 一部の共変量は、連続的な数値ではなく、曜日や機械の状態(稼働中、アイドル中、メンテナンス中)など、カテゴリの集合から値を取ります。これらを数値としてエンコードすると、本来存在しない順序や尺度が課されてしまいます。Timestral はこれらをカテゴリカル入力として直接受け付け、予測を改善します。
既知の将来共変量。 センサーの挙動を左右する要因の一部は、生産スケジュール、計画停止、気象予報など、事前に分かっているものです。Timestralはこれらを条件として用いることで予測品質を向上させ、計画された負荷増加を不意の事象としてフラグ付けするのではなく、予期されたものとして扱えます。
モデルからシステムへ
Timestralは、既存のモニタリングパイプライン内で実行できる数値モデルであり、マルチモーダルなエージェント型ワークフローで当社の言語モデルと組み合わせることもできます。
工場では、例えば次のようになります:
植物のセンサーデータストリーム上で継続的に稼働し、異常が発生すると同時に検出するTimestral。
ポンプに異常を検知すると、エージェントがその信号を埋め込み、過去のセンサーデータの埋め込みと比較して、類似した過去の故障を探します。
エージェントは次にサブエージェントを起動して根本原因分析を実行し、そのプラント固有のコンテキスト、すなわち保守記録、シフトログ、オペレーターのメモ、設備マニュアル、過去の作業指示書、関連設備の測定値などを活用します。
エージェントはこれらの調査結果に基づいて、裏付けとなる証拠と考えられる次のステップを添えた診断案を作成します。
プラントマネージャーは、単なるアラートではなく、センサーデータに裏打ちされた診断と計画を受け取ります。
主要な技術的貢献
これらの結果を生み出すために、いくつかのアイデアが組み合わされました。それぞれについて、技術レポートで詳しく説明します。
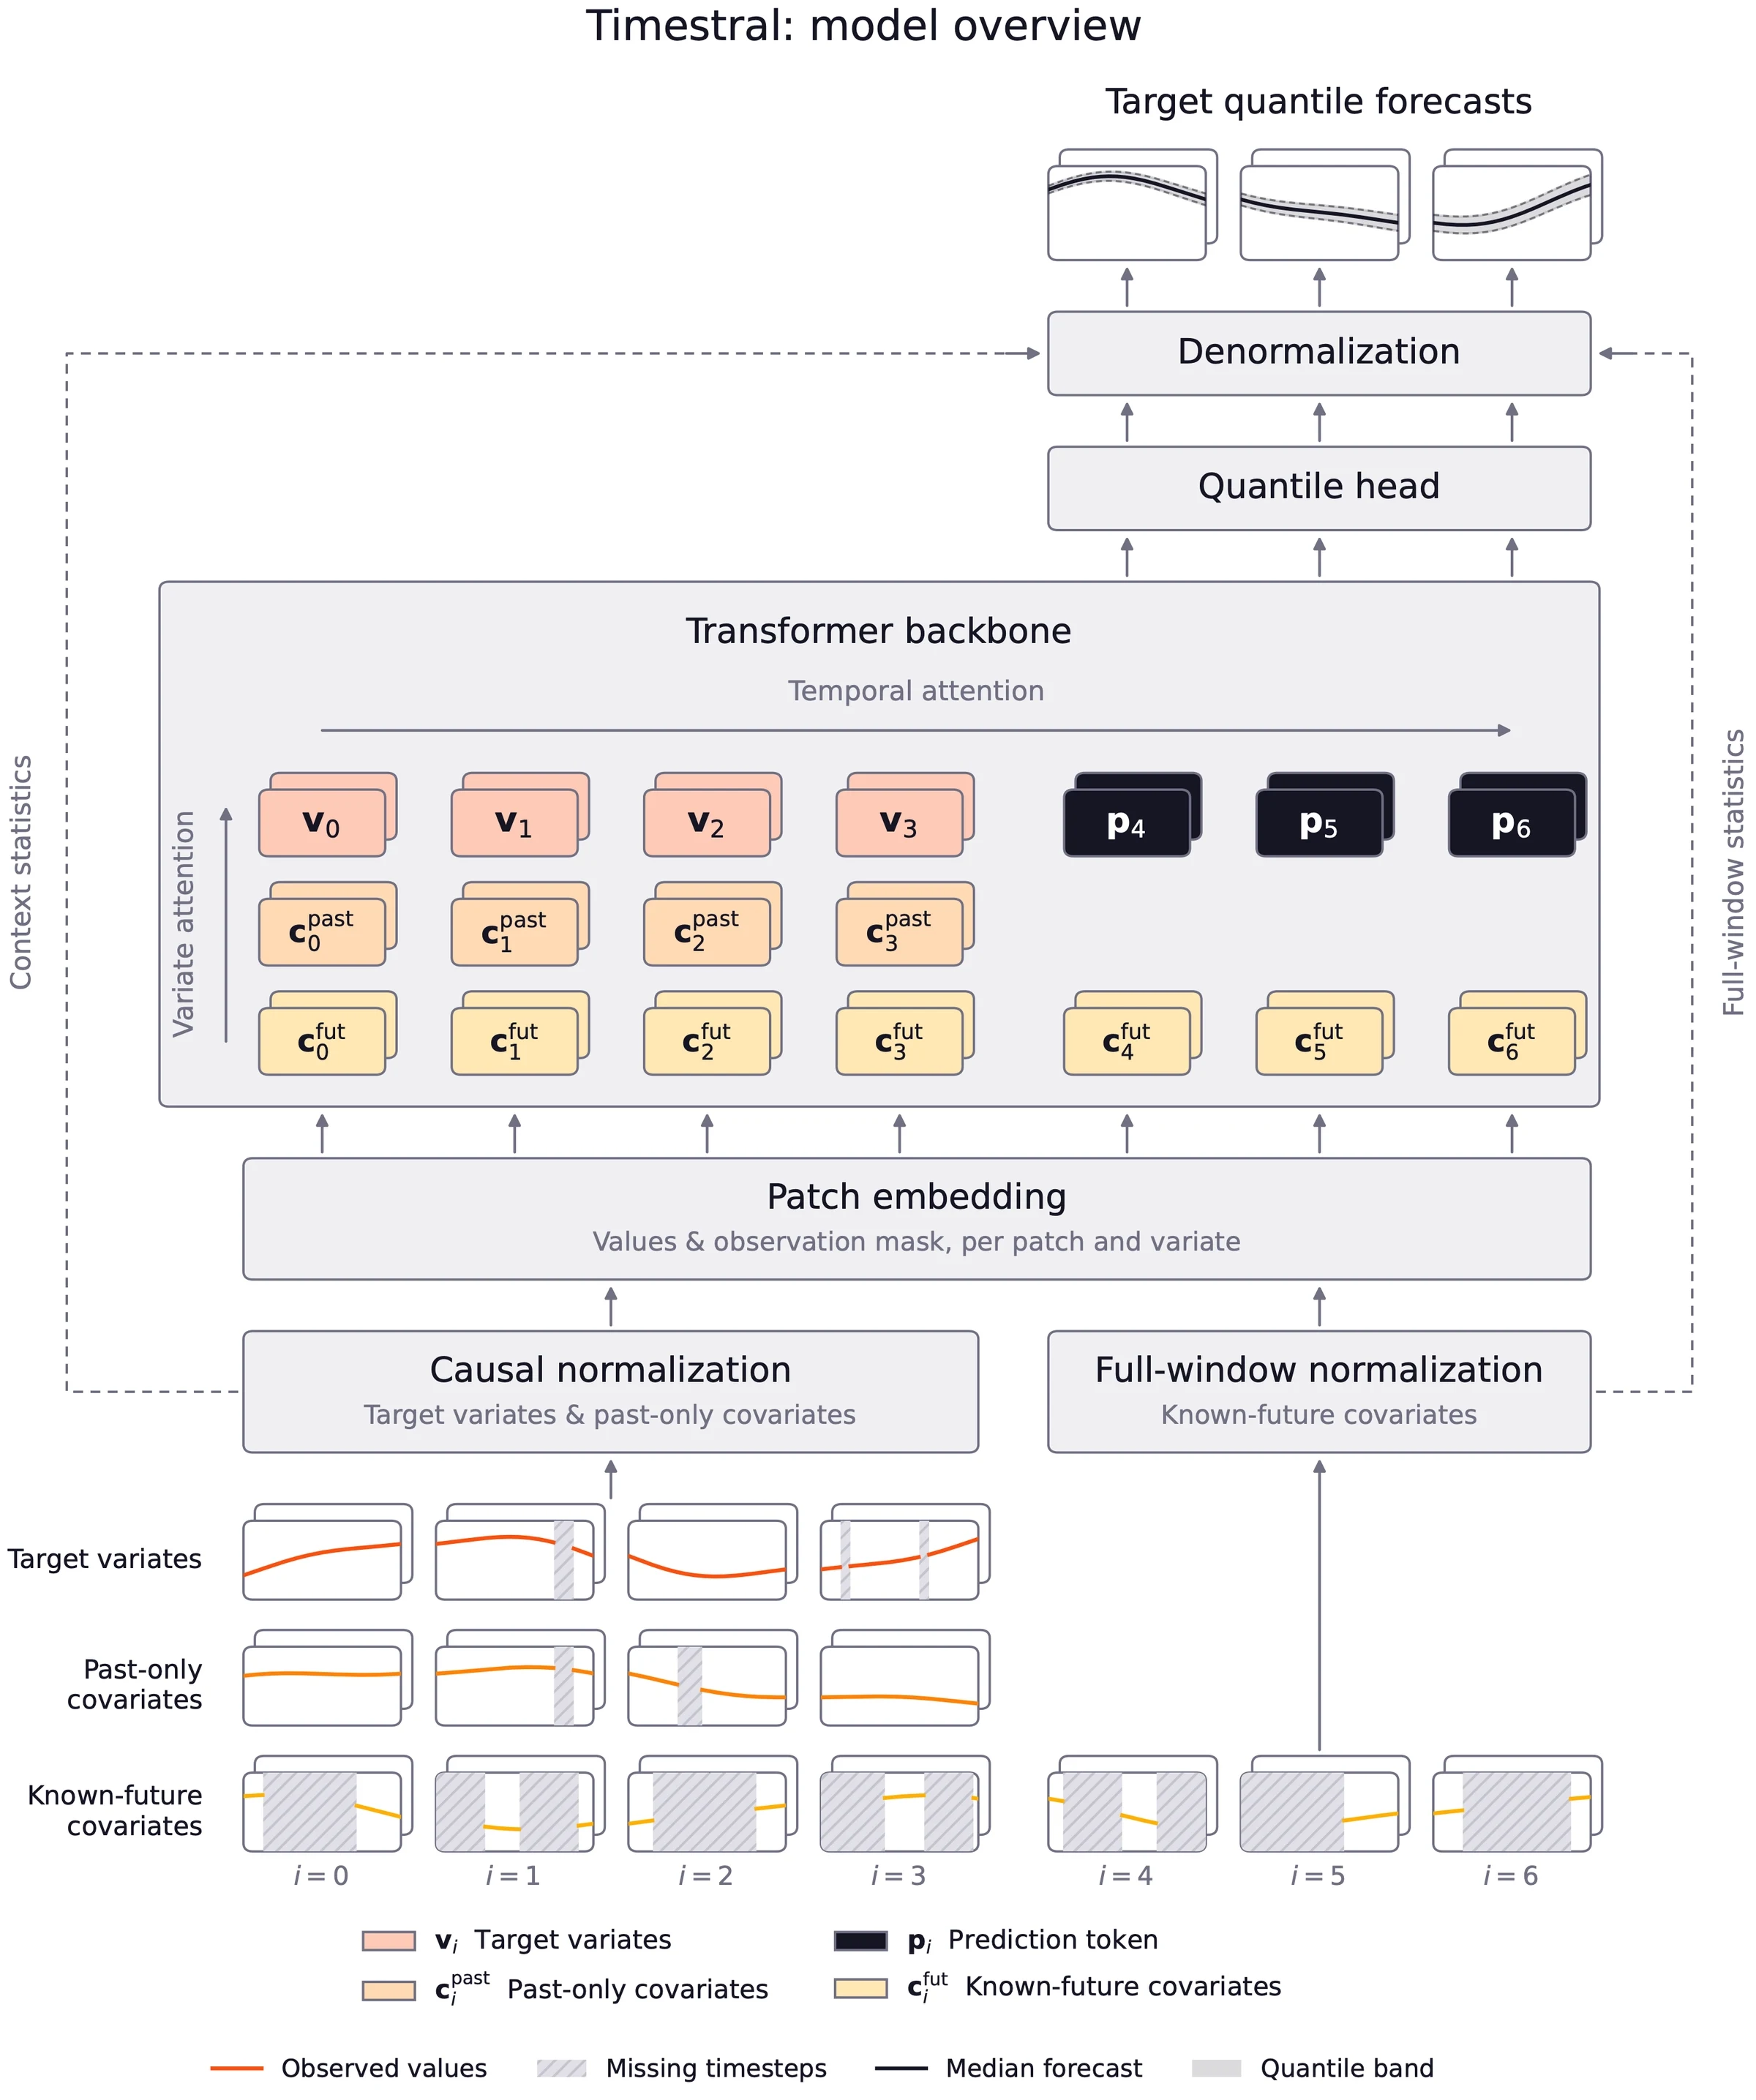
Decoupled Horizon Forecasting(デカップルド・ホライズン・フォーキャスティング)。 Toto 2.0 や TimesFM-3 と同様の、連続パッチマスキングで学習された因果的デコーダーでは、予測対象の値がマスクされ、欠損値のように扱われるため、その後の予測のコンテキストからも失われます。私たちのアプローチである DHF では、この2つを分離します。完全な履歴はシーケンス内に保持され、学習された予測トークンが自分より前の履歴を読み取ります。これにより、すべての観測値がターゲットとコンテキストの両方の役割を果たし、真の欠損は欠損としてフラグされたまま残り、学習時のホライズン長と欠損データ拡張を互いに独立して調整できます。
Covariate-aware attention(共変量対応アテンション)。 各入力系列には役割が割り当てられます:ターゲット変量、過去のみの共変量、または既知の未来の共変量です。既知の未来の共変量はウィンドウ全体で可視であり、ターゲットは因果性を保つ一方、情報は共変量からターゲットへのみ流れます。そのため、Timestral はターゲット自身の未来を予測に漏らすことなく、祝日カレンダーや天気予報を利用できます。
合成データファースト。 学習データの大半は合成データでした。まず、トレンド、季節性、多様なノイズパターンを含む、一貫した時間的ダイナミクスを持つ単変量プロセスを生成しました。次に、多変量シンセサイザーを使って、これらのプロセス間に非線形の依存関係を導入することで多変量系列を構築しました。
2段階学習。 Timestral はまず、コンテキストサイズ 8192 で純粋に合成データのみを用いて大規模に事前学習され、その後、4倍の長さのコンテキストで実データと合成データの混合データによりポストトレーニングされます。目的関数は 21 個の分位点に対するピンボールロスで、CRPS の離散近似です。
適応可能なモデル
公開ベンチマークは一般的な性能を測定しますが、本番データは挙動や構造が大きく異なる場合があります。また、市場がレジームを変え、設備が劣化し、需要パターンが変化するにつれて、時間とともに変化することもあります。持続的な価値は、モデルをインドメインデータに適応させ、分布が変化しても再学習を続けられることにあります。
さらに進みたい組織のために、Timestral は以下から利用できます: Mistral Forge,当社の言語モデルに使用しているものと同じ学習パイプラインです。以下をサポートします:
Zero-shot inference(ゼロショット推論) をすぐに利用可能。
Architectural extensions(アーキテクチャの拡張),例えばドメイン固有の共変量など。
Fine-tuning on proprietary data(独自データでのファインチューニング),汎用性能を維持しながら特定ドメインに特化。
Control over the training data(学習データの管理),学習ミックスの調整、事前学習データのリプレイ、ターゲットドメインを反映した合成データサンプルの生成を含みます。データを完全に管理することで、バックテストしたものが事前学習で見られていなかったことを保証します。
パイプライン全体は、エアギャップ環境を含め、クライアントのハードウェア上に展開できます。
今後の展開
私たちは GitHubリポジトリ そのため、Timestralを自身のデータで実行できます。全結果を含む技術レポートは後日公開予定です。より専門的な予測問題への対応や研究での共同作業については、ぜひご連絡ください。
Timestral | |
|---|---|
タイプ | 時系列基盤モデル(TSFM) |
パラメータ数 | 5M、28M、123M、209M |
コンテキスト長 | 32,768タイムステップ |
出力 | 確率的予測、21分位点 |
入力 | 多変量ターゲット、過去のみの共変量と既知の将来共変量 |
デプロイメント | オンプレミス、VPCまたはエアギャップ環境 |
ライセンス | Modified MIT |
Timestral
新着
Mistralの時系列基盤モデル。最先端の確率的予測を実現し、パラメータは5M~209M、CPU上で動作します。
確率的予測
詳しく見る