
常時稼働するエージェントは、視覚情報を解釈し、それに基づいて推論し、ツールを使用して行動することがますます求められています。こうしたワークフローには、マルチモーダル理解と高精度な実行を兼ね備えたモデルが必要です。
NVIDIA Nemotron 3.5 Super VL は、長時間稼働するエージェント向けに構築されたオープンでカスタマイズ可能なマルチモーダルモデルであり、開発者が特殊なワークフローにおいて精度と効率を最大化できるようにします。
1 つのモデルに推論、指示追従、ツール使用と、テキスト・画像・ドキュメント・動画の理解を組み合わせることで、テキスト用とビジョン用のモデルを別々にデプロイする必要性を減らし、ワークフローの各ステップを通じてタスクに関連するコンテキストを維持しやすくなります。
120 billionパラメータの混合エキスパート(MoE)アーキテクチャを基盤とし、アクティブパラメータは12 billion。Nemotron 3.5 Super VLは、専門的な常時稼働エージェントタスクにおいて精度と効率のバランスを実現します。組織はNVIDIA NeMoを使用して、自社のデータ、ツール、ポリシー、ワークフローに基づくポストトレーニングを行うことができます。
モデルシステムの中で、Nemotron 3.5 Super VL は、ドキュメント・画像・動画の理解をネイティブに備えたデフォルトの高精度エージェント実行モデルとして設計されています。大量のテキスト実行向けの NVIDIA Nemotron 3.5 Lightning や、最も難しいテキストのみの推論向けの NVIDIA Nemotron 3 Ultra を補完します。
Nemotron 3.5 Super VL は、マルチモーダルで常時稼働するエージェントに必要な 2 つの実務上の要件に対応します:
- エージェント実行を備えたネイティブな視覚理解: このモデルは、高精度な推論とツール使用を、ドキュメント・画像・動画の理解と組み合わせ、特殊なワークフローを通じてタスクに関連するコンテキストを維持します。
- 効率的で制御しやすいデプロイ: ハイブリッド Mamba-Transformer アーキテクチャ、マルチトークン予測、NVFP4 量子化は、生成効率を向上させ、より多くの同時長コンテキストセッションのための余裕を生み出すように設計されています。
TL;DR: NVIDIA Nemotron 3.5 Super VL について
- アーキテクチャ: 混合エキスパート設計による総パラメータ 120B、アクティブパラメータ 12B
- モダリティ: 入力としてテキスト、画像、ドキュメント、動画。出力はテキスト
- 最適化: C-RADIOv4 ビジョンエンコーダ、ハイブリッド Mamba-Transformer アーキテクチャ、マルチトークン予測、NVFP4 量子化
- モデルの役割: モデルシステム向けの、ネイティブな視覚理解を備えた高精度エージェント実行
- カスタマイズ: NVIDIA NeMo を使用して、組織固有のデータ、ツール、ポリシー、ワークフローでポストトレーニング
- デプロイ: クラウドおよびデータセンター環境全体で最適化された本番サービングのための NVIDIA NIM
- デプロイ対象: 1x GB10、B200、B300、RTX PRO 6000、H200、および 2x H100
- 入手方法:
vLLMで高スループット推論を実行する
Nemotron 3.5 Super VL は、幅広い NVIDIA プラットフォームでの実行を想定して設計されています。vLLM は、continuous batching、prefix caching、speculative decoding、OpenAI 互換 API など、モデルを本番ワークフローに組み込むために必要なサービング層を提供します。
BF16チェックポイントは、デプロイメントのためのわかりやすいベースラインを提供します。NVFP4もローンチ時から利用可能で、より低い精度の推論を活用できる環境に対応しています。
vLLM をインストールする
docker pull vllm/vllm-openai:v0.31.0

docker run --rm -it --gpus all --ipc=host --network=host \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  --entrypoint /bin/bash \
  vllm/vllm-openai:v0.31.0
モデルを提供する
以下のNVFP4起動構成は、1× GB200セットアップの例です。使用前にターゲットハードウェアで検証してください。
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --served-model-name nemotron-3.5-super \
  --trust-remote-code \
  --max-model-len 114688 \
  --reasoning-parser nemotron_v3 \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 5
サーバーが起動すると、アプリケーションはOpenAI互換クライアントを通じてプロンプトを送信できます。
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="null")

response = client.chat.completions.create(
    model="nemotron-3.5-super",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "Describe what happens in this video."},
                {
                    "type": "video_url",
                    "video_url": {"url": "https://example.com/clip.mp4"}
                },
            ],
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=4096,
)

print(response.choices[0].message.reasoning)  # thinking trace
print(response.choices[0].message.content)    # final answer
Speculative Decodingによる長時間実行のエージェントワークフローの高速化
Nemotron 3.5 Super VL は Multi-Token Prediction(MTP)をサポートし、対象モデルの出力品質を維持しながらトークン生成を高速化します。
Nemotron 3.5 Super VLには、マルチトークン予測(MTP)ヘッドが組み込まれています。デコード時、これらのヘッドが将来のトークンを提案し、ターゲットモデルがそれを検証することで、より長い応答に必要な逐次生成ステップの数を削減します。
たとえば、3つの speculative token を指定して MTP を有効化することもできます。
vllm serve nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 \
  --served-model-name nemotron-3.5-super \
  --trust-remote-code \
  --speculative-config.method mtp \
  --speculative-config.num_speculative_tokens 3
特殊化された常時稼働エージェントワークフローのために構築
組織は NVIDIA NeMo を使用して、Nemotron 3.5 Super VL を自社の用語、データ、ポリシー、ツール、ワークフローに適応させることができます。これにより、汎用マルチモーダルモデルが、ドメイン固有のエージェントタスクのための特殊化された実行エンジンとなり、モデルの動作とデータ処理に対する制御を維持できます。
ユースケース例
- カスタマーサービス: 顧客が提供したドキュメントや画像を解釈し、ポリシーを適用し、サービスツールを使用することで、複数ステップのリクエストを解決します。
- ドキュメントインテリジェンス: OCR、表、チャート、ページレイアウトを含む複雑なドキュメントを解釈し、情報を抽出して要約やレポートを生成します。
- エンタープライズ生産性: 視覚情報を解釈し、それにわたって推論し、ツールを使用することで、複数ステップのタスクを完了します。
- 動画理解: 検索、コンテンツレビュー、広告、小売、インシデント分析を支援するために、動画から重要な情報を抽出します。
- ウェブリサーチ: 複数のウェブサイトを横断して検索し、複数のソースからの情報を結び付け、結果を検証します。
マルチモーダルエージェントタスクにおける精度と効率
Nemotron 3.5 Super VL は、各トークンに対して合計パラメータの一部のみを使用しながら、特殊化されたマルチモーダルエージェントタスクで高い精度を提供するよう設計されています。ハイブリッド Mamba-Transformer アーキテクチャと multi-token prediction、さらに NVFP4 量子化により、出力生成が加速されます。
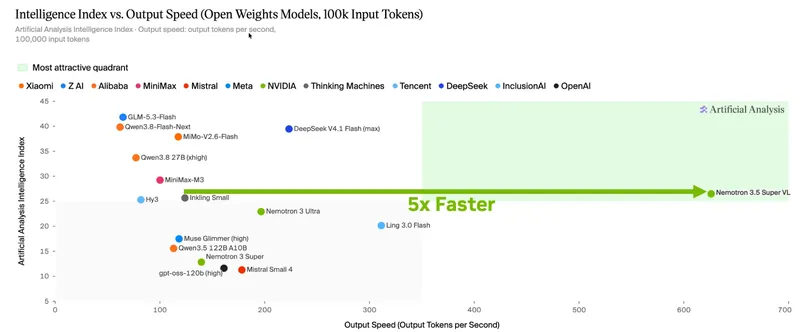
図1に示すように、単一のGPU上で、このモデルはエージェント型タスクにおいて他のモデルと比較して最大5倍高速なスループットを実現します。 オープンモデル と比較して、エージェントタスクで最大 5 倍高速なスループットを提供します。
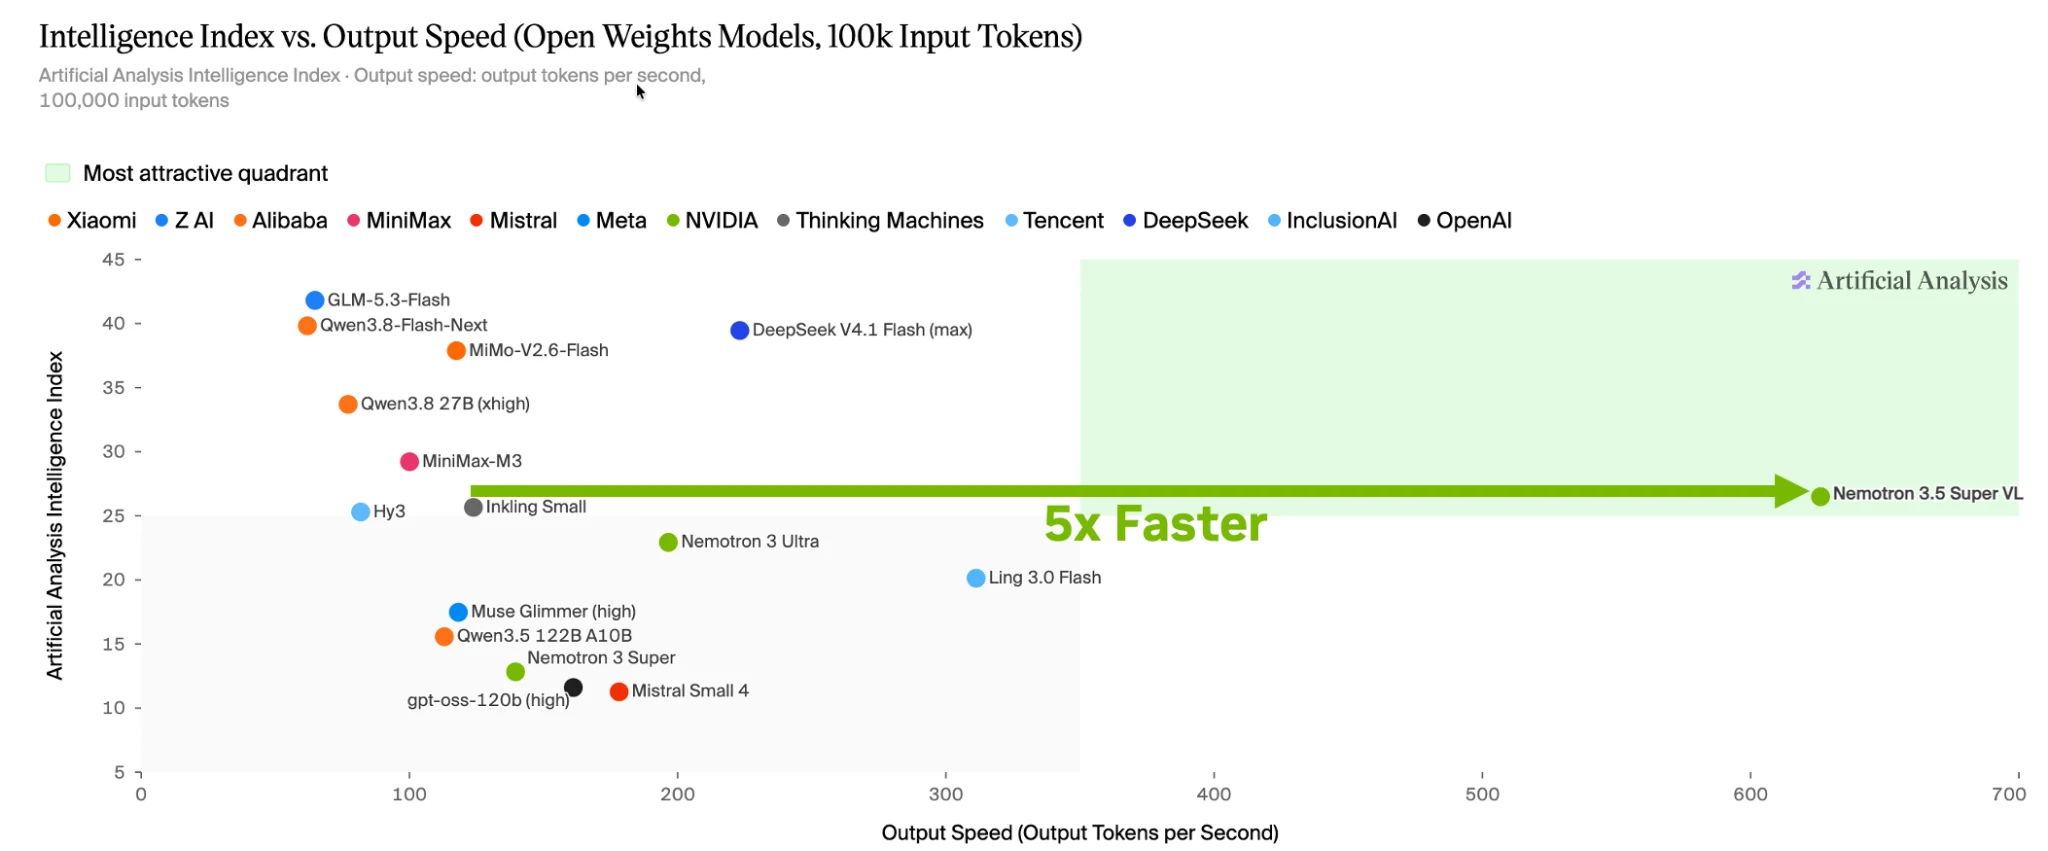
図 1. Nemotron 3.5 Super VL は、Baseten エンドポイント上の Artificial Analysis Intelligence Index エージェントタスクで 600 を超える TPS を提供します。
図 2 に示すように、Nemotron 3.5 Super VL は同程度のサイズの他の主要なオープンモデルと比較して、タスクを 4 倍高速に実行します。
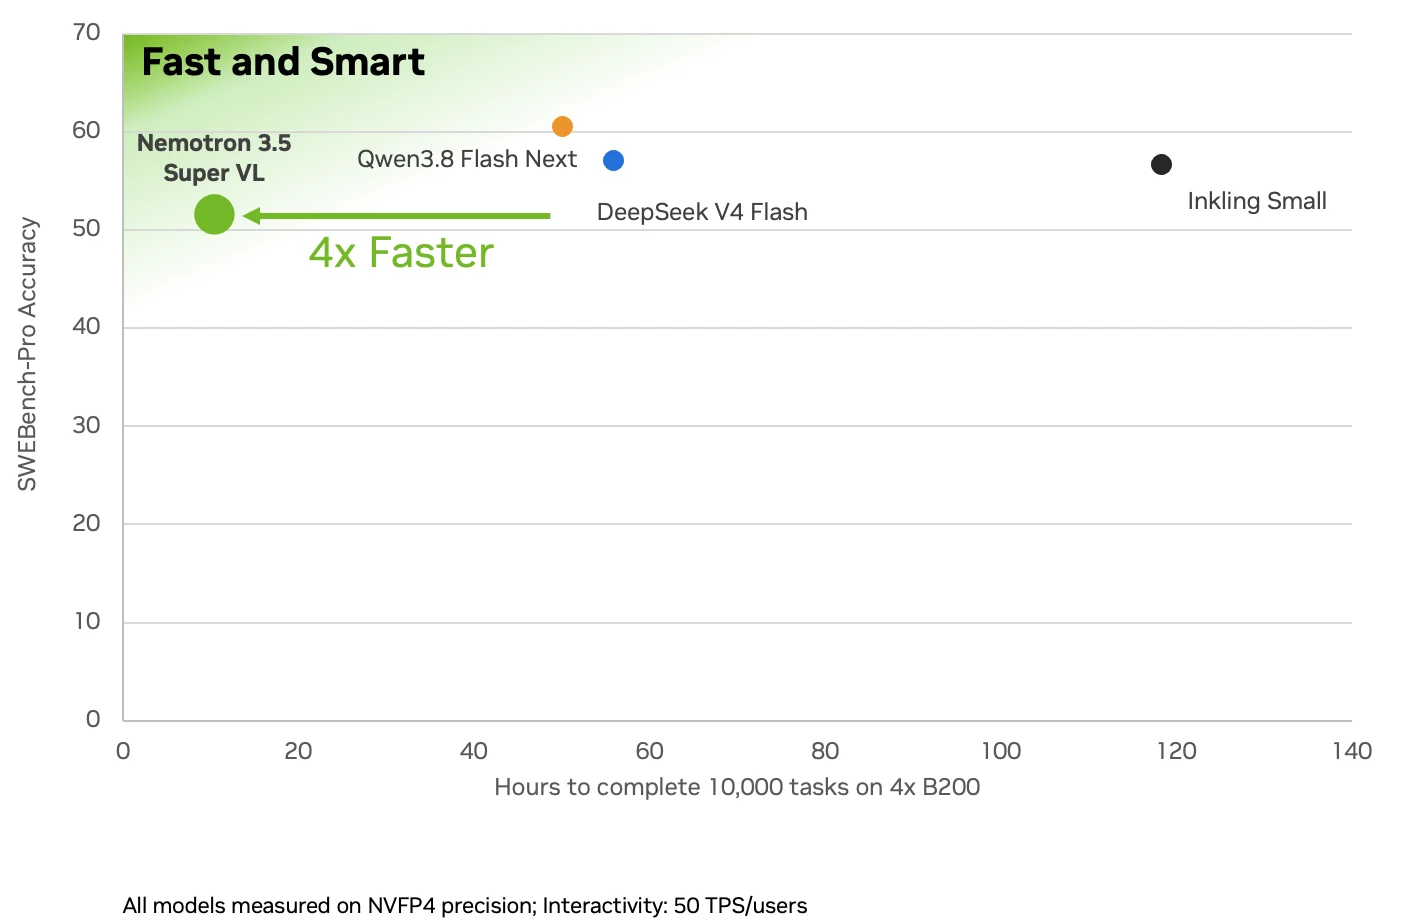
図 2. Nemotron 3.5 Super VL は、高いスループットとトークン効率を活かして、4 倍高速なタスク完了を実現します。
参考として、図 3 は関連モデルである Nemotron 3.5 Super の DGX Spark との比較を示しています。このチャートは Nemotron 3.5 Super VL を測定したものではありません。
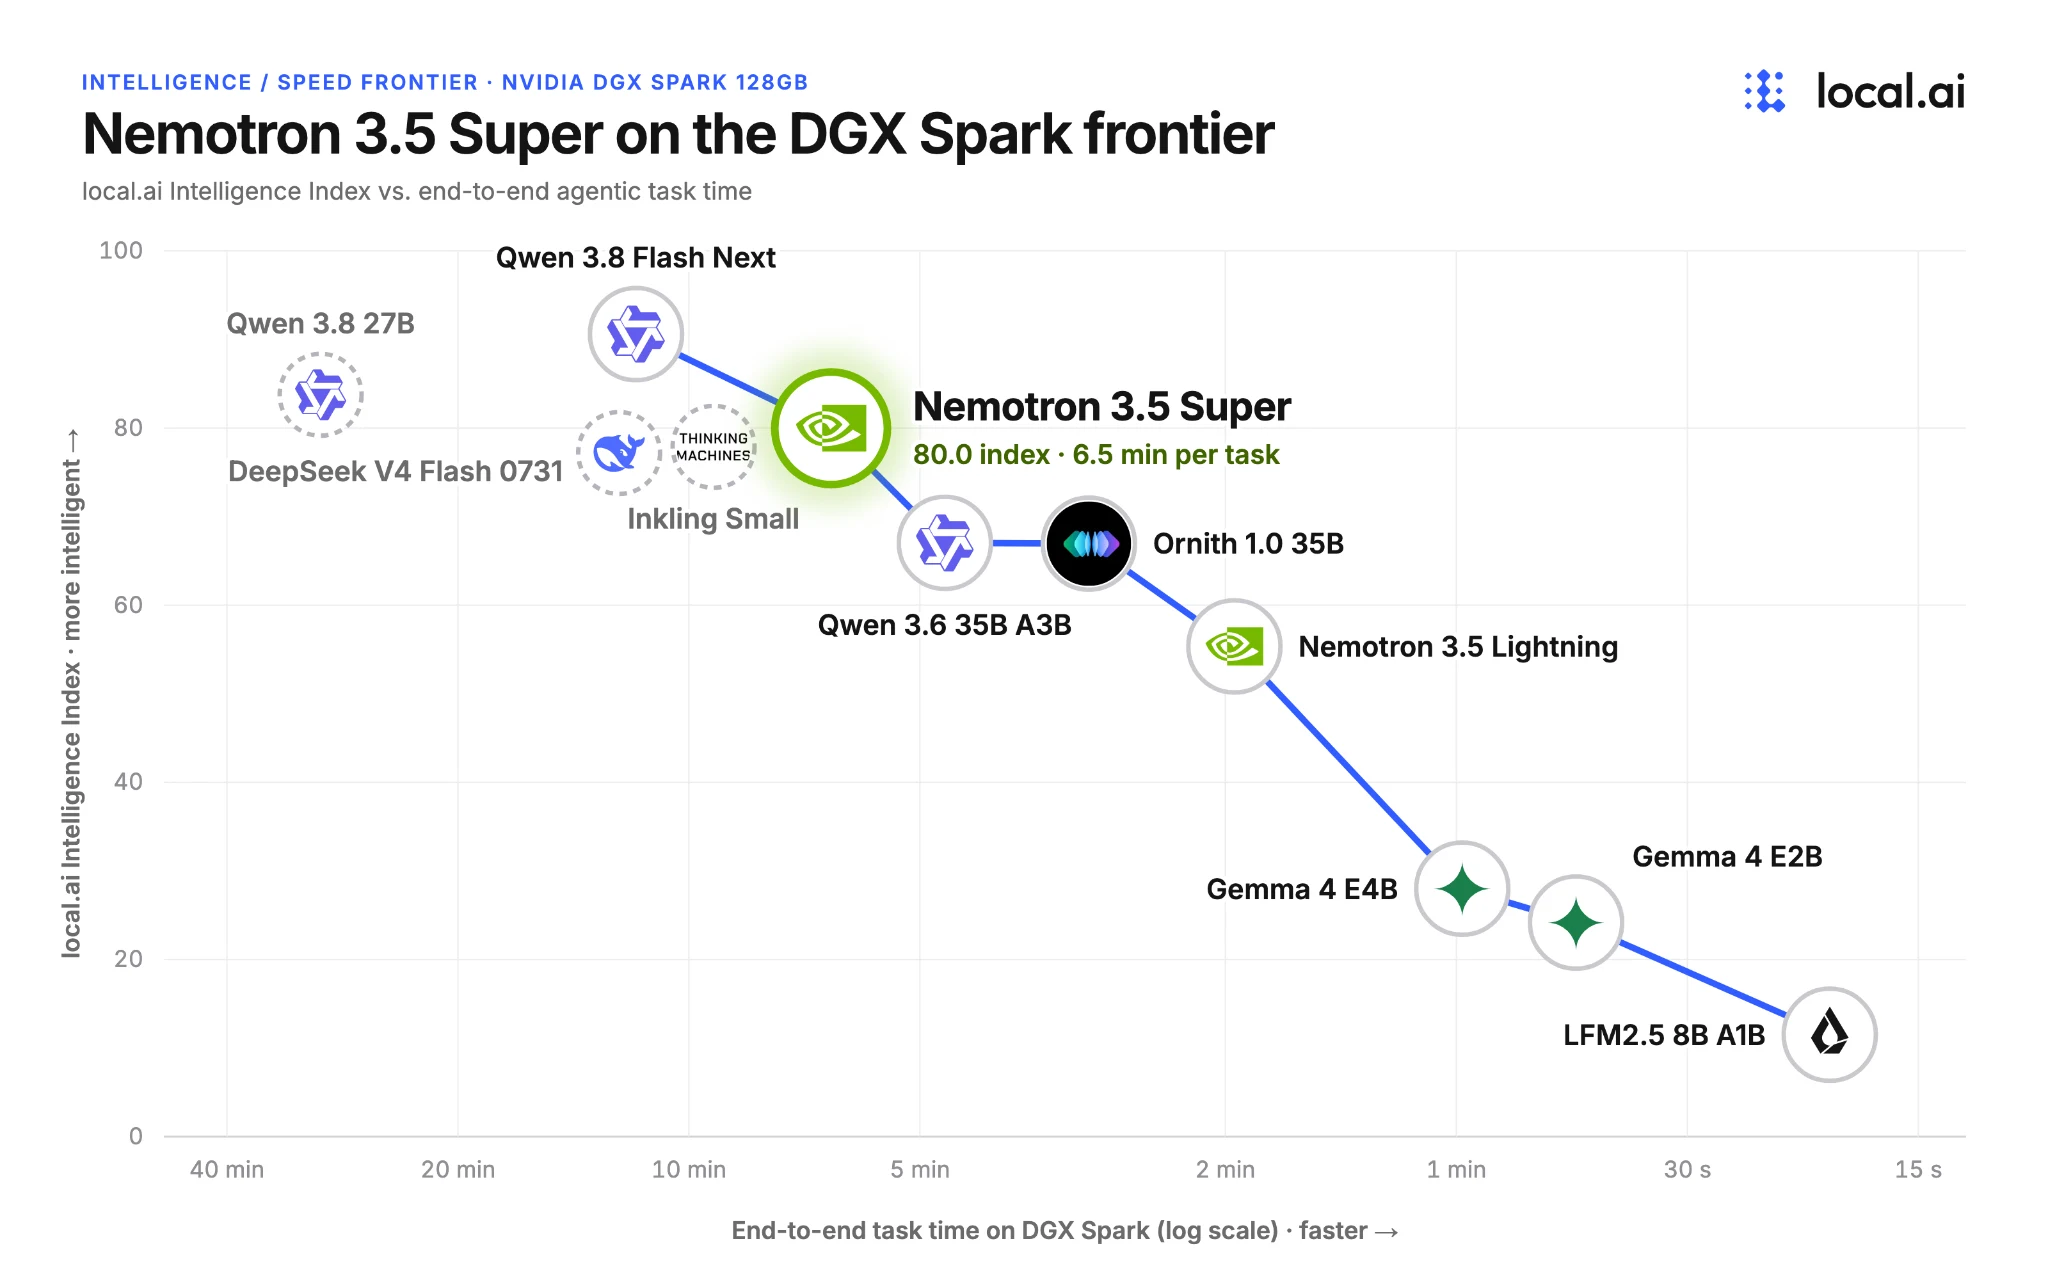
図 3. DGX Spark の効率フロンティア上の Nemotron 3.5 Super。
始めましょう
見て、推論し、行動できるエージェントを構築する準備はできましたか?
- Hugging Face からモデルの重みをダウンロードしてください: BF16 および NVFP4
- getting-startedを使ってvLLMでNemotron 3.5 Super VLを実行する cookbook
謝辞
NVIDIA:ニルマル・クマール・ジュルル、アヌシャ・パント、ファラドーン・ヤン、ペン・チュン・リー、アレックス・スタイナー、ラン・ジルバースタイン、ナーヴ・アサフ、アミール・クライン