
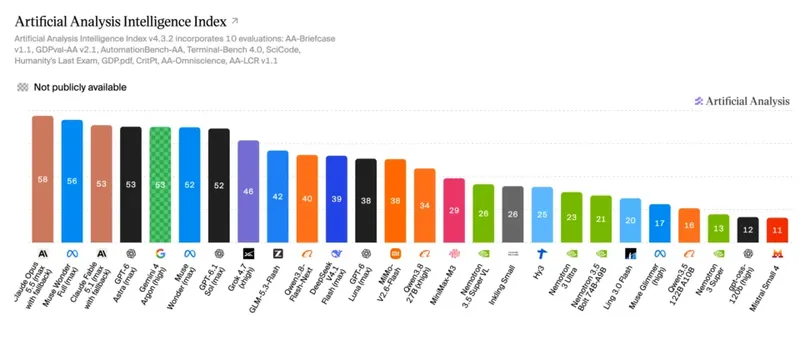
NVIDIAは本日、常に稼働する特殊用途エージェントに対して最速のタスク完了と最高の精度を実現する、オープンな120Bパラメータモデル「Nemotron 3.5 Super VL」をリリースしました。
これに加えて2つの新しいエッジモデルが登場します。1つは、ローカルのエージェントワークロードにおいてGBあたりの知能と速度のバランスを最適化した「Nemotron 3.5 Bolt 74B-A9B 24GB」、もう1つは、高速な会話型エージェント向けにGBあたりの知能を最適化した「Nemotron 3.5 Bolt E4B 4GB」です。
Super VLとBolt 74B-A9Bは現在提供中で、Bolt E4Bは10月23日に提供開始予定です。
この3つの オープンモデル は、大規模なエンタープライズサーバーからエッジデバイスやローカルハードウェアまで、エージェント展開の全範囲をカバーします。
NVIDIAインフラ上でエージェントを実行したい組織は、能力と展開性のどちらかを選ぶことなく、自社のティアに対応したオープンで最適化されたモデルを利用できます。
Super VLとBoltは、Nemotronファミリーに Lightning およびUltraとともに加わります。
8月にリリースされたLightningは高スループットのワークロードを処理し、Ultraは最も難しい推論タスクを処理し、Boltはエッジに知能をもたらします。
Nemotron 3.5 Super VL: 5分の1のサイズでフロンティアレベルの精度
Nemotron Coalition との協力により構築されたSuper VLは、マルチモーダルなエージェントタスク(指示への追従、ツールの使用、複数ステップのビジネスワークフロー、視覚理解)において最先端の精度を実現し、パラメータ数は約5分の1でありながら、NVIDIA最大の推論モデルに匹敵します。Nemotron 3.5 Super VLは、大規模なエージェントワークフローにおいて、そのクラスでフロンティアレベルの知能を提供します。
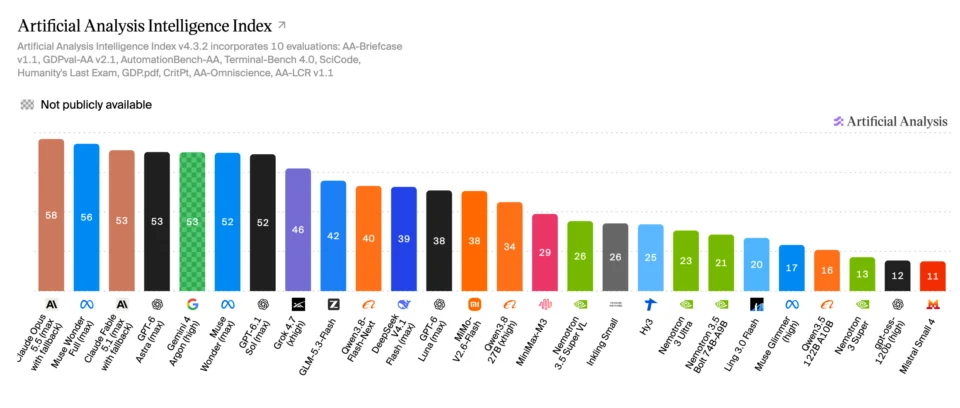
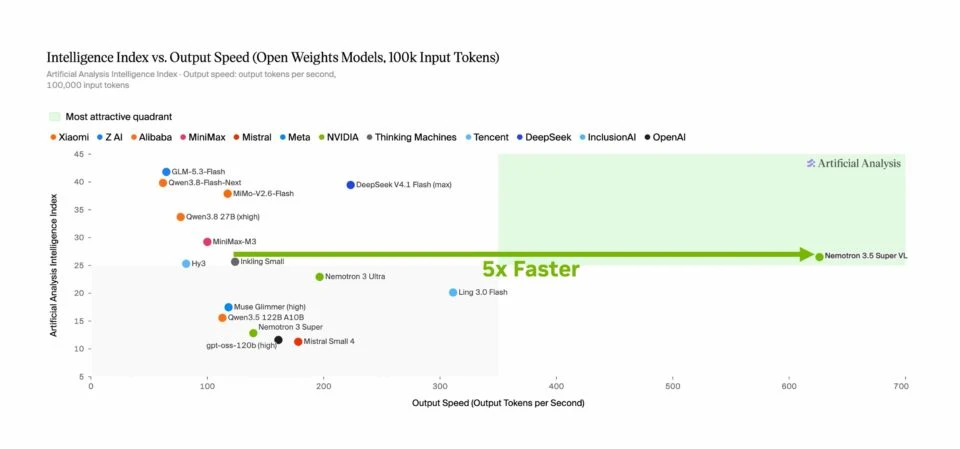
Nemotron 3.5 Super VLは、Artificial Analysis Intelligence Indexのリーダーボードにおいて、同クラスの他のモデルと比較して最大5倍のスループットを達成しています。
Nemotron 3.5 Bolt: エッジにおけるエージェント知能
Nemotron 3.5 Bolt: エッジにおけるエージェント知能
Bolt 74B-A9B 24GBは、NVIDIA RTX/DGX Spark上で日常的なエージェントタスクをローカルで実行できるよう設計されており、ネイティブの2ビット量子化を使用することで24GBのメモリに収まり、他のアプリケーションと並行して実行できます。
Bolt 74B-A9B 24GBにより、ユーザーは人気のローカルエージェントハーネスにプロジェクトを委任できます。Web調査から執筆、コードのデバッグまで、これらのワークロードをクラウドに送信することなくすべて実行できます。このモデルは、
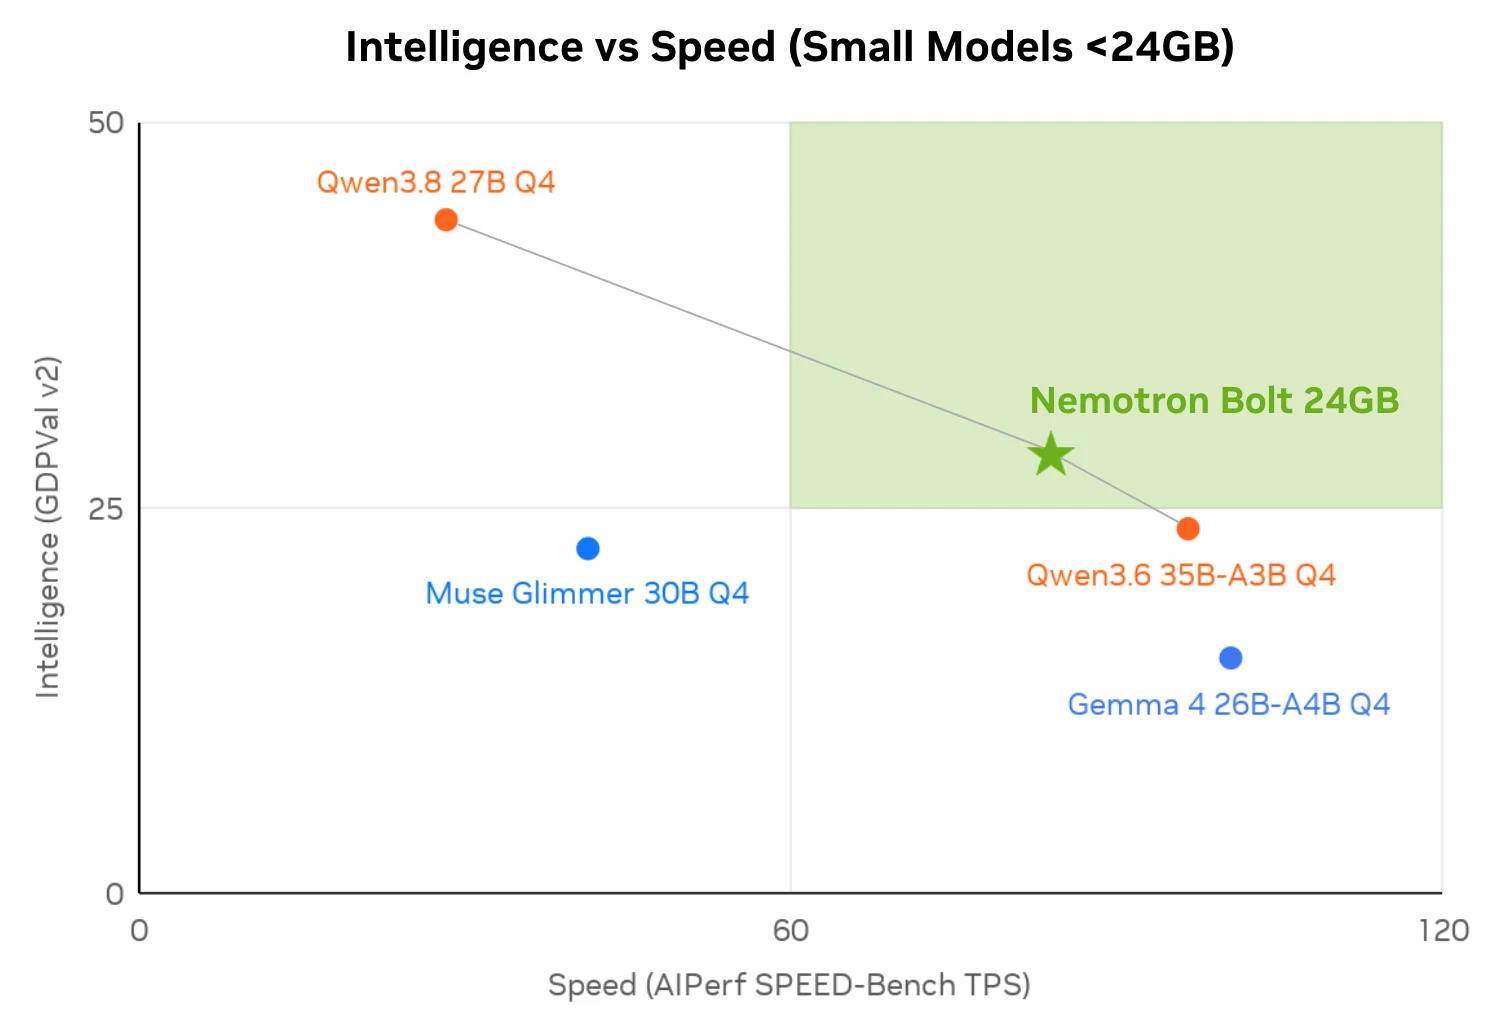
Bolt 74B-A9B 24GBにより、ユーザーはプロジェクトを人気のローカルエージェントハーネスに任せることができます — ウェブでのリサーチから文章の執筆、コードのデバッグまで — そのすべてを、こうしたワークロードをクラウドに送ることなく実行できます。同クラスにおいて#1のオープンモデルであり、 における同クラス第1位のオープンモデルであり、、そして#2のオープンモデルです。 における第2位のオープンモデルです。.
Bolt E4B 4GBは、GeForce RTX、Jetson、RTX/DGX Spark上の物理エージェントおよび会話型エージェント向けに構築されています。自然な会話とマルチターンのエージェント機能を組み合わせ、高速なローカル音声アシスタント、インタラクティブなキャラクター、組み込みインターフェースを支えます。
カスタムスーパーインテリジェンスの採用
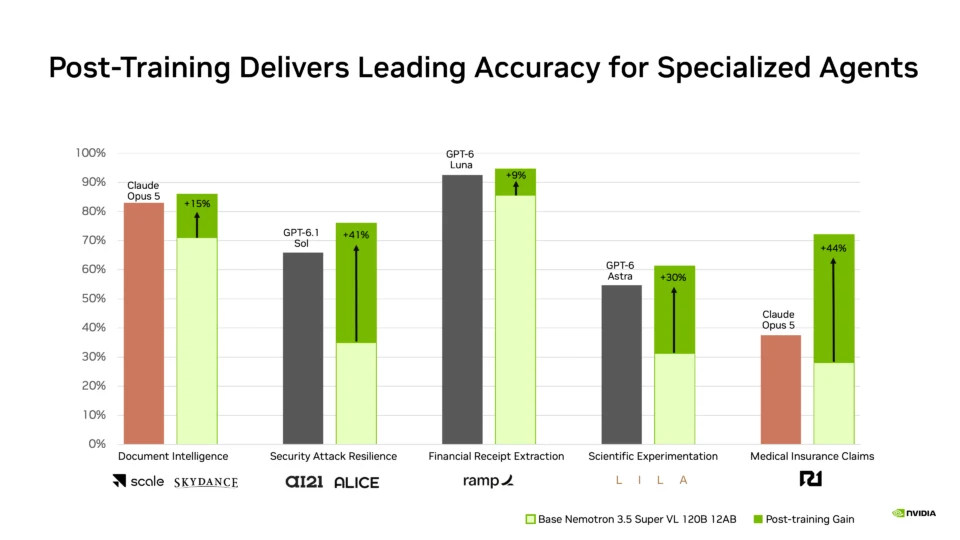
各業界の多数の組織が、自社のエージェント展開を定義する特殊なタスクで精度をさらに高めるため、自社のデータ、ツール、ポリシー、ワークフローでSuper VLをポストトレーニングしています。
Super VLは、様々な業界の組織によって事後学習(post-training)およびカスタマイズが行われています。 Scale AI は、Skydanceのベンダークレジット金融エージェントおよびEYのM&Aデューデリジェンスエージェント向けにモデルの事後学習を行いました。AfterQueryは、Hebbia向けにクレジット契約分析のためのモデルをカスタマイズしました。 AI21 と Alice は、サイバーセキュリティの攻撃耐性に向けてモデルの事後学習を行いました。Mercorは、コードの計画・作成・デバッグを行うコーディングエージェント向けに、APEX-SWEコーディングベンチマークでモデルの事後学習を行いました。 ModelScope は、開発者が同モデルを ms-swift フレームワークを通じてファインチューニングし、専門的なマルチモーダルアプリケーションに活用できるようにします。
Nemotron 3.5 Super VL をカスタマイズしているその他の組織には、財務ドキュメントインテリジェンスの Ramp、主権AIによるサイバーセキュリティ研究および脆弱性分析の Dream、科学探索と検索の Lila Sciences、そして R1 が医療請求分析および収益サイクル管理に取り組んでいます。TrainLoop は、AIによる初回患者処方箋作成の承認を取得したばかりの最初の企業となった Nolla の皮膚科データを用いて、このモデルをポストトレーニングしました。
Nemotron 3.5 Super VL を統合しているソフトウェアプラットフォーム企業は以下の通りです:
- Atlassian, は、Jira や Confluence などのアプリケーションを横断するエージェンティック検索などのタスクに活用しています。
- CrowdStrikeは、エンタープライズセキュリティにおけるエージェンティックなブルーチーミング向けにモデルをカスタマイズしています。
- Dassault Systèmesは、エンジニアリング設計およびシミュレーションを支えています。
- Perplexityは、Perplexity Search および Computer における検索とエージェンティックなタスクに活用しています。
- Salesforceは、Missionforce Operations を通じて、安全な顧客環境において複雑な政府ワークフローをデジタル化・自動化するAIエージェントを動かすために Nemotron をカスタマイズしています。
- Synopsys の半導体設計検証ソフトウェアは、このモデルと相互運用します。
Nemotron 3.5 Super VL が実際に見るもの
Nemotron 3.5 Super VL の ビジョン言語 の強みは、エージェントが実際に遭遇する場面、すなわち視覚的ドキュメント内の光学文字認識、表、グラフ、構造化情報に的を絞っています。
このモデルはWebページを処理し、テキストを抽出し、グラフやチャートを読み取り、見つけた内容からインサイトを返します。PDF や、エージェントが日常的に扱うその他のドキュメントについても同様です。
Nemotron 3.5 Super VL は画像、Webページ、PDF を理解し、その理解に基づいて行動します。テキストと視覚の理解を1つのモデルに統合することで、エージェントは個別のシステム間でタスクを振り分ける必要がなくなり、ドキュメントからデータ、そして意思決定へと作業が進む中でコンテキストが引き継がれます。
最大限の制御、セキュリティ、プライバシーのためのオープン性
オープン性とカスタマイズ性は互いを強化します。このモデルは、オープンな重み、オープンなデータセット、およびトレーニングレシピとともに提供されます。
制御は2つの方向に及びます。組織は、セキュリティおよびデータレジデンシーの要件が求める場所であればどこでもモデルを実行できます。さらに、プロバイダーの制限に縛られるモデルではなく、適応可能なモデルを選択することもできます。
たとえば保険業界では、カスタマイズされたエージェントが不正の兆候を繰り返し請求書からスキャンできます。金融サービスでは、エージェントがクレジットスコアを確認し、組織独自の融資基準に反する活動をフラグ付けできます。モデルはオンプレミスに置かれ、データはプライベートに保たれます。
カスタマイズは、NVIDIA NeMo、Python ベースのパイプライン、およびオープンデータセットを通じてサポートされます。
Nemotron 3.5 Super VL は、約26兆トークンにわたって学習を行い、 事前学習 継続的な事前学習が行われ、その後、約3.8百万件のサンプルと数十の環境における強化学習を用いた事後学習が施されました。
NVIDIA はまた、Hugging Face 上で エージェンティックなツール使用「、金融、指示追従、長いコンテキスト、公平性、視覚言語理解に加え、NeMo Gym の強化学習環境を含みます。」
NVIDIA NIM モデルを本番環境対応のマイクロサービスとしてパッケージ化し、パフォーマンスが最適化された検証済みの構成とエンタープライズグレードのサポートを提供し、セキュリティパッチとパフォーマンス改善を2週間ごとに更新します。
さらに、このモデルをNVIDIA Dynamo上で実行することで、組織は最大8倍多くのユーザーに、85%低いレイテンシでサービスを提供できます。
Nemotron 3.5 Super VLは現在、Hugging FaceやOpen Routerで利用可能です。 ModelScope コミュニティ 「また、NVIDIA NIMとしても提供されます。」
DGX Spark、DGX Station、RTX上で動作
Nemotron 3.5 Super VL はNVIDIAのハードウェアスタック全体で動作します: DGX Spark, DGX Station、デスクトップ上でローカルインテリジェンスを実現するRTX PROおよびRTXシステム、 NVIDIA Jetson エッジ、およびデータセンターとクラウド環境全体にわたって提供します。
Nemotron 3.5 Bolt 74B-A9B 24GB は現在Hugging Faceで入手可能で、llama.cppに対応しています。 Ollama, LM Studio, Unsloth、および vLLM。〜のために構築された NVIDIA RTX Spark ノートパソコン 10月16日に到着し、 GeForce RTX PC, DGX Spark, DGX Station および RTX PRO ワークステーション.
以下からダウンロードしてください オープンウェイト、NVIDIA NeMoのカスタマイズリソースを調べるか、以下をお読みください テクニカルブログ アーキテクチャの詳細な解説をご覧ください。
NVIDIAのエージェントに関する最新情報をチェックしましょう Nemotron 「…などをもっと読むには、以下を購読してください。」 NVIDIAのニュース, コミュニティへの参加、X(旧Twitter)でNVIDIA AIをフォローする LinkedIn, Instagram, X および Facebook.
探索 自己ペースで学べる動画チュートリアルおよびライブストリーム.
参照 お知らせ ソフトウェア製品情報に関する。