
企業のリーダーと行うすべての会話で、同じことを言われます。エージェントにもっと多くのことをさせたいが、すべてを正しくできるとは信頼できない、と。
それはもっともなことです。エージェントを有用にする創造性と自律性そのものが、エージェントを信頼しにくくしています。エージェントにタスクを与えると、開発者がスクリプト化したことのないツールの選択やステップの順序付けを通じて、独自の方法で完了への道を見つけます。同じタスクを2回実行すると、毎回異なる経路をたどるかもしれません。今日合格したテストは、明日そのエージェントが何をするかについてほとんど何も教えてくれません。
通常の答えは、人がループに入り、エージェントが行うすべてを承認することです。これは小規模では機能しますが、エージェントがより多くの仕事を担うようになると、人間の承認が積み重なり、レビュー疲れが生じます。すべてを確認するよう求められた人は、重要なことを見逃すようになります。慎重さがボトルネックとなり、はるかに多くのことができるはずのエージェントが、より大きなインパクトを与えられる貴重な仕事のために遊休状態に置かれます。
解決策は、行動を検証できる場合にはエージェントに自律的な行動を許し、判断を必要とする決定には人間の判断を留保することです。エージェントが金融取引のようなリスクの高い仕事を担うようになると、誤った行動の害はますます大きくなります。組織は、誰も監視していないときでも設定された限界内にとどまるとわかったうえで、AIエージェントに重要な仕事を任せる確信が必要です。その確信は築き上げなければなりません。
コンテンツフィルタリング、テスト、モニタリングはそれぞれ重要な役割を果たしますが、これらの機能のどれひとつとして、エージェントが次回の実行で正しく振る舞うことを保証できるものはありません。信頼は、互いを補強する独立したレイヤーから生まれます。これは、業界が2 decades(20年)にわたって多層防御(Defense in Depth)として実践してきたレイヤー化の規律と同じものを、新しい目的に転用したものです。多層防御が何がうまくいかないかを制限するのに対し、これは安全に許容できる範囲を拡大します。AWSはこれを Trust in Depthと呼んでいます。
Trust in Depth: 検証できる信頼
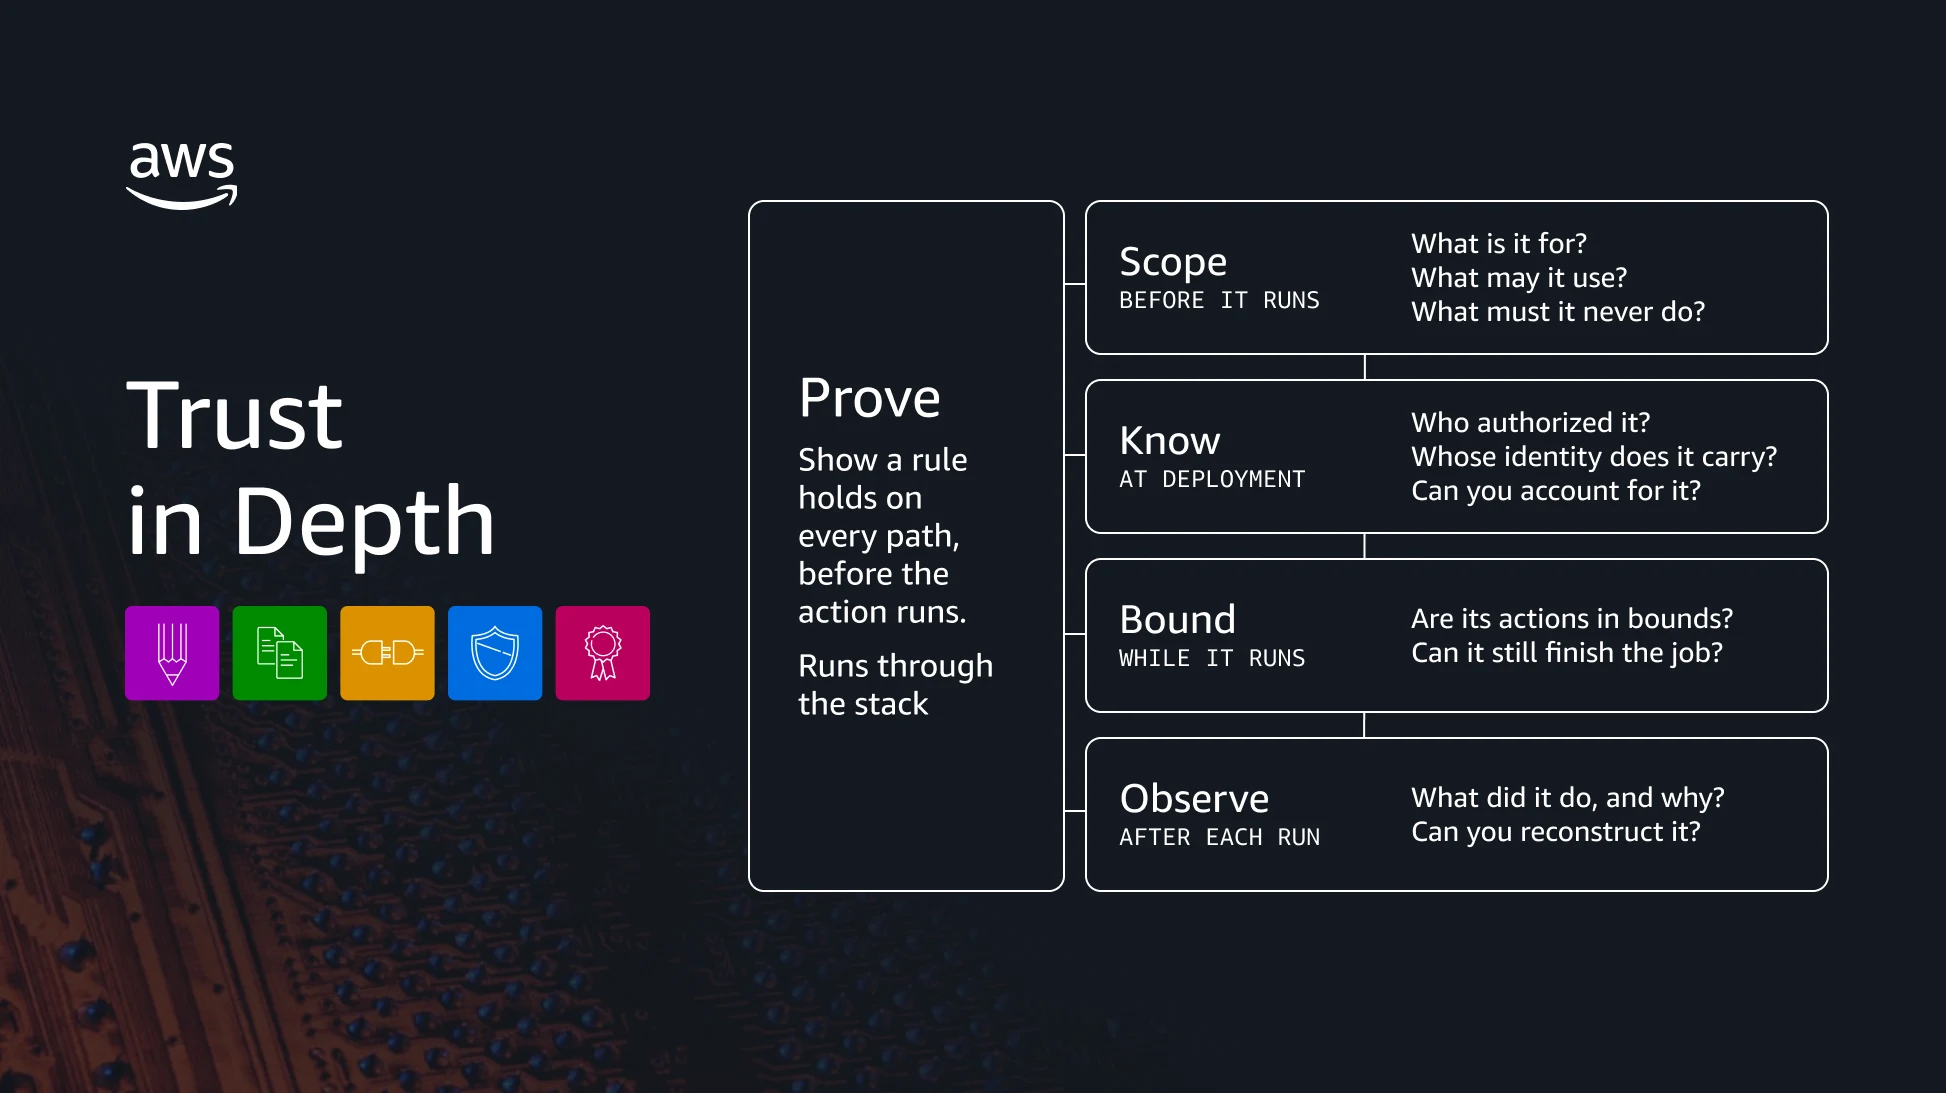
信頼は、エージェントのライフサイクルにおけるさまざまな時点で一連の問いに答えることによって築かれます:
- スコープ(scope)、実行前: このエージェントは何のためにあるのか、その仕事にはどのような能力が必要か、そして決してしてはならないことは何か?
- 把握(know)、デプロイ時: 誰がこれを許可したのか、どのアイデンティティを持つのか、そして自分の代理で行動するすべてのエージェントを説明責任をもって把握できるか?
- 制限(bound)、実行中: その行動は設定した限界内にとどまっているか、そしてそれでも仕事を果たせるか?
- 観察(observe)、実行後: エージェントが何を、なぜ行ったのかを再構成し、そこから学ぶことができるか?
これらの問いを通して、一部の要件は厳密なルールとして表現できますが、他は判断を必要とします。企業は、マネージャーのみがアクセスを承認できること、または従業員のサインインがブロックされなければメールボックスを共有できないことなどを要件とするかもしれません。一方、フレンドリーなトーンを保つことや機微な状況に適切に対処することといった期待は、文脈と人間の判断に依存します。
厳密に定義されたルールについては、テストによって想定するケースで制御が機能するかを確認できますが、エージェントは想定していなかった経路をたどります。さらに先へ進む技術が自動推論(automated reasoning)です。これは、ルールがすべての可能なケースで成立するかを検査する数学的論理です。システムとその前提の厳密な記述でカバーされるすべての経路上でルールが成立することを確立できるか、あるいは失敗する正確なケースを突き止めることができます。その結果は証明であり、その背後にあるルールと前提と同じ程度にしか良くありません。だからこそ、最も難しい作業はエージェントが実行される前に行う必要があるのです。
AWSは 10年以上にわたり自動推論を本番環境で運用してきましたIdentity and Access Management(IAM)では毎秒21億回を超えるリクエスト、AWS Nitro Hypervisor、Amazon S3 Block Public Access、VPC Reachability Analyzerといった重要なシステムなどで使用されています。現在、私たちはこれをエージェントにも導入しようとしています。エージェントのルールが正確に記述できる場所であれば、自動推論によってそれらを検証できます。
しかし、すべてのルールを厳密に記述できるわけではありません。「マネージャーのみがアクセスを承認できる」は証明できます。「フレンドリーなトーンを保つ」は証明できません。証明が適用できない場合は、エージェントのアクセスと行動を制限し、その振る舞いを評価し、本当に曖昧な場合は人間の判断のために送ります。関連するルールが強制されていること、エージェントがそのタスクで確実に遂行できること、そして失敗を検出して対処できることを確認しながら、自律性を段階的に広げていきます。
以下は、Trust in Depthの各レイヤーがあなたに求めることと、AWSがその答えをどのように支援するかです。
エージェントを仕事に必要な範囲だけに限定する
信頼はエージェントが実行される前に始まり、ここが最も労力を投資すべき場所です。ここで発見された問題は修正コストが低くて済みます。スコープ設定とは、エージェントが担当する仕事、アクセスを許可するツール、データ、サービス、従うべきルール、そして人間に留保される決定を決めることです。
「顧客の問題を解決する」は、達成すべきことを示すものであり、エージェントが達成のためにどのように行動してよいかを示すものではありません。エージェントには、何を見てよいか、何をしてよいか、いつ停止して質問すべきかに限界を設ける必要があります。仕事に必要なアクセスだけを与え、それ以上は与えません。誰も意図的に許可していない能力、つまりツールやロールにバンドルされている能力に注意してください。1つのタスクのために管理者ロールを付与すると、エージェントは環境全体にわたる権限を継承してしまう可能性があります.
スコーピングはビルド段階から始まります。それはエージェントをどのように定義するかということです。 Kiroはエージェンティックなコーディングシステムであり、エージェントのビルド段階に厳格さと成熟したエンジニアリング実践をもたらします。Kiro は高レベルの意図を構造化された仕様駆動の要件に変換し、自動推論を用いて、コードを書く前に矛盾、曖昧さ、欠落を明らかにします。さらに Kiro は、プロパティベースのテストを導出し、幅広い入力範囲にわたって実装がそれらの要件を満たしているかを検証することで、検出が困難なバグを捕捉します。 Strands は、エージェントのモデル、指示、ツールを定義するためのオープンソースツールキットと、それを運用するためのマネージドランタイムを提供します。どのフレームワークを選んでも、エージェントの職務とその境界を定義する責任は同じです。
次のステップは、それらの境界を、エージェントに課すことのできるルールに変換することです。 Amazon Bedrock AgentCore は、エージェントを安全にスケールさせるためのガバナンスコントロールを提供し、エージェントの行動を管理します。Bedrock AgentCore の Policies を使用すると、エージェントがアクセスしてよいツール、API、データを平易な言語で記述でき、自動推論がポリシーの発効前に、過剰なアクセスを許可するルールのようなギャップを検出し、ルールを決して満たせなくする矛盾がないかをチェックします。
エージェントのスコーピングが最も難しい部分です。人間の意図を永続的で強制可能なポリシーに変換するには、正確さと完全さが求められるからです。しかし、それは同時に最も見返りの大きい部分でもあります。ここで設定した内容の上にすべてが築かれ、ポリシーが正確であるほど、エージェントはより多くのことを安全に自律的に実行できます。
あなたの代理として行動するすべてのエージェントと、その権限の主体を把握する
見えないものは管理できません。チームは誰も追跡しきれないほどの速さでエージェントを作成しており、誰にも知られていないエージェントは誰にも管理されていないエージェントです。すべてのエージェントには固有のアイデンティティが必要であり、行動のたびに検証されなければなりません。孤立したアクションがあってはなりません。問題が発生したときには、どのエージェントが何をしたのか、誰がそれを承認したのかを把握できるようにする必要があります。
AWS Agent Registry は、組織全体のエージェント、Model Context Protocol (MCP) サーバー、ツール、スキルの承認済みマネージドカタログを提供します。管理者は承認ワークフローを使用して、発見可能になるものを制御し、セキュリティ、コンプライアンス、品質の基準を満たさなくなったものを削除します。人間とエージェントの双方が、既存のものを再構築するのではなく、見つけて再利用できます。しかし、カタログが教えてくれるのは何が存在するかだけです。エージェントが把握された後は、AgentCore が各エージェントに固有のアイデンティティを発行し、すべてのリクエストでそれを検証するため、すべてのアクションは既知の権限のもとで動作する特定のエージェントに遡ることができます。それによって、あなたの代理として行動するすべてのエージェントを把握できるのです。
エージェントの発言と行動を、設定した制限の範囲内に収める
境界を設定することが重要なのは、エージェントが承認した 10 ステップを実行しても、誰も意図しない結果に達する可能性があるからです。機密データを公開したり、話題から逸脱したり、許可されたアクションをポリシーが禁じる形で組み合わせたりする可能性があります。制限は両方向で破綻し得ます。緩すぎれば、エージェントはあってはならないことを実行できます。厳しすぎれば、まったく職務を果たせません。したがって、エージェントにタスクの遂行方法を選ばせることは許しても、その限界の強制をエージェント自身に任せてはなりません。それらの制限はエージェントの境界を定義するものであり、エージェントを取り巻く環境に属し、決定論的に強制され、一度に一ステップではなくアクションの全シーケンスにわたって評価されるべきです。
ここで、スコープで定義したポリシーが発効します。 AgentCore の Policy は、エージェント、ツール、モデルの安全な入口である AgentCore Gatewayを経由するすべてのツール呼び出しに対してそれを強制します。強制がエージェントの推論の外部に置かれているため、エージェントにバグがある場合、操作された場合、プロンプトインジェクションを受けた場合でも、同じチェックが維持されます。エージェントは、自分が実行していないコントロールを無効化できないからです。権限は固定されたままである必要もありません。タスクのリスクは進行とともに変化するため、 時間的ポリシー (temporal policies) はセッションで既に起こったことを考慮し、作業の継続に応じて権限を調整します。 Amazon Bedrock Guardrails は、エージェントの発言と、エージェントに与えられる情報を管理します。有害または話題外のコンテンツをフィルタリングし、機密データをマスキングします。 Automated Reasoning checks はさらに進んで、応答がモデルの解釈ではなく、設定したポリシーと整合していることを証明します。
境界はまた、エージェントがそもそも何に到達できるかも管理します。どのファイルに触れられるか、どのサービスを呼び出せるか、どの認証情報を使用できるかです。 Strands Boxはオープンソースのサンドボックスであり、エージェントの指示の外部からそれらの境界を強制するため、エージェントは実際のツールやデータを扱いながら、許可されたものにのみ到達できます。同じ境界が、開発者の最初のローカルセッションから本番環境まで維持されるため、開発環境でできなかったことをエージェントが本番環境で行うことはありません。
エージェントが何をしたかを観察し、改善する
スコープ設定、アイデンティティ、境界がすべて整っていても、エージェントはミリ秒単位で応答し、エラーもなくダッシュボードがすべてグリーンなのに、間違ったことを行う可能性があります。誤った情報を取得したり、誤ったツールを選んだり、誰も予想しない経路をたどったかもしれません。健全なシステムと成功したタスクは同じではありません。その違いを見分けるには、エージェントが実際に何をしたのか——受け取ったコンテキスト、呼び出したツール、適用されたポリシーの決定、そしてその結果——を再構築する必要があります。デプロイ前のテストは依然として不可欠です。本番環境は、実際の条件下での動作に関する証拠を追加し、運用担当者に調査、介入、改善に必要なものを提供します。
Amazon CloudWatch Omni 継続的な観測のために構築されています。モデル呼び出しからツール呼び出しまで、エージェントが取った各ステップをすべて記録し、チームが調査できるタイムライン上に展開します。組み込みの評価機能は、正確性や忠実性、エージェントが適切なツールを選択したかどうかといった、標準的なモニタリングでは見落とされる品質をスコア化します。また、エージェントが誤った箇所のトレースは、修正を検証するためのデータセットとなり、エージェントの運用と改善が同じエビデンスに基づいて行われます。
実際の「多層的な信頼(Trust in Depth)」とはどのようなものか
ある管理者が、退職するアカウントマネージャーのSamの退社処理をヘルプデスクの担当者に依頼します。担当者はSamのアクセス権を削除し、メールボックスを後任者に移行し、会社がもはや必要としないライセンスを解放する必要があります。しかし、Samのメールには顧客との紛争に必要な証拠が含まれている可能性もあります。手順を誤れば、Samが退職後もアクセス権を持ったままになったり、その証拠が危険にさらされたりしかねません。セキュリティ、メッセージング、法務、財務の各部門がそれぞれ要件を持っており、担当者はそれに従わなければなりません。誰もワークフロー全体をスクリプト化してはいないにもかかわらずです。
この順序を左右する2つのルールがある。Samのサインインをブロックしてからでなければ、彼のメールボックスを後任者向けに変換・共有することはできない。また、エージェントはメールライセンスを変更する前に、法的保留、つまり紛争のために記録を保全する要件がないか確認し、その変更によってそれらの記録が引き続き保護されることを確認しなければならない。
スコープ。エージェントの実行前に、チームはこれらのルールをポリシーとしてAgentCoreに書き込みます。各ポリシーは、次のステップを実行できるようになる前に、前提となるステップがSamのアカウントですでに成功していることを要求します。エージェントには正確に6つのツールが与えられます:サインインのブロック、法的保持の確認、保持の適用、メールボックスの変換、後継者へのアクセス権の付与、そしてライセンスの変更です。アカウントを削除するツールは与えられません。共有メールボックスが機能するにはアカウントが存続している必要があるからです。
知る。エージェントは独自の識別情報を持っているため、Samのアカウントへのすべての変更はそのエージェントにたどることができます。
製本されたエージェントはSamのメールボックスを後任のPriya用に共有メールボックスへ変換しようとします。AgentCore Gatewayで強制されるAgentCoreのポリシーがこの呼び出しをブロックします。Samはまだサインインできており、メールボックスを変換してもパスワードは変わらないため、古い資格情報がそのままメールボックスを開けてしまうからです。そこでエージェントはSamのサインインをブロックしてから、メールボックスを変換し、Priyaにアクセス権を付与します。次に、マネージャーの実際の依頼であるライセンスの解放に移りますが、ゲートウェイはこれもブロックします。Legal(法務)の保留リストを誰も確認していないからです。エージェントが確認すると、法務は顧客との係争のためにSamのメールを保全するよう求めていました。エージェントは保全(hold)を設定し、有効になっていることを確認した上で、Samのライセンスをその保護に対応したものへ変更します。これにより、会社は証拠をそのまま保持しつつ、より広範なライセンスを回収できます。
観察する。すべてのステップが記録されます:エージェントが何をしようとしたか、ルールが何を決定したか、ホールド、そしてその結果です。
エージェントは、人間が各ステップを承認することなくタスクを完了しました。その権限によって変更できる範囲が制限され、そのIDによって変更が追跡可能になり、必要な安全策が整う前にポリシーが行動を阻止しました。記録されたステップにより、チームはSamのアクセスがブロックされたこと、後継者がメールボックスを利用できること、必要な証拠が保護されたままであることを確認できました。
エージェントが信頼されるとき、何が可能になるのか
AWSはこれらのレイヤーを組み合わせることで、エージェントをその役割に限定し、どのエージェントがあなたのために動いているかを把握し、その行動や発言に境界を設け、何を行ったかを確認して継続的に改善し、そしてルールを正確に記述できる場面ではどこでもそのルールが守られていることを証明できるようにします。どの単一のレイヤーも、それだけではその信頼を獲得することはできません。組み合わさって初めて、それらは「多層的 信頼(Trust in Depth)」となり、優秀なエージェントを、重要な仕事を任せられる信頼に足るエージェントへと変えるのです。
線引きはあなたが行います。エージェントが単独で行ってよいこと、人間の承認を要すること、そして停止しなければならないときです。それにより、人間にしかできない仕事――難しい判断の熟慮、グレーゾーンの解決、そして人間の手に留めることを選択した決定の責任を担うこと――に、あなたの社員を解放できます。エージェントがその線の中にとどまっているという証拠が積み重なるにつれ、その責任範囲を広げることも狭めることも可能です。
AWSでは、どんなプラットフォーム上でエージェントを展開するすべての組織が、この4つの問いに根拠をもって、そして該当する場合には証明をもって答えられるべきだと考えています。それこそがAWSがお客様のために築こうとしている基準であり、業界全体にも自らに課すよう呼びかける基準です。Defense in Depth(多層防御)によって、システムを世界とつなぐことが安全になりました。Trust in Depth(多層的な信頼)によって、エージェントがその中で自律的に行動することが安全になります。
1つのエージェント、1つのワークフロー、そして証明できる1つの境界から始めましょう。その後、信頼が得られながら拡大していきます。
実施可能なルールの実装を始めるには、次を参照してください Amazon Bedrock AgentCore のポリシー および Amazon Bedrock Guardrailsの自動推論チェック.