
はじめに
大規模にAIエージェントを展開するチームは、常に同じパターンに直面しています。FableやAstraといった最上位モデルを基盤に構築されたエージェントでさえ、特定の製品内で複雑なエンドツーエンドのタスクを、デプロイに耐える一貫性をもって実行するのが難しいのです。そのため、チームは最も重要なワークフロー向けに評価を作り込み、多くの場合、手書きの数百から数千のケースを用意し、その後、プロンプトの編集、ハーネスの修正、特殊ケースの追加によって少しずつエージェントを改善し、十分な数のケースをパスして本番稼働できるようにしていきます。
一方で、その製品のユーザー自身が毎日同じタスクを実行しており、どのアクションをどの順番で行えばよいかを知っています。オープンソースのCopilotKitフレームワークとAG-UIプロトコルを開発するCopilotKit社は、 CLiFという、フルスタックの軌跡からの継続学習のためのプラットフォームを 早期アクセスとして公開しました。CLiFは、エージェントが何をしたか、そしてユーザーが製品内で何をしたかを安全に記録し、その記録をスキル、本番データに基づく評価、ファインチューニング用データセットへと変換します。これらはすべて、生の軌跡データとともにエクスポート可能です。
CopilotKitはオープンソースで、GitHubで38,000以上のスターを獲得しています。
TL;DR
- エージェントのトレーシングはエージェントがどこで間違えたかを示しますが、正しい手順はユーザーが製品内で行う行動の中にあり、その大部分はどのスタックでも記録されていません。
- 早期アクセス中のCLiFは、フルスタックの軌跡から学習します。すなわち、エージェントのトレースとユーザーの製品内での行動を、AG-UIを介して1本のタイムラインとして安全に記録するものです。
- CopilotKitのAutomatic Learningを基盤とする4段階のループが、これらのフルスタックの軌跡をスキル、本番データに基づく評価、ファインチューニング用データセット、生データのエクスポートに変換し、すべてのスキルを人間がレビューします。
- 実際の事例では、エージェントがチームリードが実際にスプリントを完了させる方法を学習する様子を示しています。
- CLiFは、評価、コンテキストの肥大化、コスト、分断されたスタック、シャドウAIの利用といった、エージェントチームの足を引っ張る課題に対応し、完全なセルフホストで動作します。
エージェントのトレーシングが見落とすもの
現在のエージェントのオブザーバビリティの多くは、エージェントを中心に据えています。トレーシングツールはプロンプト、ツール呼び出し、モデルの出力を記録し、エージェントがどこで間違えたかを示す一方で、正しい手順を視界の外に置いたままにします。プロダクトアナリティクスはクリック、ファネル、セッションリプレイで反対側をカバーしますが、そのデータはダッシュボードを読む人間のためのものであり、エージェントにタスクを教えたりテストしたりするためのものではありません。ほとんどの本番エージェントスタックでは、この2つが同じタイムライン上に載ることはありません。
このギャップが問題になるのは、エージェントがプロンプト、スキル、ツールの説明、公開されたAPIから製品を学習し、実際のタスクのためにそれらがどのように組み合わさるのかを自分で解明しなければならないからです。一方、その製品を使っている人々はすでにそれを解決しており、多くの場合、何百回も繰り返しています。CopilotKitの見解は、その「エージェント学習」に関する解説記事で示されているように、 ユーザーが実際に仕事を成し遂げる方法こそが、エージェントチームにとって最も価値のあるデータセットであるにもかかわらず、エージェントが学習できる形で記録されることはほとんどない、というものです。
フルスタックの軌跡:CLiFが基盤とする学習信号
CLiF は CopilotKit Intelligence の一部であり、フルスタックの軌跡という単一のプリミティブを中心に構築されています。これは、 AG-UI(Agent-User Interaction Protocol)、すなわちCopilotKitがエージェントとユーザー向けアプリケーションを接続するために作ったオープンプロトコルを通じて記録されます。AG-UIはあらゆるサーフェス上でエージェントとユーザーの間に位置するため、タスクの両側を把握できます。
- エージェントの軌跡(エージェントトレース): エージェントが実行したすべての実行、ツール呼び出し、状態の変化、およびそれぞれが返した結果。
- 製品のトラジェクトリ(ユーザーアクション): ユーザーの画面に表示されていたもの、クリックしたボタン、そしてトリガーされたサーバーリクエスト。ユーザーが途中でエージェントと会話すれば、その会話も順序どおり同じタイムライン上に記録されます。
これらを合わせると、フルスタックのトラジェクトリになります。
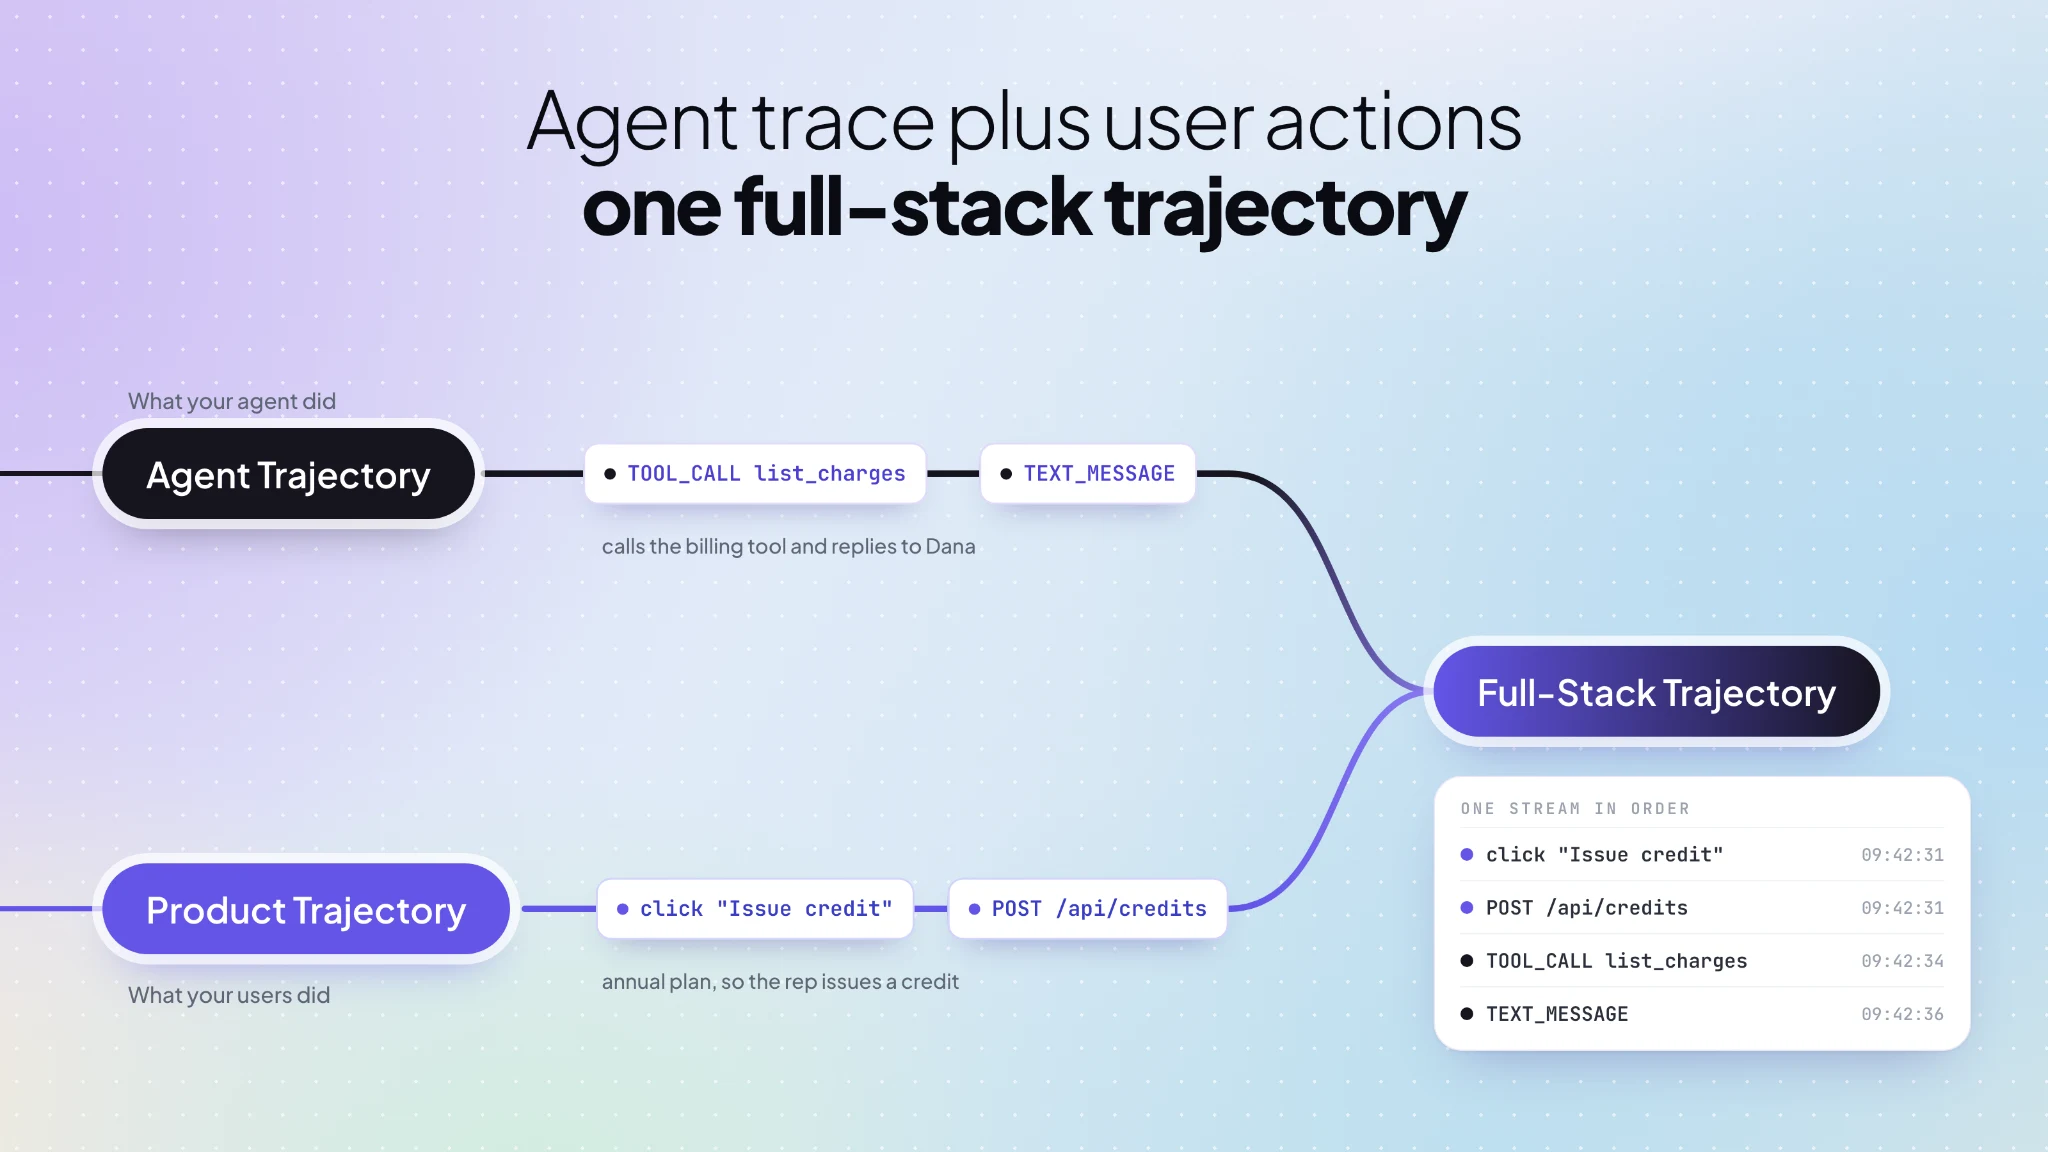
AG-UIはすでにエージェントのイベントをフロントエンドへストリーミングしているため、同じプロトコル経由でユーザーアクションを安全にキャプチャすれば、最初から両方の半分がひとつのストリームにまとまり、後から別々のアナリティクスパイプラインをつなぎ合わせる必要がありません。各ユーザーセッションは単一のトラジェクトリとなり、チームはCopilotKit Intelligenceで開いて、クリック、サーバーリクエスト、エージェントメッセージを発生した順にステップごとに再生できます。
CLiFの内部:トラジェクトリからスキル、評価、トレーニングデータへ
CopilotKitはこのラーニングループを4つのステージで説明しています。
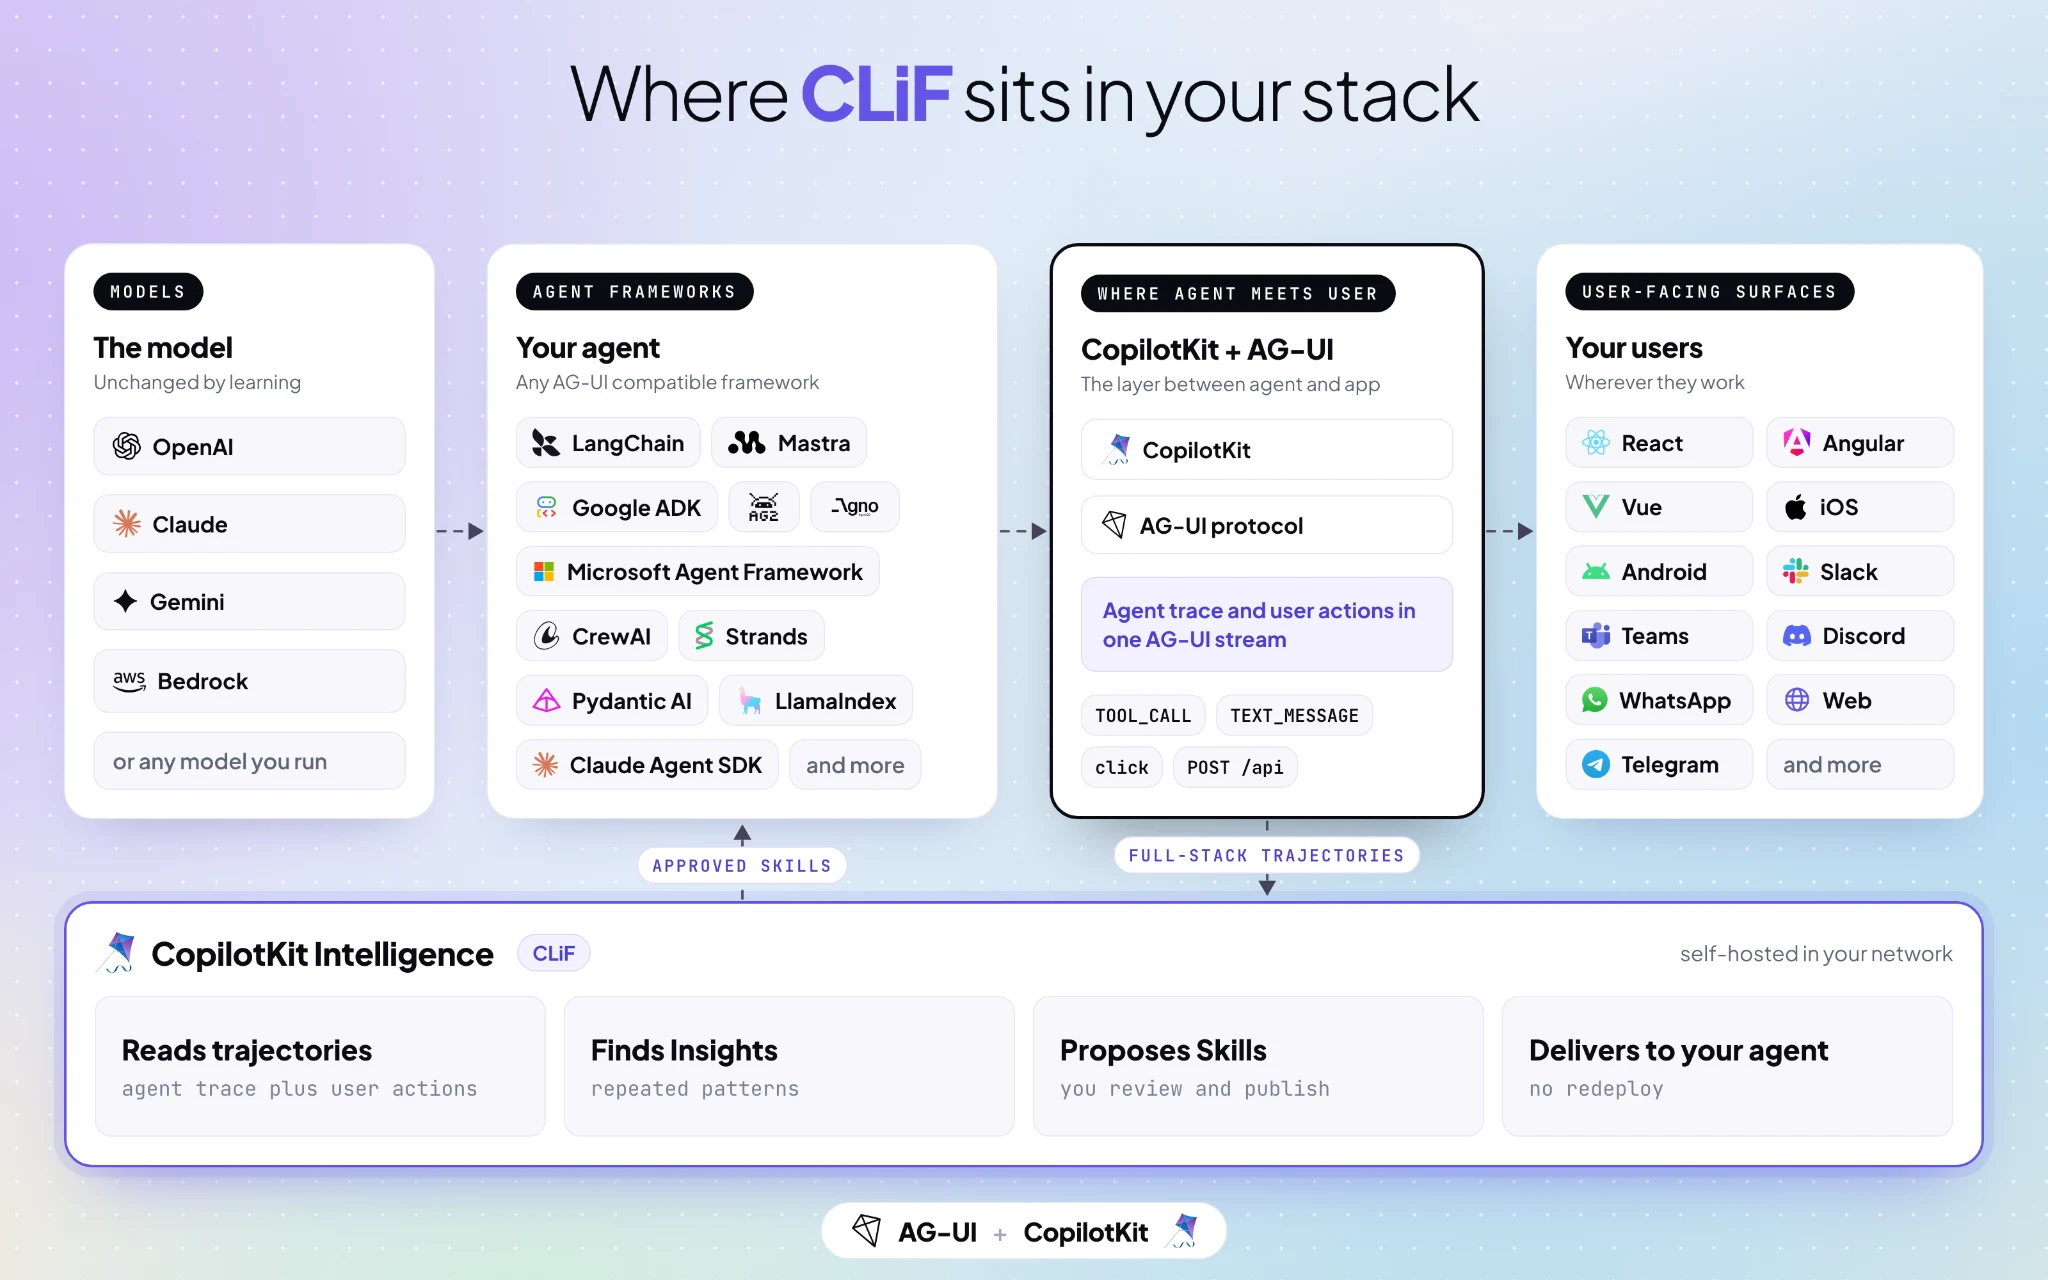
1. キャプチャ。 Trajectories は CopilotKit Intelligence にストリーミングされ、学習コンテナに割り当てられます。学習コンテナは、請求サポートやカスタマーオンボーディングなど、1種類の作業に学習範囲を限定します。ランタイムは getTrajectoryLearningContainerIds コールバックを通じて各セッションのコンテナを選択し、セッションは後から Intelligence UI でコンテナに出入りさせることができます。各コンテナは自分自身のセッションからのみ学習します。
2. パターンを発見する。 分析は、コンテナが設定された新しいセッションのしきい値を超えるとスケジュールに従って実行され、チームが手動でトリガーすることもできます。各実行はコンテナのセッションの固定スナップショットに基づいて行われ、Insights を明らかにします。それは、繰り返されるリクエスト、何度も行われる修正、そしてユーザーが黙って回避している摩擦点です。CopilotKit はこの摩擦点を最も強いシグナルと見なしています。それは何千ものセッションを横断して繰り返される傾向があり、エージェントが次に学ぶべきことを正確に示すからです。すべての Insight はその根拠となる具体的なイベントを引用し、ソースの Trajectory へ直接リンクしています。
3. レビュー。 証拠が再利用可能な教訓を裏付けている場合、CLiF はそれをスキルとして提案し、プレーンな SKILL.md ファイルとして記述されます。分析サービスが単独で何かを公開することはできません。人は各提案を、Intelligence UI または CopilotKit CLI を通じて承認または拒否します。公開されたスキルはバージョン管理され、いつでも廃止できます。
4. 配信とエクスポート。 公開されたスキルは再デプロイなしでエージェントに届き、安定性を必要とするチームはエージェントを固定のスキルリビジョンに固定できます。その他のエージェントや MCP サーバー向けには、copilotkit skills download <container> –output <dir> を使ってスキルをプレーンなファイルとしてダウンロードできます。Trajectory 自体は、Intelligence ダッシュボードから生のイベントデータとしてエクスポートできます。 早期アクセス チーム向けには、同じパイプラインがこれらの Trajectory から eval 候補とファインチューニングデータセットも生成します。
Agent Trajectories: CopilotKit Intelligence における自動学習
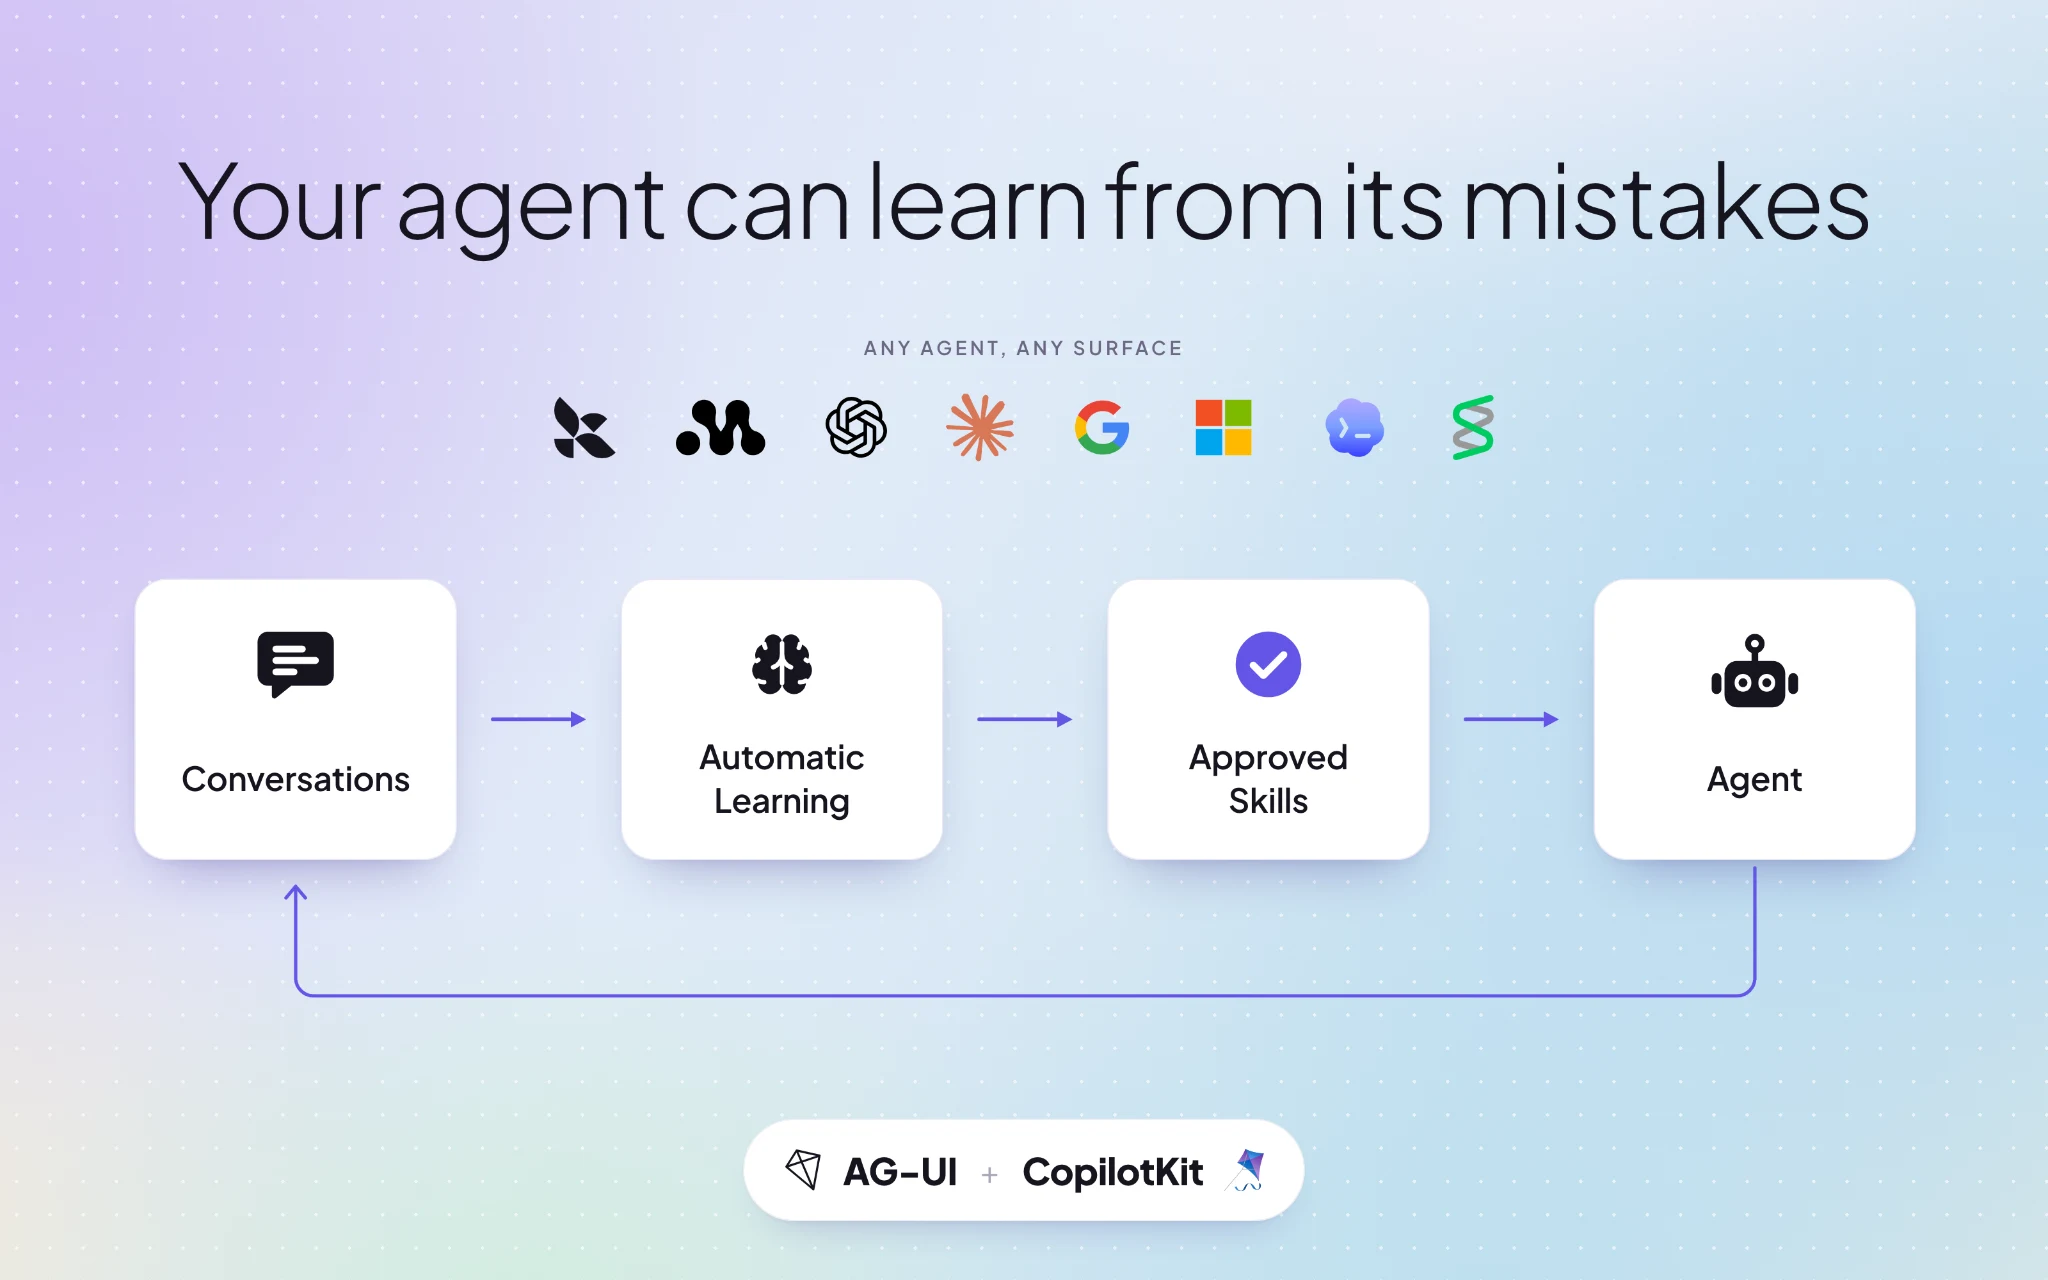
エージェント側で、CLiF は Automatic Learningの上に構築されています。これは CopilotKit Intelligence の機能で、CopilotKit はこれを 自己改善するエージェントの基盤としても位置付けています。Automatic Learning は、ユーザーがエージェントと行う会話から学習します。CLiF は同じループをプロダクトの Trajectory に拡張するため、チャットの外でユーザーがプロダクト内で直接行う作業からも学習します。
すべてのエージェントとの会話は、 AG-UI Streamsを通じて完全に保存されます。メッセージ、ツール呼び出し、ジェネレーティブ UI、状態、承認、ファイルです。開発者は、CopilotKit ランタイム上の getLearningContainerId コールバックからコンテナ ID を返すことで、どのスレッドを証拠とみなすかを選択できます。これは Trajectory コールバックのエージェント側の対応物です。すでに本番環境でエージェントを稼働させているチームは、ゼロから始める代わりに、LangGraph Server または LangSmith Deployment から既存の履歴をインポートできます。
Skill delivery は、LangGraph(Python および TypeScript)、Mastra、Google ADK、Microsoft Agent Framework、CopilotKit の組み込みエージェントなど向けのアダプターを通じて機能します。アダプターはカタログと 2 つのツール copilotkit_load_skill および copilotkit_read_skill_file を追加し、タスクが必要とするときにモデルがスキルをロードします。開発者の指示が優先されるため、スキルがエージェントの役割、安全性ルール、ツール制限を上書きすることはできません。
スキルを超えて: Evals、ファインチューニングデータ、生の Trajectory
スキルは最初の出力にすぎません。同じ Trajectory が合計 4 つの出力に供給され、すべてチームの既存のスタックにエクスポート可能です:
- Skills は、多くのセッションにわたって繰り返されるパターンから構築された、エージェントまたは MCP サーバー向けのものです。
- Production-based evalsは、ユーザーが実際に実行したタスクから構築され、誰も手で書こうと思わなかった入力やエッジケースを含みます。これらはチームが既に使用している eval プラットフォームにエクスポートできます。
- Fine-tuning datasets は実際のタスクの Trajectory から取り出され、企業の最も頻繁なワークフローにおいて、より小さく高速なオープンモデルを訓練することを意図しています。
- Raw full-stack trajectories は、任意のオブザーバビリティプラットフォームにエクスポートできるか、チームが望む任意の方法で利用できます。
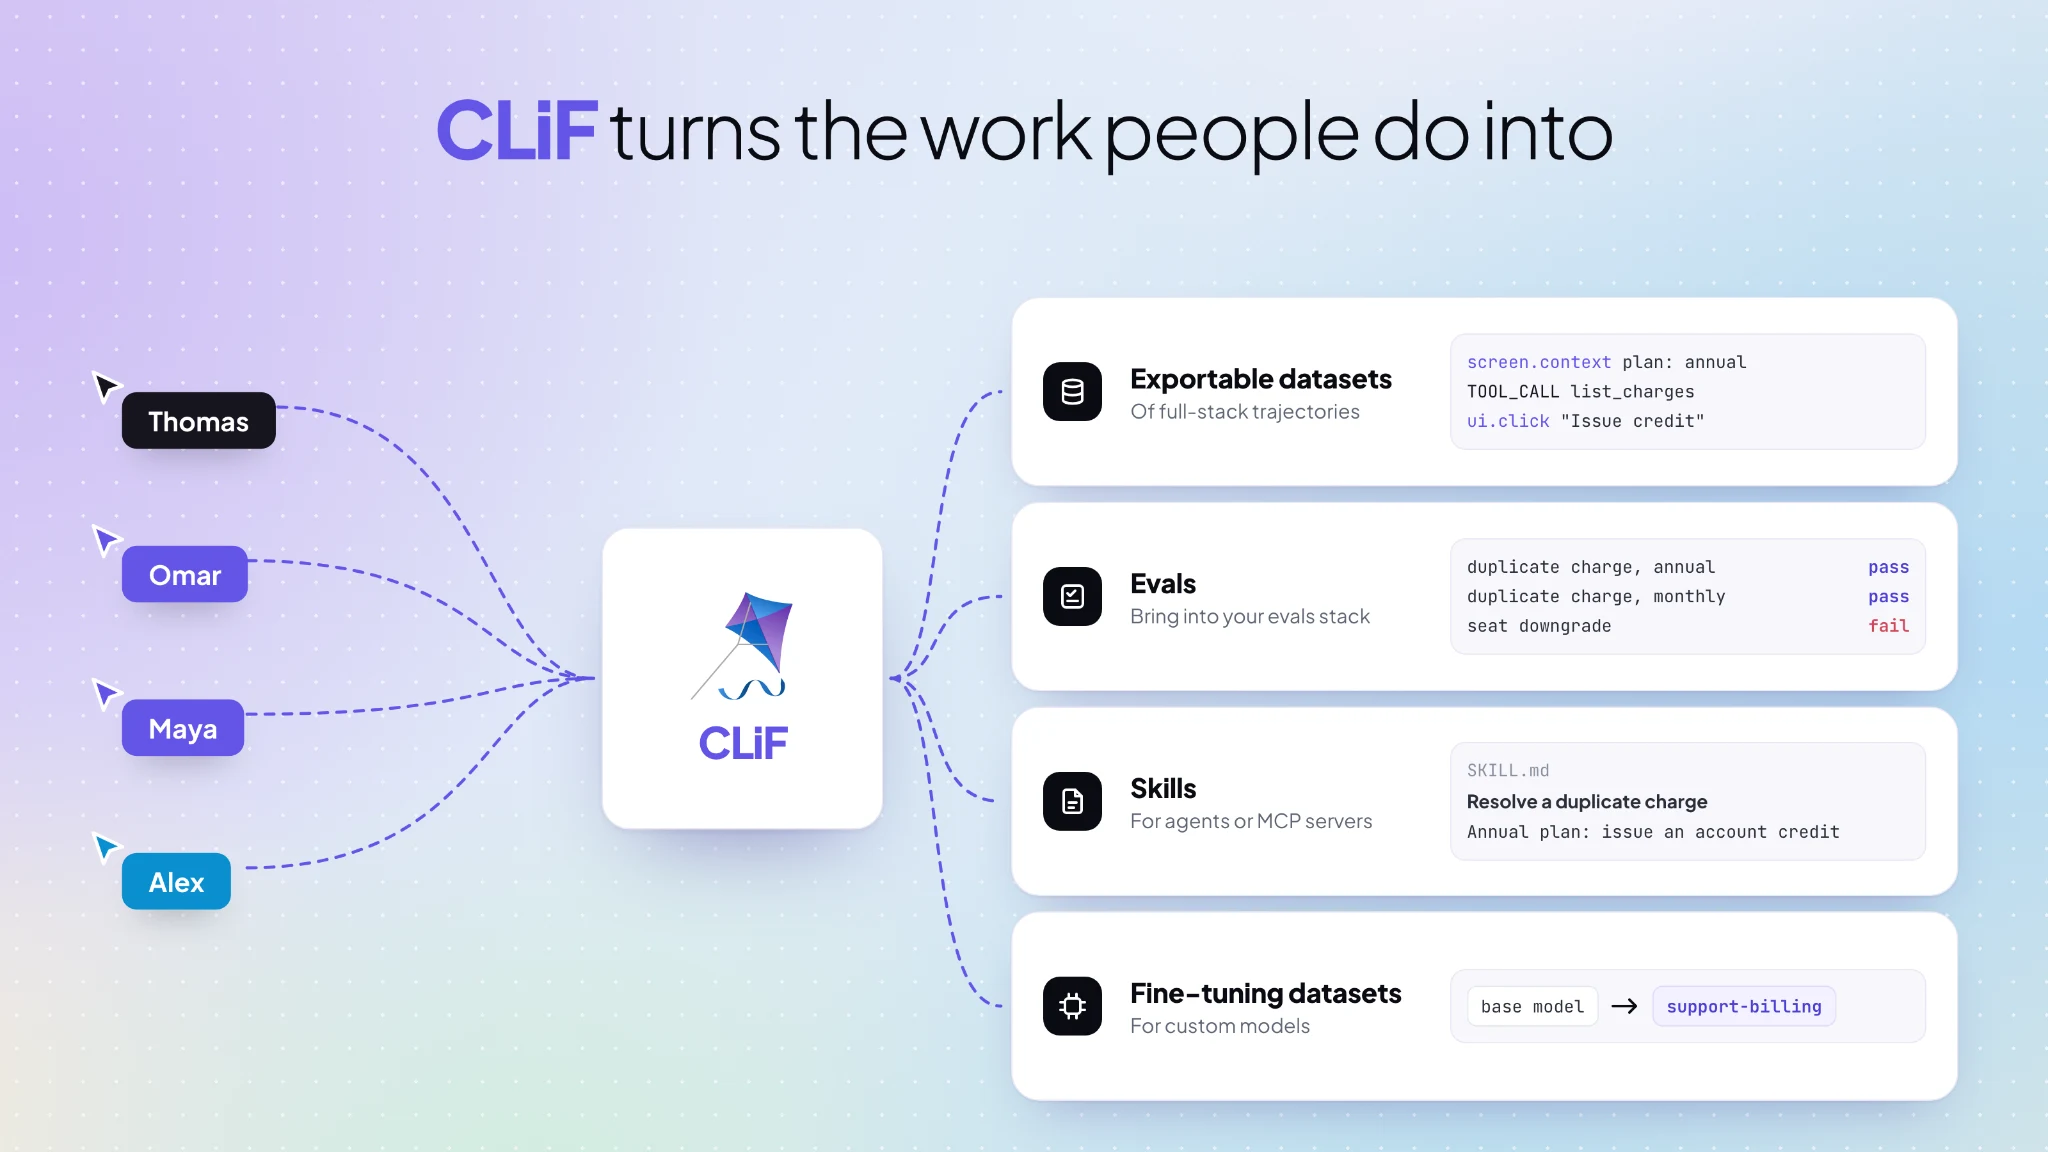
CopilotKit の見解では、チームは既に使用している eval ツールやオブザーバビリティツールを使い続けるべきであり、CLiF はそれらのツールに不足していたデータを提供します。
CLiFの実践例
Linearに似たプロジェクト管理プラットフォームのCTOだとします。そこではエンジニアリングチームがスプリントを計画し、イシューを追跡しています。あなたは、自社の組み込みエージェントだけでなく、顧客がMCPサーバー経由で接続するClaudeのような外部エージェントにも、プロダクト内の定型的な作業を確実に任せたいと考えています。リストの最初のタスクの一つがスプリントのクローズ処理です。
あなたのプラットフォームには、未完了のイシューをすべて次のスプリントに移動するワンクリック機能がすでにあり、ドキュメントでもクローズ処理はまさにそのように説明されています。そのため、スプリントのクローズを依頼されたエージェントはその通りに実行し、未完了のイシーをすべて先に進めてしまいます。
CLiFがプロダクトの操作軌跡を安全に記録するようになると、数千件のクローズ処理のデータから、あなたのプラットフォーム上のチームリードはそれ以上のことをしていることが分かります。ほとんどのリードはワンクリック機能を使った後、数分かけて結果を修正しています。
- すでに一度繰り越されたイシューをバックログに戻し、担当者の割り当てを解除します。
- ブロックされているイシューにコメントを付け、そのブロックの担当者にメンションします。
あなたのチームの誰もこのルーティンを設計しておらず、尋ねられてもそれを説明できるユーザーはほとんどいません。それはワンクリック操作の後に続くクリックとリクエストの中にのみ存在します。エージェントのトレースはそれを目にすることはありません。ユーザー自身がそれを行うからです。プロダクト分析はその意味なしに余分なクリックを記録するだけで、セッションリプレイでパターンを見つけるには何千もの録画を見ることになります。
CLiFはそのルーティンをインサイトとして浮かび上がらせ、その背後にある正確なセッションを引用し、完全なクローズ処理のためのスキルを提案します。チームがレビューして公開した後は、組み込みエージェントが再デプロイなしでそれを取り込み、MCPサーバーと共に同じスキルを出荷すれば、Claudeやその他の接続されたエージェントもそれに従います。ユーザーの習慣が変化しても、新しいセッションがスキルを最新に保ち、インサイトは自社の機能がどこで不十分かも示してくれます。
同じセッションは、エージェントが各課題をプラットフォーム上のチームリーダーと同じように処理できるかを検証する評価ケースにもなります。これにより、タスクを任せる前にエージェントの準備が整っているかを確認できます。また、後で計画作業向けに小さなモデルをファインチューニングする場合には、トレーニングデータにもなります。
2026年にエージェントチームの足を引っ張る課題にCLiFがどう取り組むか
大規模にエージェントを運用する技術リーダーに向けて、CopilotKitはCLiFを、よく知られた一連の問題への回答として位置づけています。
- エージェントを評価に合格させること: ほとんどのチームにとって、エージェントの出荷で最も時間がかかるのは、重要なワークフローで十分な評価に合格させることです。ユーザーがそれらのワークフローを完了する様子から学習したスキルは、エージェントに不足していた手順を与えます。そして本番ベースの評価が、実践でユーザーが遭遇するエッジケースを追加するため、スイートは実際の使用とともに成長し続けます。
- コンテキストの肥大化とツールの過剰: エージェントのミスがあるたびに、システムプロンプトにルールが1つ増えたり、エージェントにツールが1つ追加されたりしがちです。時間が経つとコンテキストが満杯になり、挙動の予測が難しくなります。CLiFは学習された挙動を代わりにスキルカタログに保持し、モデルはタスクが必要とするときにのみスキルを読み込みます。
- コスト: エージェントはツールや長いプロンプトが増えるにつれて高コストになりがちです。実際の軌跡から作られたファインチューニングデータセットは、高頻度のワークフローをより小さく安価なオープンモデルに移行する道をチームに提供し、ワークフローごとのコンテナはエージェントがどこで苦戦し、どこでしないかを示します。
- 分断されたスタック: 大規模な組織が1つのエージェントフレームワークに落ち着くことはまれで、そのエージェントはWebアプリ、モバイルアプリ、Slack、Teamsに存在します。CLiFはAG-UI上で動作するため、あらゆるエージェントハーネスと、その下のあらゆるモデルで機能します。AG-UIはGoogle、Microsoft、Anthropic、Amazon、Oracleに加え、LangChain、Mastra、Pydantic AI、Google ADKなどのフレームワークでサポートされています。
- 中央の監視を外れたエージェントの採用: チームが独自にエージェントツールを採用するにつれ、各エージェントが何を学習したのか、なぜそうしたのかを把握するのが難しくなります。すべてのCLiFスキルは人間によるレビューを経て、その由来となったセッションまで遡ることができ、バージョン管理され、元に戻すことも可能です。プラットフォーム全体を企業の自社インフラ内で実行することもできます。
設計からセルフホスト可能
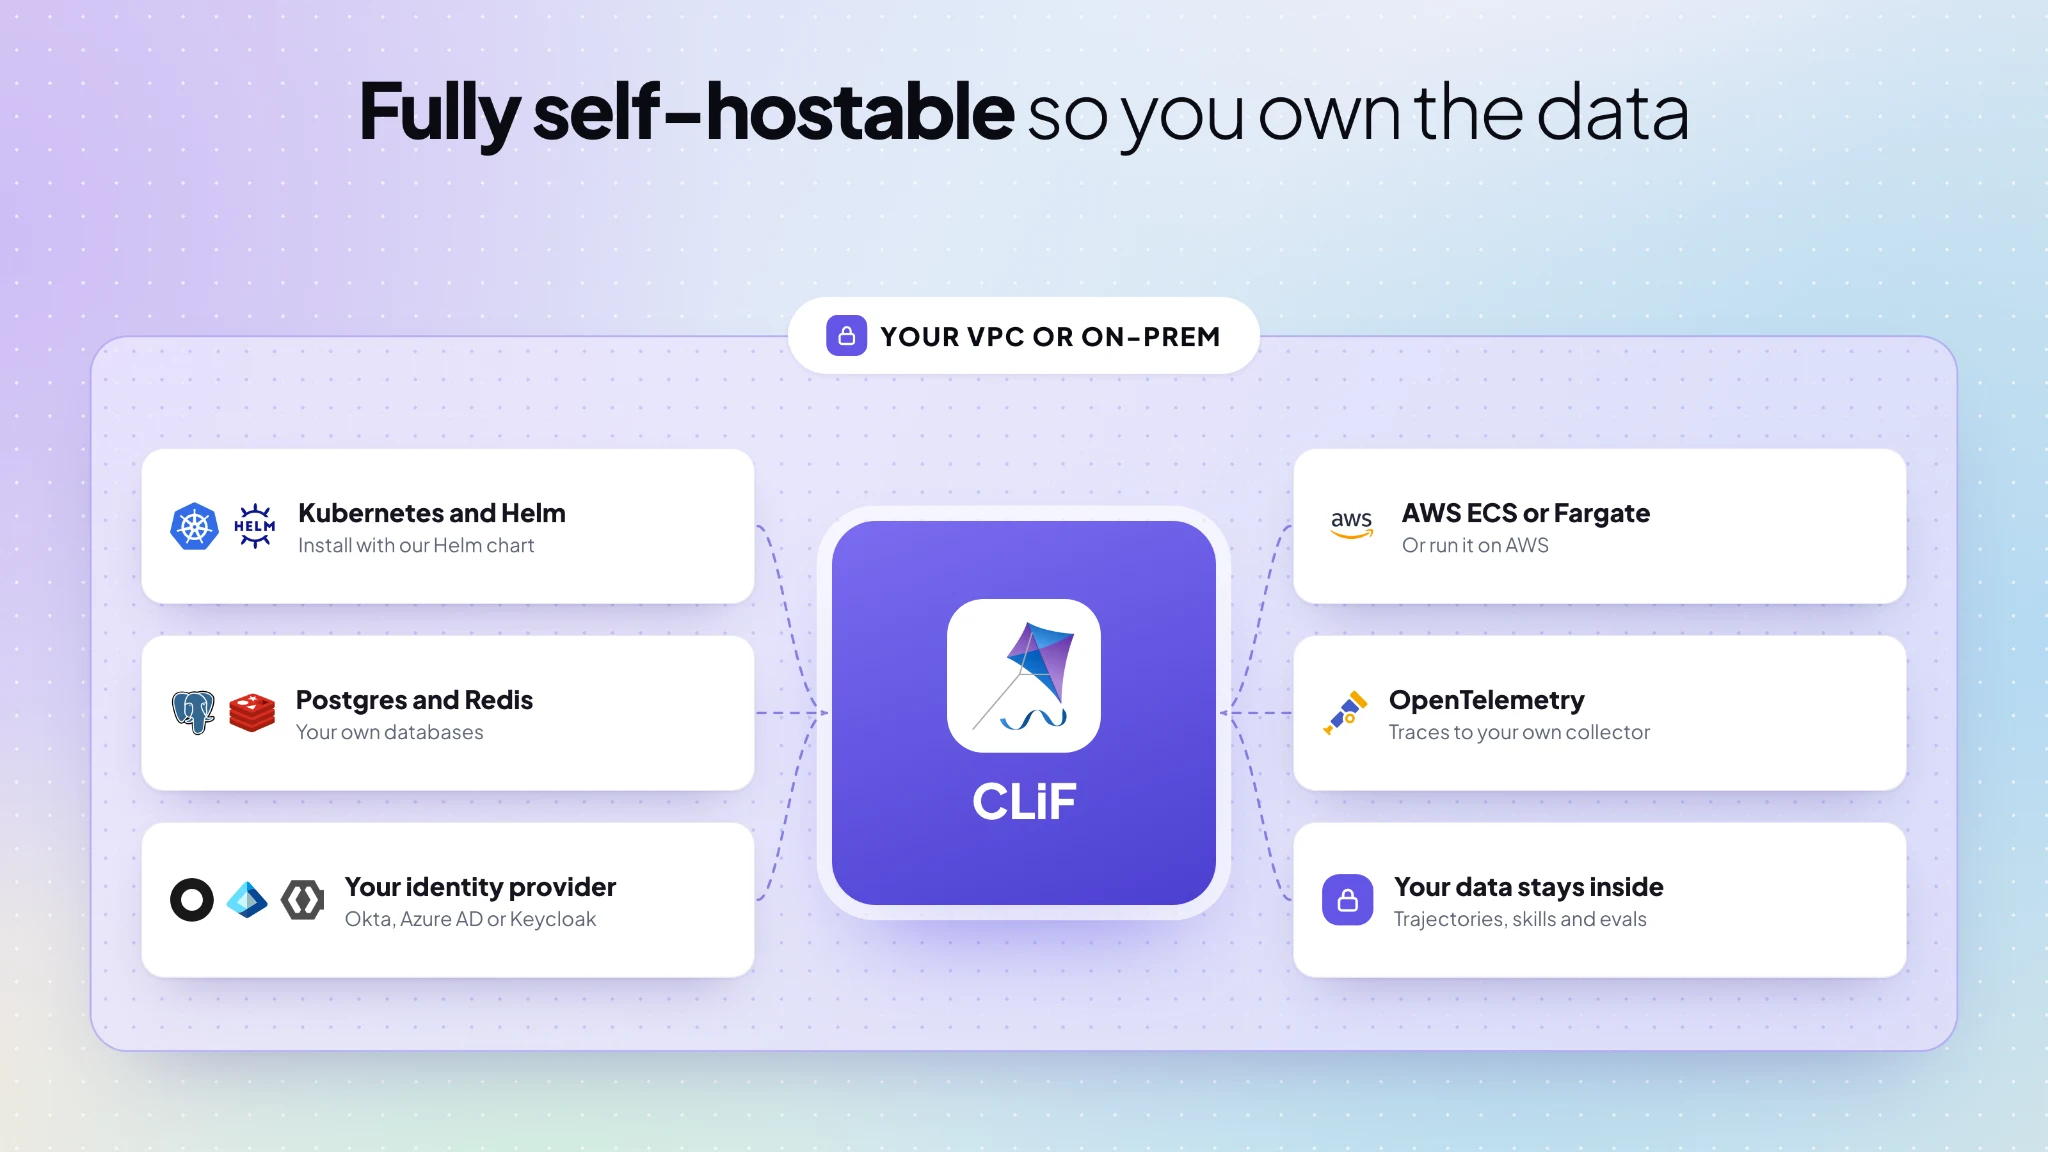
CLiFは完全にセルフホスト可能です。CopilotKit Intelligenceは セルフホスト で、Helmチャートを使って企業の自社Kubernetesクラスタ上、またはAWS ECSとFargate上で、チーム独自のPostgres、Redis、Okta、Azure AD、Keycloakなどのアイデンティティプロバイダと共に実行できます。
軌跡、スキル、そしてそこから学習されたすべてのものは、企業のVPC内またはオンプレミス環境に留まるため、ユーザーのアクティビティやエージェントのトレースがそのネットワーク外に出る必要はありません。トレースを既存のOpenTelemetryコレクタに流すこともできます。CopilotKit Intelligenceは、最速のセットアップを望むチーム向けに マネージドクラウド でも実行できます。
重要なポイント
- CopilotKitはCLiFをリリースしました。フルスタックの軌跡からの継続的学習のためのプラットフォームで、CopilotKit Intelligenceの一部として 早期アクセス が可能です。
- ユーザーがすでにその作業を行っている方法こそが、エージェントに欠けているシグナルです。 フルスタックの軌跡は、エージェントのトレースとともに、AG-UI上の一つのタイムラインでそれを記録します。
- CLiFはそれらの軌跡を4つの成果物に変換します: 本番ベースの評価、より小さなオープンモデル向けのファインチューニングデータセット、エージェントやMCPサーバー向けのスキル、そしてエクスポート用の生の軌跡で、すべて既存の評価およびオブザーバビリティスタックと互換性があります。
- すべてのスキルは人間によるレビューを受ける、それぞれが元のセッションまで遡って追跡できます。公開されたスキルは再デプロイなしでエージェントに届き、Claude などの外部エージェント向けに MCP サーバーと共に提供することもできます。
- 大規模にエージェントを運用する際の核心的な課題を対象としています:評価(eval)の合格、コンテキストの肥大化、コスト、分断されたスタック、そして各エージェントが学習した内容の監視です。
- CLiF は AG-UI を通じて、あらゆるエージェントフレームワークおよびあらゆるモデルで動作し 、完全にセルフホスト可能です。
チームは詳細の確認、デモの予約、または早期アクセスのリクエストを CLiF ページ.
参考資料
- CLiF 製品ページ
- CLiFのご紹介:フルスタックの軌跡から学ぶAIエージェント向け継続学習プラットフォーム (CopilotKit ブログ)
- エージェント学習とは何か? (CopilotKit)
- CLiF ローンチ動画
- CopilotKit Intelligence
- 自動ラーニング ドキュメント
- スキル配信ドキュメント
本記事の思想的リーダーシップとリソースを提供してくださったCopilotkitチームに感謝します。本記事はCopilokitの提供です。
この投稿 CopilotKitがCLiFをリリース:エージェントのトレースとユーザーアクションをスキル、評価、ファインチューニングデータに変換する継続学習プラットフォーム は最初に MarkTechPost.