IT之家 10 月 15 日付の報道によると、NVIDIA は、継続的に稼働しマルチステップのタスクを実行する AI エージェント向けのオープンなマルチモーダルモデル Nemotron 3.5 Super VL を発表した。
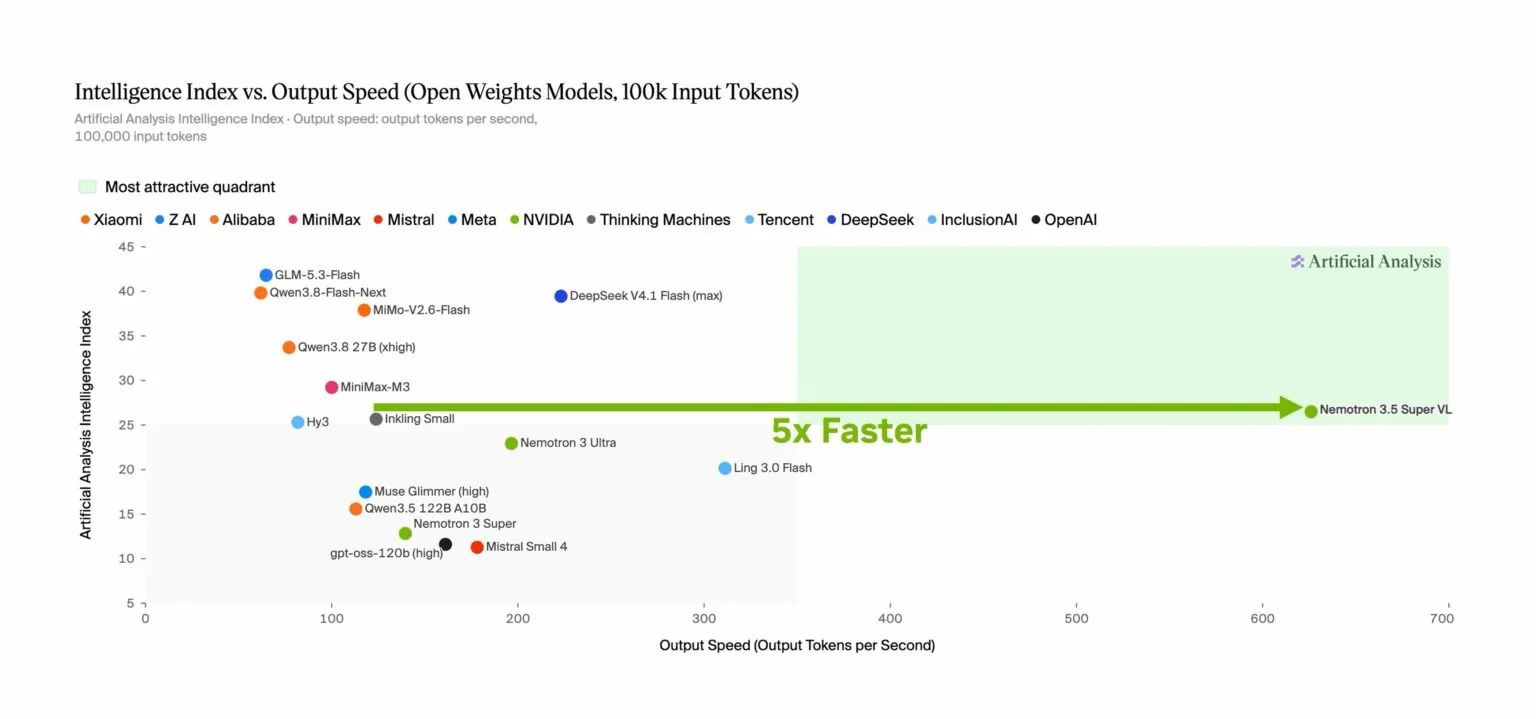
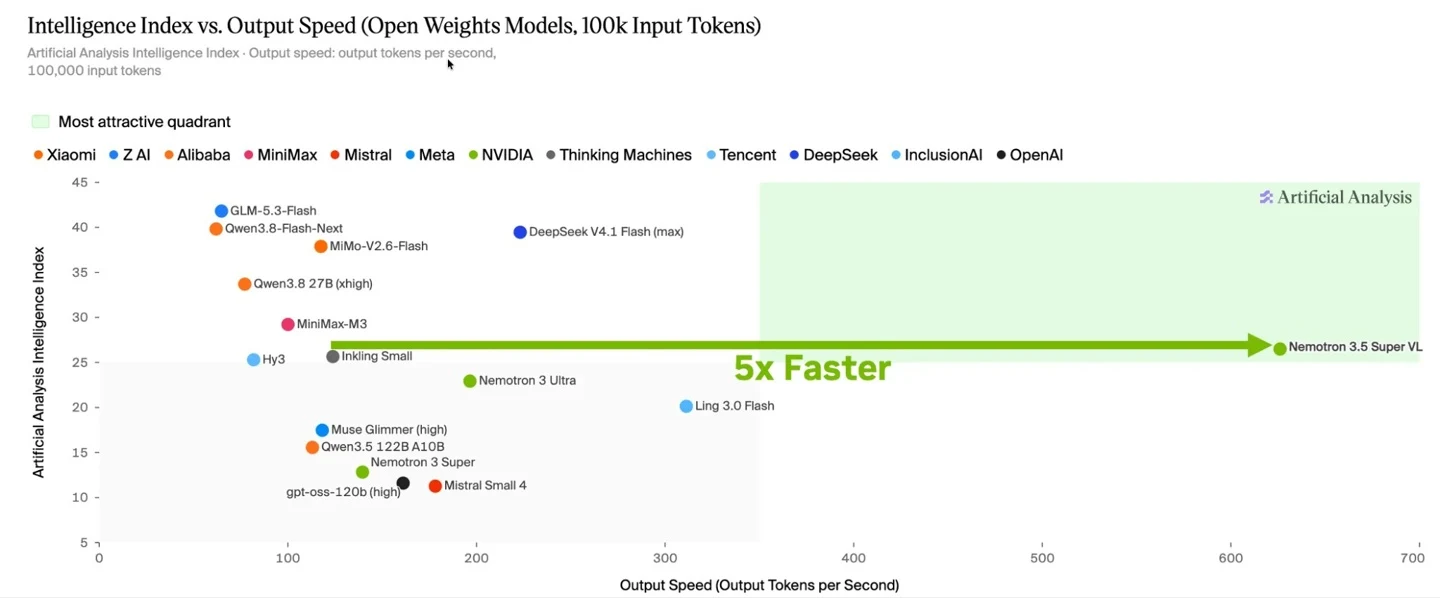
このモデルは混合エキスパート(MoE)アーキテクチャを採用し、総パラメータ数は 1200 億、アクティブパラメータは 120 億である。NVIDIA によると、単一の GPU 上でエージェントタスクを実行する際、このモデルのスループットは同規模の他のオープンモデルの最大 5 倍に達するという。
紹介によると、Nemotron 3.5 Super VL は、推論、指示追従、ツール呼び出しの能力と、テキスト、画像、ドキュメント、動画の理解能力を 1 つのモデルに統合しており、コードのテストとデバッグ、複数ウェブサイト横断の情報検索、ドキュメント分析、サイバーセキュリティ脅威の識別、動画コンテンツの検索などのシーンに活用できる。開発者は NVIDIA の NeMo ツールチェーンを利用し、自社のデータ、ツール、ポリシー、ワークフローと組み合わせてポストトレーニングを行い、ビジネスニーズに応じてモデルの挙動を調整できる。
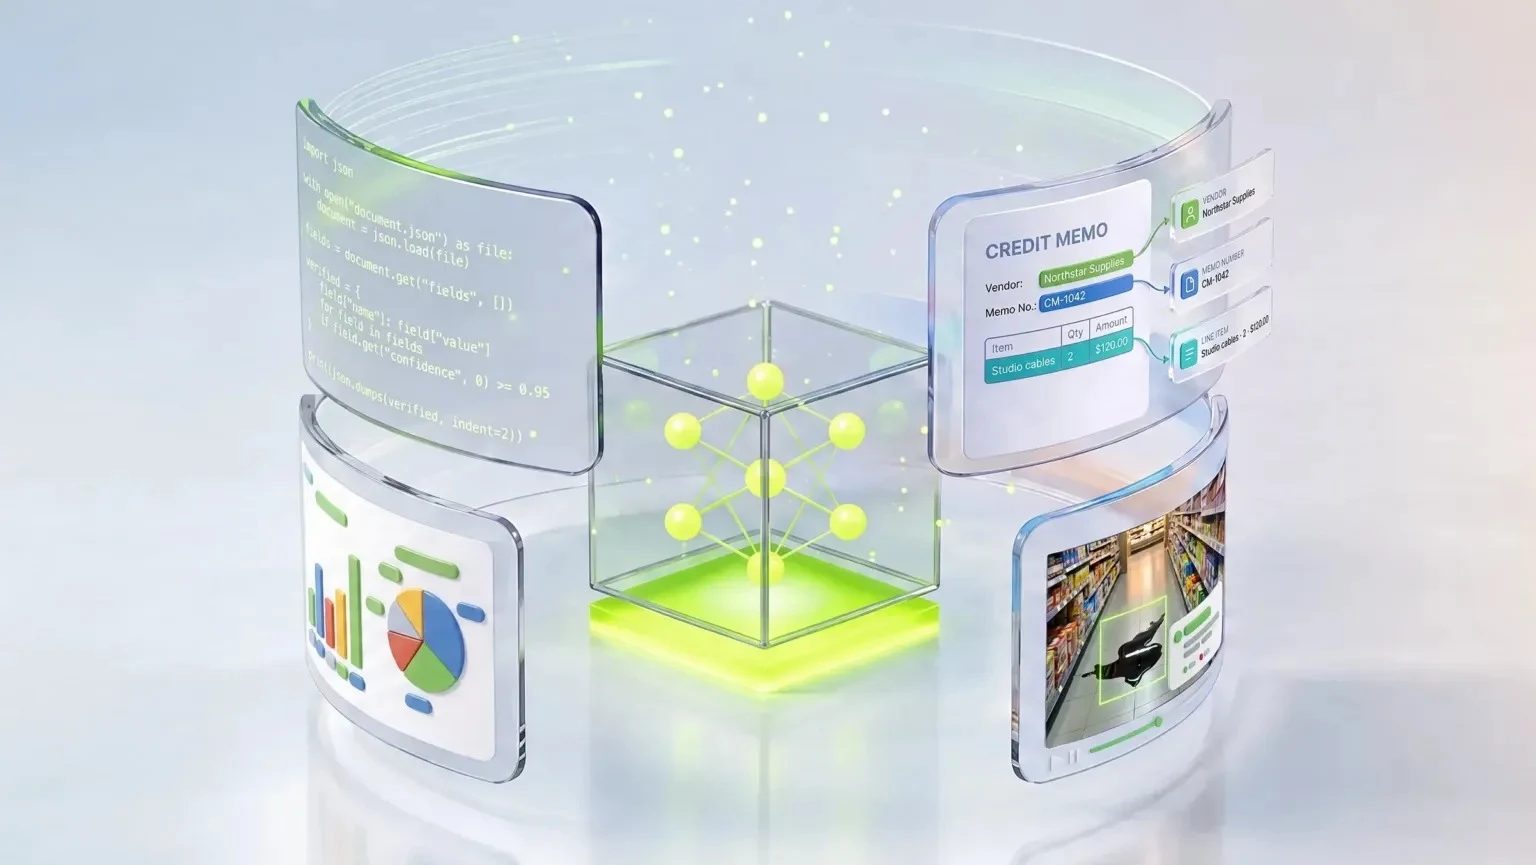
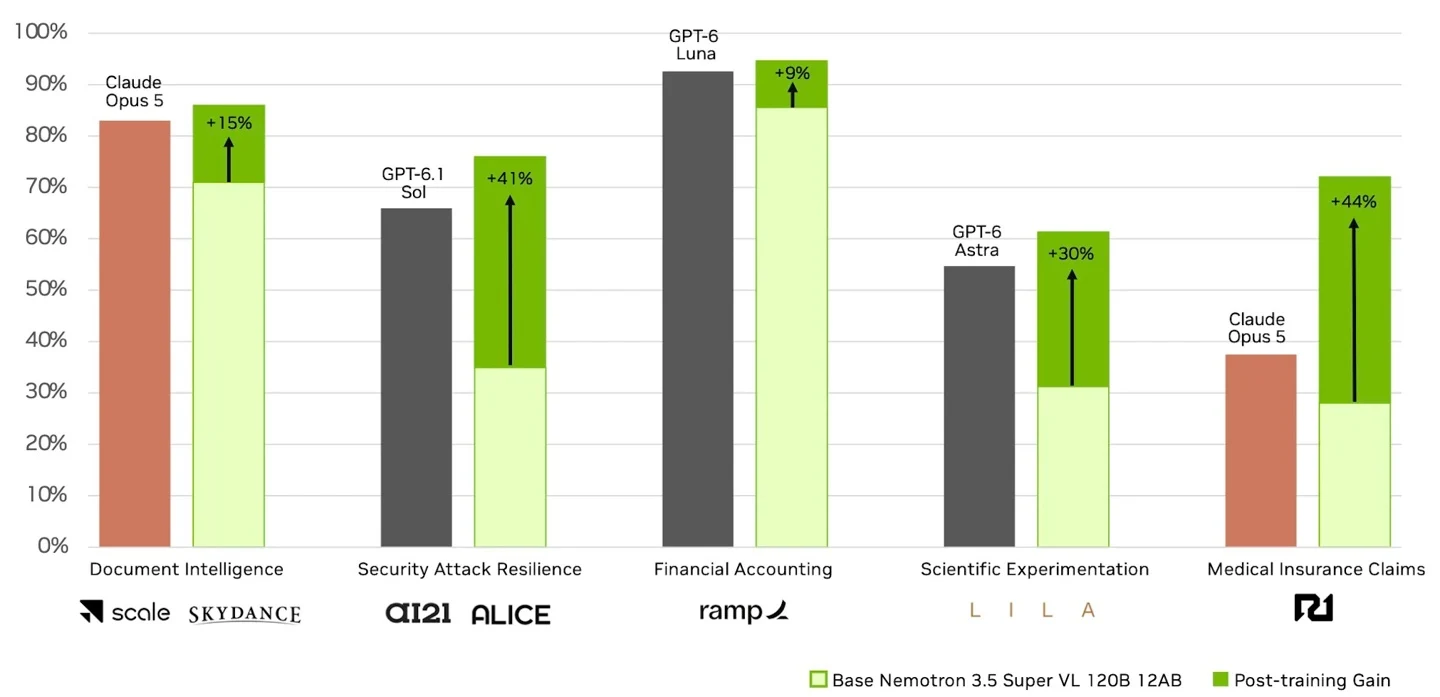
NVIDIA は同時に複数の企業向けカスタマイズ事例を公開した。例えば、AI データ技術プロバイダーの Scale AI はメディア・エンターテインメント企業の Skydance Corporation 向けにベンダークレジット処理エージェントをカスタマイズしており、関連ワークロードの推論コストは 97.5% 削減、レイテンシは 80% 削減できると見込まれる。
金融運営プラットフォームの Ramp はレシート画像を、店舗名、日付、支払い情報を含む構造化 JSON データに変換しており、スループットは最大 50% 向上、レイテンシは 90% 削減すると見込まれる。AI21 は AI セキュリティ企業の Alice と協力してモデルをカスタマイズし、脅威インテリジェンスと脆弱性分析に用いており、関連タスクの精度は 40% 向上した。
モデル評価では、NVIDIA は Nemotron 3.5 Super VL が CharXiv のチャート推論ベンチマークで 80.8% のスコアを獲得し、Nemotron 3 Nano Omni の 63% を上回ったとしている。Python コードインタプリタと組み合わせると、スコアは 84% に達する。
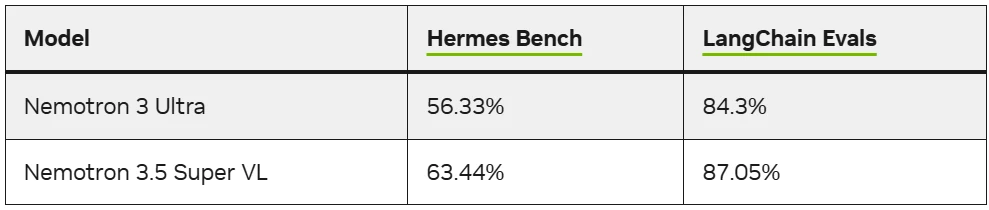
Hermes Bench と LangChain の挙動評価では、このモデルはそれぞれ 63.44% と 87.05% を獲得し、Nemotron 3 Ultra の 56.33% と 84.3% を上回った。NVIDIA はさらに、このモデルが OCRBench v2 ランキングで上位のオープンモデルの一つであると述べている。
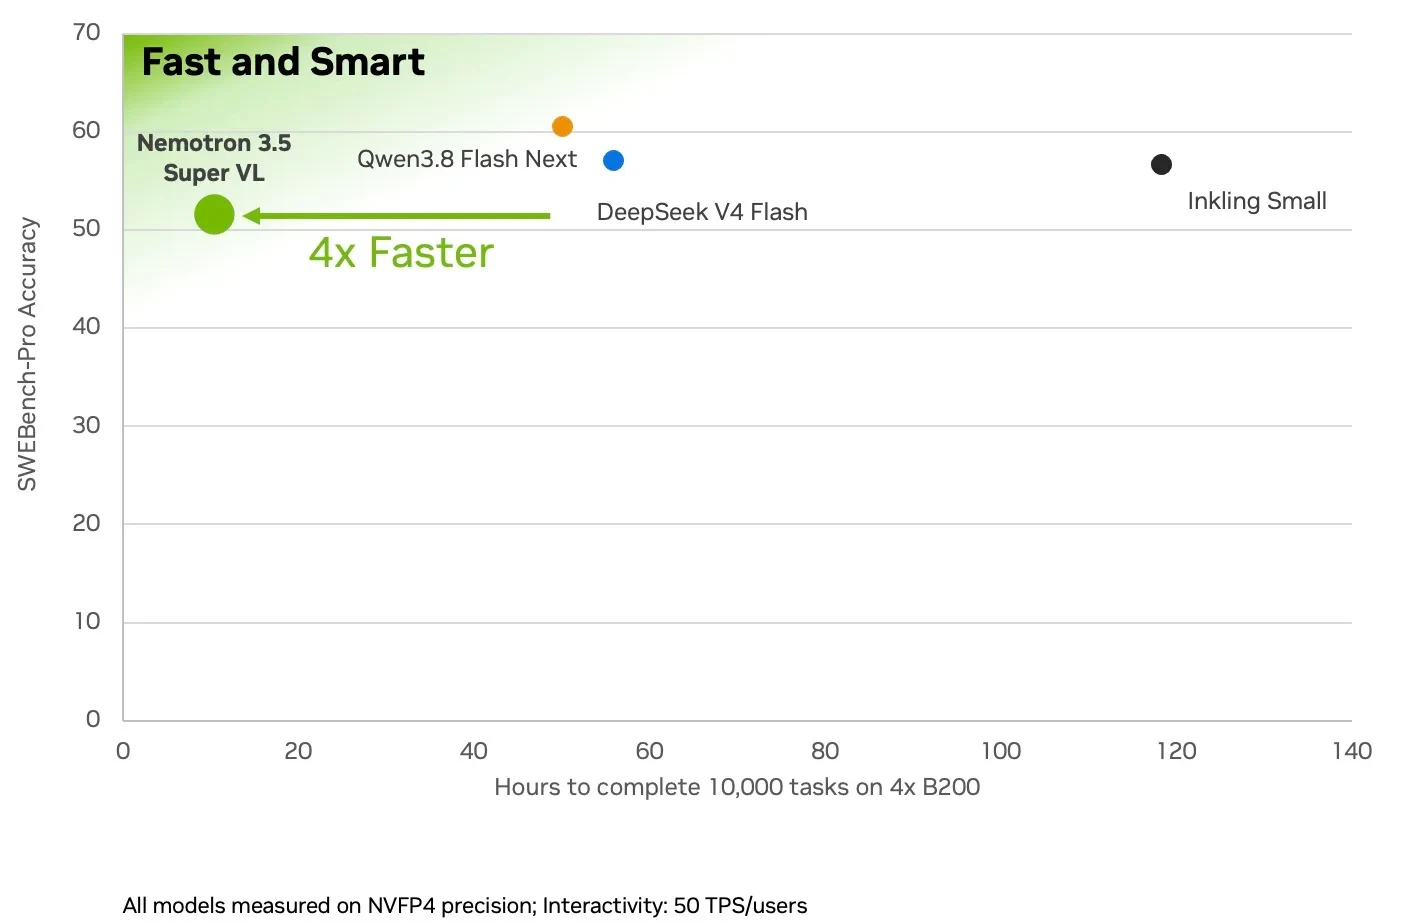
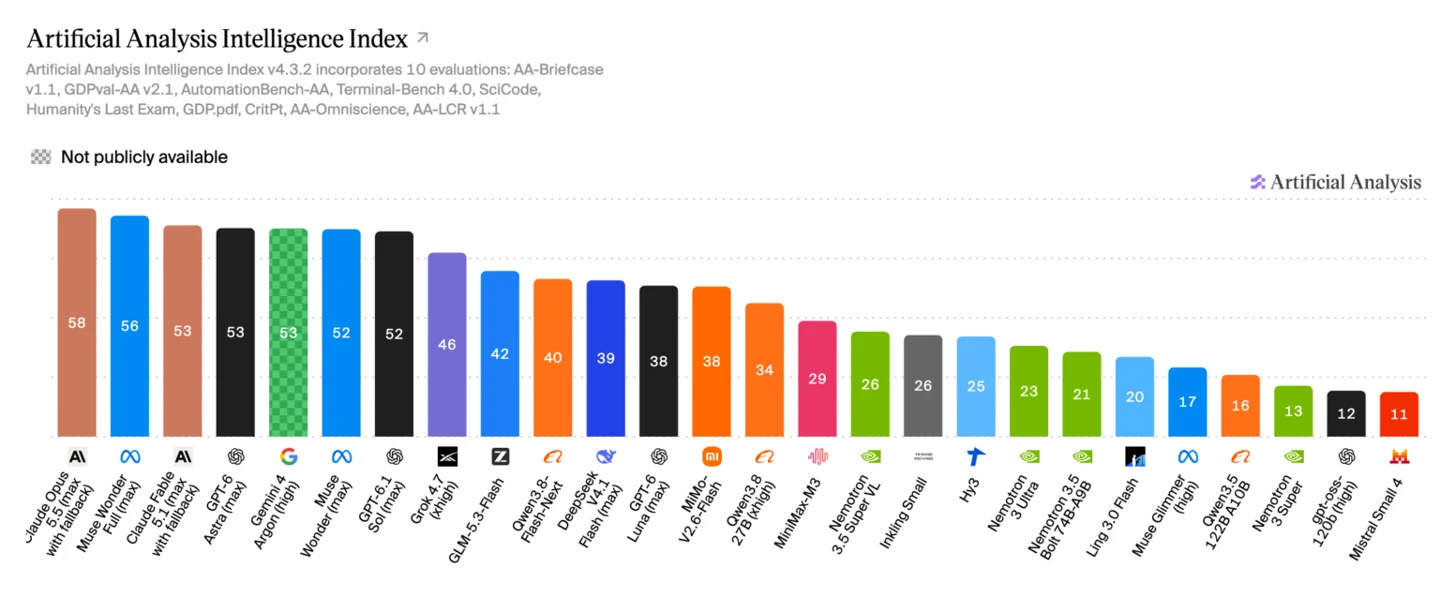
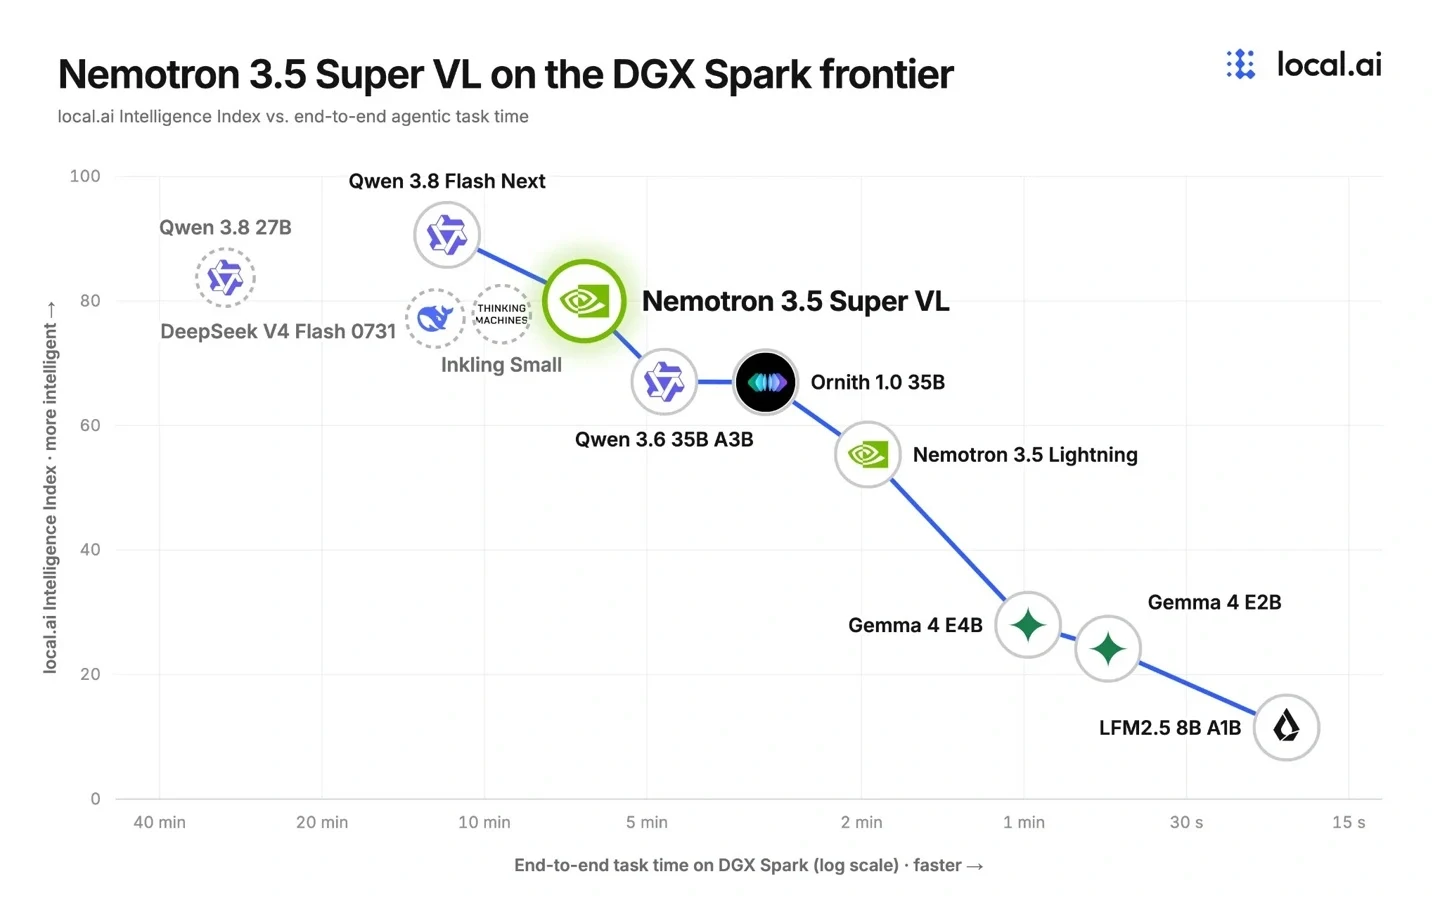
推論オーバーヘッドを削減するため、Nemotron 3.5 Super VL は投機的デコード、混合精度、コンテキスト再利用などの技術を採用している。NVIDIA によると、同社の LiLiCorr 投機的デコード手法は、DGX Spark 上でトークン生成速度を最大 2.3 倍に向上させることができる。モデルはさらに NVFP4 量子化をサポートし、NVIDIA の Blackwell アーキテクチャ上では 4 ビットの重みと 4 ビットのアクティベーションを使用する。Blackwell 以外のプラットフォームでは、同じチェックポイントで 4 ビットの重みと 16 ビットのアクティベーションを使用する。
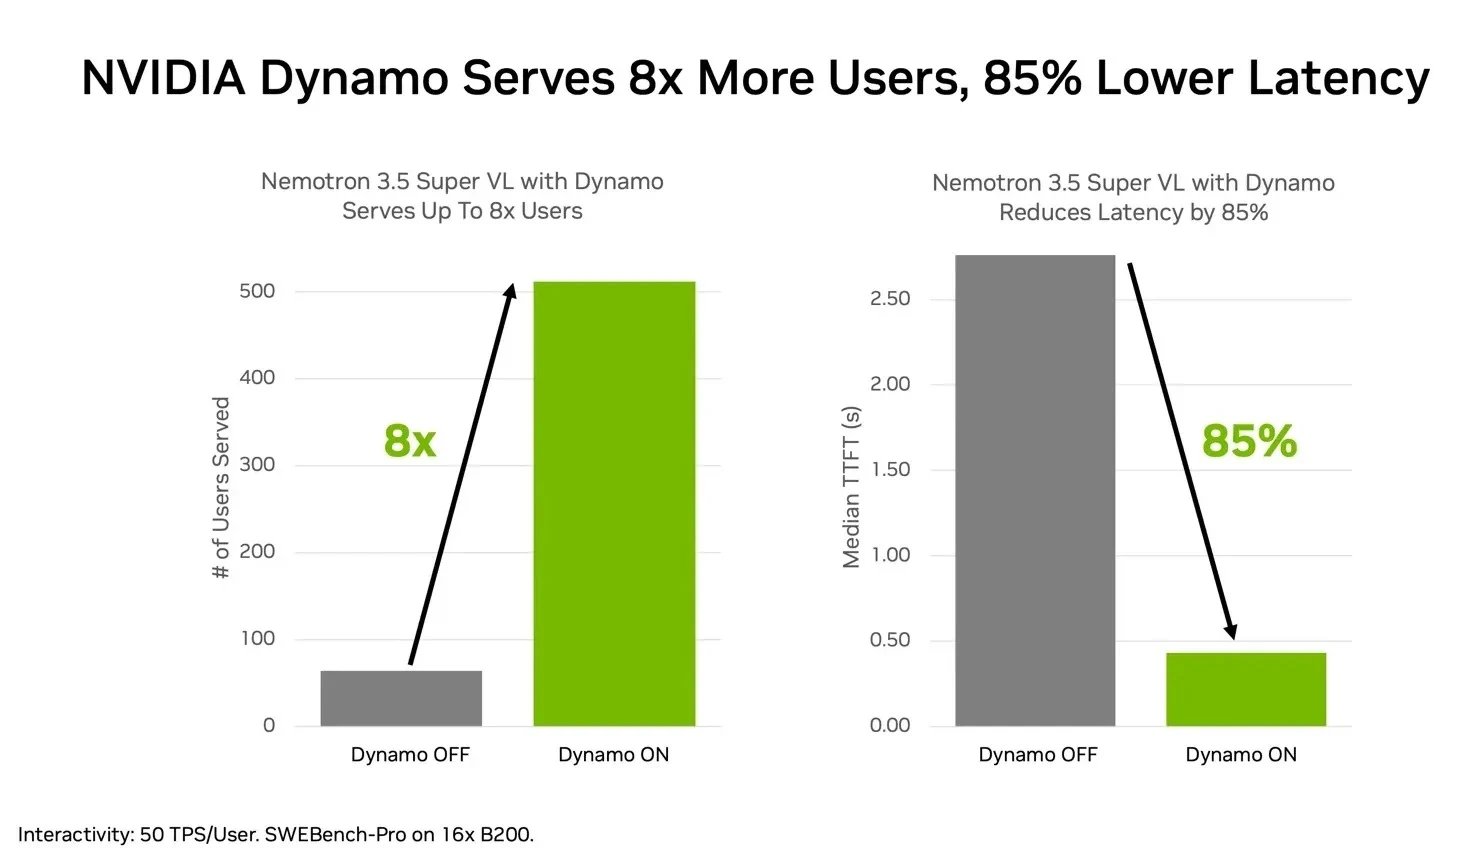
NVIDIA はさらに、分散推論向けのデプロイ最適化ソリューションも発表した。同社が公開したデータによると、16 枚の NVIDIA B200 GPU を使用し、ユーザー 1 人あたり毎秒 50 トークンを生成するというテスト条件下で、NVIDIA Dynamo がキャッシュ対応ルーティング、セッションアフィニティ、KV キャッシュのオフロードと組み合わさることで、最大 8 倍のユーザーにサービスを提供でき、初回トークンのレイテンシを 85% 削減できるという。
今回のリリースには、ベースモデル、ポストトレーニングモデルおよび NVFP4 量子化モデルの重みに加え、トレーニングレシピ、データセット、強化学習環境も含まれている。
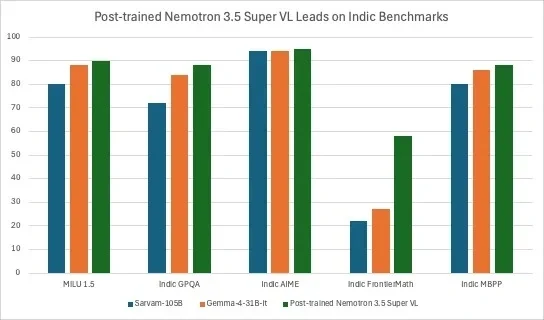
NVIDIA によると、Nemotron 3.5 Super VL は事前学習と継続事前学習の段階で合計約 26 兆トークンを使用し、ポストトレーニング段階では約 380 万個のサンプルを使用し、数十種類の環境で強化学習を行った。新たに公開されたデータセットは、エージェントのツール呼び出し、金融推論、指示追従、長文コンテキスト、公平性、視覚言語理解などの分野をカバーしている。
Super VL に加え、NVIDIA は 2 つの Nemotron 3.5 Bolt エッジ向けモデルも発表した。Nemotron 3.5 Bolt 74B-A9B 24GB は、総パラメータ 740 億、アクティブパラメータ 90 億の MoE アーキテクチャを採用し、ネイティブの 2 ビット量子化によりモデルを 24GB に圧縮しており、ローカルのエージェントタスク向けで、llama.cpp、vLLM、Ollama、Unsloth、LM Studio に対応している。Nemotron 3.5 Bolt E4B 4GB は、ローカル音声アシスタント、インタラクティブキャラクター、組み込みインターフェースなどのシーン向けで、10 月 23 日に発表される予定である。
IT之家が注目したところでは、Nemotron 3.5 Super VL と Bolt 74B-A9B 24GB はすでに公開されており、開発者は Hugging Face、OpenRouter、ModelScope などのチャネルを通じて関連モデルリソースを利用できる。Super VL は DGX Spark、DGX Station、RTX システム、データセンターまたはクラウドにデプロイ可能である。Bolt E4B 4GB は 10 月 23 日にリリースされる予定である。