

Google、Gemini 4 Argonをロボットに必要な唯一のAIモデルにしたい考え
 ジョナサン・ケンパー
Jonathan KemperさんのLinkedInプロフィールを見る
2026年10月15日
 Google DeepMind
重要ポイント
- Gemini 4 Argonは、ロボットを制御し、インタラクティブな3Dトレーニング環境を生成し、トレーニングデータを評価する、単一のAIモデルというGoogleの試みです。
- 写真やスケッチのようなシンプルな入力から、このシステムはロボットが実際に展開される前に動作を練習できるシミュレーションを構築します。
- デモはまだ詳細な人間によるプロンプトとガイダンスを必要とします。ArgonはGoogleの有料開発者アクセスプログラムを通じて利用可能です。
GoogleはGemini 4 Argonにより、ロボティクスのパイプライン全体を1つのモデルで賄うことを提案している。このモデルはロボットを制御し、バーチャルな練習用ワールドを構築し、訓練用動画を採点する。しかし、公開されたサンプルプロンプトは、このモデルがいまだにどれほど人間の細かな補助を必要としているかを浮き彫りにしている。
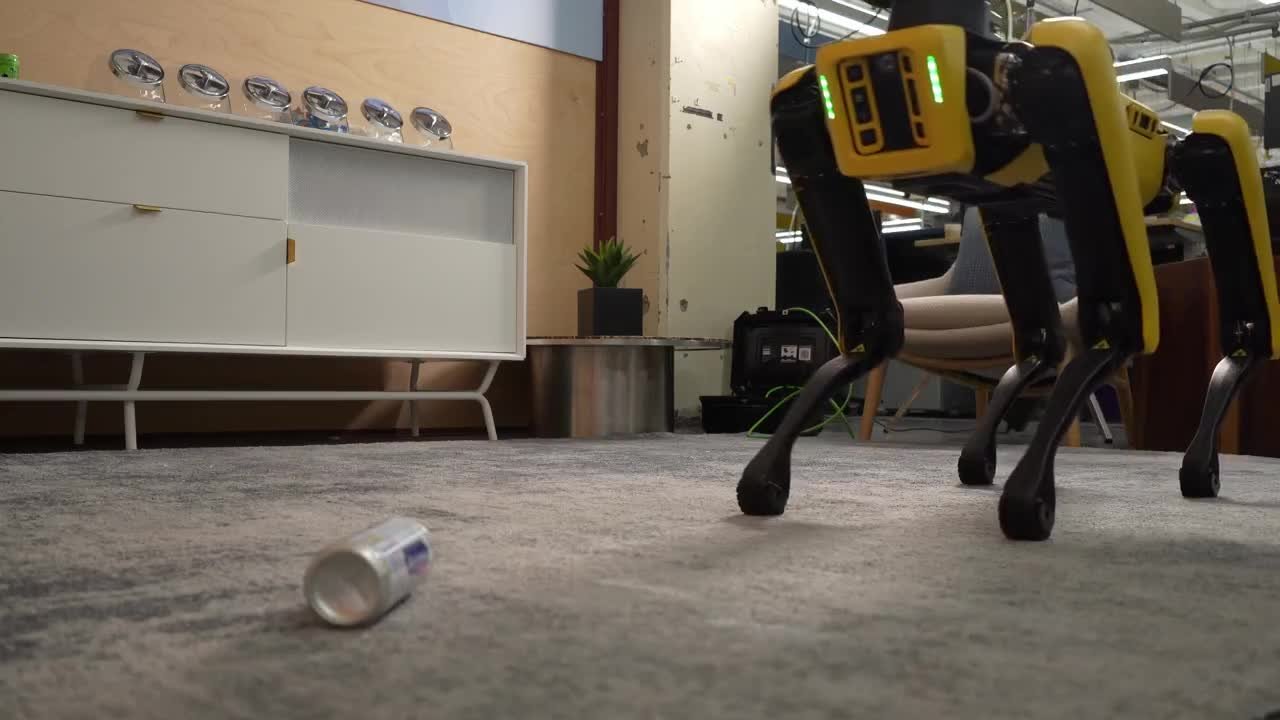
ボストン・ダイナミクスのSpotロボットは、ソーダの缶を踏み式ゴミ箱に投げ入れることになっている。実際のペダルに触れる前に、Gemini 4 Argonがゴミ箱の仮想コピーを作成し、ロボットはそのシミュレーション内で3本脚でのバランス取りを練習する。その後になって初めて、実機でこのタスクに挑む。缶を落とす前に、2つの追加のAIエージェントが脚とグリッパーの位置が正しいかを確認する。
Googleがその能力を実演する方法がこれです。 ロボティクスタスク向けの最新モデルArgonは空間関係をより的確に把握し、制御コードを書き、動画を物理の観点から解釈するように設計されています。Googleはこのモデルを、個々のロボットの制御から発表済み研究の再現に至るまで幅広くカバーする汎用ツールと見なしており、同社とそのAI子会社DeepMindが掲げる目標である「物理的AGI」へのまた一歩と呼んでいます。 長年追求してきた.

1枚の写真が何千もの学習実行へと変わる
Spotのデモは、Googleの多くの事例に共通して見られるパターンを示している。Argonはシミュレーションを用いてタスクの準備、検証、あるいは訓練データの生成を行うのだ。パーティー小物が置かれたテーブルの写真を1枚から、柔らかいぬいぐるみの帽子を含む仮想レプリカを構築した。モデルは、倒れた物体を起こすことからテーブルの片付けまで、77個のタスクを考案し、制御モデル用に4,500を超える訓練エピソードを生成した。実物のロボットでテストしたところ、成功率は56%から75%に上昇し、実行時間は35秒から24秒に短縮された。Ad

Argonは他のソースからも動作させることができます。テレオペレーションによるロボットの録画からは、同じ外観を持ち、指先で同じ力の読み取り値を再現するように設計されたシミュレーションを構築します。把持タスクを行う人間の一人称視点動画からは、このモデルが手や指の動きを、五本指の-handを持つバーチャルなヒューマノイドにマッピングします。
ボールペンのスケッチでも十分機能します。ある図では、人型ロボットがボールを投げて箱のピラミッドを倒しており、Argonはそれを、ロボットが倒れることなく6個すべての箱を倒す投擲動作を計算するシミュレーションに変換します。

ArgonはAI動画モデルにロボットの動作計画を指示する
あるデモは、完全にAI生成の動画内で展開される。 Gemini Omni シーン内で何かが起きたときにその様子がどう変化するかを示すクリップを生成するビデオ・ワールドモデルであり、Argonは監督の役割を果たします。スクラブルのタイルをテーブルの中央に滑らせるといった、手が何をすべきかを記述したタイムスタンプ付きの指示を書きます。Gemini Omniがその指示からビデオを生成し、Argonは個々のフレームを確認して次のコマンドを調整します。目標は、散らばった5枚の文字タイルを並べて「ARGON」と綴ることであり、33ステップ後、タイルは正しい順序に並びました。

別のデモでは、シンプルなロボットアームを使い、Argon にレゴブロックを木箱に入れ、時間とともに自らのパフォーマンスを向上させることが求められた。試行が失敗すると、プロンプトは Argon に自身のログとカメラ画像を見直し、原因を突き止め、検証済みの修正を適用してから再試行するよう指示した。1回目の実行は1分弱で、2回目はブロックが箱の縁に当たったものの23秒とはるかに速かった。3回目の試みでは、約17秒で箱のど真ん中にブロックを収めた。Ad

Google はまた、Argon に研究への貢献も期待している。論文ごとに1つのプロンプトを与えると、ブラウザで動作するインタラクティブなシミュレーションとして公開済みのロボティクス実験を再現する。Google によれば、これまでにロボットサッカーやスケートボードに乗るヒューマノイドロボットを含む68のサンドボックスが構築されたという。
The ERQAベンチマーク (Embodied Reasoning Question Answering)は、AIモデルが3D環境における物理的・空間的な問題をどれほどよく理解し解決できるかを試験する。テストではヘルパーツールなしの400問が使われ、モデルは推論だけですべてを解く必要があった。Google によれば Argon は87パーセントを獲得し、他のすべてのフロンティアモデルを上回った。2位の Claude Opus 5.5 は82.3パーセントで、約5ポイント差だった。GPT-6 Astra が81パーセントで続き、Claude Fable 5.1 は13ポイント差の74パーセントだった。

翌日公開された Artificial Analysis の AA-Robotics ベンチマークは、異なる結果を示している。このテストでは、言語モデルが実際のロボットアームを8つのタスクで直接制御し、Argon は100点中55点で3位となり、69点の GPT-6 Astra と65点の GPT-6.1 Sol に及ばなかった。
Argon は学習データの品質もレビューする
ロボットの制御やシミュレーションの構築に加え、Argon は学習データの評価も担う想定だ。2分強の動画で両腕ロボットが折り紙のキツネを折る様子が映し出されており、モデルはシーケンスをサブステップに分解し、一時停止や失敗した把持にフラグを立てる。これらのセグメントは学習時に重みが低く設定される。人間がリングを仕分けする別の動画では、Argon はタスクが進行する場所、停滞する場所、後退する場所を追跡した。
Google はまた、 古典的な天秤パズルを題材にした、より遊び心のあるユースケースも披露した。外観が同一の12個のボールのうち、1個だけが他より重いか軽い。Argon は2本のロボットアームと天秤を備えたシミュレーションを構築し、カメラ画像のみから天秤の傾きを読み取った。3回以内の計量で正解のボールを見つけ出す。
本当の足場はプロンプトの中にある
Google はデモ用の詳細なプロンプト例を公開しており、それらは大きな主張のいくつかを相対化するものだ。「ゼロショット」と説明された転んだカップを起こすタスクでは、Argon はセンチメートル格子を重ねたカメラ画像と、「grasp」や「lower until contact」のような事前構築済みコマンドを受け取る。シミュレーションについては、測定したセンサー値を単純にコピーするような近道をモデルが取らないよう、長い禁止リストが用意されている。Google はブログ記事で個々のデモの失敗率を公表しておらず、75パーセントの成功率については、それが何回の試行に基づくものかについての言及もない。

Argon は現在 Google AI Studio および開発環境 Antigravityで利用可能だが、 Google AI Ultra の加入者に限られる。開発者は有料 tiers の Gemini API.
を通じてモデルにアクセスすることもできる。Google はわずか数日前に Gemini 4 Argon を世界規模でリリースしていた。ロボティクス分野では、空間認識とタスク計画のためのモデルとして、すでに Gemini Robotics-ER 1.6を発表していた。仮想環境での学習も目新しいものではない。スタートアップの World Labs 実際のシーンを仮想トレーニングの世界に変換する方法を示し、一方で NvidiaのDreamDojoは ロボットの動作を動画としてシミュレーションします。Googleのアプローチを際立たせているのは、 シミュレーション、制御、評価 をすべて同じモデルで処理するという野心的な狙いです。
誇張なしのAIニュース – 人間によるキュレーション
広告のない読書、週刊AIニュースレター、年6回の限定「AI Radar」フロンティアレポート、アーカイブへの完全アクセス、そしてコメント欄へのアクセスのために、THE DECODERを購読してください。
出典: Google