
Metaのコーディング最適化オープンウェイトモデル「Muse Spark Open」が、以下で利用可能になりました Amazon SageMaker JumpStart、機械学習(ML)のハブである Amazon SageMaker AIこのモデルは、複数ファイルにわたるリファクタリングや長時間のデバッグセッションといった実際の開発者ワークフローで学習されており、100万トークンのコンテキストウィンドウをサポートしています。いくつかのステップで、自分のAWSアカウント内のSageMaker AIエンドポイントにデプロイでき、サービングインフラを自分で管理する必要はありません。SageMaker JumpStartでは2つのバリアントが提供されています:BF16(Muse-Spark-Open-816B-A42B)およびNVFP4量子化された(Muse-Spark-Open-816B-A42B-NVFP4).
この記事では、Muse Spark Openを紹介し、そのモデルのデプロイ方法をお見せします。 Amazon SageMaker Studio そして SageMaker Python SDK、最初の推論リクエストを送信し、クリーンアップします。
Muse Spark Open の概要
Metaは、Muse Spark Openを、エージェント型のコーディングワークフロー向けに訓練されたコーディング最適化モデルであり、初回試行の精度、ツール呼び出し、大規模コードベースの理解に重点を置いていると説明しています。これは推論モデルで、テキスト、画像、ドキュメント、音声、音声付き動画を入力として受け付け、テキストを返します。
Muse Spark Openは、合計8160億パラメータのmixture-of-experts(MoE)アーキテクチャを使用しており、そのうち420億が各トークンに対してアクティブになります。このモデルは非常に大規模なネットワークの容量を持ちながら、各トークンに費やす計算量は、はるかに小さなdenseモデルに近いものです。Metaは、Muse Spark Usage Policyを含むMuse Model Licenseの下でウェイトを公開しています。
以下の表はモデルをまとめたものです。
| 属性 | Muse Spark Open |
| 提供元 | Meta |
| アーキテクチャ | Mixture of experts(MoE)、推論モデル |
| パラメータ | 合計816B、アクティブ42B |
| コンテキスト長 | 1Mトークン |
| 入力モダリティ | テキスト、画像、ドキュメント、音声、音声付き動画 |
| 出力モダリティ | テキスト |
| SageMaker JumpStart のバリアント | BF16 および NVFP4 |
| ライセンス | Muse Model License(Muse Spark Usage Policy を含む) |
長時間実行コーディングエージェント向けに構築
Meta は、Muse Spark Open を、実際のリポジトリにおける開発者の作業スタイル、すなわちコード生成、デバッグ、複数ファイルのリファクタリング、長時間実行されるタスクに基づいて訓練しました。100万トークンのコンテキストウィンドウにより、モデルは依存関係、レガシーコード、数千のファイルを含むプロジェクト全体を取り込むことができます。コンテキストに収めるためにタスクを小さな単位に分割する必要はありません。
Meta はまた、Muse Spark Open を最初からエージェント型モデルとして設計しました。Meta によると、このモデルは単一のツール呼び出しを行うのではなく、長期的な視点で計画し、行動し、結果を観察し、自己修正します。推論モデルとして、行動する前にタスクを処理し、SageMaker AI エンドポイントはその推論を回答とともに返すため、エージェントが何を、なぜ行っているのかを追跡できます。Meta はモデルに対し、ウェブの閲覧、分割可能な作業のためのサブエージェントの調整、デスクトップ、モバイル、ブラウザ環境でのコンピュータ操作を訓練しました。これらはモデルの能力です。SageMaker AI では、モデルが呼び出すツール、ブラウザ、コンピュータ利用環境はアプリケーションまたはエージェントフレームワークが提供します。コードに加えて、Meta は Muse Spark Open が画像、ドキュメント、音声、ビデオにわたって推論できると報告しています。
モデルの 2 つの特性が、提供方法に影響します。第一に、スパースな活性化によりトークンあたりの計算量は少なく抑えられますが、提供にはすべての 8160 億のパラメータを保持できるだけの GPU メモリが必要であるため、インスタンスの選択はメモリ容量次第となります。第二に、NVFP4 バリアントは NVIDIA の 4 ビット浮動小数点形式で重みを保存するため、BF16 の重みのおよそ 4 分の 1 のメモリで済みます。SageMaker AI では、この違いがインスタンスを決定します。NVFP4 バリアントは ml.p5e.48xlargeで実行され、BF16 バリアントは ml.p6-b300.48xlargeで実行されます。そのため、コストを考慮してサイジングする際には、まず NVFP4 バリアントを試すのがよいでしょう。品質がユースケースに合うかを確認するため、自身のワークロードで評価してください。
SageMaker AI 上でオープンな重みを使用すれば、デプロイも自身で制御できます。エンドポイントはお使いの AWS アカウント内で実行されるため、ソースコードとプロンプトは、自身で構成・管理するインフラストラクチャ上で処理されます。エンドポイントを自身の Amazon Virtual Private Cloud (Amazon VPC)に接続し、ストレージボリュームを AWS Key Management Service (AWS KMS)のキーで暗号化し、コンテナのネットワーク分離を有効にすることができます。また、インスタンスタイプとスケーリング上限を選択し、モデルバージョンを固定できるため、モデルは再デプロイ時にのみ変更されます。
ユースケース
Muse Spark Open は幅広い用途にご利用いただけます。コーディングとエージェントワークフローに注力した Meta のアプローチにより、以下のようなユースケースに適しています。
- プライベートリポジトリ上でのコーディングアシスタント: 大規模なコードベースについて質問に答え、リファクタリングし、プロジェクト全体をコンテキストに入れてデバッグします。コードはご自身のアカウントのエンドポイント上で処理されます。
- 長期間稼働するコーディングエージェント: 変更を計画し、複数のファイルにまたがって編集を行い、自分のサンドボックス内でテストを実行し、その結果に基づいて軌道修正するエージェントを実行します。
- マルチモーダルエンジニアリングワークフロー「: スクリーンショット、設計ドキュメント、音声・映像付きのバグ報告の記録を、再現手順や修正案に変換します。」
SageMaker JumpStart をはじめよう
Muse Spark Openは、SageMaker Studioから、またはSageMaker Python SDKを使ってデプロイできます。どちらの方法でも、アカウント内にリアルタイムのSageMaker AIエンドポイントが作成されます。
前提条件
始める前に、以下のものが揃っていることを確認してください。
- SageMaker AI のモデルとエンドポイントを作成する権限を持つ AWS アカウント。
- An AWS Identity and Access Management (IAM) SageMaker AIの実行ロール。このチュートリアルでは、
AmazonSageMakerFullAccess管理ポリシーで十分です。本番環境では、ロールをデプロイに必要なアクションとリソースに限定してください。詳細については、以下を参照してください。 SageMaker AI 実行ロールの使用方法. - SageMaker Studio にアクセスできる SageMaker AI ドメイン(Studio の手順の場合)。セットアップ手順については、以下を参照してください。 Amazon SageMaker AI のクイックセットアップを使用する.
- エンドポイントインスタンスタイプのサービスクォータ: エンドポイント使用における ml.p5e.48xlarge NVFP4バリアントの場合、または エンドポイント利用における ml.p6-b300.48xlarge BF16バリアント向けです。クォータを引き上げるには、次を参照してください: クォータ増加のリクエスト.
- SDK パスの場合:Python 3.10 以降および SageMaker Python SDK v3(
pip install --upgrade sagemaker). - SageMaker JumpStart で Muse Spark Open を利用できる AWS リージョンです。提供開始時点で、Muse Spark Open は米国東部 (バージニア北部) および米国東部 (オハイオ) で利用可能です。他のリージョンでの利用可否を確認するには、お使いのリージョンで SageMaker JumpStart を開いてください。
Muse Spark OpenをホストするインスタンスはマルチGPUインスタンスであり、エンドポイントはリクエストを処理しているかどうかにかかわらず、稼働している限り料金が発生します。作業が完了したら、この記事のクリーンアップセクションの説明に従ってエンドポイントを削除してください。料金については、以下をご参照ください。 Amazon SageMaker AI の料金.
SageMaker Studioを使用してデプロイする
SageMaker Studio の方法は、最初の評価に適しています。モデルを探し、ライセンスを確認し、1つのモデル詳細カードからデプロイできます。
SageMaker JumpStart で Muse Spark Open を見つけるには
- SageMaker Studio を開きます。
- ナビゲーションペインで、以下を選択します。 JumpStart.
- 検索ボックスに「Muse Spark Open」と入力します。
- 選択 Muse-Spark-Open-816B-A42B BF16バリアントの場合、または Muse-Spark-Open-816B-A42B-NVFP4 NVFP4バリアントについては、モデル詳細カードを開いてご覧ください。
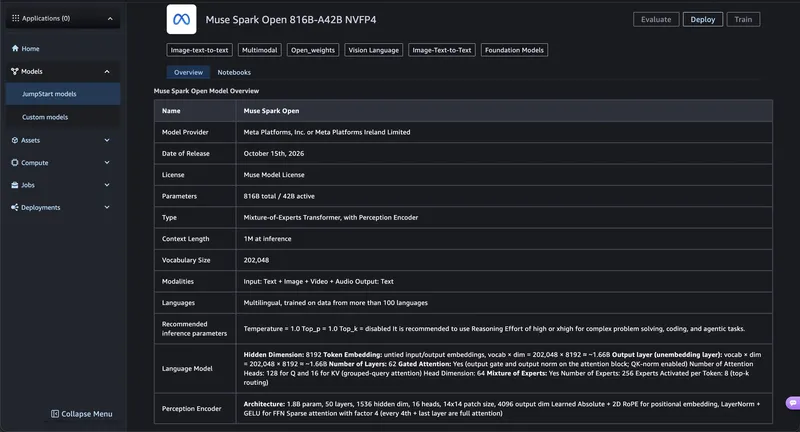
Figure 1はモデル詳細カードを示しており、そこにはモデルの説明、ライセンス、そして…が一覧表示されています。 デプロイ オプション。
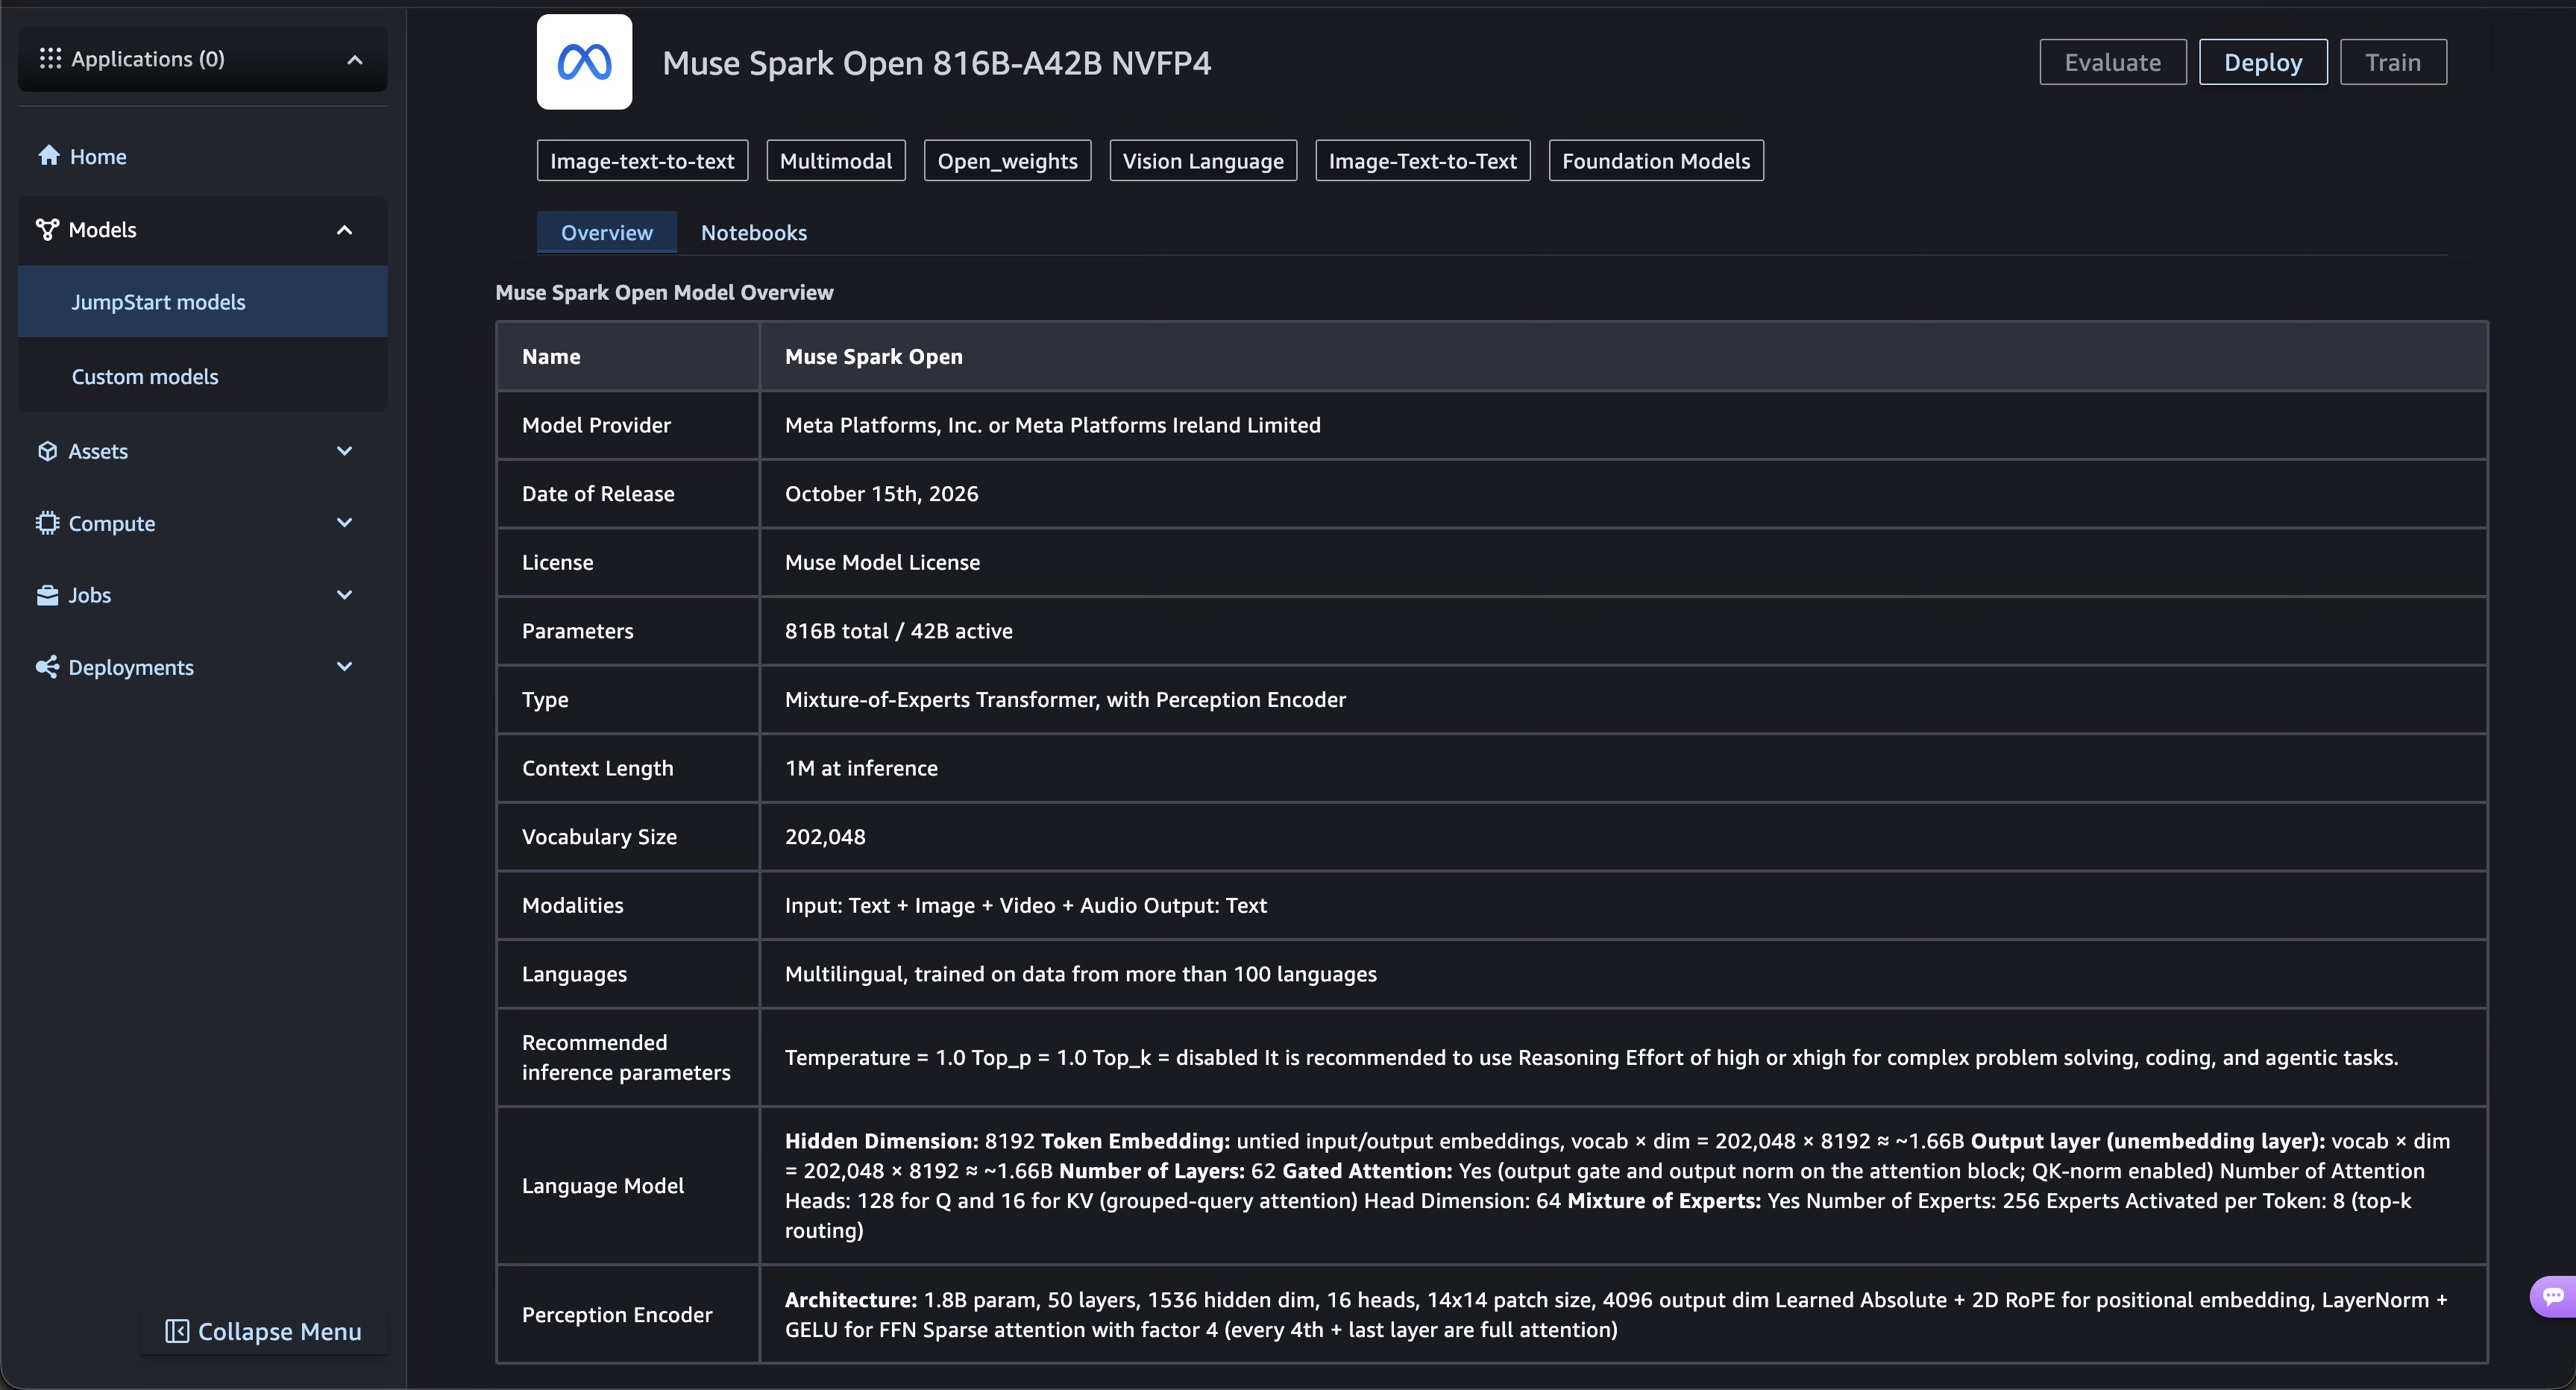
Figure 1: SageMaker JumpStart の Muse Spark Open モデル詳細カード
モデルをデプロイするには
- モデル詳細カードで、次を選択します デプロイ.
- Muse Spark Openはゲーテッドモデルであるため、SageMaker Studioにはエンドユーザーライセンス契約(EULA)が表示されます。続行するには契約を確認して同意してください。
- のために エンドポイント名生成された名前をそのまま使うか、独自の名前を入力してください。
- のために インスタンスタイプ, 選択 ml.p5e.48xlarge NVFP4 または ml.p6-b300.48xlarge BF16用です。SageMaker Studioでは、モデルがサポートするインスタンスタイプのみが表示されます。
- 〜のために 初期インスタンス数"1" と入力してください。
- (任意) アンダー 詳細オプションで、VPC と AWS KMS キーを選択するか、ネットワーク分離を有効にします。
- 選択 デプロイ.
Figure 2 に、NVFP4 バリアントのデプロイ設定を示します。
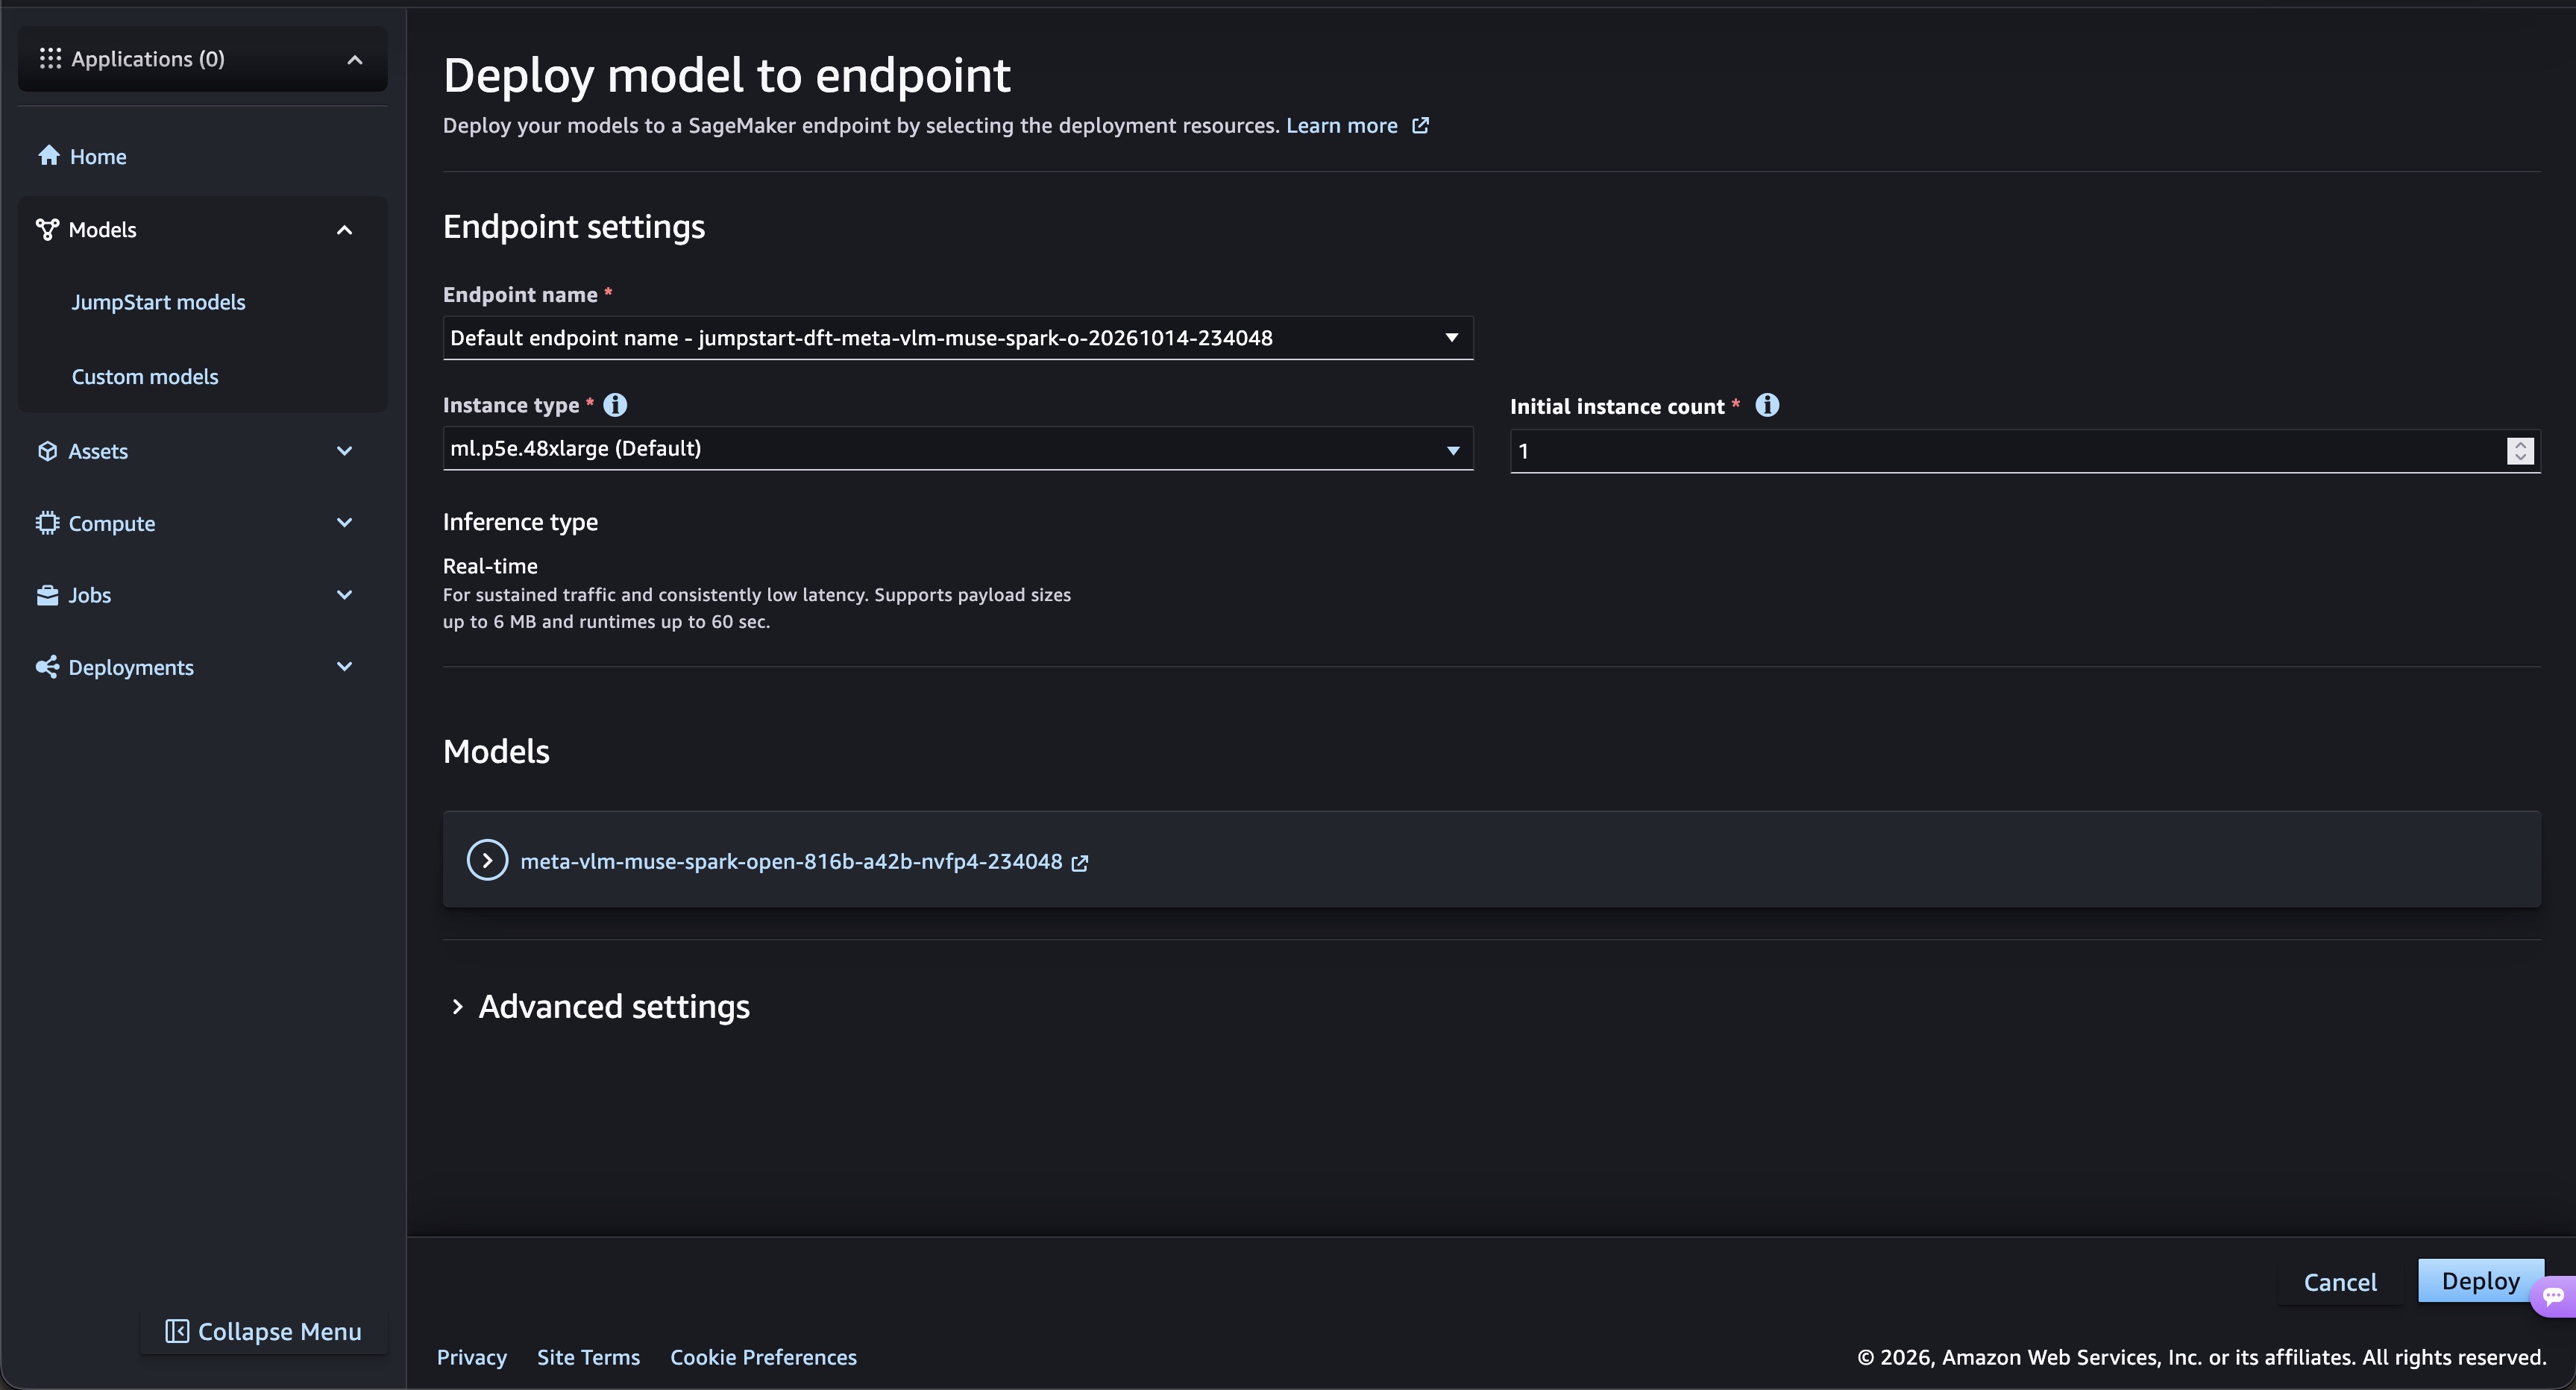
図2:Muse Spark Openのデプロイ設定
SageMaker AIがインスタンスをプロビジョニングし、重みをロードする間、デプロイには通常15〜20分かかります。エンドポイントのステータスが次のように変わると InService, エンドポイントはリクエストを受け付けられる状態になり、図3に示すようになります。
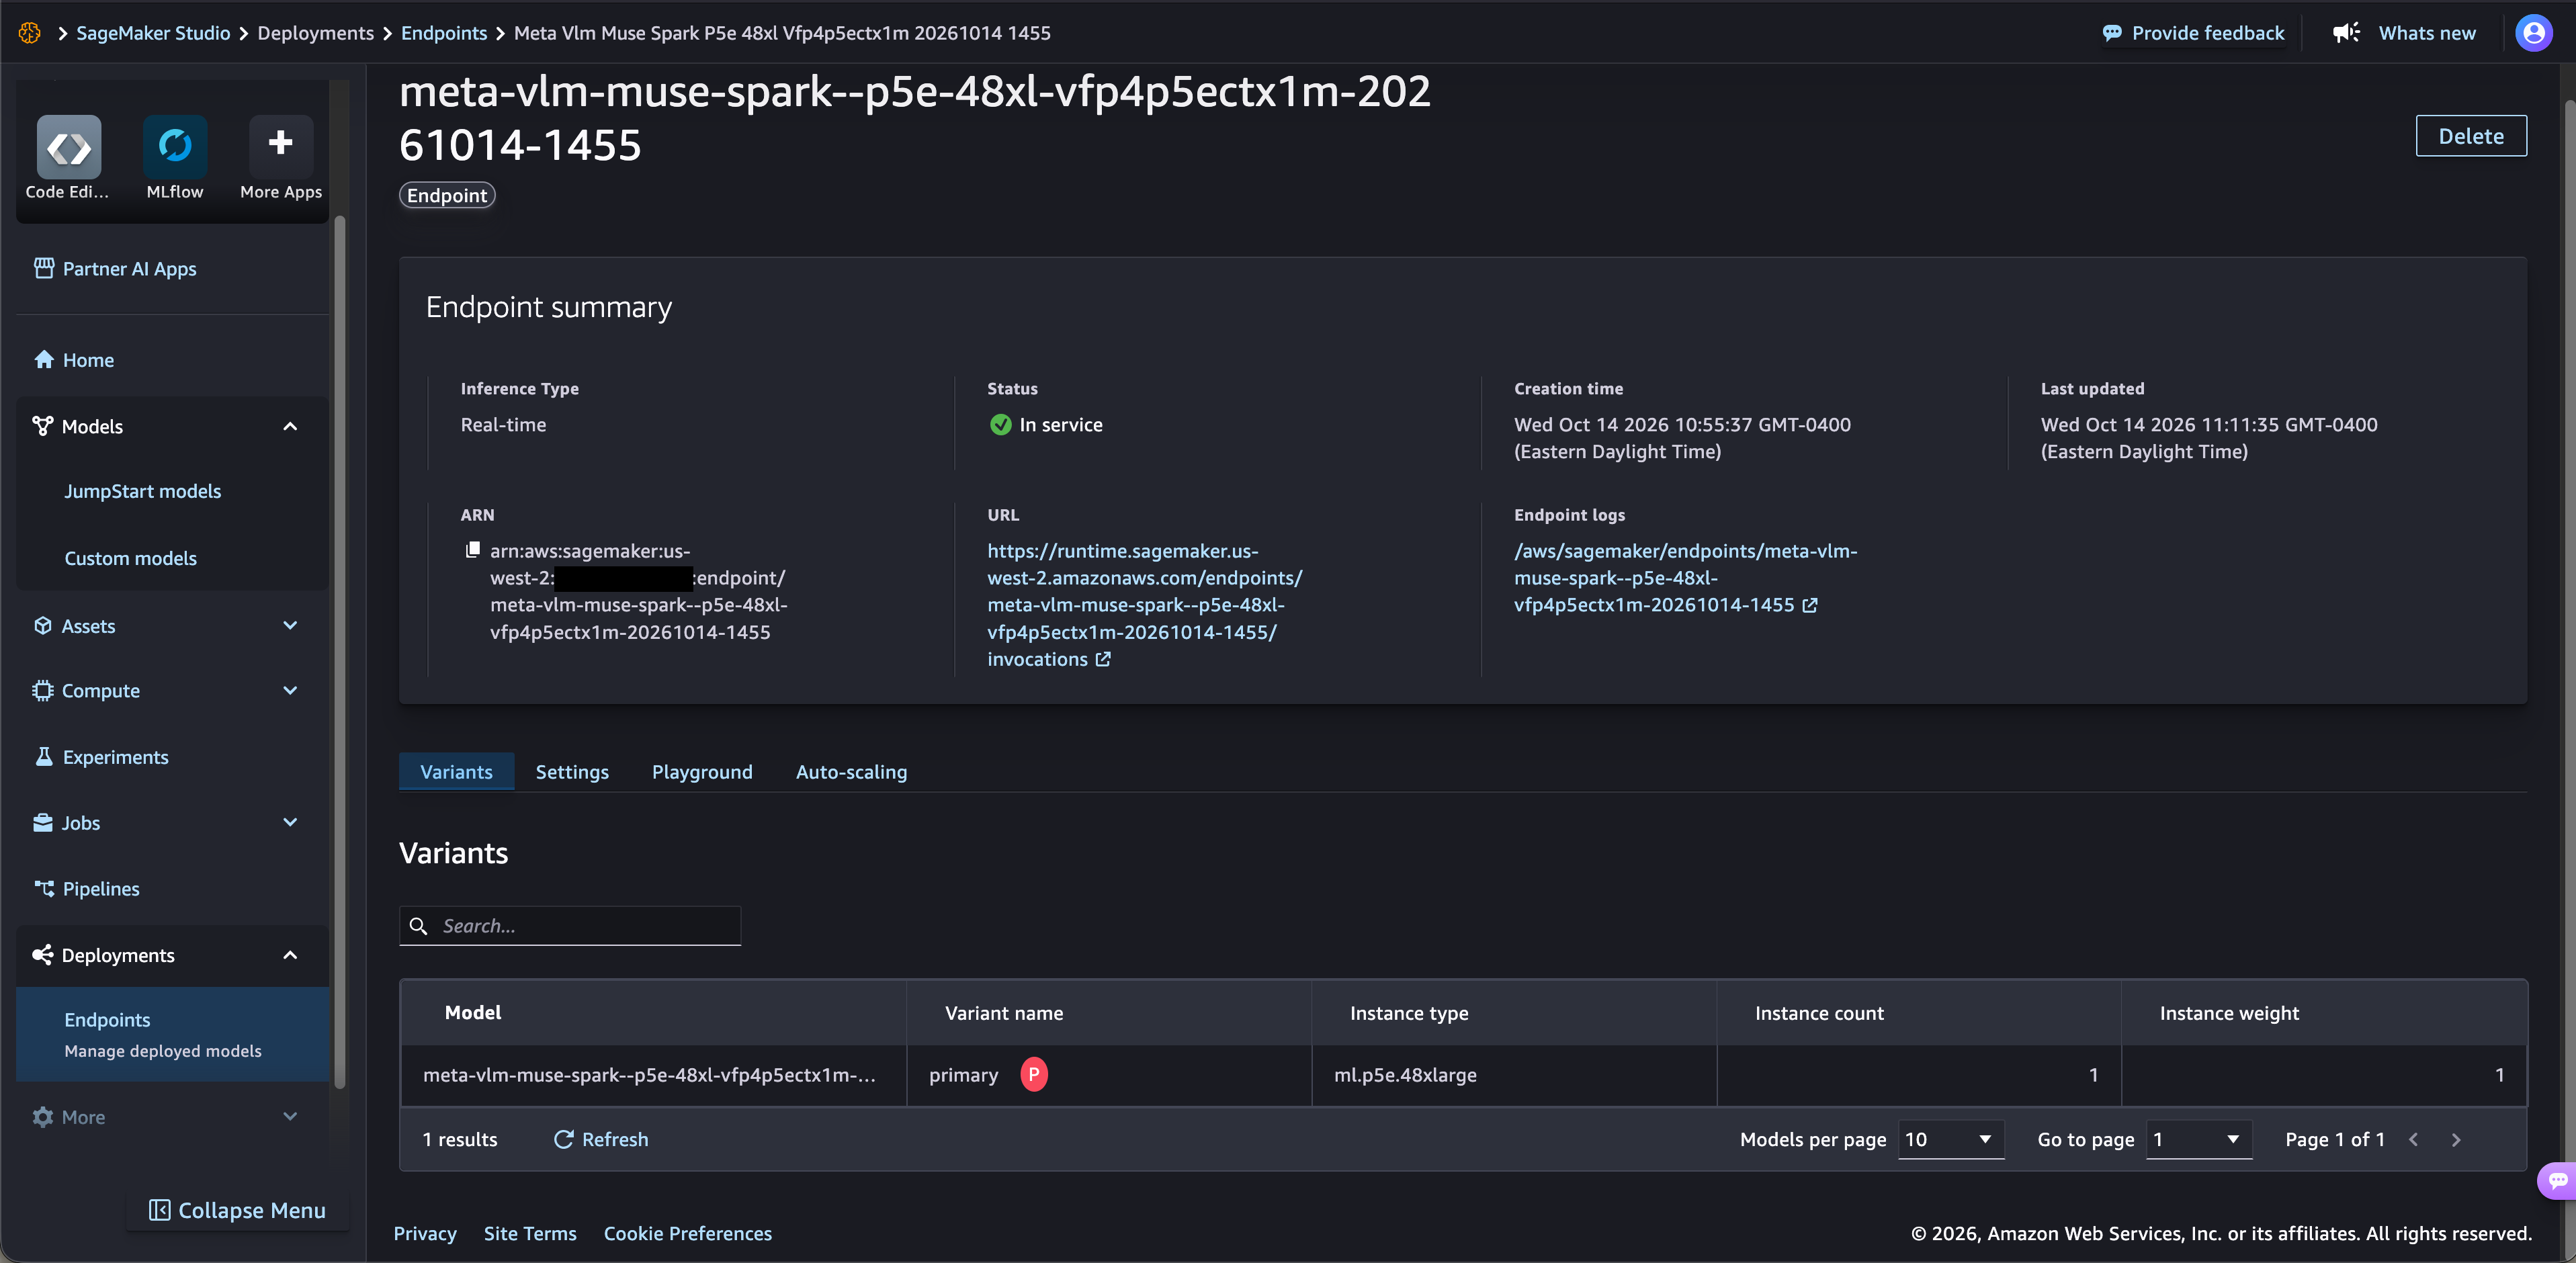
図3:稼働中のMuse Spark Openエンドポイント
SageMaker Python SDK を使用したデプロイ
SageMaker JumpStart は各バリアントをモデル ID で識別します。
- BF16:
meta-vlm-muse-spark-open-816b-a42b. - NVFP4:
meta-vlm-muse-spark-open-816b-a42b-nvfp4.
以下のコードは、SageMaker Python SDK v3 を使用して NVFP4 バリアントをデプロイします。SageMaker Studio のノートブック(ドメインの実行ロールを使用)で実行できます。AWS 認証情報を持つその他の Python 環境では、 role_arn パラメータ。Muse Spark Openはゲート付きモデルであるため、設定する必要があります。 accept_eula=True それをデプロイします。特定のモデルバージョンを固定するには、 model_version から JumpStartConfig.
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.serve import ModelBuilder
from sagemaker.train.configs import Compute

# NVFP4 variant; for BF16, use "meta-vlm-muse-spark-open-816b-a42b" with ml.p6-b300.48xlarge
model_id = "meta-vlm-muse-spark-open-816b-a42b-nvfp4"

jumpstart_config = JumpStartConfig(
    model_id=model_id,
    accept_eula=True,  # Confirms that you accept Meta's license terms
)

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=jumpstart_config,
    compute=Compute(instance_type="ml.p5e.48xlarge"),
    # role_arn="<your-sagemaker-execution-role-arn>",  # Required outside SageMaker Studio
)

model = model_builder.build(model_name="muse-spark-open-nvfp4")
endpoint = model_builder.deploy(endpoint_name="muse-spark-open-nvfp4")
推論を実行
エンドポイントが稼働中になったら、以下のコマンドでリクエストを送信してください。 invoke method. The endpoint accepts…の文脈として翻訳します。
「メソッド。このエンドポイントは、OpenAI互換のチャットペイロードを以下の形式で受け付けます:」 messages リストを受け取り、チャット補完を返します。最終的な答えは message.content、このモデルの推論は message.reasoning_content、また usage.reasoning_tokens 推論に使用されたトークン数を報告します。Muse Spark Open は推論モデルであるため、 max_tokens 推論と最終回答の両方に対して。
import json

payload = {
    "messages": [
        {
            "role": "user",
            "content": "Write a Python function that validates ISO 8601 dates, and add pytest unit tests for it.",
        }
    ],
    "max_tokens": 4096,
}

response = endpoint.invoke(
    body=json.dumps(payload),
    content_type="application/json",
)

result = json.loads(response.body.read().decode("utf-8"))
message = result["choices"][0]["message"]
print("Reasoning:", message.get("reasoning_content"))
print("Answer:", message["content"])
このエンドポイントはストリーミングにも対応しています。生成されると同時にトークンを受け取るには、 "stream": true リクエストボディに追加し、呼び出し endpoint.invoke_with_response_stream の代わりに invoke.
クリーンアップ
課金が発生し続けるのを防ぐには、エンドポイントが不要になった時点で削除してください。SDK を使ってデプロイした場合は、モデル、エンドポイント、エンドポイント設定を削除します:
from sagemaker.core.resources import EndpointConfig

endpoint_config = EndpointConfig.get(endpoint_config_name=endpoint.endpoint_name)
model.delete()
endpoint.delete()
endpoint_config.delete()
SageMaker Studio からデプロイした場合は、SageMaker AI コンソールでエンドポイントを削除します。次を選択します。 推論、その後 Endpointsでエンドポイントを選択し、 Actions, から Delete を選択します。.
結論
この記事では、Meta のコーディング向けに最適化されたオープンウェイトモデルである Muse Spark Open を、SageMaker JumpStart から自身の AWS アカウント内のエンドポイントにデプロイする方法を紹介しました。SageMaker Studio または SageMaker Python SDK を使用し、モデルに最初の推論リクエストを送信しました。本番用のインスタンスを選ぶ前に、両方のバリアントを自身のリポジトリでベンチマークしてください。
開始するには、SageMaker Studio の SageMaker JumpStart で Muse Spark Open を検索します。インファレンスコンポーネントや最適化されたデプロイ構成などのデプロイオプションの詳細については、Amazon SageMaker AI Developer Guide の JumpStart foundation model usage を参照してください。デプロイの前に、モデルのデプロイ時に SageMaker JumpStart が表示する Muse Model License を確認してください。本番デプロイの計画に関するサポートについては、 contact AWS.