
ハイライト
- アーキテクチャ: 総パラメータ数816B、トークンあたりアクティブパラメータ42B、コンテキストウィンドウは1M。
- 量子化: MetaはBF16とNVFP4の両方でモデルをリリースしました。MXFP4の重みはAMDがリリースしました。
- マルチモーダル: Muse Glimmerと同じPerception Encoderによるネイティブの画像・動画認識に加え、追加の音声サポート。
- 並列化: NVIDIAとAMDの両方でテンソル並列およびパイプライン並列に対応。NVIDIAではEP、TEP、DEP、PD分離に対応。TPU上でも初期サポートが利用可能です。
- 推測デコーディング: CUDAとROCmの両方でサポートされるDSparkドラフトモデルを訓練し、モデルの性能を高速化しました。SPEEDベンチでテスト済みです。
使い方
両ベンダー向けに事前構築イメージが提供されています:
- NVIDIA: vllm/vllm-openai:muse-spark-open
- AMD: vllm/vllm-openai-rocm:muse-spark-open
コード(PR #61879)がレビューされマージされた後、モデルはnightly PyPI wheelでのみ利用可能になることにご注意ください。マージには通常約1週間かかります。
# Rust frontend is recommended
export VLLM_USE_RUST_FRONTEND=1

vllm serve meta-models/Muse-Spark-Open-816B-A42B-NVFP4 \
    --tensor-parallel-size 8 \
    --enable-expert-parallel \
    --max-model-len 1048576 \
    --reasoning-parser muse \
    --tool-call-parser muse \
    --enable-auto-tool-choice \
    --speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'
このモデルをプレーンテキストで使用するには:
  curl http://localhost:8000/v1/chat/completions \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "meta-models/Muse-Spark-Open-816B-A42B-NVFP4",
      "messages": [{"role": "user", "content": "Refactor this module."}],
      "reasoning_effort": "xhigh"
    }'
マルチモーダル認識の場合:
 curl http://localhost:8000/v1/chat/completions \
   -H 'Content-Type: application/json' \
   -d '{
     "model": "meta-models/Muse-Spark-Open-816B-A42B",
     "messages": [{"role": "user", "content": [
       {"type": "image_url", "image_url": {"url": "https://example.com/screenshot.png"}},
       {"type": "video_url", "video_url": {"url": "https://example.com/demo.mp4"}},
       {"type": "audio_url", "audio_url": {"url": "https://example.com/clip.wav"}},
       {"type": "text",      "text": "What is happening here, and when?"}
     ]}]
   }'
実装の詳細
モデルアーキテクチャ
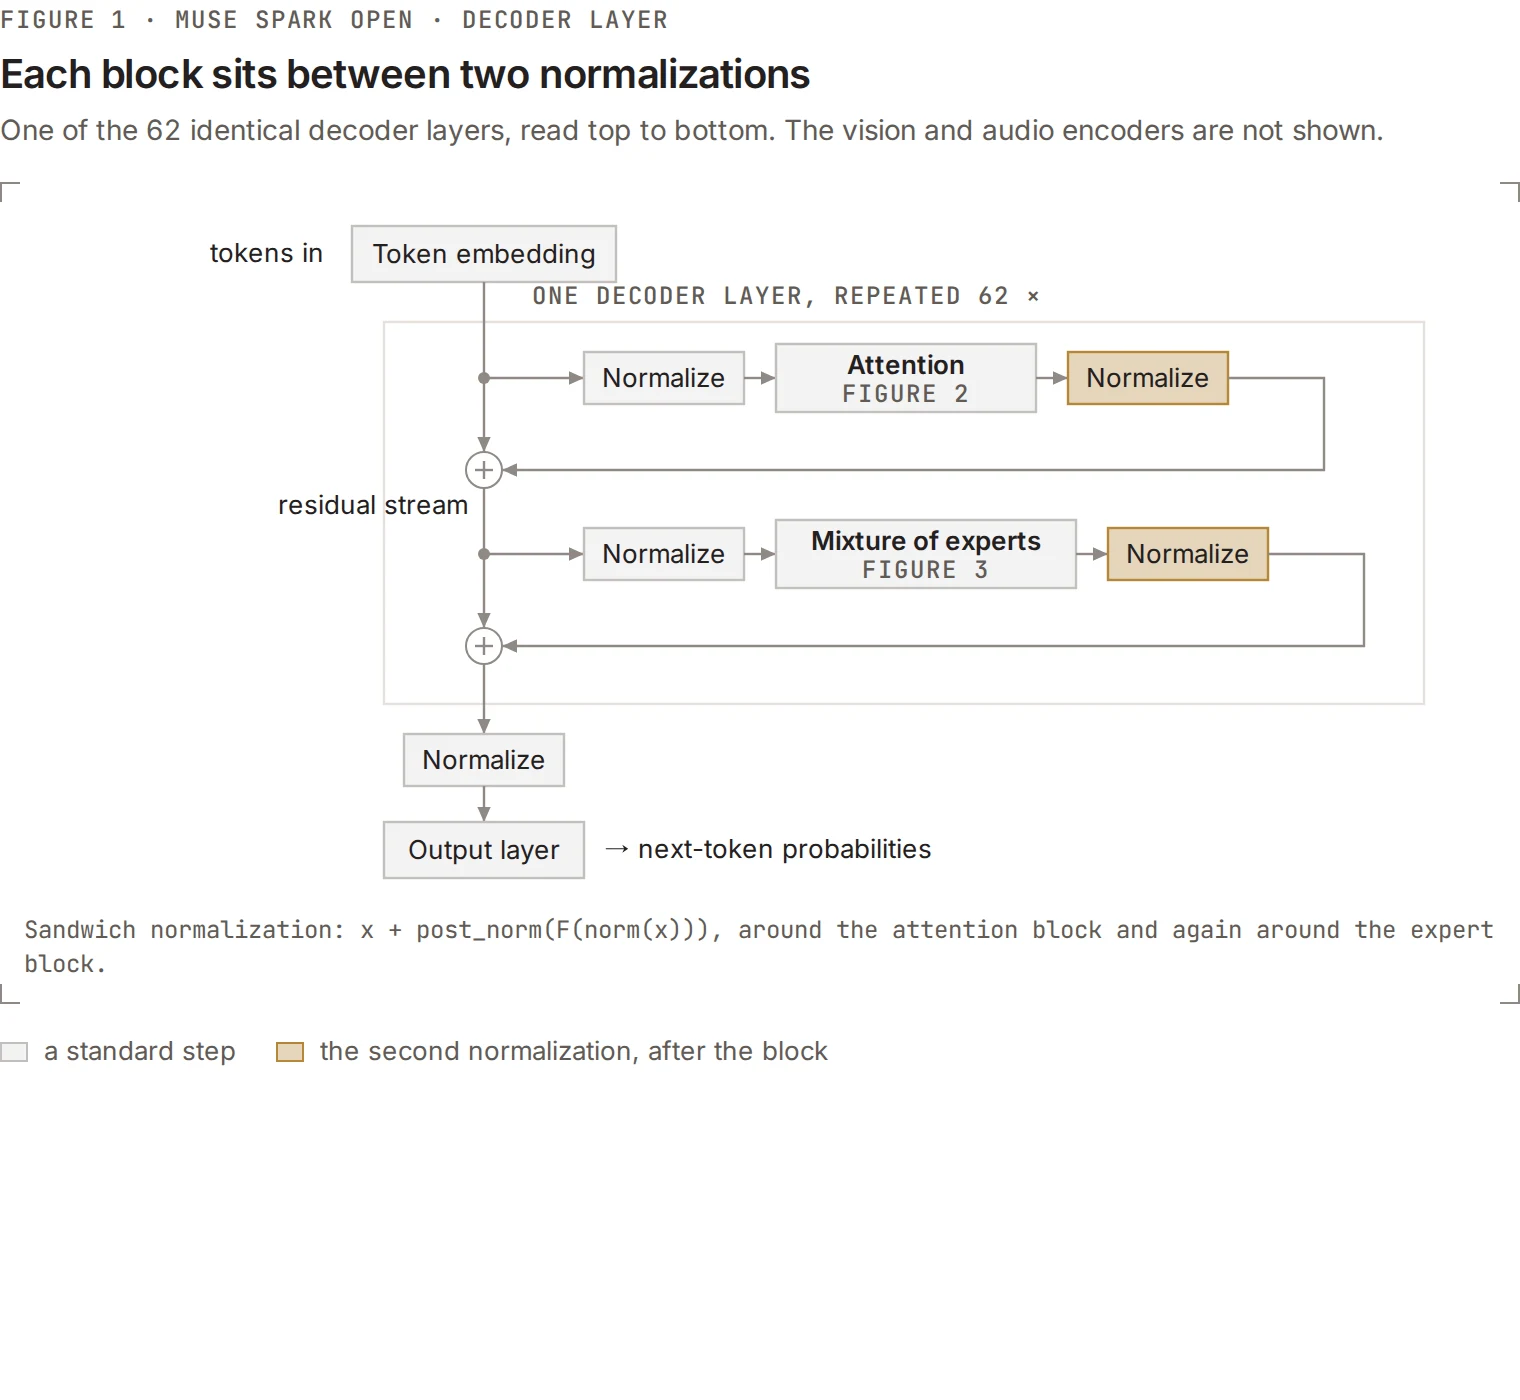
Muse Spark Openは、テキストデコーダを含む総パラメータ数816Bの混合エキスパートモデルで、それに加えて2Bのビジョンエンコーダと小さな音声エンコーダを備えています。デコーダは62層あり、そのすべてが混合エキスパート層です。重みの内訳は以下の通りです:
| 部分 | サイズ |
|---|---|
| レイヤーあたり256エキスパート | 799 B |
| アテンション | 13.5 B |
| MoE潜在射影 | 4.2 B |
| 埋め込み層と出力層 | 3.3 B |
| vision tower(別個) | 1.9 B |
このモデルアーキテクチャは Muse Glimmer と類似しています。Muse Glimmer を使ったことのない方のために、このモデルアーキテクチャにはより詳しく見る価値のあるポイントがいくつかあります。
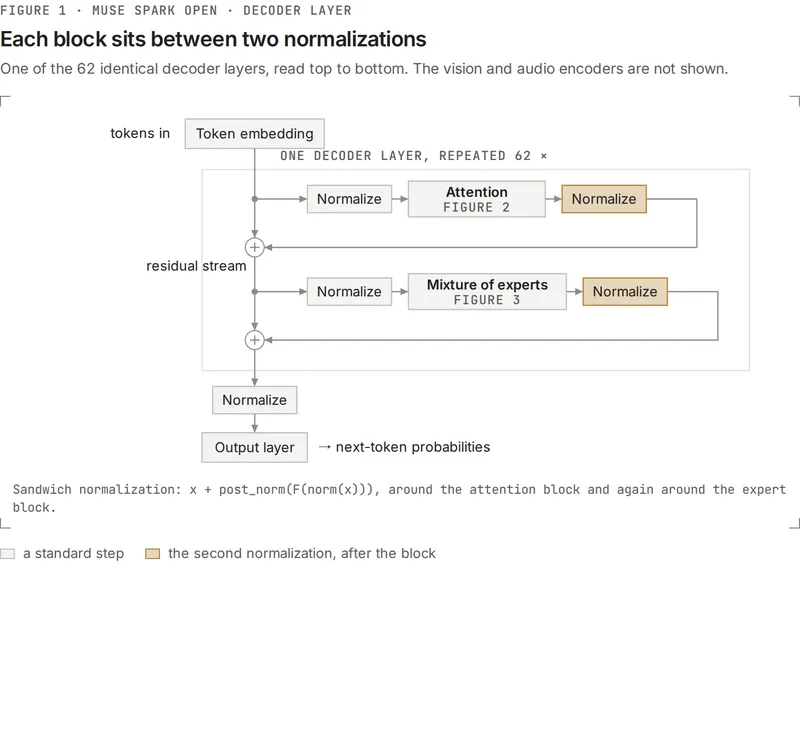
サンドイッチ正規化。 ほとんどのデコーダは各ブロックの前に1つの正規化層を置き、x + F(norm(x)) となります。Muse Spark Open は Muse Glimmer と同様、1つを前にもう1つを後ろに置きます。これはブロックをサンドイッチされ、x + post_norm(F(norm(x))) となります。
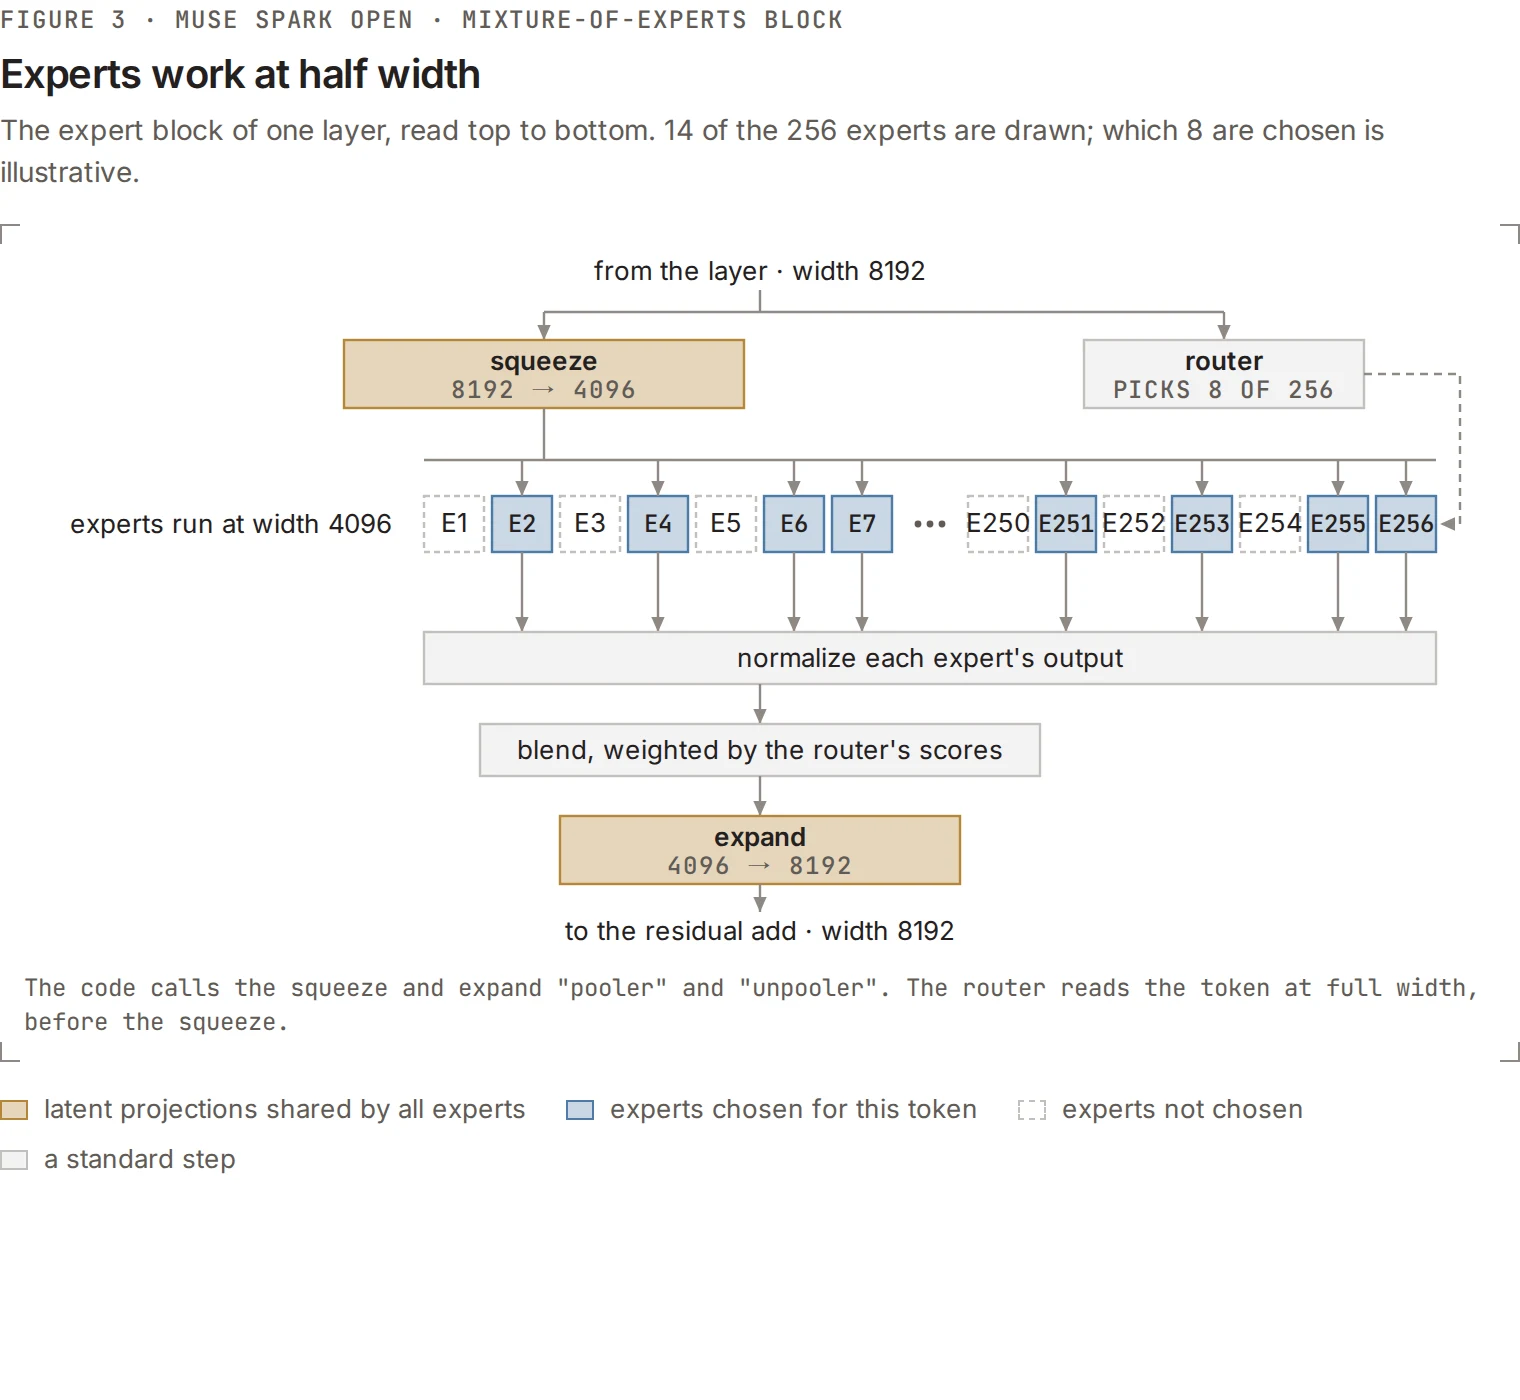
潜在 MoE。 すべての Mixture-of-Experts(MoE)層は、その層の 256 人のエキスパート全員で共有される2つの追加行列を持ちます。コードではこれらをプーラー(pooler)とアンプーラー(unpooler)と呼んでいますが、どちらも通常の意味でのプーリングではなく、次元を圧縮・拡張する学習済み射影です。プーラーは 8192 × 4096 の行列で、各トークンの幅をエキスパートに到達する前に半分にします。アンプーラーはその後、完全な幅を復元します。したがって、エキスパートは 8192 ではなく完全に 4096 で動作し、これにより2つのエキスパート射影層に必要なパラメータ数が実質半分になりました。
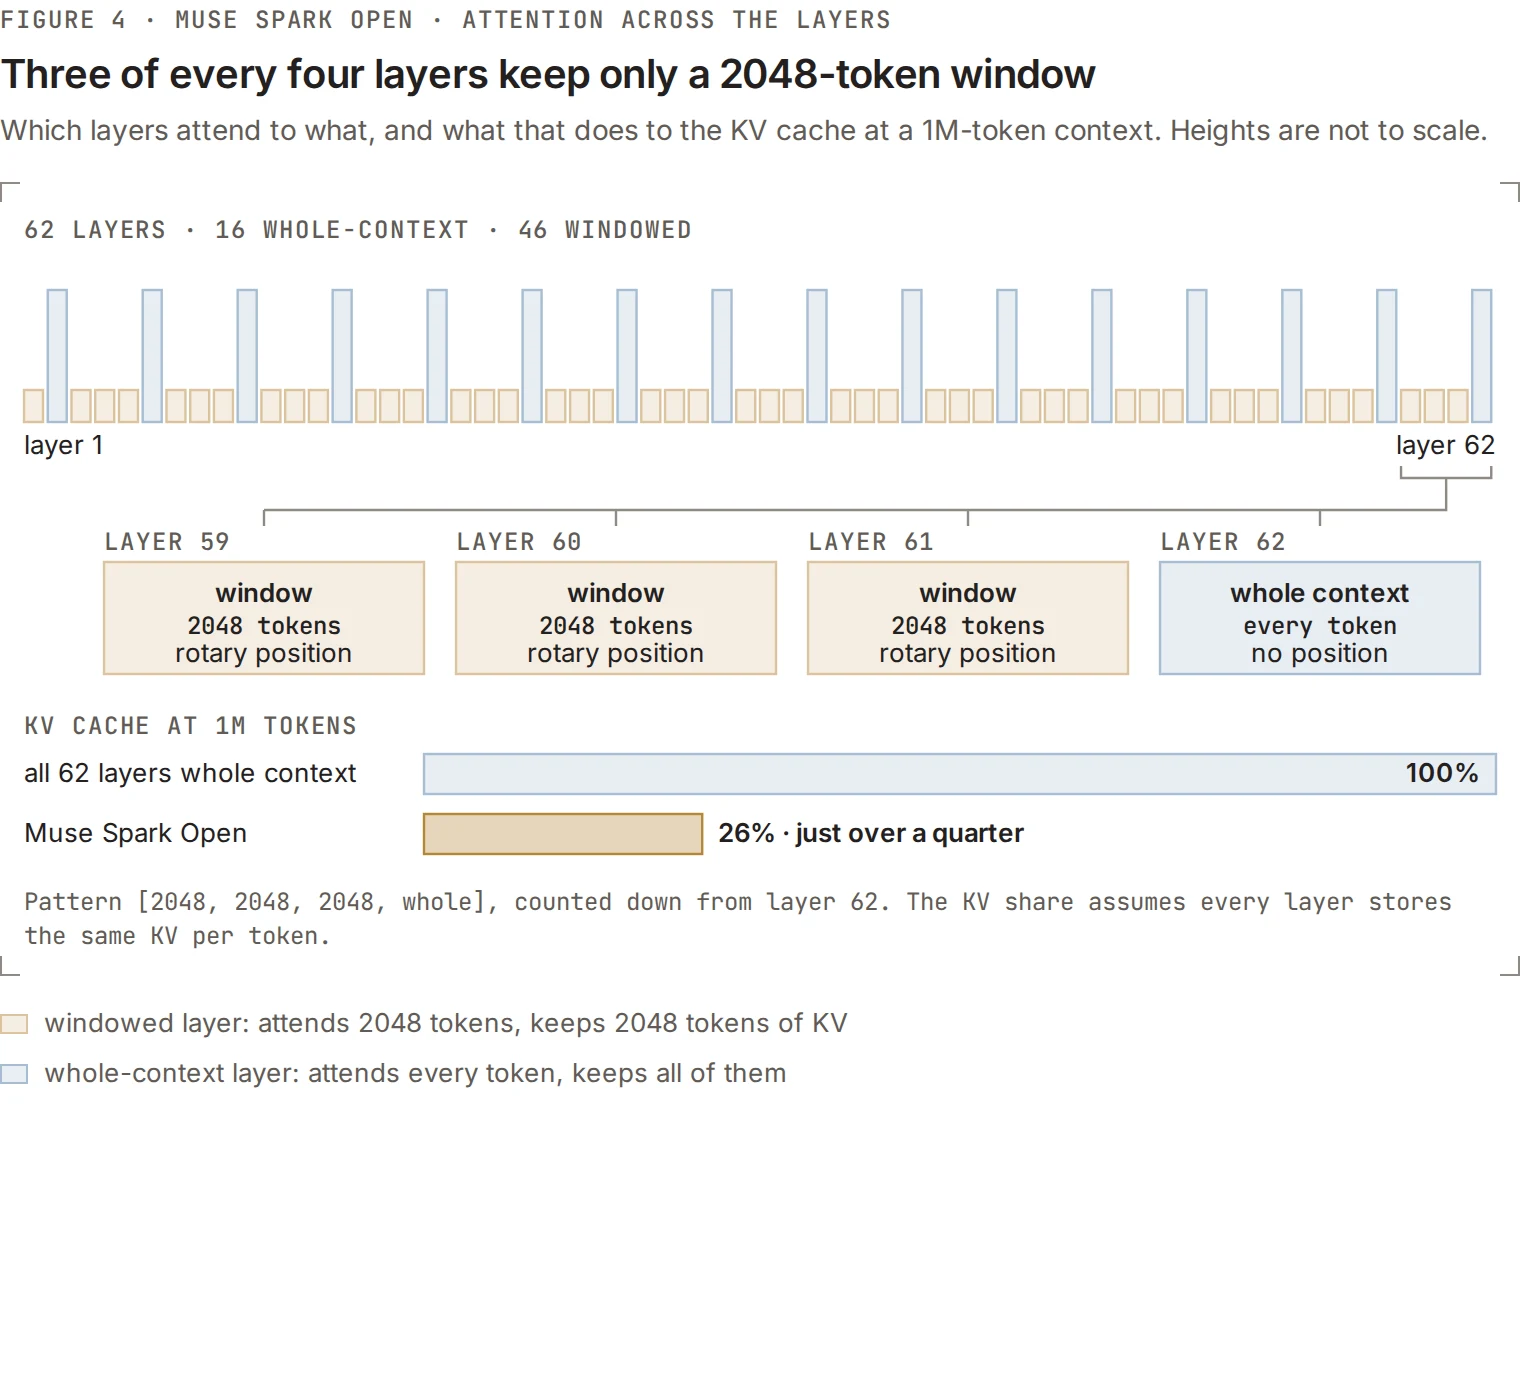
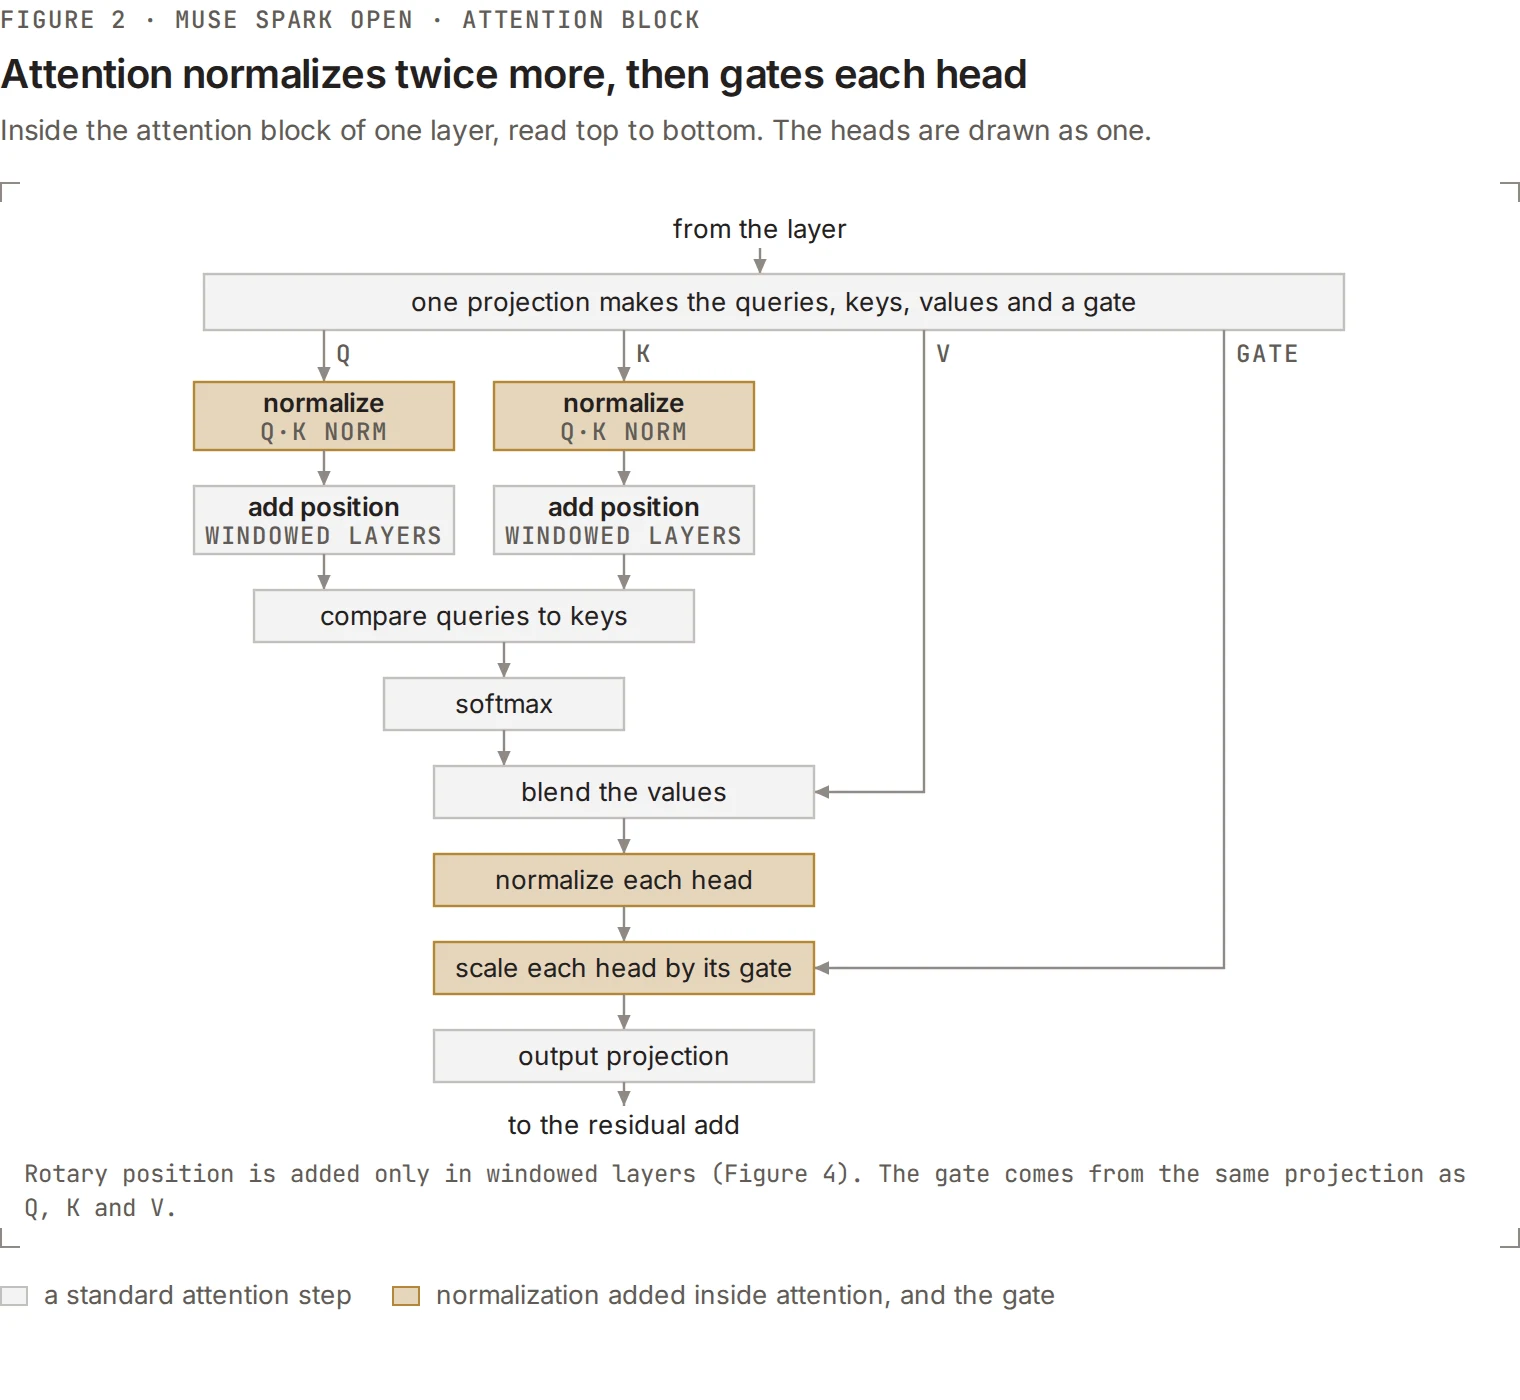
ハイブリッドアテンション。 各層は、4 を周期とする繰り返しサイクルでフルアテンションと Sliding Window Attention(SWA)を交互に繰り返し、3 層が 2048 トークンのウィンドウにアテンドし、第4層がコンテキスト全体を見ます。このサイクルはスタックの末尾に固定され、最終層は常にフルアテンション層となります。62 層全体で、これは 46 の狭い層と 16 の広い層を生み出し、狭い層は最近の KV のみを保持します。1M トークンにおいて、これによりキャッシュは全層フルアテンションの場合のわずか ¼ 強になります。これが 1M のコンテキスト長を手頃なものにしているのです。
Vision Encoder。 Muse Spark Open は Muse Glimmer と同じ Perception Encoder を使用します。これは 2B パラメータのタワーで、画像を正方形にリサイズするのではなく、ネイティブ解像度のまま読み込みます。動画も同じエンコーダを通ります。フレームは読み込み時にサンプリングされた動画フレームの系列としてサンプリングされ、タイムスタンプがプロンプト内でトークン化されます。
Audio Encoder。 音声は 24 kHz の生波形として読み込まれ、1920 サンプルごと、すなわち 80ms ごとに、一連の変換を通じて1つのトークンになります。オーディオエンコーダ全体でわずか 118M パラメータです。なお、動画の音声トラックは処理されません。モデルにクリップの映像と音声の両方を与えるには、同じリクエスト内で動画と抽出した音声を2つの別個のコンテンツ部分として送信してください。
DSpark
vLLM 上での Muse Spark Open の推論を高速化するため、我々は DSpark を用いてスペキュレータを訓練しました。DSpark はブロック拡散を用いて1回のパスで最大7つのドラフトトークンを提案する speculative decoding アルゴリズムです。信頼度ベースのスケジューリングにより、speculative decoding が従来は効果が薄れる大バッチサイズにおいても、以下の結果に示す通り大幅な高速化を持続できます。
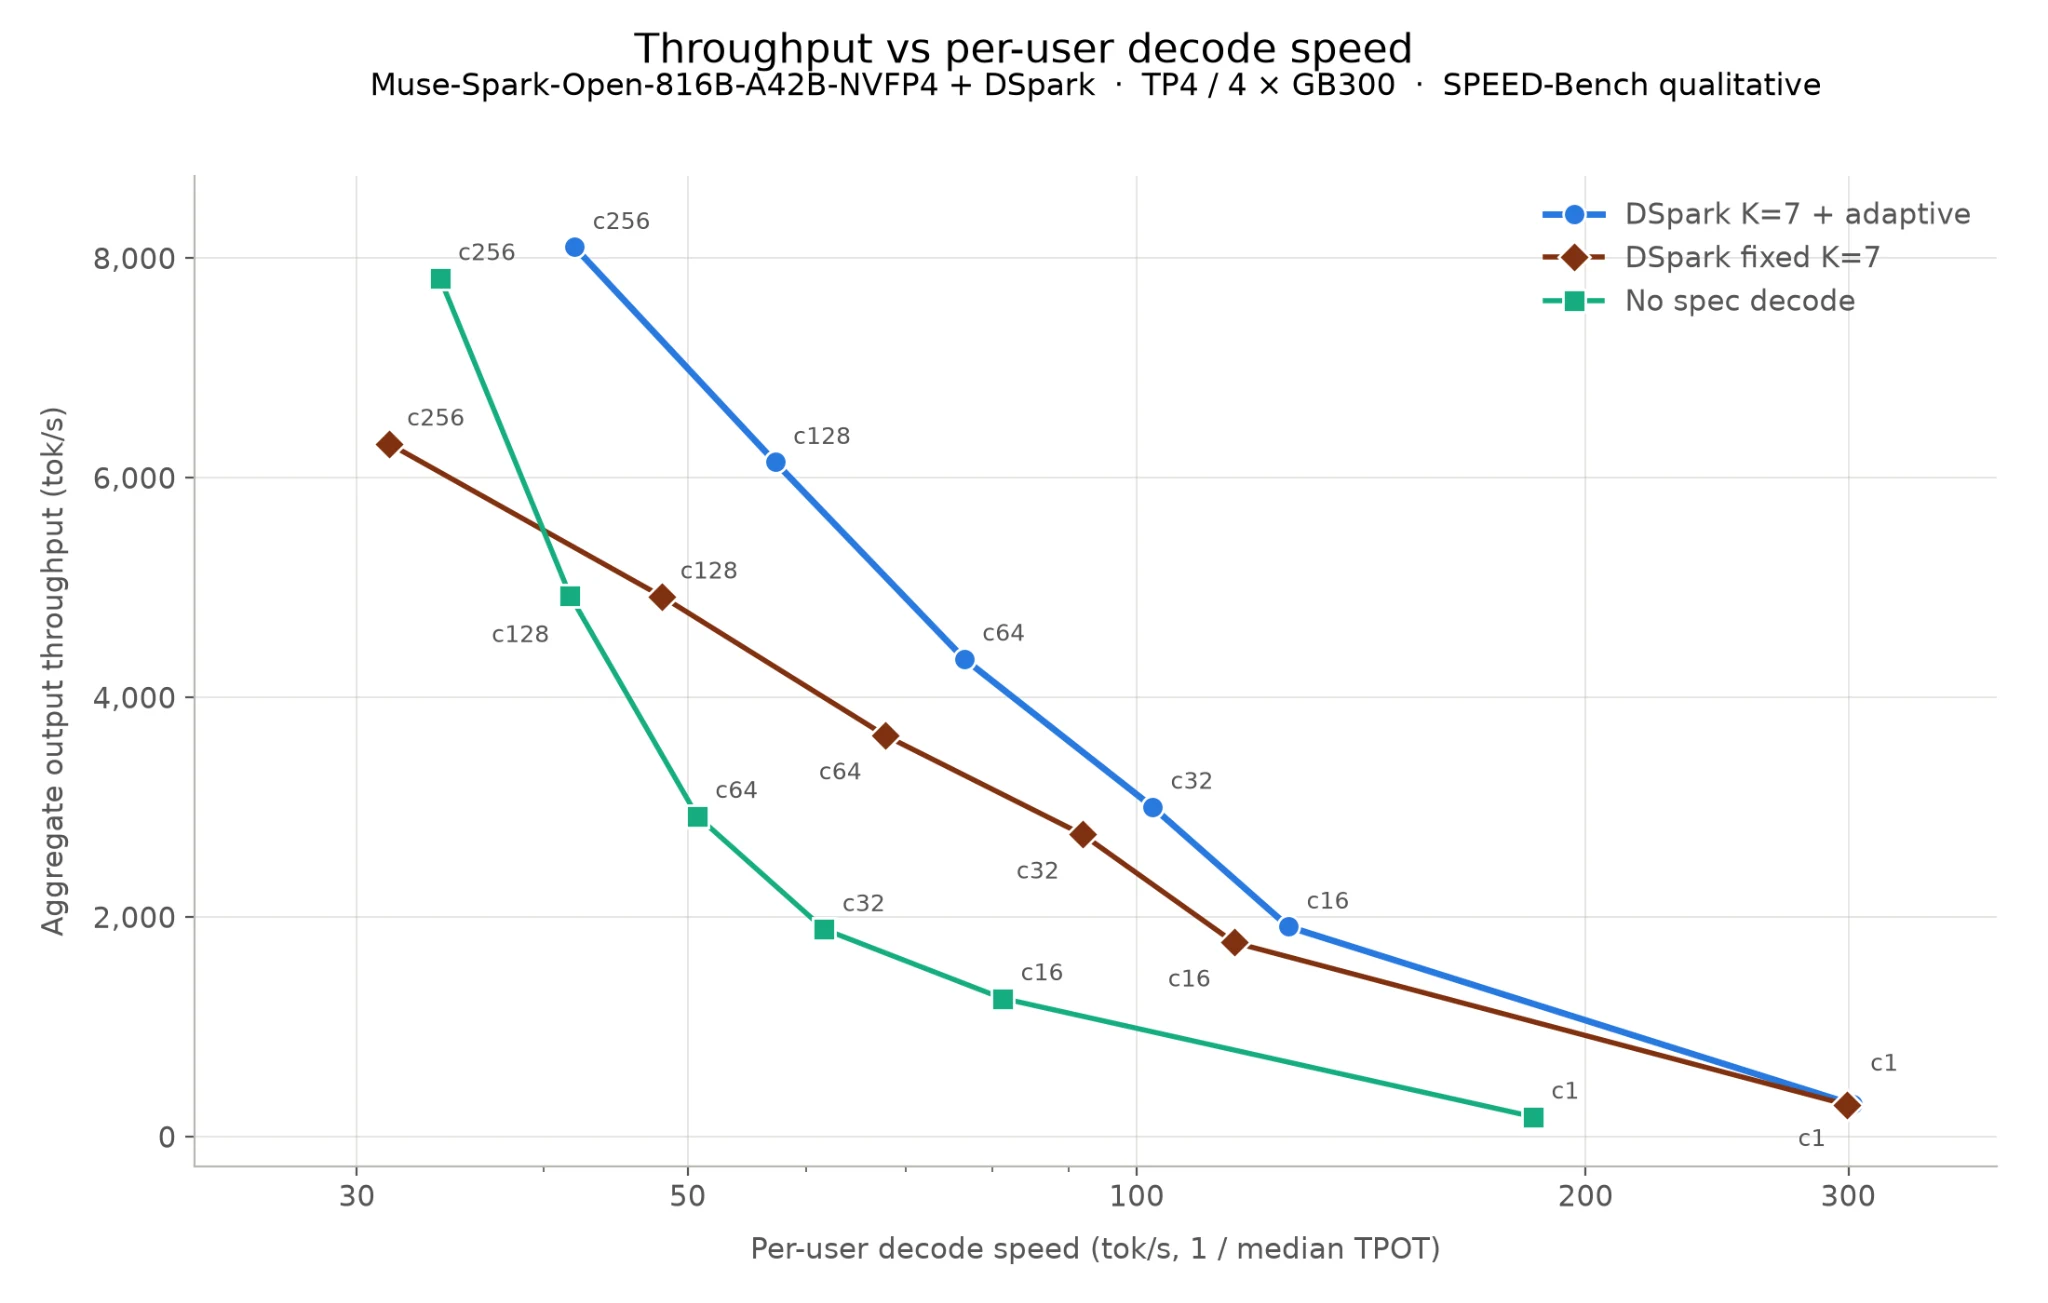
我々のスペキュレータは、Muse Spark Open のスライディングウィンドウアテンションも使用しており、1M トークンのコンテキストでもドラフトを軽量に保ちます。これらの選択により、幅広いバッチサイズとコンテキスト長にわたる本番ワークロードに適したものとなっています。
これを有効にするには、サーバ起動時に以下を追加してください:
--speculative-config '{"method":"dspark","model": "Inferact/Muse-Spark-Open-DSpark","num_speculative_tokens":7,"draft_sample_method":"probabilistic","rejection_sample_method":"block","enable_adaptive_verification":true}'Nvidia
Nvidia チームは、フューズド正規化・ゲーティング・残差カーネル、テンソル並列通信と RMSNorm を組み合わせたフューズド MoE ファイナライズ、新しい低レイテンシ BF16 GEMM 実装とコンパイルオーバーヘッドの削減、フューズド MNNVL コレクティブを組み合わせた TEP プーラー/アンプーラーシャーディング、正規化の FP32 出力を入力とする TF32 ルーター GEMM、そしてデータ移動、ハードウェアサポート、ランタイム信頼性の改善を通じて、FlashInfer と vLLM 全体で Muse Spark Open の推論を改善しました。
AMD
AMD チームのおかげで、AMD Instinct™ MI355X GPU 上でも FP8 および MXFP4 量子化フォーマットの両方でこのモデルをサポートし、推論性能とデプロイ効率の向上を実現しました。なお、ROCm は現在、テンソル並列とパイプライン並列の両方をサポートしています。
TPU
TorchTPU の上で TPU 上の Muse Spark Open のサポートを追加しました。コードへのアクセスについては、我々または Google にお問い合わせください。また、Muse Spark Open 向けに megakernels を構築しました。DSpark speculative decoding(acceptance length = 6)を用いると、4 TPU v7 チップで 650 tokens/sec 超、8 チップで 960 tokens/sec 超に達します。speculative decoding なしでも、それぞれ 270 tokens/sec 超、350 tokens/sec 超を達成します。
vLLM での強化学習
vLLM は、0日目から Muse Spark Open での LoRA RL もサポートしており、Verl FSDP2 をトレーナーとしてロールアウトエンジンとして機能します。vLLM は、LoRA アダプタを上に適用した元の NVFP4 チェックポイントを提供します。トレーナーは同じ重みの BF16 逆量子化で実行され、アダプタ(rank 32、alpha 64)のみを更新します。このアダプタは、アテンション、MoE 潜在射影、およびルーティングされるすべてのエキスパートをカバーします。さらに、ロールアウトの MoE ルーティング(R3)をリプレイし、各ステップの後にアダプタのみが vLLM に同期されます。
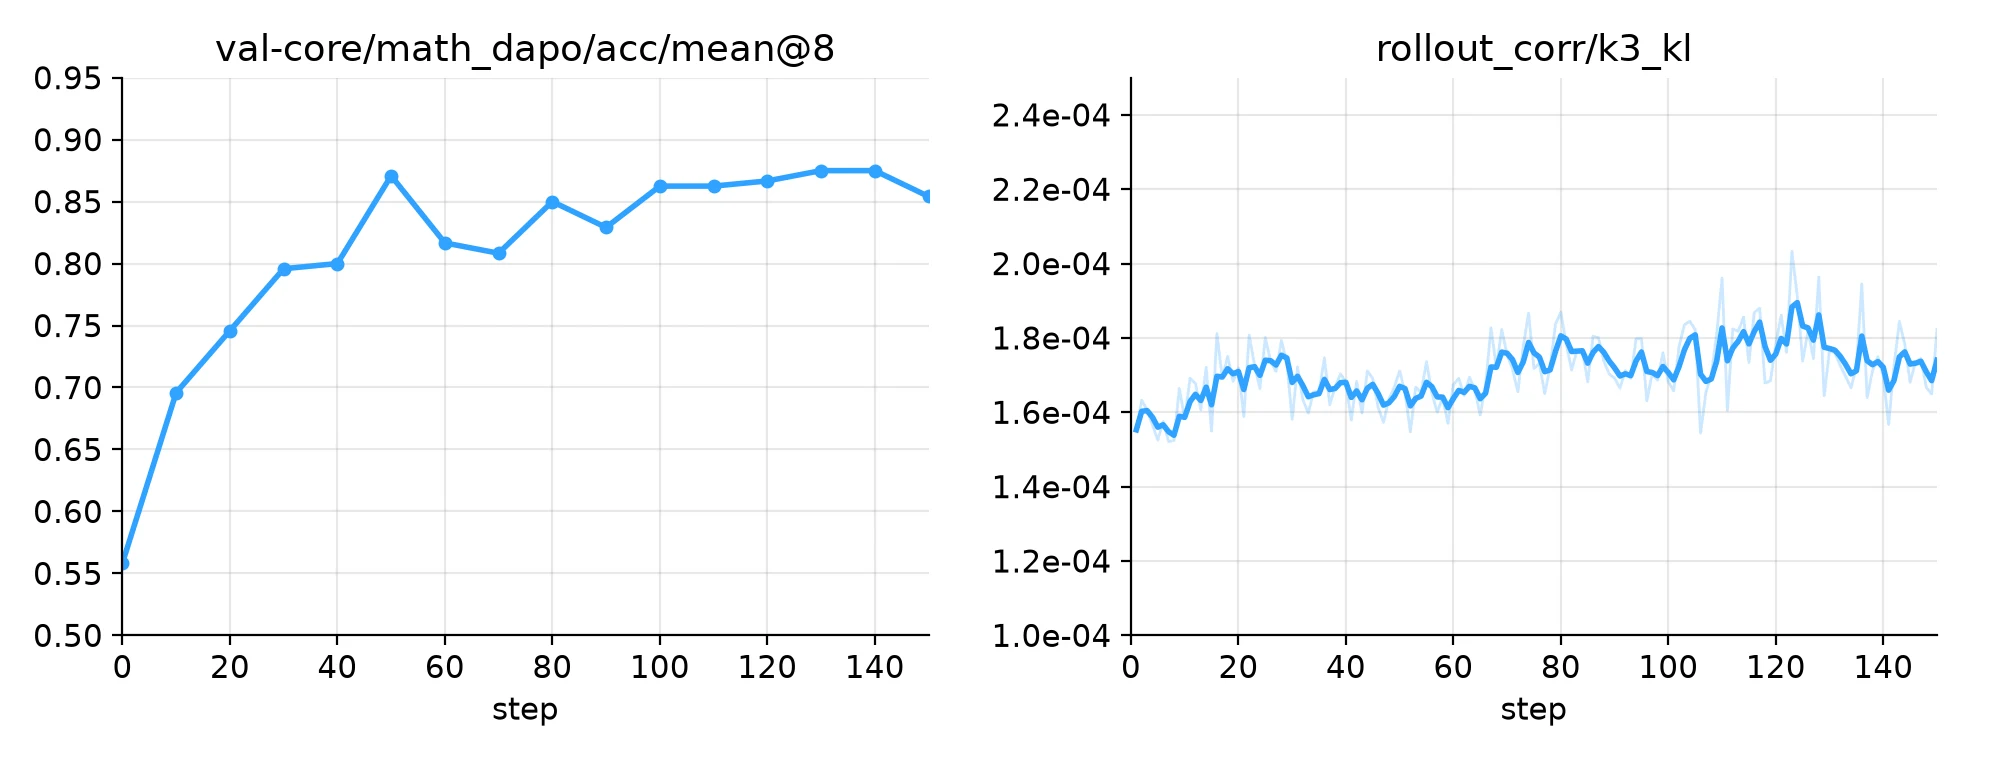
我々は DAPO-Math-17K で GRPO を用いて、16 枚の GB300 GPU 上で 150 ステップ訓練しました。ステップごとに 32 プロンプトそれぞれに対して 8 応答をサンプリングし、応答あたり最大 4K トークンとしました。AIME-2024 での精度(mean@8)は、訓練前の 0.56 から実行終了時に 0.85 に向上しました。実行全体を通じて、トレーナーと vLLM の対数確率間の k3 KL は 2×10⁻⁴ 付近に保たれました。詳細は次をご覧ください: https://github.com/verl-project/verl/pull/8257。vLLMエコシステムにおいて、Titan RLもロールアウトエンジンとしてvLLMを使用し、day-0でのRLサポートを提供しています。
謝辞
Muse Spark Open の vLLM における Day 0 サポートの提供にあたり、緊密な協力をしてくださった Meta Superintelligence Labs のチームおよび vLLM コミュニティに心より感謝申し上げます。また、DSpark スペキュレータのトレーニングと TPU 統合を行った Inferact、そして重要なハードウェア最適化を提供してくださった NVIDIA と AMD にも感謝いたします。
貢献者:
- Inferact: Jie Li, Zifeng Mo, Zixi Qi, Jeff Ma, Ziqi Zhao, Dakai An, Ao Shen
- Meta: Beto de Paola, Sidhartha Reddy Potu
- Nvidia: Cyrus Chang, Duncan Moss, Marek Pikulski, Seong Hee Lee
- AMD: Andy Luo, Hongxia Yang, Haichen Zhang