
量子位智库
公式アカウントAI123All
この1年間、「全面的にAIを拥抱する」と声高に叫んでいない企業は、ほとんど存在しなかった。
Chatbotを導入し、Agentも使い始め、社内報告では「効率がXX%向上」という数字がますます見栄えよくなくなっている。
しかし、業務責任者に素朴な質問をしてみるとどうだろう——欠品は減ったか?納期は速くなったか?顧客満足度は上がったか?その答えは、必ずしも確かなものではないことが多い。
実際のところ、大多数の企業の知能化転換は、集団として「偽りの繁栄」に遭遇している。私たちはAIを個人の生産性向上ツールとして扱うことに慣れてしまったが、ある残酷な真実を見落としている。
個人のタスクの高効率化は、企業経営価値の実現とイコールではないのだ。
AIが本当にデータ、判断、行動、そしてシステム制御の全バリューチェーンのクローズドループを打通できなければ、企業の知能化は永遠に規模化応用のラストワンマイルで足止めされたままになる。
エンタープライズAIの後半戦は、一体どうやって突破口を開けばよいのか?Agentはどのようにして本当に業務の毛細血管に深く入り込み、未来に向けたシステマティックな再構築を完成させることができるのか?
このほど、量子位智库はレポート『Agentが駆動する企業の知能化:単点効率化から規模化リシェイプへ』を正式に発表した。このレポートで私たちは、大規模モデル実装の霧を晴らし、企業の知能化計画の新しい解法を探ろうとした。
AIは使われているが、どこでつまずいているのか?
企業のAI実装プロセスでつまずきやすい箇所は、一つのシナリオでつなげて見ることができる。店舗の欠品リスク対応。
同じ経営分析アシスタントでも、技術チームはレポートが生成されれば完了と考え、業務担当者は原因が究明されて初めて説明になったと考え、経営者は欠品が実際に減ったかどうかを気にしている——三者三様の完了基準がまるで噛み合っていない。
データ面にも同様のずれがある。帳簿上は在庫が表示されているが、割り当て済みや凍結分を差し引くと、実際に動かせる量とシステム上の数字にはかなりの差がある。AIが帳簿上の数字で判断すれば、出発点からして狂っている。
仮にデータが正確で分析が正しくても、提案から実行までの間には、手作業での入力、承認の提出、配送の追跡という一連の流れが横たわっている。提案がシステムに入ったからといって仕事が終わったわけではなく、また完了状態をAIに返信できるかどうかが、タスクのクローズドループを真に閉じられるかを決める。
まして、一つひとつの操作の裏には誰が発起する権限を持ち、誰が承認し、問題が起きたとき誰が引き継ぐのかという権限と責任の問題が関わっている。
この種の断点は全部で六つに帰納される。タスク定義、データの信頼性、判断の検証可能性、行動の実行、権限責任の分担、そして価値の測定と複製。
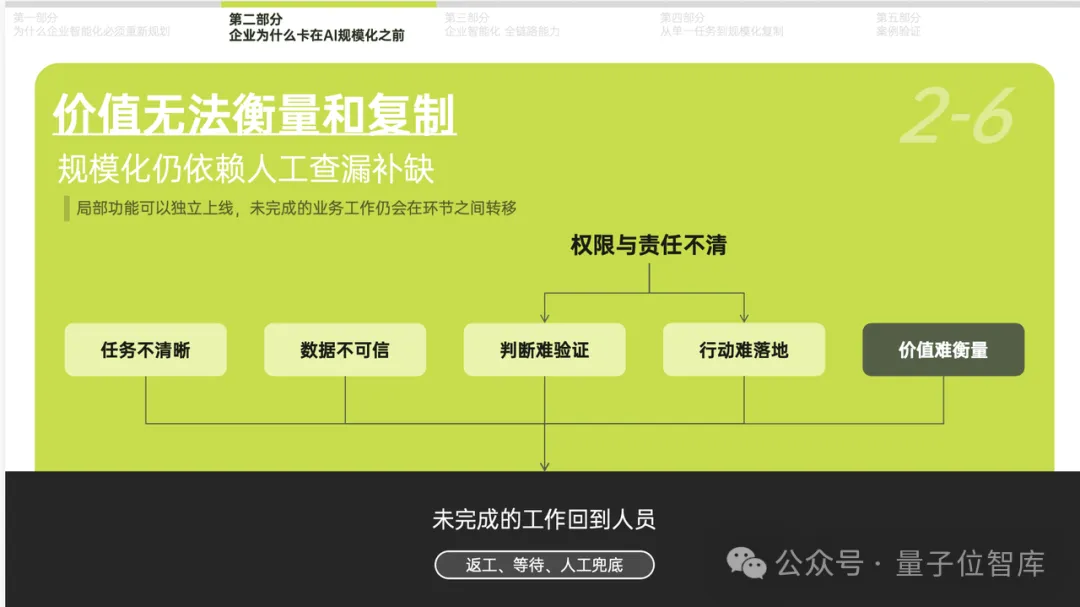
それぞれ単独で見れば致命的ではないが、つなげて見れば、多くの企業のAIプロジェクトが「部分的には使えるのに、全体的には推進できない」状態で止まっている理由を説明できる。
これら未完了の仕事は、結局また人間の手に戻り、長い手戻り、待ち時間、そして救済対応へと変わっていく。
では、企業は一体どうすればこれらの盲点をシステマティックに解消できるのか?
業務成果を中心とした全バリューチェーンのフレームワーク
既然部分的細かな修正では根本的な問題を解決できないのであれば、企業はどのようにして実効性のあるインテリジェント化のソリューションを再構築すべきなのだろうか。
量子位智库は報告書の中で、成熟したエンタープライズ級のAgentは決して孤立した質問応答ツールではなく、必ず備えるべきだと提唱した。貫通タスク、コンテキスト、判断、行動、制御と測定の「フルチェーン能力」。
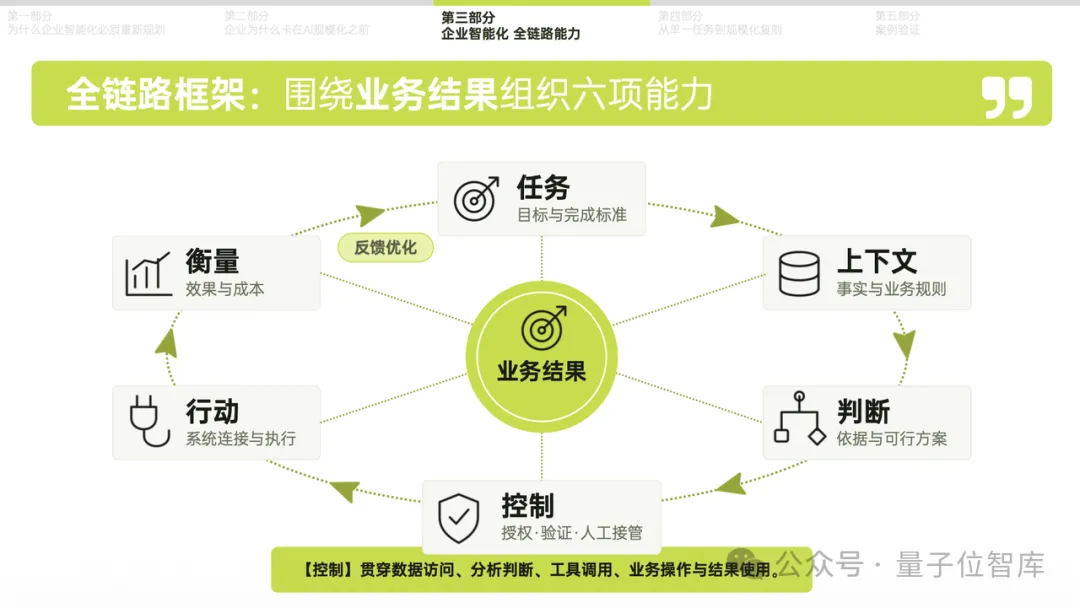
その中でも、すべての知的意思決定の出発点は、データサイロを打破し、構築することにある。真に信頼できるコンテキスト環境。
多くの場合、AIがビジネス分析において「あまり賢くない」と見える根本的な原因は、基盤となるデータとビジネスセマンティクスの乖離にある——フィールド定義が混乱し、バージョンごとの基準が一致していないため、AIが信頼できる結論を導けないのは当然である。
Agentを真に業務を理解する「参謀」にするためには、まずデータを単なる「検索できる」状態から全工程にわたる「信頼できる」状態へと進化させなければならない。
この点において、いくつかの先行する技術実践は業界に良い手本を提供している。例えば網易智傘(NetEase智企)傘下のデータインテリジェンスブランド数帆、その開発・ガバナンス統合プラットフォームを通じてEasyData,データ開発、品質、セキュリティとビジネスガバナンスを深く融合させ、Agentに高品質で追跡可能なアセットセマンティクスを安定して供給してきた。
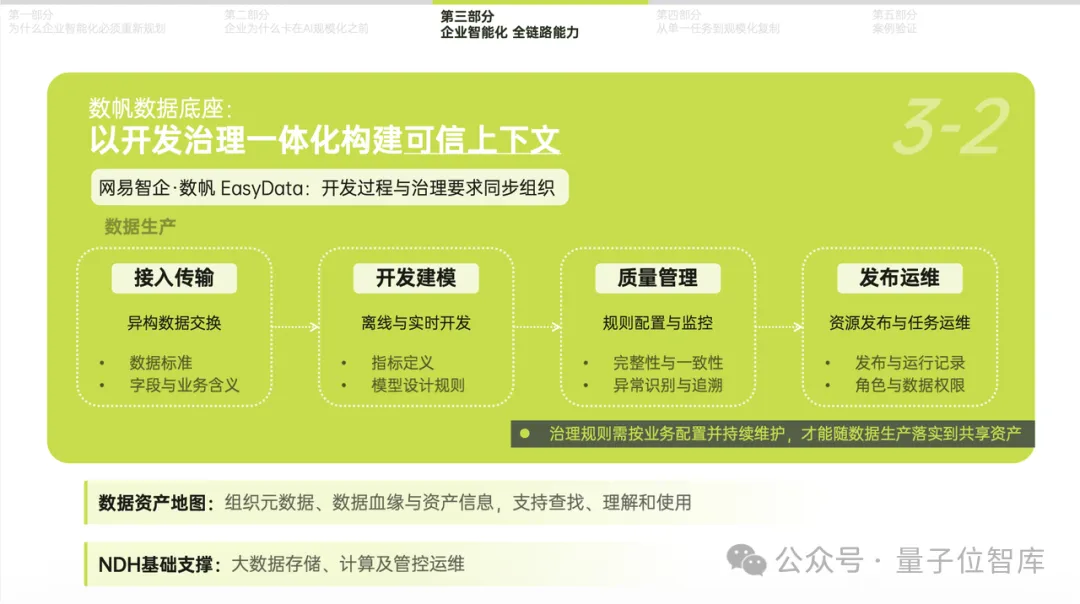
これを踏まえ、NetEase智企・知数DataAgent,企業は分散した指標、ナレッジベース、自然言語クエリをシームレスに連携させることができ、AIにビジネスの言語を本当に理解させることができます。
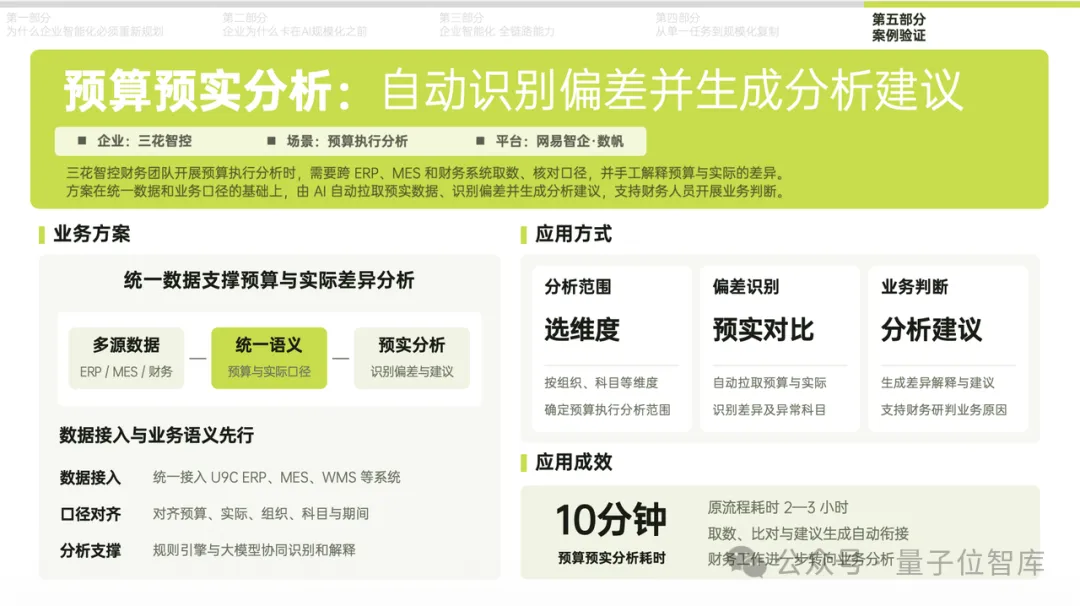
実際の展開において、このような全チェーンの連携がビジネスの潜在力を解放し始めています。例えば三花智能制御を例に挙げると、数帆が基盤層でデータとセマンティックの基準を統一することにより、AIは予算の実績データを自動で取得して偏差を識別できるようになり、従来2-3時間かかっていた予算分析を大幅に10分まで短縮し、財務チームは重いレポート処理から深い業務分析へとシフトできるようになった。
一方、知能化が分析・意思決定からさらに奥のソフトウェアエンジニアリングとアプリケーションデリバリーへと進むとき、新たな課題が現れる:Coding Agentがアプリを開発する際の要件のズレやフロントエンド・バックエンドの連携テストに時間がかかる問題をどう回避するか?
注目すべき変化の一つは、企業がAI開発を「自由な生成」からより制御可能なエンジニアリングプロセスへ引き戻そうとしていることだ。
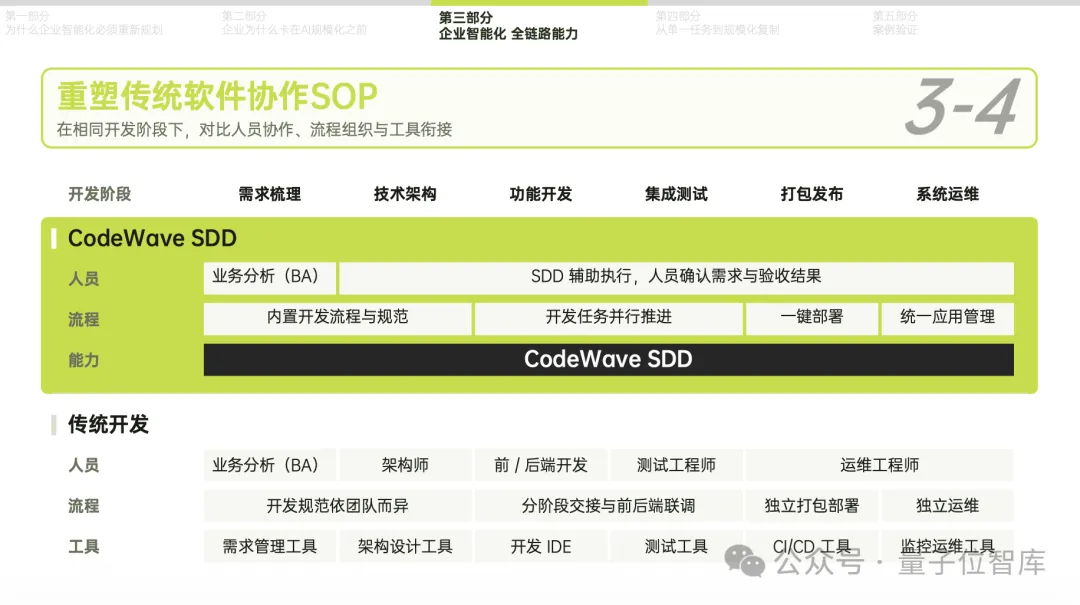
例として、網易智企·CodeWave のSDD(仕様駆動開発、Spec-Driven Development)を挙げると、その核心的な考え方はAIに直接「書かせる」ことではなく、デリバリーを要件、アーキテクチャ、開発、テスト、リリース、納品の多段階に分解し、段階ごとに伝達していくことである:
業務要件はまず構造化された仕様に変換され、次に技術設計とタスク分割へと導かれ、最後にコード生成に入る。
各段階には明確な入出力と検証のチェックポイントがあり、要件の明確化から開発、テスト、リリースに至る全プロセスが常に制御可能で追跡可能になる。
この「段階的伝達」は、市場でよく見られるSDDソリューションの3つの断絶点にちょうど対応している:仕様の書き方が標準化されておらず、明確化のメカニズムが欠けているため、大規模モデルにとってはソフトな制約にすぎない。要件が複雑になるとコンテキストウィンドウを圧迫し、忘却やハルシネーションを引き起こす。さらに能力が開発の一段階しかカバーせず、要件とデリバリーの両端が手薄になる。
CodeWave SDDはこれらを一つずつ補完し、EARSで要件フォーマットを標準化し曖昧さを明示的に明確化し、モジュール分割と細粒度のサブタスクでコンテキストを分離・部分化し、要件、設計、コーディング、テストからリリースまでを多役割協働のエンドツーエンドのチェーンとしてつなぐ。
この方式はすでに実際のプロジェクトで効率面の価値を示し始めている。たとえば、スペース数智科技は新エネルギーCRMプロジェクトで開発期間を60人日から16人日に短縮した;上海企通数字科技はBIMSシステム開発で約2.5倍の効率化を実現し、機能の初回稼働率は78.63%に達した。
Demoを1つ動かすのは簡単だが、100回複製してこそ本物の実力だ
フレームワークができたら、次の問題はどう始めるかだ。
多くの企業はパイロットを展開し複数ラインで並行して進めているが、量子位智库(量子ビットシンクタンク)の助言は次の通り:まず高価値のシーンを一つ選び、クローズドループを回しきってから、拡張を検討する。
シーン選定には5つのスクリーニング軸がある:
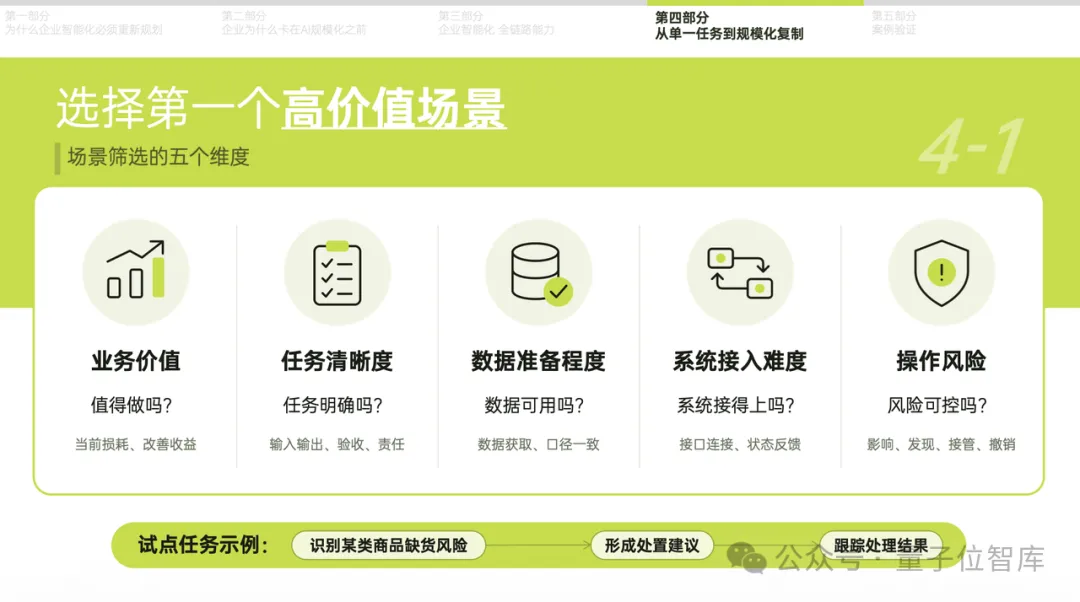
常識のように聞こえるが、実際には多くのチームが逆を行っている——技術的に簡単にできるものから手をつけ、終わってみると業務価値が低く、展開する動力も失われる。
シーンを決めた後、パイロット段階でやるべきことは想像以上に細やかだ。
既存プロセスのどの環節をシステムに任せ、どれが依然として人手での確認を要するか、例外時はどう処理するか、これらは単純に重ねるのではなく再設計が必要だ。
陥りやすい落とし穴の一つは、旧プロセスをすべて残したままAI結果のチェックを余分に加えることで、結果として全体の投資がかえって増えてしまうことだ。
パイロットが終わると、企業はしばしば3つの選択肢に直面する:
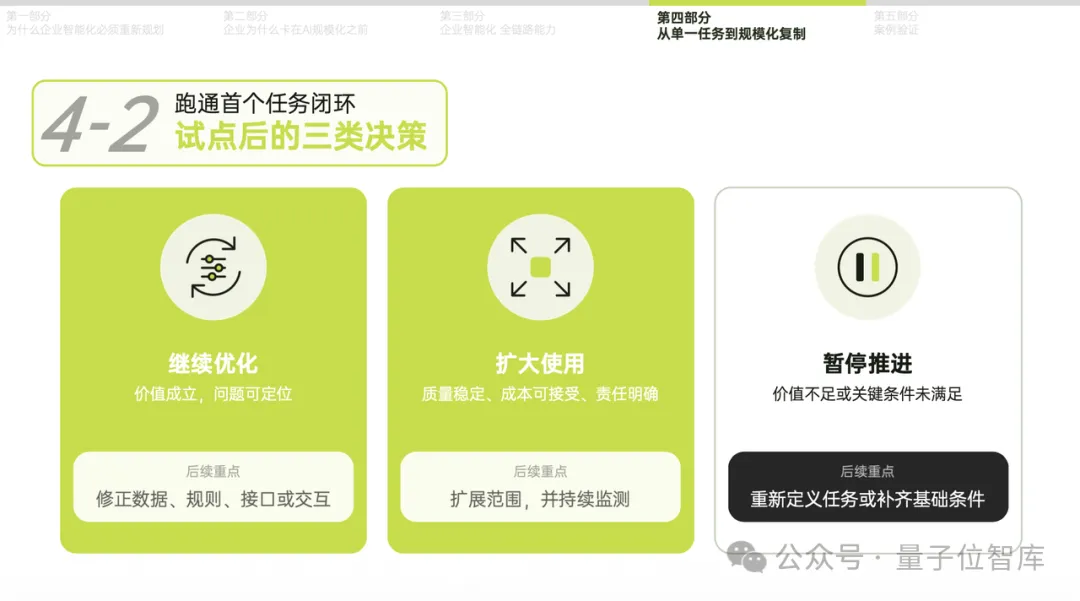
しかし、企業が本当に「1」から「100」へ進めるかを決めるのは、この後にある——最初の成功から得た経験を、繰り返し再利用できるインテリジェンス資産として蓄積することだ。
たとえば、すでに検証済みの指標の定義、インターフェースコンポーネント、承認ルール、例外サンプルなどは、シーンが変わるたびに一からやり直す必要はない。新しいタスクはこれらの共通能力を直接再利用し、具体的な業務に応じて必要な調整だけを行えばよい。
したがって、スケール化された複製の本質は、2回目、10回目、100回目の構築時に、いずれも前回の基盤の上で前へ進み続けられるようにすることだ。
完全なレポートを無料で入手
企業の知能化が今日に至り、差を生んでいるのは、実は企業がモデルの能力を業務、組織、プロセスにつなげ、最終的に目に見える経営成果へ変えられるかどうかなのである。
優れたインテリジェント化の計画は、決してツールから出発するものではなく、「業務の結果から遡って考える」必要がある。そして未来に向けたAgentの核心はむしろ「人は境界を定め、AIが推進する”。
このレポートが提供しているのは、まさにそうした問題の診断からフレームワークの構築、実装検証までの完全な考え方。
である。AIのパイロットを推進している業務責任者であっても、「AIで効率化を」と求められながら成果の測り方がわからない技術チームであっても、あるいはスケール段階で多方の役割を調整する必要のある管理者であっても、おそらく現在の段階に対応する参考情報をこの中に見つけられるだろう。
多くの細部、たとえばタスクの完了基準をどう定義するか、ビフォー・アフター比較の測定方法をどう設計するか、パイロットの成果を再利用可能な資産としてどう蓄積するか……といった点は、記事内では一つひとつ展開されていないが、それこそがあなたがいま行き詰まっている环节かもしれない。
完全なレポートは下記のリンクから無料でダウンロードできます:
https://jkhbjkhb.feishu.cn/wiki/W5D7wuDcbiPXDLkaRLQcAJpOn8f