
IT之家 10 月 16 日付の報道によると、アント百靈は昨日、Ling-3.1-flash モデルのオープンソース化を発表した。Ling-3.1-flash は総パラメータ約 560B、Token ごとの活性化パラメータは約 25B、最大 1M コンテキストに対応する。
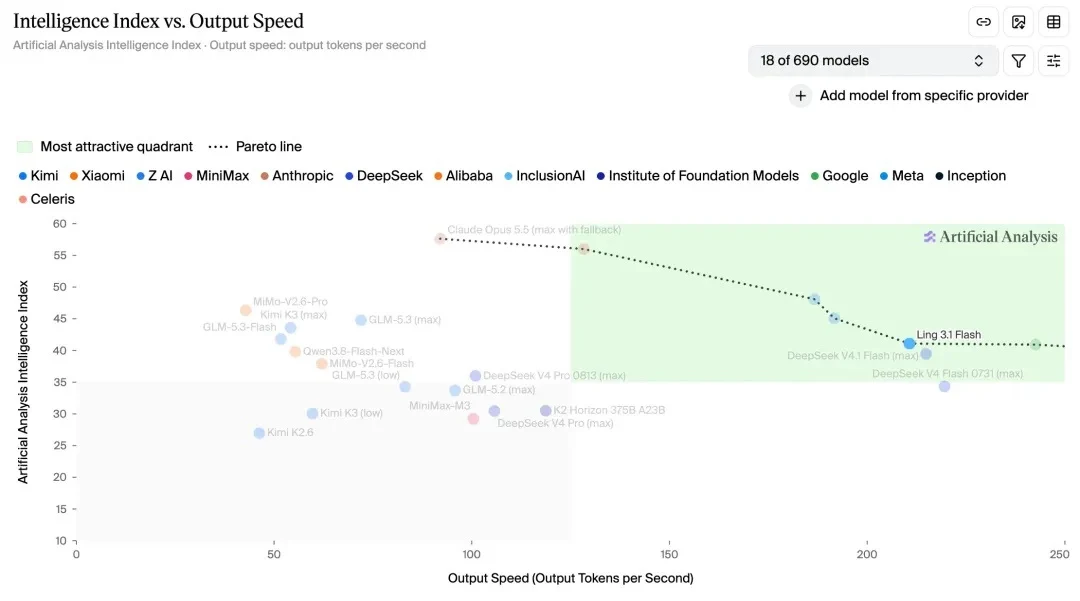
Artificial Analysis の公開評価では、Ling-3.1-flash の知能指数は 41、出力速度は毎秒約 210 Token となっている。
ローカルデプロイメント向けに、チームは routed experts に MXFP4 量子化を適用し、dense 層は block-FP8 を維持することで、重みの占有容量を約 534GB から 292GB に削減した。対応する Hopper GPU テスト構成では、サービスデプロイメントが 8 枚から 4 枚に削減され、サーバークラス GPU を保有するチームがより少ない枚数でモデルを実行できる。実際の必要枚数はコンテキスト、同時実行数、サービス構成によって変わる。
長文資料処理向けに、チームは長コンテキスト並列推論ソリューション(PCP / DCP)を提供している。ツール呼び出しも JSON Schema への対応を強化し、既存の業務インターフェースとの接続を容易にした。
企業のナレッジ Q&A やオフィスアシスタントでは、長い資料を先に読み込む必要があることが多く、ユーザーはできるだけ早く応答を見たいと期待する。チームは演算子融合と DSpark 投機的デコードにより推論オーバーヘッドを削減した。平均入力約 25.47K Token、出力約 224 Token、キャッシュヒット率 76% の模擬本番リクエストにおいて、8 枚の Hopper 構成での平均初回 Token 時間は 604 ミリ秒、隣接する出力 Token の平均間隔は 3.28 ミリ秒だった。これは長文資料入力後のインタラクティブ応答のテスト参考となる。
継続的にサービスを提供する業務システムでは、固定の GPU 予算内で 1 インスタンスがどれだけのリクエストを処理できるかを評価する必要もある。平均入力約 8.5K Token、出力約 800 Token の 4 枚 Hopper スループットテストでは、モデルは約 1.36 QPSを達成し、初回 Token 時間 P50 が 3 秒未満、隣接する出力 Token 間隔 P90 が 70 ミリ秒未満というテスト制約を同時に満たした。これは自己デプロイメントのキャパシティプランニングの参考となる。
オンライン体験面では、Ling-3.1-flash は現在期間限定の 2.5 折(75% オフ)キャンペーンを実施しており、割引後の価格は以下の通り:
OpenRouter(米ドル建て):入力 0.075 米ドル;出力 0.225 米ドル;キャッシュ読み取り 0.015 米ドル。
Ling Studio(人民元建て):入力 0.5 元;出力 1.5 元;キャッシュ読み取り 0.1 元。
IT之家、オープンソースリンクを付す:
Hugging Face:https://huggingface.co/inclusionAI/Ling-3.1-flash
ModelScope:https://modelscope.cn/models/inclusionAI/Ling-3.1-flash
関連記事:
広告に関する声明:本文中に含まれる外部ジャンプリンク(ハイパーリンク、QRコード、口令などの形式を含むがこれらに限らない)は、より多くの情報を伝え、選別の時間を節約するために用いられたものであり、結果は参考情報にすぎません。外部リンクを含むIT之家の記事には、すべてこの声明が含まれています。