
以前にもお伝えしたように、Claude Code自身のコードの約90パーセントはClaudeが書いています。では、あの量のコードをどうレビューしているのでしょうか?今でも誰かがコードを読んでいるのでしょうか?何かが壊れた場合、誰がそれを発見するのでしょうか?
本記事では、Claude Codeチームにおけるコードレビューのフローとその進化について説明します。6月から9月にかけて、Claude Codeのコードベースへのマージされたプルリクエストは2倍以上に増加し、一方でリバートせざるを得なかった割合は40パーセント以上減少しました。
私たちはレビューを廃止したわけではありません。しかし、読む作業の大部分をマシンに移し、人間の時間と注意力に最適化し、ミスを素早く簡単に元に戻せるようにすることに大きく投資しました。
コードレビューの目的の再考
エージェントがコードを書くと、変更の数は急速に増加します。Anthropicのモノレポでは、1日に land する変更数は 5月の約2,500から9月には30,000以上へと 今年増加しました。
Claude Codeはモノレポとは別の独自のリポジトリにありますが、同様に大きな圧力を受けています。これほど速くリリースしていると、手動の行単位のコードレビューは、不可能でないまでも極めて困難です。
コードレビューには2つの役割があります:
- リリース前に問題を発見し修正する
- チーム全体で共有の文脈とコードベースへの理解を築く
本記事では主に問題の発見と修正に焦点を当てますが、2つ目の役割については終盤で改めて触れます。
私たちは「人間がコードを読んだか?」という問いが、「この変更で何が問題になりうるか、そして自動チェックか人間か、どちらのチェックがそれを発見するのに適切か?」という問いの不正確な代理指標だと考えています。
この問いを立てたことで、レビューが いつ 行われるかも変わりました。以前は、レビューは道の終わりのゲートでした:コードを書き、PRを開き、同僚を待つ。
今では、レビューは継続的に実行され、書きながらのスペルチェックのようなものです。ほとんどの変更は、人間に見てもらう前に、少なくとも1回はClaudeによってレビューされ修正されています。これによりほとんどの定型的なミスが捉えられ、チームの注意力はより高度な質問や精査のために温存されます。
希少なリソース:人間の時間と注意力
私たちは、人間にしか解決できない問題のために人間の時間と注意力を温存し、残りは自動チェックに捉えさせたいと考えています。現在の変更のペースでも、人間がやるべき膨大な仕事が依然としてあり、チームはほぼ毎日新しく未知の課題に直面しています。
人間の時間はレビューのコストの両側をカバーします:人々がレビューに費やす時間と、悪いコードが壊したものを修正するのに費やす時間です。前者を削っても、その時間が後者に現れるだけなら意味がありません。
したがって目標は、Claude Codeのリポジトリ(CLI、デスクトップ・Webアプリ、モバイルアプリ)のほとんどのプルリクエストが、著者自身であってもよい最大1人の人間の関与でマージされ、リバートやインシデントが増えないことです。人間の時間を測るために、PRあたりの人間による承認数(中央値と95パーセンタイル)、人間によるコメント数、そしてPRが人を待つ時間を追跡しています。リバート率とインシデント率がガードレールです:これらが上昇すれば、人間の時間を節約したのではなく、移動させただけだということです。
変更のライフサイクル
典型的な変更は、エンジニアのラップトップ(またはSlack上のClaudeセッション)から、複数層のコードレビューを経ていきます。
層ごとに
1. 他の誰かが見る前に、作品は検証済みとなる
現在、レビューの大半はPRが存在する前に発生します。私たちはClaudeに、実行できるもの—テスト、ビルド、あるいはデザインと比較するスクリーンショットなど—を与え、「完了した」と言わせるのではなく、その出力を見せるよう求めます。その後、サブエージェントが新しいコンテキストでdiffをレビューします。どちらの習慣も私たちの ベストプラクティスガイド.
PRを開く前に、私たちの多くはいくつかの社内スキルも実行します。1つはバグを探し、1つはdiffを簡素化し、もう1つは動作をエンドツーエンドで確認します。UIの変更も、当社のデザインガイドラインに照らしてチェックされます。
Claude Codeの開発者であるBoris Chernyは、Claudeに自分の作業を検証する方法を与えることをこう呼びました。 おそらく最も重要なこと 良い結果を得るためのものです。これにより最終結果が2〜3倍良くなると見積もっており、「検証はドメインごとに異なります。bashコマンドの実行やテストスイートの実行ほど単純な場合もあれば、ブラウザやスマホシミュレータでアプリをテストする場合もあります」と書いています。
自動レビュワーが同じ箇所を何度も指摘し続けるときは、ソースで修正します: スキル内で、リントルールで、または以下のような説明ファイルの更新によって:
CLAUDE.mdプロジェクトが何であるかをClaudeに伝えるものです:技術スタック、規約、目標、そして目標外の事項。すべてのレビューでこれが読み込まれるため、大規模なコードベースでは短く保ち、そこから他のドキュメントへの参照を示すようにしています。レビュワーはまた、この文書の規約に反するコードや、文書内の記述を古くさせる変更にもフラグを立てます。REVIEW.md(コードオーナーによって書かれたもの)は、レビュワーに対してコードのその部分で何が重要かを伝えます。レビュワーが実際にそれに従っているかは、別途チェックします。良いものは短いものです。そのリポジトリにおける「失敗」とは何かを述べ(ドキュメントなら「嘘をついていること」、設定なら「誤ったルーティングをすること」)、nits(些末な指摘)に上限を設け、スキップすべきパスを列挙し、名前からの推測ではなくファイルと行を証拠として求めます。さらに、件数で始まる要約を求め、修正すべきものが何もないときはその旨を率直に述べるよう求めます。
2. すべてのプルリクエストに対するAIレビュー
すべてのプルリクエストは、人が見る前にClaudeのレビューを受けます。Claudeはdiffをリポジトリ全体とそのPRの明示された意図と照らし合わせて読み、次の点を問います。その変更は問題を解決しているか、システムに適合しているか、それとも何か別のものを壊していないか?
バグ修正については、根本原因を探します。公開版である Code Review for Claude Codeは、TeamおよびEnterpriseプランで一般提供され、 /code-review はローカルで軽量版を実行します。
私たちが 研究プレビューを開始したとき、実質的なレビューコメントを受け取る社内PRの割合は16%から54%に上昇しました。1,000行を超えるほとんどのPRは指摘を受け、小さいPRのほとんどはクリアです。管理者は各リポジトリをQuick、Standard、Deepに設定できます。見逃したバグ1つのコストが追加のレビュー時間を上回る場所では、Deepにする価値があります。
指摘は、人が確認する前に他のエージェントによって検証されます。 複数のエージェントが同時にバグを探します。その後、別のグループが各指摘について投票し、十分な数が本物だと同意した場合にのみ投稿されます。スタイル、診断、クリーンアップのみに関する指摘は破棄されます。これらのフィルターは、採用前に自社のPRでA/Bテストしました。残ったものは重要度順に並べられたインラインコメントとして表示されます。それぞれにImportant、Nit、Pre-existingのタグが付けられ、そのPRが持ち込んでいないバグが作成者のせいに見えないようにしています。
すべての指摘には回答が必要です。 修正するか、理由を添えてスレッドを解決します。多くの場合、エージェントが一晩で修正を引き受けるため、作成者はすでにもう一段階のレビューを経たPRに戻ってきます。
3. ブロックできるセキュリティレビュー
セキュリティにも専用の自動レビューがあります。バグレビューまたはセキュリティレビューによる指摘が1つでもオープンのままである間、PRはマージできません。修正するか、短い理由を添えてスレッドを閉じます。後者が誤検知を解消する方法です。
後のコミットで問題が修正された場合、指摘は自動的にクリアされます。同じ仕組みは、オープンソースのセキュリティレビューGitHub Actionや /security-review コマンドでセットアップできます。セットアップ方法については automated security reviews in Claude Code.
4. ブロックする自動チェック
通常のものです:lint、型チェック、全プラットフォームでのテスト、そしてビルド。(このボリュームに対応するためのCIのスケーリングについては こちらで書きました。)典型的なCLIのプルリクエストでは、誰かが見る前に数十のチェックが実行されることがあります。PRテンプレートでは、変更がどのようにテストされたか、そして元に戻す方法を尋ねます。Claudeがこれを記入することもできますが、変更を依頼した人が承認(サインオフ)します。
5. リスクに応じて変動する人的承認
ドキュメントの修正と自動アップデータの変更ではリスクが異なるため、レビューの重さも異なります。
| リスク | 例 | 人的承認 |
|---|---|---|
| 低 | ドキュメント、コピー、内部専用機能、フラグの背後にある追加的変更 | 自動レビューとセキュリティチェックがグリーンになれば不要 |
| Medium(中) | 通常の製品変更、およびキャッシュ、自動アップデータ、システムプロンプトなどの機密性の高い領域への変更 | 1人 |
| High(高) | 最もリスクの高いコード、および常に2人を必要とする少数のパス | 2人 |
ティアを決めるのは変更内容であり、作者ではありません。 分類器が変更を読み取ってリスクティアを選びます。第2の分類器は、ティアが別の人を必要としないと判定した場合でも、この特定の変更にもう1人の人物が必要かどうかを判定します。一部のパスは常に人を必要とします。オーナーが機密として列挙したものすべて、および任意のCIワークフローファイルがそれに該当します。
より軽いパスを利用できるのは信頼された作者のみです。 より軽いパスを利用できるのは、リポジトリの信頼リストに載っている作者、主にそのリポジトリを所有するチームのみです。それ以外の全員は承認のために2人目を必要とします。エージェントによる承認は、いかなる場合も人の承認として数えられません。自動レビューは低リスクの変更をクリアできますが、人を必要とする枠を埋めることはできません。
変更を指示した者は、その変更に対して責任を負います。 エージェントが書いたPRでは、エージェントに指示を出した人が必須レビュアーの1人として数えられ、自分でコードを書いた場合と同様に扱われます。
承認は1つの特定のコミットにのみ適用されます。 システムが保証できない新しいコミット、たとえばエージェントによるプッシュや誰かが手動で解決したマージが届いた場合、承認を改めて与え直さなければなりません。
6. マージキュー、フラグ、段階的リリース
マージキューは、変更を適用した状態でmainに対してすべてのチェックを再実行するため、個別には合格した2つのPRが組み合わさって壊れたmainになることはありません。新しい動作は通常、まずフラグの背後でAnthropicの従業員に展開され、私たちのヘビーな利用によって、ユーザーよりも先にリグレッションが表面化することがよくあります。公開リリースはまず latest チャンネルに展開されます。 stable チャンネルはそれに続きます。
7. 高速な検出、高速なロールバック
それでも一部のミスはすり抜けるため、最後の層はそれらを素早く捉えることにあります。フラグはデプロイなしでオフにできます。Claude Codeには週次のオンコールローテーションがあり、インシデントレビューではどの層が問題を捉えるはずだったかを問います。
悪いマージに気づくことは依然として、作成者とオンコール、さらにrevertとインシデントのダッシュボードに依存しています。それらの数値が動いた際に承認を厳格化するサーキットブレーカーはまだなく、ここでは、より多くのコードが人間ゼロのマージに移行する前に、エンジニアたちはそれを求めています。
ある同僚は、速度を落とすことは確かにエラー率を下げるが、それは主にすべての作業量が減るためだと言いました。私たちは、問題に気づき修正する速度を上げたいと考えています。
レビュアーをどう改善しているか
私たちのコードレビューのプロセスは、ループの中で絶えず改善されています。
インシデントはすべて、今ではevalになっています。 チームは、インシデントを引き起こした過去のPRを、そのfix-forwardとrevertとともに収集し、そのコードを知るエンジニアに各バグとその所在を確認させました。レビュアーは毎日、そのセットに対して実行されます。
私たちは、人々がコメントにどう対応するかを見ることでノイズを測定しています。 多くの非バグを指摘することを気にしなければ、より多くのバグを捕捉するのは簡単です。そのため、それに対するチェックが必要です。レビュアーが残したすべてのコメントを、PR上の人がどう応答したかで分類します。修正した、間違いだと言った、その動作は意図的だと言った、重要ではないと判断した、のいずれかです。また、クリーンであると分かっているPRにもレビュアーを実行し、有害な変更をするよう人を導きかねないものを報告する頻度を数えています。私たちの優先順位は書かれており、まず本物のバグを捕捉すること、次にレビューラウンドを削減することです。
作成者がエージェントの場合、ノイズのコストはさらに高くなります。人は些細な指摘を数秒で受け流せます。エージェントはそれを修正するため、別のコミットと別のレビューラウンドが生じます。
レビューは収束しなければなりません。 エージェントの作成者とエージェントのレビュアーは、互いを無限に忙しくさせ合えます。あるCLI PRは、作成者が止めるまでに、一晩で50回以上のレビューと修正のラウンドを経ました。
レビュアーが指摘し続けていた箇所にgit blameを実行したところ、その約59%がレビュアーの最初のパスの時点から存在していたコードでした。レビュアーは新しいバグを見つけているのではなく、各ラウンドで古いバグを少しずつ追加で見つけていたのです。
私たち自身がそれを悪化させていました。各パスが何か新しいものを捕捉するため、デフォルトで複数ラウンドを実行することに慣れていたのです。リスクの高い変更ではそれが価値を持つこともありますが、すべてのPRでそうであるべきではありません。チームは現在、recallとともに合格までのラウンド数を追跡し、再レビューを変更しました:
- ラウンド上限。 3ラウンド後、レビュアーは作成者に一歩引いてアプローチを再考するよう求めます。
- 最初の数パス以降は 差分のみの再レビュー
- バグのクラスを指摘し、 作成者が1行ではなくすべてのインスタンスを修正するようにする。
- すでに投稿された指摘の 繰り返しはしない。
レビューエージェントはまた、既存のコードに対しても夜間に実行され、古いバグが別の場所に現れる前に捕捉する助けとなっています。
人間がループ内に留まる場面
シニアエンジニアを深い作業から引き離してルーティンなミスを捕捉させることは、自動レビューよりはるかにコストがかかります。Anthropicでは、私たちの仕事はすべてのdiffを読むことから、機械が苦手とする判断へと移りました:
- そもそもこれは作るべきか? 方向性、センス、スコープ。レビューのボトルネックは解決したと宣言したあるチームでも、チーム外からの変更については人間によるレビューを続けており、誰かが「そもそもこれはやるべきか?」と問うようにしています。
- リスクの高いコード たとえば課金、自動アップデーター、CIワークフローなどです。
- アーキテクチャ 他の人が真似するパターンを定めるもの。
- 証拠を読むこと。 テスト出力、実行されたコマンドとその返り値、スクリーンショット、レビュアーの所見。チェックが何を見逃しうるかを言えないなら、手早い承認ではなく実際のレビューを求めましょう。
- 結果への責任を持つこと。 誰がタイプしたかにかかわらず、出荷されるすべての変更には人が責任を負います。
チーム全体でコンテキストを共有する
コードレビューの2つ目の役割は、常にコードベースへの理解を広めることでした。チームメイトのdiffを読むことで、何が変わったのか、そして各部分がどう組み合わさっているのかを学べます。もし機械が読み物の大部分を担うなら、人はどうやってコードを学ぶのでしょうか?
私たちには、そのための正式なプロセスはありません。チームの誰もClaude Codeの完全な全体像を頭の中に保持しているわけではなく、誰もその必要はないと考えています。コードベースの一部を理解したいときは、その特定のスライスについてClaudeに解説文を書かせます。数分で完了し、今日現在のコードそのものを反映したものになります。
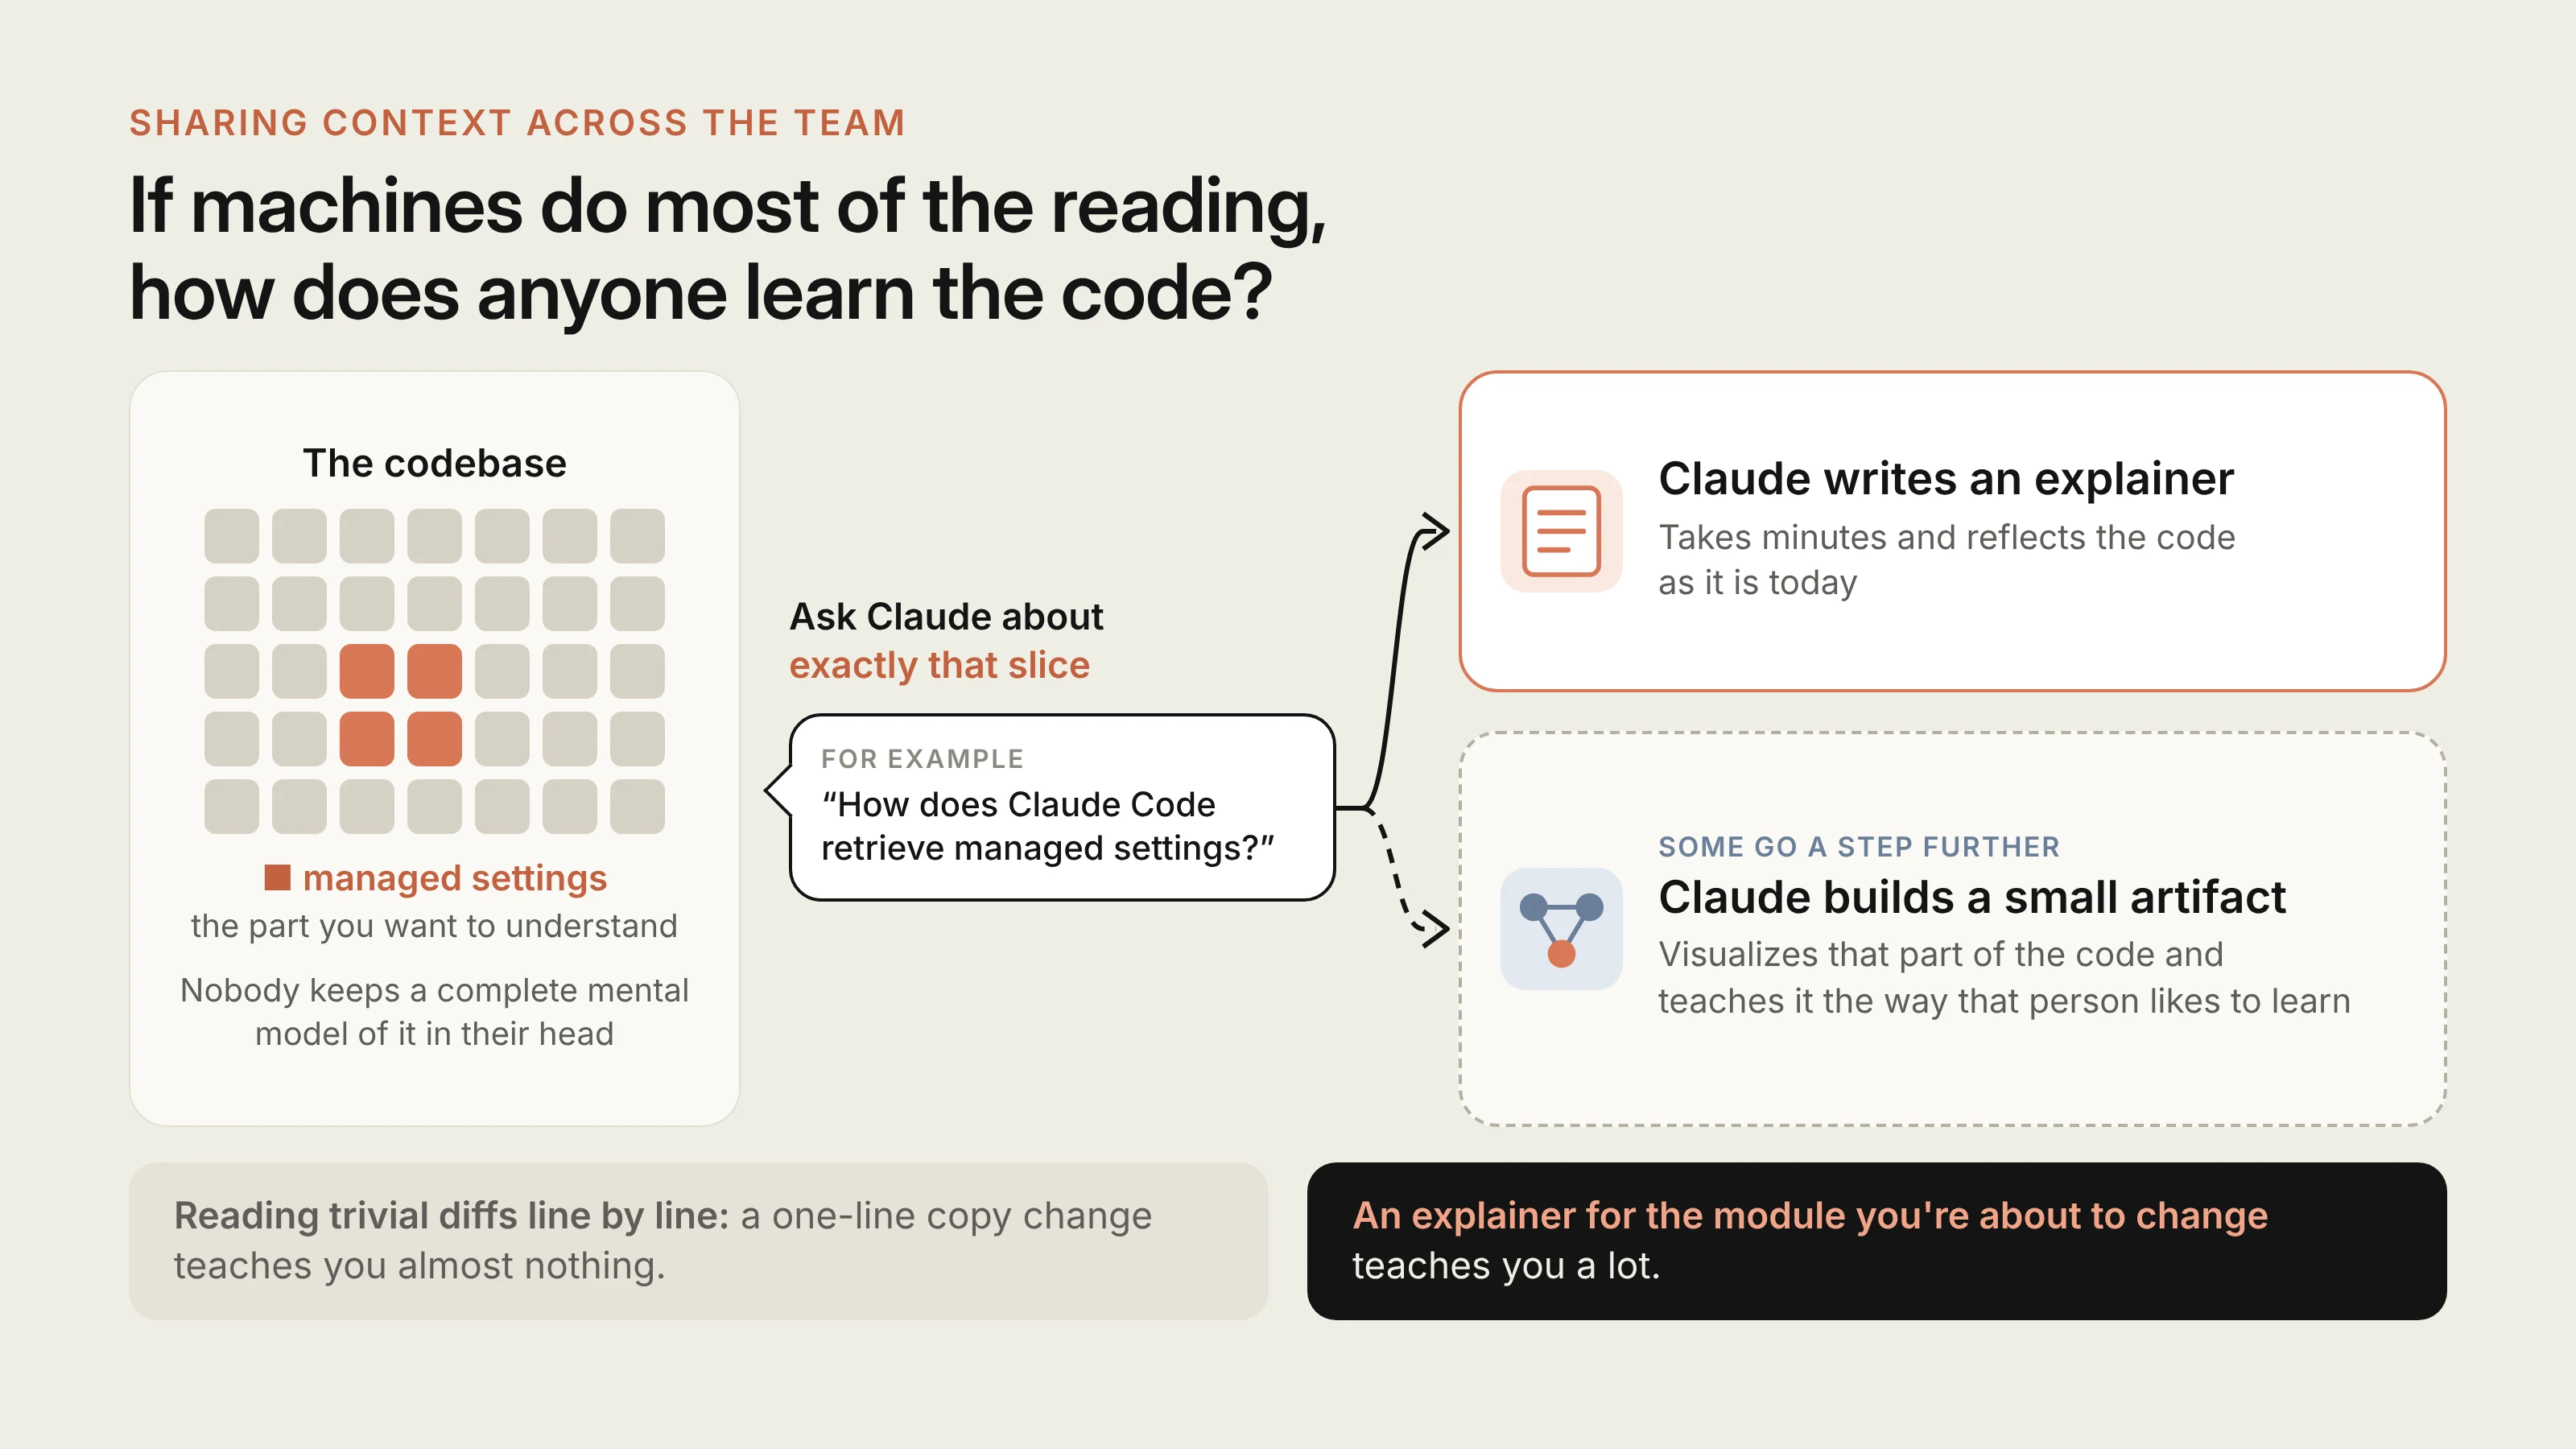
さらに一歩進んで、Claudeにそのコードの該当部分を可視化する小さなアーティファクトを作らせ、その人が好む学び方で教えてもらう人もいます。
人間の注意をうまく使うことが目的なら、些細なdiffを一行ずつ読むよりも、こちらの方が優れています。一行のコピーチェンジから学べることはほとんどありません。これから変更しようとしているモジュールの解説からは多くのことを学べます。デフォルトでオープンなSlackチャンネルで作業するという私たちの文化も役立っています。他の人が何を作っているのかを、その作っている最中に見ることができるからです。
「着陸させたら、その所有者は君だ」
小規模〜中規模の変更をマージした後に何か問題が起きた場合、通常は自分で修正するのがチームの慣習です。これが悪い結果にならないようにするいくつかの取り決めがあります。
- 変更は小さいが、 そのため、レビュー、デバッグ、そして取り消しが容易に行えます。
- すべては元に戻せます。 フラグ、リバート、段階的リリースにより、ほとんどのミスは数分で元に戻せます。
- 破壊半径が基準を決める。 高価なコードには、より多くの人手とより多くのチェックが必要になる。
- リグレッションはすぐに表面化する テレメトリおよび内部利用を通じて。
- それは責めているのではありません。 修正を担当した人は最も詳しい状況を把握していることを意味し、インシデントレビューはシステムそのものを検証します。
所有権も共有されています。チームの多くは〜で働いています。 開水路 誰もが他人が作っているものを見たり、スレッドを拾ったり、Claudeを未着手の部分に向けたりできる場所であり、フィードバックはコードの所有者でない人からも届きます。その開放性こそが、すべての行にゲートを設けなくても品質を高く保つ大きな要因です。
進路を変えるとき
エージェントによって物事を始めるコストが下がるため、中には取り込むべきでない仕事も生まれます。通常はチャンネル内の誰かが理由を問い、以前の決定を指摘したり、よりシンプルな方法を提案したりし、作者がPRを閉じるか形を変えます。
コードを書くのが速かったので、PRをクローズしても損には感じられません。コツは、完成したPRへのブロッキングコメントとしてではなく、スレッドの中で早い段階に別の方向性を提起することです。
このプロセスを導入する方法
これを自分のチームで行うための要素の大半は、すでに存在しています。
プルリクエストの前に
- エージェントに実行可能なチェックを与え、短い
CLAUDE.md、さらにフォーマッタやリンタを実行するフックも含まれます。 - 実行
/code-reviewおよび/security-reviewローカルでの確認、または新しいコンテキストのサブエージェントによるレビュー。 - 追加
REVIEW.md保存し、繰り返し表示されるレビューコメントをそこに移動してください。
すべてのプルリクエストに対して
- CI を必須にし、PR テンプレートに「Testing」「Risk」「How to revert」を追加しましょう。
- 1 つのリポジトリに AI レビュアー(Code Review for Claude Code、または Claude Code GitHub Action)を追加し、
REVIEW.md数週間調整してから、対象を広げましょう。 - 自動セキュリティレビューを追加し、マージ前にすべてのレビュースレッドの解決を必須にしましょう。
- レビューの手間をリスクに見合わせます:ルーチンな変更には軽いチェック、見逃しが高くつくバグになり得る箇所には深いレビューを(Code Review では Quick、Standard、Deep)。
- レビューのラウンド数に上限を設けます。最初の数回以降は、新しい差分のみを再レビューします。
承認
- リスク階層を文書化し、作者ではなく変更内容に基づいて設定します。厳しく始めて、根拠ができたら緩めましょう。
- 信頼できる作者には、より軽い承認フローを維持します。
- CODEOWNERS とブランチ保護を使い、認証、課金、CI、リリースワークフロー、およびインストーラーには必ず人間の承認を必要としましょう。
- ボットの承認が必須の人間の承認の代わりになることは決して許さず、新しいコミットがあったら承認を取り消しましょう。
マージとその後
- マージキューの使用、フィーチャーフラグ、まず内部での利用、段階的リリース、そしてワンステップでのロールバック。
- インシデントとリバートを評価セットに変え、レビュワーのプロンプト、ツール、モデルが変わるたびに再スコアリングする。
- 人間の時間を測定し、リバート率とインシデント率をガードレールとする。
これからの方向性
Code Reviewの お知らせ では、プルリクエストの承認は依然として人間の判断であると述べており、この製品は承認ではなく所見を投稿します。私たち自身のリポジトリではさらに進んで、オーナーがどの低リスクの変更を自動チェックだけでマージするかを決められるようにしており、その一線は動き続けています。
レビューで見落としがあったときは、モデルが目の前に持っていなかったものは何かを問い、その修正を CLAUDE.mdやスキル、あるいは新しいチェックに組み込みます。目標は変わっていません。変更あたりの人間の時間を減らし、リバートの数を以前より増やさないことです。
あなたのチームがエージェントにプルリクエストを開かせているなら、どのチェックを自動化したか、どれがまだ人間を必要とするか、そして私たちが何を間違えていると思うかをぜひお聞かせください。
レビューに協力してくれたEmma Webb、Michael Segner、Amie Rotherhamに感謝します。