
IT之家 10月16日の報道によると、テクノロジーメディアのAppleInsiderは昨日(10月15日)に投稿で、アップル研究チームが「Minions」というシステム研究を発表したと報じている。この研究では、使用されていないMac GPUを集約し、動的に調整可能な「仮想GPUクラウド」を形成することで、大規模な機械学習推論タスクを実行することが試みられている。
IT之家がブログの情報を引用して言うには、従来のAI推論は通常、集中型GPUクラスターに依存しているため、コストが高く、拡張が遅く、待ち時間が長いという問題に直面しています。一方で、Macでは日常の作業、ブラウジング、創作の場面で、GPUは長期間空いていることが多いです。
アップル社は論文でMinionsプログラムについて説明し、これらの「見えない計算能力」を再編成することで、追加のGPUを購入せずに、複数のMacが協力してAIタスクを実行できるようにしたいと述べている。
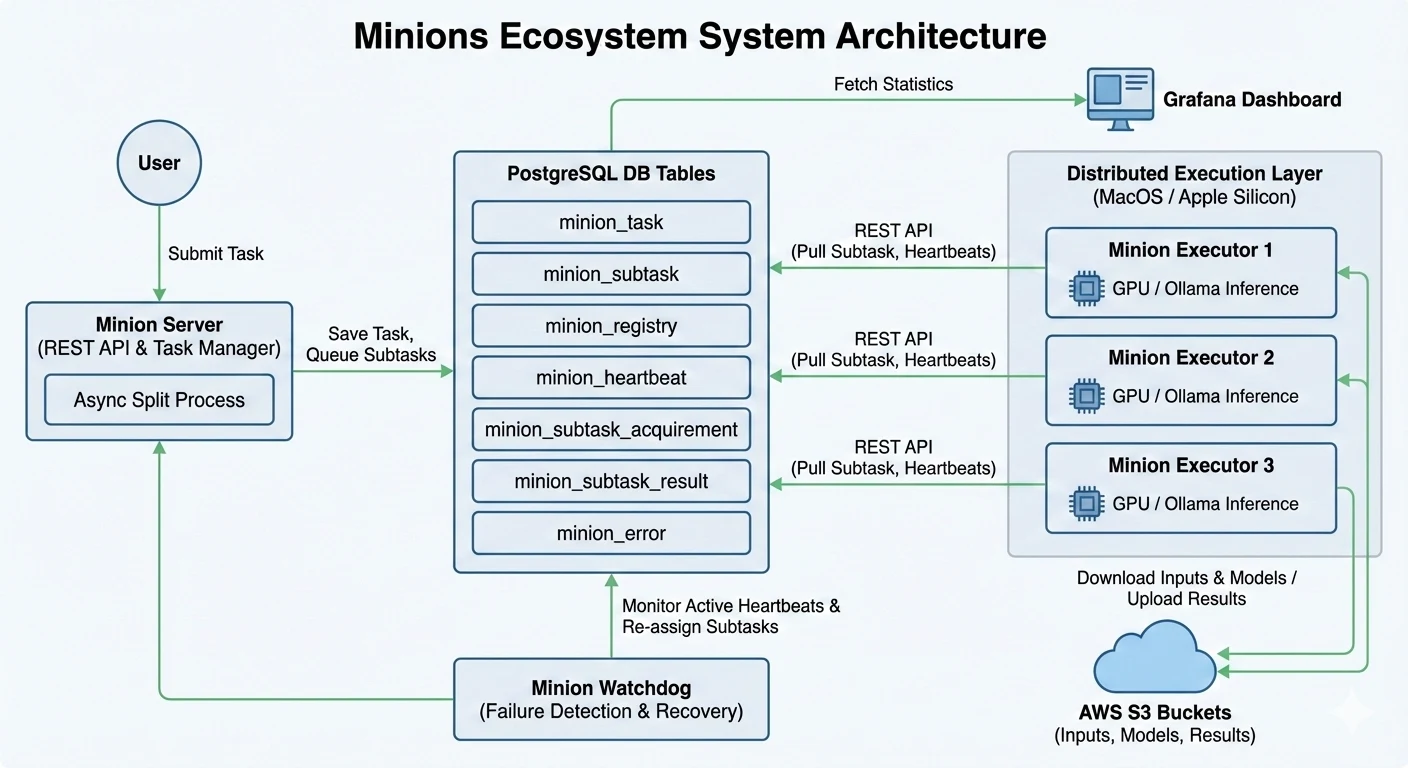
論文の概要によると、システムは4つの重要な部分で構成されている:
Minion Serverは、タスクの受信、個別タスクへの分割、およびスケジュールの調整を担当します;
PostgreSQL データストレージは、タスクとデバイスの状態を記録します;
各macOSデバイス上で実行されるMinion Executorは、Apple Silicon GPUを利用してローカルに推論を行います。
Minion Watchdogは、デバイスの切断、スリープ状態、または電源切断などの状況を監視し、未完了のタスクを別の利用可能なデバイスに再分配します。
技術実装において、Minionsは「引き出し式」タスクモデルを採用しています。つまり、デバイスが自らサーバーから実行可能なサブタスクを取得し、アトミックなメカニズムを通じて複数のデバイスが同一タスクを重複して処理することを防ぎます。推論結果はオブジェクトストレージに書き込まれ、システムはGrafanaを基盤としたリアルタイム監視パネルも提供し、チームがオンラインで利用可能な、忙しい、または暇なデバイスの数を把握するのに便利です。
アップルが公開したテスト結果によると、以前は集中型GPUリソースが不足して10時間以上の待ち時間が必要だった一部の推論タスクは、Minionsを使用すると数分以内に実行可能になります。チームは新たなGPUハードウェアを追加する必要がなく、インフラコストも低減されました。
しかし、この技術は現在、一般消費者向けの正式な製品ではなく、企業内部向けの研究やエンジニアリング案のようなものです。研究チームによると、部門間で他者の機器を使用する際、データの秘密保持と管理が重要な懸念事項であると述べています。
参考
広告声明:この文章には、外部へのジャンプリンクが含まれています(ハイパーリンク、QRコード、パスワードなどを含む)。これは、より多くの情報を提供し、選択時間を節約するためのものです。結果は参考値に過ぎず、IT之家で外部リンクが含まれる記事にはこの声明が適用されます。