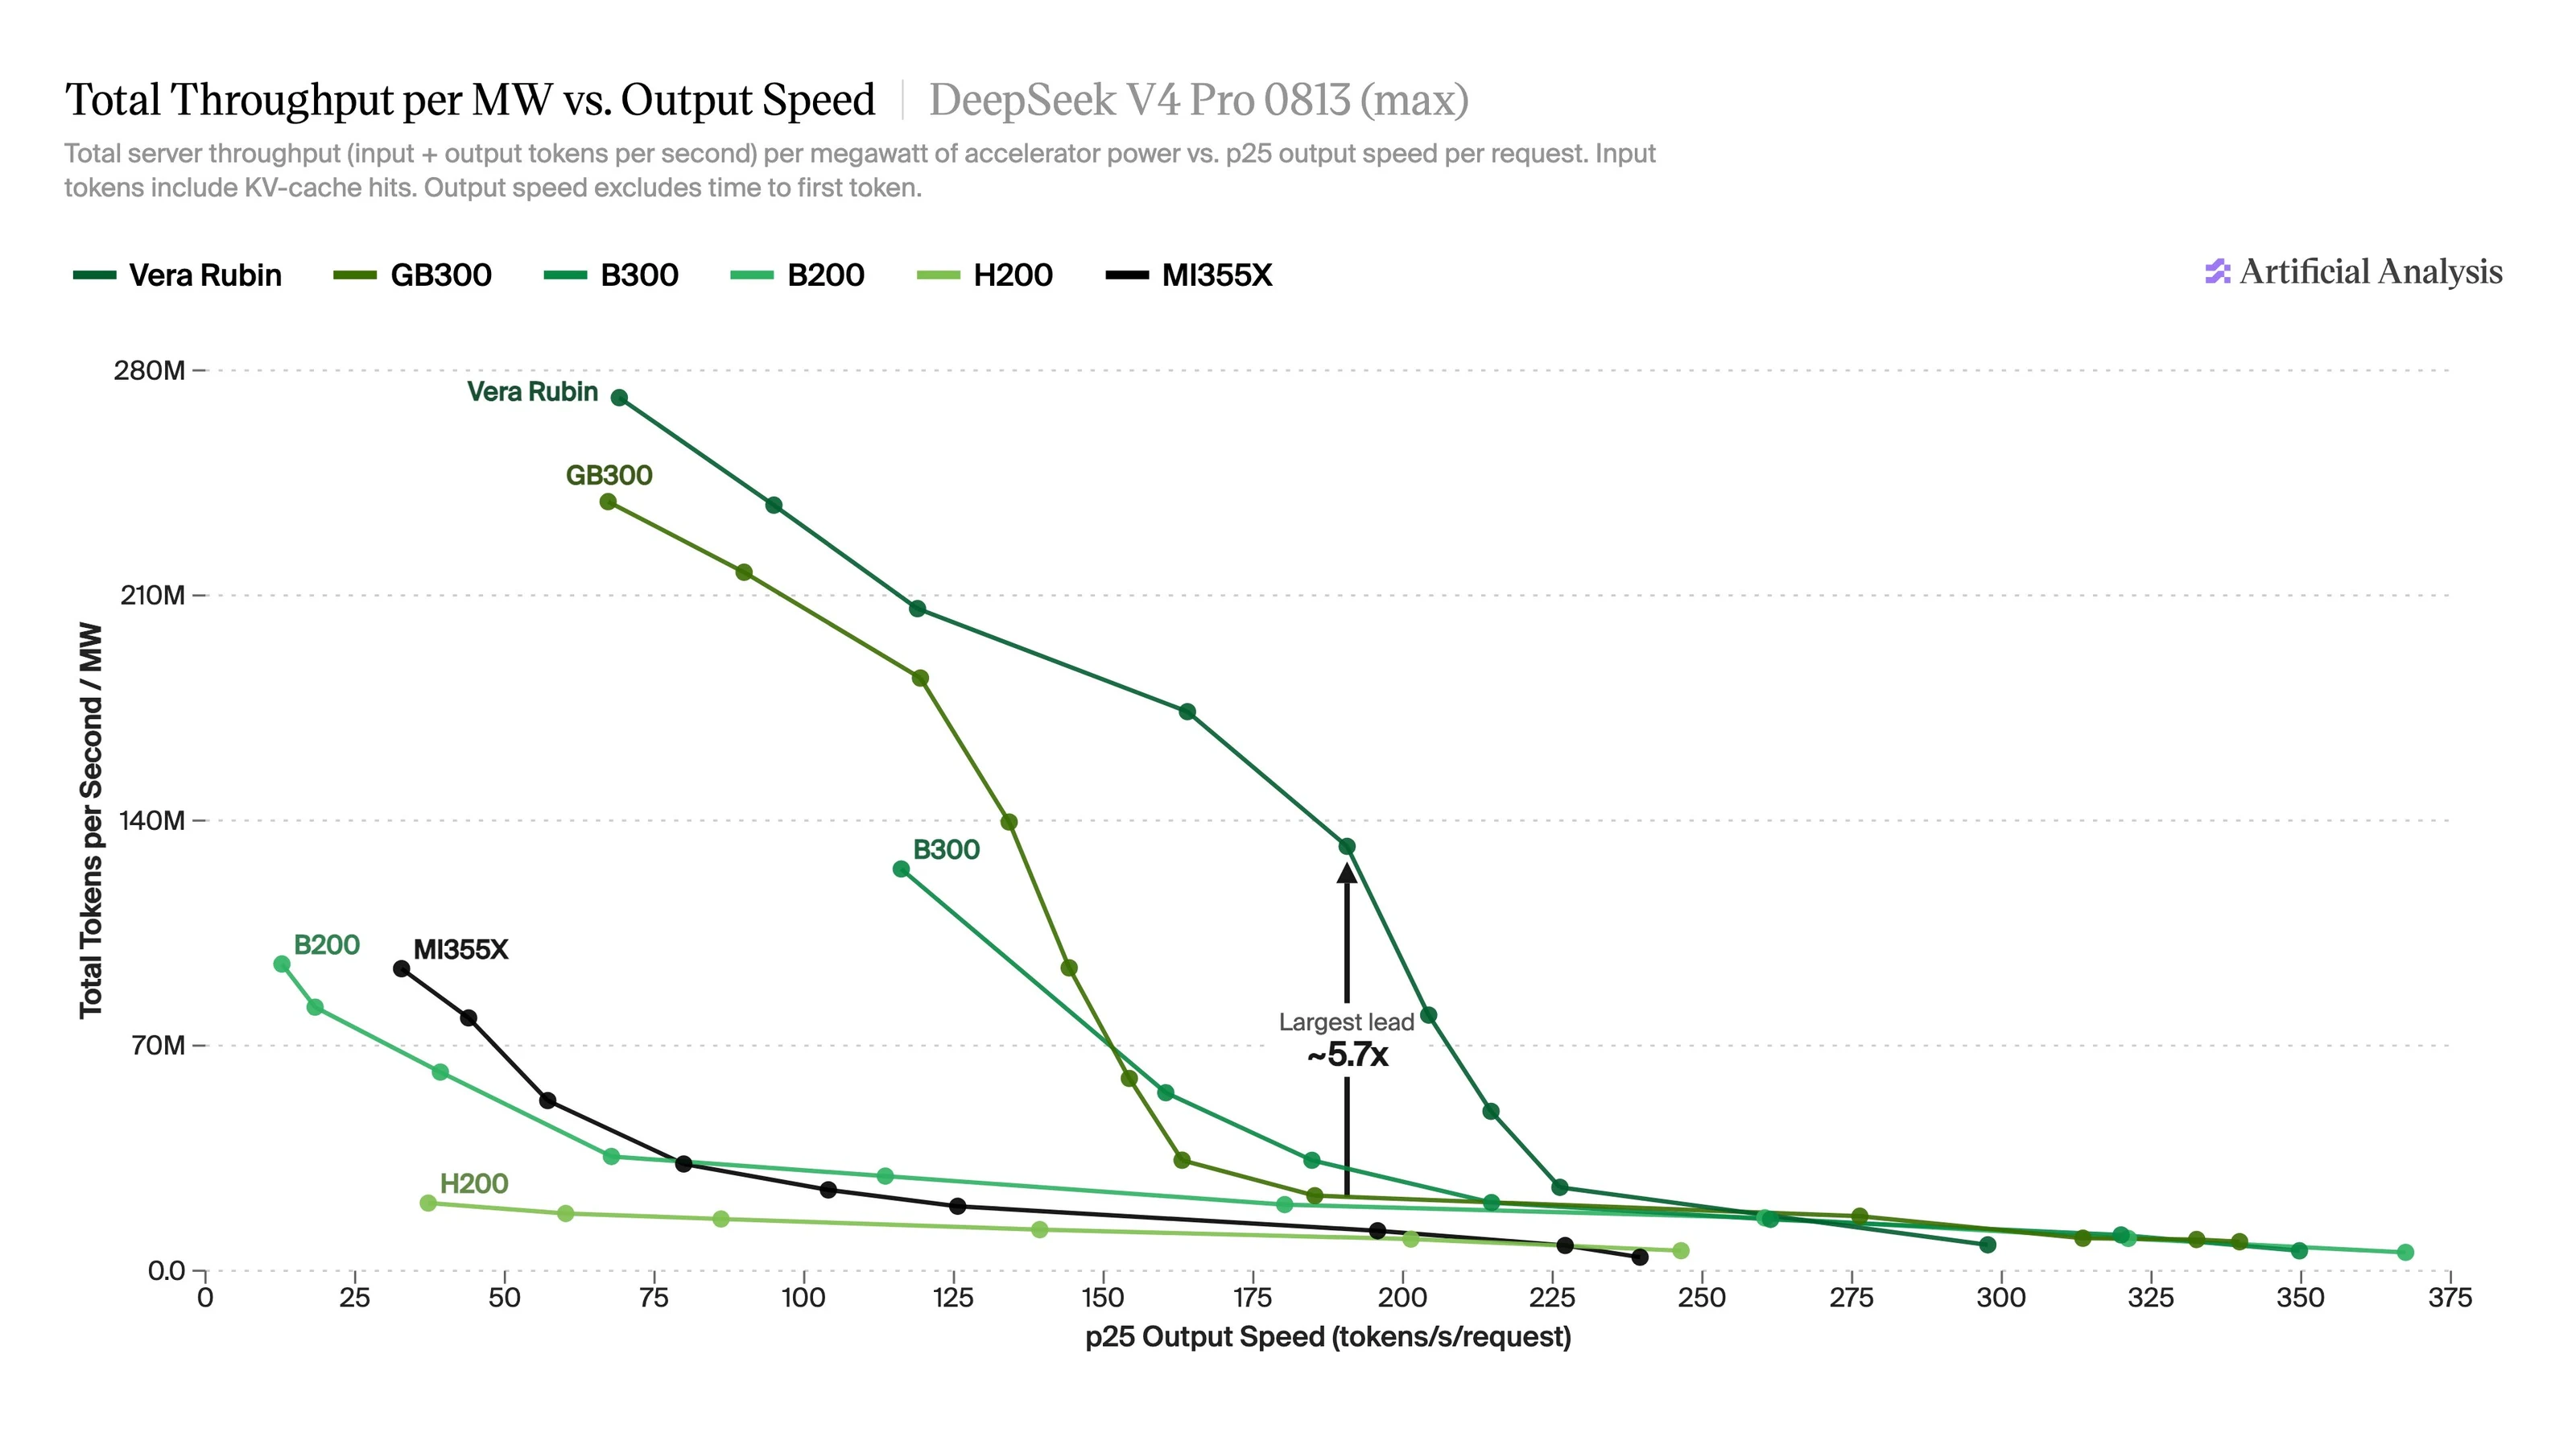
NVIDIAのVera Rubin NVL72の初期結果が、AA-AgentPerfで公開されました。DeepSeek V4 Proでは、前代モデルのGB300 NVL72の1メガワットあたりの総処理能力の約5.7倍、DeepSeek V4.1 Flashでは約5.4倍、GLM-5.2では約3.0倍、Kimi K3では約2.8倍です。
Vera RubinはNVIDIAのBlackwellの後継製品であり、Vera Rubin NVL72はラックスケールシステムで、72台のRubin GPUと36台のVera CPUを搭載しています。各Rubin GPUはBlackwell Ultraと同じ288GBのメモリを持ちますが、メモリ帯域幅は2.4倍、NVLink帯域幅は1.7倍、densified NVFP4計算能力は2.3倍です。NVIDIAは、TensorRT-LLMおよびvLLMをNVIDIA Dynamoで実行する各Vera Rubinの結果を提出しました。
AA-AgentPerfは、我々のエージェント型推論性能ベンチマークです。長いキャッシュコンテキストやツール呼び出しの遅延を含む実際のエージェント型コーディングセッションを再現し、日常的なエージェント型ワークロードにおける推論性能を実際的に測定します。我々は、測定されたGPUパワーのメガワットあたりの総システムスループットと、異なるコンカレンスレベルでの各エージェントの出力速度(リクエストごとのp25)を測定することで、システムの利用度と個々のユーザー体験の間のトレードオフを示します。
初期結果:
➤ Vera Rubinのリードは、ユーザーあたりの速度が速い場合に最大ですが、GB300のスループットは低下します。DeepSeek V4 Proでは、ユーザーあたり約120から約165 tok/sに増加すると、GB300はMW当たりのスループットの81%を消費し、Vera Rubinの場合は16%になります。
➤ピークスループット時には、二つのシステムがより近くなります。DeepSeek V4 ProではVera Rubinが1MWあたり272Mトークン/秒、GB300では239M(1.14倍)、DeepSeek V4.1 Flashでは571M対395M(1.45倍)、GLM-5.2では272M対201M(1.35倍)、Kimi K3では70M対56M(1.26倍)です。Vera Rubinカーネルやその他のサービスソフトウェアが最適化されるにつれて、二つのシステム間のギャップは広がると期待されます。
➤ Vera Rubinは、DeepSeek V4.1 Flash(906トークス/秒、すべてのモデルの中で最速の結果)、GLM-5.2(408トークス/秒)、Kimi K3(255トークス/秒)のランキングボードにおいて、ユーザーあたりの最速スピードを設定しています。
@nvidiaの素晴らしい結果を祝福します!
全文分析を読む:https://artificialanalysis.ai/articles/vera-rubin-nvl72-agentperf