
Kimi K3 最適化の内幕:ボトルネックの理解と、推論を高速化した設計判断
本記事の内容- AgentX:ワークロードと結果
- Kimi K3 の内部:エキスパート、アテンション、再帰状態
- 1. キャッシュ:会話状態を再利用可能な形で保持する
- 2. MoE:GPU 間の重複作業を排除する
- 3. メモリトラフィック:演算を融合し、不要なコピーを除去する
- 4. MLA:AMD AITER アセンブリによる高速な長コンテキストデコード
- 5. KDA:プリフィルと投機的検証の並列化
- 6. 投機的デコーディング:ドラフトするトークン数の選択
- 次に最適化すべきもの
- 貢献と謝辞
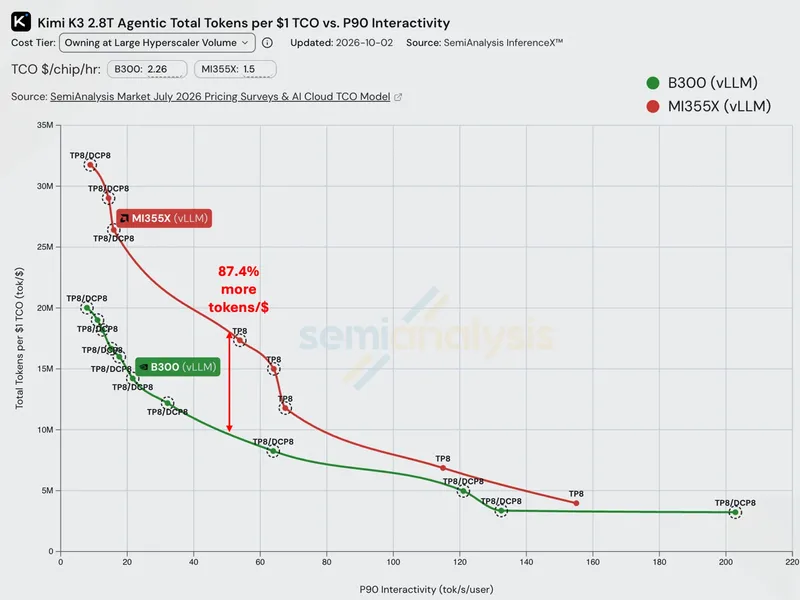
AgentX において、vLLM で Kimi K3 をサーブする 8 GPU 構成の AMD Instinct MI355X システムは GPU あたり総トークン毎秒で 24.4% 多く 出します。これは 50 tokens/s/user の P90 インタラクティビティにおける NVIDIA HGX B300 との比較です。ベンチマークの所有コストモデルの下では、 1 ドルあたりトークン数で 87.4% 多く.
本記事では、AMD Instinct MI355X 上の Kimi K3 を支えるエンジニアリングを解き明かし、vLLM のサービング上の判断を GPU カーネルとその下にあるハードウェアに結び付けます。最適化がなぜ機能したのかを説明し、無駄な作業を見抜き、ボトルネックを特定し、読者自身の推論スタックにおける次の最適化を見つけるための直観を構築します。
インタラクティビティは P90 の応答トークン間レイテンシの逆数で、最初のトークンまでの時間は含みません。総トークン数には再利用された入力と生成された出力を含みます。
出典: SemiAnalysis InferenceX、2026 年 10 月 9 日時点のスナップショット。 比較構成.
公表されている dense 行列ピーク性能は、AMD Instinct MI355X が MXFP4 で 10.1 PFLOP/s、NVIDIA B300 が FP4 で 13.5 PFLOP/s です。両者とも 288 GB の HBM3E と 8 TB/s のピークメモリ帯域幅を備えます。このサービング性能の達成は、vLLM コミュニティ全体で AMD と協力者たちが続けてきた継続的なソフトウェアエンジニアリングの成果です。
AgentX:ワークロードと結果
公開されている AgentX ベンチマークは、実際のコーディングエージェントのセッショントレースを合成トークンで再生し、リクエスト長、タイミング、プレフィックス共有パターンを保持します。このワークロードは、キャッシュが無制限の場合に 96% を超える理論上のプレフィックス再利用率を提供します。投機的実行では、固定された合成アクセプタンス基準を使用します。
現在 50 tokens/s/ユーザー P90 インタラクティビティ、AMD Instinct MI355X は約 合計7,567トークン/秒/GPU、比較すると NVIDIA HGX B300向けの6,083、 24.4%のスループット上昇効果SemiAnalysisのモデル化したTCOによると GPU時間あたり1.50ドル対2.26ドルそれぞれ、これは以下のことを意味します 1ドルあたりのTCOで1,816万対969万トークン: 1ドルあたり87.4%多いトークン.
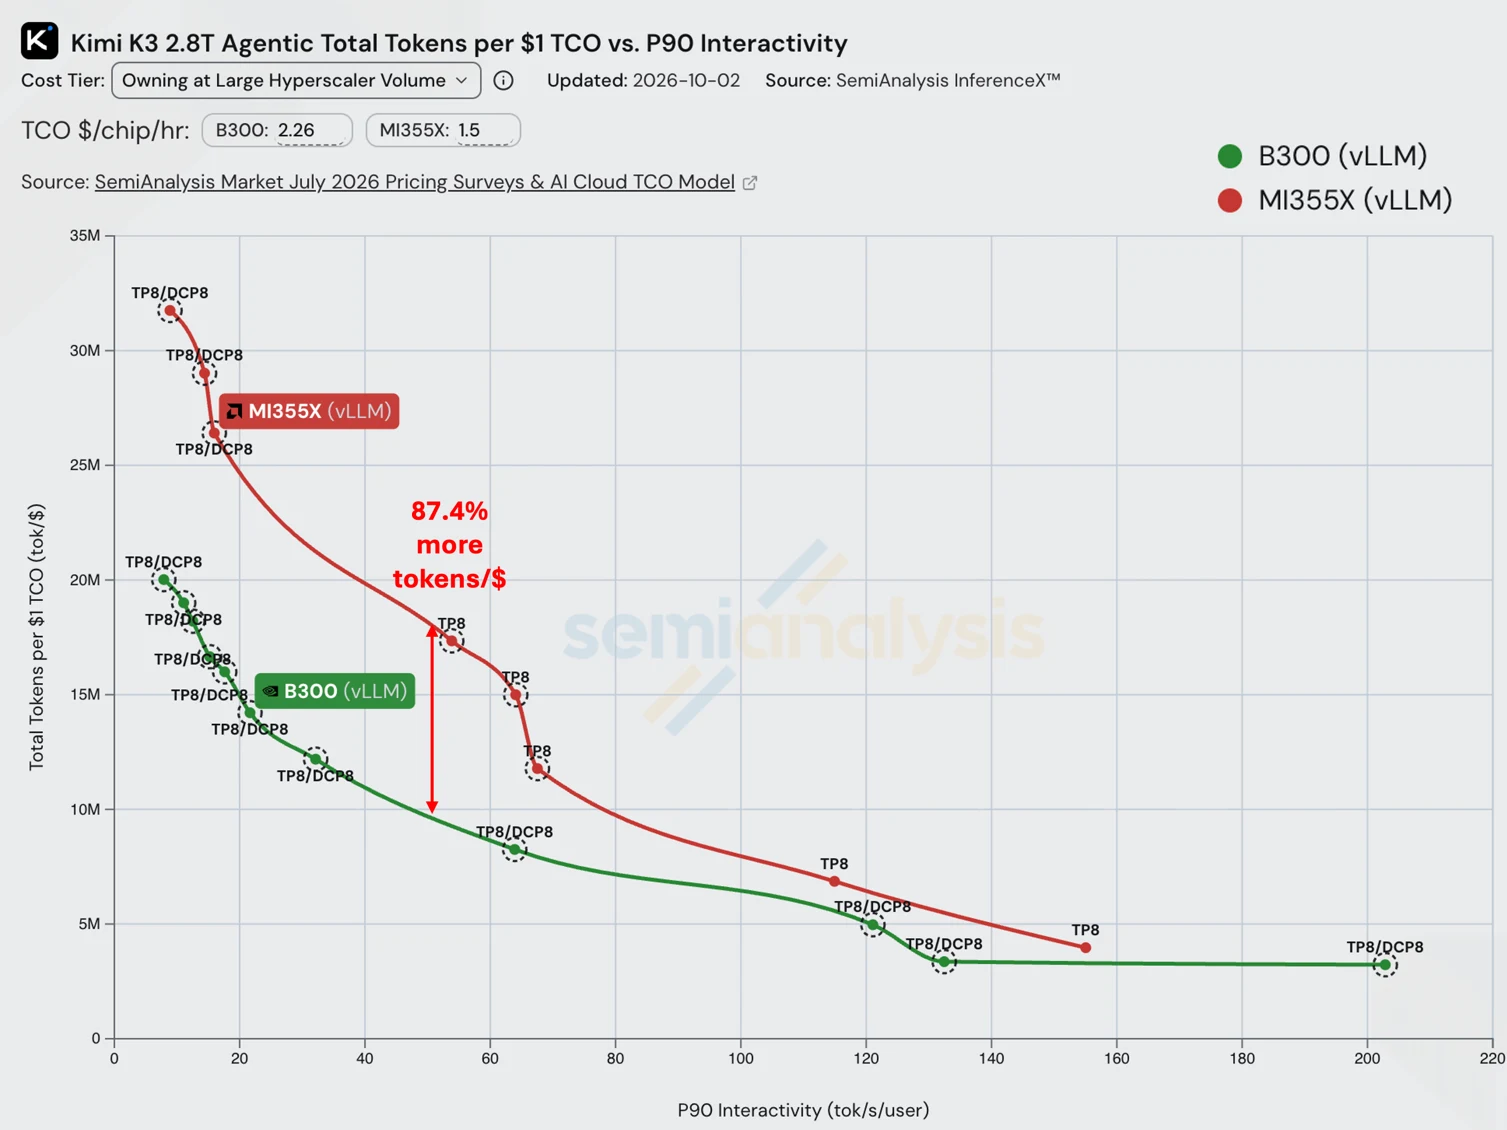
SemiAnalysis InferenceX 50 tokens/s/userという目標に注釈を付けた公開曲線。 ベンチマークに関する注記.
公開曲線は、サービングスタック全体を比較したものです。各最適化の横にある測定値は別個のテストから得られたものであり、明記された構成の下で個々のメカニズムを説明しています。
Kimi K3の内部: エキスパート、アテンション、リカレント状態
エージェントのターンを再開する場合はプレフィックスの大部分を再利用できますが、短い継続処理でも3種類のデータに触れることになります。
Kimi K3は2種類のアテンションを使用します。その 24 MLA層 会話の進行に伴って伸びていく圧縮されたKV履歴を保持します。新しいクエリもその履歴を参照します。その 69 KDAレイヤー 代わりに固定次元の状態行列を持ち越し、新しいトークンが到着するたびにそれらを更新する。 モデル設定.
MoEレイヤーでは、ルーターがエキスパートネットワークを選択し、各トークンを変換します。その重みはリクエスト間で共有されます。
会話が長くなるにつれ、MLAはより多くの履歴を保持します。KDAは固定次元の状態を更新するため、以前のチェックポイントを保持するには、その状態の追加コピーを保管しておく必要があります。
ターンをまたいで: キャッシュの再利用とオフロード(Section 1)。
モデルの1ステップ内で: "expert projections, kernel handoffs, and MLA/KDA scheduling (Sections 2–5)." → 専門家の投影、カーネルの引き渡し、および MLA/KDA スケジューリング(セクション 2~5)。
ドラフトの深度の選択: 確約された出力と完全なサイクルコストの比較(第6章)。
1. キャッシュ: 会話の状態を再利用できるように保持する
DCPはGPUメモリ内の重複した履歴を削減し、CPUオフロードは再利用可能な状態をその外部に保持します。
DCP: 履歴を複数のGPU間で共有する
TP8の下では、各GPUはKimi K3の96個のMLAクエリヘッドのうち12個を処理しますが、圧縮されたKV履歴全体を格納します。テンソル並列化はヘッドを分割しますが、キャッシュは分割しません。
共に eight-way decode context parallelism(DCP8)各GPUがキャッシュされた位置情報の8分の1を保持します。デコード時には、GPU同士がクエリを交換し、ローカルの履歴に対して計算を行い、部分的な回答をマージします。
2つのGPUは、TP8/DCP8で使用される同じパーティションを示しています。この追加の分割はMLA履歴に適用されます。KDA状態はヘッド間で既存のパーティションを維持します。
各部分回答には正規化情報が含まれており、マージ時にシャードを正しく重み付けできるようになっています。 #51705 ROCm AITER DCP パスをマルチトークン検証に拡張します。
142,000トークンの会話の場合、推定MLAペイロードは24レイヤー × 142,000ポジション × 576 FP8バイト ≈ GPUあたり約1.96 GBとなります。DCP8はこれを、アロケーションオーバーヘッドを除いて約245 MBまで削減します。各GPUは8倍のヘッドを処理する一方で、履歴は8分の1となるため、主要なアテンション演算量はほぼ変わりません。
CPUオフロード:HBMに収まりきらなくなった状態を保持する
状態がGPUメモリに収まらなくなると、 AMDのレシピのネイティブなvLLM CPUオフロードは、MLA履歴とKDAチェックポイントをホストDRAMに保持します。
キャッシュヒットには再開ポイントの一致が必要です。MLAの履歴がトークン3,072に達していても、最新の互換KDAチェックポイントが2,048にある場合、リクエストは2,048から再開し、残りのプレフィックスを再計算しなければなりません。
利用可能な再開ポイントには、必要なすべてのレイヤーにわたる互換性のある状態が必要です。位置は説明のための例です。
attentionブロックの末尾をKDAチェックポイントとともに保存することで、両者の再開位置が揃います(#54736)。その状態を復元することで、プレフィックスの再計算を回避する代わりにGPUへの転送が発生します。リクエストが再開した後も、その新しいトークンによって複数のGPUが同じ計算を繰り返す可能性があります。
2. MoE: GPU間の重複作業を排除する
単一のGPUでは、ルーティングされたエキスパートの出力射影は、利用側が期待する完全なベクトルを返します。元のROCmパスでは、前段のリダクションと正規化により8つのGPUすべてが同じ潜在入力を受け取り、それぞれが完全な重みを保持していました。 そのため、同じ射影が8回実行されていました。
出力の座標はGPU間で分割できますが、すべてのランクは依然として完全な結果を必要とします。Kimi K3には、共有エキスパートの部分結果のためのall-reduceがすでに存在します。
各GPUは、自分が所有するルーティング出力のみを共有エキスパートの部分結果に加算します。既存のall-reduceが完全な結果を組み立てるため、新たな集合通信は不要です(#51253)。ROCm実装は、対応するCUDAの戦略を基に構築されています。
2つのGPUが出力座標の所有を示しています。どちらの経路も既存のall-reduceを1回使用し、すべてのGPUに同じ完全な結果を返します。
各出力座標は、ルーティングされた寄与を正確に1回だけ受け取ります。完全な射影重みは複製されたままです。
PRのテストでは、TP8で8基のAMD Instinct MI355X GPU上、同時実行数8〜128、ランダムな8K入力/1K出力リクエスト、プレフィックスキャッシング無効の条件で、出力スループットが3.05〜4.91%向上しました。
GPUメモリを解放して、より多くのキャッシュされた状態を保持する
各ランクは、完全な重みを保持したまま、割り当てられた射影の座標のみを計算するようになりました。
各ランクが使用する行だけを読み込むことで、約 GPUあたり3.85 GiB 92のMoE層全体、TP8での(#59591`). 融合されたパスの計算は同じままです。追加のスペースにはMLA履歴とKDAチェックポイントを格納できます。
この変更は、見出しに使われた公表結果の画像の後に行われたものです。別個のAgentX実験では、次のことが判明しました。 同時実行数32および48では1%未満のスループット向上にとどまりましたが、70では28.9%の向上を示しました, 報告されたプレフィックスキャッシュのヒット率は74.8%から80.1%に上昇しました。
分離 #59591 の測定値「AMD Instinct MI355X GPU 8基、TP8/DCP8、FP8 KV、30分間の実行、CPUオフロードおよび投機的デコードなし。プロットは報告された実行結果を示す。繰り返し実行の不確実性は報告されていない。」
高同時実行時の大きな性能向上はキャッシュ圧力と整合的です。同一のキャッシュ容量で両実装を比較すれば、その影響を切り分ける助けになるでしょう。
関連記事 expert routing と 4 ビット活性化.
3. メモリトラフィック: 操作を融合し、不要なコピーを削除する
各GPU内では、次に調べるべき場所はカーネル間で受け渡しされるデータです。
Kimi K3のシングルトークンのKDAパスは、3つの計算カーネルと2つの出力コピーを実行していました。畳み込みは、Q/K正規化、減衰、ベータゲート、および再帰更新をすでに統合していたカーネルの前に実行され、出力正規化はその後に実行されていました。統合されたHIPパスは、これらの操作を1回の起動で実行し、宛先バッファに直接書き込みます(#50654).
中間の受け渡しはチップ上に留まります。畳み込み履歴とリカレント状態は、次のトークンのためにGPUメモリへ送られます。
シングルトークン、非投機的KDAデコード実行時間 #50654「. Before は融合化された Triton 正規化パスを使用します。数値はソースコードに従っており、射影はこのビューの対象外です。保存状態の読み書きは残ります。」
AttnRes は、前のレイヤーブロックの出力をランニング残差に混合します。この混合を RMSNorm と組み合わせることで、一時的な混合物をレジスタ内に保持します(#50593)。後続のレイヤー用に保持される実行中の残差は BF16 の丸めを維持し、混合物は正規化を通じて FP32 のままです。テストでは永続的な更新が正確であることを要求し、正規化された出力には数値の許容誤差を認めます。
AttnRes fusionを使用すると、AMD Instinct MI355X GPU 8基、TP8、入力100K/出力1Kのリクエスト、プレフィックスキャッシング無効の条件で、出力スループットが14.2%向上しました。Long-prefillレイテンシは事実上変わりませんでした。
使用するカーネルに対してのみ入力をコピーする
ROCm の行列乗算ディスパッチャーは、カーネルを選択する前に入力をパックしていました。フォールバックが選択された場合、そのカーネルは元の入力を読み込み、コピーを未使用のまま残していました。パック処理を特殊化された各分岐の中に移動することで、これらのコピーは削除されました(#58566).
そのプロフィールによって廃棄物が見える形になった: デコードステップごとに69個の不要なコピーKDAレイヤーごとに1回ずつ。それぞれ移動したのはわずか1,792バイトでしたが、約4.8マイクロ秒かかりました。これらのバイトをより速く転送してもほとんど効果はなく、起動オーバーヘッドが支配的でした。
このPRのTP8、concurrency-one、six-draft、384Kコンテキストのプロファイルにおいて、削除されたコピーは1ステップあたり0.339 msのコピーカーネル時間に相当します。
4. MLA: AMD AITERアセンブリによる高速な長コンテキストデコード
Kimi K3はTP8でGPUあたり12個のクエリヘッドを持ちます。16にパディングすることで、AMD AITERのアセンブリデコードパスが利用可能になりました。報告された長コンテキストテストでは、出力トークンあたりの時間が43.8ミリ秒から23.6ミリ秒に低下しました。
この比較はDCPなしのTP8、同時実行数1で行われました。 #50578 内のアダプタは4つのクエリヘッドをコピーして16ヘッドレイアウトにパックし、その出力を破棄します。DCP8は異なる96ヘッドの形状を提示します。
これはモデルの動作を維持します。各クエリヘッドはキャッシュされた位置に対して独立にアテンションを行うため、ヘッドを追加しても元のヘッドのソフトマックスは変化しません。このデコードパスではクエリのみがパディングされ、保存された圧縮KV履歴のサイズは変わりません。
長い会話はアテンションに多くの仕事を与えますが、その仕事はGPU全体に分散される必要があります。我々が調査した過去のコードでは、控えめな スケジューリングヒント により、Gluonパスは リクエストあたり1ワークグループに制限されていました。そのワークグループは依然として会話全体を処理していました。パディングによりAMD AITERのアセンブリパスが利用可能になり、履歴を並列な部分に分割して結果を結合するための 異なるポリシー が使われました。
履歴パーティションは、1つのGPU内のワークグループに割り当てられる作業です。説明のために4つを図示していますが、検査されたアセンブリポリシーでは16が選択されました。KVストレージは変更されていません。
| 入力/出力トークン | 元のGluonパス | パッド入り組立て経路 |
|---|---|---|
| 1K / 1K | 22.9 ms/token | 22.8 ms/トークン |
| 32K / 1K | 43.8 ms/token | トークンあたり 23.6 ms |
PR報告の出力トークンあたり平均時間:AMD Instinct MI355X GPU 8基、TP8、同時実行数1、モデル重みはMXFP4、アテンションはBF16、通常のシングルトークンデコード。
短い入力のケースはほとんど変化しませんが、長い入力のケースでは出力トークンあたりの時間がほぼ半減します。これらのサービング計測にはクエリの準備と出力の処理が含まれています。
5. KDA: プリフィルと投機的検証の並列化
MLAでは保持された履歴をワークグループ間で分割できます。KDAはより難しいスケジューリング問題を提示します。各トークンが直前の状態に依存するためです。フューズドプリフィル(fused prefill)は #54038 入力状態が判明する前に、各トークングループの統合変換を準備します。
たとえば、「状態を半分にして2を加える」、その後「それを半分にして1を加える」という操作は、「初期状態の4分の1を取り、2を加える」という操作に合成できます。このルールは、初期状態が到着する前に計算しておくことができます。
KDAはこれを行列変換で実現します。グループ概要を順番にスキャンして各グループの開始状態を決定し、その後、各グループはトークンを並列に再生します。トークンの順序は保たれますが、各グループは先行グループの再生完了を待つ必要がなくなります。
グループ化は2回目のウォークを追加し、融合されたチャンク処理の起動回数を2回から4回に拡大します。これは、シーケンスやヘッドの数が少なくて並列処理の作業量が足りない場合に有効です。そうでなければ、追加のパスが節約できるコストを上回ってしまうことがあります。
各グループ内では、再帰的なウォークがチャンク間で行列アキュムレータレジスタに状態を保持し、グローバルメモリへの書き込みと再読み込みを回避します。 状態ストレージの図。
別の3バックエンド比較——8基のAMD Instinct MI355X GPU、TP8、同時実行数32、プレフィックスキャッシュ無効、1トークン出力という条件——において、Fused KDAは入力長4Kおよび16KでTritonより5.3–5.6%高い入力スループットを達成しました。これは完全なバックエンドを測定したものです。 ベンチマーク結果.
推測的検証には小さいタイルを使用する
短い検証バッチには、異なる分割方法が必要です。TP8では、各GPUは128の値列を持つ12個のKDAヘッドを担当します。各ヘッドを32列のタイル4つに分割すると、256の計算ユニットに対して48のワークグループしか起動できません。 #58045 4列のタイルに切り替わり、数は384に増えます。
各タイルは異なる値の列を持ち、同じトークン列を順番に処理します。より狭いタイルにより、独立したワークグループの数は48から384に増加します。
AMD Instinct MI355X GPU 1基(TP8次元、1シーケンス、4検証位置)での別のグラフリプレイカーネルテストでは、レイヤーあたりの時間が16.20マイクロ秒から5.61マイクロ秒に短縮されました(2.89倍)。これには、より狭いタイル、シングルウェーブのワークグループ、同一長の特殊化、トークン不変処理の巻き上げが含まれます。不揃いなバッチでは動的パスが維持され、テストでは出力と再帰状態を比較します。
6. スペキュレーティブデコーディング: ドラフトするトークン数を選ぶ
より高速な検証は、ドラフトトークンをいくつ検査する価値があるかを変えられます。有用な割合は、確定された出力をドラフト・検証・確定の完全なサイクル時間で割ったものです。
たとえば、AgentXの固定受理リファレンスでは、ドラフト3つでサイクルあたり期待確定トークン3.00、ドラフト4つではリカバリーボーナストークンを含めて3.36となります。つまり、サイクルあたりの確定出力が12%増加します。 ドラフト4つがスループットを向上させるのは、完全なサイクルがドラフト3つより12%未満しか長くならない場合に限られます。
管理された受理リファレンスに基づく説明用の比較です。12%のしきい値はコスト予算であり、完全なサイクルの増加はここでは測定されていません。
公開されている AMDの公開レシピ では、DCP1を使った3〜7個のドラフトが用いられ、より大きいDCP8の並列度設定では推測(speculation)が無効化されます。
次に最適化すべきポイント
進行中のprefill/decode分離(disaggregation)の取り組みは、調べるべき別の観点をもたらします。ワーカーのバランス、そしてデータが必要になる前に転送が完了しているかどうかです。
別のモデルやワークロードについては、デプロイ済みのリクエスト形状を出発点として、次の3つのチェックを行ってください:
ランクを比較する。 集合演算(collective)の前に、複数のGPUが同じ結果を計算していないか?
バッファを追跡する。 選択されたパス上で、各一時テンソルには消費者が存在するか?データをチップ上に留められないか?
独立した処理の数を数える。 実際のヘッド、トークン、タイルは、負荷を分散するのに十分な数のワークグループを生み出しているか?
必要とする応答速度でリクエスト全体を計測し、出力と保存された状態の両方を確認してください。カーネルが速くなることが意味を持つのは、次のトークンを妨げている処理を短縮する場合です。
貢献と謝辞
Kimi K3の取り組みは、 AMD、Embedded LLM、およびより広いコミュニティによる50件超のマージ済みAMD/ROCm関連vLLM PR に加え、AITERの開発、統合、レビュー、ベンチマーキングにわたります。貢献の範囲は、attention、recurrence、MoE、量子化、グラフ実行、キャッシュサポート、プラットフォーム統合をカバーします。
感謝の言葉: Pin Siang Tan、Jun Kang Chow、Ye Hur Cheong、Hongxia Yang、Seungrok Jung、Bill He、Yichao Zhu、Hyukjoon Lee、Andy Luo、Mrinal Karvir、Richard Li、Sun Peng
Andy Friedrich氏, Ethan Yang氏, Tang Rui氏, Andreas Karatzas氏, Ankur Singh氏, Yihua Cheng氏, Badr Ba Sowid氏, Benjamin Chislett氏, Taoyu Zhu氏, Bill He氏, Bin Ding氏, Bowen Bao氏, Brandon Zhang氏, Chaemin Lim氏, Charles Wu氏, Chuan (Richard) Li氏, Felix Li氏, Cameron Quilici氏, Weishu Deng氏, Dewei Wang氏, Divakar Verma氏, Douglas Lehr氏, Edwin Lim氏, Yudong Pan氏, Elvir Crnčević氏, Fang Che氏, Fangzhou Ai氏, Xingran Fan氏, Fulu Li氏, Felix Marty氏, Canlin Guo氏, Summer Yang氏, Haichen Zhang氏, Yufeng He氏, He Liu氏, Hongxia Yang氏, Hyukjoon Lee氏, Yifan Qiao氏, James E T Smith氏, Jiahui Cao氏, Yanyuan Qin氏, Jonathan Chen氏, Juntian Liu氏, Shao-Chun Lee氏, Kedar Potdar氏, Kevin H. Luu氏, Kuan-Fu Liu氏, Kuntai Du氏, Kyle Sayers氏, @lalala-shさん, @linnea-lin-00638949さん, Yinfeng Liu氏, Lucas Wilkinson氏, Gabriel Wu氏, Markus Hartikainen氏, Maithili Joshi氏, Jeff (Junze) Ma氏, Matthew Wong氏, Misha Goin氏, Micah Williamson氏, @minmengdieさん, Matvei Pashkovskii氏, Mathews Neha氏, Nicolò Lucchesi氏, Nick Hill氏, Nicholas Susanto氏, Oxana Korzh氏, Pei Zhang氏, @ppalangaさん, Peiran Qin氏, Qiuyang Yue氏, Rita Brugarolas氏, Rebecca Lee氏, Ryan Rock氏, Rohan Potdar氏, @Saddssさん, Samuel Shen氏, Sean Filimon氏, Seungrok Jung氏, Shantipriya Parida氏, Shanshan Shen氏, Shengnan Xu氏, Simon Danielsson氏, Siraj Shaikh氏, Stacy Roberts氏, Stefan Koncarevic氏, Asan Stefanski氏, Minghui Jiang氏, Tarık Saraç氏, Tun Jian Tan氏, Lingpeng Jin氏, Vansh Bhatia氏, Maksim Vedenev氏, Ye Hur Cheong氏, @wenwzhanさん, Wei Zhao氏, Xavier Aguilar氏, Xiaobing Zhang氏, Xiaohu Guo氏, Xin Li氏, Xudong Lyu氏, Yanxue Ren氏, Wentao Ye氏, Yongqin Wang氏, Riggins Chen氏, Chao Hong氏, Yuchen Shen氏, Matt Qin氏, Yichao Zhu氏, Roger Wang氏, Zheng Gong氏, Jiangyun Zhu氏, Zvi Grinberg氏, Yongye Zhu氏.
ベンチマークに関する注記
比較対象におけるサービス提供構成
| P90 インタラクティビティ(トークン/秒/ユーザー) | AMD Instinct MI355X | NVIDIA HGX B300 |
|---|---|---|
| 30 および 50 | SimpleCPU オフロード; DCP8 / DCP1 へのドラフトなし / 3 ドラフト | Mooncake オフロード; DCP8 |
| 150 | GPU のみ; DCP1; 5〜7 ドラフト | Mooncake オフロード; DCP8 |
両システムとも 8 基の GPU、TP8、FP4 ウェイト、FP8 KV を使用。値は、一致するインタラクティビティにおいて公開済みの各オフロードまたは GPU のみの系列内で補間されたものです。同時実行数、DCP、ドラフト深度は、括弧となる実行間で異なる場合があります。固定された AMD レシピ(YAML) および NVIDIA ランチャー に、イメージタグと完全な設定が記載されています。
リプレイには cc-traces-weka-062126 データセットと ピン留めされた AIPerf ハーネスを使用し、ウォームアップを除外し、 固定された合成アクセプタンス曲線のもとで 1 時間のプロファイリングを行いました。レシピにはシード、セッション開始、およびウォームアップの設定が記されています。ダウンロードされたデータセットのリビジョンは記録されていません。クローズドループのリプレイでは、完了したリクエストの構成が異なる場合があります。
ソフトウェアとオフロード。提出物では vLLM 36768d1bf (AMD)および 5894fdf98(NVIDIA)を使用。設定されたホストキャッシュ予算は、それぞれ GPU あたり 224.875 GB と 281 GB です。コネクタとイメージの設定は、リンクされたレシピに記載されています。
コスト。SemiAnalysis の 大手ハイパースケーラー所有モデル および 公開された GPU コスト定数 では、AMD Instinct MI355X は GPU 時間あたり $1.50、NVIDIA HGX B300 は $2.26 を使用しています。総トークン/$ = 総トークン/秒/GPU × 3,600 ÷ モデル化された $/GPU 時間。一部の資本および稼働率の前提は未公開のままです。50 トークンのインタラクティビティ目標において、この比較ではトークンあたりのモデル化コストが 46.6% 低くなります。
スナップショット。 SemiAnalysis InferenceX データ 2026年10月9日取得、提出日は2026年9月30日(AMD)および2026年8月16日(NVIDIA)。PRベンチマークは先方が明示したワークロードに基づく; #59591 は、見出し画像の後に行われた別個の実験です。
| 公開仕様、GPUあたり | AMD Instinct MI355X | NVIDIA B300 GPU |
|---|---|---|
| 低精度密行列ピーク性能 | 10.1 PFLOP/s MXFP4 | 13.5 PFLOP/s FP4 |
| GPUメモリ | 288 GB HBM3E | 288 GB HBM3E |
| ピークメモリ帯域幅 | 8 TB/s | 8 TB/s |
出典: AMD Instinct MI355X, NVIDIA HGX B300, NVIDIAメモリ仕様。ベンチマーク詳細: AgentX の方法論.
技術ノート: エキスパートルーティングと精度
Kimi K3は1トークンあたり896個のエキスパートから16個を選択するため、大規模なサーバーバッチでもエキスパートあたりの行数は少なくなり得ます。その結果、エキスパートタイルにはパディングが含まれる場合があります。
A4W4はトラフィックの別の部分を削減します。 #53940 への統合により、アクティベーションが8ビットから4ビットに変更されますが、重みは4ビットのままです。トラフィック合計には、BF16の中間出力およびエキスパートタイルのパディングも含まれます。
技術ノート: KDAの精度とオンチップメモリ
各チャンクは依然としてトークン間の依存関係を解決する必要があります。カーネルはそれらを、後続の行列積が適用できる変換へと結合します。それにより、実務上の2つの疑問が生じます。どの精度なら答えを保持できるのか、そしてどれだけの一時データがチップ上に収まるのか?
小さな例でその考えを示します。先の修正を後の修正に代入すると、各答えは既知の入力を用いて直接表すことができます。得られる係数表には、依存関係の連鎖がすでに織り込まれています。
このスカラー図では、位置1が位置3に与える影響は2つの経路をとります。直接は −1/8、位置2を経由すると (−1/4) × (−1/4) = 1/16 です。合わせると −1/16 となり、表の左下の項に一致します。対角線より上のゼロは、後の位置が前の位置に影響を与えられないことを示しています。
実際のプロローグでは、64×64のチャンク内依存行列の逆行列を計算します。その後の行列積では、この変換を使ってそれらの依存関係を考慮します。
「逆数の中間値は増大したり相殺されたりする可能性があります。あまり早い段階で丸めると、最終結果に必要な情報が失われます。この実装ではAMDのネイティブな」 FP32行列命令感度の高い逆行列についてはFP32の入力と累積を維持します。完了した逆行列のみがBF16に丸められ、その後の積に使用されます。 カーネル実装.
丸められた入力をFP32の累積で復元できない理由
256.5 から 256 を引くことを考えてみてください。どちらの入力も FP32 では正確です。この大きさでは、256.5 を BF16 に変換すると 256 に丸められます:
| 入力精度 | FP32 で実行される減算 | 結果 |
|---|---|---|
| 元のFP32入力を保持する | 256.5 − 256 | 0.5 |
| まず入力を BF16 に丸めてください。 | 256 − 256 | 0 |
FP32の減算では、処理開始前に失われた情報を取り戻すことはできません。これらの単純な数値は、逆行列の計算がネイティブの16×16×4 FP32行列命令を使用し、入力と累算の両方の精度を維持する理由を示しています。
FP4モデルもまた、より高い精度での演算に依存しています。その性能は、こうした数値経路をいかに効率化するかにかかっています。
プロローグにもローカルメモリの予算があります。AMDはオンチップの共有スクラッチをLDSと呼んでいます。QとKのタイルは、必要とされるタイミングが異なるためストレージを再利用します。三角形状の入力は、占有されている10個の16×16ブロックだけを格納します。ワークグループは 79.5 KiBこれは切り上げると 80 KiBとなり、AMD CDNA 4 のコンピュートユニット 1 基の 160 KiB の LDS 予算の半分です.
割り当ては 1,280 バイト単位で切り上げられます。図示された追加の KiB はレジデンシーのしきい値を超えます。2 つの割り当てはもはや収まりません。これはキャパシティの計算であり、レジスタやその他のリソースが追加の制限を課す可能性があります。
このしきい値は、カーネルバイナリを固定したまま、しきい値を超える量の未使用 LDS を予約することでテストできます。実行時間がほとんど変わらない場合、追加で常駐していたワークグループはそのシェイプに対してほとんど寄与していなかったことになります。
チャンク間の状態
グループサマリーと開始状態は引き続きカーネルの境界を越えます。要求されたチェックポイントと最終状態は保存されます。
免責事項
本書に記載された情報は情報提供のみを目的としたものであり、技術的な不正確さ、脱落、誤字を含む場合があります。ここに含まれる情報は変更される可能性があり、製品およびロードマップの変更、コンポーネントおよびマザーボードのバージョン変更、新型モデルおよび/または製品のリリース、メーカー間の製品差異、ソフトウェアの変更、BIOSフラッシュ、ファームウェアのアップグレードなどを含む(ただしこれらに限定されない)多くの理由により、不正確なものとなる場合があります。コンピュータシステムには、完全には防止または軽減できないセキュリティ脆弱性のリスクがあります。AMDは、本情報を更新、修正または改訂する義務を負いません。ただし、AMDは、本情報を改訂し、その内容に対して随時変更を加える権利を留保しており、かかる改訂または変更についてAMDはいかなる者にも通知する義務を負いません。本情報は「現状有姿」で提供されます。AMDは本書の内容に関していかなる表明または保証も行わず、本情報に現れる可能性のある不正確さ、誤り、脱落に対していかなる責任も負いません。AMDは、非侵害、商品性、または特定目的への適合性のいかなる黙示的な保証も明示的に否認します。いかなる場合も、AMDは、AMDがかかる損害の可能性を明示的に告知されていた場合であっても、本書に含まれる情報の使用から生じる、依拠、直接的、間接的、特殊的、またはその他の結果的損害について、いかなる者に対しても責任を負いません。AMD、AMD Arrowロゴ、およびそれらの組み合わせは、Advanced Micro Devices, Inc. の商標です。本書で使用されているその他の製品名は識別のみを目的としており、それぞれの会社の商標である場合があります。© 2026 Advanced Micro Devices, Inc. All rights reserved.