
Beam by ReflectionがHugging Faceで公開されました!これは新興の米国ラボReflection初のモデルで、オープンです。501Bパラメータ(トークンあたりアクティブ23B)のMixture-of-Experts(MoE)モデルで、テキスト入力に対応しており、a 1Mトークンのコンテキストウィンドウ, Apache 2.0ライセンスの下でリリースされています。
「Beamは重点を置いています」 コーディング および エージェント型 ユースケース向けのものです。自社のハードウェア、インフラ、またはクラウド上でフロンティア規模のモデルを稼働させ、自社のユースケースに合わせてカスタマイズしたいチームのためのものです。Beamは、モデルから最高のパフォーマンスを引き出す専用のオープンソースのRustベースのハーネスを同梱して出荷されます。
Beamはtransformersのネイティブ実装に対応しており、vLLMやSGLangなどのダウンストリームライブラリにも対応しています。私たちはReflectionチームと協力し、このモデルを皆さんのニーズに合わせて構築できるよう、推論、SFT(教師ありファインチューニング)、RL(強化学習)のレシピをご用意しました。transformers、SGLang、vLLMでのday-0サポートに加えて、本記事ではこのモデルの実行方法、事後学習(ポストトレーニング)の方法、そして私たちがこのモデルを使って構築したものをご紹介します。
要約
- トークンごとに23Bがアクティブになる501BパラメータのMoE LLM。52層、MoE層ごとに256エキスパート、トークンごとに8個をルーティング。
- テキストを入力し、テキストを出力する、そのために トークンのコンテキストウィンドウ1M。
- チェックポイント形式: BF16, FP8, および NVFP4
- ターンをまたいでコンテキストに保持できる推論(
preserve_thinking)、専用の文法によるツール呼び出し。このモデルは5つの推論値「low」、「medium」(デフォルト)、「high」、「xhigh」、「max」をサポートしています。- トークナイザー内の応答テンプレート。
- DFlash2 を用いた投機的デコーディングドラフターモデル
- Day-0対応ライブラリ: transformers、SGLang、vLLM。MilesによるフルパラメータRL。
- 同梱品は次のとおりです。 Rustベースのカスタムハーネス。
- Apache 2.0。
Beam で構築しよう
Reflectionは、Beamを使用した最優秀プロジェクトに10,000ドル分のHubクレジットを提供します。必要なのは、何かを作ってHubで共有することだけです:
- Beamモデルを使用したデモをSpacesで作成できます。
- お好みのハードウェア向けに量子化することもできます。
- お気に入りの問題のための合成データセットを生成できます
- Beam を使って、または Beam 向けに RL 環境を構築できます
- Beam をベンチマークして結果を共有できます。
- 私たちを驚かせてください!
Beam を使って何かを作り、Hub で共有すると、10,000 ドルを獲得するチャンスがあります。やるべきことは、スペース、モデル、またはデータセットリポジトリを作成し、それを モデルのリポジトリページで共有するだけです。すべてのリンクを集め、最優秀のものを選び、あなたの Hub アカウントにクレジットを送付します。
Beam とは何か?
Beam は、長いコンテキスト(1M のコンテキスト長)での推論とエージェント的な作業のために構築されたテキスト専用モデルです。スパースな MoE モデルであり、各トークンはネットワークのごく一部によって計算されるため、はるかに小さいモデルの速度で動作しながら、大きなモデルの容量を維持します。
Attention
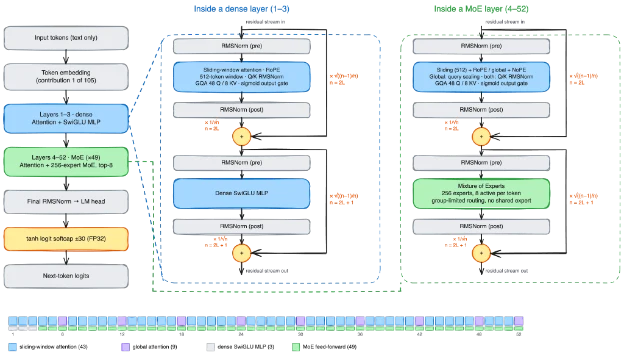
デコーダは 52 層で、隠れ層のサイズは 5,120 です。ほとんどの層は直前の 512 トークンに対するスライディングウィンドウアテンションを使用し、6 層ごとの層と最後の層はフルコンテキストにアテンションします。これにより、スライディングウィンドウ層が 43 層、グローバル層が 9 層になります。
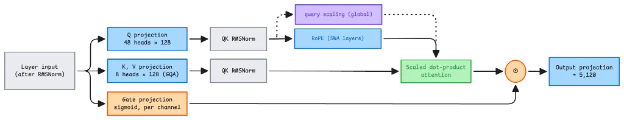
アテンションブロックの内部(両方の層タイプ)
2 種類の層は位置を異なる方法で扱います。スライディングウィンドウ層は RoPE を使用します。短いウィンドウ内では相対位置が最も重要だからです。 グローバル層は位置エンコーディングを使用しません。その代わり、各クエリは、可視トークンの数に応じてゆっくりと増大するスケーラーで乗算されます。 (1 + (pos + 1) / 2048) ** 0.1これは温度として機能します。コンテキストが長くなっても、softmax は平坦化するのではなく精度を維持します。実装では、これを scalable-softmax クエリスケーリングと呼んでいます。
アテンションは 48 個のクエリヘッドと 8 個のキーバリューヘッドを持つ grouped-query attention を使用し、クエリとキーに RMSNorm を適用します。層入力から計算される学習済みの sigmoid ゲートが、出力射影の前に各ヘッドのすべてのチャネルをスケーリングします。
Mixture of Experts
最初の3層は密なSwiGLU MLPを使用します。残りの49層は、それを256エキスパートからなるMixture-of-Expertsブロックに置き換えています。各エキスパートは中間サイズ2,560、約39MパラメータのSwiGLU MLPです。エキスパートがモデルのパラメータの98.4%を占めています。
ルーターはDeepSeek-V3のグループ限定方式に従います。全256エキスパートをシグモイドでスコアリングし、32個ずつの8グループに分割し、上位4グループ(各グループの上位2スコアの合計でランク付け)を残し、その中からトップ8のエキスパートを選択します。BeamはDeepSeek-V3と同じグループサイズを使用しますが、共有エキスパートはありません。エキスパートの出力は正規化されたルーター重みで結合され、2.5倍にスケールされます。
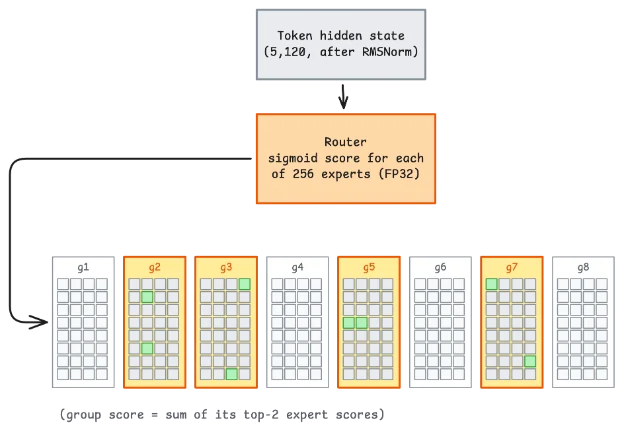
トークンごとに実行されるのは8エキスパートのみなので、モデルは各トークンを約23Bパラメータで計算します。全256エキスパートがメモリに常駐するため、デプロイには501Bモデル分のメモリが必要ですが、23Bモデルの速度で動作します。BF16チェックポイントはsafetensors形式で約1 TBです。NVFP4チェックポイントはNVIDIA Blackwell GPU向けに大部分のパラメータを4ビット精度で保存し、精度のため一部のパラメータはBF16のまま維持されています。ハブにはFP8チェックポイントもあり、HopperおよびAmpereシリーズのチップに最適です。
Beamを自分でデプロイしたい場合は、以下のvLLMまたはSGLangのレシピを参照してください。
残差ストリーム
残差接続が最も特徴的な部分です。標準的なトランスフォーマーは、各サブレイヤーの出力を重み1でストリームに加算するため、ストリームは深さとともに成長します。
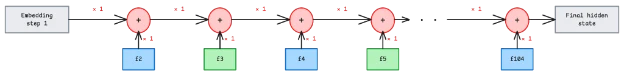
Beamは入力埋め込みをステップ1として数えます。ステップ k では、サブレイヤーの出力を重み 1/sqrt(k) で加算し、既存のストリームを重み sqrt((k-1)/k)で保持します。2つの重みの二乗和は1になるため、ストリームは最初の層から最後の層まで一定のスケールを保ちます。104回の加算がすべて終わった後、すべてのサブレイヤー出力と入力埋め込みは、最終的な隠れ状態において同じ重みを持ちます。
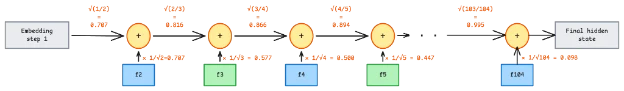
すべてのサブレイヤーは前後で正規化され、最終的なロジットは±30のtanh softcapを通ります。これはFP32で計算されます。実装では、ルーター、SwiGLUの積、ノーム、RoPE、クエリのスケーリング、softcapをFP32で計算する箇所が固定されています。
長いコンテキスト
ハイブリッドアテンションは長いコンテキストでうまく機能します。各層はトークンごとに2 x 8 KVヘッド x 128次元 = 2,048個の値をキャッシュします。全52層がすべてのトークンを保持すると、キャッシュはトークンごとに208 KiBずつ増加します。全シーケンスを保持するのは9つのグローバル層のみです。43のスライディングウィンドウ層はそれぞれ固定の512トークンのウィンドウを保持し、それ以上増加しません。したがって、キャッシュはトークンごとに36 KiBずつ増加し、これは素朴な方式のおよそ6分の1です。
| コンテキスト | 全52層がグローバルの場合 | Beam |
|---|---|---|
| 32Kトークン | 6.5 GiB | 1.2 GiB |
| 128Kトークン | 26 GiB | 4.6 GiB |
| フルコンテキスト (1M) | 208 GiB | 36.08 GiB |
これらの数値は、BF16、transformersのダイナミックキャッシュを使用した1シーケンスあたりのものです。
ベンチマーク結果
以下は、Reflectionチームから提供された、異なる精度レベルでのベンチマーク結果です。
| Beam (BF16) | Beam (FP8) | Beam (NVFP4) | |
|---|---|---|---|
| エージェンティックコーディング / ターミナル | |||
| DeepSWE v1.1 | 43.3% | 43.0% | 42.7% |
| SWE Bench Pro v2-Hard | 76.5% | 78.4% | 78.6% |
| SWE Bench Pro v1 | 66.1% | 65.9% | 65.6% |
| Terminal Bench v2.1 | 80.1% | 78.9% | 78.2% |
| SWE Atlas Codebase QnA | 31.8% | 32.2% | 31.4% |
| SWEBench Multilingual | 78.3% | 78.1% | 77.5% |
| SWEBench Verified | 81.6% | 80.2% | 80.7% |
| 推論 | |||
| AIME 2026 | 97.7% | 98.0% | 97.5% |
| HLE(ツールなし) | 36.0% | 36.0% | 34.8% |
| HLE(ツールあり) | 51.1% | 51.1% | 51.1% |
| SciCode | 49.2% | 48.3% | 46.9% |
| CriPT AA | 16.3% | 17.4% | 15.4% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
| ツール呼び出し / 検索 | |||
| AutomationBench - 公開スプリットのみ | 39.3 | 38.2 | 39.8% |
| MCP Atlas | 80.8% | 81.5% | 80.5% |
| Tau3 Banking | 36.1% | 36.8% | 35.4% |
| コンテキスト管理付き BrowseComp | 76.8% | 76.7% | 75.6% |
| コンテキスト管理付き DeepSearchQA | 80.5% | 79.6% | 81.1% |
| 一般的な能力 | |||
| AA-LCR | 78.2% | 79.4% | 78.7% |
| LongBench v2 | 67.5% | 67.6% | 67.2% |
| IFBench | 79.6% | 80.7% | 79.2% |
| AA Omniscience(インデックス)- 公開スプリットのみ | 10.8 | 8.8 | 9.8 |
ハードウェア要件
このモデルを実運用で提供する最も実用的な方法は、NVFP4チェックポイントを提供することです。NVFP4はbf16チェックポイントの品質のほとんどを維持しています。NVFP4は一部の重みを4ビットで保存するため、BF16の501Bパラメータを1 TBから約280 GBに縮小します。Blackwell GPUはNVFP4をネイティブに実行できますが、H200のようなBlackwellより古いGPUでは実行できません。FP8チェックポイントはBlackwellより古いGPUに適しています。
B200は180 GBのHBM3eを搭載しているため、2基(360 GB)でBeamの重みを保持できますが、アクティベーションとKVキャッシュのための余裕はほとんど残りません。4基のB200(720 GB)を計画すれば、長いコンテキストや同時リクエストのための十分な余裕が生まれます。8xB200のノード全体、あるいは288 GBのB300を2基、さらには8xRTX Pro 6000でも提供できます。Blackwellハードウェアをお持ちでない場合は、Inference Providers(サーバーレス)を使ってReflectionをテストできます。
推論サポート
Beamはtransformers、SGLang、vLLMでday-0サポート付きで提供されます。
Transformers
transformersの最新バージョンをインストールしてください。
pip install -U "transformers>=5.20.1"
Beamを実行する最も簡単な方法は、text-generationパイプラインです:
from transformers import pipeline

pipe = pipeline(
    "text-generation", model="reflectionai/Beam-1.0-501B-A23B", device_map="auto"
)

messages = [
    {"role": "user", "content": "Write a limerick about Python exceptions."}
]
output = pipe(messages, max_new_tokens=2000)
output[0]["generated_text"][-1]
パイプラインはチャット全体を返します。最後のメッセージがBeamの返信で、応答テンプレートによってすでに解析されています。
もう1つ下のレベルに進み、次を使用します AutoModelForCausalLM および AutoTokenizer.
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "reflectionai/Beam-1.0-501B-A23B"
tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(
    model_id, dtype="auto", device_map="auto"
)
チャット
messages = [
    {"role": "system", "content": "You should only answer with a number."},
    {"role": "user", "content": "What is 17 * 23?"},
]

inputs = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    tokenize=True,
    return_dict=True,
    return_tensors="pt",
    reasoning_effort="medium" # by default
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

outputs = model.generate(**inputs, max_new_tokens=2000)

tokenizer.parse_response(
    outputs[0][input_len:], prefix=inputs["input_ids"][0]
)
Beamのトークナイザーはレスポンステンプレートを保持しています。 parse_response 読み取って生の出力を、推論、回答、およびツール呼び出しを別々のフィールドに持つメッセージの dict に変換します。これにより、推論と回答、ツール呼び出しを分割するための通常の正規表現が不要になります。そして、そのルールはトークナイザーに付属しているため、解析された構造は Beam が生成するよう訓練されたものと一致します。チャットテンプレートはアシスタントターンの一部を事前に書き込むことができ、パーサーはそれを見る必要があります。
ツール呼び出し
\n\nツール呼び出しの完全な例\n\ndef get_weather(city: str, unit: str = "celsius"):
"""
Get the current weather for a city.
Args:
city: The city to look up.
unit: Temperature unit, "celsius" or "fahrenheit".
"""
...
tools = [get_weather]
messages = [
{"role": "user", "content": "I land in Paris tonight. Do I need a coat?"}
]
inputs = tokenizer.apply_chat_template(
messages,
tools=tools,
add_generation_prompt=True,
tokenize=True,
return_dict=True,
return_tensors="pt",
).to(model.device)
input_len = inputs["input_ids"].shape[-1]
outputs = model.generate(**inputs, max_new_tokens=1000)
message = tokenizer.parse_response(
outputs[0][input_len:], prefix=inputs["input_ids"][0], tools=tools
)
message.get("tool_calls")
通過 tools へ parse_response 場合も同様です。Beamはツール呼び出しの引数を、独自のXMLスタイルの文法でインラインに書き出すため、単なる 7 数値または文字列のいずれかである可能性があります。ツールのスキーマにより、パーサーは各引数を宣言された型にキャストします。
マルチGPUおよびマルチノード
Beam の設定ではエキスパート並列のプランが定義されています。エキスパート並列では、各エキスパートを 1 台のデバイスに配置します。アテンション、dense 層、埋め込み、LM head はすべてのデバイスに複製されます。その量は 8B パラメータ、BF16 で 16 GB に相当します。モデルを a で読み込みます。 DistributedConfig:
import os

from transformers import AutoModelForCausalLM
from transformers.distributed import DistributedConfig

model = AutoModelForCausalLM.from_pretrained(
    "reflection/Beam-1.0-501B-A23B",
    distributed_config=DistributedConfig(
        tp_size=int(os.environ["WORLD_SIZE"]), enable_expert_parallel=True
    ),
)
スクリプトを次のコマンドで起動します torchrun 16基のH200 GPUに分散する場合、各GPUは78 GBの重みを保持します。8基の場合は各139 GBとなり、141 GBのH200には収まりきりません。デバイス数はエキスパート数256の約数でなければなりません。
vLLM
Beam は vLLM で day 0 サポートを提供しています。以下のコマンドは、BF16 チェックポイントを 16 GPU(8x H200 ノード 2 台)でテンソル並列を使ってサーブし、OpenAI 互換 API を公開します:
vllm serve reflection/Beam-1.0-501B-A23B --tensor-parallel-size 16 --served-model-name beam
高速な生成のためには、DFlash2 speculative decoding を追加してください。小型のdrafterモデルが最大15トークン先を提案し、Beamがそれらをすべて1回のforward passで検証するため、各ステップで複数のトークンを受け入れられます。その代償として、drafter用にわずかに追加のメモリが必要です:
vllm serve reflection/Beam-1.0-501B-A23B \
  --tensor-parallel-size 16 \
  --speculative-config '{ "method": "dflash", "model": "reflection/dflash2-drafter-preview", "num_speculative_tokens": 15 }'
両方のコマンドはOpenAI互換サーバーを起動するため、任意のOpenAIクライアントを向けて接続できます http://localhost:8000/v1。追加のサービング構成については、次を参照してください: vLLM 向けに提案された Beam レシピ.
SGLang
BeamはSGLangでもday-0サポートを備えています。以下の両方のコマンドで有効になるDFlash2仕様的デコーディングを使った提供をお勧めします。Blackwellでは、NVFP4チェックポイントが4基のB300に収まります:
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-NVFP4 \
--served-model-name beam \
--tp 4 \
--attention-backend trtllm_mha \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
Hopper GPUでは、代わりにFP8チェックポイントを8基のH200で使用してください。変更するフラグは3つだけです:チェックポイント、テンソル並列サイズ(4ではなく8)、およびアテンションバックエンド(Blackwellが必要なtrtllm_mhaではなくfa3):
python -m sglang.launch_server \
--model-path reflection/Beam-1.0-501B-A23B-FP8 \
--served-model-name beam \
--tp 8 \
--attention-backend fa3 \
--page-size 64 \
--context-length 1048576 \
--mem-fraction-static 0.85 \
--enable-unified-memory \
--speculative-algorithm DFLASH \
--speculative-draft-model-path reflection/Beam-1.0-501B-A23B-DFlash2 \
--speculative-dflash-block-size 8 \
--tool-call-parser beam --reasoning-parser beam \
--host 0.0.0.0 --port 30000
推論プロバイダー
BeamはHugging Face Inference Providersで利用可能です。Baseten、Fireworks、Togetherが提供しており、今後さらに追加される予定です。
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://router.huggingface.co/v1",
    api_key=os.environ["HF_TOKEN"],
)

completion = client.chat.completions.create(
    model="reflection/Beam-1.0-501B-A23B:auto",
    messages=[{"role": "user", "content": "What is the capital of France?"}],
)

print(completion.choices[0].message)
推論エンドポイント
Beamレシピを用意しました。以下のカタログからInference Endpointsにワンクリックでデプロイできます。 FP8 または NVFP4、または次のコマンドでインストールしてください hf CLI は次のようになります:
hf endpoints catalog deploy --repo reflection/Beam-1.0-501B-A23B --name beam
テストした内容
私たちは、Reflection プラットフォームを通じて、低推論と高推論のそれぞれ 1 回ずつ、5 つのタスクにおける Reflection Beam-501B-A23B の vibe eval をいくつか共有します。これらはベンチマークではなく vibe eval です。Beam の利用を検討している方にとって、実際に触れてみて特定のユースケースでの挙動を確認し、さらにはどのような場面で優れ、どのような場面で劣るかを知るのに最適な方法です。
以下は、実行したプロンプトの概要とハブからの出力トレースです。完全な入力、出力、API 使用状況、タスクフィクスチャ、グレーダー、会話トレースは この公開 Hugging Face バケット.
| カテゴリ | プロンプトの説明 | 低推論(トークン) | 高推論(トークン) |
|---|---|---|---|
| マルチステップのツール呼び出し | ORD-742 を処理する:在庫、予約、追加料金、到着日を比較し、条件を満たす最も安い倉庫を予約する。 | ✅ 544 | ✅ 811 |
| コードベースに対する長文脈の検索 | 3 つの完全なソースファイルから Click コマンドの設定と 2 つの実行結果を導き出す。6 つの実装シンボルを引用する。 | 🔴 1,613 * | ✅ 5,007 |
| サンドボックス内のターミナルタスク | CSV台帳CLIを検査して修復する。すべてのバグを修正し、テストを維持したまま、テストとCLIチェックを実行すること。 | ✅ 582 | ✅ 1,548 |
| 数学的推論(AIME形式) | {1, …, 16} の8元部分集合のうち、その和が17で割り切れるものはいくつあるか?理由を述べよ。 | 🟠 829 † | ✅ 2,809 |
| 構造化出力 | 順序が乱れたリビジョンログを厳密なJSONに変換する:パッチ、キャンセル、null、日付、通貨、合計をマージする。 | ✅ 1,040 | ✅ 2,088 |
* Low の長文コンテキスト応答は、すべてのコード動作と6件のソース引用をすべて正しく再現しました。ただし、その応答はパーサーの形式に対応していなかったため、これは部分的にはプロンプトの曖昧さが原因です。
† Low は正解を返したが、求められていた根拠の説明を省略した。High は一乗根を用いた正しい証明を提示し、独立に検証された。
私たちの言葉を鵜呑みにしないでください。ぜひご自身で バケット「、あなたのユースケースやプロジェクトに合わせて書き換え、Beam を限界まで使い倒してください。」
ポストトレーニング ビーム
Beam は自分のユースケースに合わせてファインチューニングできます。ここでは、教師ありファインチューニングと強化学習を始めるための例を TRL と Miles でいくつか紹介します。
TRLを使ったSFT
Beamを自身のデータに適応させる最も迅速な方法は、TRLのSFTTrainerを使った教師ありファインチューニングです。メモリ負荷を抑えるため、全501Bパラメータを更新するのではなく、PEFTでLoRAアダプタを学習します。
TRLの SFTTrainer Beamをシンプルな目標に適応させること:ユーザーが要求した言語で推論を維持することです。我々は以下のデータでファインチューニングを行いました。 Multilingual-Thinking LoRA を使用します。LoRA はベースモデルを凍結したまま、少数のアダプター重みのみを学習します。
このセットアップは、ロード時のモデルシャーディング、エキスパート並列、FlashAttention 4、およびシーケンスパッキングを組み合わせています。LoRA SFT は B300 GPU 8 枚の単一ノードに収まり、毎秒約 19,000 トークンに到達します。対応する H100 セットアップでは 4 ノードが必要です。
Multilingual-Thinking を 1 エポック学習した後、Beam はヘルドアウトの 16 プロンプト中 16 で要求された言語で推論しました。ベースモデルは 16 中 3 でした。この小規模な評価は、推論自体の正確さではなく、言語への従順さを測定するものです。
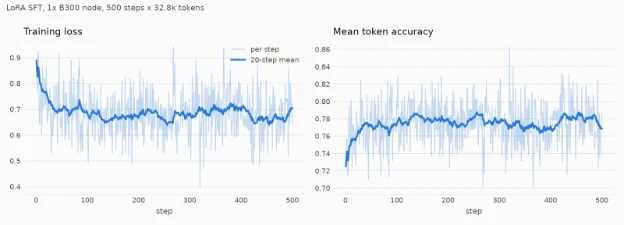
学習損失(左)と平均トークン精度(右)。open-r1/Mixture-of-Thought の推論サブセットを用いて、8-GPU B300 ノード 1 台による別の 500 ステップ実行中のものです。これらの学習メトリクスは公式の TRL example PR.
Miles による GRPO
Reflection と RadixArk は、Miles で BF16 により GRPO を用いてモデルを学習するレシピを構築しました。フルモデルを更新することも、ベースの重みを凍結したまま LoRA でアダプターを学習することもできます。Megatron が学習を行い、SGLang がロールアウトを生成し、Miles が各更新後に新しい重みをロールアウトエンジンへ公開します。我々はこのレシピを確認しました。
| ワークロード | リファレンス構成 |
|---|---|
| 推論 / 評価、BF16 | エンジンごとに H200 16 基 |
| フルパラメータ GRPO、BF16(Miles) | H200 96 基:学習 64 基、ロールアウト 32 基。あるいはコロケーション構成で H200 64 基。 |
| LoRA GRPO、BF16(Miles) | H200 32 基:学習 16 基、ロールアウト 16 基。 |
| フルパラメータ GRPO、BF16、128 トークンコンテキスト(Miles) | 48x H200: トレーニング用に32、ロールアウト用に16。この構成は、ReflectionとRadixArkがまず実際のチェックポイントで検証したものです。 |
このレシピはDAPO-Math-17K上でGRPOを実行し、AIME25で評価します。イメージをビルドし、データをダウンロードし、8x H200ノード12台のRayクラスタにジョブを投入します:
docker build -f docker/Dockerfile.beam -t miles-beam .

python scripts/run_beam.py prepare \
  --model-id reflection/Beam-1.0-501B-A23B \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets

export MASTER_ADDR=10.0.0.1
export RAY_ADDRESS=http://${MASTER_ADDR}:8265

python scripts/run_beam.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
ロールアウトで何が起こるか:
サンプル: 32個のプロンプトがモデルに渡され、それぞれ8個の応答が生成されます。2つのSGLangエンジンがそれぞれ16基のGPUでロールアウトを処理します。
スコアリング: ボックスで囲まれた回答が正解ラベルと照合され、長さ制限に近い応答にはソフトなペナルティが課されます。
更新: 256サンプルすべてで1回のオプティマイザーステップを実行。グループ相対のアドバンテージに切り詰められた重要度サンプリングを用い、KL項もエントロペナルティもありません。
並行してトレーニングする: テンソル並列8、エキスパート並列8、データ並列8、シーケンス並列と完全再計算を組み合わせています。
オプティマイザー: Adamを1e-6の一定値で使用します。勾配はBF16、マスター重みはFP32、モーメントはBF16です。オプティマイザの状態はノードローカルのNVMeをストリーミングするため、各トレーナーノードには2 TBのスクラッチ領域が必要です。
評価: AIME25を5ロールアウトごとに実行し、問題ごとに8サンプルを使用します。チェックポイントは20ごとに保存されます。
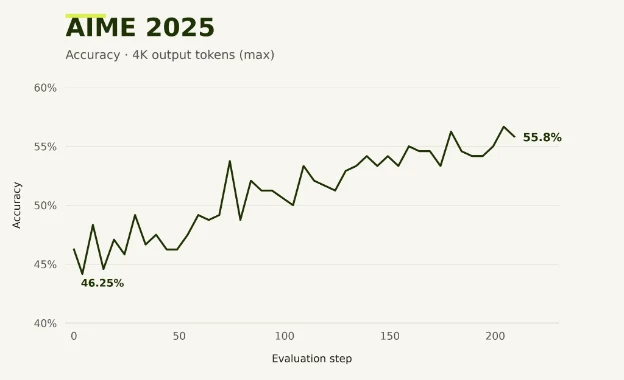
現在のロールアウトが学習している間に次のロールアウトが生成されるため、応答は1更新遅れています。Add --resume 最後のチェックポイントから再開する。 execute-colocate 8 ノードで同じレシピを実行し、すべての GPU が訓練と推論を順番に行います。
LoRAで学習する
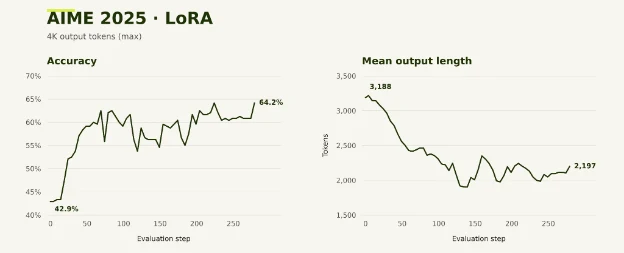
4台の8× H200ノードでもLoRAによるGRPOを実行できます。訓練用に16基、ロールアウト用に16基のGPUを使用します。このレシピでは、Beamのattention層、dense MLP層、expert層にrank-16のアダプタを訓練し、ベースの重みは凍結したまま保ちます。SGLangと同期されるのはアダプタの重みのみで、オプティマイザの状態はGPUメモリ内に留まるため、NVMeへのオプティマイザのオフロードは不要になります。
python scripts/run_beam_lora.py execute \
  --model-dir /root/models/Beam \
  --data-dir /data/datasets \
  --output-dir /root/shared_data/beam-run \
  --num-rollout 100
Beamで構築:デモ
Beamで何かを作成したら、ハブで共有して$10,000を獲得するチャンスをつかみましょう。必要なのはスペース、モデル、またはデータセットリポジトリを作成し、それを モデルのリポジトリページ。ご参考までに、私たちが構築したものをいくつかご紹介します。
ねえ Beam、MacOS のネイティブローカルアプリケーションを作って!
Hugging Faceでは、ハードウェア上でネイティブに動作するオープンでローカルなモデルを大切にしていますが、Macでネイティブアプリを構築するのは大変なこともあります!Beamが私たちの助けになるか見てみましょう。
Beamに、音声をテキストに変換してカーソル位置に便利に挿入してくれるネイティブのMacOSアプリケーションの構築を依頼しました。Mac Metalの性能を最大限に引き出すためにMLXを使用し、優れた音声書き起こしのためにParakeet Modelを採用したいと考えています。
Build BeamSpeak, a native macOS menu bar dictation app with a compact recording pill and no main window or account.

Use ⌘⇧Space to start and stop microphone recording, showing elapsed time, microphone level, and transcription status. Run speech recognition entirely locally using a Hugging Face model, preferably Parakeet v3 through MLX, and keep the model loaded between recordings. Paste the transcript into the original app if it remains focused and Accessibility permission is granted; otherwise copy it to the clipboard, preserving newer clipboard changes and never pressing Enter. Handle permissions, cancellation, silence, errors, a two-minute recording limit, and temporary audio cleanup. Deliver source code, a runnable BeamSpeak.app, setup instructions, and verification of offline transcription, the physical shortcut, microphone capture, and text delivery.
BeamとPiコーディングハーネスを使用して、MLXでParakeetを実行する初期のネイティブmacOSメニューバーアプリを構築しました。保存された実行記録にはフォローアッププロンプトが含まれています。最終的なソースには、その後のCodexによる修復も含まれています。上記のプロンプトは、ビルド要件を簡潔にまとめたバージョンです。
Beamがこれをどのように構築したかのエージェントのトレースを pi in で確認できます このトレース。デモを試したい場合は、次をダウンロードしてください ソースコード または次のものを読む セットアップ手順.
ねえ Beam、複数のエージェントでどうやってスケールするの?
Beamがプログラミングタスクを複数のエージェントに分割することでより速い進捗を達成できるかどうかを検証しました。BeamをオープンソースのPiコーディングエージェントと組み合わせ、3つの構成を比較しました: 1. 単独で作業する1つのエージェント、2. 共有のGitリポジトリを通じて協力する5つの永続的なピアエージェント、3. 非同期のサブエージェントに作業を委任するリードエージェント。ハーネスはHugging Face jobs上で動作し、推論はReflectionのプラットフォームAPIを通じて行われました。
タスクにはProgramBenchを使用しました。エージェントは、ソースコードや評価者のテストを見ることなく、コンパイル済みの実行ファイルとドキュメントからプログラムを再現しなければなりません。各セットアップには同じ8M APIトークンの上限と、タスクごとに2時間のソルバー制限が設けられ、これはそのエージェント間で共有されました。実装のスナップショットを保存し、からの固定の非公開テストスイートに対して評価しました。 ProgramBench-Tests データセット.
私たちの スコアとレイテンシのプロット 合格したテストの平均割合を示しています。時間軸には、経実時間(ウォールクロック時間)ではなく、モデルトークンの固定基準レートと実測されたツール時間を用いています。当初は5つのタスクを実行しました。現在の図は、jq、xsv、FIGlet、hexylの事後的なサブセットを示したものです。保存された成果物の採点が遅すぎたため、ripgrepは3つのセットアップすべてから除外されました。公開されている結果には、元の15エピソードすべてが含まれています。
その実行結果は、次の場所で確認できます: Trackioダッシュボード「を探索し、」 公開された結果データ、および再利用する 研究ハーネス.
ねえ Beam、私のコードベース向けに決定モデルをファインチューニングして!
決定モデルは今まさに大流行しています。非常に高速で、多くのユースケースに実用的だからです。私たちはBeamから始め、Beamのクォータが使い切られた後はPiでGLM-5.3に切り替え、開発者インシデントのトリアージ向けのカスタム決定モデルを訓練・評価しました。
私たちは、コーディングエージェントがインシデントトリアージのポリシーを小型で高速な判断モデルに変換できるかどうかを検証しました。タスクは、開発者のインシデントを読み、担当チーム、その重大度、そして誰かを即座に通知すべきかどうかを選択することでした。Unslothを使用して、Qwen3.5-0.8Bをファインチューニングし、これらの選択肢を直接スコアリングできるようにしました。
まず、ワークフローはインシデントクラスタごとに分割された2.3k件のインシデントを含む合成データセットを、トレーニング、キャリブレーション、テスト用に構築しました。Science Slurmクラスター上のH100 80GBを1基使用し、4ビットのバックボーンで、LoRAアダプターと判断ヘッドを3エポックにわたってトレーニングしました。
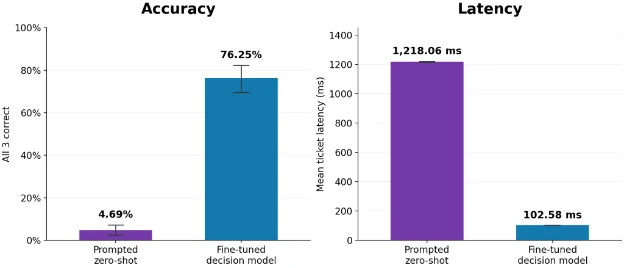
ベースラインとして、例を示さずに、チリアージポリシー全文とチケットをそのまま未適応モデルに入力し、3つの判断をJSONとして生成するよう求めました。同じ320件の合成テストチケットにおいて、ファインチューニング済みの判断モデルは3つの回答すべてを正解した割合が76.25%だったのに対し、プロンプトによるzero-shotでは4.69%でした。チケット1件あたりの平均レイテンシは1,218.06 msから102.58 msに低下し、11.9倍の高速化となりました。
この実験を自分でも試してみたい方は、以下をチェックしてください。 アーティファクトバケット データ、コード、チェックポイント、結果を含むもの。
まとめ
Beamは、自分のハードウェア上で実行し、改変することもできる501Bのオープンモデルです。まずは BF16 チェックポイント、またはいずれかの量子化版を試してください FP8, NVFP4。Beamで何かを作ったら、ぜひ ディスカッションタブ.