
要約: Reflection's Beamは、トークンごとに23Bのアクティブパラメータを持つ501BパラメータのMoEモデルです。vLLMはday 0からこれをサポートし、NVIDIA Blackwell上で最適化を行っています。
- フル機能対応。 推論、ツール呼び出し、構造化出力はそのまま動作し、モデルはテンソル並列、データ並列、またはエキスパート並列で実行できます。
- エージェント駆動の最適化。 コーディングエージェントがモデルを自律的に最適化し、batch-1 デコードを最初の実装より2.71倍、プリフィルを1.87倍高速化しました。
- 適応型ベリフィケーションを備えたDFlash2。 BeamのDFlash2ドラフターにより、1件のリクエストが 708トークン/秒 TP8 上で、受け入れ長は 3.7 です。各ステップで検証に値するドラフトトークンの数を決定する適応的検証(Adaptive verification)は、さらに スループット10%向上 高同時実行時において。
試してみるには、私たちのDockerイメージをご利用ください vllm/vllm-openai:reflection-beam:
docker run --gpus all --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  vllm/vllm-openai:reflection-beam \
  reflection/Beam-1.0-501B-A23B-NVFP4 \
  -tp 4 \
  --max-num-seqs 128 \
  --reasoning-parser beam \
  --tool-call-parser beam --enable-auto-tool-choice \
  --kv-cache-dtype fp8 \
  --attention-config '{"backend":"FLASHINFER"}' \
  --kernel-config '{"enable_flashinfer_autotune":false}' \
  --speculative-config '{
    "method": "dflash",
    "model": "reflection/Beam-1.0-501B-A23B-DFlash2",
    "num_speculative_tokens": 7,
    "attention_backend": "FLASH_ATTN"
  }'
モデルのアーキテクチャ
Beamは隠れサイズ5120の52層MoEデコーダーです。MoEのルーティングはDeepSeek-V3に従います。主な違いは、attention層とresidual streamの正規化の方法にあります。
図1: Beamのレイヤースタックとスパースデコーダレイヤー1層。金色で示した部分が、標準的なpre-norm MoEと異なる箇所です。 全画面で開く.
注意
- ハイブリッドなスライディングウィンドウとNoPEレイヤー。 43層は直近の512トークンに対するスライディングウィンドウ・アテンションをRoPEとともに使用します。残りの9層(6層ごとに1層、および最終層)は、以下の要素を用いて全コンテキストに対してアテンションを行います。 位置エンコーディングなし(NoPE).
- NoPEレイヤー上のSSMax。 RoPE がない場合、キーの数が増えるにつれて注意(attention)は平坦化します。SSMax は各クエリを以下のようにスケーリングします。
(1 + p/2048)^0.1、そこではpは1から始まる位置であり、したがってコンテキストが大きくなるにつれてソフトマックスが鋭くなる。 - ヘッドごとのQ/K正規化を備えたGQA。 クエリヘッド48個、KVヘッド8個、ヘッド次元128。QとKは、RoPEまたはSSMaxの前にヘッドごとにRMS正規化されます。
- シグモイド出力ゲート。 前
o_proj各ヘッドの出力には σ(gate + bias) が掛けられます。ここで gate は各ヘッド自身の全幅投影から得られ、bias は学習されたヘッドごとのバイアスです。ヘッドはトークンごとに弱められたり、オフにされたりできます。 - 小さなKVキャッシュ。 9つの全注意層のみがシーケンス全体のKVを保持します:
- トークンあたり 9 × 2 × 8 × 128 個の値、つまり BF16 では 36 KiB、FP8 では 18 KiB です。
- シャーディング前の状態で、フル1Mトークンのコンテキストに対して約18 GiBのFP8 KVが必要です。
MoEと残差ストリーム
- DeepSeek-V3スタイルのMoE。 256個のルーティングエキスパート(d_ff 2,560、NVFP4)は、DeepSeek-V3と同じ方法でルーティングされます。すなわち、シグモイドスコアと補正バイアスにより8つのエキスパートグループから最良の4グループを選び、次に上位8エキスパートを選択し、再正規化された重みに2.5を乗じます。DeepSeek-V3と異なり、共有エキスパートはありません。レイヤー0~2では、代わりに密なSwiGLU MLP(d_ff 20,480)を使用します。
- FP32ルーター。 5120 × 256 のルーターウェイト、累積値、およびロジットはすべて FP32 です。
- サンドイッチの基準。 すべてのサブレイヤーの前後に、RMSNormが1つずつ配置されています。
- 深さに応じてスケールされた残差。 その n-th residual add computes
h ← √((n−1)/n)·h + x/√nの代わりにh + x「サブレイヤー出力の分散が1であることで、残差ストリームは深さに応じて成長するのではなく、どの深さでも分散1を保ちます。」
エージェント駆動の最適化
当初の実装バージョンは、最適化されていない、ほぼ純粋なPyTorchによるモデル実装でした。その後、コーディングエージェントを使って自律的に最適化を行いました。エージェントはモデルをプロファイリングし、カーネルを作成し、各変更をベンチマークしました。TP8環境において、以下の7つの変更により、バッチ1のデコードが1ステップあたり8.95 msから3.30 msへ、また8 × 2Kのプリフィルが328 msから176 msへ短縮されました。
図2: 各変更後のGB200におけるTP8モデル順伝播のレイテンシ。バッチ1のデコード、およびコンテキスト約100Kでの8 × 2,048トークンのプリフィルの結果を示す。2つのパネルはスケールが異なる。正確な値は表を参照、または 全画面で開く.
- 融合正規化 → 残差 → 正規化 (−40% デコード)。104個のサブレイヤー境界それぞれにおけるポストノーム、スケール済み残差加算、および次のプレノームが、現在は1つのTritonカーネルとして実行され、FP32演算とリファレンス実装のBF16丸めポイントを維持しています。
- Q/K正規化、RoPE/SSMax、および出力ゲートを融合。 ヘッドごとのQ/K RMSNormとRoPE(またはSSMax)は1つのカーネルとして実行され、シグモイドゲートは別のカーネルとして実行されます。
- ノーマライズにオールリデュースを融合した。 各レイヤーにおける両方のTP all-reduceはnormカーネル内で実行され、FlashInferのマルチキャストall-reduceを基盤としています。MoEの後、同じカーネルがtop-8エキスパートの出力も統合します。
- FP32ルーター向けの特殊化GEMMカーネル。 このルーターは従来、汎用的なパスにフォールバックしていました。vLLMの小バッチFP32ルーターカーネルがBeamの5120 × 256シェイプに対応し、FP32の重み、累積、およびロジットが維持されます。
- 低レイテンシのGEMMによるQKV + ゲート射影の統合。 Q、K、V、およびゲートの重みはロード時に1つの行列にパックされるため、4つの射影が1つのGEMMとして実行されます。小バッチの場合は、低レイテンシのCuTe DSL GEMMまたはFlashInferのTinyGEMMを使用します。
- KVキャッシュ更新の融合。 Q/K normおよびRoPEカーネルは、KとVをKVキャッシュにも書き込むようになったため、別途キャッシュ書き込み用カーネルは不要です。
- 1つのカーネルでのDense-MLP活性化 3つのdense層に対して。
融合されたグラフ
これらの変更により、1つのMoE層は 13個のカーネル として、バッチ1デコードのTP8で実行されます。
図3: バッチ1 TP8デコードのrank-0トレースにおける、1つのMoE層の起動順に並んだカーネル。金色のカーネルはBeam向けに作成、融合、または拡張されたものです。各カーネルは計算する操作を列挙しています。 全画面で開く.
- 6個のカーネルはBeam向けに作成、融合、または拡張されたものです。 小さなBeam固有の操作はすべて隣接するカーネルに統合され、両方のall-reduceはnormカーネル内に配置されています。
- 7個のカーネルはライブラリから提供されています: TRTLLM-gen attention、cuBLASの出力投影、およびTRTLLM NVFP4 MoEパス(量子化、2つのルーティングカーネル、2つのgrouped GEMM)です。残りの時間の大部分はここにあり、次の最適化対象です。
Attention DP + MegaMoE
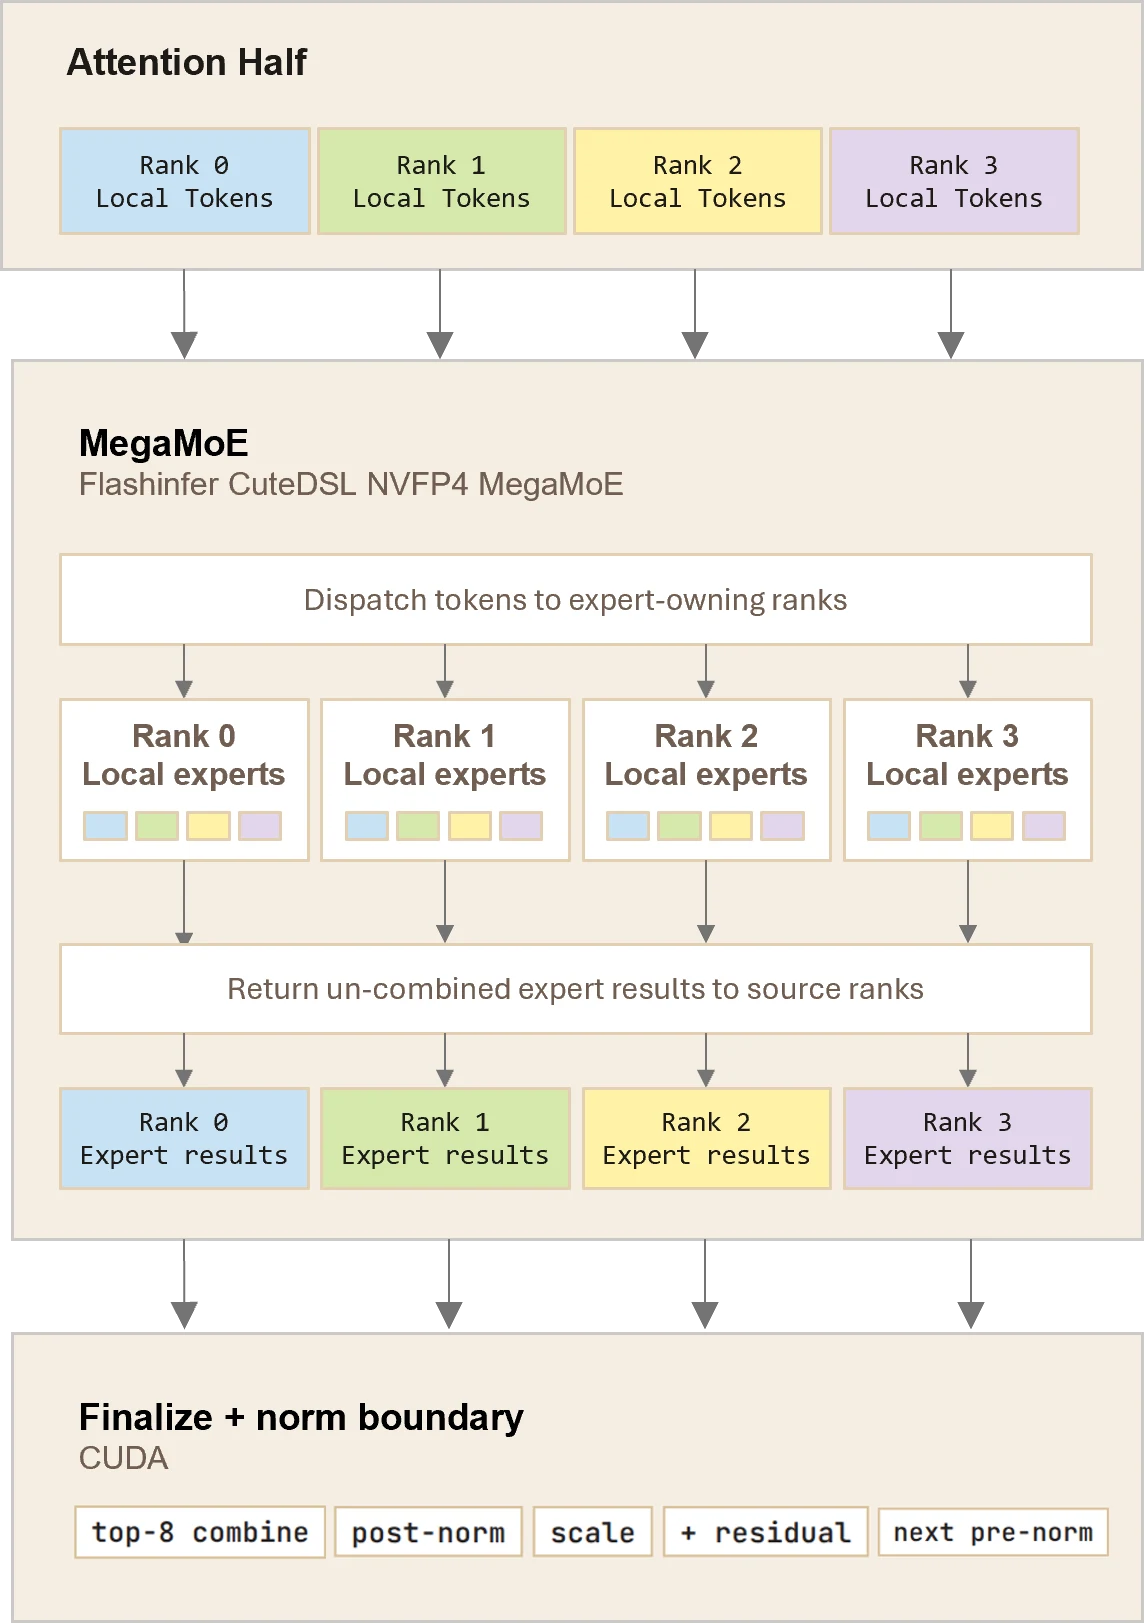
図4: FlashInfer CuteDSL NVFP4 MegaMoEは、通信とエキスパート計算を融合できます。
高同時実行領域では、Attention DPをMegaMoEと組み合わせることで、Beamの性能をさらに向上できます。これはFlashInferのCuTe DSL NVFP4 MegaMoEカーネルによるものです。Finalize + norm境界の融合も引き続き適用可能です。
| 構成 | ピーク入力トークンスループット |
|---|---|
| Attention DP + MegaMoE | 168.8Kトークン/秒 |
TP (flashinfer_trtllm, flashinfer_nvlink_one_sided) | 98.7Kトークン/秒 |
Attention DPとMegaMoEの組み合わせは、TP4と比較して1.71倍高いピークプリフィルスループットを実現しました。ベンチマーク構成: 4×GB300、入力シーケンス長32Kトークン、出力シーケンス長1トークンで、プリフィル性能を分離して測定しています。
Attention DP + MegaMoEを有効にするには、MoEと並列化の設定を以下に置き換えます:
  --moe-backend flashinfer_moe_ep_cutedsl \
  --data-parallel-size 4 \
  --enable-expert-parallel
DFlash2 スペキュレーティブデコーディング
Beamには DFlash2 vLLMがday 0からサポートしているドラフトヘッドです。1トークンずつドラフトする代わりに、ターゲットモデルの隠れ状態から1回のフォワードパスでトークンのブロック全体を予測します。
- ドラフター。 5つのスライディングウィンドウ層が5つのターゲット層から隠れ状態を読み取り、ターゲットのembeddingとLMヘッドを共有します。grouped convolutionと小さな候補セレクターにより、並列ドラフターで失われる左から右への依存関係を一部回復しています。
- 適応型検証。 しかし
"enable_adaptive_verification": true, vLLM は各ドラフトトークンが受理される可能性を予測し、1ステップあたりの固定数ではなく、コストに見合うトークンのみを検証します。DFlash2 には confidence head がないため、受理の推定はドラフター自身の logits から得られます(詳細は弊社の 適応的検証に関する最近の投稿). - カーネル。 ドラフターの畳み込み、ノルム、KV書き込みは融合されており、ドラフトステップ全体がCUDAグラフで実行されます。FP8 KVキャッシュはドラフターでも機能し、受容率に変化はありません。
低エントロピーカテゴリにおける、適応的検証ありとなしの TP8 での推論結果 SPEED-Benchの throughput_1k split: 約1Kトークンのプロンプトで、主にコード補完とテキストの並べ替え、greedy decoding(貪欲デコード)を使用し、出力トークンは最大4K。エントロピーの低いテキストは予測しやすいため、自由度の高いチャットでは受理率が低下すると予想されます。
| 並行性 | 固定ドラフト (tok/s) | Adaptive(tok/s) | 変更 | 採択までの長さ |
|---|---|---|---|---|
| 1 | 708 | 707 | −0.1% | 3.71 → 3.61 |
| 8 | 3,232 | 3,221 | −0.3% | 3.67 → 3.57 |
| 32 | 7,744 | 8,275 | +6.9% | 3.68 → 3.29 |
| 128 | 15,012 | 16,632 | +10.8% | 3.68 → 3.23 |
負荷がかかった状況で適応型検証は効果を発揮します。同時実行数128では出力スループットを10.8%向上させ、p99 TPOTを9%削減します。その一方で、ステップごとに検証するドラフトトークン数が減るため、受理長はわずかに下がりますが、失う計算量よりも多くを節約できます。同時実行数が低い場合は、追加のドラフトトークンがほぼ無料であるため、影響は中立です。
はじめに
本投稿の先頭にあるコマンドは良いデフォルト設定です。単一のGB300ノード上でTP4、DFlash2およびFP8 KV cacheを使用します。適応型検証を有効にするには、次を追加します "enable_adaptive_verification": true への --speculative-config。上記のその他の最適化はデフォルトで有効になっています。
- 並列構成の選択について。
- 最低レイテンシを求める場合は、TP4 または TP8 を使用してください。
- より高いスループットを求める場合は、エキスパート並列と組み合わせたデータ並列アテンションを使用してください。例えば、
-dp 4 --enable-expert-parallel.
- 推論とツール呼び出し。 この
beamパーサーは、チェックポイントに同梱されているレスポンステンプレートを読み取ります。デフォルトでは、vLLM はすべてのレスポンスをそのテンプレートに制約するため、ツール呼び出しは常にパースされ、各ツールの JSON スキーマに適合します。response_formatとthinking_token_budgetは通常どおり機能します。デフォルトの制約を無効にするには、VLLM_BEAM_ALWAYS_CONSTRAIN_OUTPUT=0.
SkyRL による強化学習(RL)の Day 0 サポート
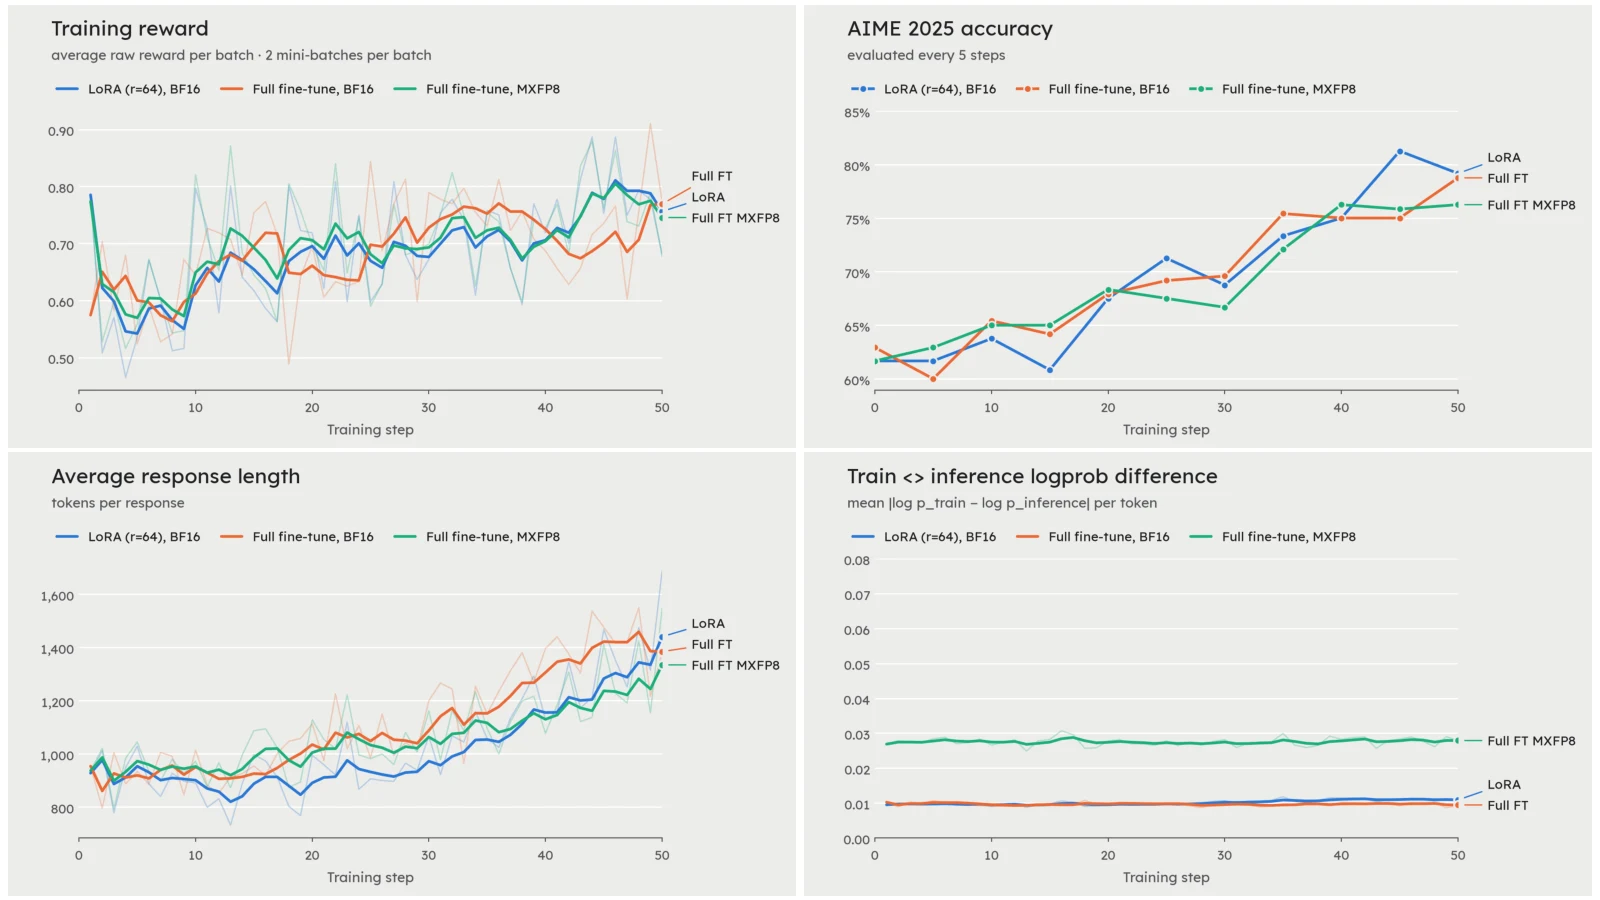
また、SkyRL チームと協力し、Beam における強化学習(RL)の Day 0 サポートを実現しました。LoRA、BF16 フルファインチューニング、MXFP8 RL が out of the box でサポートされており、500B スケール向けに強化された RL スタックを備えています。
SkyRL チームは、推論に vLLM、学習に Megatron を用いた DAPO レシピで Beam モデルをポストトレーニングしました。LoRA、フルファインチューニング、MXFP8 RL は、50 学習ステップ、すなわち 100 オプティマイザ更新(推論 minimal)において同等の性能向上を達成し、AIME25 での平均精度(avg@8)は約 61% から約 79% へと向上しました。LoRA と BF16 フルファインチューニングでは Rollout Routing Replay(R3)を有効にした場合、Megatron と vLLM の平均絶対対数確率差は 0.01 未満に、MXFP8 RL では 0.03 未満に抑えられています。
詳細については、SkyRL の ブログ をご覧ください!
謝辞
本件は、Inferact チーム、Reflection チーム、Nvidia チームによる緊密な協力の成果です:
- Inferact: Woosuk Kwon、Ziqi Zhao、Ao Shen、Tiezhen Wang
- Reflection: カイシン・ウー、ヨニ・ゴズラン、ニール・ゴラプディ、ティボ・バロワイエ、アイメン・カララ、マティアス・レゾ、フロラン・グベリジ
- Nvidia: Siyuan Fu