
AIの可解性は画期的な成果に近いか?新しい論文により研究者たちが分かれている
 マキシミリアン・シュライナー
のLinkedInプロフィールを表示
Oct 16, 2026
 Nano Banana ProはTHE DECODERによって起動されました。
重ね合わせ仮説の背後にある人物の一人であるニック・カンマラタによると、神経ネットワークは研究者が想定していたほど複雑ではない。OpenAIのRoonはこれを歴史的な瞬間だと言う。Google DeepMindの研究者ネイル・ナンダは、過度に大げさに言わないよう警告している。
「ニューラルネットワークはすでにクリーンだ」と題された長いエッセイの中で、ニック・カンマラタは、大規模なAIモデルの内部動作が以前思われていたよりもはるかに理解しやすいと主張している。カンマラタはGoodfireの可解性ラボの研究者である。このエッセイを通じて、彼は数年前に形作った説明を否定する。
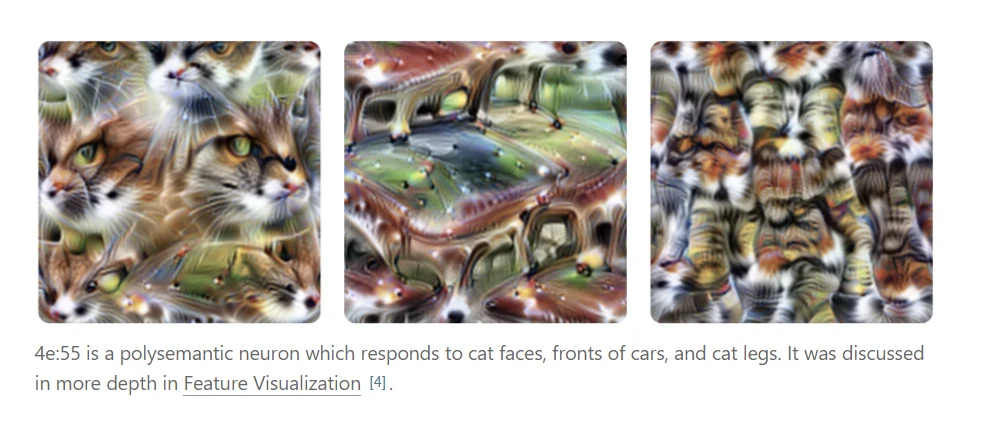
機構的な可解釈性とは、AIモデルの出力を観察するだけでなく、モデルがどのようにして答えに至るのかを内部でどのようにして行うかを追跡しようとするものです。理想的には、数百万個の人工ニューロンがそれぞれ識別可能な概念を表しているはずです。実際には、多くのニューロンが全く無関係な事柄に対して活動することがあり、研究者はこれを多義性と呼びます。初期の有名な例としては、InceptionV1の画像モデルに存在する一つのニューロンがあり、猫の顔も車のフロントも反応しました。 カンマラータは自身の初期研究でそれを例として使用した。
標準的な説明は重ね合わせである。この理論では、ネットワークがニューロンを使い果たしたとき、無関係な概念を同じニューロンに詰め込むとされる。なぜなら、それらの概念はほとんど互いに邪魔にならないからだ。その結果は結び目のように見える。そのため、多くの研究室では、スパース自動エンコーダのような第二のモデルを訓練し、概念を分離させる。そして、元のモデルではなくそのモデルを研究する。
カンマラータはこの見解の形成において重要な役割を果たした。クリス・オラハと共に、「Zoom In」という論文を執筆し、初めての重ね合わせ回路を紹介した。2023年には、OpenAIで自動化された可解性解析プロジェクトを開始した。当時、最も寛大な基準でさえも、約1.7%のニューロンしか理解可能と見なされていなかった。
証拠が誤読された可能性がある
カンマラータは今、最も有名な例が誤解されていたと考えている。彼によると、猫と車のニューロンは実際にはV字型検出器であるという。キツネの鼻のような尖った形や炎のような形がそれを活性化させるが、Oのような丸い形はその活性化を抑える。したがって、猫の顔と車という全く無関係な二つの概念を表しているわけではなく、これは重複性の例ではない。
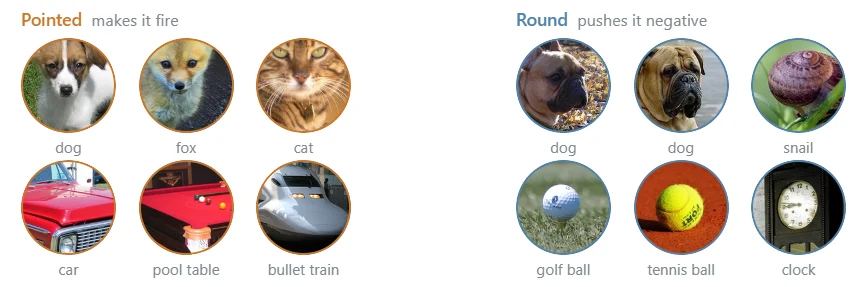
彼はまた、「Zoom In」における重ね合わせ回路を再解釈している。そこでは、車が犬のニューロンの中に隠れているように見えた。彼の見解では、これは単なる一般的化であり、回路は単に車と犬がカメラに向く方向によってグループ分けされているだけだ。彼は、InceptionV1の後期層における混乱を、時代遅れのアーキテクチャと弱い解析ツールのせいだと考えている。
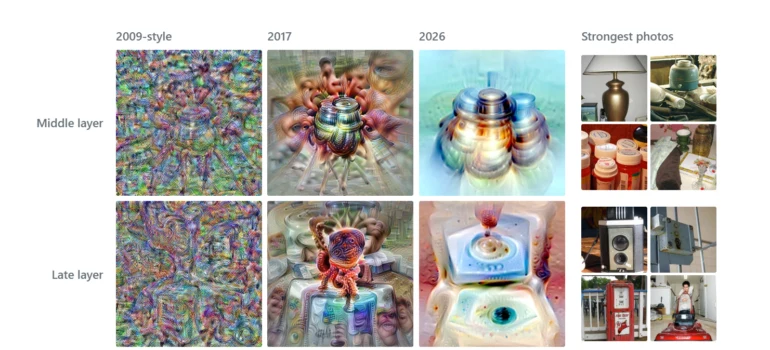
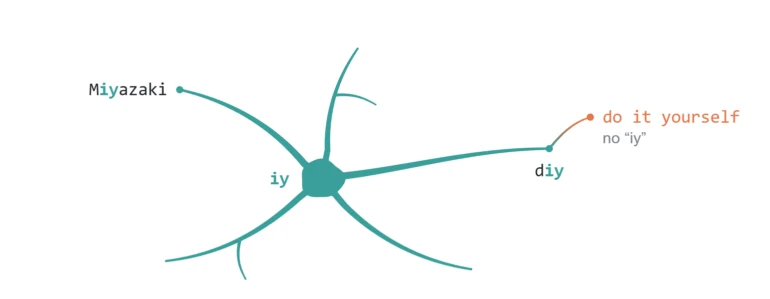
カンマラタは、「再帰的一般化」と呼ばれるパターンで残りの曖昧さを説明する。彼によると、ニューラウンズは枝が側枝を伸ばすように成長するという。文字列「iy」を認識した一つのニューラウンズが、後に「diy」や最終的には「自分でやる」という反応を示し、その「do it yourself」には「iy」は全く含まれていない。重ね合わせとは異なり、これらのグループ化によってネットワークについて何かを学ぶことができる。
言語モデルについては、予備的な数値を提供している。Qwen3-32Bでは、約90%のニューロン極が一つの主要な役割を持ち、約7%は二つの関連する役割を持っている。不明確なものは2~4%のみである。Goodfireは、数兆個のパラメータまで含むモデルでも同様の結果が得られると述べている。ニューロンを大量に分析するAIエージェントがほとんどの作業を行っている。CammarataはRich Suttonの「Bitter Lesson」を参考に、解釈可能性においても、大規模な単純な調査が巧妙な分解方法よりも優れていると結論づけている。
カマラタは根本的に新しい方法を導入していない。彼は、より良いツール、より大きなモデル、自動化されたエージェントを用いることで、ニューロンを直接研究するこの分野の元のアプローチに戻っているだけである。
読みやすいネットワークはAIの安全性にとって大きな成果となるでしょう
もしカマラタの意見が正しいなら、それは良いニュースです。特にAIの安全に関しては。現在、信頼性が低下し続ける思考の流れを監視する以外には、モデルが人々を欺いているか、危険な行動を取っているかを判断する方法はほとんどありません。カマラタは、AIを人間の目標に向けて導くというアライメントの問題は、可解性がない限り解決できないと疑っています。そうでなければ、何を作っているのかわからないからです。欺瞞には、モデルの内部回路から隠れる理由はないと彼は書いています。もし人間がネットワークの「読者」に過ぎないなら、欺瞞も見えるようになり、エラーも特定された方法で修正されるかもしれません。
オープンAIの従業員であり、Xでその偽名で投稿する人物で、AI界の影響力ある声であるローンは大変喜んでいる。彼はカマラータと親しい友人であり、彼がいなければオープンAIに入ることはなかったと言う。この仕事は「科学史における重要な瞬間として記憶されるかもしれない」と、ローンは書いている。さらに、このニュースは、AIの危機を警告する最も著名な声の一人であるエリエゼル・ユドコフスキーでさえ、災厄の確率を下げざるを得ないほど良いものだと述べている。ローンによれば、アライメントは「通常の科学」になり得るという。
Roonでさえもいくつかの懸念があります。業界の他の人々はまだ結果を確認する必要があり、彼はまた、可解性の進歩がAIの能力をさらに向上させるだろうと疑っています。これらが外部から来るという事実は、OpenAIを含む大規模なラボにとって良くない兆候です。
南田は有用な道具を見出した、画期的なものではない
ニール・ナンダははるかに慎重です。彼は機械論的可解性の創始者の一人と見なされており、Google DeepMindの可解性チームを率いています。それ以前はAnthropicで働き、独立した研究者としても活動していました。彼によると、彼の見解は変化しています。2024年半ば以降、彼は野心的な可解性についてより悲観的になり、実用的なアプローチに傾いています。彼のチームはスパース自動エンコーダに関する研究を低く評価しました。 彼らはその技術が無意味だとは思わなかったが、フィールドが費やしている努力に見合う価値はないように思えた。
カンマラタの研究は興味深いが、全体像を変えるものではない。ナンダが書いている。ニューロンベースの分析は、モデルが何故問題のある行動を取るのかといった実用的な問題に役立つかもしれない。また、フロンティアモデルへの適用もずっと容易になる。しかし、可解性が完全に解明されたと考えるのは間違っている。彼は、ニューロンベースの分析には重大な欠陥があり、多くを見落としていると予想している。
ナンダは依然として重ね合わせが実在すると考えている。言語モデルはニューロンよりもはるかに多くの事実を記憶しており、特に弱い活性化がその情報の大部分を保持していると主張する。小さな画像モデルから得られる成果が他のモデルにも当てはまるかどうかには疑問がある。また、その論文は単意性を過度に緩く定義していると考えているが、カンマラータが古い研究を現代のツールで検証したことについては認める。
争点の一部は定義に関するものです:カマラタは、寸法よりも多くの概念を表すモデルに問題を抱いていないとし、ナンダは彼がその点で同意していると考えています。カマラタが反論するのは、ネットワークが全く関係のないものを任意に一緒にまとめていることです。
技術関連の共同論文はまだ公開されていません。可解性企業であるGoodfireも、この研究に明らかな利害関係を持っています。Cammarataの見解が正しいとすれば、自動化された研究者は数ヶ月の間に、人間が画像モデルを使って10年近くかけた作業を完了できると考えています。彼は、そのための時間はあまり残っていないかもしれないと書いています。
AIニュース 過度の宣伝なし – 人間が選んだ情報
広告のない読書、毎週のAIニュースレター、年に6回の独占「AIラダー」フロンティアレポート、完全なアーカイブへのアクセス、そしてコメントセクションへのアクセスを得るために、THE DECODERを購読してください。
全体の内容はここからです。
興味をそらさない報道を希望なら、登録してください。
- THE DECODERのすべての記事に完全なアクセス権
- 広告なし
- コメントやコミュニティの議論に参加する
- 週間のAIニュースまとめをメールで送る
- 6回/年:「AIレーダー」 — 最も重要なAIに関する深い探求
- 毎日のAIニュース、常に最新です
- 私たちの完全な10年間アーカイブ
- AIで10年以上の経験を持つチームによって担当されている