

GoogleのGemini 4 Argonは、数ヶ月前のGoogleのモデルよりもAIの最先端に近い
 Matthias Bastian
のLinkedInプロフィールを表示
Oct 16, 2026
 Google
 Deepmindは、ARC-AGI-3ベンチマークで95%を達成した第2の主要なAIラボです。しかし、その結果はテスト方法に大きく依存し、Epoch AIによるとArgonは数学とソフトウェア工学の面で競争相手に匹敵します。
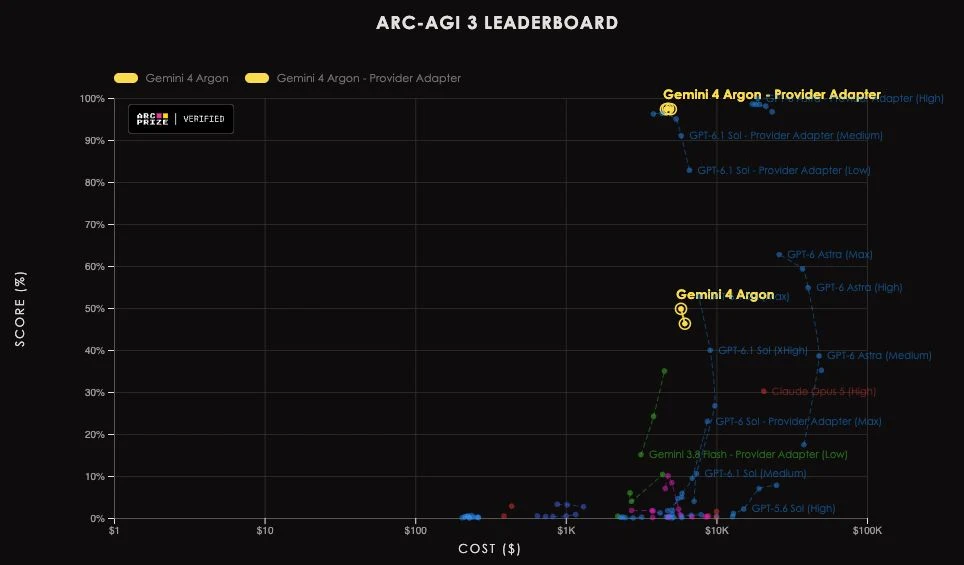
Google Deepmindの新しいフロンティアモデル、Gemini 4 Argonは、「Provider Adapter Harness」というテスト環境を使用し、4,800ドルのコストでARC-AGI-3のテストで97.5%のスコアを獲得した。このテスト環境では、保持される推論やコンテキストの圧縮といったベンダー特有の機能が利用されている。ARC Prizeによると、GoogleはOpenAIに次いで、一般的な問題解決のための最も難しいベンチマークで95%のマークを達成した2番目のAIラボとなった。GPT-6 Astraは99.9%というより高いスコアを記録している。
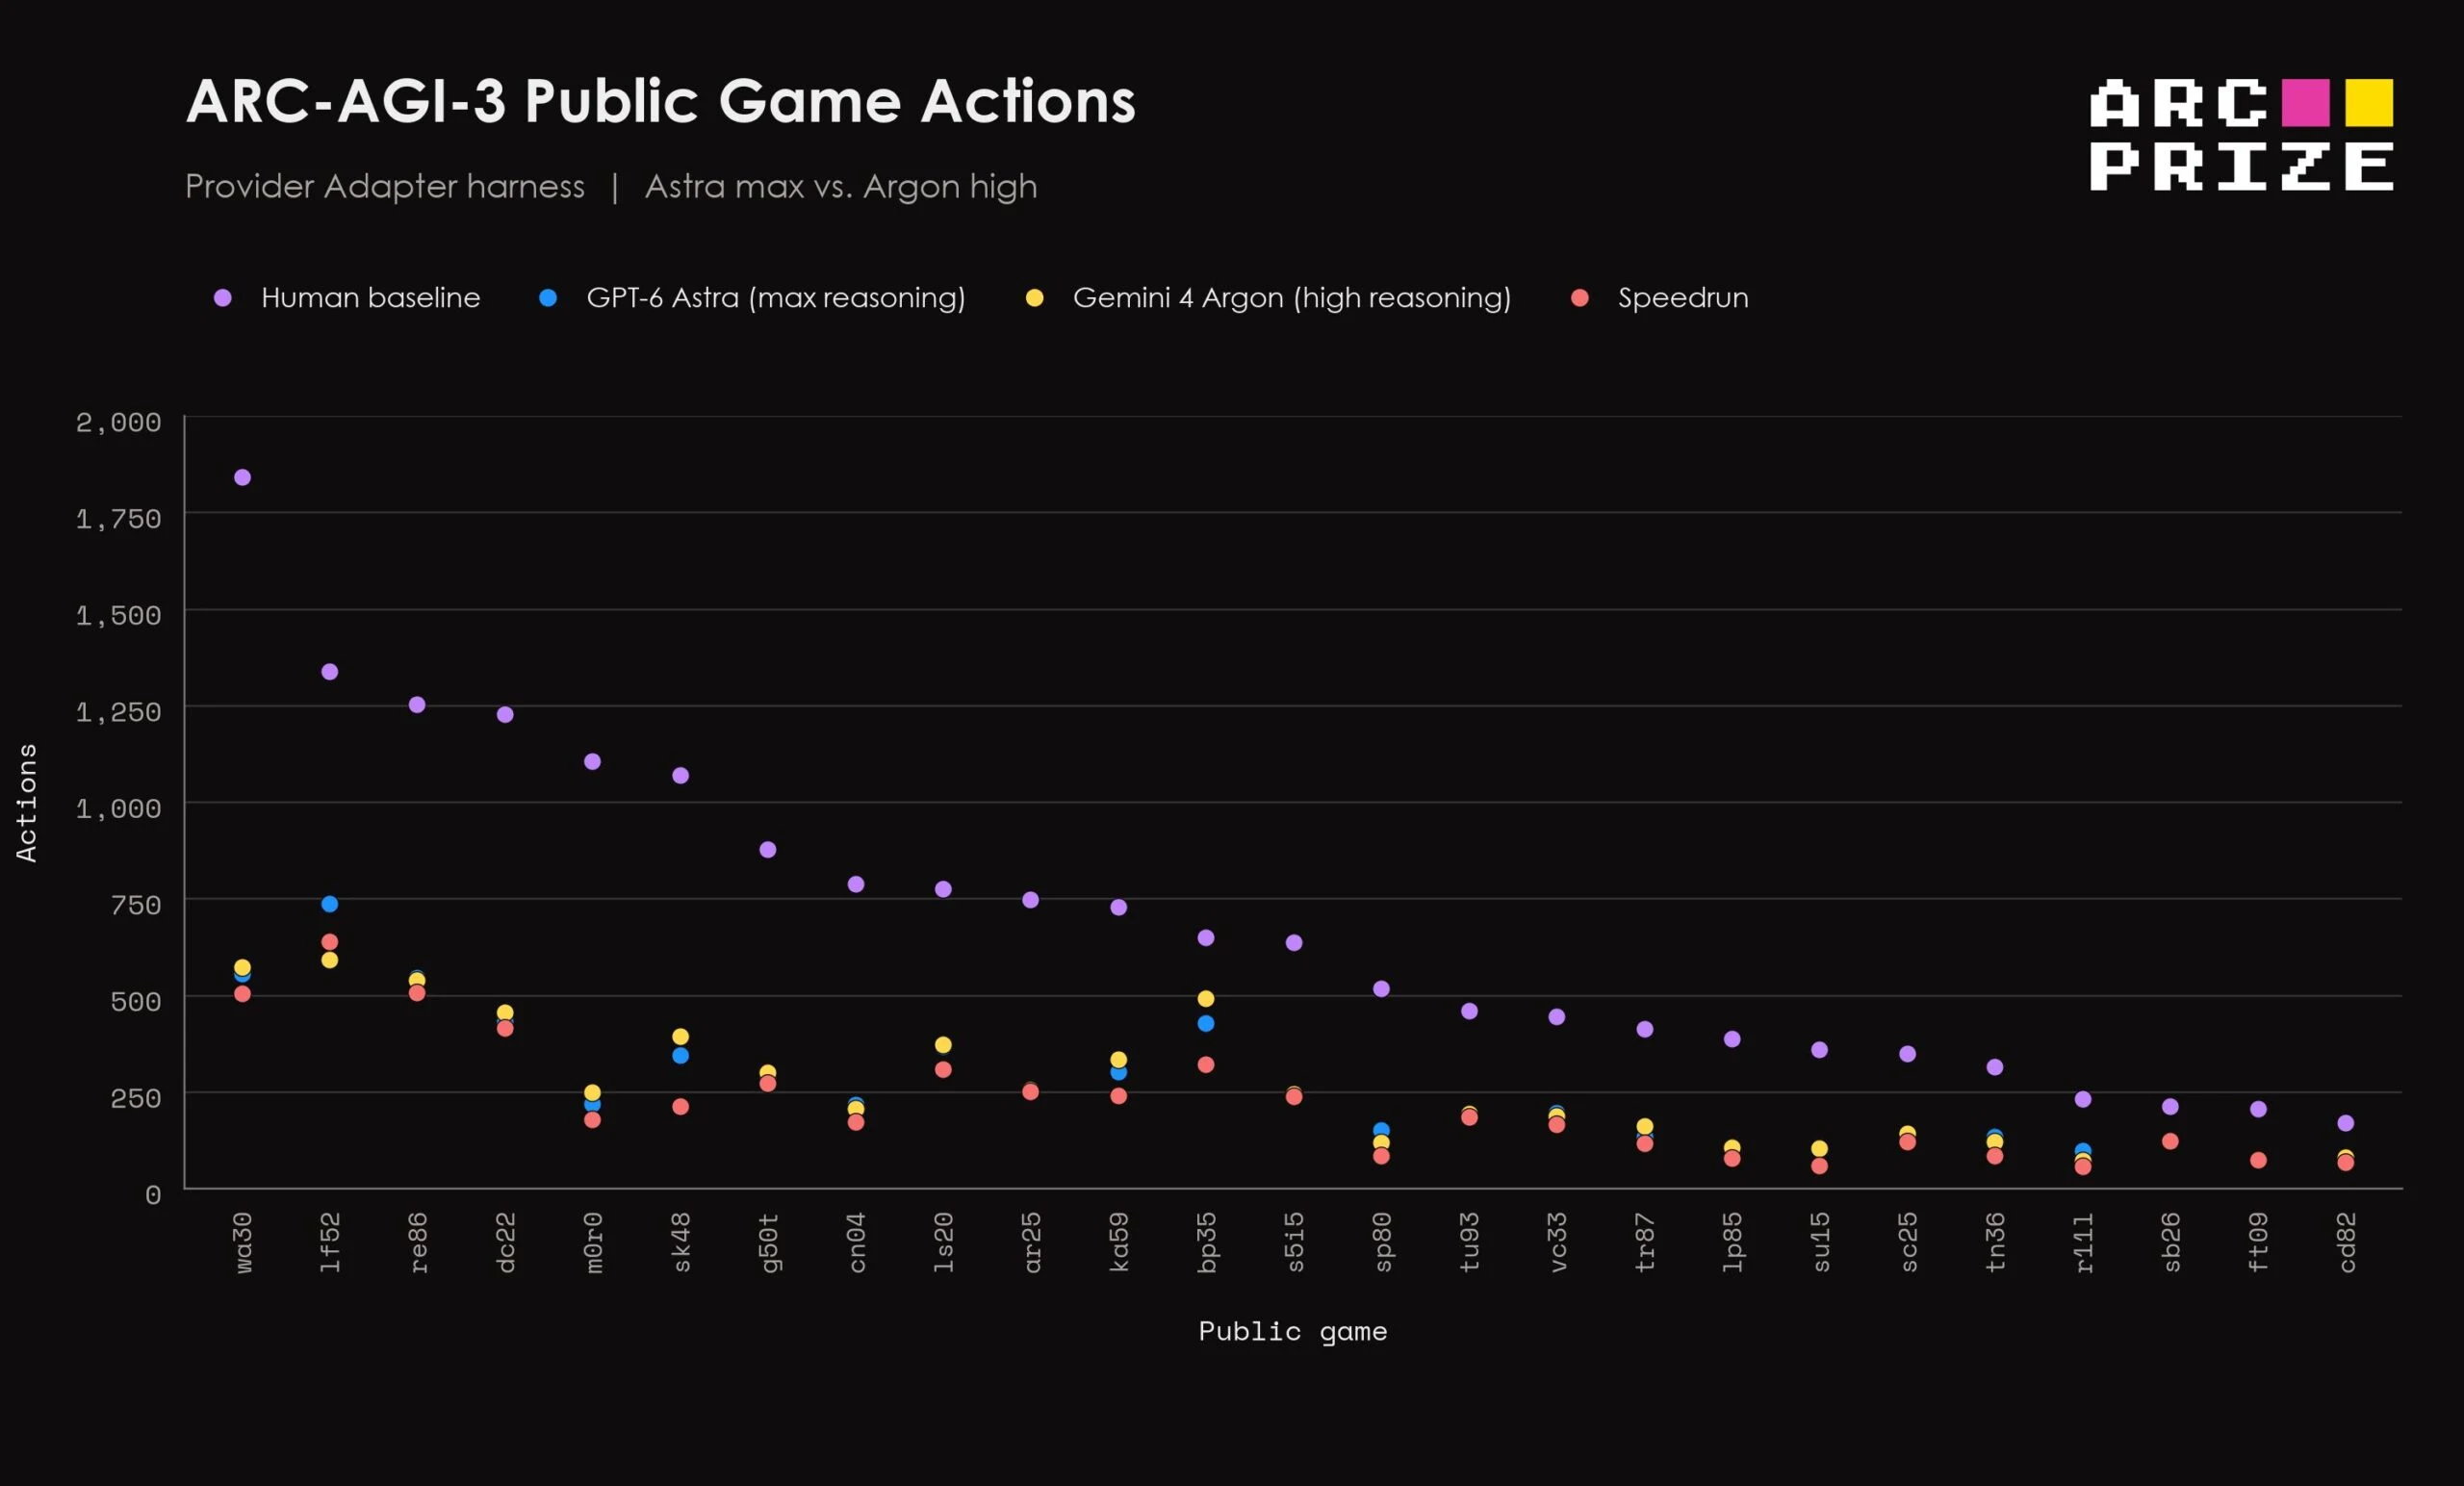
Astraと同様に、Argonは25の公開ゲーム全体で人間の基準値より62%少ない行動数を必要とした。3つのゲームではスピードランの記録に匹敵、また6つのゲームでは最高タイムの10%以内に達した。ベンチマークの古いバージョンでは、ARC-AGI-2(タスクあたり$0.32)では91.3%、ARC-AGI-1(タスクあたり$0.16)では98.5%のスコアを記録した。これは、百万個の入力トークンあたり$2、百万個の出力トークンあたり$10の導入価格に基づくものである。
ベンチマーク結果はテスト環境に大きく依存する
「標準ハーネス」では、ラウンド間の単純なメモのみが許可されるため、Argonは5,800ドルで低レーティング時、49.8%に低下する。この差は2026年7月の紛争に起因し、 OpenAIのGPT-5.6 Solは、2つのAPI設定を用いてARC-AGI-3でClaude Opus 5を打ち勝った.Ad
GPT-5.6 Solは標準環境下で7.8%の性能しか達成できなかった。これは、各アクション後に内部推論を捨て、新しいClaude API機能を欠いた古いインターフェースを使用していたためである。つまり、ClaudeはGPT-5.6とは異なる条件でテストされたのだ。OpenAI自身のResponses APIを用いて「保持された推論」とスマートコンテキスト「Compaction」を含むテストでは、モデルの性能は38.3%に上がり、Opus 5の30.2%を上回った。 OpenAIは、ベンチマークが常に技術環境を測定してしまうと主張した。その後、ARC Prizeの共同創設者であるFrancois Cholletは、一般的で公開可能なAPI設定を許可した。
APIの問題により、ArgonはStandard Harnessの全55試合を完了できなかった。テスターによるとだ。低レベルでは42試合(49.8%)が、中レベルでは46試合(46.3%)が完了した。最高レベルでは19試合しか完了せず、ARC Prizeはスコアを公表しなかった。報告された結果は、中止された試合の部分得点を含めて全55試合をカバーしている。
アルゴンは差を縮めるが、数学とコーディングでは遅れる
研究機関Epoch AIもGoogleの進捗を追跡した。Argon 165点を獲得 エポック・カパネルティー・インデックス(ECI)では、Fable 5.1と並び、Opus 5.5(167)およびGPT-6 Astra(166)のすぐ後ろに位置する。ECIは、人工分析が主なスコアを構築する方法と同様に、50以上のベンチマークを一つの能力スケールにまとめている。
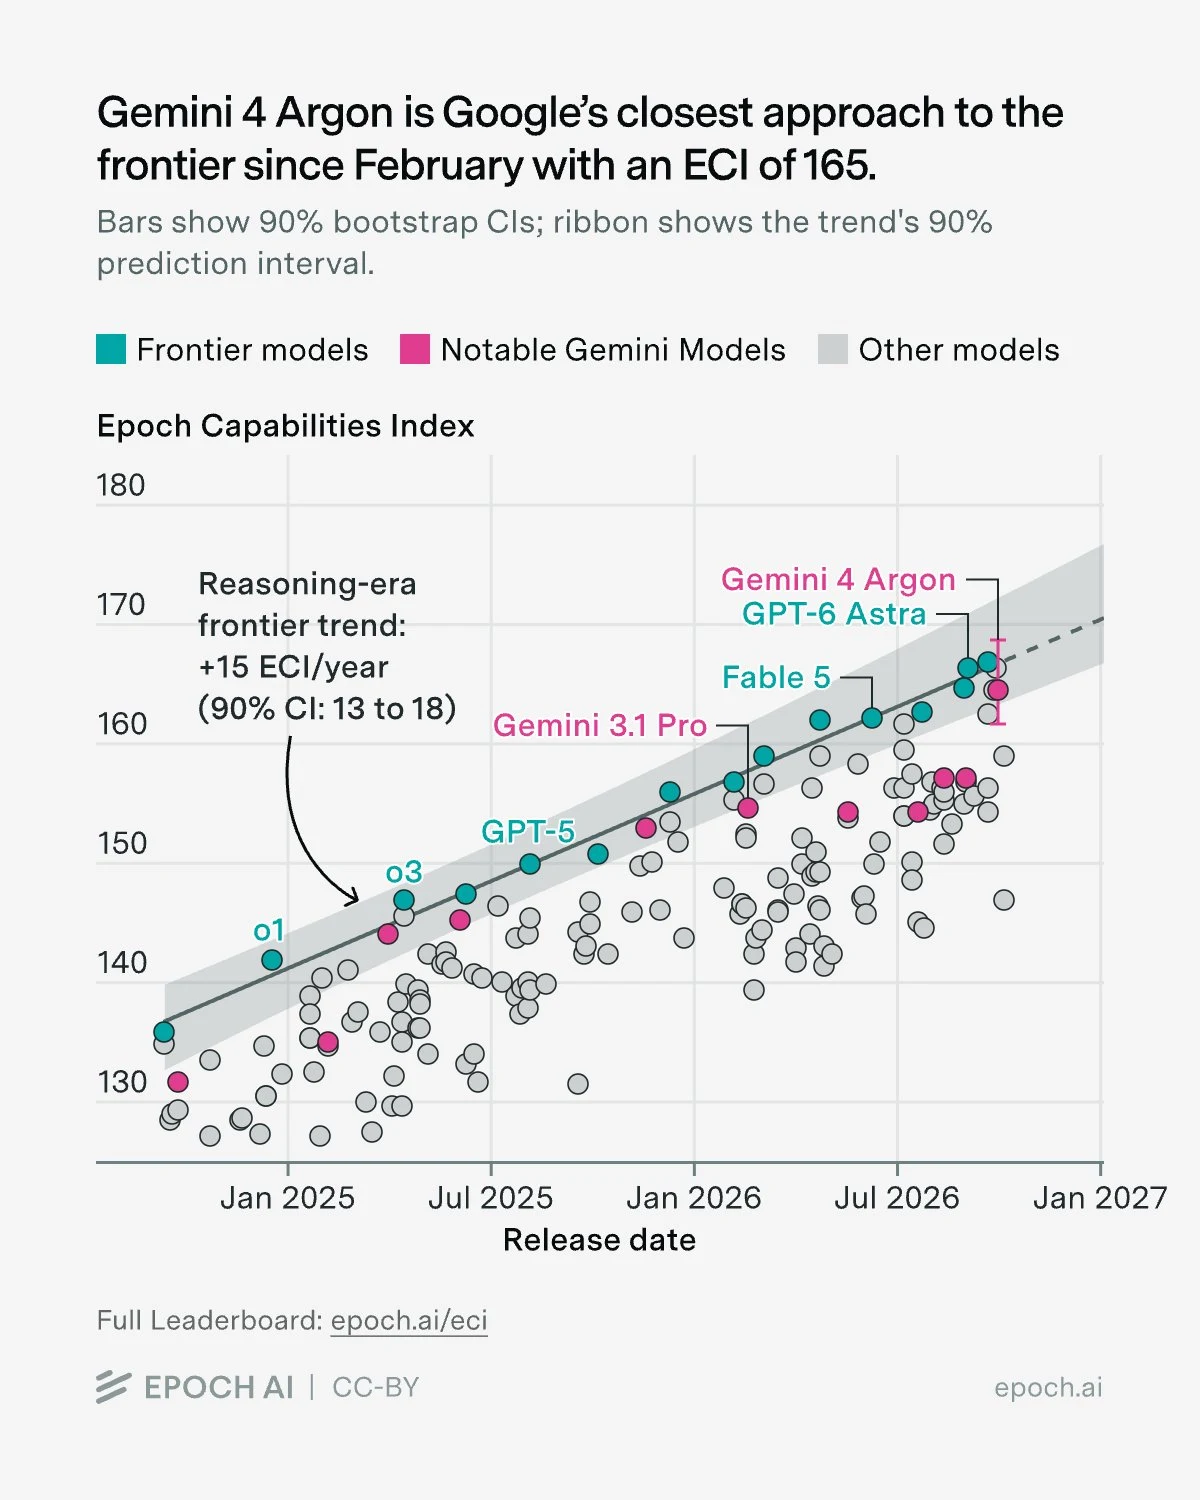
アルゴンはGemini 3.8 Flash(157ポイント)を大きく上回り、2月のGemini 3.1 Pro以来、Googleをトップに近づけました。Artificial Analysis and Vals.aiが以前にこのトレンドを確認していました。
しかし、パフォーマンスはドメインによって異なります。Epoch AIによると、Argonはいくつかの知識ベンチマーク、エージェントベンチマーク、ビジョンベンチマークで首位を獲得していますが、初期の推定ではMath ECIでは8位、ソフトウェア工学指数(SWE ECI)では6位に位置しているとされています。
AIニュース 大げさなものは抜き – 人間が選んだもの
広告なしの読書、毎週のAIニュースレター、年に6回の独占的「AIラダー」フロンティアレポート、完全なアーカイブへのアクセス、そしてコメントセクションへのアクセスを得るために、THE DECODERを購読してください。
出典:EpochAI | ARC Prize