
Reflection AI Reflection AI は、コードの保守、ツールの使用、結果の解釈、多段階ワークフローの完了といった、エージェンティックコーディングおよび長期的なタスク向けのオープンウェイトモデルである Beam を発表しました。オープンウェイトとしてのリリースにより、開発者や研究者はランタイム、デプロイ環境、およびカスタマイズプロセスを制御できます。
この記事では、Reflection のビジョンを説明し、AWS に Beam をデプロイする方法を示します。完全マネージドな手法としては、Amazon SageMaker JumpStart のリアルタイムエンドポイントから始めてください。分散 GPU インフラストラクチャを Kubernetes ネイティブに制御する必要がある場合は、 Amazon SageMaker HyperPod Inference JumpStart、SGLang、または vLLM と組み合わせて使用する場合です。また、Beam の合計 5010億のパラメータがチェックポイントストレージ、重みメモリ、シャーディング、並列化にどのように影響するか、そして 230億のアクティブパラメータがトークンごとの計算量にどのように影響するかについても説明します。
リリース時点で、Beam は米国東部 (バージニア北部) および米国東部 (オハイオ) の Amazon SageMaker JumpStart で利用可能です。
オープンインテリジェンスに対する Reflection のビジョン
Reflection のミッションは、オープンなモデルの重み、公開された研究、オープンソースソフトウェアを通じて、 インテリジェンスをすべての人に開かれたアクセス可能なものにする ことです。同社の フル AI スタック は、モデル、コアソフトウェア、本番インフラストラクチャ、およびアプリケーションを網羅しています。Beam はこのアプローチを、ソフトウェアエンジニアリングおよびエージェンティックシステムを構築する開発者にもたらします。
Reflection Beam について
Beam は、ソフトウェアの問題の解決、コードの修正、ツールの呼び出し、中間結果への対応を行うためのスパースな Mixture-of-Experts モデルです。合計 5010億のパラメータと 230億のアクティブパラメータを持ち、Reflection によると実効コンテキスト長は 100万トークンです。
Reflection は Beam の重みを Hugging Face から Apache 2.0 ライセンスでリリースしています。Beam 1.0 は BF16、FP8、NVFP4 のチェックポイントバリアントで利用可能です。これらのフォーマットは、それぞれ異なるメモリフットプリントとハードウェア互換性を提供します。AWS マネージドの JumpStart コンテナ設定でモデルをデプロイすることも、AWS 環境内で SGLang または vLLM を使ってモデルを検査・カスタマイズすることもできます。
デプロイアーキテクチャを理解する
制御およびスケーリングの要件に応じてサービング手法を選択してください。
- Kubernetes を運用せずに、AWS マネージドのモデルパッケージ、エンドポイント、呼び出し API を利用したい場合は、 SageMaker JumpStart リアルタイムエンドポイント Kubernetes を運用することなく、AWS マネージドのモデルパッケージ、エンドポイント、および呼び出し API を利用したい場合に適しています。
- Amazon Elastic Kubernetes Service (Amazon EKS) によってオーケストレーションされる HyperPod クラスタ上で、AWS マネージドのコンテナとモデル設定を利用したい場合は、 HyperPod Inference 上の JumpStart Amazon Elastic Kubernetes Service (Amazon EKS) がオーケストレーションする HyperPod クラスター上で、AWS マネージドのコンテナとモデル構成を利用したい場合に適しています。
- サービングイメージ、ランタイム引数、量子化、または分散実行を制御する必要がある場合は、 HyperPod Inference 上の SGLang または vLLM サービングイメージ、ランタイム引数、量子化、または分散実行を制御する必要がある場合に適しています。
- チェックポイントストレージ、重みメモリ、KV キャッシュ、コンテキスト長、バッチ処理、ランタイムオーバーヘッド、およびサポートされる並列化に応じてデプロイのサイジングを行ってください。
- 予想される同時実行数とレイテンシーの目標を定義し、実測されたワークロードの挙動に基づいてレプリカ、キャッシュ、ルーティング、オートスケーリングを設定してください。
JumpStart のリアルタイム手法では、モデル、コンテナ、エンドポイントがマネージドなデプロイワークフローの背後にパッケージ化されます。HyperPod の手法では、クラスタとサービングランタイムが公開されるため、分散実行、キャッシュ、ルーティング、スケーリングを制御できます。
次の図は、HyperPod パスで使用されるコンポーネントを示しています。Beam は、SageMaker JumpStart、Hugging Face Hub、またはオプションの Amazon Simple Storage Service (Amazon S3) ミラーから入手できます。分散ワーカーは、AWS が管理する JumpStart コンテナ、またはカスタムの SGLang または vLLM ランタイムを使用します。
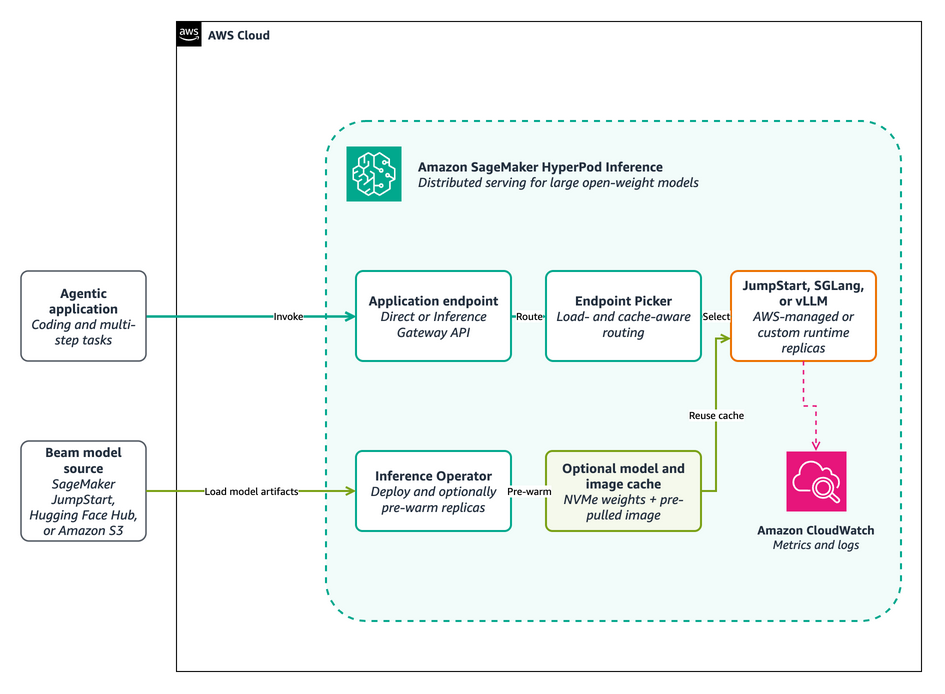
図 1: Amazon SageMaker HyperPod Inception を用いた分散 Beam デプロイメント (Amazon SageMaker HyperPod Inference)
前提条件
必要なもの:
- 選択した SageMaker デプロイメントパス、およびそれを支える AWS Identity and Access Management (IAM)、ネットワーキング、ストレージリソースに対する権限を持つ AWS アカウント。
- SageMaker JumpStart、または Hugging Face 上の Beam 1.0 チェックポイントリポジトリのいずれかを通じた Beam へのアクセス。
- モデル規約への同意、AWS Command Line Interface (AWS CLI)、および Python 3.11 以降。
- サポートされている Beam 構成に対する GPU クォータとキャパシティ。
GPU キャパシティの計画と確保
Beam の合計 501 billion パラメータでは、マルチ GPU デプロイが必要です。BF16 は重みのメモリ要件が最も大きいため、重みとランタイムのオーバーヘッドに十分な合計 GPU メモリを備えたマルチノード構成を計画してください。FP8 の場合は、NVIDIA H100 GPU で ml.p5.48xlarge NVIDIA H100 GPU または ml.p5e.48xlarge および ml.p5en.48xlarge を使用します。NVFP4 の場合は、NVIDIA B200 GPU で ml.p6-b200.48xlarge NVIDIA B200 GPU を使用する場合。リリースされたチェックポイント、ランタイム、および並列レイアウトが、選択したインスタンスタイプをサポートしていることを確認してください。
- 1 レプリカあたりの重み、KV キャッシュ、およびランタイムオーバーヘッドのメモリを計算し、ロードテストでその推定値を確認してください。
- 必要なアクセラレーテッドインスタンスをサポートする AWS リージョンを選択します。
- 選択したインスタンスタイプのサービスクォータと利用可能なキャパシティを確認します。利用可能な場合はオンデマンドキャパシティを使用するか、スケジュールされたワークロードの短期リザベーションとして SageMaker トレーニングプラン を使用します。
- 画像転送、重みのダウンロード、シャードの読み込み、ランタイムの初期化には時間を見込んでください。
Path 1: SageMaker JumpStart のリアルタイムエンドポイントを使ってみる
モデルカタログからマネージド HTTPS エンドポイントへの最短経路を求める場合は、まず JumpStart のリアルタイムエンドポイントを使用してください。このサンプルは、BF16、FP8、NVFP4 の各モデル ID を、1 つのバリアント対応コマンドでサポートしています。対応インスタンスタイプ、リクエストスキーマ、デプロイコマンド、クリーンアップコマンドについては、README と Python ファイルが信頼すべき情報源です。
- サンプルリポジトリをクローンします。
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - SageMaker JumpStartのデプロイメントサンプルディレクトリに移動します。
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - Pythonの仮想環境を作成して有効化します。
python3 -m venv .venv source .venv/bin/activate - サンプルの依存関係をインストールします。
python -m pip install -r requirements.txt - FP8 に対して、範囲を限定したデプロイ、呼び出し、クリーンアップのライフサイクルを実行します。
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
このコマンドは FP8 エンドポイントをデプロイし、短いリクエストを送信し、レスポンスを表示して、エンドポイントをクリーンアップします。Use
bf16またはnvfp4別のチェックポイントのバリアントを選択するためのものです。省略した場合のデフォルトは NVFP4 です。--variantエンドポイントを実行し続ける必要がある場合は、READMEにあるPython関数を使用してください。
パス 2:SageMaker HyperPod Inference でデプロイする
分散GPUインフラストラクチャに対するKubernetesネイティブな制御が必要な場合は、HyperPod Inferenceを使用してください。AWSマネージドのJumpStartコンテナ設定を利用するか、SGLangまたはvLLMを使ってBeamをデプロイできます。The HyperPod Inference デプロイメントサンプル README およびその設定ファイルは、リリースされるマニフェスト、モデルおよびイメージ識別子、サポートされるランタイムバージョン、コマンドに関する信頼できる情報源(source of truth)です。
始める前に、設定を行ってください kubectl EKSでオーケストレーションされたHyperPodクラスタへのアクセス権、HyperPod Inference Operator、および必要なアドオンが必要です。また、クラスタのVirtual Private Cloud(VPC)、サブネット、セキュリティグループ、選択したBeamおよびランタイムアーティファクトへのアクセス権、そしてモデルキャッシングを有効にする場合はローカルのNVMe容量も必要です。選択したリポジトリが認証を必要とする場合は、分離されたHugging Faceアクセストークンを使用してください。
開発および実験のために、Hugging Face Hubからピン留めされたBeamのリビジョンをデプロイします。本番環境へのデプロイやモデルのキャッシングには、チェックポイントをAmazon S3またはAmazon FSxにコピーしてください。 HyperPod のモデルおよびイメージキャッシング ノードローカルのNVMeストレージに重みを事前ロードし、推論用イメージを事前プルしておくことができます。
その HyperPod Inference Gateway OpenAI互換のインターフェースを提供し、レプリカ間でリクエストをルーティングします。HyperPod Inferenceはさらに、 管理型の階層型KVキャッシングとインテリジェントルーティングこれらは以下のうちの一部です。 2026年に発表されたAmazon SageMakerの推論機能.
次の図は、モデルの準備およびランタイムのリクエストフローを拡張したものです。モデルキャッシングが有効になっている場合、Inference Operator は選択された重みとサービングイメージで対象ノードをウォームアップします。ランタイム時には、Inference Gateway と Endpoint Picker が各リクエストを適切な JumpStart 管理、SGLang、または vLLM のレプリカに振り分けることができます。
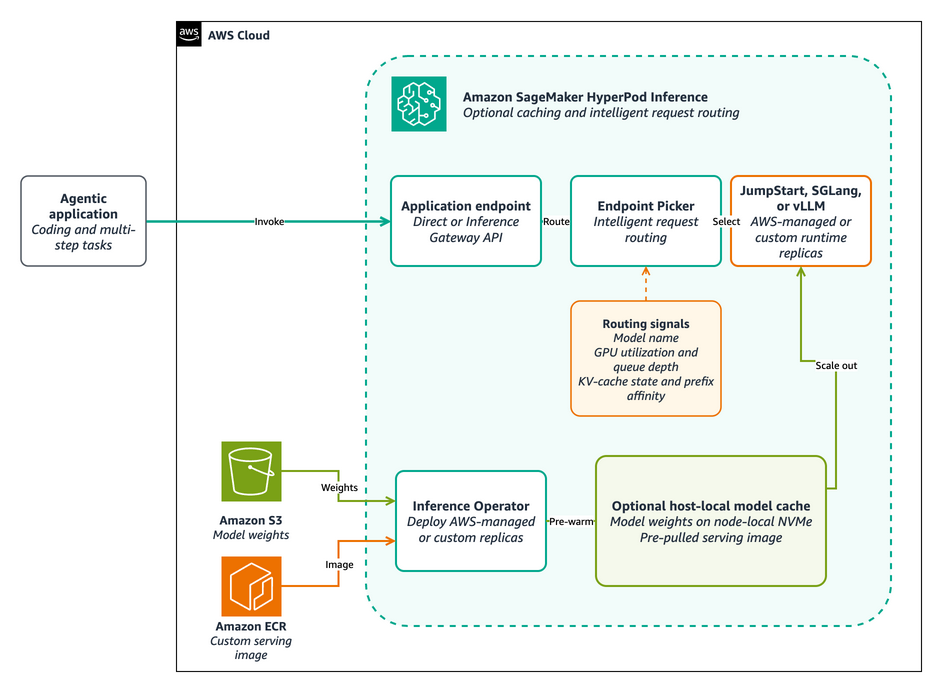
図2: HyperPodのモデルキャッシングとリクエストルーティング
デプロイ用アーティファクトを準備する
デプロイおよびパフォーマンスの結果を再現できるように、不変の入力を使用してください。
- デプロイサンプルに記録されているJumpStartモデルリリースを使用してください。
- カスタムランタイム向けには、BF16、FP8、または NVFP4 のチェックポイントを選択してください。
- カスタムランタイムの場合は、公開されている Beam の commit SHA とイメージダイジェストをサンプルリリース設定に維持してください。
- クラスタが上流のイメージを取得できない場合や、組織が承認済みレジストリを要求している場合にのみ、リリース済みイメージをプライベートの Amazon Elastic Container Registry (Amazon ECR) リポジトリにミラーしてください。
- トークン、生成されたシークレット、非公開のモデル ID、レジストリ資格情報、未公開の結果はリポジトリに含めないでください。
サービングパスの選択
ワークロードに特定の推論ランタイムや構成が必要でない限り、まず SageMaker JumpStart から始めてください。
| サービングパス | 使用するケース | 管理する内容 |
| SageMaker JumpStart | ランタイムの保守負担を抑えられる AWS 管理のコンテナとモデル構成を利用したい場合。 | Beam のモデルバージョン、サポート対象のインスタンスタイプ、エンドポイント構成、スケーリングポリシーを選択します。 |
| SGLang または vLLM | 特定の推論ランタイムや構成が必要な場合、たとえばカスタムランタイム引数、パーサー、量子化、並列処理などが必要です。 | サポート対象のランタイムイメージ、モデルリビジョン、パーサー設定、分散実行設定をピン留めします。 |
SageMaker JumpStartでデプロイする
SageMaker JumpStartはコンテナ統合作業を削減する一方、HyperPodはクラスターのキャパシティ、スケーリング、オブザーバビリティに関する制御を維持します。
- SageMaker Studio で、 JumpStartモデルカタログ.
- 以下 公開中のすべてのモデル、選択します ビーム.
- 選択 SageMaker HyperPod デプロイターゲットとして。
- クラスタとKubernetesのネームスペースを選択します。
- エンドポイント名を入力し、次を選択します デプロイ.
- リリースされたJumpStartリクエストスキーマでエンドポイントを呼び出す前に、デプロイ状況を確認してください。
インフラストラクチャ・アズ・コード(Infrastructure-as-code)のワークフローについては、HyperPodサンプルでリリース済みのJumpStart設定をご利用ください。以下を確認できます。 reflection-beam-jumpstart.yaml マニフェストテンプレート デプロイを設定する前に。
- サンプルリポジトリをクローンし、HyperPod Beam ディレクトリに移動します。
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - README に記載されているローカル設定ファイルを作成します。
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - クラスタを変更する前に、JumpStart構成を検証してください。
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - JumpStart構成をデプロイします。
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
翻訳:「ヘルパーはリリースされたをレンダリングして適用します」 JumpStartModel ディスクにリリースの値を書き込むことなく、リソースを取得できます。
「SGLang または vLLM でデプロイする」
提供ランタイムを直接制御する必要がある場合は、SGLang または vLLM を選択してください。デプロイを設定する前に、次を確認します。 reflection-beam-sglang.yaml マニフェストテンプレート または reflection-beam-vllm.yaml マニフェストテンプレート. サンプルのREADMEは、リリースされた値やコマンドの信頼できる情報源であり続けます。
- サンプルリポジトリをクローンします。
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - HyperPod Beamディレクトリに移動します。
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - READMEに記載されているローカル設定ファイルを作成してください。
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - クラスタを変更する前に、選択した構成を検証してください。
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - Beamをデプロイし、デプロイが最終状態になるまで待機します。
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
置換
sglangとvllmvLLM を使用するためのものです。このヘルパーは選択された設定を検証し、レンダリングされたマニフェストをリリース値をディスクに書き込まずに適用し、固定のタイムアウトで待機し、デプロイが失敗した場合には診断情報を出力します。
Beamを起動する
リリース済みモデルのリクエストスキーマでJumpStartエンドポイントを呼び出します。SGLangまたはvLLMの場合は、HyperPodサンプルに含まれる境界付きスモークテストを使用してください。
デプロイされたエンドポイントを呼び出す
- サンプルクライアントの依存関係をインストールします。
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - 推奨の初期サンプリング設定で、プライベートなヘルスチェックと短いリクエストを実行します。
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
置換
sglangとともにvllmvLLM デプロイメント向けです。ヘルパーは準備のできたワーカーを選択し、一時的な port-forward を開き、エンドポイントの健全性を確認し、リクエストを送信して、port-forward を閉じます。
The response resembles the following:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
認証付き Inference Gateway については、HyperPod サンプル README のベアラートークン手順を使用してください。認証情報はソースコード、マニフェスト、コマンド履歴に含めないでください。
パフォーマンスの測定とチューニング
- 提供されるサービング経路ごとに、想定される同時実行数で、典型的なコーディングおよびツール利用のリクエストを繰り返し送信してテストしてください。
- Beamモデルのバージョン、イメージのダイジェスト、インスタンスタイプ、精度、コンテキスト長、並列度、サービング引数、キャッシュの状態、テストの繰り返し回数を記録します。
- リクエスト成功率、p50およびp95の最初のトークンまでの時間、出力トークンあたりの時間、エンドツーエンドのレイテンシ、および1秒あたりの合計出力トークン数を測定します。
- それらの結果をもとに、バッチサイズ、KVキャッシュの割り当て、レプリカ数、オートスケーリング、モデルとイメージのキャッシュを調整します。
- 精度や量子化を変更した後は、出力品質を再確認してください。
クリーンアップ
継続的な課金を避けるため、テストが終わったらリソースを削除してください。
- SageMaker JumpStartのリアルタイムエンドポイントについては、SageMaker JumpStartデプロイメントサンプルのREADMEに記載のクリーンアップ手順に従ってください。
- Amazon SageMaker HyperPod Inference 上の JumpStart、SGLang、または vLLM については、HyperPod Inference デプロイメントサンプル README のクリーンアップ手順に従ってください。
- チュートリアル用に作成した専用の HyperPod または Amazon EKS クラスターを削除します。
- 未使用のキャッシュされた重み、ミラーリングされたアーティファクト、ロードバランサー、ロググループ、一時的なIAMロール、およびキャプチャされた推論データを削除します。
結論
Reflection Beam は、エージェント型コーディングやマルチステップのタスク向けに設計されたオープンウェイトモデルを開発者に提供します。完全マネージド型のデプロイには、SageMaker JumpStart のリアルタイムエンドポイントから始めることができます。サービングコンテナを管理せずに Kubernetes ネイティブなインフラ制御が必要な場合は、JumpStart と組み合わせた SageMaker HyperPod Inference を使用するか、カスタムランタイムが必要な場合は SGLang または vLLM を選択できます。
次を使用します: SageMaker JumpStart デプロイサンプル または HyperPod Inference デプロイサンプル、その後、指示に従ってください。
Reflection AIとそのオープンインテリジェンスに対するビジョンについて詳しく知るには、以下をご覧ください Reflection AI を読んで Beamのご紹介.
リソース
- Reflection Beam チェックポイントのバリエーション: BF16, FP8、さらに NVFP4
- SageMaker JumpStart デプロイサンプル
- JumpStart、vLLM、SGLangを使用したHyperPod Inferenceデプロイサンプル
- SageMaker JumpStartからHyperPod Inferenceへ基盤モデルをデプロイする
- Amazon SageMaker Inference 2026年年初来のローンチまとめ