
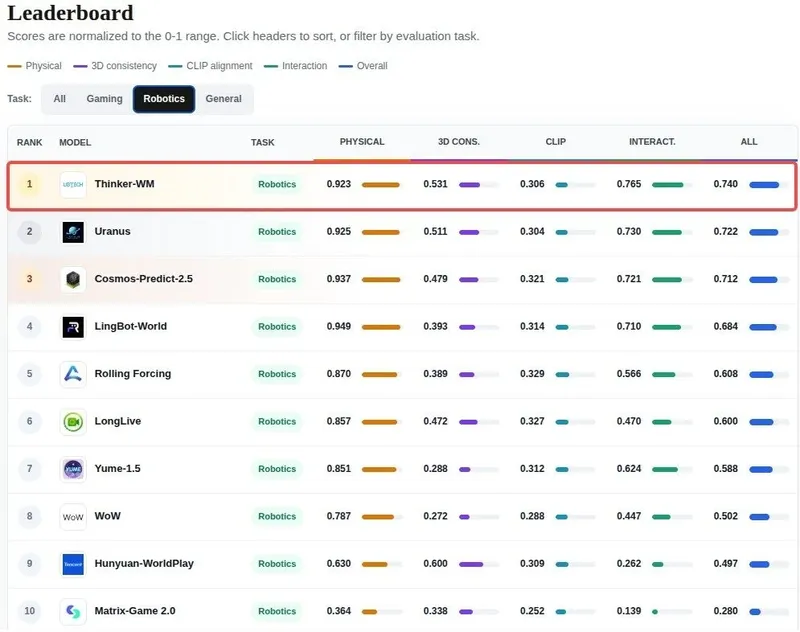
01 三大基準の全ランキングでトップに立ち、Thinker-WMは3つの第1位を獲得した
先日、ユービーソン・ティン커ー-WMは、3つの主要な世界的なモデル評価で全て1位を獲得し、業界の記録を更新した:
WorldOlympiad:
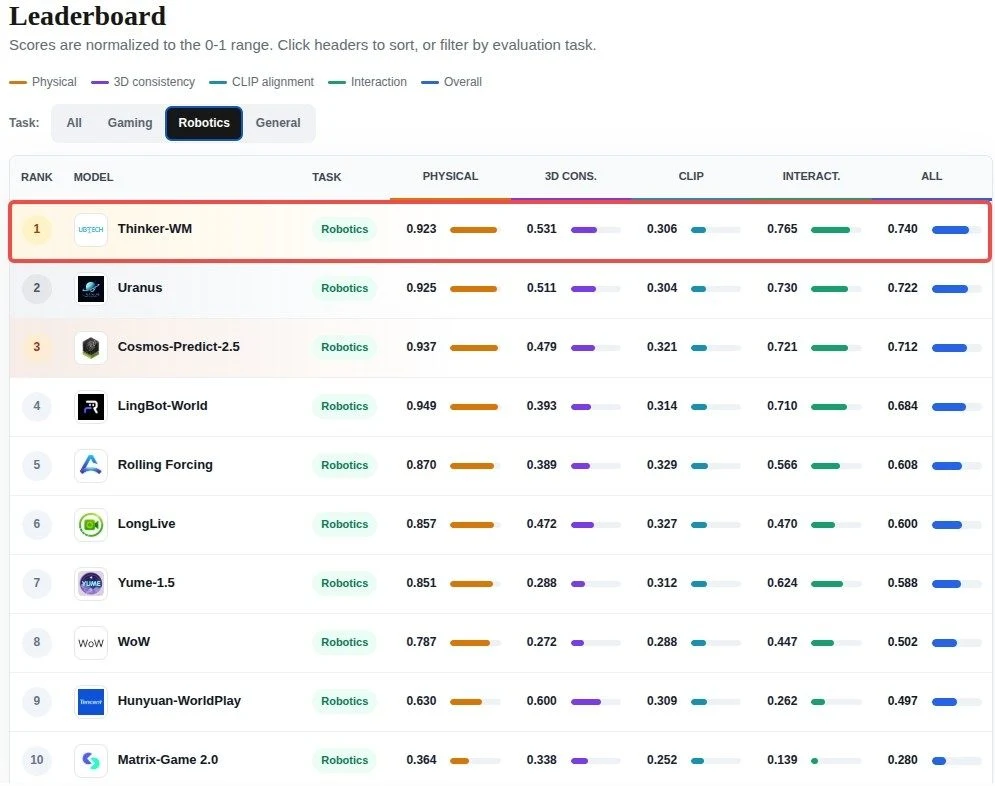
Thinker‑WMの取得総合得点は0.740で第1位となりました。この基準は、多数の実際のロボットとのインタラクションデータに基づいて構築されており、10種以上の異なるロボット本体と多様なカメラ構成を含んでいます。特に、モデルが異なるロボット形状や視点間で通用する汎用性を評価しています。モデルは3D一貫性0.531、インタラクションの精度0.765を達成し、これら2つの個別指標は全参加モデル中で最高位に位置し、3次元の幾何構造とロボットとのインタラクションプロセスに対する正確なモデリング能力を示しています。
EWMBench:
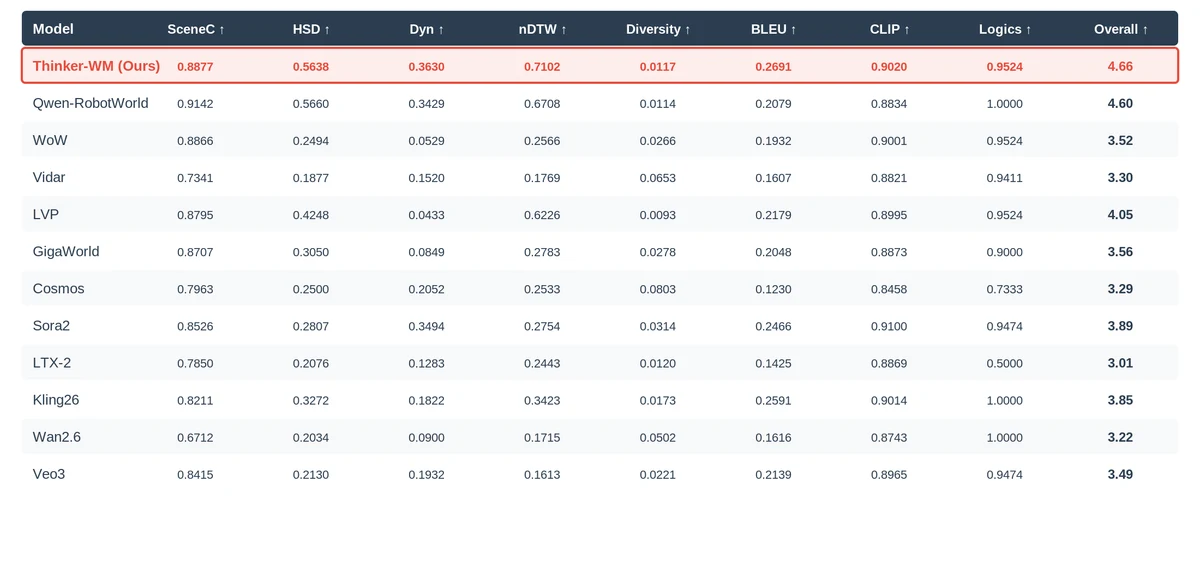
Thinker‑WMの取得総合得点は4.66で、Qwen‑RobotWorldやSora2などの主流モデルを超えています。EWMBenchでは、完全な評価シナリオの一貫性、ロボットの末端運動の正確性、指令の意味論的な一致という3つの能力の側面が評価されます。表現レベルでの多モダル統合モデリングのおかげで、Thinker‑WMは、ロボットの軌跡の時空適合を反映するnDTW(正規化動的時間整合法)や、運動速度と加速度の妥当性を評価するDyn(動力学的一貫性)といったロボット運動の核心指標において優位性を発揮しています。
WorldArena1.0 トラック-1:
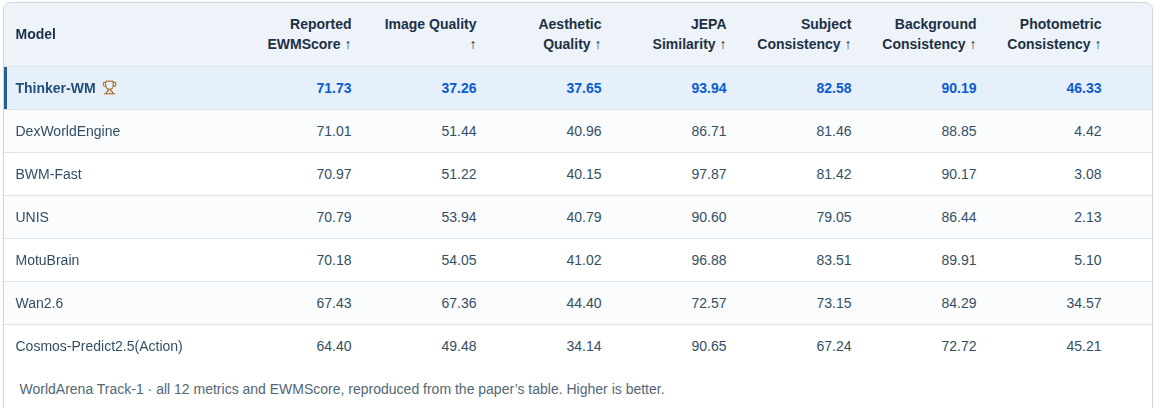
シミュレーション環境基準のWorldArena Track‑1において、Thinker‑WMは視覚的な画質、内容の一貫性、物理的合理性、3D幾何学的精度、命令の遵守など12項目の重要な評価指標において全体的に優れており、シミュレーション環境下での視覚生成の品質と物理的なインタラクションの信頼性を両立させている。 Thinker‑WMは、表現層が統一されたUnified Dynamic Transformer(UDT)を核とし、RGB画像、測定深度、ロボットの動作を同じ共有動的表現の連続的な進化プロセスに組み込む。これにより、ビデオと動作の統合生成、世界予測、戦略推論、ビデオから動作への変換、逆動力学など、多くの機能が一体化され、身体を持つインテリジェンスに新世代の基本的な世界モデル基盤を提供する。
02 Thinker-WM技術突破:表現レベルで視覚、幾何学、動作のマルチモーダル統一を実現
ロボットを実世界で実際に動作させるには、目の前の物体を認識することが最も難しいのではなく、環境の次の変化を予測することです。これが世界モデルの存在意義です。過去の世界モデルは一般的に「スプライング式」のアプローチを採用していました。ビデオ生成が画像を担当し、戦略ネットワークが動作を担当し、幾何学的予測が空間情報を担当するように、各モジュールは独立して計算され、インターフェースを通じて統合されて出力されます。
しかし、この技術モデルの問題点は、動作が環境を変え、環境が動作を制約し、幾何学的構造が両者に影響を与えること、そして物理的に密接に結合している信号が異なるモジュールに分割され、その内在的な因果関係が失われることです。
例えば、「カップがテーブルから押し下げられる」という事象は、言語では一つの文として表現され、動作では一連の命令として表現され、映像では物体の動きとして表現され、深層では連続する距離場として表現される。これら四つの表現は、同じ事件を指しており、四つの異なる対象ではない。したがって、モデルにどれか一つを生成させるという要求は、本質的に同じプロセスを問うことである。
しかし、この重なりも完全ではない。動作は外見も文脈も持たず、同じ関節コマンドでも空のテーブルに置くと、乱雑なテーブルに置くと、意味が全く異なる。言語も時空の詳細を持たない。「カップをテーブルから押し下ろす」という文には、どちらの側から押し、どれだけ力を入れ、どの速度で押すか、手の具体的な軌跡やカップが何回転するか、最終的にどこに落ちるかが指定されていない。 動画には明確な幾何学的形状や測定値が含まれておらず、一連のピクセルを使って表現されているだけである。カップのサイズも、カップとテーブルクロスの距離も分からない。深さについても、外観、名前の意味、意図が含まれておらず、表面がどこにあり、どのように隠れ、どのように接触するかが示されているだけで、それがカップなのかテーブルクロスなのか、またなぜ押す必要があるのかは教えてくれない。
この問題に対して、優必選のThinkerチームは新しい解決策を提示している。それは、インターフェースで単純な統合を行わず、表現レベルで多モダンを統一することである。Thinker-WM(Thinker World Model)は、優必選が研究した統一された多モダン世界モデルであり、RGBビデオ、深度情報、ロボットの動きを同じ中間表現空間にエンコードし、共通のパラメータ群によって連携して進化する。外観、幾何学、動きは、3つの独立した流れが異なるものではなく、同じ世界の進化過程の3つの表現形態となる。 つまり、Thinker-WMの下層設計論理は次のように要約できる:異なるモーメントは同じプロセスの異なる表現である。モデルはそれらを共有された表現空間に整列させ、この共有された表現空間上で推論を行う。モーメントのインターフェース上での条件付き組み合わせではなく。
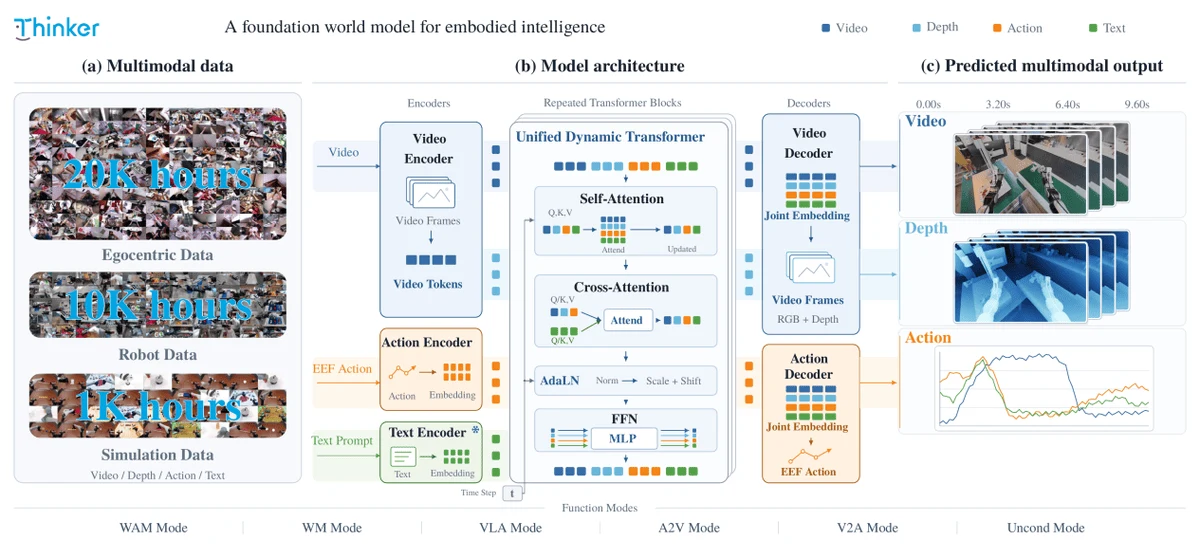
思考者-WM:視覚、幾何学、動作の統一モデリングフレームワーク
具体的に言うと、RGB画像、深度情報、ロボットの動作はそれぞれ独自のエンコーダを通じて統一された潜在空間にマッピングされ、共有された統一動的トランスフォーマター(Unified Dynamics Transformer, UDT)に入力されて共同時系列モデリングが行われ、最終的に各々のデコーダによって出力ビデオ、深度画像、ロボットの実行可能動作が復元される。 これは、多モーダルな相互作用がTransformerの内部で起こることを意味します。視覚トークン、幾何学トークン、動作トークンは、入力や出力層で単純に結合するのではなく、同じ注意機構を通じて直接情報を交換します。
幾何情報はもはや単なる補助的な監視信号に過ぎない。Thinker-WMは深さを生来的に生成されるモダリティとして扱い、映像と一致した潜在的なトポロジーおよび時空の構造を共有する。深さによる監視は直接、共有される表現を形成し、物理空間の構造を世界モデルの「母語」として位置づける。これにより、人型ロボットが物理空間をより正確に理解できるようになる。統一されたモデリングの価値は、ロボットの実際の実行効果にも表れる。RoboTwinの単一タスクのアブレーション実験において、深さモダリティを導入した後、操作成功率は深さのないベースラインに比べて15ポイントポイント向上し、空間の幾何情報がモデルの状況理解に役立つだけでなく、動作生成やタスク実行を改善することがわかった。
03 3万時間の異構データにより、1つのモデルが6つの能力を獲得する
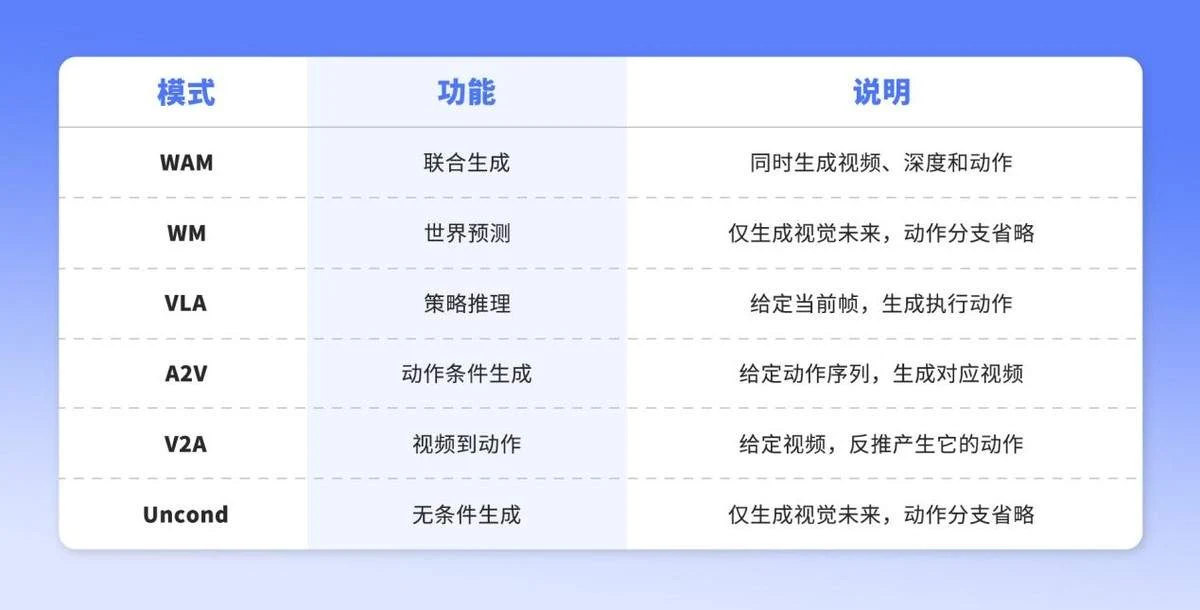
多モダル統一表現に依存して、すべてのモダルが同じパラメータ群を共有する。Thinker-WMは、条件モダルと生成モダルを柔軟に切り替えることで、6つの能力モードをサポートする。
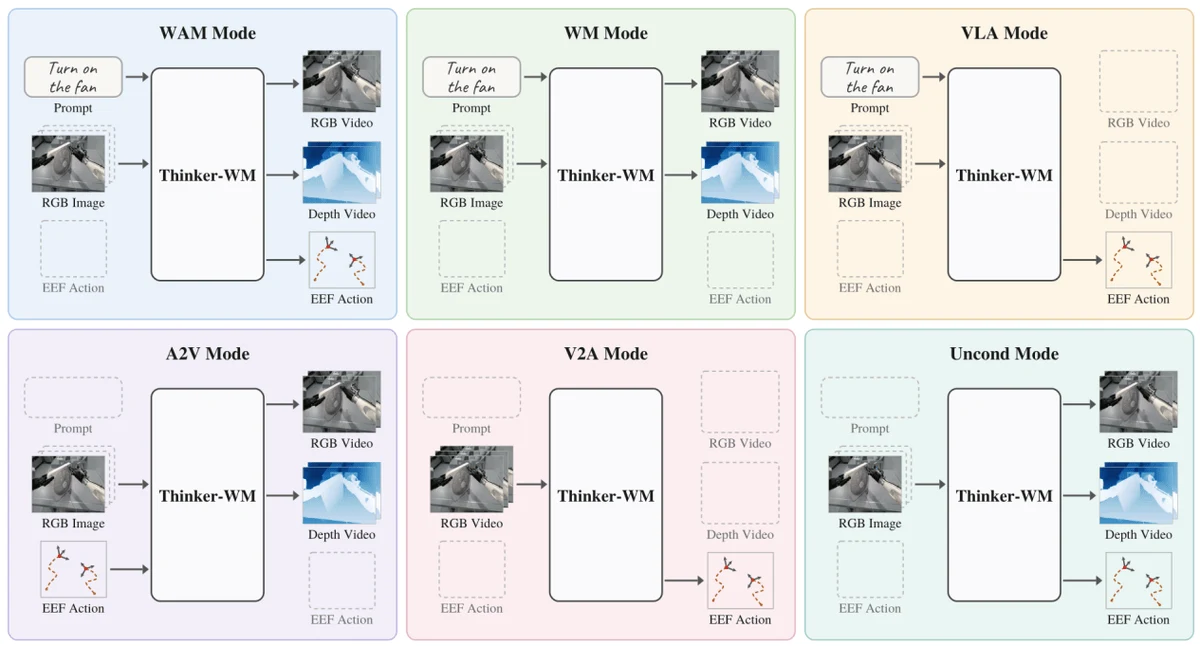
同じ重みで、未来の映像を予測したり想像したりすることができる。また、ロボットの動きの軌道を逆に推測することも可能だ。さらに、ビデオから動作情報を抽出することもできる。これこそが、統一表現による核心的な技術の恩恵である。
04 3万時間の異構データにより、汎用世界モデルの基盤が築かれる
統一表現能力の背後には、UbiSelectの豊富な規模と多様なタイプの訓練データが支えとなっている。Thinker-WMの訓練コーパスは、具身知能分野においてかなりの規模を持っている:
- 約2万時間の第一人称人間型ビデオ:家庭、商業小売、工業などのシーンをカバーし、ロボットの遠隔操作で低コストで得られにくいタスク、物体、シーンへの多様性を補完し、同時に約1千時間の対応深度データも提供しています。
- 約1万時間の実際のロボットデータ:様々な形態のロボットから得られたもので、視覚観察と実行動作の対応監督を提供し、そのうち約3千時間は対応深度のマークが含まれている。
- 約1千時間のシミュレーションデータ:高精度の幾何学・物理的監視信号を提供します。
異なるロボットの動作空間、座標系、制御プロトコルには大きな違いがある。Thinker-WMの統一思想はモデルフレームワークにのみ適用されるわけではなく、データ選択にも応用される。このモデルでは、すべてのロボットの動作を末端位置で表現し、異なるロボットごとにトークン内に固有のタグを埋め込む。こうすることで、異なる形態のロボットが同じ生成空間を共有できる一方で、正確な本体制御能力も保持される。
05 データインフラ:大量の異種データを効率的に活用して統一モデルのトレーニングを支える
大量のデータをモデル能力に変換するには、安定かつ効率的なデータインフラが不可欠です。異なるロボット、人間のビデオ、シミュレーションデータのフォーマット、モーメント、アノテーションにおける違いに対応するため、優必选ThinkerチームはData Factoryを構築しました。これにより、データ管理とトレーニングサンプリングを分離し、モデルの要求に応じて多様なデータを柔軟に組み合わせることができます。
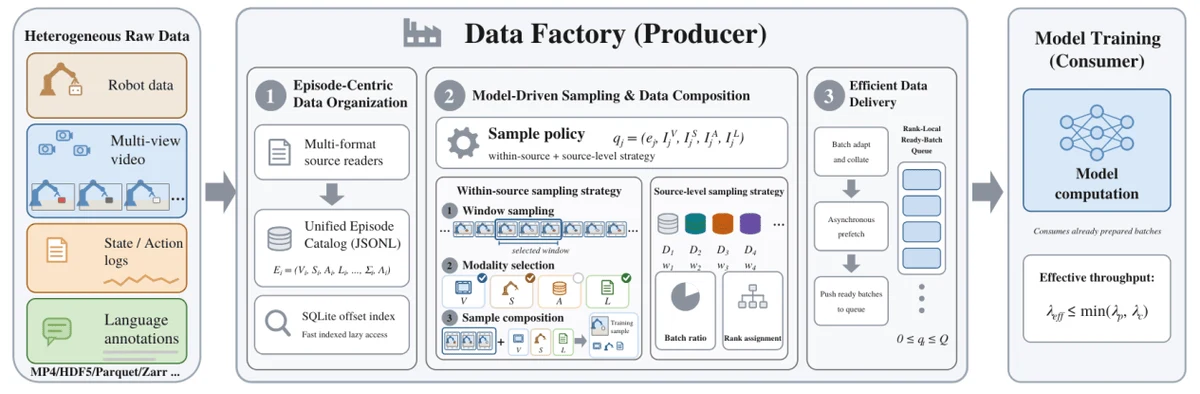
データファクトリー:複数の異なるデータ源から統一されたモデル訓練まで
Data Factoryは、3つの重要なプロセスによってトレーニングをサポートします:統一化組織によりビデオ、状態、動作、言語情報を管理し、必要に応じて異なるトレーニングモードに必要なサンプルを生成します。層別品質検査によって異常なフレームをフィルタリングし、深さとビデオの一致を確認することで、トレーニング信号の信頼性を保証します。非同期事前取得とコーディングの再利用によりトレーニングデータを事前に準備し、待ち時間や重複計算を減らします。
このデータインフラ基盤により、複数の異なるデータ源が信頼性を持って整理され、柔軟に呼び出され、効率的に提供される。これにより、Thinker-WMの6つの能力モデルを組み合わせた共同訓練と継続的な改善に工程上の支援が提供される。
06 Motion Probe実験デザインを通じた軽量化実験:クロスモダル表現の実際の結合性の検証
表現レベルで多モダルが統一されるというのは、アーキテクチャ設計の革新のように聞こえますが、核心的な疑問があります。モデルは本当に空間を通じて視覚、幾何学、動作の間の結合関係を共有しているのか、それとも単に多様な情報を並行して処理し、異なるモダルを単純に一緒に扱っているだけなのか?
この質問に答えるために、ユービーソン・ティンカー・チームは軽量なモーション・プロバー検証実験を設計した。研究チームは凍結されたUDT視覚表現上に非常に小さな動き予測ヘッドを接続し、このヘッドのみを訓練することで、純粋な視覚表現から末端実行器の位置変化を復元できるかどうかを調べた。
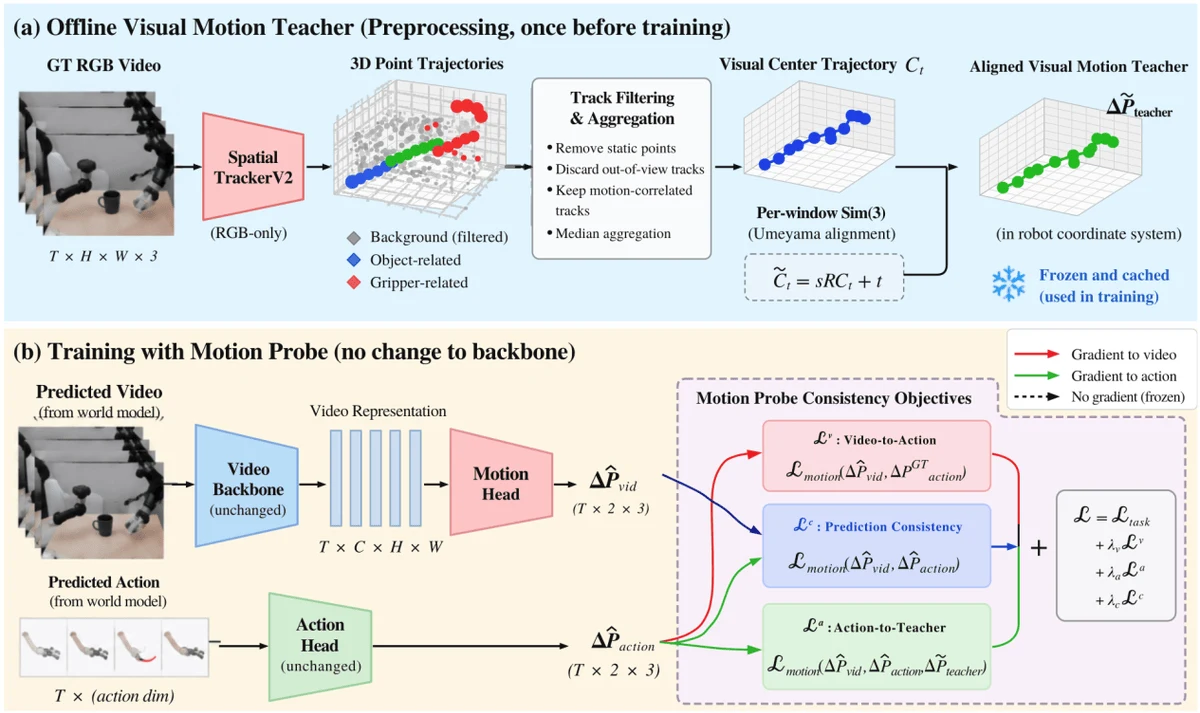
モーションプローブ図示
実験結果が予想を裏付ける:プローブの予測誤差は非常に低い。動作の監視がない場合でも、視覚表現には動作に関連する運動情報が既に编码されている。この結果は、表現レベルでの多モダル統一が実際に有効であり、視覚認知と動作計画は独立した二つの経路ではなく、共有される潜在空間内で深層的に結合していることを直接証明する。
07 これはどういう意味ですか
これはまた、Thinker-WMの今回の技術的突破の価値が、単なるランキング上位入りの成果にとどまらないことを示しています。それは、具身世界モデルの下層の新しいパラダイムを明らかにします。
具身インテリジェンスの世界モデルは、「ビデオ生成器 + 戦略ヘッド」の単純な組み合わせではなく、視覚観測、空間構造、動作計画という、同じ物理的世界プロセスの異なる表現である完全に統一された生成プロセスであるべきだ。
そのロボットが同じ表現空間内で、表示画面の変化、空間構造、動きの軌道を同期して推測できるようになったことで、物理世界の因果論理への理解が大きく進展する。これは、ロボットが「タスクを実行する」ことから「現実世界を理解する」へと移行する重要な飛躍である。
Thinker-WMは、Yobitロボットプラットフォーム上での展開検証を完了しました。関連技術は、次世代の「具身知能システム」をさらに強化する役割を果たします。
Thinker-WMの探索は今回の成果発表にとどまりません。モデル技術レポートおよび後続のイテレーションバージョンは、優必選の公式「具身インテリジェンス開発者コミュニティ」であるThinker Cosmosで継続的に更新されます。世界のモデル二次開発能力開放計画や技術解説ライブの予告も、開発者向けに即時に公開されます。Thinker Cosmos(https://thinkercosmos.ubtrobot.com/)に参加し、具身インテリジェンスエコシステムを共に構築しましょう。
プロジェクトリンク
論文リンク: https://arxiv.org/abs/2610.18447
プロジェクトアドレス: https://thinkercosmos.ubtrobot.com/thinker-wm
Github: https://github.com/UBTECH-Robot/Thinker-WM
Huggingface:https://huggingface.co/UBTECH-Robotics/Thinker-WM
本文は優必選が提供し、量子位が許可を得て転載したもので、意見は原作者に帰属します。