
金磊 シンセン発
量子位 | 公式アカウント QbitAI
恐怖は非常に悪い意思決定方法です。
この企業はAIの変革の機会を逃すことを心配しています。アマゾンのCTOであるWerner Vogelsは、焦るほどに、まず何を解決すべきか、AIがどのように役立つかをしっかり考える必要があると注意を促しています。
今では毎週新しいモデルが登場し、人々はどんどん焦ってしまい、一歩遅れたり、少しずつ遅れたりするのを恐れる。効率を上げ、革新を行うという気持ちは一つずつ強くなっていくが、技術が実際に何をできるのかについては、まったく明確にはなっていない。
深センでの交流の中で、彼は率直に述べた。企業が今この時点でAIを利用していないからといって、すぐに倒産するわけではないと。したがって、決定を下す前には、エンジニアと管理者が技術の能力を十分に学ぶことが必要だ。
しかし、ヴェルナーの口から出るこの言葉には、少し対照的な感じがする。
20年以上もアマゾンのCTOを務めてきたこの技術のベテランは、決して「不可能」を受け入れることを嫌う。クラウドコンピューティングの裏側の話をするとき、彼は特にコンピュータの先駆者であるグレース・ホッパーの言葉を引き合わせて、開発者たちに「私たちは常にそうしてきた」という言葉に注意を促す。
常にエンジニアに常識を打ち破るよう促す人が、なぜAIの場合にはまずゆっくりとやるように言うのでしょうか?
彼が話したデータベースの障害については、この矛盾する態度を説明するのに役立つかもしれない。
データベースで踏んだ落とし穴、AIはもう一度踏むべきか?
2004年12月12日、アマゾンはクリスマスショッピングシーズンの重要な時期にありました。当時、ユーザーが25ドル以上を購入すると無料配送を受けられるというサービスがありましたが、配送には時間がかかります。遅く注文すると、荷物がクリスマスに間に合わない可能性がありました。
ちょうどその日、顧客データベースの背後にある共有ディスクに障害が発生し、ユーザーはログインできず、注文も行えなかった。Wernerの記憶によると、この障害は12時間以上続き、Amazonは数百万ドルを損失した。
データベースサプライヤーが後から連絡してきた。Wernerは相手が正式に謝罪すると思っていたが、聞いたのは「テストをしっかり行うべきだ」という言葉だった。
自分の製品に問題があって、どうして顧客を責めることができるのですか?
ヴェルナーはもちろん怒っていたが、その後、アマゾンの規模がこの商業ソフトウェアの設計範囲をはるかに超えていることに気づいた。供給業者と議論を続けても、次の障害を解決することはできない。
そこで、チームはより基本的な問題を調査し始めた。アマゾンはどのようにデータベースを利用しているのか?
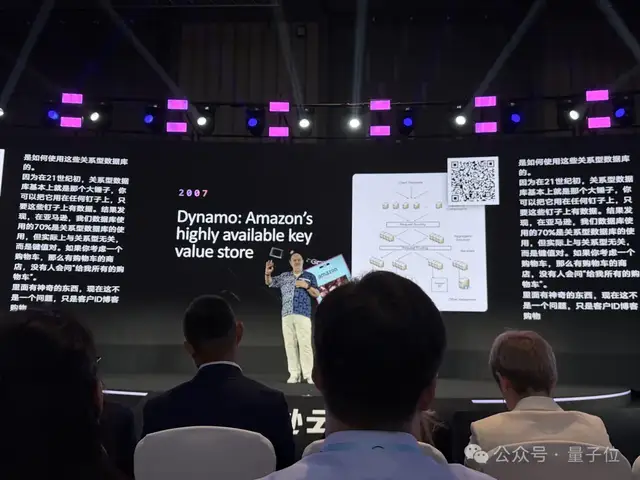
調査結果によると、約70%のリレー型データベースの利用シーンでは、キーと値のみのアクセスが必要である。
カートを例にとると、システムは通常、ユーザーの識別情報だけで対応するカートを取り出すだけです。アマゾンは全てのユーザーのカートを一括で表示し、複雑なクエリを行う必要はありません。
要求がそうである以上、チームは別の実装方法を考えられないか?実際のアクセス方法に沿って考えると、彼らはキー・値ストレージシステムDynamo、つまりDynamoDBの前身を構築した。
この経験は今日に置いてみると、なんとなく懐かしい感じがします。当時は関係型データベースという大きな道具で様々なデータの問題を解決していましたが、今では大規模モデルも同じように便利な道具になり得ます。
企業がAIを導入する際、ヴェルナーが繰り返し尋ねるのも同様の問いです。企業は何を解決したいのか、AIが適切か、現代のこの世代のAIが適切か?
彼は指摘した。画像認識、音声処理、予測などの分野では、すでに多くの有効な方法が蓄積されていると。企業が技術を選択する前に、まず課題自体を見る必要がある。大規模モデルを使用しても、必ずしもランキングで第1位を目指す必要はない。
ヴェルナーは基準テストについて保留を置いている。なぜなら、人工的に作られたテストと実際のビジネスとの間にはまだ差があるからだ。もしモデルが課題を十分に解決している場合、企業がより高いランキングのために費用を支払うことになると、利益を再考する必要が生じる。
また、ヴェルナーはこの計算をすでに20年以上にわたって行っている。
交流の話題がクラウドコンピューティングがもたらす根本的な変化に移ると、彼は経済モデルの変化を特に重視した。
以前に企業向けソフトウェアを購入すると、企業は5年や10年の契約を結ばなければならなかった。管理者は来年の需要すら予測できず、先に資金を支払わなければならない。Wernerは、これはまるでレストランに1000ドルを置いて、食べ終わっても返金されないようなものだと感じている。
クラウドコンピューティングは、リソースの使用量と支払いを関連付けることで、「縮小」にも実際的な意味を持たせる。夜間にはユーザーが少ないため、企業は不要なリソースを停止することができる。コストはついにアーキテクチャの議論に取り入れられ、事業部門も、ある能力にどれだけの費用をかける価値があるかを答えなければならない。
AIの時代になると、この取引には新たなプロジェクトが加わった。
例えば量子ビットが尋ねる際、「なぜスマートアイテムが忘れ去りまで重要なエンジニアリング問題になるのか?」という時、Wernerは率直に、スマートアイテムが毎回作業前に自分が知っている全てをスキャンする必要があると言い、システムのコストが高くなると指摘した。開発者は、タスクに本当に重要な内容だけを残す方法を見つける必要がある。
彼はまた、一部のプログラミングツールが再起動すると、再びプロジェクトの内容を読み込むことになると言った。ユーザーは昨日すでにその準備に費用を支払っていたが、今日は再び支払う必要がある。Kiroのクロスセッション記憶は、このような重複作業を減らすことを目的としている。
ですから、モデルがどれだけ賢いかという点に加えて、開発者は、あるタスクを実行するために、どれだけの無駄な作業を繰り返し行ったのかを問う必要があります。
これは、Wernerがなぜより小さなモデルについて話し合いをする意欲があるのか、またDeepSeek、通義千問、Kimiなどのオープンウェイトモデルについても説明しています。彼の観察によると、一部の顧客は継続的な実験を経て、より小さなモデルで要件を満たすことができ、使用コストもはるかに低いことに気づいたとのことです。
何を使い、どのように使い、いくらかかりるか、これらの古くなった問題は、企業がAIに取り組む際も依然として避けられない。
エージェントの過ちを引き受けるのは誰か?
企業がコストを計算したとしても、開発チームには別の問題が待っている。
チャットボットが文章を提供し、人はそれを読んだ後でどうするかを決めることができます。エージェントはユーザーの代わりに行動し、スケジュールを変更したり、ツールを呼び出したり、プログラムを実行したりします。モデルが間違った答えを出した場合、その誤りは実行過程を通じて実際の結果になってしまう可能性があります。
ヴェルナーは交流の過程で、エージェントにチケットの変更手続きを手伝ってもらうことを喜んで受け入れると述べましたが、明確な要求もあります。システムはどのように操作するかを知り、彼の好みを記憶し、同時に制限を受ける必要があります。
そして、この境界への執着は、彼が語るNitroの話の中で既に触れられている。
初期のクラウドコンピューティングは仮想化に依存しており、1台の物理サーバーを複数のユーザーに割り当てる。しかし、仮想マシンを管理し、ネットワークやストレージへのアクセスを処理するソフトウェア自体もリソースを消費する。仮想マシンが増えれば、管理層がボトルネックになる可能性もある。
AWSは後にNitroを構築し、多くのネットワークやストレージ機能を専用ハードウェアに移行させ、元の完全なLinux管理環境dom0を削除した。チームはパフォーマンスのボトルネックを解消し、同時に攻撃面も大幅に減少した。
Nitroには「受動通信」という興味深い設計があります。Wernerの説明によると、仮想マシン監視プログラムはNitroコントローラからの命令を待っています。もし逆にコントローラに積極的に連絡を取るような場合、通常のプロセスにはない行動が起こります。そのためプラットフォームは関連システムをサービスから切り下げて調査を開始することができます。
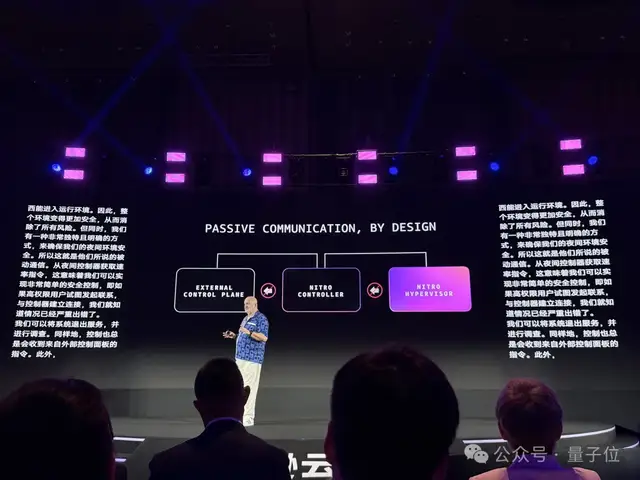
この考え方に沿えば、WernerがAgentに求める条件も容易に理解できる。ユーザーがシステムに許可することを何をしてもらうかは、事前によく明確にしなければならない。彼は簡単な例を挙げた。ユーザーはAgentに対して、毎日100ドルを超えないようにすることを指定でき、超過した場合は人間の決定が必要になるということだ。
彼の説明によると、アマゾンはAgentにルール実行メカニズムを設計しており、Agentがツールにアクセスしたりスクリプトを実行したりする操作をチェックし、顧客が明確に許可した範囲内でのみ行動するように制限している。
ユーザーの自主行動の権限は具体的な範囲を定めています。モデルがある事柄を実行する価値があると判断しても、実行システムはその権限があるかどうかを確認する必要があります。
しかし、これらの制約がエージェントの効率を低下させることになるのではないか?この問題に対して、Wernerが最初に語ったのは責任である。
あなたがそれを構築するなら、その責任もあなたにあります。(You build it, you own it.)
彼にとって、エージェントの開発者はそれを制御できる必要がある。システムがどのような行動を取ったか、境界を超えたかどうかは、最終的には人が責任を持つべきだ。
ヴェルナーは、AIへの信頼を分散型システムの経験に戻した。エンジニアは、各コンポーネントが永遠に信頼できると仮定することは決してないため、複製、隔離、および様々な信頼性メカニズムが必要となる。チームが個々のコンポーネントに対して警戒心を持つことで、全体のシステムへの信頼を築くことができる。
しかし、エンジニアはこれらの保護機構を、顧客が手頃な価格で利用でき、かつ作業の遅延を明らかにしないサービスとして実現するためには、多くの妥協が必要です。Lambdaも同様の困難に直面したことがあります。
若い頃、WeTransferはS3にアップロードされたファイルを処理するために、新しいファイルが来るのを待つ間、一連の計算インスタンスを常に稼働させていました。顧客は単に待機状態を維持するだけで、一連のインフラ基盤を管理しなければならなかったのです。
AWSはこれらの作業を引き受けたいと考えており、顧客にコードを提出させ、実行時間とメモリ使用量に基づいて料金を請求する。チームは料金の仕組みや、底層でどのように効率的に実装するかを十分に考えたが、それでも難題である。
異なる顧客を分離するために、初期のLambdaで使用されていた仮想マシンは、関数タスクに対して依然として大きすぎてコストが高かった。その後、チームはFirecrackerを利用して隔離ユニットをより軽いマイクロ仮想マシンに変換することで、リソースの利用率を向上させた。
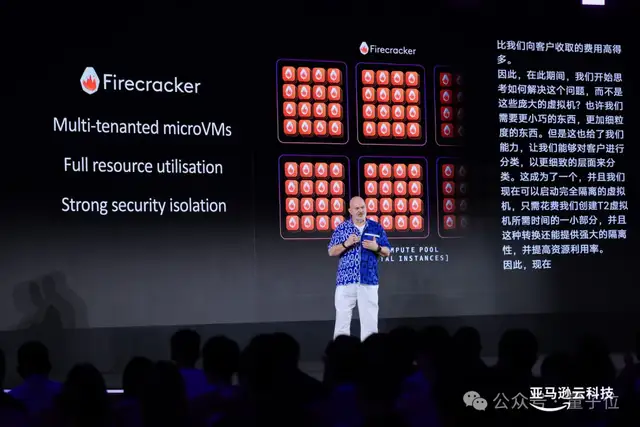
隔離問題が解決された後、チームは冷起動を処理する必要があります。関数が実際に実行される前に、システムは運用環境、コード、依存関係を準備する必要があります。SnapStartは初期化された環境のスナップショットを保存することで、この準備コストを減らし、起動性能を向上させます。
顧客が見るのは、ただ一つの関数呼び出しかもしれない。しかし、エンジニアチームは背後で継続的に隔離、リソース配分、起動、およびネットワークメカニズムを磨き上げている。
ヴェルナーはこれらの作業を「見えない工学の革新」(Invisible Engineering)と呼んでいる。
エージェントが実際の業務に入るためには、開発チームにこれらの細かい作業も欠かせません。デモンストレーションが成功した後、チームは権限をどのように制限するか、異常をどのように処理するか、そしてユーザーがどれだけの範囲のタスクをそれに任せるかを明確にする必要があります。
経験には圧縮アルゴリズムはない
エージェントがコードを書き始めると、上記の問題が再び開発チーム自身に戻ってしまいます。
初級エンジニアの採用について話すと、Wernerはアマゾンが初級エンジニアを募集する人数は以前と変わらないと応答した。その後、彼は新入社員がチームに入った後の学習について話題を変えた。
卒業したばかりの人がS3チームに加わり、20年前のコードに直面するかもしれない。学校では、そのようなシステムをどう理解し、どのように維持・保守するかを教えるのは難しい。
したがって、ヴェルナーは好奇心、学習能力、そしてオープンソースプロジェクトの経験を重視している。新人がオープンソースでの協力に参加したということは、彼のコードが他の人々によって検討されていることを意味し、彼もまた他人と共に問題を解決する必要がある。
AIは新入社員にチームの規則を説明するのを手伝い、経験豊富なエンジニアが何度も説明する必要を減らすことができます。WernerがKiroを紹介した時も、仕様の説明を重視していました。開発者はまず要件やアーキテクチャ、開発規則を明確にし、その後でシステムが正常に動作するようにします。
しかし、AIがコードを生成する速度が上がったため、チームがコードを理解し検査する速度は必ずしも追いつかない。
ヴェルナーは、開発チームが注意を払うべき概念について言及した。それは債務の検証である。
過去は進捗を急ぐために、開発者が近道を歩み、後に修正する必要があることを記録しました。その結果、技術の借金が蓄積されました。現在では、AIで生成されたコードの中には、まだ検証されていない部分があり、チームはさらに借金を抱えることになっています。
一つのインターフェース要素が数ミリずれしただけで、顧客情報が漏れる可能性のあるコードと比べると、影響は全く異なります。開発チームはリスクに応じて検査を行い、最も検証が必要な部分に力を注ぐ必要があります。
ヴェルナーの考え方に沿って見ると、チームはコードの量を増やしやすいが、そのコードを理解し、それに伴う結果を受け入れるかどうかは別途評価が必要だ。そうでないと、開発者が今日節約した時間は、後々の調査や作業に再び費やされる可能性がある。
これは、Wernerがなぜ初級エンジニアにコードを読ませ、ベテランエンジニアと共に審査・議論を行わせることを続けるのか理由です。ツールは知識を説明できるが、具体的な問題に対する判断には、人間が少しずつ蓄積する必要がある。
経験には圧縮アルゴリズムはありません。(経験には圧縮アルゴリズムが存在しない。)
ヴェルナーのこの言葉は、開発者の不安に対する答えとして、非常に適切です。
しかし、中国への旅行について話すとき、彼はAI応用に対してより楽観的な例を話しました。彼は「米と小麦」の訪問体験について多くの時間を費やして説明しました。
この機関は、自閉症や注意欠陥多動性障害など、発達支援が必要な子供たちに介入サービスを提供しています。Wernerによると、この機関はAIを利用して教育記録を分析し、子供の進歩を観察し、リハビリテーションセラピストに提案を提供します。リハビリテーションセラピストは、専門的な判断を加えて、どの提案を実施するかを決定します。
彼に印象を与えたのは、AIが専門家の業務的な作業を減らし、彼らがより多くの時間を子供と家族のために使えるようにしたことだった。
ここで、ウェルナーの楽観的な考えに具体的な対象が現れた。技術はどのような人々の負担を軽減し、どのような人々が元々支援を得ることが難しいかを助けることができるのか?これらの具体的な応用によって、彼はAIの価値を見出した。
「まず一時停止キーを押す」ということについて、企業が止まってよく考えなければならない事柄が具体的になった。タスクがAIに任せるのに適しているか、コストが負担できるか、行動範囲はどのように定めるか、結果は誰が検証するかなど、開発チームは一つ一つ答えなければならない。
ヴェルナーは、開発者が行う最も優れた仕事は、他人には見えない場所に隠されていると言った。
AIがコードを書き加えた後、エンジニアはこのコードが公開された後に何が起こるかを知っていなければならない。