
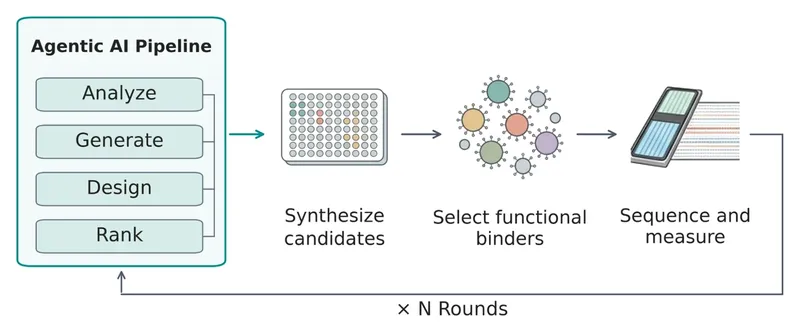
Frontier AIシステムは、広大な組み合わせ探索空間を知的に操作することで、生物学研究や薬物発見を変革する可能性を持っています(例えば、1つの100アミノ酸のタンパク質は少なくとも20100通りの可能な配列を含む)。これには動的な複数候補の探索が必要です。私たちの長期的な研究ビジョンでは、AIエージェントは単にアイデアを思いつき分析するだけでなく、実験を行って仮説を検証し、結果から学び、自己改善して複雑な問題を解決することも行うということです。これらはすべて、人間の科学的な介入によって推進されるものです。
このビジョンを実現するには、2つの密接に関連する課題を解決する必要がある。第一に、フロンティアモデルは依然として3次元幾何学や物理的状態について信頼性の高い推論を行えない――これは、試薬を移動し、量を追跡し、湿潤実験室で分子生物学的プロトコルを実行する専門的な液体処理ロボットの自動化において問題となる。第二に、エージェント型仮説生成やin-silico設計は急速に進展しているが、提案を検証し、広大な探索空間を navigateするために実世界のフィードバックを繰り返し行う必要がある。しかし、実世界の湿潤実験はそのペースに追いついておらず、実験結果の取得は以前よりもさらにボトルネックとなっている。
この記事では、インシリコAIの探索と実世界のwet-lab実験との間のギャップを埋めることに関する私たちの進捗を示す3つの研究プロジェクトを共有します:
- VERIDフレームワークを使用して、AIエージェントが物理測定に基づく安全で資源効率的な実験を行えるようにする。
- アプタマーとデノヴォタンパク質設計に関するプロトタイプで、閉ループ型エージェント型科学発見を実証しています。
物理的現実における接地剤
まず、AIエージェントの高水準な推論と、湿潤な実験室の複雑で誤りを含む物理的現実との間のギャップを埋めるために、VERified Infrastructure for Discovery Laboratories(VERID)フレームワークを紹介します。これは実験室の作業セルのセマンティックなデジタルツインであり、ロボットアームの形状から個々の井戸の容積、試薬の識別情報、ピペットの先端在庫に至るまで、すべてを追跡する状態を持った3Dボリュームラテラルエンティティツリーです。
コマンドの安全性は、コードだけでなく実際の物理的状況にも依存する。エージェントは、構文上は有効だが物理的に不可能なコード(例:8チャンネルのピペットを、短すぎる狭い溝に入れること)、論理的に不適切なコード(例:空になったポートから吸引すること)、またはモデル化されていない流体効果によって科学的に問題となるコードを生成することができる。
VERIDを通じて、AIエージェントは液体処理ロボット上で液体処理プロトコルを計画し、シミュレートし、実行する。同期化された複数カメラの映像とライブ状態追跡を組み合わせて、サイクルを通じて実験を改善する。
オープンソースのPyLabRobotフレームワークを基盤として、VERIDは4つの核心機能を提供します:
- ライブ3D状態トラッキング:エージェントが行動する前に、デッキの配置、ボートの容量、利用可能なティップを確認できるようにする。
- 迅速な仮想実験:数秒でプロトコルをシミュレートし、試薬に触れる前に衝突や空のウェルを発見する。
- ハードウェア安全チェック:ロボットに到達する前に、無効なコマンドを遮断する。
- 同期化されたビデオとアクションログ:研究の厳密性、再現性、デバッグのために、各実行の完全な記録を取得する。
私たちの報告書において、ケーススタディを通じてこれらの能力が実際に動作していることを示しています。まず、井戸底に近すぎる投与によって引き起こされる不均一な染料の層化を、同期ビデオと実行トレースが捉え、エージェントは混合戦略を改善することができました。同じキャンペーンで、持続的なデジタルツイン状態により、エージェントはプレートリーダーが故障した場合でも、再調合することなく途中で回復することができました。次に、シミュレータが狭い溝に物理的に収まらない8チャンネルの吸引を拒否したとき、エージェントは即座に再計画し、残りのチップ壁の残留による微妙な偏りを抽出するターゲット型ファクタリアル診断を設計しました。これは、単独での再現では見逃されるものです。最後に、閉ループ自己プレイキャンペーンにおいて、エージェントはオーバーヘッドカメラ画像から盲入れされた染料混合物を再構築するために、ロボット実験を反復的に設計・実行し、回数を重ねるごとに自身の光学的および流体学的アーティファクトを特定し、精度を5倍以上向上させました。
再現可能な実行と完全なトレースログ — 滞在時間、蒸発、プレートレイアウトなどのプロシージャル変数を記録する — は、エージェントが複数の候補を同時に探索・改善する過程で、生物学的信号と実験的なノイズを区別できるようになるための基盤となる。
アプタマーを使った学習方法の習得
エージェントは、計算モデルが湿潤実験での反応の全貌を把握できず、経験的検証に代わるものではないため、仮説を精緻化するために実際の実験結果が必要である。『Aptamers as a sandbox for lab-in-the-loop agentic molecular discovery』において、私たちはタンパク質と結合するDNAのアプタマーを使用し、3回の設計・テスト・反復サイクルを経て、AIエージェントを用いた閉環式実験プロトタイプを作成した。アプタマーの発見は、臨床バイオマーカーの発見に関する研究活動で一般的な実験の一種である。完全なアプタマー設計・テスト・分析サイクルはわずか7~10日で済む。なぜなら、DNAはプールライブラリで化学的に合成され、シークエンスによって直接読み出すことができるからである。各ラウンドにおいて、エージェントは候補配列を設計し、磁気ビーズ上の標的タンパク質に対してスクリーニングを行い、機能的な結合剤を分離する。その後、シークエンスによって次のサイクルに向けた豊富な定量的データを得る。
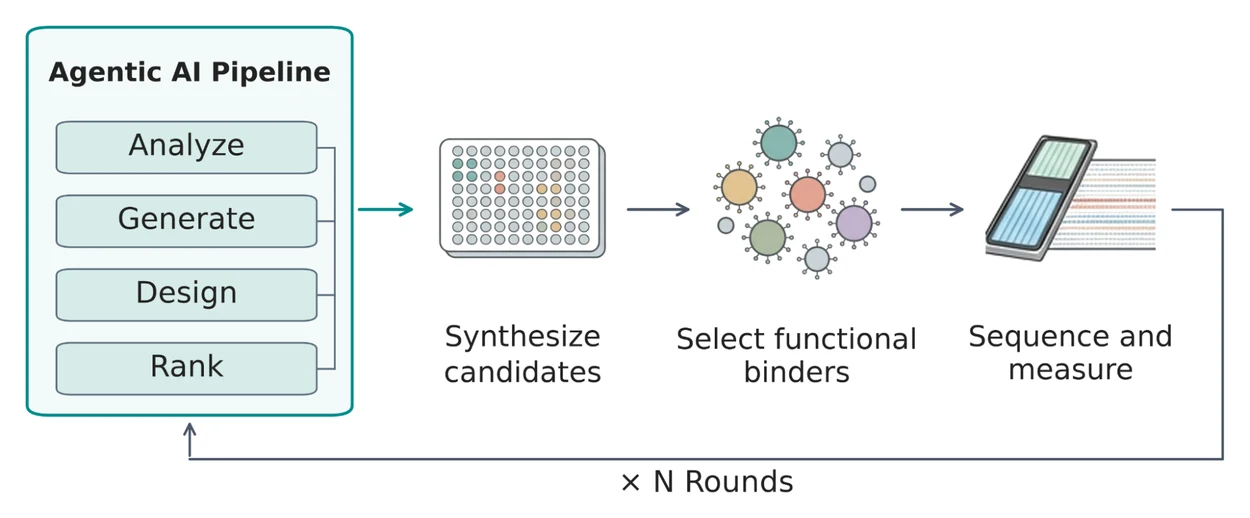
エージェントは閉ループの中で、アプタマーを反復的に設計し、合成し、選択し、配列する。
2つの異なる難易度のタンパク質標的に対して、3ラウンドにわたる試験ミオグロビン そして α-トリプターン),AI駆動型の合理的かつ新規設計により、下の図で見られるようにターゲット到達率が確認されました(ミオグロビンとα-トリプターンでそれぞれ33.5%と42.1%)。しかし、各ターゲットには異なる湿潤実験の失敗モードを特定し克服する必要がありました。
α-トリプターンについて、第1ラウンドでは0%の結合能が得られた。なぜなら、固定されたプライマーのオーバーハードが48%の配列で折りたたみ機構を破壊したからである。第2ラウンドに薬剤がクランプ型の隣接配列を導入し、第3ラウンドで多様化したことで、ヒット率は26.0%に上昇し、98.5%の特異性を持つ場合には42.1%に達した。
ミオグロビンにおいて、第2ラウンドでは生の結合親和性を優先する因子が作用し、G-quadruplexモチーフが63%で大幅に増加した。生のプルダウンが増加したものの、湿潤実験データによると、これらのG-quadruplexのほとんどが標的外のタンパク質や裸の磁石ビーズに付着する非特異的な「粘着」結合体であり、標的特異性(75.0%から19.1%へ)と、ビーズを正確に調整したヒット率(10.2%から3.7%へ)が急落した。第2ラウンドの読み出しからこの現象を認識した後、因子は自動的に第3ラウンドの設計規則を修正し、多様なモチーフの使用を制限し、ビーズ結合体を除外し、非G4構造的スカフロワに転換することで特異性(72.4%)を回復し、オンターゲットヒット率は9倍に上昇した(33.5%)。
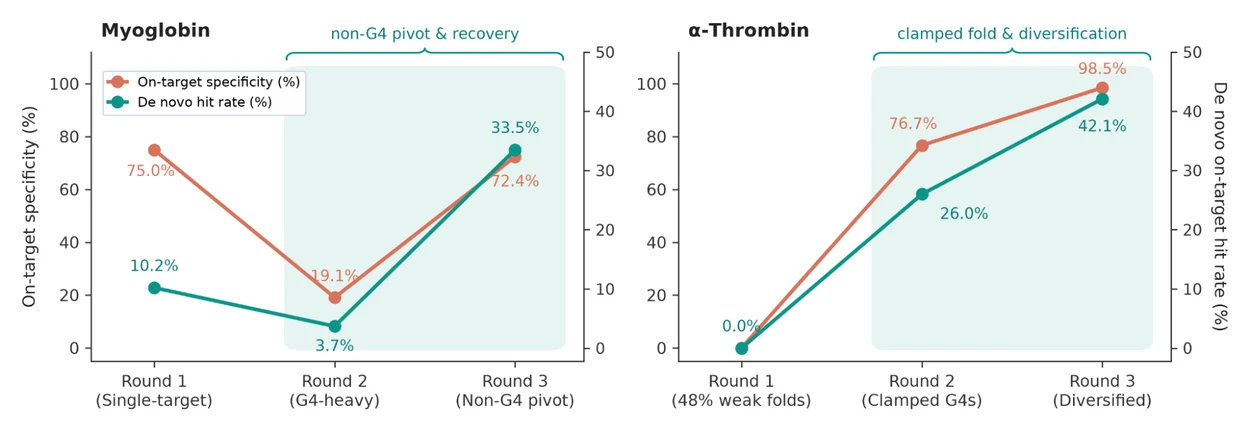
3ラウンドにわたり、エージェントは湿潤実験のデータから学び、目標の特異性を回復し、ミオグロビン(左側)およびα-トリプターン(右側)に対する確認された新規ヒット率を向上させる。
論文では、エージェントが科学者と同じようにデータを分析し、湿潤実験プロトコルに修正を提案する方法を検討している。しかし時には非典型的な思考をし、構造生物学者が探求しない系列空間を探索することもある。
新規にプロテイン結合剤の設計を加速する
タンパク質のループを閉じることはより複雑です。化学的に合成されるアプタマーとは異なり、タンパク質は生物学的に発現されなければならないため、各ループには細胞内または細胞外での選択、発現、および折りたたみのステップが加わります。より大きな配列空間と共に、これにより計算側と湿潤実験室の両方でボトルネックが生じます。
「エージェント主導のエピトープ切除により、経済的なデノヴォ結合剤設計が可能になる」という論文において、我々は固体腫瘍で過剰発現する大規模で難易度の高い受容体である線維芽細胞活性化タンパク質アルファ(FAP)に、自らのワークフローを適用した。わずか数回の実験を行っただけで、最良の設計により、単位数字のナノモルの親和性を持つ結合剤が得られ、これは通常、長期にわたる実験的最適化を経て初めて達成される薬物様の密着結合レベルである。
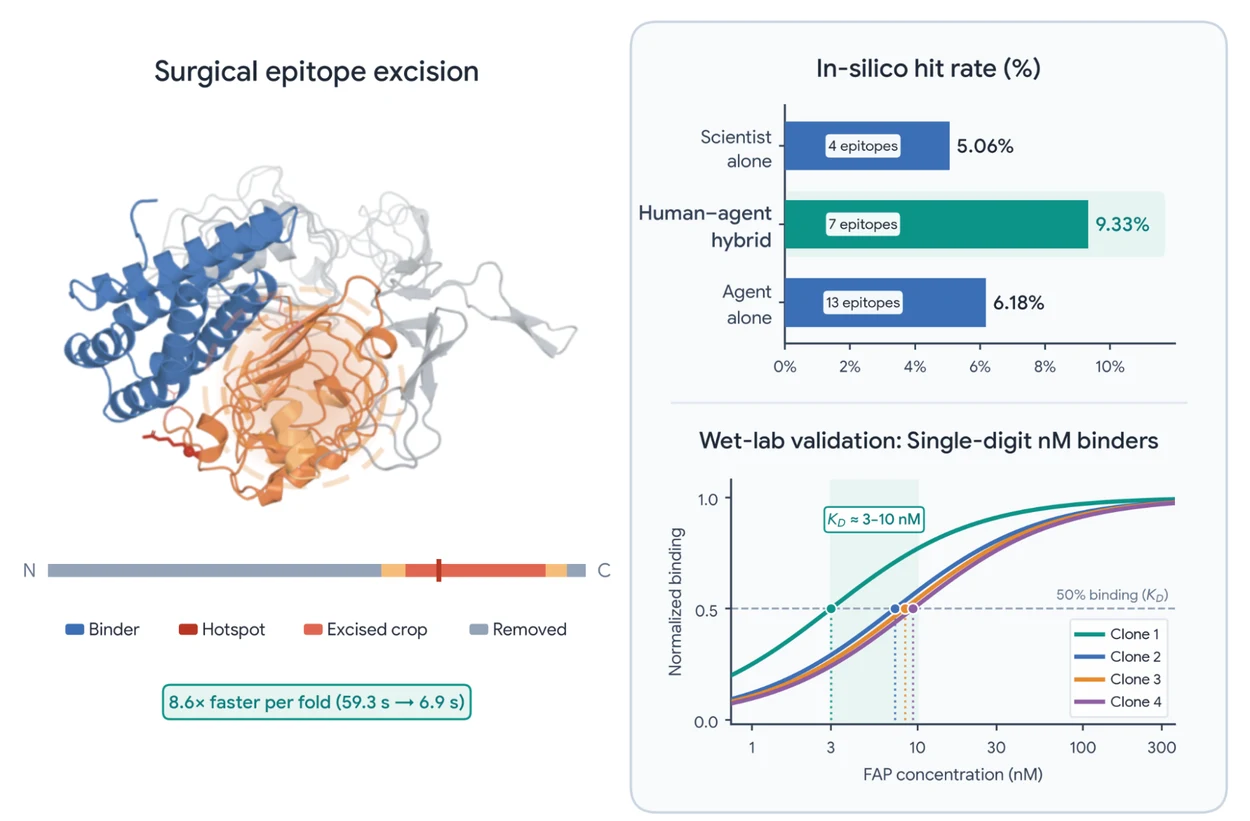
手術エピトープ除去により、構造予測が8.6倍加速する。左)、人間とエージェントのハイブリッドパイプラインを実現し、コンピュータ内でのヒット率をほぼ2倍にする右上) そして湿潤実験室で単位数のナノモルレベルのFAPバインダを発見する(右下).
計算上、新たにバインディング構造を設計するには、候補のバックボーンを生成し、それに合った配列を設計し、得られた複合体を再折りたたんで結合を予測する必要があります。最終的な再折りたたみステップは、ターゲット長に比例して二次的に増加するため、ほぼ全体のGPU計算を消費します。再折りたたみ時に局所の結合ポケットのみを切除することで、パイプラインは構造的精度を失うことなく、各サイクルを8倍以上速く加速できました。 これにより、どこに結合するか、どれだけ周囲の構造を含めるかに関する決定が、LLMエージェントが最適化するのに適した戦術的な要素となります。
同等の計算能力を持つ、人間とエージェントの協力による対決シナリオでは、科学者が高水準の戦略を定め、エージェントが戦術的な実行を担うという状況下で、単独で働く科学者のインシリコヒット率はほぼ2倍になり、より広範な標的サイトにおいてヒットを発見することができる。計算パイプラインと共に湿潤実験のスクリーニングを拡大するために、酵母表面表示を蛍光活性化細胞分離(FACS)というワークフローで実用化した。これにより、蛍光法を用いて大量の工程化されたタンパク質変異体を並行してスクリーニングすることが可能になる。
次のステップは、VERIDの完全に追跡可能な自動化と閉ループ学習を組み合わせて、タンパク質発見のための複雑で厳しい生物学的探索空間を湿潤実験室で直接操作できるエージェントを実現することです。
安全
GoogleのFrontier Safety Frameworkや、私たちの生物回復力への取り組みに沿って、私たちはワークフローの計算的側面と湿潤実験の側面の両方において保護措置を構築しています:
- 安全な試験台とスクリーニング:私たちは、機能向上のリスクがない、よく管理された非感染性の生物システムを意図的に選択し、病原体の行動を評価し、早期に変化を発見するための試験台としています。すべての設計された配列は生物セーフティスクリーニングを経ています。
- 実行前のシミュレーション:VERIDを通じて、エージェントは未検証のコードを液体処理ロボットに直接送信することはありません。すべてのプロトコルはシミュレーション中に実行され、試薬に接触する前にデジタルツインで検証されます。
- 人間の監督:人間が直接、設計されたシークエンスを承認し、レビューを行い、湿潤実験のプロトコルを確認し、ロボットの実行を監督する。
AIエージェントが設計・テストサイクルをより多く担うようになると、新たな安全性と信頼性の課題が生じる。自律型ウェットラボへと進むには、人間の介入や監督の機会をもたらす形でこれらの未解決の問題を解決する必要がある。つまり、エージェントが意図しない実験的な近道ではなく、真の目標を達成するために最適化されることを保証し、複数段階にわたるウェットラボのプロトコルを確認し、エージェントの推論と実行の痕跡を継続的に監視することが求められる。
物理的なラボロジスティクスにおけるエージェントを基盤とし、エージェントが配列空間を探索することを学ぶ高速閉ループアプタマーサイクルを実行し、単位数字のナノモルレベルのタンパク質結合剤を発見することに至るこれらの取り組みは、生命科学分野における人間主導型自律的な発見の構成要素となっている。私たちはこの進歩に興奮し、次に何が起こるかを共有することを楽しみにしている。
謝辞
この研究は、Annalisa Pawloskyが主導し、Pooja RaoおよびPetar Sirkovicも参加しています。この研究を支える基礎的な論文に協力した共著者や協力者たちに感謝します:Zach Cutts、John Coller、Rachel Chen、Mathias Bellaiche、Hua Tang、Ryder Easterlin、Dina Zverinski(aptamerの発見);Jun Kim、Artiom Myaskovsky、Oscar Donosa、Jamie Rogers、Lawrence Chan(タンパク質設計);Yves Delley、John Coller、Zach Cutts、Alexander Daryin、Mathias Bellaiche、Jun Kim、Oscar Donosa、Srinidhi Seshadri、Tanner Clary、Sandy Klemm。Xinyi Deng、Sanath Ramachandran、Jiawu Biからも技術的・実験的な貢献があり、VERID automationにも寄与しています。
レウヴェン・サヤグ、アヴィナタン・ハシディム、ロニット・レヴァヴィ・モラド、ヨッシ・マティアス、ジェームズ・マニカの指導的支援に、またこの研究を通じての支援をしたマティアス・ハイラー、ブラク・ゴクトゥルク、ビル・ジャ、プッシュメート・コーリーに深く感謝します。また、レビューと洞察に富んだフィードバックを提供したシェコフェ・アジジ、アンドリュー・キャロル、フィリップ・Q・ネルソン、イシャイ・マンスール、ダン・ポポヴィチ、リッカルド・ピソニに感謝します。この取り組み全体への貢献に対してアマニエ・ブリクに、そしてこの投稿のビジュアルデザインとグラフィックに対してウディ・グラフに感謝します。