
北の星
AIエージェントを導入しようと急ぐあらゆる組織は、同じ課題に直面する。美しく動作するエージェントが実際の運用中に徐々に性能が低下することがある。人間が気づく頃には、信頼関係はすでに破綻している。従来のソフトウェアが騒々しく失敗するとき、エージェントは静かに失敗する。自信に満ち、流暢に読めるように見えるが、実際には間違っている答えを返す。その答えが実際のビジネス決定を導くとき、問題となるのは機能の破損ではなく、ユーザーとの関係の破損である。
それが品質問題の核心です。したがって、課題は一度だけ動作するエージェントを構築することではなく、すべてのサブエージェント、すべてのワークフロー、すべてのリリースにおいて、大規模に継続して動作することを証明することです。エージェント時代を制覇するチームは、品質を最終的なQAステップとしてではなく、エージェント自体のオペレーティングシステムとして扱うことで、継続的に測定し、自動的に保護し、すべてのインタラクションと共に改善していくのです。 この記事では、Amazon Bedrock AgentCoreを使用して、大規模な生産準備ができるエージェント型ソリューションのための連続的な品質ループをどのように構築したかを紹介します。
ビジネス問題
このソリューションでは、内部利用のためにAmazon Bedrock AgentCoreおよびその他のAWSサービスが使用されています。そのため、販売員や営業リーダーはAmazon Quickから簡単な英語でビジネスに関する質問をすることができます。この単一の体験の背後では、いくつかの専門的なサブエージェントが協力して機能しています。地域ごとの収益とパフォーマンスの分析を行うPerformance Insights Agent、顧客情報の分析を行うCustomer Insights Agent、基本的なデータセット上でのテキストからSQLへの処理を行うData Insights Agent、そして直接ダッシュボードにアクセスできる機能です。 回答は各ユーザーの領域と役職レベルのセキュリティに基づいています。フィールドチームはこれらの回答を利用してアカウント戦略の計画を立て、顧客ミーティングの準備を行います。そのため、数字は正確でなければなりません。最も悪影響を与える失敗はクラッシュではなく、静かに間違った自信に満ちた回答です。リリース前に、Customer Insights Agentを評価したとき、私たちはまさにそれを見つけました。
- 顧客の3ヶ月間のサービス収入が410.08ドルであると報告され、「410.08百万ドル」と記載されていました。
- 調整を除く売上収入として「売上収入」と記載された売上収入が報告されました。
- データの中にどこにも見当たらない、年間定期収入の推定値が示されていました。
- それは自身の計算結果を根拠となる事実として示した。
異なる実行を通じて、監視は正常な状態が続いた。これにより、システムが応答したことがわかったが、その回答が正しいかどうかは分からない。
これらのエラーが発送されずにいる場合、フィールドはそれに対する費用を負担することになっていただろう。誇張された数字を繰り返す販売者は、顧客からの信頼性を失う可能性がある。まさにそのため、私たちはリリース前にそれを発見したのだ。リスクはリリース時で終わるわけではない。新しいエージェントが登場するたび、データ、プロンプト、コード、モデルに変更があるたびにリスクは増大する。また、リリースがない状態でもリスクは増大する。なぜなら、アップストリームパイプラインが毎週データを更新するからだ。 連動的なリリースは関連するリスクをもたらす:データの変更、ツールの変更、そして対応するプロンプトの更新が一緒に提供されるはずなのに別々に実施された場合、システムはすべての変更が追いつくまで、互換性がない状態で動作する。事前製作テストの一例では、その不一致の期間だけで合格率が78%から38%に低下した。 こうした失敗を捕捉するためには、リリース前や運用中に継続的に、回答が正確かつ根拠があるかどうかを示し、各失敗がデータ、プロンプト、またはエージェントのコードにおける根本的な原因に至るまで追跡できるフレームワークが必要です。
AWSでは、営業・マーケティング・グローバルサービス(SMGS)運営チームが、世界中のAWSフィールドセールスを支援する生産型マルチエージェントシステムを開発しました。このシステムは2つの異なる対象者にサービスを提供します。フィールドセールスチームにとっては、手動でのデータ分析に費やす時間を、オンデマンドの対話型インテリジェンスに置き換えることで、セールス担当者が自社の状況を把握し、リスクや機会を明らかにし、より迅速に行動できるようにします。 リーダーシップにおいて、週次業務レビュー(WBR)を含む事業管理プロセスをサポートし、手作業による報告の準備を必要とせずにポートフォリオ全体で重要な情報を可視化します。同じエージェント型システムが、最前線の販売担当者と、規模化されたパフォーマンスをレビューするリーダー両方に利用されます。
エージェントシステムは、それぞれ独自の能力領域を持つ専門的なサブエージェント群を成長させています。その中には、Performance Insights Agentが含まれます。このエージェントは、複雑な売上データから自然言語でビジネスインテリジェンスを生成し、生の指標を実行可能な販売者の洞察へと変換します。また、Customer Insights Agentは、製品の使用状況、サポート履歴、契約状況、エンゲージメントデータなどを統合して、各顧客の360度の視点を構築し、販売者が顧客のプロセスにおける位置や次に必要なものを理解するのを支援します。さらに、Data Insights Agentは、SQLの一行も書かずに、構造化された分析データを簡単な英語でクエリするために、アカウントチームが使用するテキストからSQLへの変換エージェントです。これら3つのエージェントが、この記事の他の部分でも言及されています。
これらのエージェントを規模において信頼性高く調整することで、一つ明らかになった。すなわち、エージェント性の品質は後々に管理すべき運用上の問題ではなく、運用の前提条件であった。1つの劣化したサブエージェントが、下流のすべての応答を静かに破壊する可能性があり、従来の監視ではそれを検出できない。この現実から、完全なライフサイクル評価フレームワークは選択肢ではなく、必要不可欠であった。 Amazon Bedrock AgentCoreの機能であるAgentCore Evaluationsは、Amazon Bedrock Guardrails(セキュリティ)、Amazon CloudWatch(メトリクス、アラーム、トレーシング)、Amazon Simple Storage Service(Amazon S3)、Amazon Redshift(評価の永続化)、Amazon Quick(ダッシュボード)、およびAWS Lambda(カスタム評価器)と共に、その動作を支える結合組織である。
この記事では、企業規模でAIエージェントを運用する際の最も難しい運用課題にどのように対処したか、そしてAmazon Bedrock AgentCore Evaluationsがエージェントの品質の基盤となる方法について共有します。具体的には、以下の内容を扱います:
- エージェントは異なるルールに従う– なぜエージェントは異なる運用規律を求めるのか、そしてなぜ従来の監視(遅延、エラー率、稼働時間)が最も重要な障害を見落としてしまうのか。
- 全行程用の地図 – AgentCore Evaluations上で構築した9段階評価フレームワークで、最初のコミットから運用まで、エージェント開発ライフサイクルのすべての段階をカバーします。
- 理論から実践へ – 具体的なパターン(連続的統合と連続的デリバリー(CI/CD)の回帰ゲート、カナリースコアリング、ドリフト検出、自動化されたフィードバックループ)およびAgentCore評価がそれぞれどのように機能するか。
- 実際に重要な指標 – エージェントポートフォリオにおける展開信頼性、回帰防止、反復作業の速度への測定可能な影響。
なぜエージェントには構造化された評価フレームワークが必要か
従来のソフトウェアは決定論的である:同じ入力が同じ出力を生み出す。機械学習(ML)モデルは確率的な出力を導出するようになり、MLOpsはそのトレーニング、バージョニング、監視、再トレーニングを管理するために登場した。AIエージェントは第三の操作の複雑さの層を加える:自律的で多段階の推論であり、「何かが壊れたか?」という問いから、「エージェントが全体の推論チェーンを通じて適切な決定をしているか?」という問いへと変わる。
エージェントは前任者が抱える難問を継承しつつ、新たな問題も導入する。それらは非決定的であり、同一の入力に対して異なる推論経路を辿る。ルーティング、ツール選択、合成に関するカスケード決定を下す際、一つのステップが静かに失敗し、下流全体を破壊する可能性がある。最も重要な点は、それらが静かに劣化することである。レイテンシは低く、エラー率は安定しているが、エージェントの応答品質は低下する。なぜならエージェントは依然として 応答する。それは単に応答しているだけです 間違った.
エージェント評価とは、まさにそのことを行う手法です。これには5つの側面があります:安全性(定義された範囲内で動作しているか)、品質(エージェントが正確で一貫性のある、根拠のある応答を生成しているか)、性能(十分に高速で信頼性があるか)、コスト(スケールにおいて効率的に動作しているか)、そして運用管理(問題を迅速に検出し、診断し、修正できるか)。成熟した評価手法は、エージェントの全ライフサイクルを通じて、これら5つの側面を継続的に対処します。
この記事では、生産用マルチエージェントシステムにおいて5つの評価次元をどのように実装するかを共有します。安全とセキュリティが私たちの最優先事項です。安全基準を満たせないエージェントは、製品を出荷することも、常に動作し続けることもありません。品質については、この記事で最も多くのスペースが割かれています。なぜなら、これら5つの要素の中で最も正確に実現するのが難しく、専用のフレームワークから最大限の恩恵を受けるからですが、安全よりも優先されるわけではありません。性能、コスト、運用制御は、これらと共にライフサイクルの各段階に組み込まれています。重要なのは、このフレームワークがエージェントの階層のすべてのレベルで適用されることです。ツールレベルでは、各機能(顧客識別ツール、グラフ検索ツール)に独自の評価契約があります。エージェントレベルでは、各サブエージェントがエンドツーエンドで評価されます。マルチエージェントレベルでは、オーケストレーションパスが、エージェント間の一貫性、正しいルーティング、および合成精度について評価されます。
9つの段階は同時に3つのレベルで適用され、この階層構造はこの製品に特有のものではありません。新しい生産エージェントを構築または統合する際には、この正しい心理モデルが必要です。ほとんどのチームはエージェントレベルで評価を始め、そこで止まります。しかし、エージェントレベルの品質は、それに依存するツールの質に依存します。そして、マルチエージェントシステムは、どちらのレベルも単独では見ることができない第三の故障面をもたらします。 強固な評価手法は3段階から成り、各段階には独自のゴールドセット、独自の評価者、そして9つの段階を通じた独自の昇進基準が存在する。
エージェント評価フレームワーク:9段階、1つの閉ループ
これら9つの段階は、最初のコミットから実際の製品化までのエージェントのライフサイクルを追跡し、各段階はエージェントが成熟するにつれてチームが直面する問題に答えている。
エージェントのライフサイクルと9つの一般的な質問
各チーム構築製造エージェントは、エージェントが成熟するにつれて以下の問題に直面する:
ステージ1:基礎段階: 「良いとはどのようなものか?」
ステージ2:実験: 「どちらのバージョンが優れているか?」
ステージ3:マージ(CI): 「何か壊れたか?」
ステージ4:ゲート(CD): 「制作に安全か?」
ステージ5:カナリーフレーグ: 「何かが静かに壊れたのか?」
ステージ6:敵対者: 「もし誰かがそれを壊そうとしたらどうなるか?」
ステージ7:ドリフト: 「ライブ中のクオリティはドリフトしているのか?」
ステージ8:パルス: 「今、それが正常に機能しているかどうか、どうやって確認するのか?」
ステージ9:フィードバックループ: 「どのようにして自動的に改善するのか?」
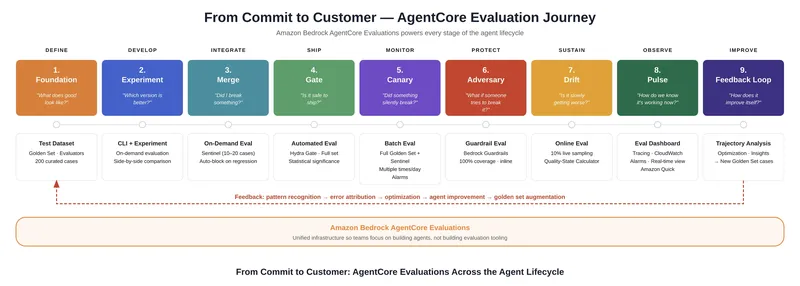
AgentCore Evaluationsを使用して、エージェントのライフサイクルの各段階に対応するフレームワークを構築します。これら9つの段階は、後から結合された別々のツールではありません。それらは単一の連続した評価面上の9つの点であり、図1に示されているように、最初のコミットから production responseまでの全過程においてAgentCore Evaluationsによって動作します。
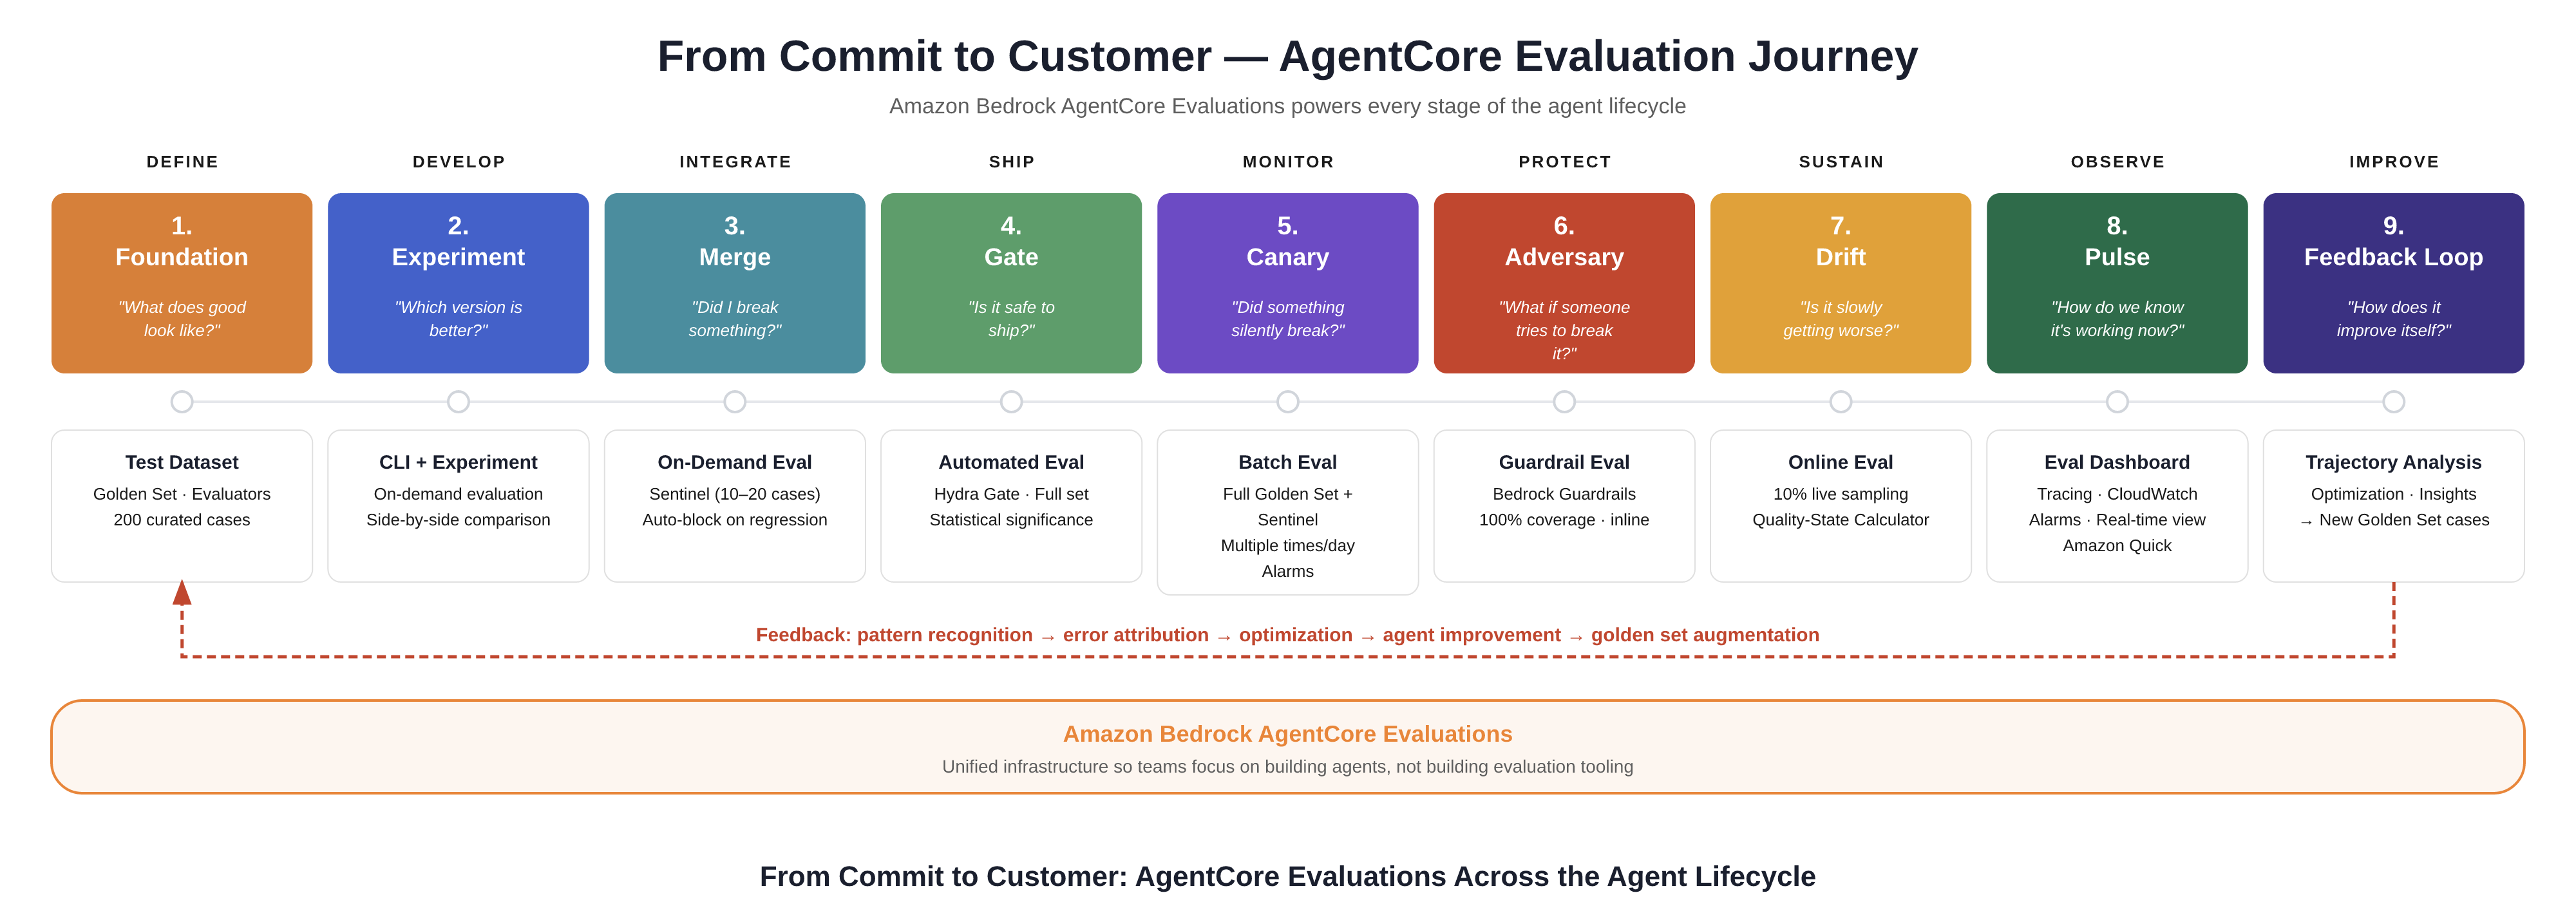
図1:DefineからImproveまでの9段階のAgentCore評価プロセス
私たちが各項目を扱う方法は次の通りです:有効なパターン、その背後にあるAgentCoreサービス、そして図2のシステム設計で示されている、実運用時の様子です。
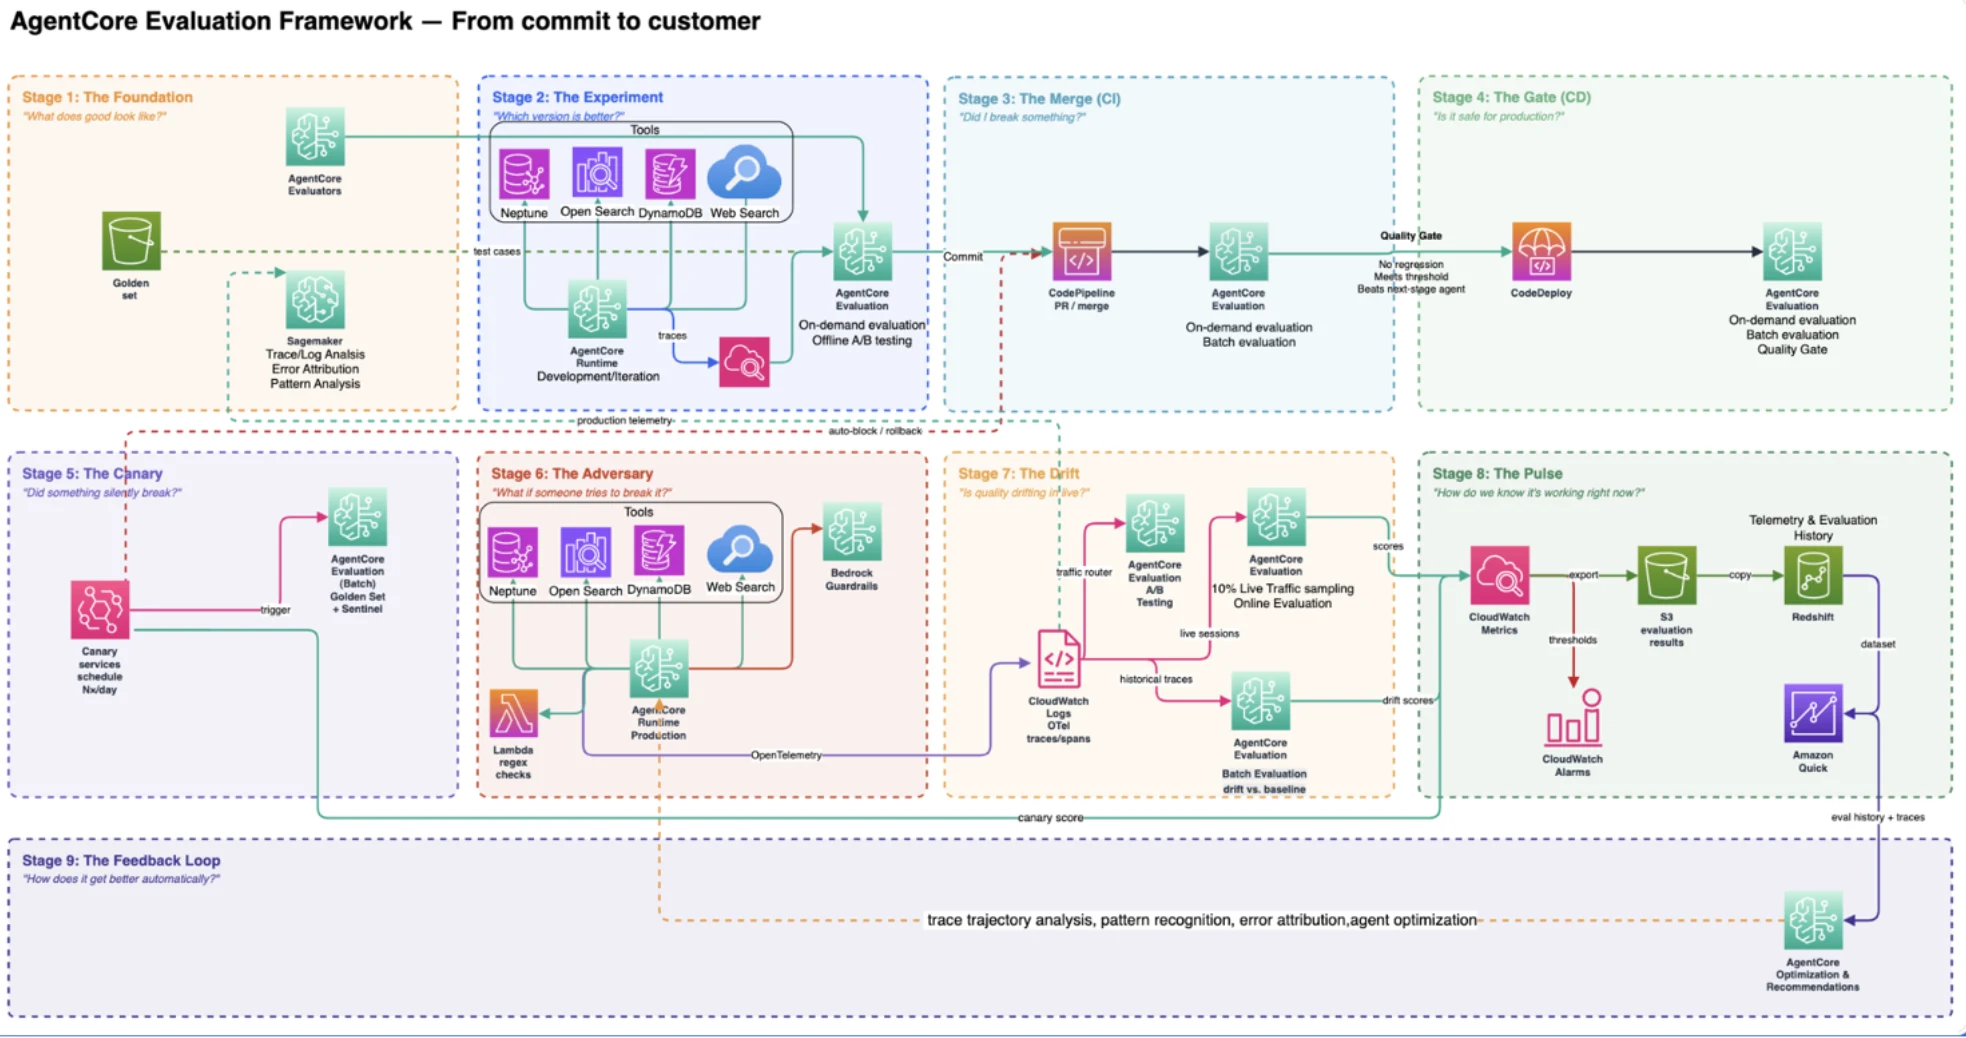
図2:AgentCore評価フレームワークのシステム設計
ステージ1:基礎。品質を定義する
エージェントを評価する基礎は、適切なツールを選ぶことではない。正しい問いを立てることである。すなわち、このエージェントにとって成功とはどのようなものか、そして何が失敗であるかをどう判断するかということだ。その答えはモデルからではなく、顧客から来るべきである。これは反復的なプロセスである。実際にエージェントが実運用中に行うことを観察するにつれて、私たちの成功の定義も明確になってきた。 ここで定義されるすべてのもの(失敗閾値、評価器スタック、ゴールドセット、安全規則、遅延予算、コスト目標)は、後続の各段階が実施する契約です。ステージ1が不明確であれば、下流の各ゲートは推測に頼ることになります。
ステージ1.1:まずビジネス指標を定義する。 エージェントが何を提供するのかを問うことから始めましょう。2つのエンドユーザーパーソンは成功の定義が異なります:
- 販売者にとって成功とは、正確で最新の情報をもち、適切な詳細レベルで、適切なタイミングで顧客との会話に入ることです。
- リーダーシップにおいて、成功とは、長い手作業の準備を必要としない、信頼性の高い週次および事業横断のレビューデータの提供を意味します。これらはモデルの特性ではなく、ビジネスの成果です。
ステージ1.2:それらのビジネス指標を評価指標に翻訳する。各成果に対して、エージェントがそれを提供したことを確認するシグナルを特定する。各シグナルは、明確な閾値とアラーム条件を持つ追跡可能な指標となる。正確なアカウントインテリジェンスはエンティティ解決精度と基礎化率に相当する。売り手の信頼性は誠実さとハルロニング率に相当する。売り手の行動は有用性と範囲遵守度に相当する。リーダーシップレビューの信頼性は精度通過率と応答カバレッジに相当する。この翻訳には5つの次元を含める必要がある:品質閾値と共に、安全ガードレールポリシーを定義し、各ツールおよび各エージェントごとにp50、p90、p99のレイテンシ目標を設定し、クエリあたりのコスト予算を定め、アラームが発火するタイミングとどのRunbookがトリガーされるかを決定するサービスレベル合意書(SLA)を定義する。
正確性の観点から、この解決策は収益決定、更新戦略、経営評価に直接影響を与えるため、要求レベルは高い。自信を持って間違った回答は、販売者の時間を無駄にするだけでなく、実際のビジネス現場での誤った判断につながる。私たちは、実際の生産エラーから派生する6種類の失敗タイプを定義しており、そのいずれかが対応策が不正確であることを示す。
- メトリクス交換:正しい顧客と期間を修正し、間違ったメトリクスが返される。100件の回答ごとに発生数で追跡する。
- 間違った期間の表示:ある時間ウィンドウから得られるデータが別のものとして表示される。例えば、年対年(YoY)の数値が売り手に対して月対月(MoM)として提示されたり、その逆の場合がある。正しいウィンドウを指し示すように%で追跡される。
- 間違ったエンティティ:アカウント名や子会社を混同しています。エンティティ解決精度%で追跡します。
- 純粋な妄想:根拠のない、出所不明の存在。根拠付け率%で追跡される。
- 間違った記号:正しいメートル法、誤った通貨や単位記号。スコープ遵守率%で追跡される。
- 無許可の計算:元データに含まれていない、承認されていない算出値。100回の回答あたりの発生数として記録される。
全体的な正確性合格率が主要な指標です。各次元の追跡が実行可能であるためです。正確性だけでなく、応答の関連性、忠実さ、有益性、指示の遵守、ツール選択の正確性も追跡されます。3つの段落に埋もれた正しい答え、または遅すぎる回答も、売り手にとって失敗となります。
ステージ1.3:それらの指標を反映する評価器スタックを構築する。 どの評価器タイプも可能な様々な故障モードをすべてカバーすることはできない。私たちは4種類を組み合わせる:
- AgentCore内蔵の評価器により、幅広い基準をカバーします。関連性、忠実性、有用性は、AgentCore Evaluationsに自然に搭載されている評価テンプレートと直接対応します。
- カスタマイズされた評価器、私たちの分類体系における各失敗タイプごとに1つずつ:メトリクスの交換評価器、間違った期間評価器、間違った顧客評価器、純粋な妄想評価器、間違った記号評価器、および無許可の計算評価器。これら6つはいずれもネイティブテンプレートには含まれていない。これらはAgentCoreフレームワーク上に構築されたドメイン固有のシグナルである。ネイティブテンプレートがすでにカバーしているメトリクスと、カスタマイズされた評価器が必要なものを事前に知ることは、設計決定の一部である。
- 第三者評価者については、DeepEvalとAutoEvalという第三者のオープンソースライブラリから管理される評価者を導入しました。
- 決定論的評価器は、収益、更新日、契約状況など、正しい答えが正確に知られている基準検査用です。
推論の質と有用性に正解が一つない場合は、関連性、忠実性、有用性に関する内包された評価基準を用いるLLM-as-judgeのルーチンを使用し、完全にカスタマイズ可能なルーチンもサポートする。AgentCore Evaluationsは、基本真理とLLM-as-judge評価の両方をネイティブで提供しており、これにより私たちは自らスコアリングエンジンを構築することなく、両方の評価手法を実行できる。Deterministicは事実に関する精度を提供し、LLM-as-judgeは推論に関する幅広さを提供する。
ステージ1.4:評価指標を確認するためのゴールドセットを構築する。 ツールレベルでは、各重要なツールには独自の決定論的な正解ペアがあります。顧客識別は正確な標準エンティティに到達するか、失敗します。エージェントレベルでは、実際のユーザークエリに関するトピック分析により、4種類の質問タイプ(包括的、報告、推論、曖昧)に関するデータセットが生成され、それぞれ異なる評価戦略が必要となり、毎月再検討されます。マルチエージェントレベルでは、エージェント間の相互作用時にのみ発生するエラーをエンドツーエンドのオーケストレーションシナリオで捕捉します。ゴールドセットは品質の高いデータセットに過ぎません。安全テストケース、遅延ベンチマークケース、コスト参照ケースも含まれており、ステージ3および4では同じカスタムメイドのデータセットを用いて5つの次元をチェックすることができます。
ゴールドセットは、3つの情報源から構成される生きた文書である。制作過程で発生したケースは、ステージ7で推進された低得点のライブセッションを含む、実際の販売者やリーダーシップに関する問い合わせからサンプルされたものである。失敗によるケースは、ステージングまたは制作中に発生したすべての回帰から得られたもので、ステージ3で推進されたセンチネルケースやステージ9で推進された永久的な回帰ガードを含む。 合成的なエッジケースは、実際の環境で遭遇する可能性があるが、まだ遭遇できるとは限らないシナリオを保証するために意図的に構築されています。例えば、上記の4種類の質問タイプや、ステージ4における親子関係やティッカーシンボルの解釈に関するケースなどです。このセットはバージョン管理されており、レビューが行われ、3つのソースを通じて継続的に拡張されています。
ステージ2:実験。どのバージョンが勝つかを知る
すべての変更(プロンプトの更新、新しいツール、モデルのアップグレード、データセットのリフレッシュ)は同じ疑問を提起する:このバージョンは本当に優れているのか? 世界的規模でAWS分野をサービスしているシステムにおいて、直感だけでは答えとしては不適切である。
変更が統合される前に、AgentCore On-Demand Evaluationを実行し、同じ評価ツール群を用いた同じゴールドセットでスコアを算出します。開発チームは品質、遅延、コストの指標やコンテキストトークンを利用して、下流での比較を選定し、図3に示すように5つの次元を同時に評価します。正確性が5%向上するが、遅延が2倍になり、コストが3倍になるモデルは、自動的に勝利するわけではありません。
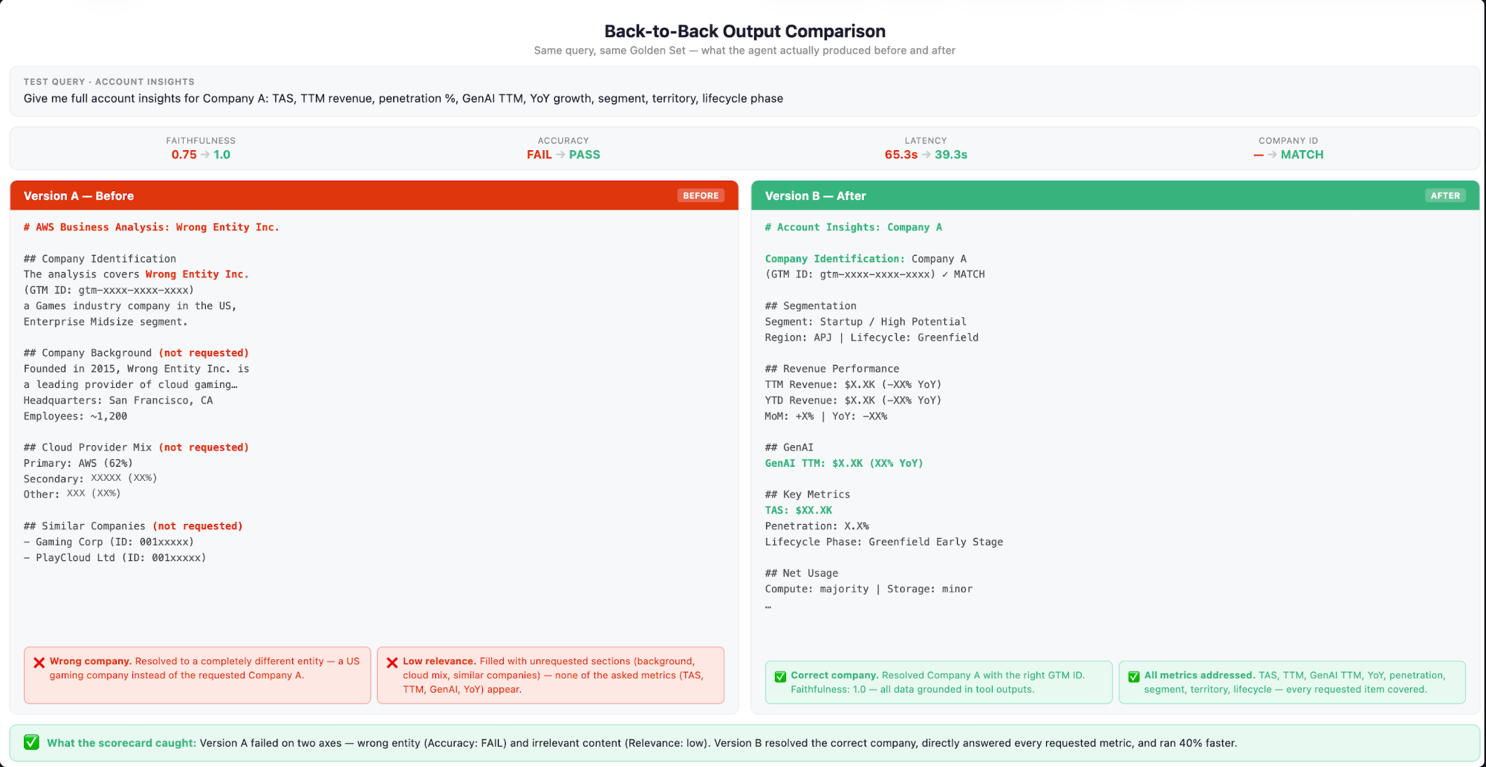
図3:AgentCore On-Demand評価において、品質、レイテンシ、コストの観点から、2つの候補エージェント応答の比較。図中の数値と値は例示目的のものです。
私たちは品質を包括的なスコアカードとして追跡します。単一の数値ではありません。単なる合格率だけでは不十分です。各評価実行時には、我々の分類体系内のすべての失敗カテゴリーについて詳細な分析が行われます。品質が改善されたかどうかだけでなく、どこで、なぜそうなったかも、図4のスコアカードに記録されます。各評価は完全に記録されています。入力、出力、取得されたコンテキスト、スコア、評価理由がS3と我々のデータ湖に保存され、根本的な原因をたどる持続的な可視性層が得られます。つまり、エージェントが何を見たか、何を生成したか、なぜ間違ったかを追跡できるのです。3ヶ月にわたる集中的な反復実行の結果、このスコアカードにより合格率は93%から安定した96%に達しました。純粋な幻覚は10,000回の応答あたり138件から52件以下に減少し、無許可の計算は59件から44件以下に減少しました。これにより、取得された情報が正確であり、改善は生成過程の修正によるものであることが確認されました。カテゴリー別の詳細な分析やその背後にある詳細なトレースデータがなければ、私たちは目立たないまま反復実行を行っていただろう。
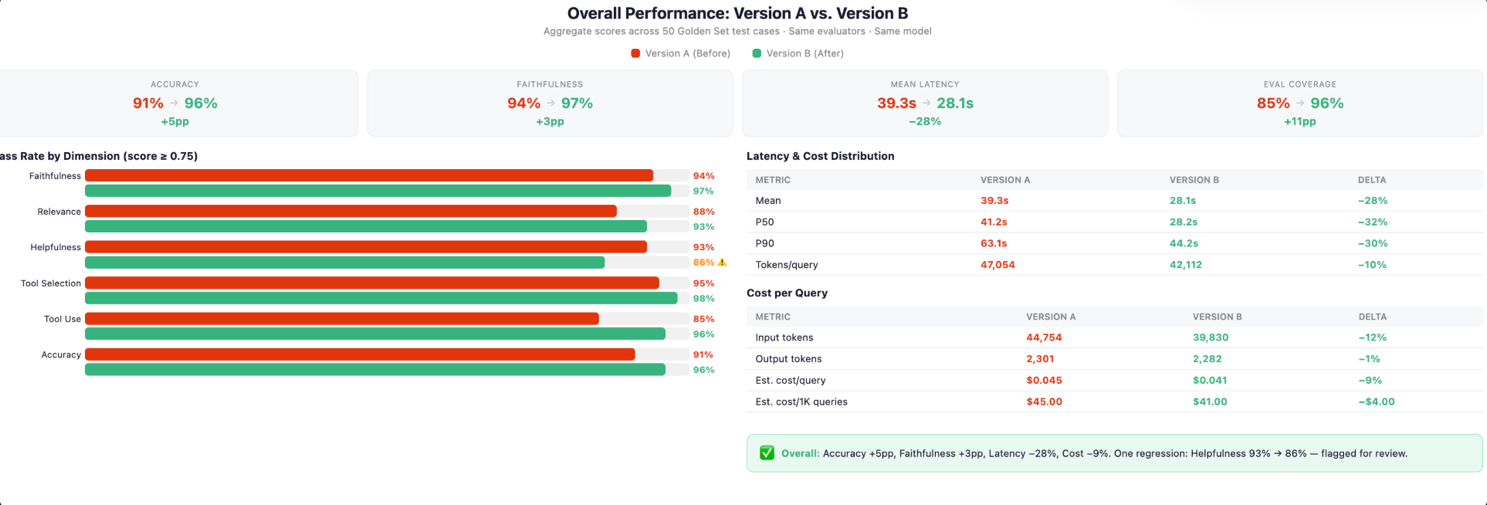
図4:カテゴリー別失敗数と合格率の推移を示す評価スコアカード。図中の数字と値は例示目的である。
ステージ3:マージ(CI)。マージ時の再帰行を防ぐ
ステージ3はプレプロダクションの段階です。コードや設定の変更によって起動されるステージング環境で動作し、生産環境に到達する前に悪い変更を阻止する役割を果たします。ステージ3が再発を検知した場合、何もリリースされません。
エンジニアや科学者は、プロンプト、基礎データ、ツール、モデルなど、多くの方法でシステムを変更します。局部では変化が明確で、テストも通過するものの、技術アカウント向けの応答を改善するプロンプトは、金融サービスアカウント向けの応答を静かに悪化させる可能性があります。自動化されたゲートがない場合、このような状況になります。
AgentCore On-Demand Evaluationを使用して、各ステージングデプロイ時にCI評価が自動的に実行されます。エンジニアは評価を実行することを覚えておく必要はありません。どのデプロイも無意識にゲートを通過することはありません。評価は完全なゴールドセットではなく、センチネルセットのみを評価するため、数分で完了します。スピードは意図的なものです。センチネルはすべてのデプロイで実行可能なほど狭いが、最も重要な失敗を発見できるほど代表性があります。
センチネルセットは、5つの次元において最もリスクの高いシナリオを選定したものです。許容範囲を超える品質の低下は導入を阻害します。安全境界の違反も同じように厳重に阻止されます。p90遅延を2倍にする変更は、意図的な決定なしには進行できません。トークンコストの急上昇は、規模が大きくなる前に警告されます。 各センチネル実行後、品質スコア、レイテンシー、クエリあたりのコスト、安全通過率と共に、CloudWatchにカスタムメトリクスとしてスコアが公開されます。また、任意のメトリクスがステージ1の閾値を超えた場合にCloudWatchアラームが発動します。各実行も記録され保存され、アウトチェックトレイルに利用されます。ステージ8およびステージ9はこのアウトチェックトレイルに依存しています。私たちは、ツール、エージェント、マルチエージェントの各レベルにおいて、別々のセンチネルを維持しています。 エージェントレベルの品質を向上させる変化があるものの、重要なツールの品質が低下するという問題は依然として存在します。センチネルは毎月レビューされ、生産に投入されるような再発があった場合は、即座に恒久的なケースに移行され、ユーザーに二度も影響を与えないようになります。
これが対処する内容の一例です。データ正常化の更新後、明確化ツールがアカウント名のフォーマットの一部に対して未解決エンティティを返し始めました。エージェントは未解決エンティティを受け取った後、最善の推測結果を返し、間違った顧客に対して実際のデータを提供してしまいました。私たちのツールレベルのセンデンには、このようなエッジケースが正確に含まれています。影響を受けたアカウント名のフォーマットについて、エンティティ解決の基準真実チェックが失敗し、デプロイは自動的にブロックされました。この変更は生産環境には届きませんでした。
ステージ4:ゲート(CD)。定量的な自信を持って船を進める
センタントは15のケースをカバーします。生産は、数百のアカウントタイプ、地理、販売者セグメントにわたる数万のクエリパターンを扱います。センタントの処理は必要ですが、それだけでは不十分です。
候補者がリリースされる前に、評価器の各次元において完全なゴールドセットに対してAgentCore On-Demand Evaluationを実行します。これをQuality Gateと呼びます。これにより、「問題ないようだ」という感覚的な判断に代わって、定量的なリリース決定が行われます。
サンドボックス実行とツールモック化。これはライブコールではなく、再現実験であると考えてください。事前に、正しいツールの動作を反映したバージョン化されたデータセットを固定します。エージェントがゲート中に行うすべてのツール呼び出しは、実際のシステムではなく、その固定されたデータセットから処理されます。この固定されたデータセットは2段階で構築されます。まず、各ツールを単独でテストします。ゴールドセットから適切な答えが既知の入力を送信し、実際に返される結果とその既知の答えを比較してスコアを計算します。これにより、エージェントが関与する前に、ツール自体が機能しているかどうか(エンティティ解決、検索、SQL生成)がわかります。次に、ツールの応答が正しいと確認された後、その検証済み答えをエージェントがゲート評価中に見る再現データセットに固定します。これにより、エージェントはツールの速度や可用性ではなく、単に自身の推論能力のみでテストされることになります。また、すべての候補者が同じ固定されたデータセットから再現実験を行うため、対戦時のスコアの差はツールのばらつきではなく、エージェント自身によるものです。
集計されたエンドツーエンドのスコアリング。 ゲートでは、候補者エージェントが200問の問題をエンドツーエンドで解答し、LLMによる評価基準に基づいて全ての評価要素でスコアが計算される holistic passも実施される。3つの条件のいずれかが発生すると自動的にゲートが閉じる:集計スコアが候補者自身の以前の成績と比較して低下した場合、現在の生産基準を超えられなかった場合、または200問中定められた割合以上の問いが各問いごとの閾値を下回った場合である。候補者はこれら3つすべてをクリアしなければならず、これにより単純な平均値では見逃されるものが明らかになる:平均値は上がっているものの、個々の問いの多くで失敗しているモデルは合格とはならない。
これが検出する例の一つです。 ここでは、エージェント自身の推論をモッキングすることが行われており、その下にあるツールだけでなくです。私たちのゴールドセットには階層不一致のケースが含まれています。顧客洞察エージェントとデータ洞察エージェントは、同じ顧客に対して異なる、個別に正しい収益数値を返します。一方は親アカウントを対象とし、もう一方は子会社を対象としています。どちらの数値も間違っていません。このケースでは、エージェントがクエリのセマンティクスやリクエスターの人物像から正しい範囲を推測するかどうかがテストされています。デフォルトで平均化したり、売り手に曖昧さを解消させるよう求めたりするのではなくです。候補者は失敗し、子会社対象の質問に対して親レベルの数値を返しました。このケースのゴールドセットのグロウトランスは、質問がどの範囲を期待しているかを指定しています。そのため、クオリティゲートは即座に不一致をフラグ付けしました。間違った数値ではなく、間違った範囲に対する正しい数値です。
ステージ5:カナリー。デプロイ後の静かな失敗を検出する
ステージ5はポストプロダクション監視です。これは生産環境内で継続的に稼働し、ライブトラフィックや合成評価ケースに対応します。その役割は、コード変更を介さずに発生した問題を発見することであり、ステージ3ではそれを見逃していました。ステージ3はエンジニアが変更するものから守るものです。 ステージ5では、アップストリームデータの変化、モデルの動作の変化、サードパーティ依存関係の変更、または実世界の負荷下でのみ現れる遅延の増加やトラフィックパターンの変化といった、他のすべての要因から守られる。
製品は、数千もの上流スキーマとデータパイプラインによって供給されるデータストアに対して動作する。特定の日には、これらのパイプラインの数十がデプロイやCIゲートを引き起こすことなく更新される。エージェントコードは変わらず、モデルも変わらないが、それが分析するデータが変わり、その結果として品質が静かに低下する可能性がある。 私たちは厳しい経験をした。スキーマの変更によりアップストリームパイプラインが更新され、エージェントが間違った時間帯のデータを参照し始め、最初のシグナルは自動化されたアラートではなく売り手からの問い合わせとして届いた。そのため、ステージ5では30分の評価ウィンドウ内にこの問題を発見する方法を採用している。
私たちは2つの異なるスケジュールでAgentCore Batch Evaluationを実行しており、その頻度の選択は意図的なものです。
両方の観点から学んだ後、30分間のサイクルに決定しました。15分間では誤報警が多すぎるため、60分間では実際の劣化が確認される前に2時間が経過します。各30分間のサイクルを評価ウィンドウと呼びます。30分間で90分以内(3つの連続したウィンドウ)に実際のトレンドを捉え、単一のクエリによるノイズを除去します。各ウィンドウではゴールドセット全体に対してラウンドロビン方式でスコアを付け、24時間以内に完全なカバーを実現します。
閾値はCI/CDゲートよりも意図的に低く設定されています。1回のウィンドウ障害はインシデントではなく、オペレーションのシグナルです。連続3回のウィンドウが閾値を超えた後にのみ、オンコールを呼び出します。このルールを厳しい方法で学んだ:最初の月には1回のウィンドウの閾値を使用し、オンコールはシステムを完全に信頼することをやめました。1日1回、完全なゴールドセットがゲートの閾値で実行され、権威ある日次スコアカードとなります。30分間のウィンドウがトレンドを明らかにします。日次実行がそれを確認し、チケットを削除します。
各実行はCloudWatchにデータを公開する(正確性、誤謬率、基盤構築率、遅延、コスト)。アラームロジックにより、2つのパターンを区別する。カナリー実行は3つのレベルで行われる:ツールレベルのスコアは、エージェントレベルの応答が破損する前に、検索ツールの劣化を示す。
これが発見したもののもう一つの例です。 アップストリームインデックスの更新後、検索ツールはクエリに対応するために必要な正確なコンテキストではなく、あいまいな関連部分のみを返し始めました。レイテンシーは許容範囲内で、エラー率はゼロでした。エージェントは弱い根拠のあるコンテキストを論理的に分析することで流暢で自信に満ちた応答を生成し続け、正しいように見える答えを出しながらも誤った数値を引用していました。インフラ警報は発せられませんでした。キャナリーは最初の30分間のウィンドウ内にそれを発見しました。ツールレベルのセンチネル全体で根拠度と検索精度が低下し、売り手が劣化した答えに対応する前にCloudWatch警報が発せられました。低い評価スコアは正確なトレースを特定しました。そこから、当直エンジニアはAgentCoreでそのトレースを開き、数分以内に劣化したコンテキストを検索ツールにたどり着けました。
ステージ6:敵対者。不正使用から守る
すべての悪い出力が劣化したモデルから来るわけではない。無許可のアカウントデータを抽出するためのクエリや、取得された文書に埋め込まれたプロンプトインジェクションは、敏感なビジネスデータを何千ものユーザーが利用するシステムにおいて予測可能なパターンである。
安全は一つのステージではありません。9つのステージ全体にわたって実施されます。私たちは、すべての相互作用において2箇所でAmazon Bedrock Guardrailsを適用します。入力時にはクエリの範囲を検証し、プロンプトインジェクションをチェックします。出力時には、機密データが未承認のユーザーに公開されないこと、そしてエージェントがポリシー違反に変更されていないことを確認します。これらのチェックは、応答がユーザーに到達する前に、100%のトラフィックに対して同期して実行されます。
2つのガードレール層を設定し、それぞれが異なる脅威クラスをカバーします:
コンテンツフィルターは、入力および出力の両方における有害または不適切なコンテンツを検出し、ブロックします。私たちはVIOLENCE、HATE、SEXUAL、MISCONDUCT、INSULTSなど、さまざまなカテゴリーにわたってフィルターを適用します。これらのフィルターが作動するリクエストや応答は、売主に到達する前やユーザーに表示される前にブロックされます。
プロンプトセキュリティフィルターは、単一のPROMPT_ATTACKガードレールカテゴリーの下でエージェントを敵対的な操作から保護し、JAILBREAK(エージェントのシステム指示を無効化したり、運用境界を突破する試み)、PROMPT_INJECTION(取得した文書、ツールの出力、またはユーザーのクエリに意図しない指示が埋め込まれること)、PROMPT_LEAKAGE(システムプロンプトや内部設定を抽出する試み)の3つのサブタイプを含む。 Retrieval Augmented Generation(RAG)を使用するマルチエージェントシステムでは、取得したコンテンツを通じたプロンプト注入が実際のリスクとなる。売り手のアカウントデータに含まれる意図しない文書が、エージェントの推理中の行動を変更しようとする可能性がある。
安全規則はステージ1で定義され、ステージ3と4で再発をチェックし、生産中には継続的に実施される。
ステージ7:ドリフト。品質を維持し、ライブトラフィックで検証する
品質は複数の方向から低下します:アップストリームデータが変更されてもデプロイが起こらず、モデルが古くなり、ユーザーが金額設定を完全に予測できないクエリで限界を押し広げます。ステージ7は売り手が気づく前にそれを検出し、完全な展開前に実際のユーザートラフィックに対して候補を検証します。
ドリフト検出。 AgentCore Online Evaluationを使用して、ステージ1で定義された異なる評価器を通じて、実際のトラフィックの10%を継続的にサンプルします。その結果、オフラインで確立されたベースラインからの逸脱として、ドリフトが即座に明らかになります。スコアは、品質・状態計算器に送られ、同じウィンドウ内で品質、レイテンシ、コストを監視します。
ある実装例です。顧客識別用のゴールドセットは、名前の変形、子会社の照会、略語といった合成ケースから構築されました。オフラインでは良好な性能を示しました。しかし、リアルタイムトラフィックでは、売り手が株価指数記号(“AMZNはどうなっているのか?”)、短縮名、タイプミスなどで合成ケースが適用できなくなりました。Quality-State Calculatorは、3つの連続する30分間のウィンドウにおいて、98%が1:30am、81%が2:00am、80%が2:30amという変化を明らかにしました。Rolling thresholdを超えたとき、CloudWatchはオンコールを発令しました。オンコールエンジニアはエージェントに次のように尋ねました:「1時から3時の間に顧客識別精度に何が起こったのか?」すると、株価指数記号の照会と短縮名が障害要因であることが分かったトレンド概要が返されました。エージェントのトレースにより、根本的な原因がすぐに明らかになりました。修正方法は、低スコアのリアルタイムセッションをゴールドセットに追加し、解決前に入力形式を標準化するディスアンビゲーションツールを更新することでした。次の評価サイクルでは、精度がベースラインに回復しました。
ライブトラフィックは2つの連続的な改善ループを生み出す:低スコアのセッションは新しいエッジケースとしてゴールドセットに推奨され、低スコアのトレースクラスターはプロンプトの修正、ツールの更新、ルーティングの調整に役立つ。
A/Bテスト:候補エージェントが品質ゲートを通過した後、Amazon Bedrock AgentCoreの機能であるAgentCore Gatewayは、現在のエージェントと候補エージェント間で実際のトラフィックを配分します。オンデマンドでは既知のケースにおける再帰化がないことを確認し、オンラインでは長尾入力や新規フレーズに対して有効であることを確認します。完全な導入前に、候補エージェントはすべての評価指標において勝つか引き分けなければなりません。
ステージ8:パルス。リアルタイムの品質可視性
エージェントへの単一の呼び出しが、3つのサブエージェント、5つのツール、2つの検索経路に影響を与える可能性があります。品質アラームが発火すると、「エージェントパイプライン内の何か」は実行手順ではありません。ステージ8では、ステージ5、6、7からのシグナルが、行動可能な十分な解像度を持つ可観測性層に集約されます。
Amazon Bedrock AgentCoreの機能であるAgentCore Observabilityが、その基盤となっています。 AgentCore実行環境上でホストされるエージェントについては、Amazon Bedrock AgentCoreの機能により、各実行がOpenTelemetryを通じて自動的にインスツルメンテッドされます。これにより、各推論ステップに関する構造化されたテレメトリが生成され、ツールの呼び出し、注文、入力と出力、遅延、トークン消費が含まれます。これらはCloudWatch Transaction Searchが有効になった後(一度限りの設定ステップ)、カスタムメトリクスおよびログとして直接CloudWatchに公開されます。 評価スコアは別のパイプラインです。これらは実行インスツルメンテーションからではなく、評価設定から来ており、独自のCloudWatchロググループに記録されます。各評価実行では、完全な出力データがS3と私たちのデータ湖に保存され、2つのダッシュボードに提供されます。
- 評価と可観測性の結果を照会するための対話型ダッシュボード。
- 全歴史データを通じて、トレンド分析、スコアカードの追跡、および異なるエージェント間の比較を行うためのAmazon Quickダッシュボード。
適切なロールに応じたビューが上に表示される。Oncallエンジニアはトレース先先のビューを得る:CloudWatchアラームからAgentCore Observabilityトレースまで、ワンクリックでそのトレースを確認できる。このトレースでは、各ツールが呼び出された順序、ステップごとの遅延時間、トークン消費量、コスト、そして全体的な推論内容が表示される。図5に示されているように、「アラームが発火」から「根本的な原因が特定される」までの間、第二のツールを開かずに必要なすべてが得られる。
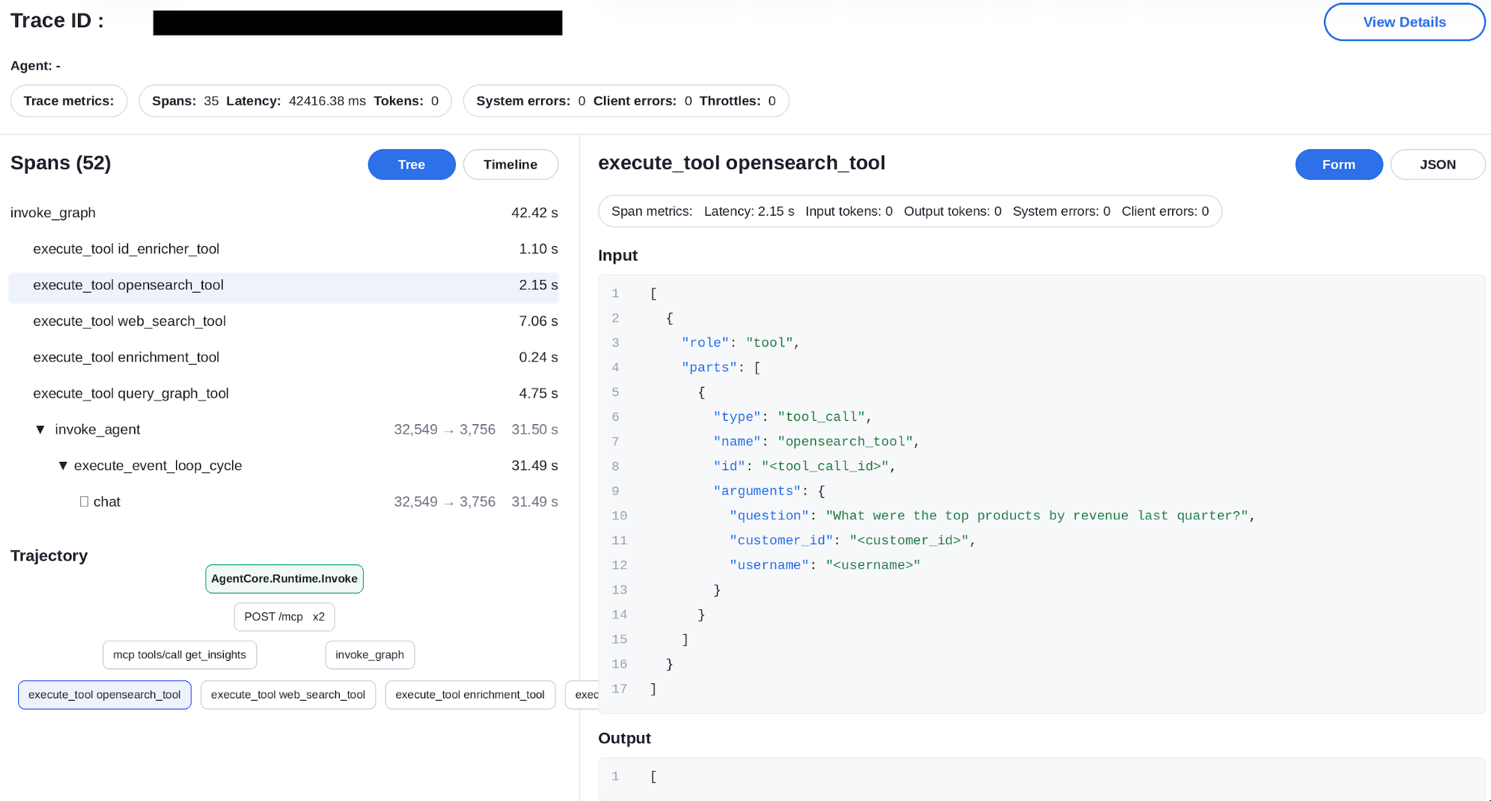
図5:顧客洞察エージェントのAgentCore実行トレース図で、スパンツリー、軌道、およびスパンレベルのメトリクスが表示されています。図中の数値と値は説明目的に過ぎません。
プロダクトマネージャーはAmazon Quickトレンドダッシュボードを利用できる。これにはサブエージェントや機能による品質スコア、リリースごとの比較が含まれる。リーダーには、週次および複数部門のレビューに沿った5つの側面すべてを踏まえた1ページの健康状況要約が提供される。これは1分間で実行できるチェックであり、「エージェントのパフォーマンスはどうか?」という問いに答えるものである。
図6は、私たちの週間評価ダッシュボードのトップレベル表示です。これには、カスタム評価者とAgentCore内蔵評価者から得られた合計通過率と、ラティネーションが含まれています。図中の数値は例示目的のものです。
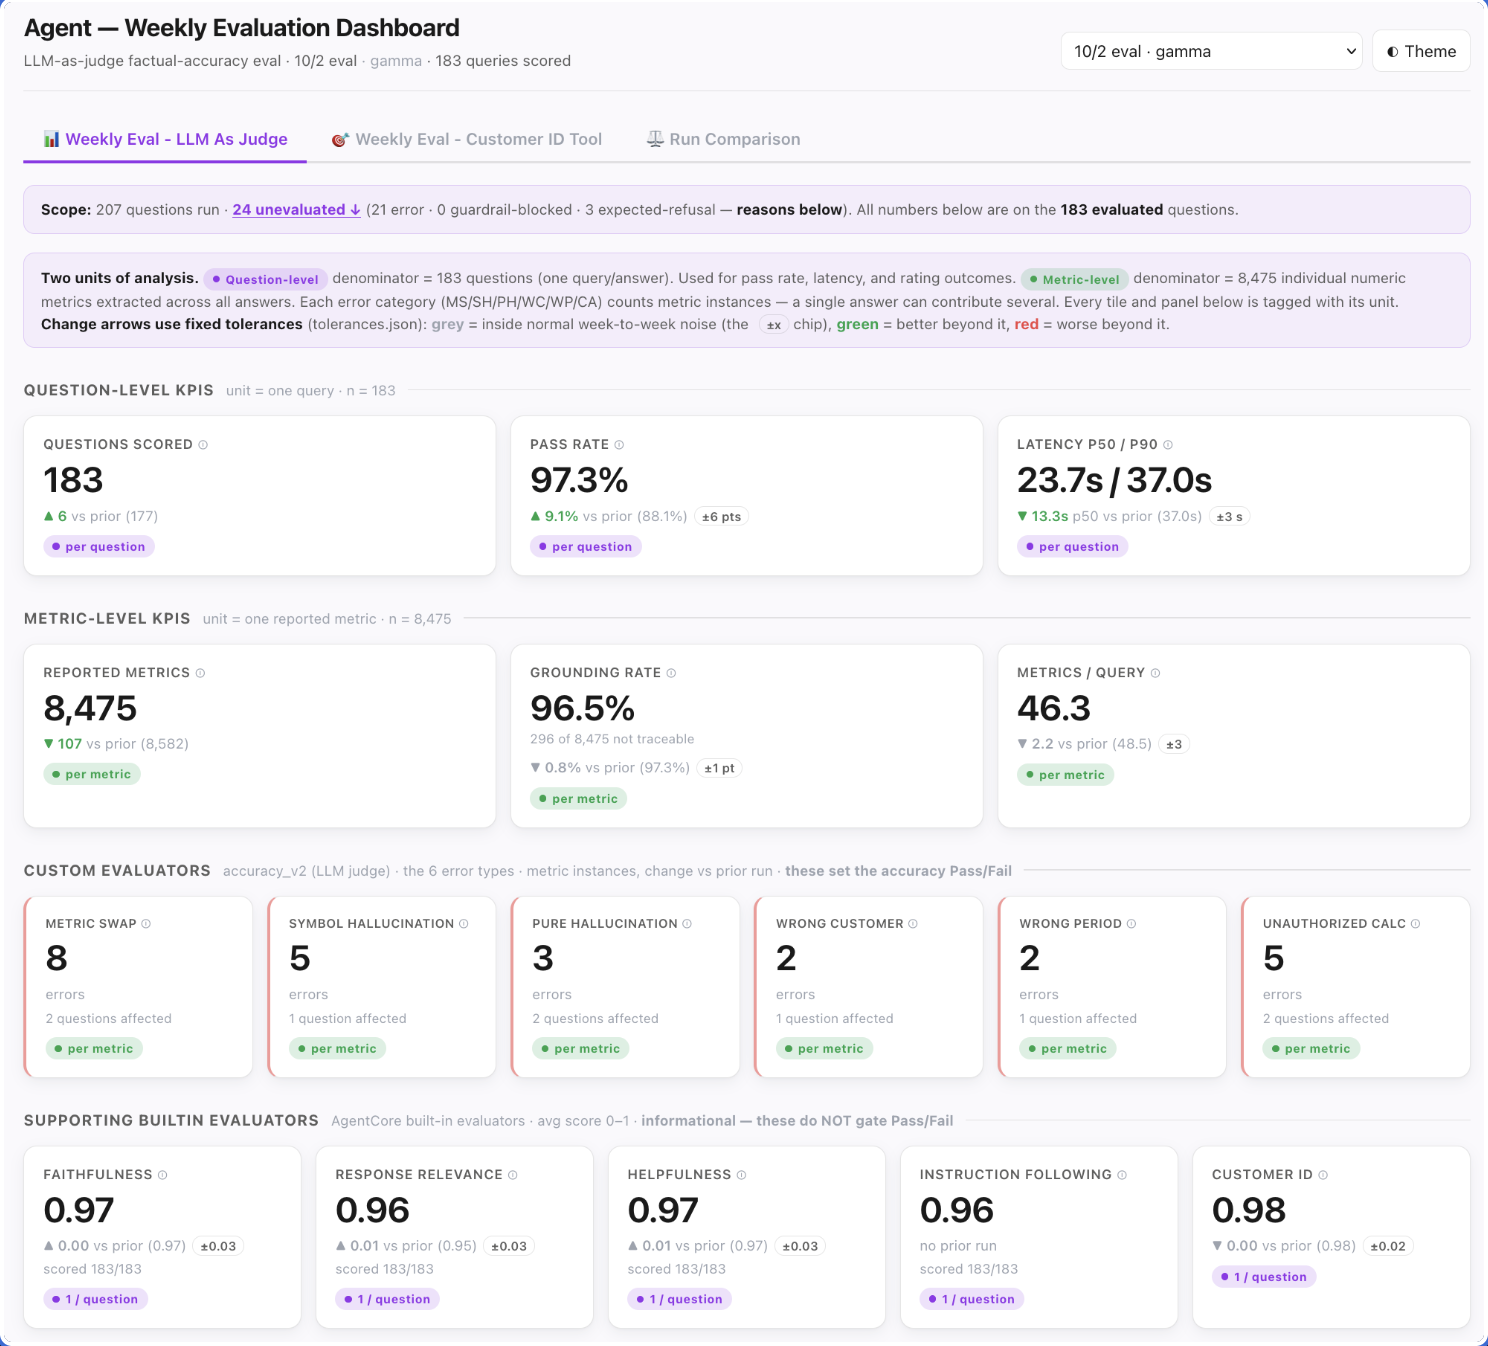
図6:組み合わせた合格率とレイテンシーを表示したトップライン週間評価ダッシュボード。図中の数値は例示目的である。
図7は、カスタム評価器の同じ走行レベルにおける故障カテゴリーレベルを詳細に調査し、どの種類のエラー(メトリクスの交換、幻覚、顧客IDの見落としなど)がギャップを生み出しており、それぞれがどれだけの問題に影響するかを正確に示している。図中の数値と値は例示目的である。
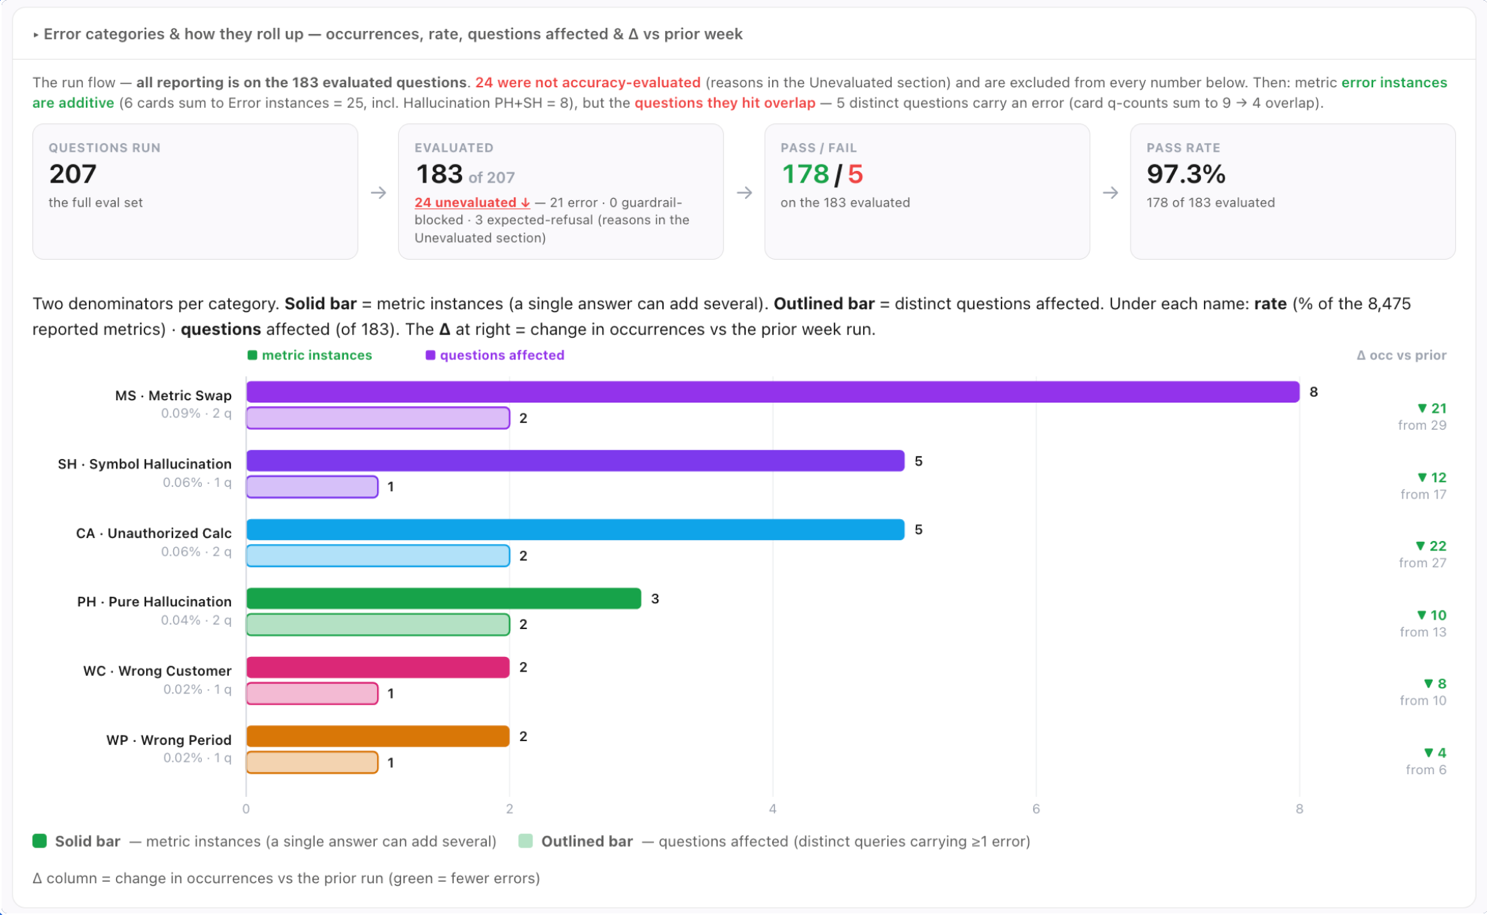
図7:カテゴリー別の障害を分析する週間エラーレポートダッシュボード。図中の数値と値は例示目的である。
ステージ8前では、検出にかかる平均時間(MTTD)は数日から数週間でした。ステージ8以降では4時間未満になり、最初のシグナルはAgentCoreトレースが付随されたCloudWatchアラームとなります。
ステージ9:フィードバックループ。継続的な改善
この段階では、観察結果を実行に移します。システムは時間をかけて品質を向上させます。私たちはAmazon Bedrock AgentCoreの機能であるAgentCore最適化を利用して、循環を完結させます。
- システムプロンプト推奨:エージェントのトレースを分析し、目標評価器での性能を向上させる、データ駆動型の最適化されたシステムプロンプトを生成する。この解決策では、失敗パターンを利用し、具体的な行動指示を追加する。
- ツール説明の推奨案:エージェントのトレースを分析し、ツール選択の混乱を減らす精緻化されたツール説明を生成する。特に、曖昧な要求に対してエージェントが間違ったツールを選択する場合に有効である。
例を見てみましょう:
エージェントコア最適化が実行中
改善すべき点:
ターゲット評価器: hallucination:少数例例文からハードコーディングされた値を無関係な文脈でそのまま再現するモデル。なぜこのようなことが起こるのか:Few-shot例には実際の金額や顧客名(例えば「$4.2M」、「Acme Corp」)が含まれており、モデルはそれらを記憶し、無関係なクエリに漏洩してしまう。
修正方法:少数例の例で定義されたハードコーディングされた値を、一般的なプレースホルダーに置き換えます(例:
$[AMOUNT]、[CUSTOMER_NAME])。これにより、モデルは特定のデータポイントを記憶することなく、応答の構造を学習することができます。影響と結果:修正が実施されました。10,000回の応答中に発生する純粋な妄想は138件から52件以下に減少し、全体的な正確性率は93%から96%に向上しました。
AgentCore最適化は、実際のエージェントのトレースと目標評価器に基づいて、データ駆動型システムプロンプトやツール説明を生成するための推奨事項を使用します。AgentCore最適化はAgentCore評価に基づいて構築されます。低スコアのトレースは、永続的な回帰保護としてゴールドセットに移され、各失敗がユーザーに二度も影響を与えないようになります。
エージェント評価の重要指標一覧
評価指標はステージ1で定義され、9つのステージ全体に適用され、製品開発中に継続的に監視されます。このセットは静的なものではありません。製品開発中のエージェントから学ぶことで、新たな障害パターンが明らかになり、新しい側面が測定可能になり、指標もそれに応じて進化します。以下は、私たちがどこから始めたか、そして今日何を追跡しているかです。
| レベル | メトリクス | 測定対象 | 追跡されている |
| 品質:エージェント | 全体的な正確性通過率 | 分類失敗がない回答の割合 | ヘッドラインのスコアカード指標 |
| 品質:エージェント | メートル法交換レート | 顧客と期間が正しいのに、間違ったメートル単位が返される | 100件の回答あたりの出現回数 |
| 品質:エージェント | 間違った期間率 | 間違った時間帯のデータ | % 正しい時間帯を引用 |
| 品質:エージェント | 間違った顧客率 | 混在したアカウント名または子会社 | エンティティ解決精度% |
| 品質:エージェント | 接地率 | 取得した情報源に基づく図表 | 報告された数値の%が根拠がある |
| 品質:エージェント | 範囲遵守率 | 質問された内容に対応する回答 | %トピックに関連する回答 |
| 品質:エージェント | 無許可の計算率 | 許可なく派生した図形 | 100件の回答あたりの出現回数 |
| 品質:エージェント | 関連性/忠実性/有用性 | AgentCore内蔵の指標による応答品質 | エージェントコア内蔵評価器スコア(0~1) |
| 品質:ツール | 顧客識別の正確性 | ツールが正確な正典エンティティに到達する | %正確な解像度(決定的) |
| 品質:ツール | ツール選択の正確性 | エージェントがクエリに合ったツールを選択する | エージェントコア内蔵評価器スコア(0~1) |
| 品質:ツール | 取得精度 | 取得されたコンテキストには、必要な情報が含まれています | % 関連するコンテキストを持つ検索 |
| 品質:ツール | SQL生成の正確性 | Data Insights Agentが正しいSQLを生成する | % 正しい結果セット(決定的) |
| 品質:ツール | ツール通過率 | 有効な応答を返すツール呼び出しの割合 | % 各ツールでの成功率 |
| 品質:マルチエージェント | エンドツーエンド精度通過率 | 完全なオーケストレーションパスが正しい応答を生成する | すべての評価者を通過したシナリオの割合 |
| 品質:マルチエージェント | ルーティング精度 | オーケストレーターのルートが正しいサブエージェントへ | %正確なルーティング(決定的) |
| 品質:マルチエージェント | 合成の忠実性 | サブエージェントは歪みなきままに組み合わせて出力する | エージェントの境界を超えたLLM裁判官スコア |
| 品質:マルチエージェント | コンテキスト伝播精度 | エージェント間で渡されるコンテキストは正確で完全です | % 文脈の損失なき痕跡 |
| 安全 | ガードレールブロックレート | 入力または出力でブロックされたリクエストの% | 1,000回のリクエストあたり |
| 安全 | 入力/出力違反率 | ポリシー違反とマークされたクエリまたは応答の割合 | 総リクエスト/レスポンスの% |
| 安全 | ガードレールの遅延 | ガードレールチェックによって追加されるレイテンシのオーバーヘッド | p99(目標:50ms以下) |
| パフォーマンス | エンドツーエンドの遅延 | 問い合わせが受信され、応答が送信された | p50, p90, p99 |
| パフォーマンス | サブエージェント/ツールのレイテンシ | サブエージェントごと、ツール実行ごと | p50、p90、p99は独立して |
| パフォーマンス | レイテンシー回復率 | ステージ1の遅延閾値を超えるCI実行 | CI実行の% |
| コスト | クエリあたりのコスト | エンドツーエンドのユーザーリクエストあたりのトークンコスト合計 | 入力+出力トークン × 価格 |
| コスト | 成功した応答あたりのコスト | クエリあたりのコストを通過率で割る | 高額な失敗を罰する |
| コスト | クエリあたりの平均ツール呼び出し数 | 推論効率。呼び出し数の増加は性能低下を示す | 平均1クエリあたり |
| Ops制御 | MTTD / MTTR | 障害クラスに応じて検出し、修正する時が来た | 時間(MTTD目標:4時間以下) |
| Ops制御 | 自動化検出率 | 評価によって検出された事件と、ユーザーの苦情との比較 | % (目標:95%以上) |
| Ops制御 | アラームの誤検出率 | 実際の劣化に応じないアラーム | 全アラームの% |
結論
9段階のエージェント評価フレームワークの影響は具体的で測定可能であった。以前は数日から数週間を要し、通常は販売者からの苦情を通じて明らかになる品質の悪化が、今では自動化された評価によって4時間未満で発見される。以前は主観的な判断に依存していた導入決定が、今ではすべての評価者が定量的基準を満たす必要がある。迅速な反復サイクルは数日から数分に短縮された。 セキュリティは定期的な監査から、要求があれば100%のガードレール対応に移行されました。遅延の悪化は、実 productionに達する前のCIゲートで検出されます。数週間後に請求書で現れるコストの予期せぬ問題は、現在ステージ2で評価され、変更がリリースされる前に品質ゲートによって適用されます。また、「エージェントパイプライン内の何か」という問題も、CloudWatchアラームから完全なエージェント実行トレースまで、一クリックで解決され、すべての推論ステップが明確になります。
より大きな教訓は、業界が以前に学んだものと同じです。DevOpsは、自動化されたテストを行わずにコードをリリースするのは無謀だと教えてくれました。MLOpsは、監視を行わずにモデルをデプロイするのは危険だと教えてくれました。AgentOpsも同様に、AIエージェントを継続的で多層的な評価を行わずに操作することは無謀だと教えてくれます。
ここで説明されている9段階のフレームワークは、販売インテリジェンスエージェントに特有のものではありません。推理を行い、サブエージェントを呼び出し、ツールを使用し、応答を合成するマルチエージェントシステムを展開するチームは、同じライフサイクルの中で同じような問題に直面します。あなたの失敗の分類法は異なるでしょう。あなたのゴールドセットはあなたの分野に応じて変わります。あなたの評価スタックはユーザーに合わせて調整されます。変わらないのは原理です:評価は最終的なQAステップではありません。 それはエージェント自体のオペレーティングシステムであり、継続的に測定され、自動的に保護され、各インタラクションごとに改善される。
生産的なエージェントを構築しており、このような評価体制をシステムに導入したい場合、Amazon Bedrock AgentCore Evaluationsがその実施のためのプラットフォームを提供します。実験のためのオンデマンド評価、継続的な監視のためのバッチ評価、ライブトラフィックのためのオンライン評価、内蔵およびカスタマイズ可能な評価器、データセットの評価(パブリックプレビュー中)、CloudWatchとの統合、AgentCoreの最適化機能、推奨事項、A/Bテストによりフィードバックループを構築できます。 ステージ1から始め、エージェントにとって良い見た目とは何かを定義し、フレームワークが残りのことを行うようにしましょう。
開始する準備ができましたか? Amazon Bedrock AgentCoreのドキュメントのエージェント性能の評価をご覧ください。また、生産環境のエージェントを構築しており、このフレームワークを自分のシステムに適用する方法について相談したい場合は、喜んで支援します。直接お問い合わせいただくか、AWSアカウントチームを通じてお願いください。
Amazon Bedrock AgentCore Evaluationsについて詳しく知りたい場合は、AWSドキュメントのエージェントパフォーマンスの評価をご覧ください。技術的な概要については、AgentCore Evaluationsを用いた信頼性の高いAIエージェントの構築をご覧ください。Performance Insights Agentの構築方法については、Amazon Bedrock AgentCoreを用いてビジネス管理を変革するためのAWS SMGSがAI駆動型対話アシスタントをどのように利用するかをご覧ください。AgentCoreの推薦と最適化については、AgentCore最適化:推薦やA/Bテストを用いたエージェント品質の向上をご覧ください。
謝辞
このプロジェクトを実現させるに至ったビジョンと指導力を持つ、私たちのエグゼクティブスポンサーとメンターに心から感謝します: Damien Forthomme、アプライドサイエンス部門IIIマネージャー; Akhand Singh、データエンジニアリング部門長; Sujit Narapareddy、AWS Insightsディレクター; Monica Jain、シニアプロダクトマネージャー – テック部門および Norman Braddock、AWSのAIプロダクトマネジメントシニアマネージャー; Muhammad Umar Javed、アプライドサイエンティスト部門III、L6。