
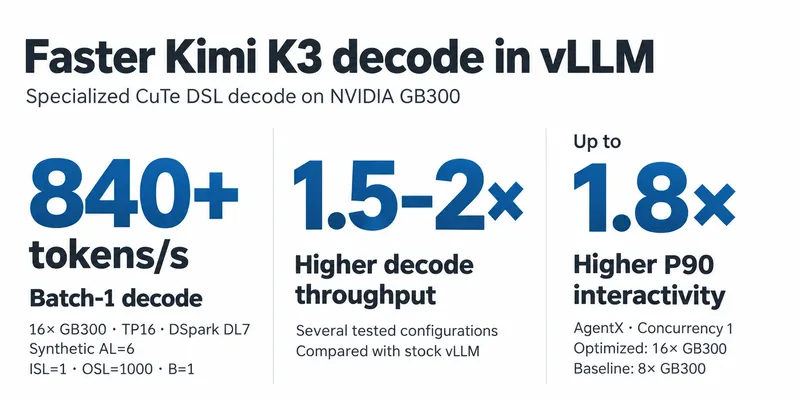
コーディングエージェントは、モデル最適化における最も難しい部分を支援することができる。具体的には、複雑なGPUカーネルを作成すること、異なるオペレーター間の融合処理を行うこと、通信と計算が重複する場合の対処、そして異なるバッチサイズやGPU構成における実行設定の調整などである。Kimi K3については、エージェント支援開発を利用して、NVIDIA GB300上で統一されたCuTe DSLデコードパスを構築した。これにより、8台または16台のGPUを利用して、注意機能、MoE、通信処理が可能となった。最適化により、DSpark(合成AL=6)を用いた16台のNVIDIA GB300 GPUを使用したバッチ1では840トークン/秒以上の速度が達成され、いくつかのテスト構成では1.5~2倍のデコードスループットが得られ、AgentXワークロードでは1.8倍のP90インタラクティビティが実現された。
エージェント最適化された推論コードは、私たちのレビューとメンテナンスワークフローを上回っている。各カーネル行ごとを理解し、潜在的な問題を特定し、サポートされるすべての設定をテストするという手作業によるレビュープロセスは、非常に時間がかかる作業である。一方で、この作業を省略すると、生産環境で故障する可能性のある不具合のあるソフトウェアをリリースするリスクがある。
両方の目標を達成する方法には明確な視線が存在する:パフォーマンス作業の組織方法を変える必要がある。エージェンタル最適化に加えて、信頼性と性能の自動検証が可能なシステムを設計し、設計上で隔離とリスク低減を実現するようソフトウェアを構造化する必要がある。
提案されている迅速なモデル最適化RFCは、このアプローチの基盤となっています。私たちの基本原則は、リスクを管理しながらレビューの負担を減らすことです。これを実現するために、私たちは以下のように行います:
- 変更点を分離する。最適化はモデルのコード内に保持する。
- スコープを制限し、核心的な機能を保持する。サポートされるハードウェアとワークロードを定義するが、実産出LLM利用に必要な機能は保持する。
- 体系的に正確性を検証する。 整合性と信頼性を確保するために、定められた性能および正確性のベンチマークを実行し、サポートされているすべての構成で厳格に高い性能を達成する。
- スケールの検証。 貢献者は自身のGPUで標準的な評価を行い、再現可能な結果を共有してから、メンテナーの注意を求めるべきです。
キミK3は、このアプローチに基づく私たちの最初の貢献です。この記事では、キミK3をどのように最適化したか、それらの最適化を実装し維持するために必要な信頼性をどのように構築したか、そして性能結果について説明しています。
目次
パート1:Kimi K3の最適化
この貢献では、Kimi K3の新しいデコードパスが導入されました。これは、特定のサブ問題に最適化されたカスタムCuTe DSLカーネルを用いて、ほぼすべての操作を統合・置き換えます。対象となるのは、8台または16台のGPUを持つNVIDIA Blackwell GPUです。デコードバッチは1から64まで、長いコンテキストに対してはオプションのデコードコンテキスト並列処理が可能です。GPUはmulticastサポート機能を持つ1つのNVLinkドメインを共有します。詳細については、PRをご覧ください。
1. 作業負荷に合わせて形状を調整する
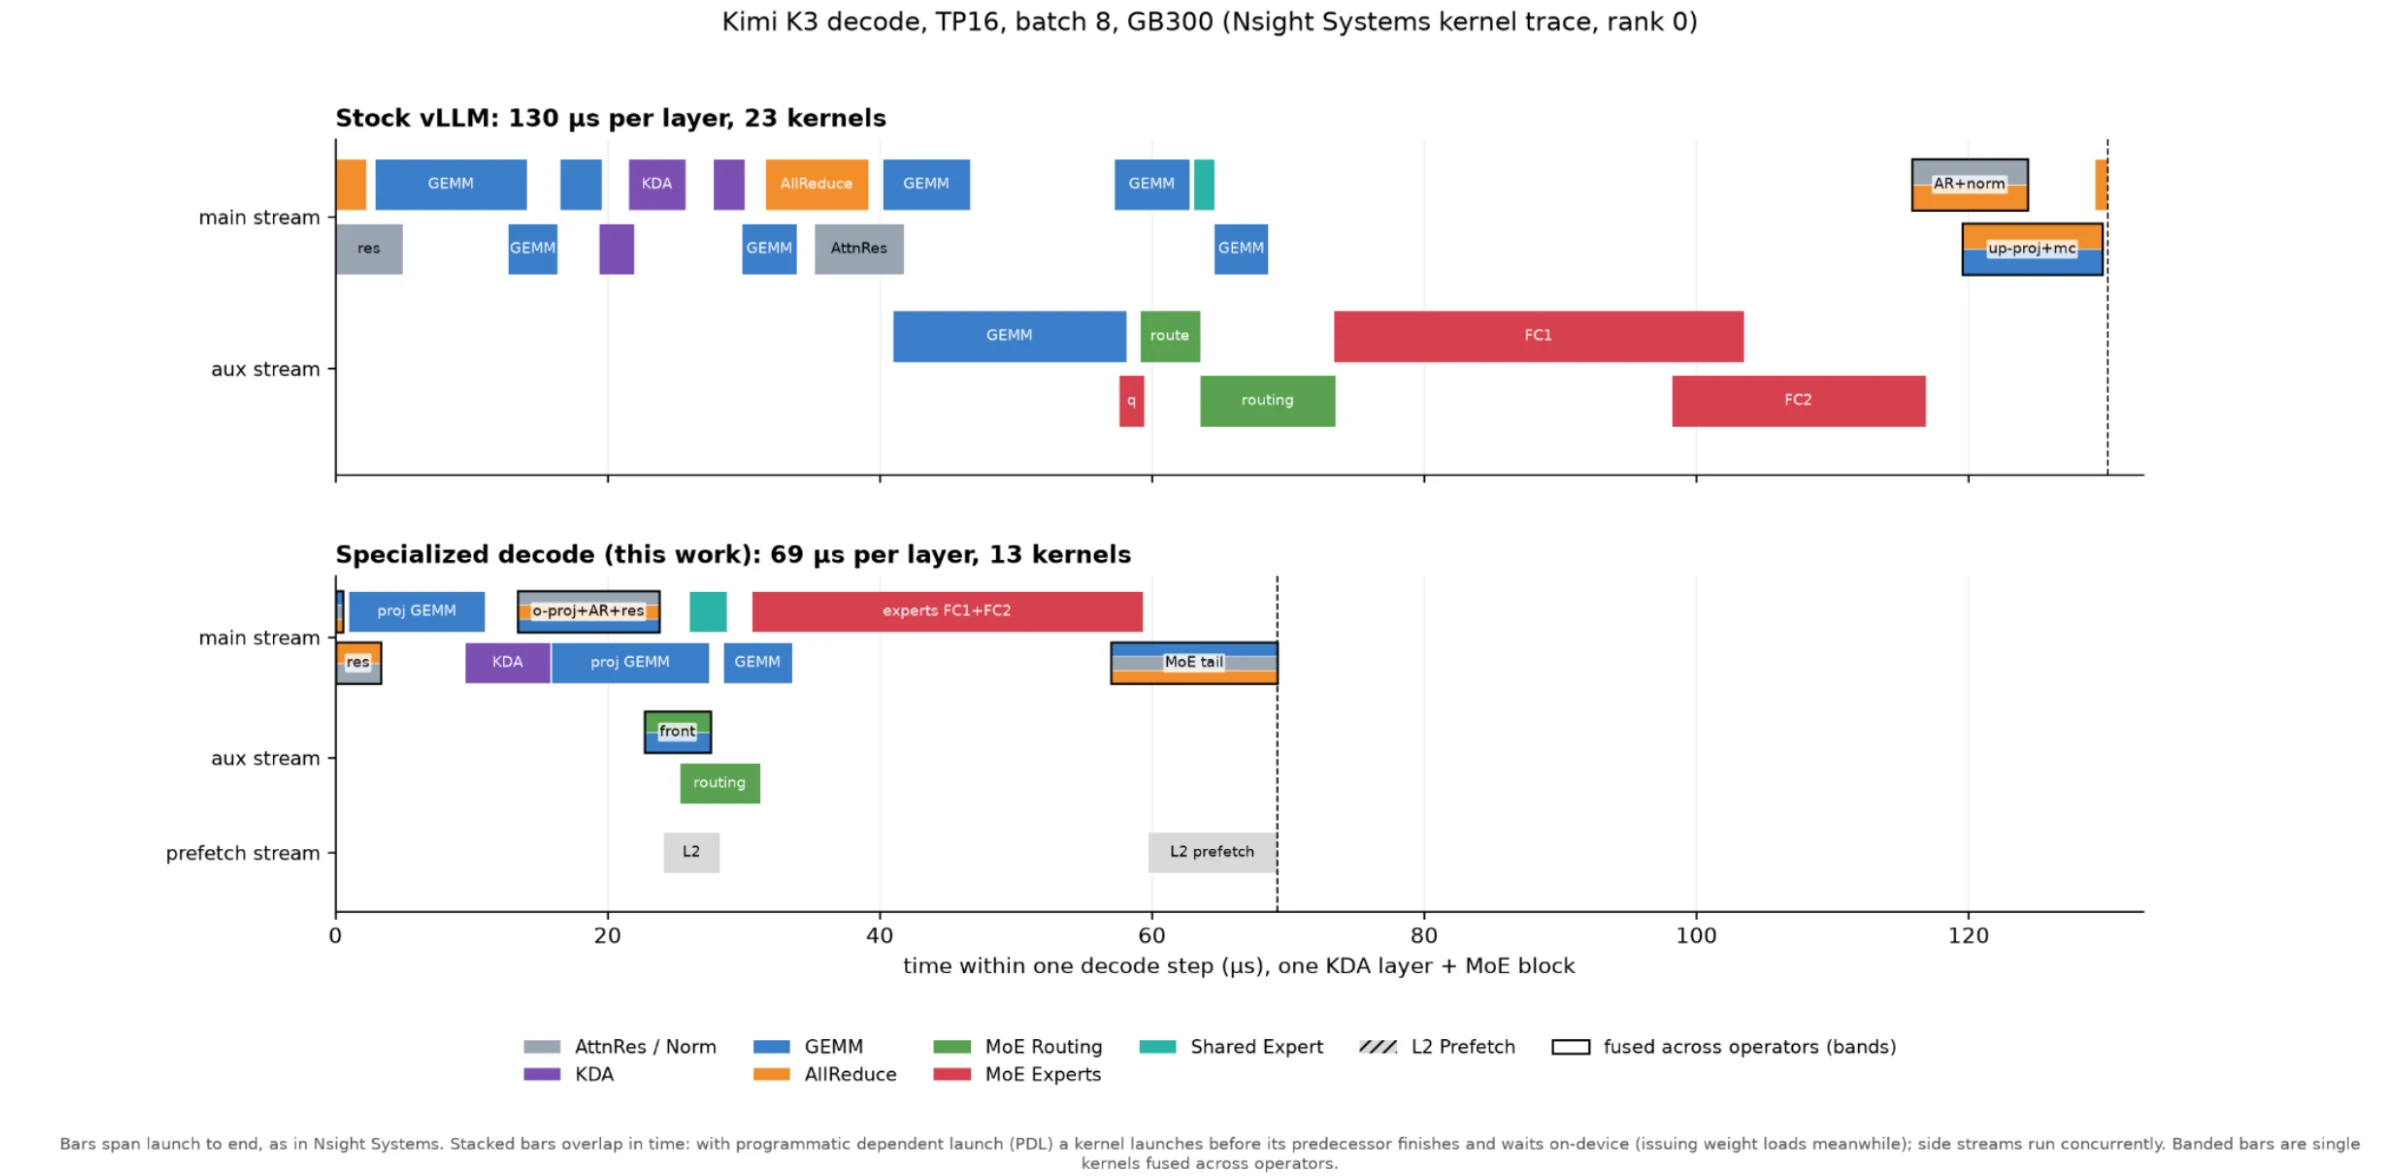
異なるバッチサイズには異なるカーネル選択が必要です。注意を要するプロジェクションの場合、1~2のバッチサイズでは特殊な小さな行列カーネルを使用し、より大きなバッチでは分割カーネルを使用して、行列乗算をより多くのGPUワーカーに分担します。これらのプロジェクションは、GPUリソースを十分に活用し、メモリ読み出し/通信と計算作業が可能な大きなカーネルを実行できるように細かく調整されています。
KDAは、バッチサイズや各GPU上の注意のヘッド数に合わせて調整されたスケジューリングを持つ、最適化されたCuTe DSLデコードカーネルも使用しています。
長いコンテキストの場合、デコードコンテキスト並列性(DCP)によりKVキャッシュをGPUに分散させる。各GPUは自身の領域について注意を計算し、調整された融合カーネルが部分的な結果をv-projとgatingと組み合わせる。
2. 重複する計算と通信
注意出力プロジェクションを直接全減算と次の注意残差計算に融合させる。GPUカーネルは部分結果をNVLinkにアクセス可能なバッファーに公開し、受信カーネルがそれらを組み合わせて計算を続行する。いくつかの小規模バッチ構成では、プロダクターとコンシューマを一つのカーネルに融合させる。データ交換は、オーバーヘッドを最小限に抑えたフェイスレスアプローチで行われる。
より大きなバッチでは、実装が二段階の削減に切り替わります。GPUはまず出力の割り当てられた部分を組み合わせ、その後結果を分配します。これにより、GPU間でのデータの移動が減少します。
3. MoEスケジューリングと重複を改善する
専門家たちはすでにテンソル並列性を利用しているが、ベースラインではすべてのGPU上で完全なルータースコアと潜在入力プロジェクションを計算する。これらの計算をTPのラン数に分けて、各ランの結果を一つの行列乗算にまとめる。GPUはNVLinkを通じて結果を交換する。これにより、専門家の実行が始まる前の繰り返し計算、ウェイト読み込み、カーネル起動が減少する。
共有エキスパートは別々のストリーム上で実行される。その作業は、設定に応じてルーティングやルーティングエキスパートの計算と重なる。スケジュールは、各操作が使用するGPUリソースの数を制御し、競合がないようにバランスの取れた並列処理を確保するために慎重に調整される。詳細はexperts_runtimeに記載されている。
4. 近々のウェイトをキャッシュにプリフェッチする
小規模な推論において、私たちはしばしばメモリの制約を受けます。これは、メモリから重みを読み出す速度に限られているためです。通信のような一部の段階では、利用可能なメモリ帯域幅を完全に活用することができません。この作業中に、側流で専用カーネルを実行することで、通信が完了した後には次の操作の重みがはるかに高いキャッシュヒット率を持つようにすることができます。
パート2:迅速かつ責任を持って動く
Kimi K3は最初の例の一つに過ぎません。私たちは、コミュニティが共に努力することで、より多くのモデル、GPU、ワークロードを高速化できると信じています。
異なる貢献者/エージェントは、異なる機会を見出す。より良い通信スケジュールや、特定のデプロイに役立つ融合がそれである。しかし、すべての貢献が異なる前提条件、不完全なテスト、再現が困難なベンチマークを持って来る場合、検証とメンテナンスの作業はすぐにボトルネックとなり、壊れたコードをリリースするリスクも生じる。ユーザーが長期的な実 production 用途で信頼できる改善に、それらのアイデアを変換する共通の方法が必要だ。
エージェントに提供させる内容が変わります。コードエージェントが生成するテスト、検証、要件について明確な期待を定めるべきです。エージェントはテストを作成し、包括的な評価とベンチマークを行い、障害を調査し、最適化が機能する条件を記録します。人間のレビュアーは依然として設計と証拠を判断しますが、行ごとのコードレビューではなく、高水準の抽象化から始めることができます。
提案された迅速実装RFCを基に、私たちは4つの原則に沿ってこの作業を進めています。
1. 変更を分離する
モデル固有の最適化をモデルのコード内に保持する。これにより、影響を受けるパスを簡単に特定でき、レビュアーが考慮するブラスト半径を減らすことができる。
隔離も実行時において維持される必要があります。レビュアーは、最適化されたパスが選択された時点、その状態がどのように変化するか、そして実行が標準パスに戻る方法を追跡できるべきです。
この制約は実際にいくつかの最適化を排除します。入力準備、サンプリング、KVキャッシュ管理などが生じるオーバーヘッドは、隔離によって除外されます。これは設計の結果であり、主に意図的なものです。これらのコンポーネントはほとんどのvLLM展開で共有されており、特定のワークロードに最適化するためにそれらを変更すると、他の数十の安定したvLLM構成が壊れるリスクがあります。これらのコンポーネントに関する作業は重要であり、迅速な対応が許す以上に、コアメンテナーがより密接に関与すべきです。
2. 範囲を制限するが、ユーザーの機能は保持する
最適化は、すべての展開を改善する必要はありません。特定のGPU、並列処理設定、またはバッチサイズの範囲を対象にすることができます。明確な境界を設けることで、調整が容易になり、検証できる定義された構成が得られます。
K3については、初期のハードウェア検証ではTP8およびTP16を用いてGB300を対象とし、64までのバッチをデコードし、様々なドラフト長を使用した推測的デコード、および1つのNVLinkドメイン内でのコンテキスト並列構成をデコードする。
これらの境界は最適化が適用される範囲を説明していますが、機能のカバレッジを削除することはありません。製品のデプロイには、エンドポイントを有用にする基本的な機能が必要です。完全なコンテキストサービス、温度サンプリング、構造化された出力などの機能は、「最適化によって排除」したり「オプトアウト」することはできません。これらは第一級のサービス機能であり、カーネル形状や数値チェックと共に検証計画に含まれます。
3. 正確性の検証
カーネルテストとモデル評価は、異なる問いに対する答えを提供します。カーネルテストでは、形状や入力値の違いによる数値結果を確認します。モデル評価では、全体的な実行パスがモデルの答えを保持しているかどうかをチェックします。両方が必要です。
テストは実際に変更されたコードを実行する必要があります。小規模バッチ最適化は小規模バッチで評価が必要です。注意カーネルの変更には長期の文脈カバレッジが必要です。標準パスを静かに使用するテストは、最適化についてほとんど証拠を提供せず、一般的な罠となります。
K3開発がその重要性を示している。当社の監査により、コンパイラが同期待ちの前にアクティベーション読み込みを行うことが判明した。修正により、その負荷タイプを静的重量に限定した。このようなエラーは単純な機能チェックでは発見できず、特定の調査が必要となる。
さらに、MRCRやAIME25のような長期コンテキストおよび長期生成評価では、モデル入力や一貫した起動タイミングを用いた単独カーネルテストでは再現不可能であった、注意と通信カーネル内の敏感な数値的問題が明らかになった。
4. 全体的な性能を確認する
ヘッドラインの速度向上は出発点です。また、影響を受けるワークロード全体でその変化がどのようになるかもわかりたいです。つまり、幅広いバッチサイズ、コンテキストの長さ、サポートされる並列処理構成などです。MoEの測定では実際のプロンプトを含めるべきです。なぜなら、専門家の選択がどの重みが読み取られるか、そしてどれだけの作業が再利用可能かに影響を与えるからです。純粋なデコード結果も、プリフィルとデコードを組み合わせたワークロードとは区別されるべきです。
信頼性の高い検証にはGPUの時間も必要です。関連する自社GPUを使用した評価RFCでは、貢献者が自身のハードウェアで実行できる標準的な評価画像が提案されています。GitHub PRにリンクされた再現可能な結果のバンドルや提出物により、証拠がより利用しやすくなります。異なる評価レベルと共有されるコミュニティの計算能力により、カバー範囲を拡大することができ、GPUの需要を管理し、プロジェクト資金で運営されるCIへの圧力を軽減することができます。
第3部:パフォーマンスの詳細解析
DSparkによるデコード性能
DSparkを使用した場合、Kimi K3は16台のNVIDIA GB300 GPUを用いて、制御されたAL=6ベンチマークで1秒あたり842トークンを達成します。これは、同じ推測型デコーディング設定でスタンダードvLLMよりも1.73倍速いです。完全な結果表については、PRを参照してください。
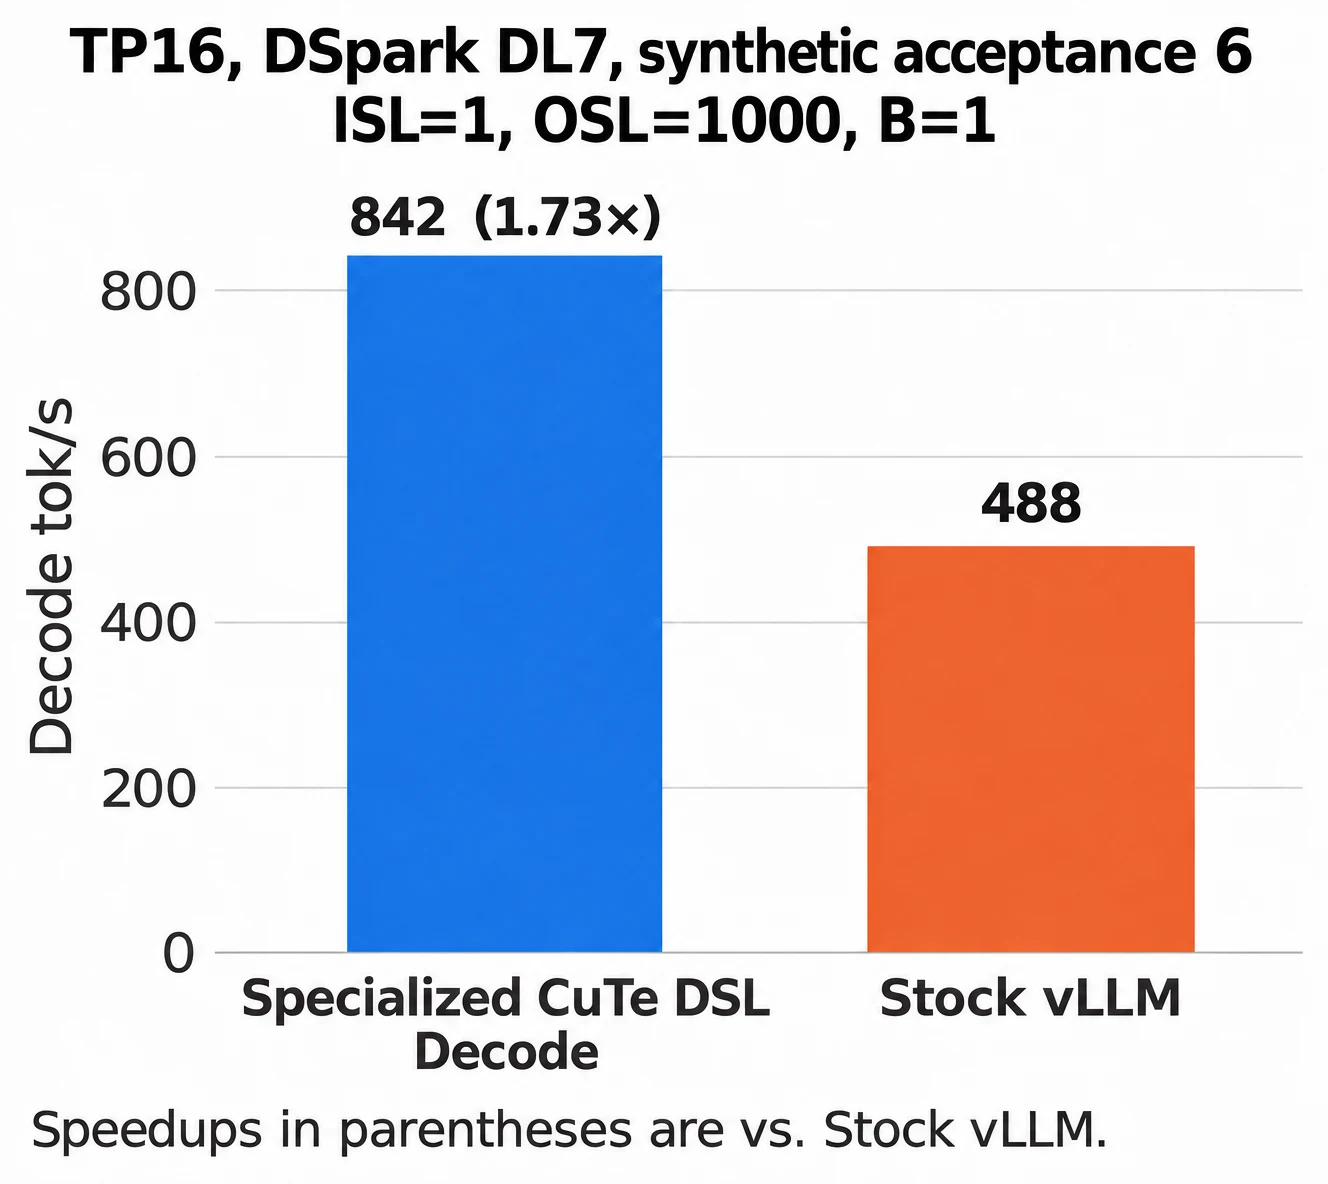
設定:TP16、DSparkで7個のドラフトトークンを用い、合成受け入れ長は6、DL=7、ISL=1、OSL=1k、バッチサイズは1。TPSは集計されたデコードスループットを測定し、プリフィルを除外する。
推測なしでデコード性能を評価する
改善はテストされたバッチ範囲全体にわたって見られます。TP16はバッチ16~64で1.62~1.71倍の増加率を維持し、一方TP8は同じ範囲で1.31~1.43倍を達成します。
| バッチサイズ | TP8トークン/秒 | TP8スピードアップ | TP16トークン/秒 | TP16スピードアップ |
|---|---|---|---|---|
| 1 | 193.3 | 1.58× | 256.4 | 1.88× |
| 2 | 317.8 | 1.50× | 436.7 | 1.92× |
| 4 | 540.6 | 1.55× | 702.5 | 1.81× |
| 8 | 820.1 | 1.45× | 1,157.9 | 1.79× |
| 16 | 1,274.8 | 1.43× | 1,758.3 | 1.71× |
| 32 | 1,702.6 | 1.33× | 2,550.9 | 1.64× |
| 64 | 2,375.9 | 1.31× | 3,606.1 | 1.62× |
推測的なデコードは行いません。スループットは全TPグループのものです。
AgentXの改善
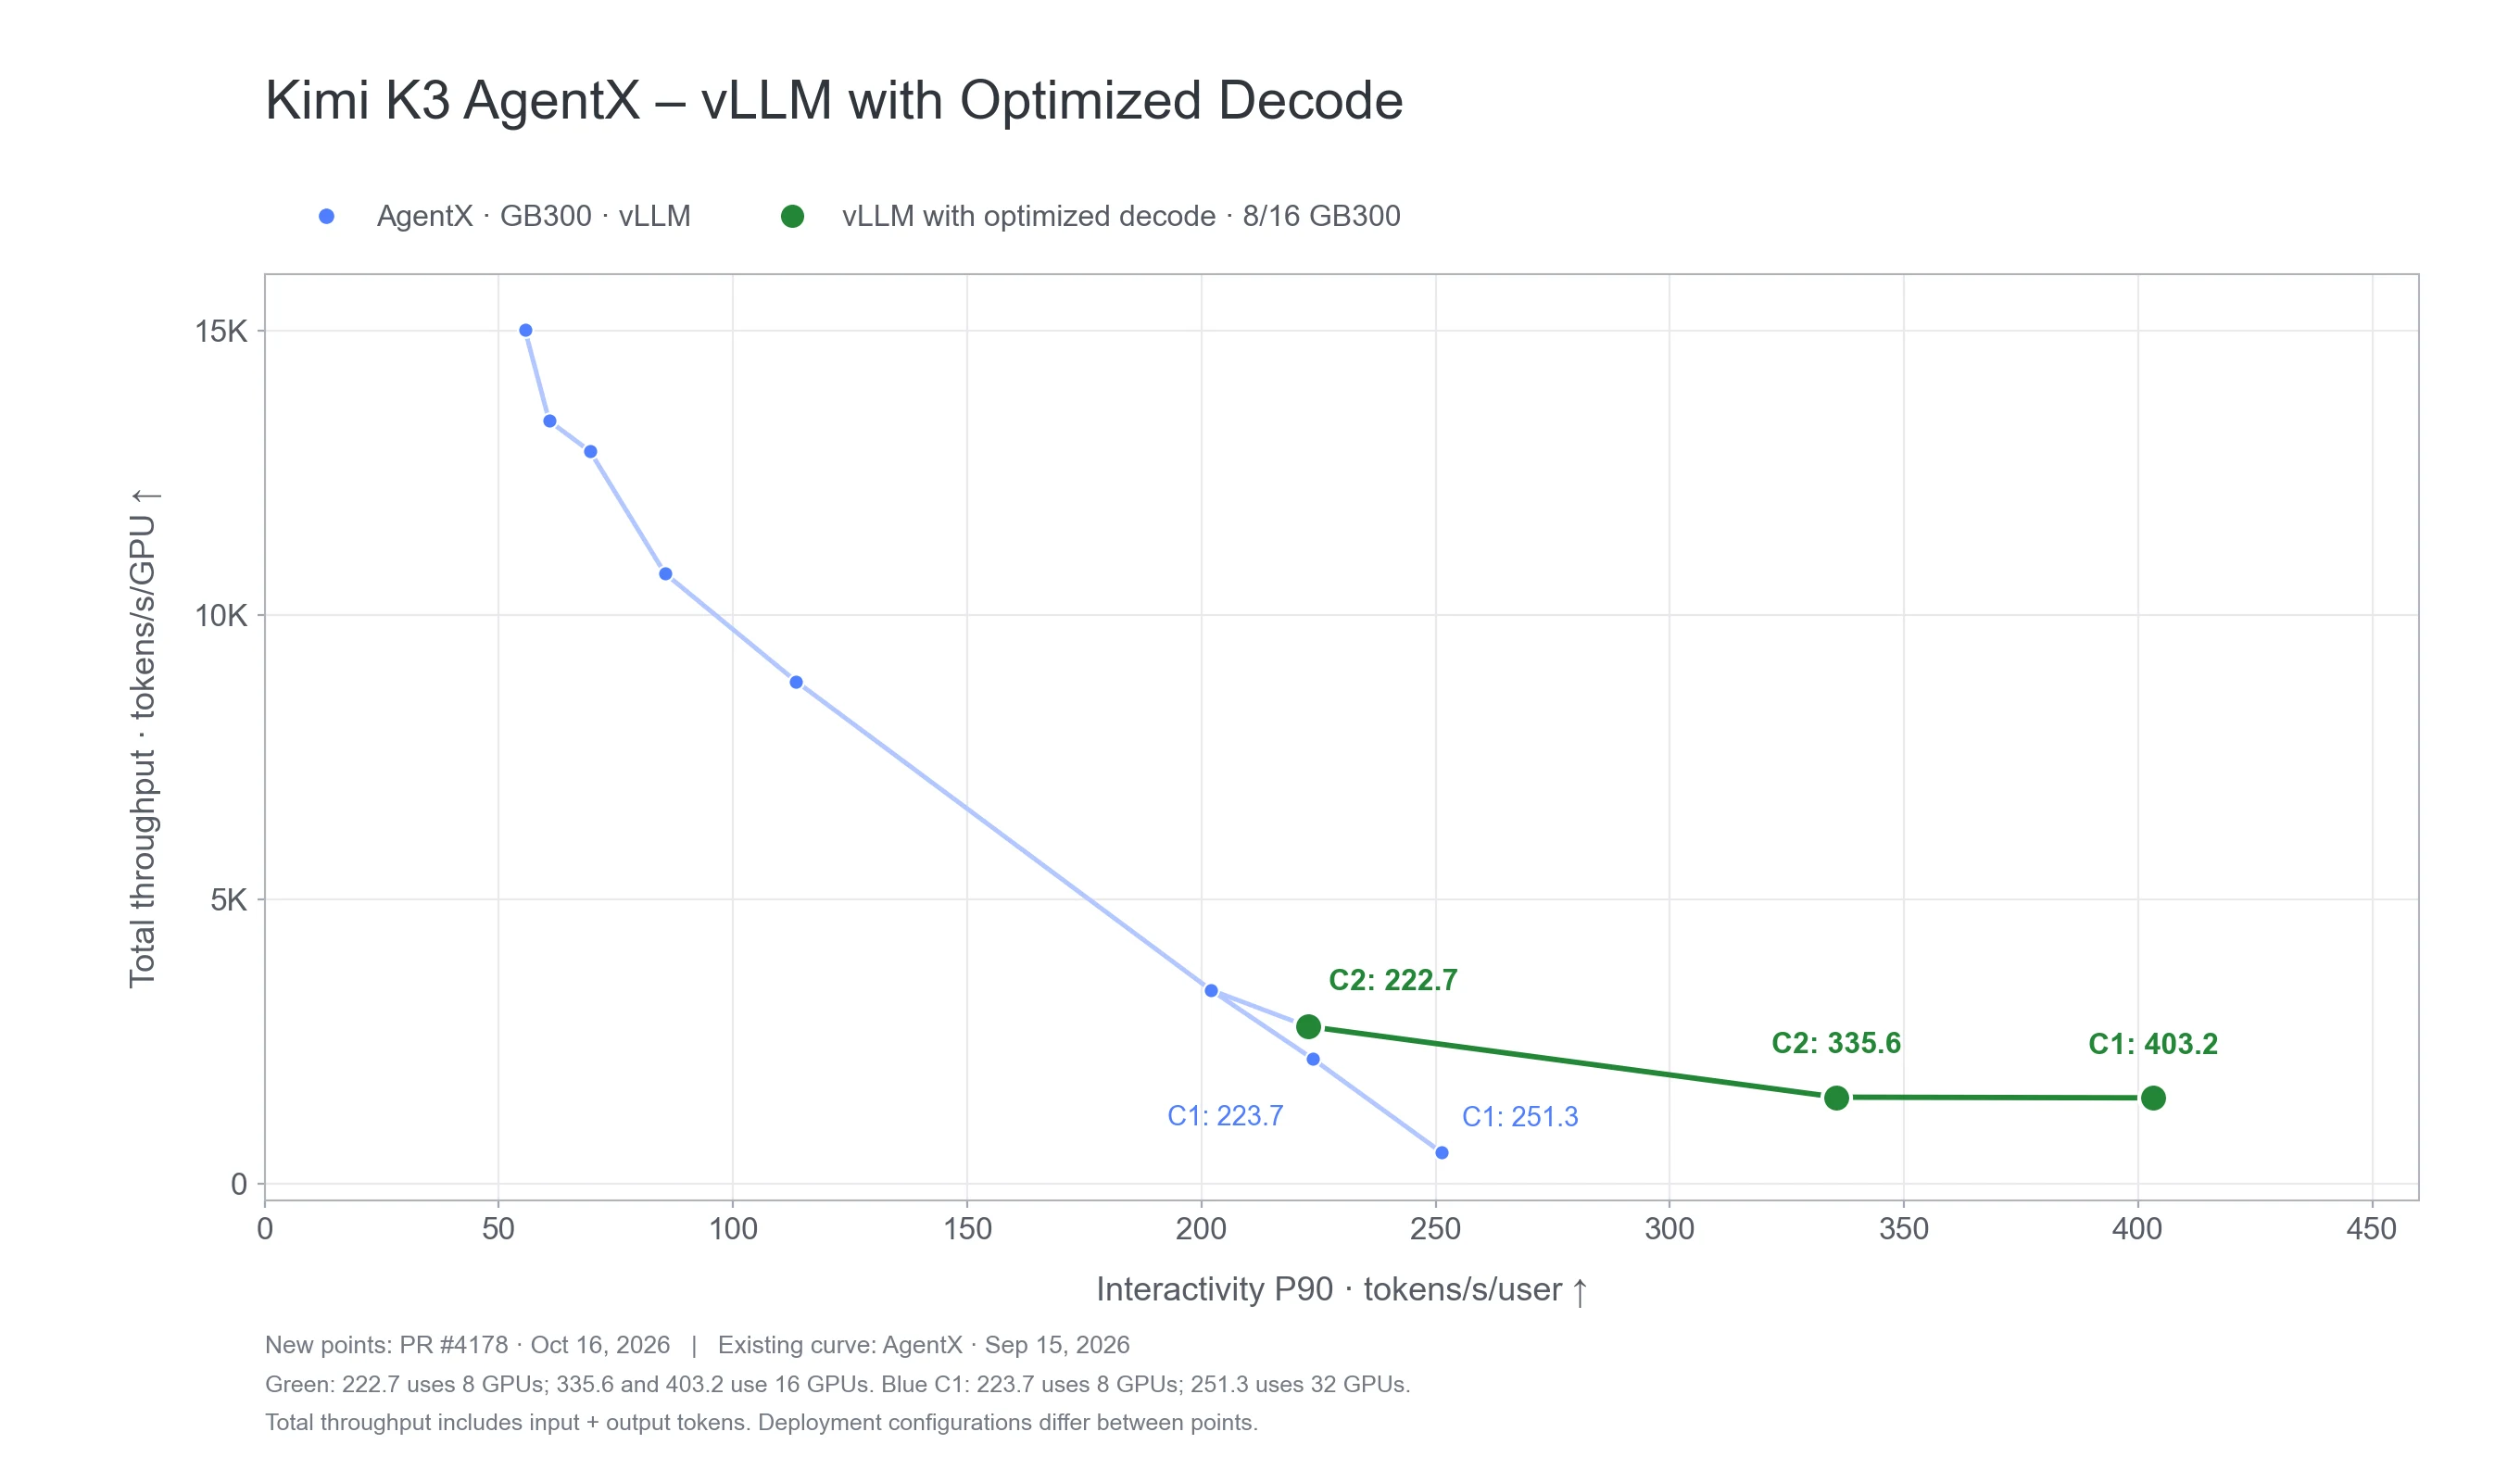
最適化されたKimi K3実装では、AgentX上で並行処理1の時、1.8倍高いP90インタラクティビティを実現しています:403.2対223.7トークン/秒/ユーザーです。これは、16 GB300 GPUを用いた最適化実行結果と、8 GB300 GPUを用いた以前のvLLM結果を比較したものです。
AgentXは、長いコンテキスト、複数の会話ターン、ツールの一時停止、並行するサブエージェント、KVキャッシュの再利用を含む、実際のコーディングエージェントセッションからのトラフィックパターンを再プレイします。これらのワークロードパターンを保持しながら、プライベートな内容を合成テキストに置き換え、現実的なエージェントトラフィックの下でサービスシステムをテストします。AgentXの方法論。
次に何?
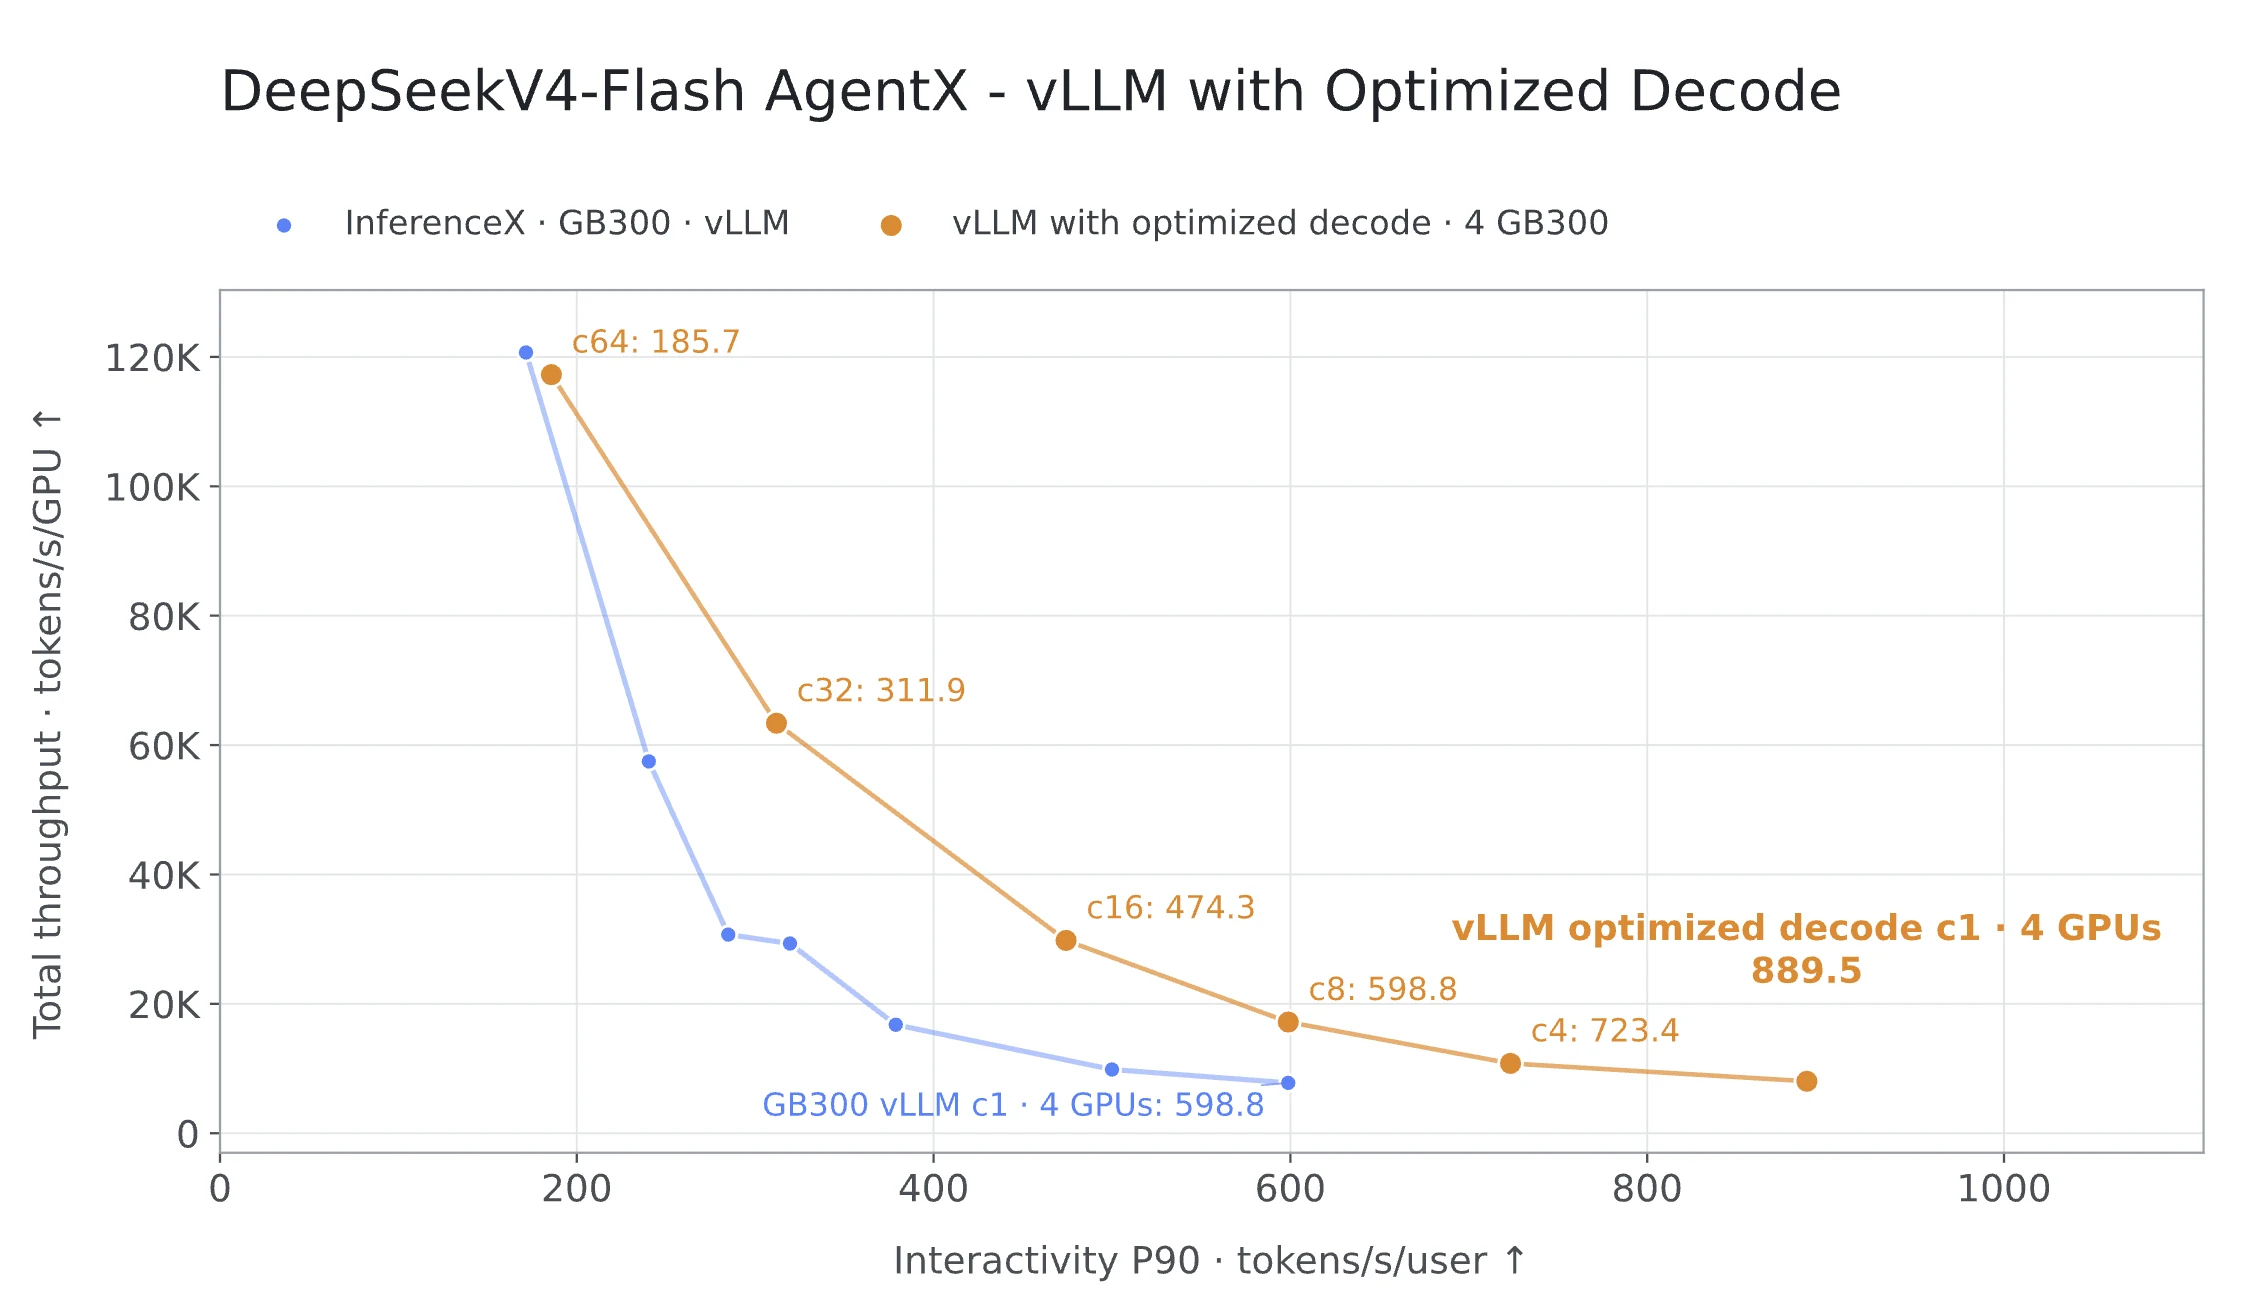
DeepSeek-V4.1-Flashの場合、#61868はK3デザインパターンに従っています。同じオプトインスwitchであるdecode_backend: latency_specializedの背後で、実装は最大64件の同時リクエストをサポートし、プリフィルや混合バッチに対するシームレスなフォールバック、および推測的デコードも可能です。単一のホットスポットを追いかけるのではなく、この実行器はカーネルとホストワークを分割します。すべてのサブレイヤー境界で全減算+mHCを融合し、大規模バッチのMoEやGEMMsを低遅延向けに構築されたCuTe DSLカーネルに置き換え、インデクサーのワークを重複排除してシャード化し、vLLMがCPU上で積極的に実行するステップごとのワークをCUDAグラフとして再現します。
MetaのMuse Spark Openのリリース後2日以内に、私たちの初期結果では1ユーザーあたり毎秒950トークンを超えることになり、7つのドラフトトークン(K=7)と6つの受け入れ長さ(AL=6)が得られました。さらに最適化が進行中です。
低コネクティビティシナリオ下でのGLM5.3のデコードレイテンシを最適化するための同様のメカニズムも公開しています。その最適化の詳細と性能結果は、後続の段階で共有します。
各貢献については、具体的な性能向上、製品機能のサポート、再現可能な正確性および性能チェックに焦点を続けていく。
謝辞
この研究に貢献してくださったRohan Varma(NVIDIA)とAlex Steiner(NVIDIA)に感謝したいです。
InferactのWoosuk Kwon、Red HatのMichael GoinおよびLucas Wilkinsonには、モデルのリファクタリングと貴重なフィードバック、サポートを提供してくれたことに感謝します。