
IT之家 10 月 17 日付の報道によると、海外メディア Wccftech によれば、開発者 abhi245y は、ベテラン AI エンジニア Mert Cobanov の PS5LM(llama.cpp 移植プロジェクト)を基に、ネイティブ GPU アプリ PS5LM Plus を開発し、クラックされた PS5 本体で Qwen3.8-27B などの大規模言語モデルをローカルで実行できるようにした。
IT之家が把握したところによると、PS5LM の初期バージョンは主に CPU でモデルを実行しており、27B パラメータモデルの実行時には、平均で毎分約 1 token しか生成できなかった。性能を向上させるため、開発者 abhi245y は Mesa オープンソースプロジェクトの AMD RADV ドライバーを移植し、Vulkan 計算インターフェースを通じて llama.cpp をネイティブアプリとして PS5 上で実行できるようにした。この変更により利用可能なメモリが約 6GB から 11.4GB に増加し、本体が高度に量子化された Qwen3.8-27B モデルを実行できるようになった。
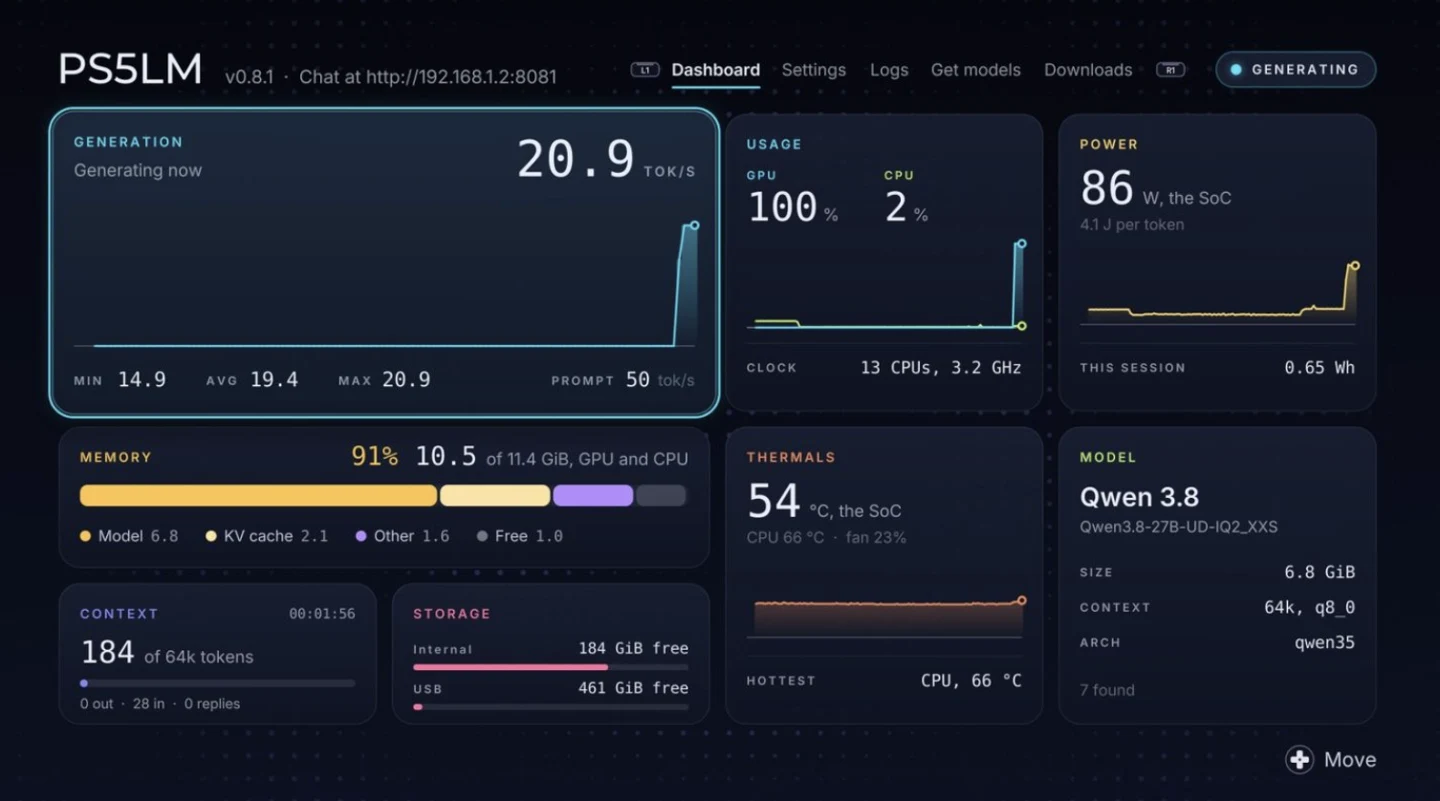
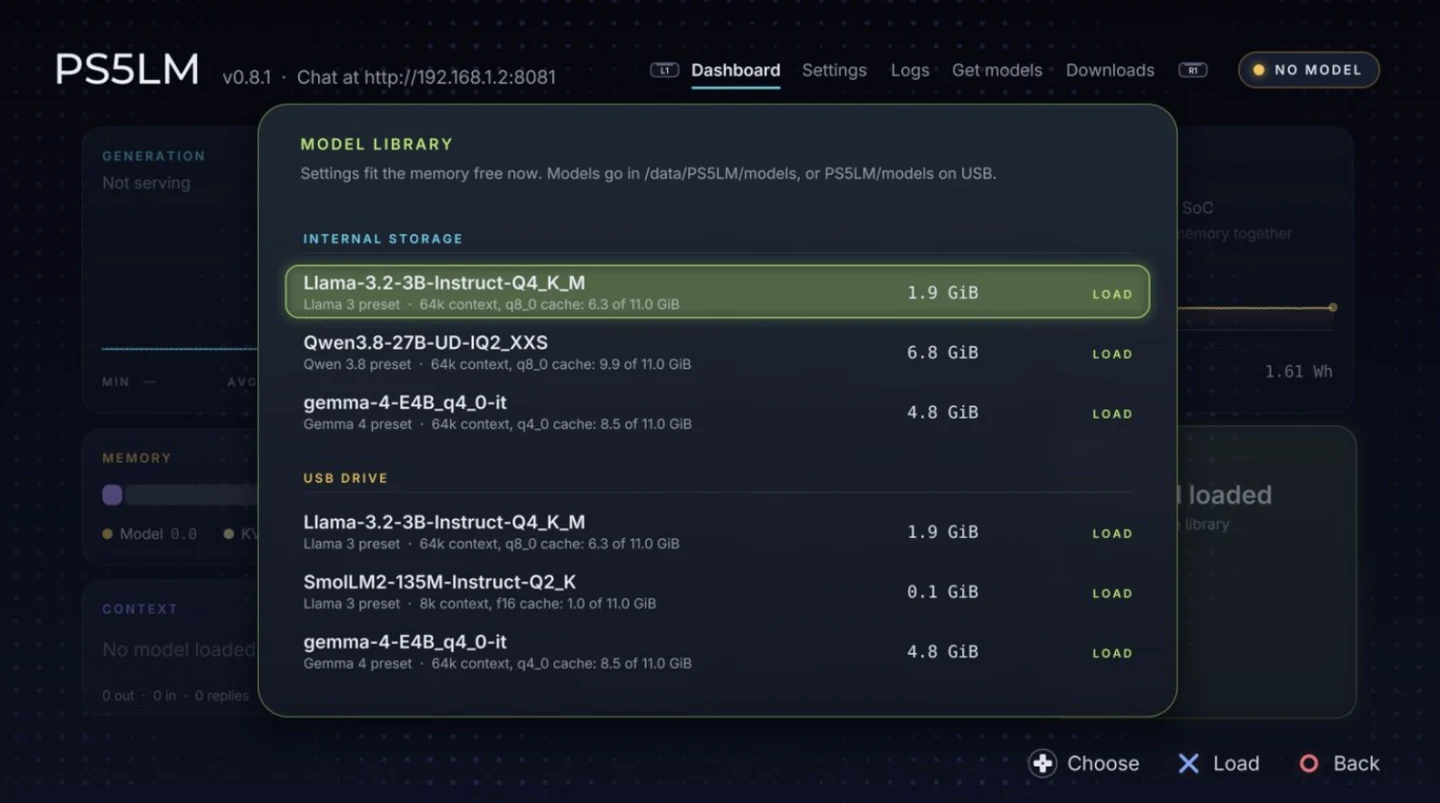
PS5 の高いメモリ帯域幅(448GB/s)のおかげで、Qwen3.8-27B の生成速度は毎秒 20.9 token に達する。テスト期間中、GPU 使用率は 100% に達し、CPU 使用率はわずか 2% だった。より小規模なモデルについては、PS5 はさらに高い生成速度を実現でき、たとえば Gemma 4 E4B は毎秒約 61 token、Llama 3.2 3B は毎秒 124 token に達した。
PS5 の GPU によるモデル推論のアクセラレーションを利用できるほか、PS5LM Plus には Web チャットインターフェースが組み込まれており、LAN の 8081 ポートを通じて API サービスを提供でき、ユーザーは同一ネットワーク内の他のデバイスからページにアクセスし、ローカルで実行されているモデルと対話できる。このプロジェクトは OpenAI および Anthropic API とも互換性があり、opencode、Codex、Claude Code などのツールが PS5 上で実行されているモデルを呼び出しやすい。
主にゲーム向けに設計された本体にとって、PS5 がローカル AI サーバーとして機能し、大規模モデル推論に GPU アクセラレーションを提供できることは、ゲーム以外におけるそのハードウェアの応用可能性を示している。ただし、本体に搭載された 16GB RAM のユニファイドメモリは、依然としてモデルの選択肢と実行品質を制限している。また、ネイティブ版 llama.cpp を実行するには、まず PS5 を脱獄する必要があり、ゲーム機や PSN アカウントの BAN などのリスクを招く可能性がある。