
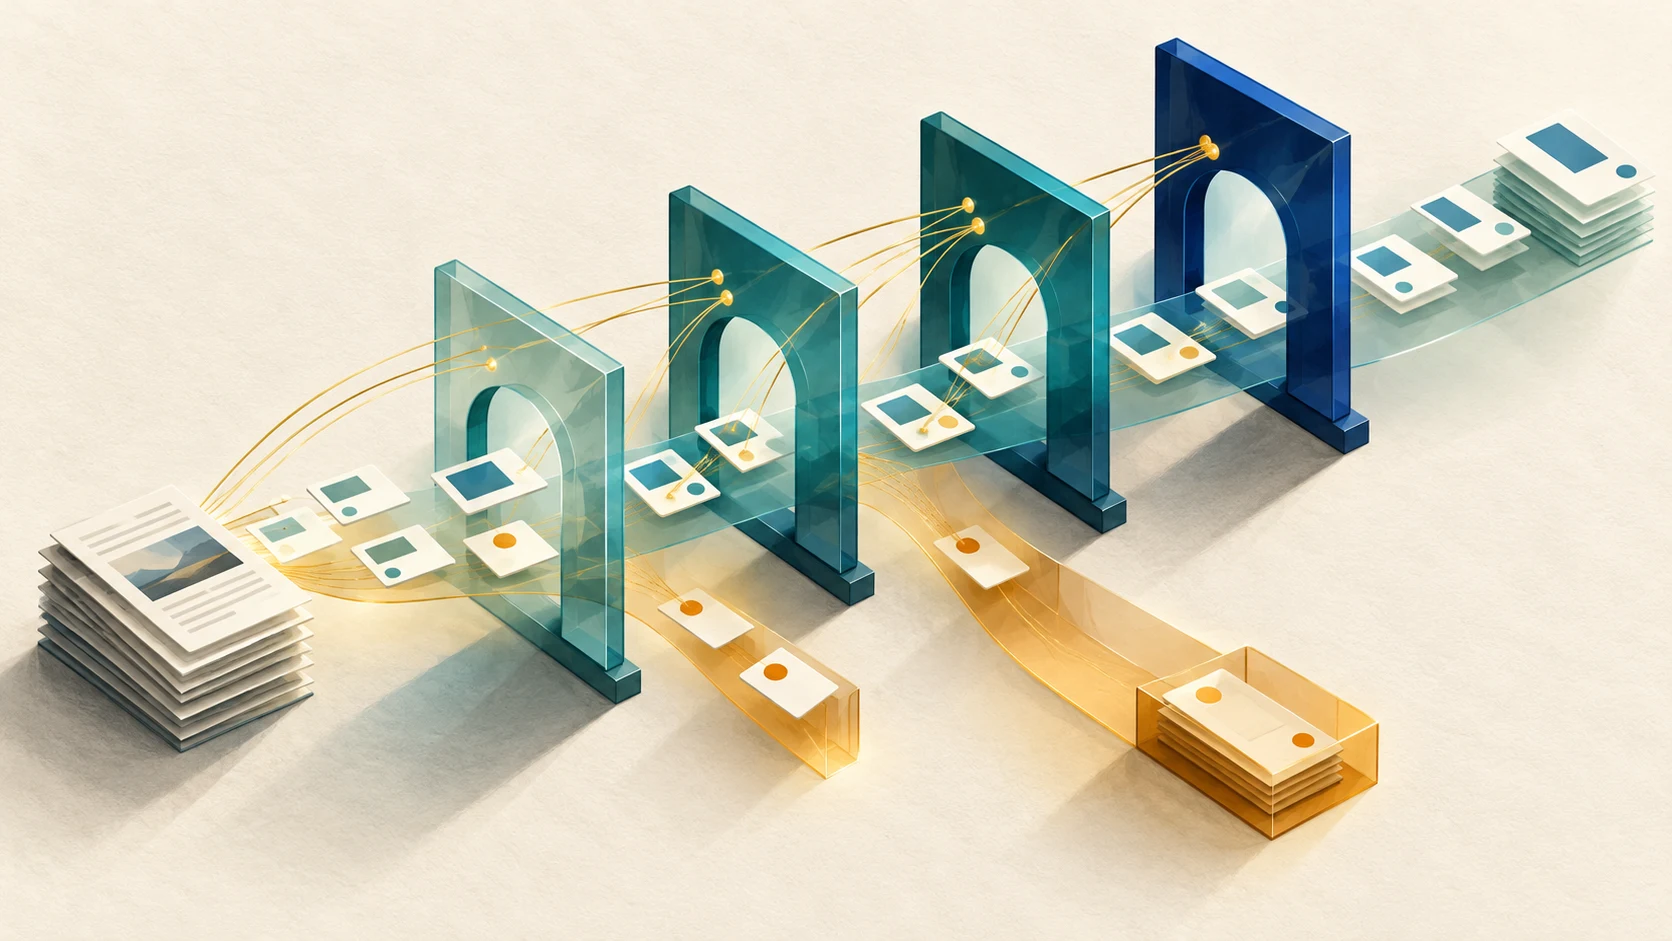
SPKEのために制作したオリジナルの記事用イラスト。概念的なワークフローを表しており、実測したベンチマークではない。
危険を見逃す緑のチェックマーク
商品データのインポート処理を想像してほしい。処理は正常に終了し、出力はJSONとして解析でき、すべての型チェックにも合格した。そして、商品重量のフィールドに 1.25 が書き込まれる。しかし、元の資料に書かれていたのは「梱包重量: 1250 g」だった。計算は正しいが、格納先のフィールドが間違っている。
これは仮想的な例であり、実測されたモデルの失敗を報告するものではない。ここで示したいのは運用上の問題だ。スキーマは数値を要求できても、その数値が商品、梱包、あるいは別のバリエーションのどれを表しているかまでは分からない。
構造化出力には、ある種の失敗を減らせる価値がある。その次にエンジニアが考えるべきなのは、どのようなデータを「根拠に裏付けられている」としてアプリケーションが受け入れるかだ。本稿では、独立した四つの検証段階に加え、「未確定」を正式な状態として扱う受け入れ基準を提案する。
プロバイダーの仕様が実際に保証すること
OpenAIは、スキーマに準拠するStructured Outputsを文書化している一方、誤りは依然として起こり得ると注意を促している。拒否応答には別途対応が必要だ。OpenAIのガイド
DeepSeekのResponses APIには、json_schemaによる出力が記載されている。一方、別の文書であるChat Completions向けのJSON Outputガイドは、有効なJSONを出力するモードを説明し、内容が空になる場合や出力の途中切れについて注意を促している。Responses API · JSON Output
これらは 2026 年 10 月 23 日に確認したドキュメント上の事実であり、新たなベンチマークの結果ではない。引用したページは、いずれのプロバイダーについても、自社の業務フィールドを正しく抽出できると証明するものではない。
米国と中国のベンダーを比較しているチームにとって有用なのは、具体的なモデル、利用するAPI、設定したモード、対応するスキーマを比較することだ。一方のベンダーの厳格なスキーマモードを、他方のベンダーにプロンプトだけでJSONを要求する方法と比べ、その差を国ごとの能力差に結び付けてはいけない。見慣れたリクエスト形式だからといって、挙動まで同じとは限らない。アダプターやモデルを変更するたびに、同じ受け入れテストを実行しよう。
不確実性をレコードに記録できるようにする
次の架空の原文を考えてみよう。
「梱包重量: 1250 g。価格: 49.00。商品重量: 記載なし。特価の終了日: 04/05/26。」
インポート処理に必要なのは、商品重量、価格の通貨、曖昧さのない特価の終了日だとする。この文章からは、どれも確定できない。空欄を 1.25 kg、USD、4 月 5 日で埋めると、整ったレコードはできるが、情報を捏造したことになる。
代わりに、簡潔で明示的なレコード仕様を定義する。
- value: 抽出した値、または null。
- status: supported(根拠あり)、missing(記載なし)、ambiguous(曖昧)、conflict(矛盾)のいずれか。
- evidence: 出典の識別子、出典内の位置、関連する原文。
- transformation: 抽出後に行った決定論的な変換。何もしていなければ、変換なし。
この例では、商品重量は null で status は missing、通貨も null で status は missing、日付は null で status は ambiguous となる。梱包重量は別のフィールドで 1.25 kg に変換してもよいが、元の 1250 g を残し、変換内容を記録する。これを商品重量のフィールドへ移してはいけない。
必須フィールドだからといって、推測まで必須にする必要はない。キーの存在を必須にしつつ、明示的な不明状態を認めればよい。missing と ambiguous は区別する。前者には追加の資料が必要で、後者にはすでにある資料の曖昧さを解消する必要がある。複数の出典が矛盾している状態も、この二つとは分けておく。
モデルの信頼度スコアで、これらの状態を覆してはいけない。モデルが 0.99 と評価しても、根拠のない値には依然として根拠がない。信頼度を運用に使いたいなら、まず、対象を代表する独立した評価用データで、スコアと実際の正しさとの関係を検証する。
書き込む前の四つの検証段階
-
完了。応答が利用可能な終了状態に達したことを確認する。空の出力、途中切れ、拒否、プロバイダー側のエラーは、それぞれ異なる結果だ。それらをすべて修復したつもりで、正常に処理できたように見える空のレコードへ変換してはいけない。理由を記録し、意図した処理経路に振り分ける。
-
構造。応答を解析し、バージョン管理されたアプリケーションのスキーマに照らして検証する。型、必須キー、許可される状態に加え、プロバイダーが強制しない制約も確認する。未対応のスキーマ機能は、動くものと黙って仮定せず、統合時に拒否する。より制約の弱い出力モードにフォールバックする場合は、その事実をテレメトリーで確認できるようにし、別途評価する。
-
根拠。引用された出典が存在することと、保存してあるバージョンの原文に引用箇所が実際に含まれることを確認する。そのうえで、引用が値とフィールドを裏付けているかを調べる。実在する引用でも、無関係なことはある。「梱包重量: 1250 g」は商品重量の根拠にはならない。スキャン文書では、OCRのテキストだけを調べてもOCRの誤りを見逃す可能性がある。重要なケースでは元のページを確認する必要がある。
出典による裏付けは原文への忠実さを示すものであり、出典自体の正確さや最新性を保証するものではない。
- 業務上の意味。可能な範囲で、単位、通貨の記載、日付の解釈、バリエーションの識別、許可されたカテゴリ、フィールド間の整合性を決定論的にチェックする。人による確認が必要な判断もある。それらを検証済みレコードのように装うのではなく、レビュー待ちのキューに入れる。
各段階が答える問いは異なる。根拠の検証に失敗した場合、それは出力形式の問題ではない。値が出るまで同じ抽出を繰り返しても、そもそも値が記載されていない資料の問題は解決しない。
先ほどの架空の例なら、status が supported なのに evidence がない値を、一つの簡単なルールで拒否できる。別のルールでは、曖昧な日付の自動インポートを止められる。こうしたルールは有用な安全策だが、真実を証明するものではない。受け入れるかどうかの判断は、モデルが生成した status とは分けておくべきだ。
スキーマでは見えない失敗をテストする
規模を拡大する前に、通常の本番データに近い例に加え、難しいケースを集めた小規模なテストセットを作る。少なくとも、次のケースを含めよう。
- 必要な事実が記載されていない。期待する結果は、その欠落を欠落のまま保持すること。
- 商品重量ではなく梱包重量など、別のラベルに数値が記載されている。
- 原文の二つのバージョンが食い違っている。レコードはその矛盾を明示する。
- 日付が曖昧であるか、格納先で必要な情報が足りない。
- 単位変換は認められているが、元の値を後から検証できるように残す必要がある。
- 原文に値を捏造するよう指示が含まれている。それを抽出方針としてではなく、原文の内容として扱う。
- 応答が空、中断、拒否、構造上不正のいずれかである。それぞれを適切な失敗処理に振り分ける。
- 引用した文章は実在するが、提案された値を裏付けていない。
モデルを比較する前に、期待する結果を書いておく。原文から答えが得られない場合は、意図的に回答を控えることも正解に含める。受け入れたレコードと保留したレコードの両方からサンプルを取り、独立したレビューを行う。そうしなければ、難しいケースを避けただけで安全性が高く見えたり、黙って推測することで生産性が高く見えたりする。
結果では、原文の言語と文書の種類が分かるようにする。サプライヤーの中国語の表、ドイツ式の小数表記、英語の説明文は、それぞれ異なるテスト区分だ。それぞれの結果を、全体の平均値の中に埋もれさせてはいけない。
解析の成功だけでなく、受け入れを測定する
少なくとも次の三つの数値を、分母を明示して報告する。ここでは、各論理ジョブがレコード1件を要求するものとし、再試行は新たなジョブとして数えない。
- スキーマ合格率: スキーマに適合するレコード数を、完了済みの候補レコード数で割る。未完了、拒否、エラーとなったジョブは別に報告する。
- 自動受け入れ率: 自動で受け入れたレコード数を、投入した全ジョブ数で割る。
- 受け入れたレコードの誤り率: 監査した受け入れ済みレコードのうち、事実またはフィールドへの割り当てに少なくとも一つの重大な誤りがあるレコード数を、監査した受け入れ済みレコード数で割る。
以下は仮想的な比較であり、実験ではない。両システムには同じ 1,000 件のジョブが投入され、それぞれがすべてのジョブについて完了済みの候補レコードを 1 件ずつ生成する。この例では、自動で受け入れなかったレコードはすべてレビューに回す。システムAでは 980 件がスキーマに適合し、800 件を自動で受け入れる。全件監査の結果、受け入れたうち 20 件に重大な誤りが見つかる。システムBでは 970 件がスキーマに適合し、600 件を受け入れる。全件監査の結果、受け入れたうち 3 件に誤りが見つかる。
Aはスキーマ合格率で 98% 対 97%、自動受け入れ率で 80% 対 60% と上回る。Bは受け入れたレコードの誤り率が 0.5% で、Aの 2.5% より低い。どちらが常に優れているというわけではない。選択は、誤ったレコードがもたらす影響と、追加で保留される 200 件をレビューするコストによって決まる。
サンプル監査では、点推定値を保証のように示すのではなく、サンプルサイズ、抽出方法、不確実性を報告する。レビュー担当者の作業時間や、復旧可能な失敗も追跡する。ほぼすべてを人に回すことで誤りを減らすシステムは、影響の大きい業務では適切かもしれないが、幅広い自動化を実証したことにはならない。
次に取り組めること
修正コストの高いフィールドを一つ選ぶ。それを裏付ける原文の根拠、不明とみなす条件、許可する変換、人が判断すべき場面を具体的に定める。モデルを変更する前に、難しいケースのテストを作る。
そのうえで、シャドーインポートを実行する。運用システムには書き込まず、レコード案だけを生成するのだ。受け入れてしまった誤りと、保留によって発生する作業量を一緒に確認する。これらの結果が、事前に合意したリスク基準を満たした場合にのみ、自動書き込みを拡大する。
実務上の目標は、AIのワークフローから推論を排除することではない。推論した答えが、いつの間にか抽出した事実として扱われるのを防ぐことだ。整ったJSONは、ソフトウェアが応答を処理するのに役立つ。適切に設計した受け入れ基準は、その応答を使ってよい場面を人が判断するのに役立つ。
根拠と限界
本稿は、リンクした公式APIドキュメントと、SPKEによる独自のワークフロー分析を組み合わせたものだ。商品情報の抜粋、システムの比較、推奨するテスト設計は、説明のための例である。ベンダーのベンチマークや本番環境の誤り率の測定は行っておらず、これらの検証でハルシネーションをなくせると実証したわけでもない。APIの機能は変わる可能性があるため、導入前に選択したモデルとエンドポイントを確認してほしい。