
そろばん、歯車、紙テープ、半導体から、ニューラルネットワークと開けた地平へ。AIで制作したオリジナルの概念イラストであり、歴史的な現場写真ではない。
そろばんを今のコンピューターの隣に置いてみると、共通点などなさそうに見える。片方は指で珠をはじき、もう片方はコードを書き、写真を認識し、人に代わってソフトウェアまで操作する。けれど、向き合っている問いは同じだ。頭の中の仕事を、頭の外へ移せないだろうか。
そろばんは数の位取りを道具の上に置いた。コンピューターは規則の実行を機械に任せた。機械学習は、そこからさらに先へ進んだ。規則をすべて人が書いておかなくても、機械は例から学べる。大規模言語モデルとAgentの時代になると、人は仕事そのものも委ね始める。答えを尋ねるだけでなく、資料を調べ、プログラムを書き、誤りを直し、結果を届けるところまで任せるようになった。
この道は、まっすぐではなかった。大げさな約束、資金の引き潮、長い停滞を経験した。それでも歩みを支えたのは、あまり絵にならない仕事だった。統計手法の改良、データセットの拡大、半導体の低価格化、ソフトウェアの信頼性向上。今日の急加速は、そうした蓄積が同時に効き始めた結果でもある。
本稿は 2026年10月9日 に執筆した。前半では、すでに起きた歴史をたどる。後半では、到来する日付に共通の合意がないAGIの未来を考える。思い切ってある年に賭けてみるが、その賭けを事実として書くつもりはない。
人類はまず、数を頭の外に置いた
そろばんは、この物語の出発点にふさわしい。ただし、「人類が初めて位取り記数法を発明した場所」と呼ぶのは適切ではない。古代の計数板、算木、珠を使うそろばんは、大きな同族をなしている。誕生と、その後の発展も別の出来事だ。中国の珠算盤は、西暦1300年ごろから算木に徐々に取って代わった。一の位、十の位、百の位にそれぞれ場所ができ、繰り上がりを記憶だけに頼る必要がなくなった。意味があったのは、位取りの計算を、目に見え、手で触れられる動作に変えたことだ。[1]
二進法は、別の問題に答えた。状態が二種類しかなくても、数を表せるだろうか。ライプニッツは1703年に、この算術を体系的に説明した。後の電子回路は、安定した二種類の状態を区別するのが得意だった。こうして二進法は、現代の計算を支える土台になった。とはいえ、二進法そのものが考えるわけではない。機械が保存し、操作しやすい表現方法を提供するものだ。[2]
バベッジは1834年に解析機関の構想を始め、演算、記憶、プログラムによる制御を同じ設計に組み込んだ。機械は生前に完成しなかったが、考え方は残った。1843年にエイダ・ラブレスが発表した注釈は、機械が手順に従って記号を処理する可能性をさらに掘り下げている。機械に何ができるかは、歯車や回路だけで決まらない。問題をプログラムとして表現できるかどうかにもかかっている。[3] CHM
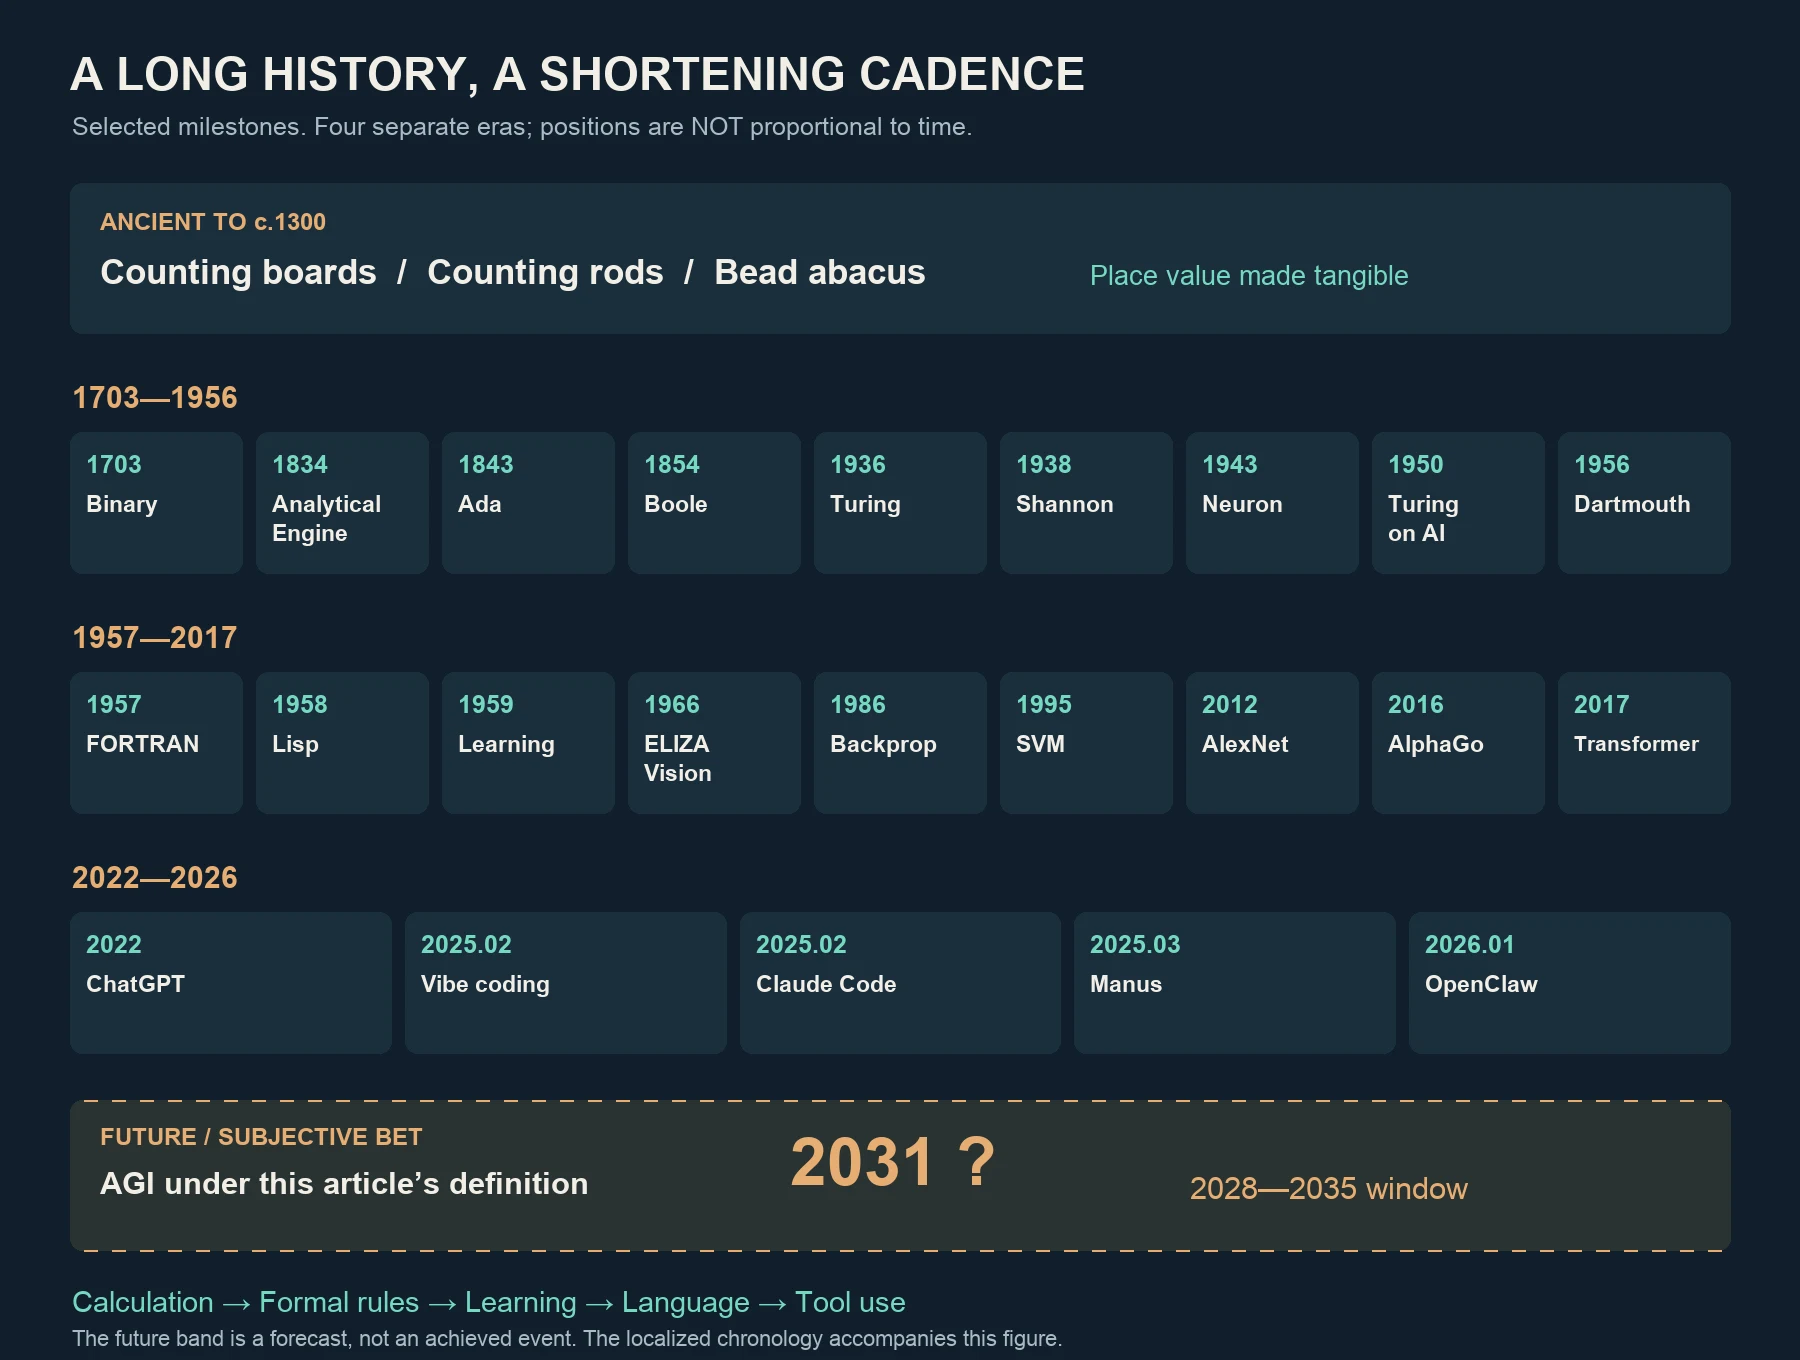
計算の歴史を古代、1703—1956、1957—2017、2022—2026の四つの時期に分けた。出来事は年代順だが、間隔は経過時間を表さない。下の破線部分は2031年への主観的な予想と2028—2035年の観察期間であり、実現済みの出来事ではない。図中の名称は以下の年表に対応する。
| 時期 | 画期となった出来事 | 何を残したか |
|---|---|---|
| 古代;1300年ごろ | 計数板、算木、珠算盤 | 計算は外部の道具に助けてもらえる。位取りと繰り上がりが、操作できる動作になった。[1] |
| 1703年 | ライプニッツが二進法を体系的に説明 | 二種類の記号で数を表し、後のデジタル回路に適した表現方法をもたらした。[2] |
| 1834年;1843年 | 解析機関の構想;ラブレスの注釈 | 演算、記憶、プログラムによる制御が結びつき始め、プログラムの可能性が個別の算術を超えて広がった。[3] CHM |
| 1854年 | ブール代数 | 論理を代数で表せるようになり、後にデジタル回路の分析に重要な考え方をもたらした。[4] |
| 1936年 | チューリングが抽象的な計算モデルを提案 | チューリングマシンが「規則に従って計算すること」を形式化し、計算には限界があることも示した。[5] |
| 1938年 | Shannonのスイッチング回路論文 | ブール論理とリレー回路のつながりが示された。原論文 |
| 1943年 | McCullochとPittsの人工ニューロンモデル | 神経活動と論理演算を結ぶ、影響力のある数学的な枠組みが生まれた。原論文 |
| 1950年 | チューリングが『計算機械と知能』を発表 | 機械は考えられるかという問いを、観察できる対話の振る舞いへと向けた。論文全文 |
| 1955年;1956年 | ダートマスの提案書;夏季研究プロジェクト | 「人工知能」が研究計画の名称となり、その後、研究分野になった。[6] |
| 1957年;1958年 | FORTRAN;Lisp | 前者は科学計算を進め、後者は初期AIにとって重要なプログラミング言語になった。[7][8] |
チューリングマシンは、そのまま使える賢いコンピューターではない。有限の規則に従って計算を実行するとはどういうことかを示す、抽象的なモデルだ。1936年のチューリングの仕事も、「どんな問題も最後には計算で解ける」と保証したわけではない。この点を理解しておく必要がある。その後AIが成功を重ねても、問題そのものにある限界がなくなったわけではない。[5]
1950年代になると、研究者は機械の目標を「速く計算する」から「知能があるように振る舞う」へと広げ始めた。ダートマスの提案書は1955年に書かれ、研究プロジェクトは1956年の夏に開かれた。現代AIの重要な出発点だが、人類が初めて人工の知能を想像した瞬間ではない。その後、プログラミング言語のおかげで、研究者は低水準の命令を逐一扱わずに済むようになり、記号、探索、推論により多くの力を注げるようになった。[6][7][8]
機械は見ること、聞くこと、推測することを学んだ
初期のAIは規則を信頼していた。専門家の知識を組み込めば、機械は病気を判断し、文を理解し、装置を制御できるように思えた。難しさはすぐに表面化する。現実には例外が多すぎるし、常識をすべて書き出すのも難しい。ルールベースのシステムは消えなかったが、研究の重心は、より実際的な方法へ徐々に移っていった。十分な例を機械に与え、不確実な状況で判断することを学ばせる方法だ。
画像認識は、画素から物体を見分ける方法を研究する。音声認識は、音を文字に変える方法を研究する。自然言語処理、つまりNLPは、言語の構造、意味、使われ方をどう扱うかを研究する。これらの分野は長く別々の道を歩み、後になって深層学習やマルチモーダルモデルの中で、少しずつ合流した。
| 時期 | 画期となった出来事 | 何を残したか |
|---|---|---|
| 1952年 | ベル研究所の数字音声認識システムAudrey | 条件を限れば、機械は音から数字を認識できるようになった。今日の自由な対話には、まだほど遠かった。CHMの歴史記録 |
| 1958年 | Rosenblattのパーセプトロン論文 | 訓練例からパラメーターを調整することが、初期の機械学習の重要な道筋になった。[10] |
| 1959年 | Samuelのチェッカーを用いた機械学習論文 | 機械は経験を使って成績を改善できる。ただし、アルゴリズムと学習目標は依然として人が設計する必要がある。[9] |
| 1966年 | ELIZA | 単純なテキスト規則でも、人は理解されたと感じる。会話が滑らかであることは、本当に理解していることとは違う。[11] |
| 1966年 | MITの夏季視覚プロジェクト | 画像の構造を機械が扱える記述に変えようとしたが、予想よりはるかに難しい課題だとわかった。プロジェクト原文 |
| 1970—1980年代 | AIの低迷とエキスパートシステムの盛衰 | 期待、計算能力、実際の性能にずれが生じた。AIの発展は、途切れず上昇する曲線ではなかった。[12] CHM |
| 1986年 | 誤差逆伝播法の代表的な論文 | 多層ネットワークの効果的な学習方法が、より大きな影響力を持つようになった。関連する考え方が、この年に初めて現れたわけではない。[13] |
| 1980—1990年代 | 統計的音声認識と統計的NLP | 確率で曖昧さやノイズを扱い、「すべての規則を書き切る」という期待に徐々に取って代わった。音声認識の総説;統計的翻訳の論文 |
| 1995年 | CortesとVapnikのサポートベクターマシン論文 | 限られた標本から堅実な分類境界を構成する、機械学習の重要な道具になった。[14] |
| 1997年 | Deep Blueがカスパロフに勝利 | 専用システムはトップ棋士を上回れる。だが、棋力が自動的に汎用的な能力になるわけではない。[15] |
| 1998年 | LeNetの代表的な論文 | 畳み込みネットワークが、手書き数字や文書の認識などで実用性を示した。[16] |
| 2000—2010年代;2013年 | 広告クリック率予測の大規模化;Googleの代表的な論文 | 機械学習がリアルタイムの商業的な意思決定に入り、大量のフィードバックから予測を改善した。[19] |
| 2009年;2012年 | ImageNetデータセット;AlexNet | 大規模データ、GPU、深いネットワークが結びつき、画像認識に大きな進展が生まれた。[17][18] |
| 2012年 | 深層ニューラルネットワークによる音声認識の総説 | 深層学習が音響モデリングを変え、音声システムは新たな改善の段階に入った。研究総説 |
| 2014年 | GAN | 敵対的学習が、生成モデルの道筋を広げた。原論文 |
| 2016年;2017年 | AlphaGoがイ・セドルに勝利;柯潔に勝利 | 深層ネットワーク、探索、強化学習を組み合わせ、以前は極めて難しかった囲碁の課題を攻略した。[20] BGA |
| 2017年 | Transformer | 注意機構によって並列学習に適したアーキテクチャが生まれ、後の大規模言語モデルの重要な基盤になった。[21] |
| 2018年 | BERT | 双方向の事前学習が言語理解の課題を前進させ、モデルはより汎用的な言語表現を共有するようになった。原論文 |
| 2020年 | GPT-3 | 少数の例を含むプロンプトによって、大規模モデルが文脈から多様な課題をこなす能力を示した。信頼性には限界が残った。[22] |
| 2020年 | DDPM | ノイズ除去拡散モデルが画像生成を進めた。ただし、拡散に関するすべての考え方の始まりではない。原論文 |
| 2020年;2021年 | AlphaFoldのCASP14での突破;手法論文 | タンパク質の構造予測が大きく進展した。構造を予測できても、新薬が検証済みになるわけではない。原論文 |
サポートベクターマシン、つまりSVMは、その時代の気風をよく表している。今日のようなチャット画面はなくても、機械学習は具体的で切実な問題を解けた。迷惑メールを見分けること、画像の種類を判断することは、機械に思考があると宣言するより役に立つ場合が多かった。[14]
広告クリック率の予測は、この能力を産業規模へと押し広げた。システムが推定するのは、「この文脈で、この広告表示がクリックされる確率」だ。通常、CTRと呼ばれる。読心術ではなく、ある利用者が必ずクリックすると保証するものでもない。確率には較正が必要で、システムは分布の変化、プライバシー上の制約、フィードバックの偏りにも直面する。重要なのは、機械学習がここで、収益と情報の流通に影響を与えながら継続的に動く循環に入ったことだ。[19]
2012年の画像認識の進展は、多くの人にニューラルネットワークへの信頼を取り戻させた。2016年のAlphaGoは、その変化を広く世間に伝えた。あの4:1は、イ・セドルとの五番勝負の挑戦マッチの結果であり、世界選手権の優勝タイトルではない。2017年の柯潔との三番勝負は3:0だった。結果は、それだけで十分に驚くべきものだ。不正確な「世界制覇」を付け加える必要はない。[18][20] BGA
ChatGPT以後、問いは回答から仕事の完了へ
2022年11月30日、ChatGPTが一般に公開された。重要だったのは、モデルが強くなったことだけではない。普通の人が、極めて敷居の低い入口を手にしたことだった。プログラミングを知らなくても、言葉で頼むだけで、機械に説明、書き直し、翻訳、プログラム生成をさせられる。AIは、さまざまな製品の裏側にある機能から、人が自ら使う相手へと変わった。[23]
続く変化は、すぐにチャット画面の外へ広がった。モデルはより多くの資料を読み、検索、ファイル、コード実行器、ブラウザーともつながり始めた。ここでいうAgentは、モデルを中心に組まれた実行システムを指す。仕事の状態を保存し、道具を呼び出し、結果を確かめ、次の行動を決める。モデルが推論を担い、実行システムがその推論を現実につなぐ。どちらも誤ることがある。
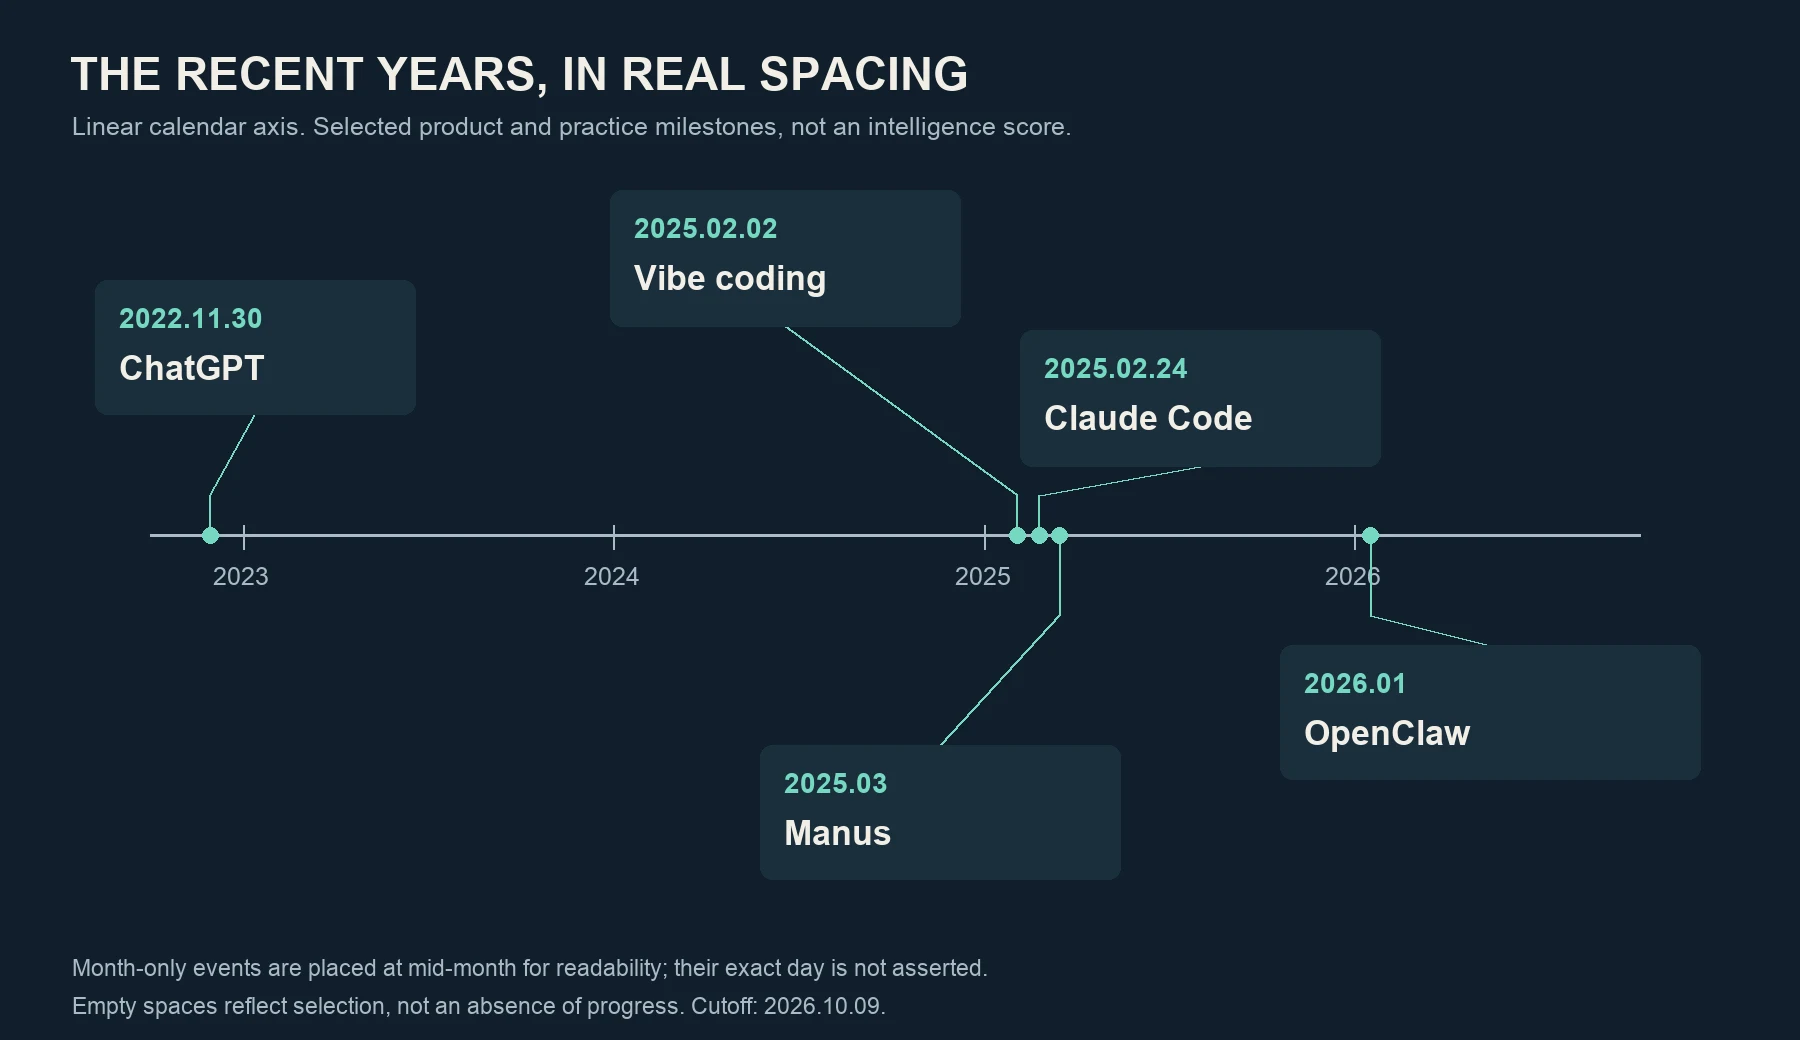
2022—2026年の直近の時間軸は、年を線形の座標で示している。ChatGPT、vibe coding、Claude Code、Manus、OpenClawの節目が近接している。本稿で選んだ出来事だけを収録しており、節目の数は汎用知能の得点を表すものではない。 月のみ判明している出来事は月の中央に置いたが、具体的な日を確定したものではない。
| 時期 | 画期となった出来事 | どう理解するか |
|---|---|---|
| 2022年11月30日 | ChatGPTを一般公開 | 自然言語が、一般の人が生成AIを使う入口になった。[23] |
| 2025年2月 | 「vibe coding」という言葉が広まる | Karpathyが、生成コードに強く依存し、逐一理解することを重視しない実践を語った。AI支援開発全体の呼称ではない。原投稿のミラー |
| 2025年2月24日 | Claude Codeの研究プレビュー | コーディング支援がターミナルに入り、コードベースと道具を使って仕事を進めるようになった。[24] |
| 2025年3月 | Manusが初めて公に登場 | 複数の工程を含む仕事の完了を目指すAgent製品が、「代わりに終わらせて」という依頼を前面に出した。[25] |
| 2026年1月 | OpenClawへの改名と普及 | 自分で管理する個人Agentのメッセージ窓口、持続する状態、道具との接続が注目された。実行システムであり、新しい基盤モデルではない。[26] |
Claude Codeとvibe codingは、同じ文の中で語られることが多い。だが、同じものではない。前者は道具、後者は使い方だ。プロの開発者は、同じ道具を使いながらコードを丁寧に読み、差分を確かめ、テストを実行できる。機械が速く書けるようになっても、人の責任が自動的に消えるわけではない。[24] Karpathyの原投稿のミラー
ManusとOpenClawは、代表的な二つの製品の選択を示している。片方は複数の工程を持つ仕事をサービスに委ねることを重視し、もう片方は常駐する助手を自分の環境につなぐことを重視する。自律的な実行の可能性を見せると同時に、新しい厄介事も浮かび上がらせた。どこまで権限を渡すのか。失敗をどう見つけるのか。すでに間違えた操作をどう元に戻すのか。これらは、モデルが問題に答える能力に劣らず重要な問いだ。[25][26]
加速は起きている。何が加速したのかを明らかにしよう
人類が知識を残し、伝えるには長い時間がかかった。規則を電子機械に任せるまでには数十年を要した。ところが、一般向けの対話助手から、日常の道具を操作する仕組みへは、数年しか隔たっていない。人の一生を尺度にすると、この時間の圧縮は強烈だ。かつては成人してから引退するまで、同じ仕事の方法を使い続けることができた。今は、仕事の入口と能力の境界が、数年のうちに何度も変わりうる。
こうは言える。多くの認知的な道具の更新周期は、世代をまたぐ長さから同じ世代の中へ、さらに数十年から数年へと縮まっている。 ただし、それだけで近年の「進歩の総量」が過去の数十年を超えたとか、その数十年が人類の生物学的進化全体を超えたとは断言できない。後の比較には、共通の単位がない。石器、文字、農業、産業革命、言語モデルも、単純に足し算できる得点ではない。
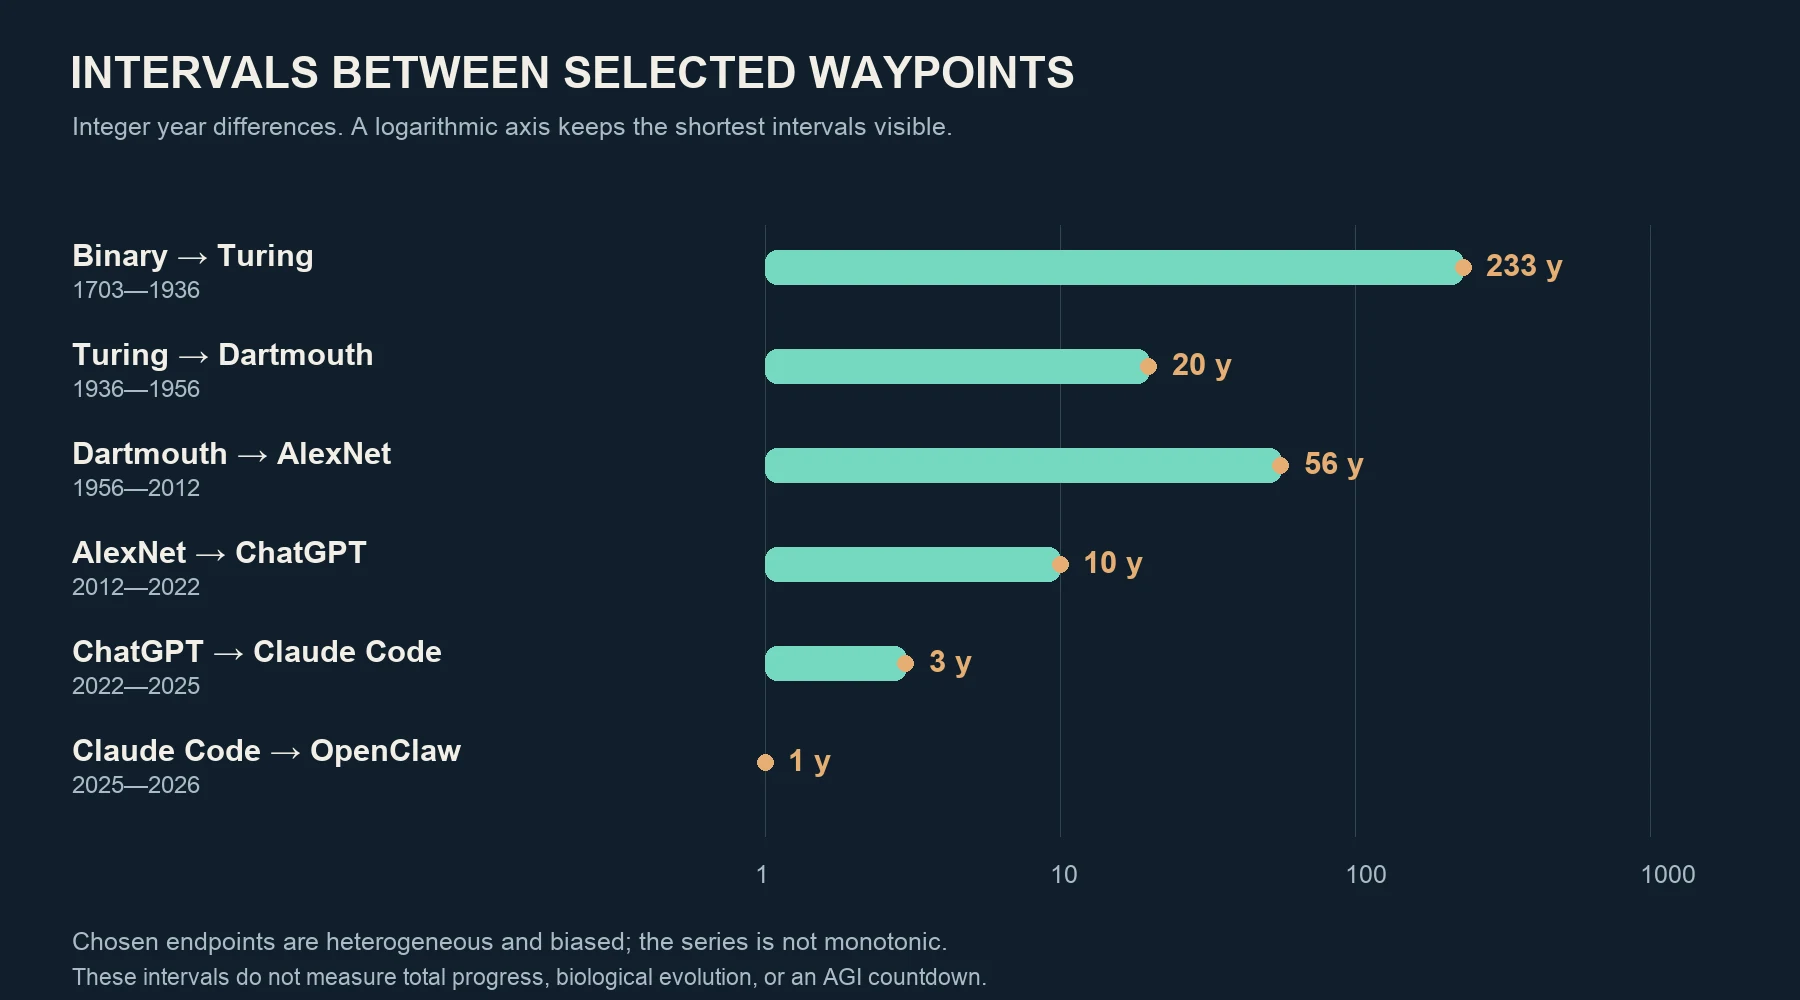
選んだ節目同士の間隔。1703—1936は233年、1936—1956は20年、1956—2012は56年、2012—2022は10年、2022—2025は3年、2025—2026は1年。棒の長さは対数尺度を用い、数値は整数の年の差である。選び方には偏りがあり、間隔も一様に短くなってはいないため、この図から知能の成長率を導くことはできない。
加速を裏づける、より確かな証拠は具体的な指標にある。Stanfordの2025年AI Indexによれば、MMLUでGPT-3.5相当の性能を得る推論コストは、2022年11月の百万token当たり20ドルから、2024年10月には0.07ドルに下がり、280倍以上の低下となった。特定の能力の水準でコストを比べたものであり、すべてのモデルが同じ倍率で安くなったという意味ではない。[28]
METRが2025年に発表した研究は、「どれほど長い仕事をこなせるか」に近い変化を観察している。同研究のソフトウェアと推論の課題集では、最先端AIが50%の成功率で終えられる課題に対応する人間の専門家の作業時間が、2019年以降、およそ7か月ごとに倍になっていた。この時間は、人間がその課題に要する時間だ。半分成功することも、信頼できる仕事の完了とは違う。将来へ外挿する理由を与える一方で、現実の仕事に広く当てはめるには大きな限界も残る。[27]
加速は、次の加速の条件もつくる。よりよいAIは、ソフトウェア開発、実験、システムの最適化を助けられる。その仕事が、次世代のAIを改善するかもしれない。ただし、フィードバックがあることは、無限に続くことを意味しない。データの質、エネルギー、半導体、実験の速度、信頼性、組織への導入が、ブレーキになることもある。歴史の低迷期は、しばらく上向いた曲線にも、その先に段差や後退がありうることを教えている。
私は2031年に賭ける。まずAGIの条件を書いておこう
AGIは通常、汎用人工知能と訳される。だが、「どこまで汎用的であればよいか」に統一された答えはない。経済活動の大半をカバーすることを求める人もいれば、未知の技能を学ぶことを重視する人もいる。自律性まで含める人もいる。AGIの段階を扱う研究は、能力の水準、適用範囲、自律の程度を分けて論じている。標語を巡って争うより、こちらのほうが役に立つ。[29]
本稿で扱うのは、実用的なAGIに限る。権限が明確なデジタル環境で、新しい課題を学び、許容できるコストで、幅広い専門的な認知作業を安定してこなせるシステムだ。意識は必要条件ではない。人の身体を持つ必要もないし、あらゆる分野ですべての人を超える超知能と同じものでもない。
予測を将来検証できるように、ここでは人為的な基準を設ける。本稿独自の操作的定義であり、業界標準でも、安全認証でもない。
| 評価項目 | 本稿で採用する基準 |
|---|---|
| 適用範囲 | ソフトウェア工学、資料分析、研究支援、マルチモーダル理解、計画、新しい道具の学習という6種類の課題のうち、少なくとも5種類で熟練者の中央値に達する。 |
| 未知の課題 | 各種類について少なくとも100件の非公開課題を用いる。訓練データへの漏洩を管理し、妥当な道具の使用と新しい課題の学習を認める。 |
| 信頼性 | 基準を満たす各分野で、課題の成功率が少なくとも90%。結果は、事前に定めた検証可能な基準で判定する。 |
| 長い課題 | 人間の専門家が少なくとも8時間かけて終える課題をテストに含める。各課題について、人への確認は最大2回まで。人間が繰り返し助けて成立させることは認めない。 |
| コスト | 推論、道具、確認、やり直しをすべて含め、課題当たりのコストが、同じ評価基準で人間が完了するコストを上回らない。 |
| 再現性 | 少なくとも2つの独立した評価機関が再現する。システムは90日間の継続評価で、その性能を維持する。見事な実演だけでは足りない。 |
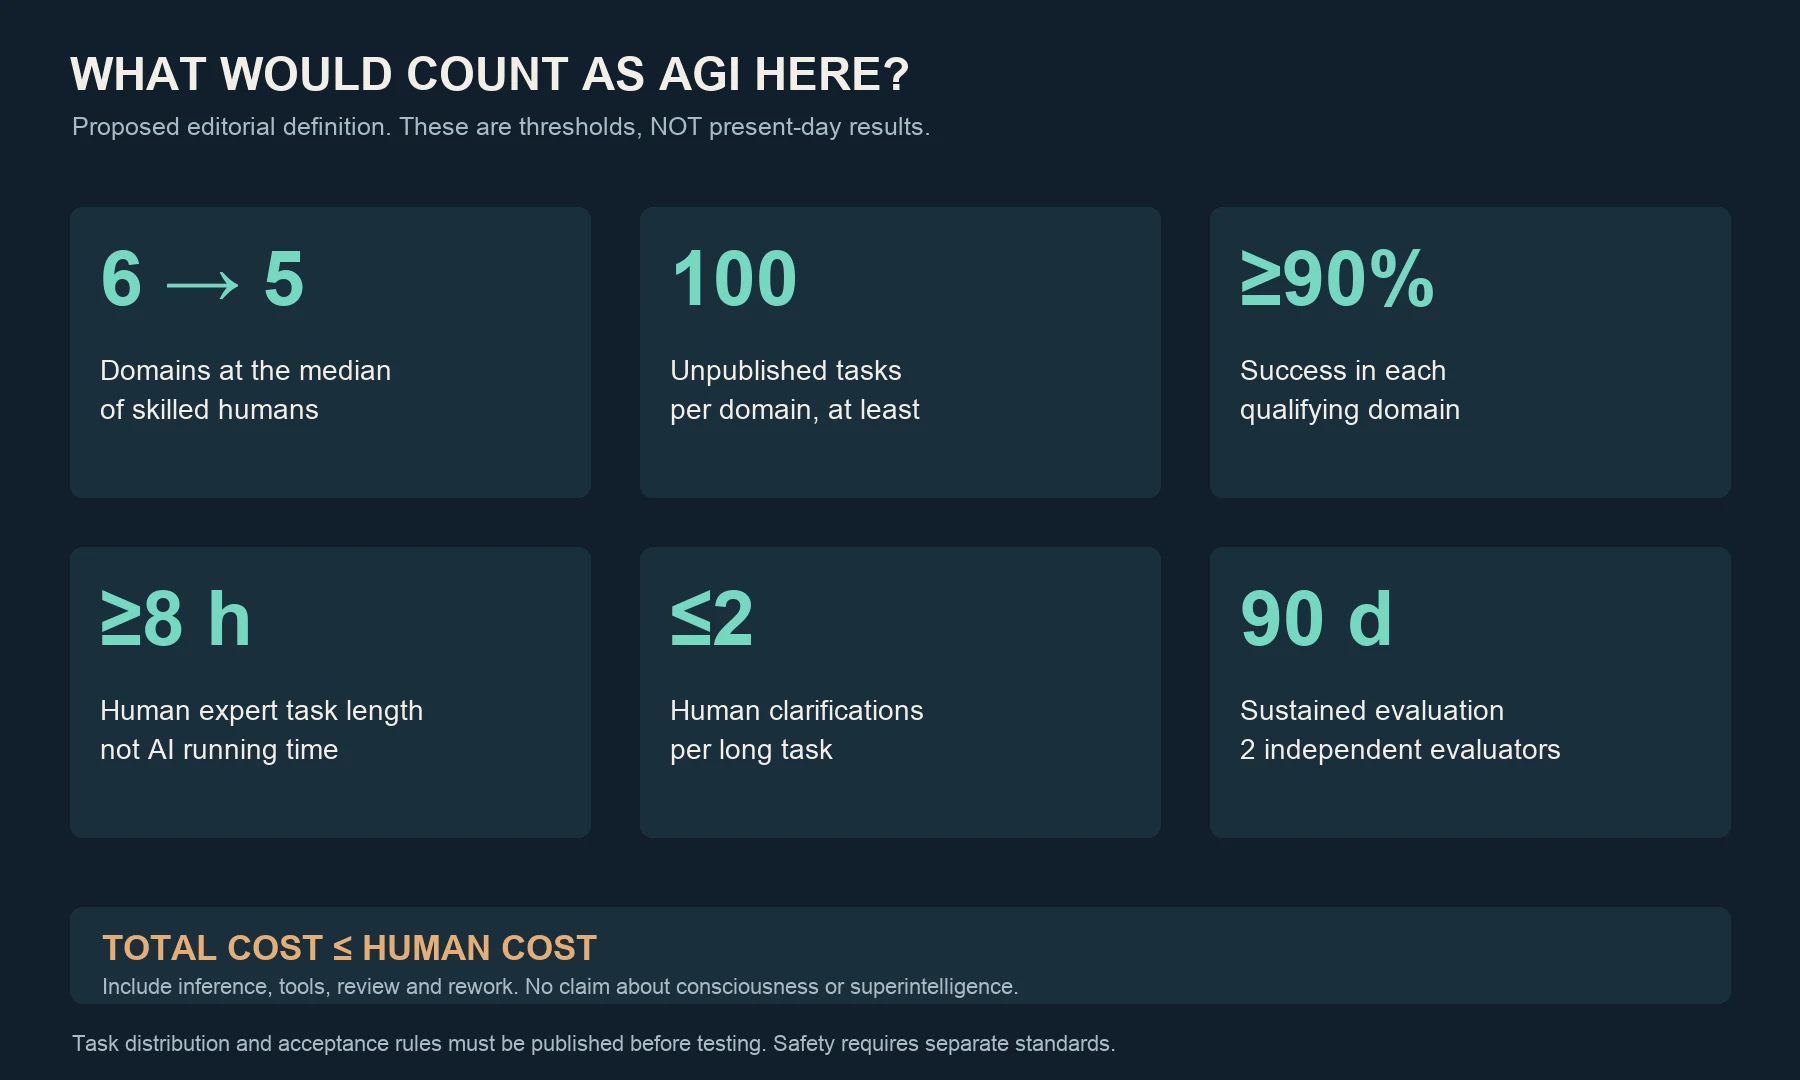
本稿のAGI基準の概念図。6種類のうち少なくとも5種類、非公開課題100件、成功率90%、人間の作業で8時間以上の課題、確認は最大2回、90日間の再現。数字は人為的に設けた評価条件であり、現在のシステムの実測値でも、広く合意されたAGI基準でもない。
この基準にも議論の余地がある。課題をどう抽出するのか、熟練者をどう募るのか、研究支援の成果をどう判定するのかは、事前に公表する必要がある。人の安全に関わる課題には、別の規制や専門的な基準も必要だ。ここでの目的は、「もう到達した気がする」という感覚を、疑い、再測定し、覆すことのできる判断へと変えることにある。
どうしても年を選ぶなら、私は2031年に賭ける。 特定の月日を当てるより、2028—2035年という期間を見ていたい。以下は、本稿の執筆時点における主観的な累積確率であり、上の基準で初めて独立した確認が得られる時期を表す。統計モデルで較正したものではなく、専門家の合意を表すものでもない。
| 初めて確認される時期 | 私の主観的な累積確率 |
|---|---|
| 2028年末まで | 20% |
| 2031年末まで | 50% |
| 2035年末まで | 75% |
| 2035年以後、または現在の路線では最終的に本稿の基準へ到達できない | 残り25% |
2031年は、この主観的な分布の中央値に当たる判断であり、技術上の期限ではない。2035年までの75%には、それ以前の確率も含まれている。各行を足してはいけない。残りの25%も、AGIが永遠に現れないことを意味しない。もっと遅く到来する場合と、現在の路線では行き着けない場合の両方を含んでいる。
こう賭けるのは、言語、視覚、プログラミング、道具の使用が合流しつつあり、長い課題をこなす能力とコストにも、真剣に考える価値のある傾向が見えているからだ。けれど、最も難しい部分は、最後に残っているのかもしれない。新しい技能を安定して学ぶこと、自分の誤りに気づくこと、未知の環境でも信頼性を保つこと、実験のフィードバックを必要とする仕事を終えること。これらが予想より手ごわければ、年は後ろへ動かさなければならない。[27][28][29]
何があれば判断を変えるだろうか。人の介入が少ない長い課題の成功率、未知の課題への転用、総コストが改善し続け、それが独立に再現されれば、早期の到来の確率を引き上げる。ランキングの上昇が慣れた問題に支えられているだけだったり、長い課題を人が引き継いでいたり、コストの低下が止まったりすれば、確率を引き下げる。発表会が増え、実演が密になるだけでは、判断は変わらない。
AGIの到来には、はっきりした鐘の音がないかもしれない。仕事の中で、もう十分に使えると気づく人がいる一方、失敗例に困り続ける人もいる。評価機関が能力を確認しても、社会が変わるのはその後だ。技術が基準を超える時期、製品が使われる時期、制度が調整を終える時期は、それぞれ違う。
楽観的な未来:人の能力が、今ほど希少ではなくなる
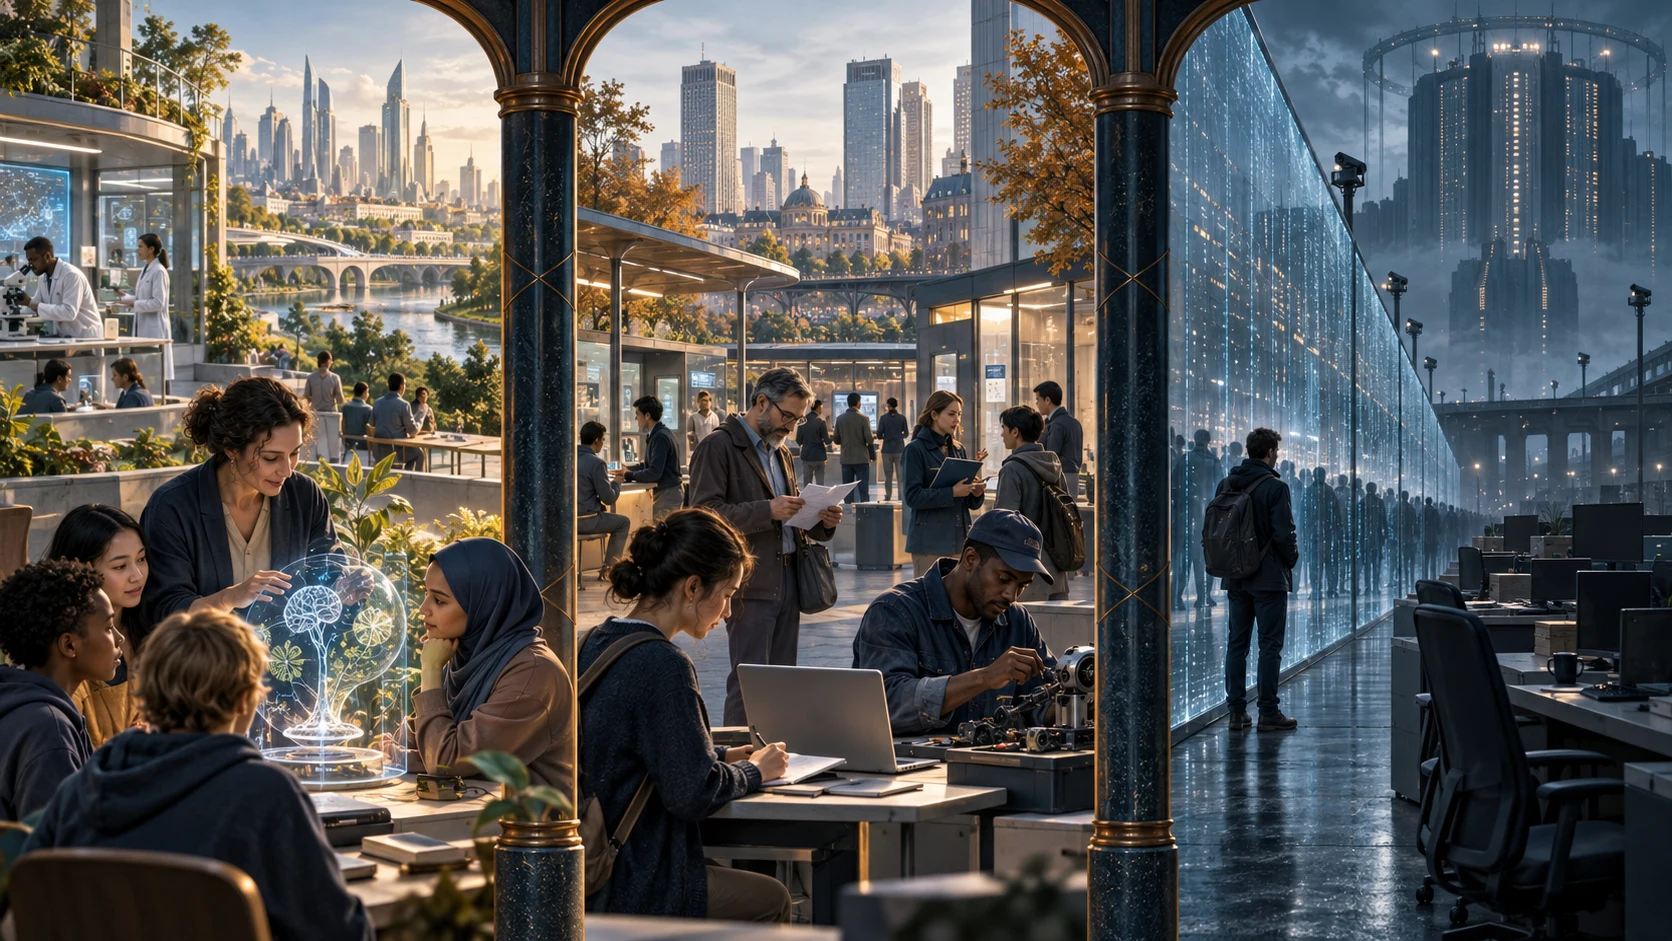
左は知識の共有と医療の進歩、中央は仕事の転換と日常の試行錯誤、右は権力の集中と失業の圧力。AIで制作したオリジナルの概念イラストであり、条件次第でありうる三つの未来を描く。発生確率を示したものではない。
楽観的な未来が成立するには、能力を広く利用でき、導入の信頼性が保たれ、社会が生産性向上の利益をより多くの人に分けようとする必要がある。最良のシステムを少数の組織しか買えないなら、この物語は最初から別の形になる。
科学では、AGIが文献を読み、実験の候補を設計し、結果を分析する研究者を助け、試行錯誤の中の繰り返し作業を減らせる。小さなチームが、かつて大きなチームにしかなかった計算と分析の能力を持つかもしれない。薬、材料、エネルギーの研究が速く進む可能性はある。ただし、候補分子の検証は必要で、臨床試験にも時間がかかる。実験装置を文章から生み出すこともできない。楽観的な変化とは、信頼できる結果へたどり着く速度が上がることであり、病気が一夜にして消えるという約束ではない。
教育や医療では、個人が、継続的で辛抱強い支援を、もっと安く受けられるようになる。教師は生徒ごとの違いに向き合う時間が増え、医師は患者の事情を理解する時間を持てる。遠隔地が最初に得るのは、より安定した質の情報整理、初期スクリーニング、遠隔支援かもしれない。それを公平な改善につなげるには、利用できる通信網、地域の言語、プライバシーの保護、そして最後の判断に責任を持つ人が必要だ。
仕事にも余裕が生まれるかもしれない。繰り返しの書類作成、照合、調整が減り、人は対話、判断、ケア、創造に時間を向けられる。小さな企業は、以前なら専門チームを雇えずに諦めたことができるようになる。普通の人も、アイデアを製品にしやすくなる。生産性の向上が、生活費の低下、労働時間の短縮、公共サービスの改善に変われば、多くの人の暮らしはよくなる。
これは自動的には起きない。賃金、税制、競争政策、公共投資が、利益をどう配るかを決める。よりよい技術が広げるのは、分けられるものの量だ。社会に代わって配り方を決めることはできない。この未来では、人の価値は「標準化された仕事をどれだけこなせるか」から、「何をしたいか、どんな責任を引き受けたいか、人とどう関わるか」へと、少しずつ重心を移していく。
楽観的であることは、学ぶのをやめることでもない。基礎知識があれば、機械がでたらめを言っていないか判断できる。専門的な経験があれば、結果を採用する価値があるかがわかる。変わるのは、学ぶ目的だ。すべての道具に追いつくためだけでなく、よりよい問いを立て、自分の判断を保つために学ぶようになる。
悲観的な未来:機械は強いが、社会が受け止められない
悲観的な未来には、機械の悪意は必要ない。労働を置き換える速さが転職や配置転換を上回り、利益が計算資源、資本、データ、流通の入口を持つ側に集中すれば、多くの人はまず収入を失い、後から経済統計で生産性の向上を見ることになる。
最初に圧力を受けるのは、仕事をデジタル化しやすく、成果を判定しやすい職かもしれない。職業全体に終わりを告げるべきではない。ひとつの職業には、さまざまな仕事が含まれている。それでも、初歩的な文章制作、基礎的な分析、簡単な開発、定型的な顧客対応への需要が大きく減れば、若者は難しい問題に直面する。経験を積むための入門の仕事がなくなったのに、高度な判断には依然として経験が必要なのだ。企業が新人を採らなくなれば、社会は専門家を育てるはしごを徐々に失う。
権力の集中は、この圧力を強める。少数の組織が最良のモデル、計算資源、実行の入口を支配すれば、価格だけでなく、誰が知識を得られるか、どう評価されるか、どんな情報が目に入るかにも影響を及ぼすかもしれない。知能が安くなれば、監視、詐欺、対象を絞った説得も拡大できる。情報は増えても、公共の議論で何が本当かを確かめることは、かえって難しくなりうる。
安全性には、もう別の層もある。能力の高いシステムでも、目標を誤って設定し、権限を広く与えすぎ、確認を欠けば、誤った行動を続けてしまうことがある。メッセージの誤送信、資料の漏洩、欠陥のあるソフトウェアの作成、さらには危険度の高い環境で実害を生む可能性もある。より極端な制御不能のシナリオには、欺くこと、監督を逃れること、より多くの資源を得ようとすることが含まれる。研究し、備えるべき仕組みではあるが、歴史の年表だけから、信頼できる発生確率を求めることはできない。
国家間でも、先進的なAIは、他国に遅れを取れない戦略資源と見なされるかもしれない。競争の圧力によって、組織が評価を短縮し、失敗を隠し、システムを重要インフラに接続するようになる。そのとき危険を生むのは、問題に誤答したことだけではない。多くの組織が、同時に大きすぎるリスクを引き受けることだ。兵器、サイバー攻撃、重要システムへの導入には、とりわけ権限、監査、隔離、人の責任を制度に組み込む必要がある。
個人に起きる損失は、もっと静かだ。判断を長く機械に任せ続ければ、書く力、推論する力、道を探す力、人と関わる力が弱まるかもしれない。便利さの中で、自立性を少しずつ失う。サービスが止まり、料金が上がり、答えが操作されたときになって、代わりの手段がないことに気づく。この未来では、技術が強くなっても、人が自由になるとは限らない。
中立的な未来:大きな変化と、長い調整
私が日常として想像しやすいのは、三つの未来が混ざった姿だ。ある仕事は急速に安くなり、ある職業はゆっくり形を変え、安全と責任のために人が主導し続ける分野もある。成功する企業もあれば、導入に失敗する企業もある。時間を得る人がいる一方で、交渉力を失う人もいる。
AGIがまずデジタルな仕事で本稿の基準に達したとしても、すぐに水道管を修理し、高齢者を介護し、送電網を建設できるとは限らない。現実の世界には、身体、材料、場所、責任の連なりがある。ロボットの製造、インフラの更新、承認、組織の手順には、別の時間が必要だ。認知労働のコストが先に変わっても、住宅、エネルギー、医療の価格まで同時に下がるとは限らない。
雇用への影響は、まず仕事の組み替えとして現れる可能性が高い。チームでは初稿を作る人が減り、検収や調整が増える。ひとりがより多くの案件を管理し、同時に、間違いの責任も多く負う。生産性と仕事の強度が、一緒に上がることさえありうる。ILOの生成AIによる職業への影響を扱う研究も、仕事の一部が影響を受けることは、雇用全体が必ず置き換わることとは違うと示している。この見方を、そのままAGIの雇用への影響の予測へ格上げすることはできない。それでも、分析には残しておくべき区別だ。[30]
制度は、現実の後を追って学び直す。学校は評価を見直し、企業は権限を組み替え、裁判所や規制当局は責任を扱う。保険と監査は、リスクに値段をつけ始める。多くの現場は、「原則として実行できるが、重要な節目では人が署名する」という形で移行するだろう。社会全体を一度に更新するというより、議論を伴う修繕の連続に近いはずだ。
人の心理の変化も、道具の変化より遅れる。身につけた技能が突然希少でなくなれば、悔しさや不安が生まれる。新しい能力には心が躍るが、いつまでも追いかけ続けることに疲れるかもしれない。効率が上がっても、自己像が自然に落ち着くわけではない。ケア、友情、身体の経験、美意識、社会への参加は、これからも人が暮らしを組み立てるうえで大切な軸になる。
だから、2031年に賭けるとしても、「その年から誰もが失業する」とは賭けない。「その年から誰もが豊かになる」とも賭けない。技術の突破は集中して起きても、社会への影響は地域、産業、人々によって異なる。中立的な未来とは、変化が小さい未来ではない。変化が大きく、結果が不均等で、調整に時間がかかる未来だ。
本当に備えるべきなのは、判断と選択だ
この歴史は胸を高鳴らせる。同時に、少し目がくらむ思いもする。そろばんは、指で珠をはじいたときだけ計算する。今日の機械は、曖昧な依頼を受け止め、それを終える方法を探し始める。私たちはますます多くの認知的な仕事を頭の外へ移しながら、どう検収し、どう責任を持ち、どう利益を分けるかを、まだ学んでいる。
個人が守っておきたいのは、専門の基礎、確かめる習慣、他の場面にも持ち運べる技能、単一のサービスに頼らない仕事の仕方だ。企業が投資すべきなのは、検証できる手順、実際の仕事での評価、明確な権限、元に戻せる操作である。社会にとって最も難しいのは、生産性の向上を少数の人だけの優位にせず、安全への要求を声明だけで終わらせないことだ。
AGIの年への賭けは、外れるかもしれない。だが、もっと外してはならない賭けがある。機械が十分に賢くなれば、人類には自動的によい未来が訪れる、という賭けだ。そろばんから今日まで、道具は人の力を広げ続けてきた。次に答えるべきなのは、その力を誰が持ち、どう使い、それでどんな暮らしを望むのかである。