
この世界は、やっぱりどこか行き当たりばったりだ。
普段 AI 業界を見ていると、もう未来の入り口に立っているような気になる。モデルはコードを書き、難問を解き、エージェントは業務の流れを丸ごと引き受けようとしている。人間にどれだけ仕事が残るのかという議論も、日に日ににぎやかになる。ところが、いざ仕事を任せようとすると、画面にはいつまでたっても答えが出てこない。
AI 業界の手本と見る人も多い DeepSeek でさえ、肝心なところでつまずく。
DeepSeek が公表した通知によると、2026 年 10 月 15 日の北京時間(UTC+8)8 時 11 分から 13 時 4 分まで、サービスシステムに障害が発生し、その間は API を正常に利用できなかった。記載された開始時刻と終了時刻から計算すると、4 時間 53 分。ほぼ 5 時間である。「半日も落ちていた」は腹立ちまぎれの言い方だとしても、午前中の大半が使えなくなったのは事実だ。[1][2]
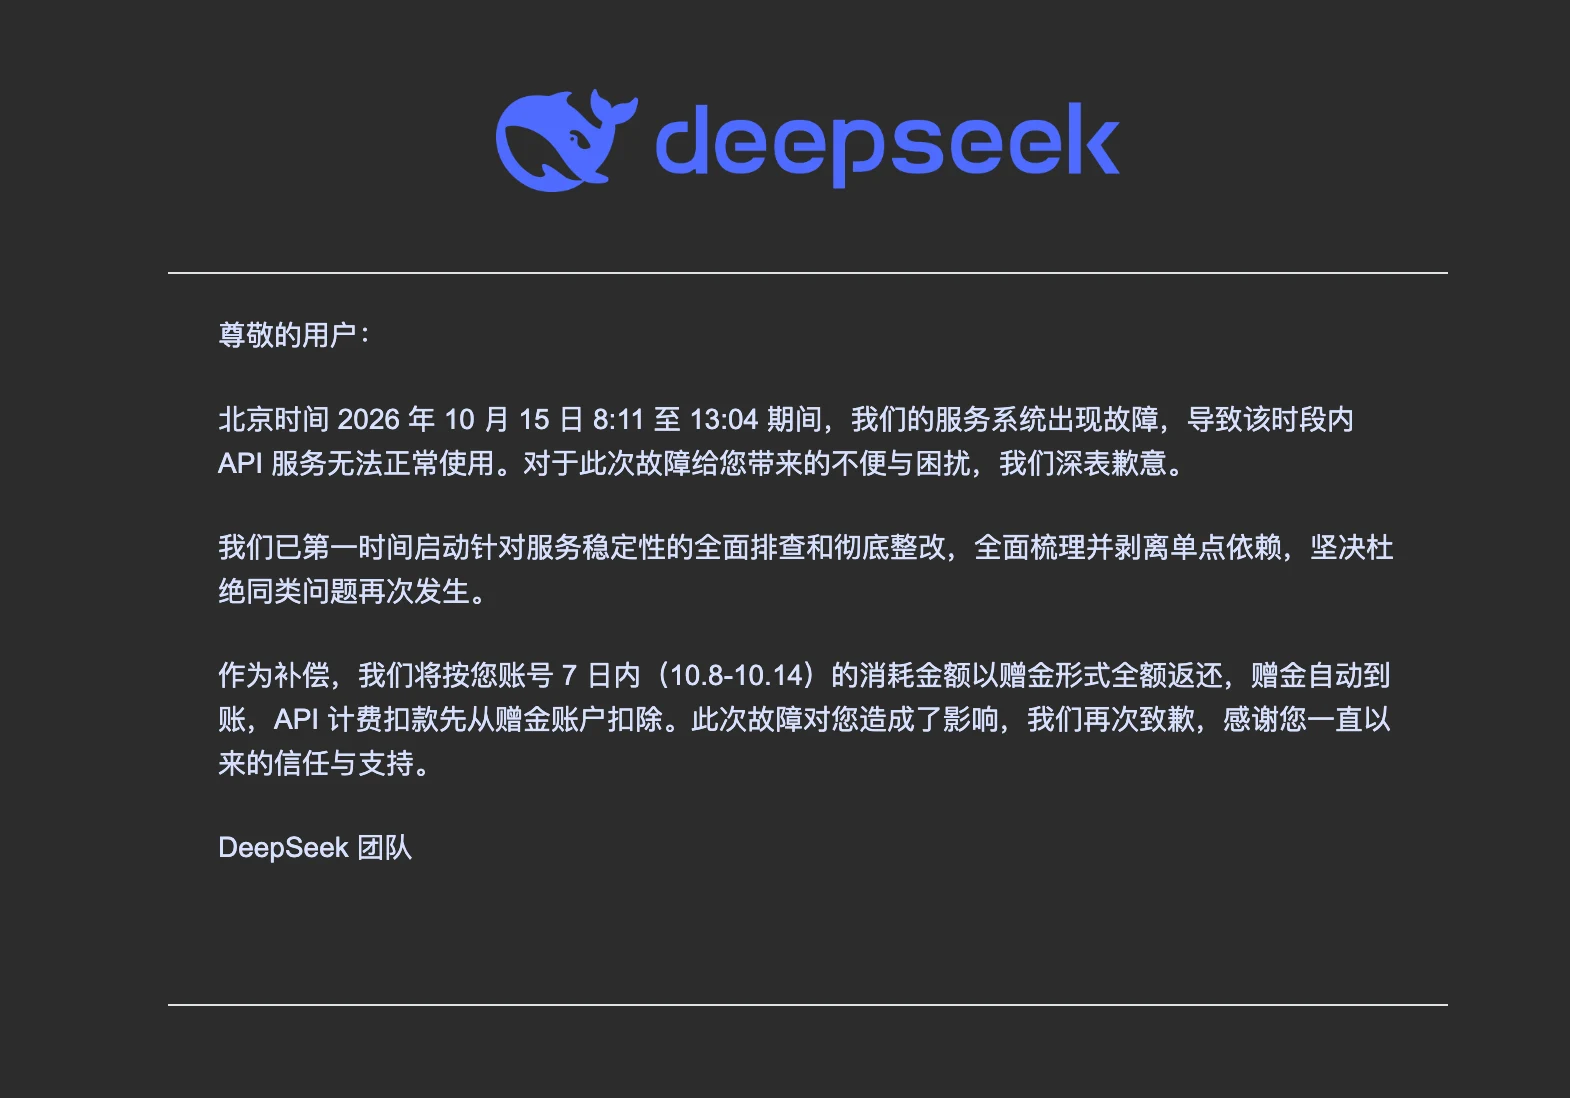
DeepSeek のサービス復旧・補償通知。読者提供。通知の時刻と補償内容は、同日の報道と一致している。
雑談をしているだけなら、しばらく話すのをやめれば済む。しかし、API が製品やカスタマーサポート、コンテンツ処理、社内の業務フローに組み込まれていれば、上流の停止で下流も待たされることになる。利用者が求めるのはあなたの納品であり、顧客が連絡する相手はあなたのチームだ。普段はモデルが優秀な答えを出すからといって、この数時間の空白を受け入れてもらえるわけではない。
今回の障害で改めて思い知らされるのは、モデルの能力とサービスの信頼性は、それぞれ別に評価されなければならないということだ。
モデルが問題に正しく答えられるかどうかと、業務で必要なときにその答えを届けられるかどうかは、別の話である。前者はランキングや発表会で注目されやすい。後者が真剣に議論されるのは、たいてい何かが壊れてからだ。実際に AI を頼りに仕事をする人にとっては、どちらも欠かせない。
「結局、行き当たりばったりなのか」というため息は、この落差から生まれる。目に見えるのは、宇宙を語り、プログラムを書く知能だ。それを支えているのは、故障する機械とソフトウェア、そして人間である。どれだけ技術的な威光があっても、監視、冗長化、障害復旧という具体的な仕事から逃れることはできない。
それでも、不満は不満として、今回の DeepSeek の補償は公正に評価してよい。
通知では、各アカウントの直前 7 日間、つまり 10 月 8 日から 10 月 14 日までの実際の利用額を、同額のクレジットとして全額還元するとしている。クレジットは自動で付与され、その後の API 料金はクレジット残高から優先的に差し引かれる。[1][2]
例えば、その 7 日間に 100 元を使ったアカウントなら、通知の条件では 100 元分のクレジットを受け取る。障害が起きた数時間に相当する料金だけを補償するのではなく、直前 1 週間分の利用額を補償の基準にした。この対応には誠意がある。
もちろん、クレジットの付与は現金での返金とは違う。これから 7 日間、好きなだけ無制限に使えるという意味でもない。金額は指定された過去 7 日間の実際の利用額で決まり、今後の API 料金に充てられる。この点を正確に説明しても、今回の補償を評価する気持ちは少しも損なわれない。
責任ある対応だと感じるのは、障害に対して明確な費用を負担し、利用者が一人ずつ証拠をそろえて何度も申請する手間も省いているからだ。今後もこのサービスを使う開発者には、自動で付与され、そのまま料金に充当される仕組みに実用的な価値がある。
この補償の価値は、会社に「お金に困っていない」という札を貼ることにあるのではない。謝罪の言葉を、利用者が実際に使える残高に変えた。その点こそ、今回の対応で評価したいところだ。
ただし、補償を褒めることと、障害そのものを良い出来事にすることは違う。
API の請求額以外にも、業務の中断、納期の遅れ、顧客の離脱というリスクがある。クレジットだけでは、すべてのチームの損失を埋められるとは限らない。お金は補えても、失った時間と傷ついた信頼の回復には、もっと時間がかかる。今回の対応は評価されてよいし、同時に、安定性について問い続けられるべきでもある。
通知では、単一障害点となる依存関係を洗い出して切り離すとも述べている。[1] これほど強力なモデルを使うサービスが、何に足を止められたのだろう。障害が始まったのは北京時間の 8 時 11 分。この時刻から、確かめてみる価値のある可能性が一つ浮かぶ。夜間に入れた変更の弱点が、朝のアクセス増で露呈したのではないか。
先に線を引いておこう。DeepSeek は、この通知で技術的な根本原因を明かしていない。夜間にリリースがあったのか、朝のトラフィックが大きく増えたのかも、ログと監視データで確かめる必要がある。ここでは、この一つの可能性に沿って、何が起こり得るかをたどってみる。
夜間に、ある共有サービスが更新されたと仮定する。モデルにリクエストを渡す前に、API キーと利用可能な残高を確認するサービスだ。新しいバージョンは動くし、チェックも通る。ただ、以前はキャッシュから読めた確認処理が、リクエストのたびにデータベースを照会する形に変わっていた。このサービスも変更内容も例であり、DeepSeek の内部実装として確認されたものではない。
夜間はリクエストが少ない。照会が 1 回増えても、大したことには見えない。API は応答し、テストでもエラーは出ず、監視画面も緑のままかもしれない。けれど、システムの処理能力は、その時点ですでに少し失われている。
朝になり、みんなが仕事を始める。製品からの呼び出しやバックグラウンド処理が次々と流れ込む。やがて、リクエストが届く速さが、その共有サービスの処理速度を上回る。リクエストがデータベースへの接続待ちで列をなし、待機中のリクエストがさらにリソースを占有し、後から来たリクエストはもっと長く待たされる。
朝食を出す店で、レジが一つしか開いていないようなものだ。厨房は料理を作れるし、料理人もいる。それでも客は全員、まず同じレジを通らなければならない。入り口が詰まれば、奥にどれほど大きな厨房があっても力を発揮できない。
ここから、問題は自分で膨らみ始める。呼び出し元は結果を待ちきれず、タイムアウトして再試行する。下流の製品も、利用者の代わりに再試行しているかもしれない。前のリクエストが速やかに取り消されていなければ、古い仕事が終わらないうちに新しい仕事が押し寄せる。本来の業務量は急増していなくても、システムが受けるリクエストは雪だるま式に増え得る。
こうなると、バージョンを戻しても、すぐ復旧するとは限らない。たまったリクエストは残り、接続プールは回復せず、外からは再試行が扉をたたき続ける。ひと息ついたところで、また負荷に押しつぶされる。復旧には、流入制限、無駄な再試行の停止、期限切れ処理の破棄を同時に進め、少しずつトラフィックを戻す必要があるかもしれない。コードを直すことと、システムを立ち直らせることは、ときに二つの別の戦いになる。
この筋書きでは、変更が問題を埋め込み、トラフィックがそれを表に出し、滞留と再試行がさらに増幅する。高価な推論クラスターは一斉に壊れたのではなく、そこへ至る狭い入り口でリクエストが詰まっているだけかもしれない。単一障害点も、ぽつんと置かれた 1 台のサーバーとは限らない。複数のレプリカがどれも避けて通れない、同じ依存先であることもある。
似た増幅の仕組みには、公開された実例がある。Google Cloud の 2025 年 6 月の事後報告では、クォータのポリシーデータが Service Control のクラッシュを引き起こした後、復旧中の集中的な再起動が基盤のデータベースに負荷をかけ、一部地域の復旧を遅らせたと説明されている。[3] 「最初の原因を直しても、システムの混雑は続き得る」という説明には、技術的な筋が通る。ただし、DeepSeek でも同じことが起きたと断定する材料にはならない。
この筋書きを確かめるには、いくつかの時系列を重ねる必要がある。障害前に何を変えたのか。いつトラフィックが増えたのか。共有サービスの遅延、待ち行列、接続使用量はいつから異常になったのか。再試行はそれに伴って増えたのか。切り戻しや流入制限の後には何が起きたのか。これらが順序立ててつながれば、仮説には重みが出る。8 時 11 分という時刻は、問いを立てるきっかけにはなるが、原因究明の完了を宣言するには足りない。
「同様の問題を二度と起こさない」は約束だ。その約束が果たされたかどうかは、今後のサービスの記録が答える。
今回の件は、AI を業務に組み込むすべての人への注意喚起でもある。使えなくなったときの道筋を用意しておきたい。
重要な業務では、上流のモデルが一時的に利用できなくなったとき、処理をキューに入れられるか、検証済みの代替サービスに切り替えられるか、人の手に戻せるかを考えておく。再試行が必要なら、回数を制限し、間隔を徐々に広げ、実行時刻も分散させたい。上流の障害に油を注いではいけない。特に、支払い、メッセージ送信、データ変更を伴う処理では、復旧後の二重実行を防ぐ仕組みも欠かせない。
こうした準備には未来らしい華やかさはない。それでも、次の障害が起きたときに、今の事業を守ってくれる。AI を真剣に使うほど、「これほど強い会社なら問題は起こさないだろう」という期待だけに、すべてを預けるわけにはいかない。
DeepSeek がほぼ 5 時間も止まったことには、不満を言って当然だ。大きな期待を集める AI サービスも、信頼性という課題にきちんと取り組まなければならない。一方、直前 7 日間の利用額をクレジットで補償したことは評価できる。問題を認め、費用を負担し、安定したサービスを積み重ねて信頼を取り戻す。その姿勢は、後押しされてよい。
世界は本当に、思った以上にその場しのぎなのかもしれない。私たちには失敗を減らすよう求める理由があるし、誰かが責任を引き受けたときには、「今回は誠実な対応だった」と言う理由もある。