
17歳といえば、将来何をしたいのかを聞かれることも多い年齢だ。陳広宇は、すでに大規模言語モデルの基盤となるアーキテクチャの研究に参加していた。2026年3月16日に投稿された論文「Attention Residuals」では、張宇、蘇剣林とともに共同筆頭著者として名を連ねている。[2]
10月15日、彼はXで、最近Kimiを離れたと発表した。計算カーネル、注意残差、最適化手法などの仕事を振り返り、当時16歳だった自分を信じ、採用してくれた杜雨倫に特に感謝を伝えた。この別れの投稿で、次の勤務先は明かされていない。[1]
これを「神童の物語」と呼ぶこともできるだろう。しかし、学びと仕事の足跡をたどると、もっと考えたい問いが見えてくる。若者はどうすれば短期間で、知識を受け取る側から最先端の課題に取り組む側へ移れるのか。そしてAIは、その変化をどう大きくできるのか。
学びと協働のつながりを表す概念イラストであり、陳広宇本人の写真ではない。
成長の道筋と公開された記録
| 項目 | 公開資料でわかること |
|---|---|
| 氏名 | 陳広宇、Nathan Chen。論文での署名はGuangyu Chen。[2] |
| 年齢と育った場所 | 2009年生まれ、深圳で育つ。2026年の報道時は17歳。[6] |
| 学校 | 華潤小径湾ベイシス国際学校。2026年3月の論文公開時は12年生。[13] |
| それまでの取り組み | アルゴリズムを使ったプログラミング、個人の技術ブログ、オープンソースプロジェクト、機械学習の小さな実験。[9][12][15] |
| 研究歴 | Tilde Researchでインターンを経験した後、Moonshot AIのKimiチームに参加。[5][6] |
| 主な公開された仕事 | MoMoEプロジェクトの著者の一人。Attention Residualsの同等貢献著者の一人として、Block AttnResの提案に参加。[2][4][7] |
| 最新の公表事項 | 2026年10月15日、最近Kimiを離れたと発表。別れの投稿で次の勤務先は明かしていない。[1] |
彼の成長を「知識ゼロから、わずか数か月で躍進」と描けば、重要な積み重ねを見落とす。個人サイトには、2024年と記された決定木のプロジェクト記事がある。日常の観察をデータにまとめ、予測モデルの学習を試みる一方、変数の選び方や推論の過程には厳密さが足りなかったと自ら指摘している。この小さな実験が示すのは、観察から問いを立て、データと検証につなげる習慣だ。[12]
GitHubのプロフィールにはCodeforcesのアカウントへのリンクもあり、手のジェスチャーを認識するプロジェクトgestureXも紹介されている。アルゴリズムの練習やものづくりは、後の大規模言語モデル研究と同じではない。それでも、これらの公開された足跡は、新しい分野に速く入っていく力が、それまでに培った実装力にも支えられていることを教えてくれる。[15]
公開された記録は、さらに2023年までさかのぼる。本人のプロジェクトページでは、OpenTeensを青少年向けのオープンソースコミュニティとして紹介し、自身を共同発起人としている。同年のオープンソースイベントの主催者も、議事日程で陳広宇をその立場で紹介した。プロジェクトページには、ジェスチャー認識や海岸のごみ検出などの試みも載っている。継続的なものづくりとコミュニティ参加の経験があり、2025年に初めてAIに触れたと単純にまとめることはできない。[17][18]
2025年2月の中高生向けハッカソンは、もう一つの節目だった。ThirdArmに関する構想を持って参加し、董科含と知り合い、その後さらに先端の研究者や課題に触れるようになった。同年夏にはTilde Researchでインターンを経験し、11月にKimiに参加。2026年3月には、AttnResの論文が公開されていた。[2][5][6][23]
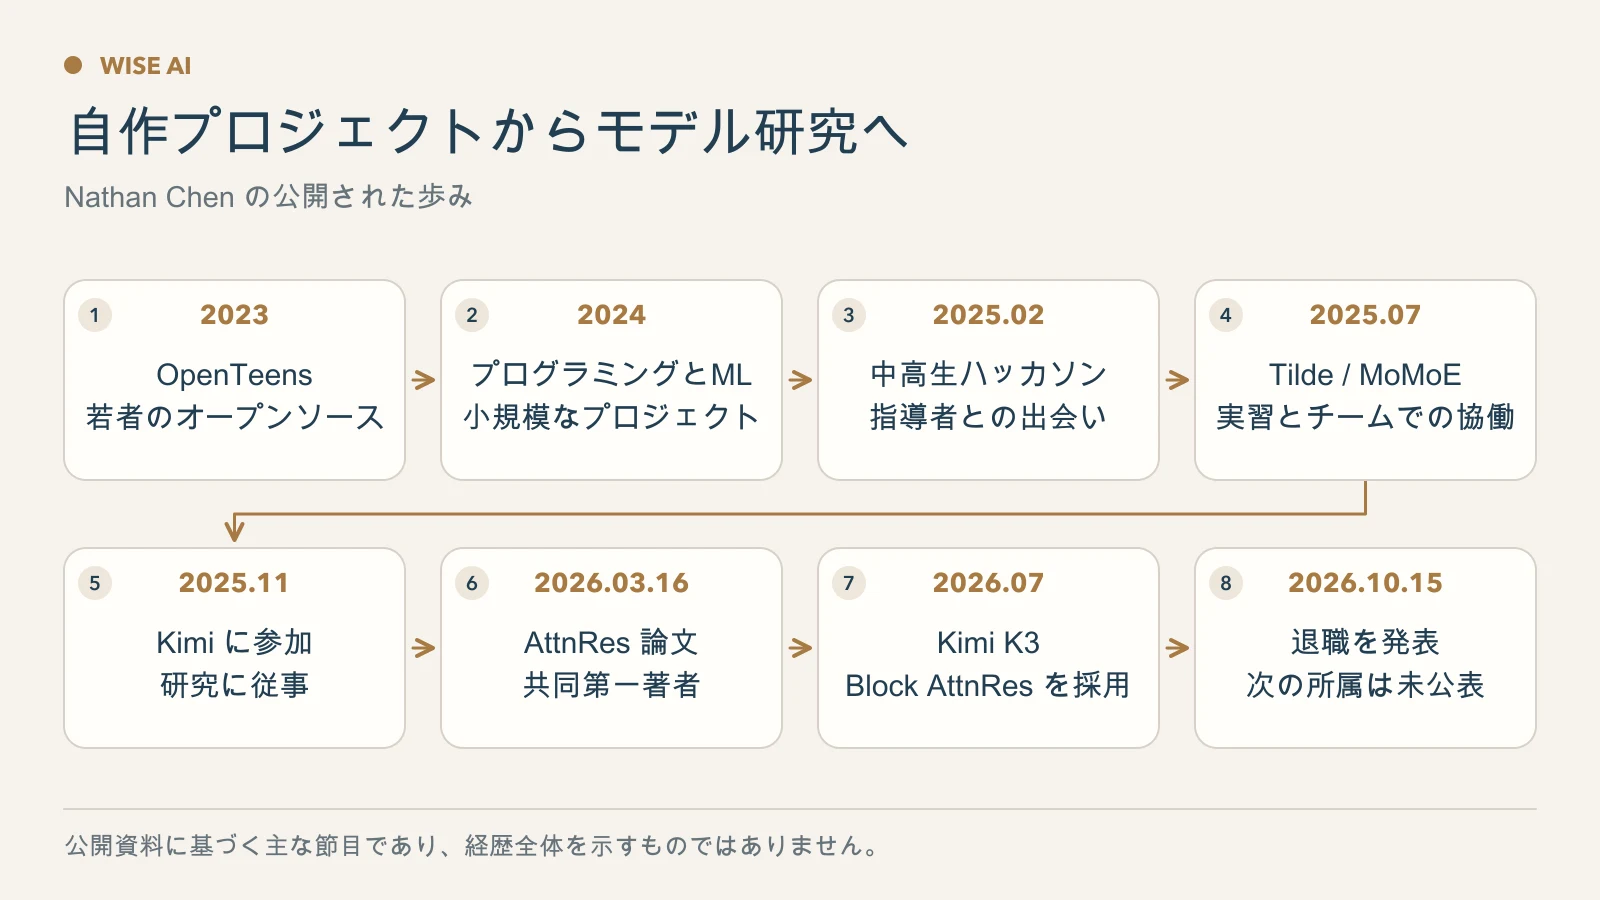
年表は本人の記事、研究論文、機関の記録、本人の退職報告を基に整理した。機械学習に触れ始めた時期と、その後Transformerの研究に集中した時期は異なる段階に当たる。[1][2][5][11][12][14][18][23]
2026年4月11日の清華大学・姚クラスのセミナー告知では、彼と張宇が登壇者として掲載され、Moonshot AIのScalingチームの研究者、AttnResの主要著者と紹介されている。これは研究交流の具体的な記録だ。彼の仕事が、すでに同じ分野の研究者と議論できる内容を持っていたことがわかる。[14]
AIへの質問から、同じ分野の研究者に見つけてもらうまで
陳広宇は深圳出身で、英語名はNathan Chen。2026年3月の論文発表時には、まだ高校生だった。2025年夏にTilde Researchでインターンを経験し、同年11月にKimiに加わった。大学や大学院に進んでから迎えることの多い節目を、すでにいくつも通過していた。[6][23]
本人の回想によると、2025年に中高生向けハッカソンに参加した後、董科含と知り合い、その紹介でDeepSeekの研究者、袁境陽と接点を持った。学び始めた頃は論文を読み、理解できない部分のスクリーンショットをGeminiに渡して説明を求め、繰り返し質問した。同時にGitHubのコードや研究者のブログも読んだ。重要な判断については、引き続き人間の指導者にも相談していた。[5]
この方法の価値は、疑問への応答が速くなることにある。数式、概念、コードの一節がわからなくても、次の授業まで説明を待つ必要がない。学ぶ人は目の前の問いに合わせて行き来しながら、導出や実装、検証を続けられるところまで理解を進められる。
AIの説明にも誤りはあり得る。理解が正しいかどうかは、最終的に論文、コード、実験で確かめなければならない。陳広宇が後に公開したTritonとFlashAttentionのチュートリアルは、GPUのメモリアクセスやカーネルの実装を具体的に扱っている。読者は、学習の速さについての本人の説明を聞くだけでなく、コードをたどって理解を確かめることができる。[8]
公開された記録には、遠回りも残っている。2025年5月の最適化手法に関する課題の記録では、AIを使って概念を理解し、資料を探し、導出と実験を行ったものの、学習を終えてから課題の意図を取り違えていたと気付いたと書いている。それでも、過程と問題点を書き残した。学びが速くなっても間違いは起こるし、間違いを見つけて説明すること自体も能力の一部だとわかる。[21]
その学びは、同じ分野の人に見つけてもらう入口にもなった。本人の説明によれば、技術についての考察を公開したことで、シリコンバレーのAIスタートアップの責任者の目に留まり、対話とインターンの機会につながった。その後、TildeのオープンソースプロジェクトMoMoEの著者一覧にNathan Chenの名前が載り、具体的な協働の成果が残った。[5][7]
MoMoEは混合エキスパートモデルの実装、特に学習やファインチューニング時のメモリ効率と計算性能を扱う。後にAttnResが扱う層間の情報の組み合わせとは別の課題だが、アルゴリズムを理解し、ハードウェア上で効率よく動かすという共通した姿勢が見える。著者一覧からプロジェクトへの参加は確認できるが、それだけで各人がどのコードを書いたかまで特定することはできない。[7]
この点は、若い人が特に参考にできる。問いを深く考え、動くものをつくり、その過程を書き残せば、面識のない人にも仕事を直接判断してもらえる。個人サイト、技術ブログ、オープンソースへの貢献は、履歴書とは別の証拠になる。
共同筆頭著者として、何に貢献したのか
陳広宇が参加したAttention Residualsは、大規模言語モデルの異なる層の間で、情報をどう受け渡し、まとめるかを研究するものだ。
一般的な残差接続は、それまでの各層の出力を順次足し合わせる。AttnResはモデルの深さ方向に注意機構を導入し、後の層が、それまでの表現を選択的に重み付けして集約できるようにする。扱っているのは層と層の間の情報の組み合わせであり、チャットボットが「もっと前の一言を覚える」ことと単純に捉えることはできない。[2][3]
この設計を大規模な学習に使おうとすると、GPUメモリや通信の負荷が問題になる。蘇剣林は研究の回想で、最初の着想と小規模な実験は自分が始めたと説明している。その後、陳広宇と張宇がより大きな規模での検証に参加し、共同でBlock AttnResを提案した。層をブロックに分けることで、実装に伴う負担を抑える設計だ。[4]
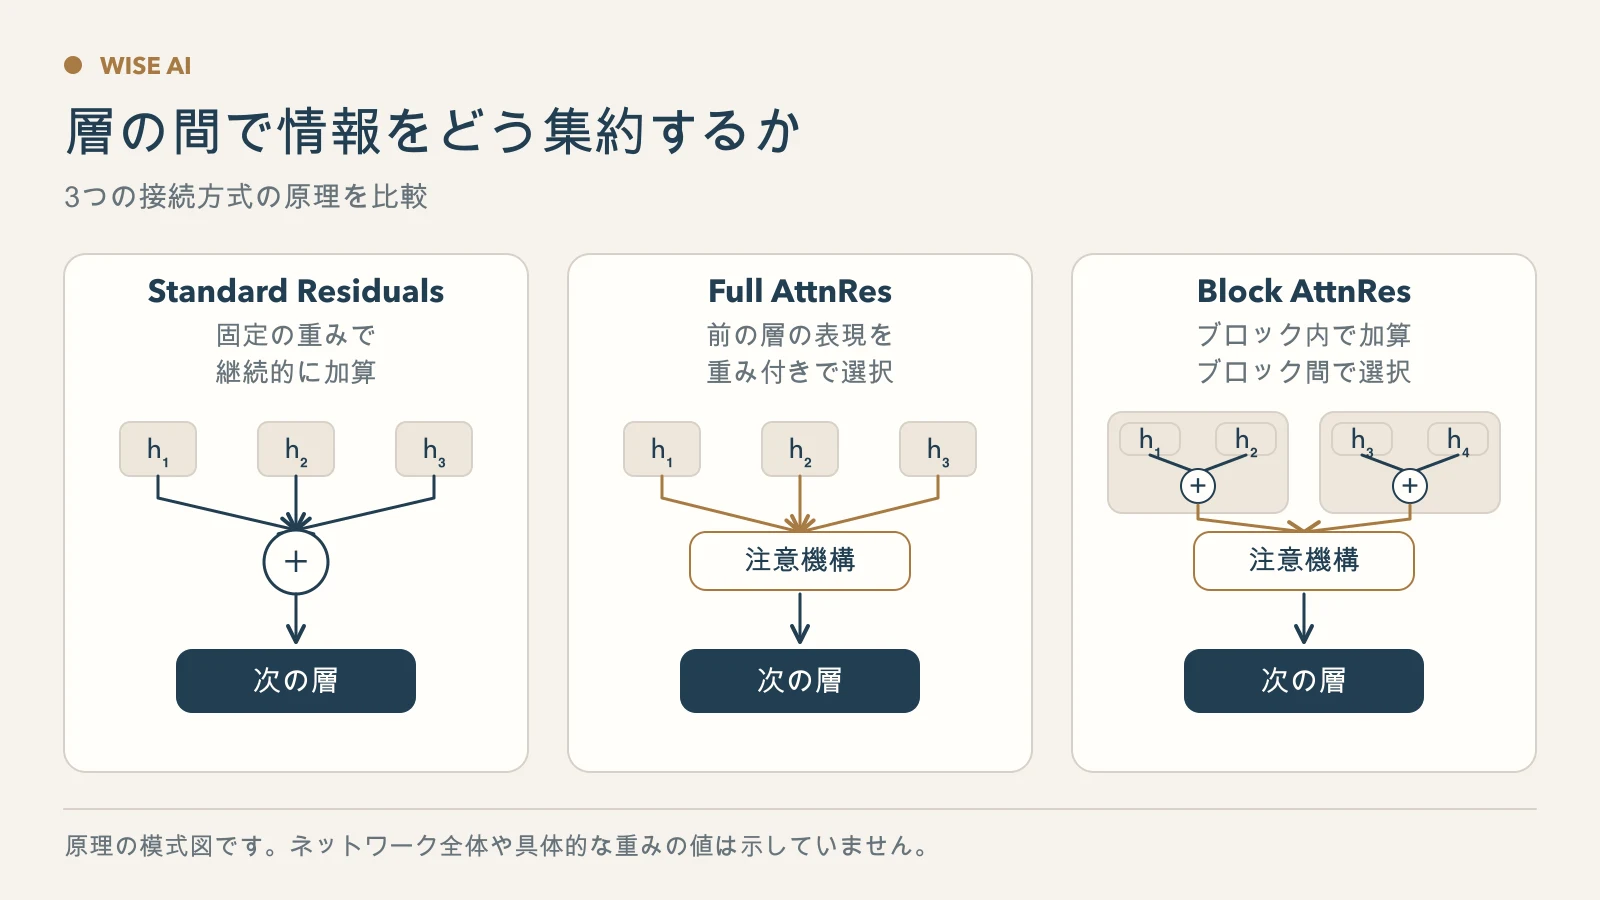
編集部が作成した原理の模式図。標準的な残差接続は加算を続け、Full AttnResは前の層の表現を選び、Block AttnResはブロック間で選択を行う。ネットワーク全体の構造を描いたものではない。[2][3]
彼の貢献は、原理の理解、手法の設計、工学的な制約への対応にまたがっていたことがわかる。有効な着想も、実際のシステムに入るまでには実験と実装を重ねる必要がある。若い研究者も、その過程で重要な仕事を担い、経験豊富な研究者と成果の評価を分かち合うことができる。
プロジェクトの公式資料によると、そのスケーリング実験では、Block AttnResは、ベースラインが1.25倍の学習計算量を使って到達する検証損失の水準に達した。換算すると、同じ損失水準に達するための計算量が約20%少ないことになる。これは特定の実験条件に基づく数値であり、あらゆるモデルやKimi全体の実際の支出が20%減ると、そのまま受け取ることはできない。[3]
彼が提案に参加したBlock AttnResは、その後Kimi K3にも採用された。技術報告にも、この設計について明確な説明がある。これにより、貢献がさらに広がる道筋が生まれた。基盤部分の改良はモデルシステムの中で繰り返し使われ、個人の限られた仕事が、チームとソフトウェアを通じて、その人の作業時間をはるかに超える範囲に作用し得る。K3全体の性能は、複数の技術と学習の取り組みが組み合わさった結果であり、一つの設計や一人の人にすべて帰することはできない。[11]
計算カーネルや最適化手法にも取り組んだ
退職を伝える投稿で、陳広宇は初期の仕事の一つにKDAの計算カーネルの最適化を挙げ、張宇と多くの設計を試したと述べた。計算カーネルはアルゴリズムをGPU上で実行する役割を担い、その効率はデータの読み書きや再利用の方法に大きく左右される。彼の仕事は、モデルの設計とシステムの実装の両方に及んでいた。[1]
オープンソースのコードには、さらに詳しい記録が残っている。FLAプロジェクトは2025年9月、彼が提出したDeltaFormerモデルの実装をマージし、同年12月には、彼が参加したKDAの逆伝播処理を担うカーネルの融合に関する変更もマージした。コード、レビュー、マージの過程が残されており、具体的にどのような実装に参加したかを外部から確かめられる。[19][20]
また、最適化手法の研究から、学習のダイナミクスについて最も多くを学んだとも述べている。最適化手法は学習時のパラメータの更新方法を決めるもので、残差接続とは別の問題だ。個人ブログの一覧にも、最適化手法の分析に加え、行列積、FlashAttention、Tritonの実装チュートリアルがある。学び続けてきた範囲を示す資料だが、すべてを、本番モデルに採用された独自の成果と自動的に数えることはできない。[1][8][16]
具体的な仕事を見ると、一つのひらめきだけで著者に加わったわけではないことがわかる。論文を読み、実装を理解し、設計を試し、実験を行い、制約に対応する。そうした研究活動が合わさって成果になっている。AIはその一部を助けられるが、論文の署名や技術的な結果については、具体的な仕事に対して責任を持つ必要がある。
AIは若者と実際の課題との距離をどう縮めるのか
陳広宇の経験からは、互いにつながるいくつかの変化が見えてくる。
第一に、学びへのフィードバックが密になる。AIは、知らない用語をいつでも説明し、複雑な問題を分解する手助けをし、次に補うべき知識を見つけやすくする。自ら動く人に、より多くの練習の機会を与えてくれる。その練習が能力になるかどうかは、確かめ、導き、実践する作業を続けるかにかかっている。
第二に、成果を確かめてもらい、見つけてもらいやすくなる。公開されたコード、論文、技術の議論によって、評価の一部は具体的な仕事そのものに向けられる。明快な分析や根拠のある修正は、学歴や役職より先に、その問題に関心を持つ人の目に届くことがある。
最後に、協働によって個人の貢献を大きなシステムに組み込める。最先端の研究には、引き続き計算資源、チームの経験、厳密な検証が必要だ。若者がそこに参加する機会を得られれば、速い学習を、再利用できる技術的な成果へと変えられる可能性が生まれる。
この三つがつながって初めて、ここでいう増幅が起こる。AIが学びを助け、公開した仕事が同じ分野の人につなぎ、チームが検証を経た貢献を実際のモデルに取り入れる。技術、個人の行動、組織が提供する機会が、一緒に作用している。
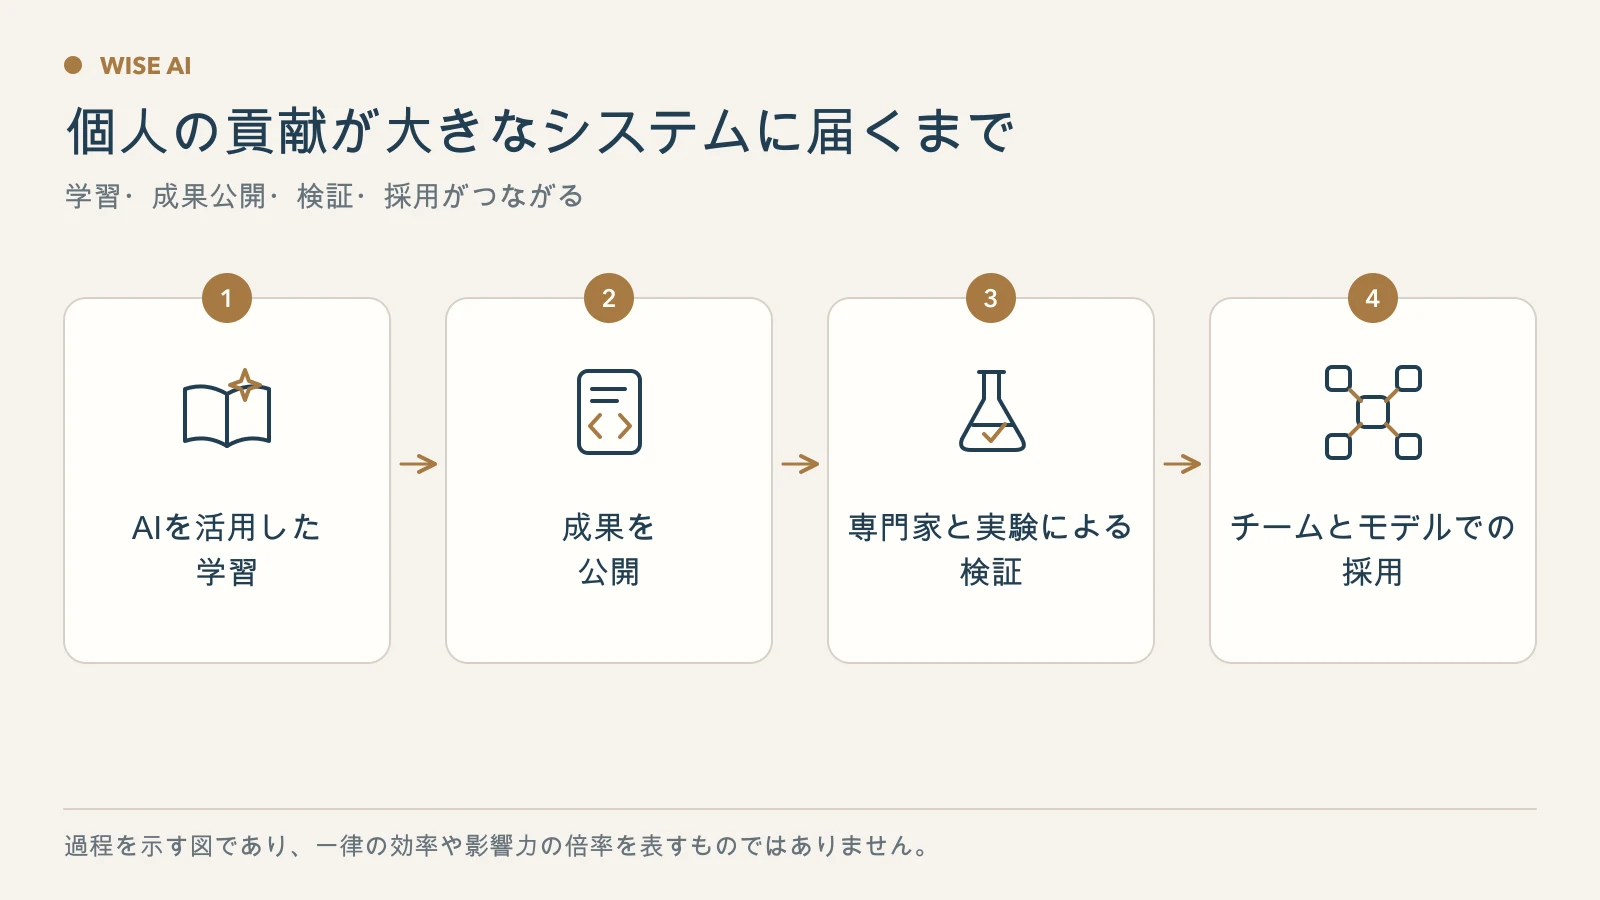
個人の貢献が大きなシステムに入る道筋を示したもの。効率や影響について、共通の倍率が測定されたことを意味しない。
だからこそ、人を評価する際に、年齢や従事した年数を能力の代わりの指標とすることの限界は、ますます明らかになる。何年働いたかは背景の一部を伝える。一方、何を理解し、何を解決したのか、その結果を説明して再現できるのかは、より直接的な判断材料となる。
経験の価値は、協働の中で示される
年齢や在籍年数による序列に反対するなら、経験も真剣に捉える必要がある。陳広宇の成長には、研究者の指導、オープンソースコミュニティの蓄積、そして実際の課題を任せてくれたチームがあった。AttnResそのものが、経験の異なる研究者たちによる共同の仕事だ。[4][5]
経験豊富な人が持つ、失敗につながる道筋、実験設計、システム上の制約への判断は、若い人の遠回りを減らせる。若い人の熱意、問いかけ、探索も、チームに新しい手法をもたらし得る。こうした力が一つの問題を囲んで結び付くとき、経験の価値は仕事の結果に表れる。
同時に、この道筋に必要だった条件にも目を向けたい。インターナショナルスクールの学習環境、指導者とのつながり、海外でのインターン、研究チームの資源は、いずれも陳広宇の経験に登場する。AIによって説明を得やすくなっても、誰もが同じ時間、支援、実験条件を自動的に手にするわけではない。[6]
学校や企業にとって、より建設的なのは、能力を見てもらえる機会を増やすことだ。明確で小さな研究課題を示し、確かめられる成果物の提出を認め、専門家が速やかにフィードバックし、貢献を正確に記録する。そうすれば、まだ肩書を重ねていない人にも、自分の力を示す入口が増える。
若者に与える余地には、次を探す自由も含まれる
陳広宇は個人サイトで、自ら動く力は超能力であり、判断力は学べると書いている。また、SNSで注目を集めることが目標になると、独自の研究に向ける注意が奪われかねないと振り返る記事も書き、内容のある対話にもっと力を注ぎたいとしている。[9][10]
こうした言葉から、彼の歩みがより具体的に見えてくる。力を注ぐ価値のある問いを探しながら、機会、注目、仕事との関係も調整している。17歳での退職という決断は、その探索の一つの節目にすぎない。
若い人の可能性に期待しながら、学び続け、進路を変え、間違える余地も残すことはできる。一つの論文の成果を真剣に評価することが、奇跡を起こし続けるよう求める重荷になる必要はない。
AI時代に目指したいのは、より多くの若者が、よい問いを持ったときに探索を始め、よい仕事をしたときに真剣な応答を得られるようにすることだ。検証された改良は、オープンソースコミュニティ、研究チーム、モデルシステムを通じて、速く広まり、その効果を大きくできる。
一人の貢献を直接確かめられるようになるほど、年齢や在籍年数で序列を決める理由は薄れていく。陳広宇の物語が促すのは、問題を解決できる人に機会を渡し、成長の途中にある人にも、早くから世界に関わる入口を開くことだ。