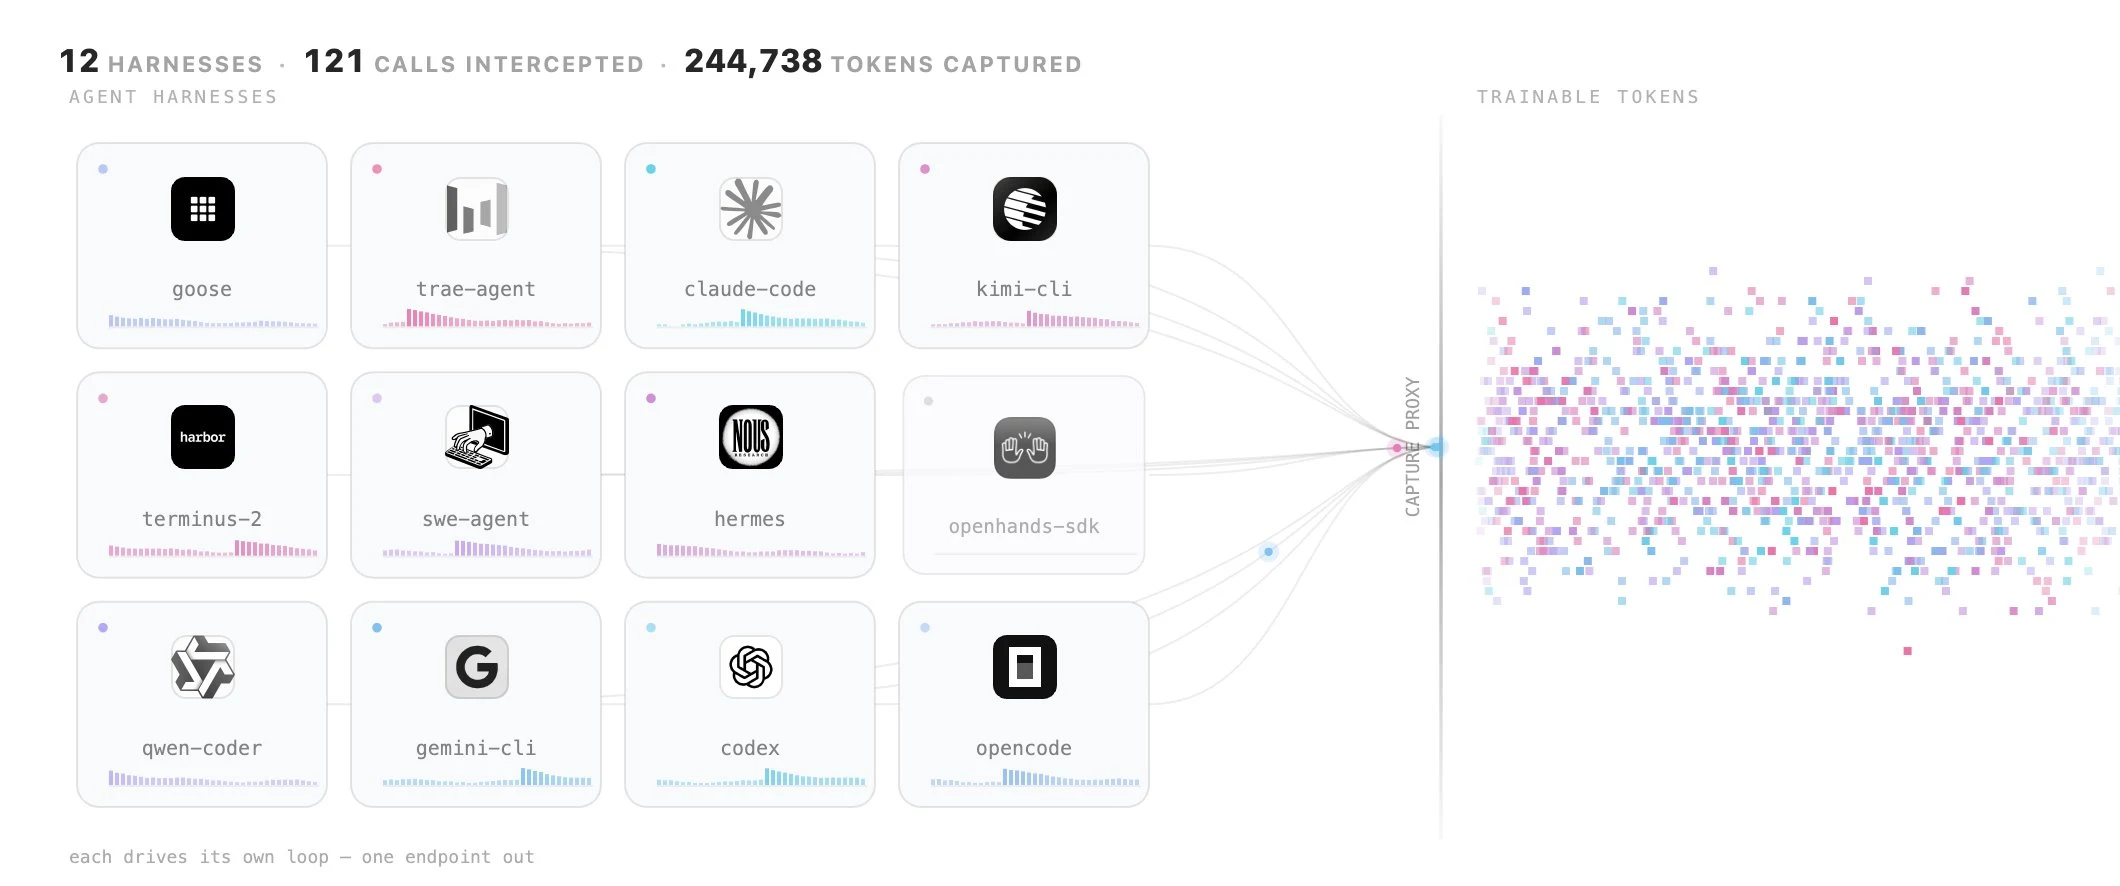
Claude Code, Codex, Hermes, Pi, @opencode 및 기타 코딩 하네스들을 RL 환경으로 만들었습니다. 하네스 변경 없이, 학습 코드 변경도 없습니다. 어떤 오픈 모델이든, 어떤 태스크 세트든, 완전한 오픈 소스입니다, 여러분!
같은 모델, 같은 가중치: Mini-SWE-Agent에서는 62%, Claude Code에서는 33%. 하지만 실제 하네스 안에서 학습하려면 보통 이를 환경으로 재구현해야 하기 때문에, 대부분의 모델은 실제로 출시되지 않는 스캐폴드에서 학습됩니다.
해결책은 재작성이 아니라 프록시입니다. 하네스는 모델 API와 통신하고 있다고 생각하지만, 실제로는 코딩 에이전트가 사용하는 4가지 형식(OpenAI Chat Completions, OpenAI Responses, Anthropic Messages, Gemini)을 지원하는 캡처 프록시와 통신하며, 이 프록시는 @vllm_project로 전달하고, vLLM이 샘플링한 정확한 토큰 ID와 logprob를 기록하며, TRL에 학습 가능한 시퀀스를 넘겨줍니다. 하네스가 곧 환경이 됩니다. 오늘 10개의 하네스를 이를 통해 실행했으며, 하나도 수정되지 않았습니다.
그리고 보상을 직접 제어할 수 있기 때문에 하네스가 요청하지 않은 동작도 형성할 수 있습니다. 더 적은 도구 호출로 태스크를 해결하면 작은 보너스를 추가했습니다: 이미 해결했던 태스크에서 모델이 이제 모든 하네스에서 호출 수를 31% 줄였고, Codex에서는 약 절반으로 줄었습니다.
@liquidai의 LFM2.5-2.6B로 테스트되었습니다:
→ 하나의 하네스에서 학습: 주로 그 하네스에서 향상 (OpenCode 34% → 58%).
→ 4개에서 동시에 학습: 4개 모두에서 향상 (42% → 54%).
→ 대신 Qwen3.8-27B의 3,189개 롤아웃으로 SFT: 47.5%에서 정체되며, 두 RL 실행 모두보다 낮음.
모든 것이 공개되어 있으며 재현 가능합니다: OpenEnv의 캡처 프록시, TRL의 트레이너, 태스크, SFT 데이터, 학습 코드 및 학습된 7개 모델 전부. 다음으로 더 큰 모델과 더 큰 실행이 예정되어 있습니다.
전체 가이드: https://huggingface.co/spaces/FineEnvs/multi-harness-rl