
사용자가 LangChain으로 구축된 Retrieval Augmented Generation(RAG) 지원 어시스턴트에게 두 제품을 세 가지 차원에서 비교해 달라고 요청하면, 사실상 여섯 가지 질문을 동시에 던지는 것입니다. 유사도 검색은 단일 쿼리 벡터를 사용해 모든 의도를 하나로 담아냅니다. 그러면 리트리버(retriever)는 해당 의도들의 평균에 가장 가까운 근사치를 생성합니다. 그 결과로 돌아오는 답변은 간결합니다. 검색은 오류 없이 실행됩니다. 관련성 점수도 합리적으로 보입니다. 그러나 검색된 청크는 주제적으로는 관련이 있지만, 질문이 실제로 요청한 내용 중 일부만 다루고 있습니다.
이 게시물에서는 Amazon Bedrock Managed Knowledge Base에서 다음과 함께 RAG 애플리케이션을 소개합니다: LangChain. 동일한 다중 파트 질문을 표준 검색과 에이전틱 검색으로 실행하고, 트레이스 이벤트를 읽어 모델이 생성한 계획을 확인합니다. 또한 두 검색 경로의 비용과 더 저렴한 쪽이 적합한 선택인 경우도 다룹니다.
에이전틱 검색은 Amazon Bedrock Managed Knowledge Base에서 사용할 수 있습니다. 단일 검색 대신, Amazon Bedrock Managed Knowledge Base가 검색을 계획합니다. 질문을 하위 쿼리로 분해하고, 이를 실행하고, 충분한 증거가 있는지 판단하며, 부족하면 다시 검색합니다. 이 langchain-aws 패키지는 에이전틱 검색과 표준 검색을 모두 노출하므로, LangChain 애플리케이션에서 어느 쪽이든 사용할 수 있습니다.
솔루션 개요
Amazon Bedrock Managed Knowledge Base는 Amazon Bedrock의 완전관리형 RAG 기능으로, RAG 아키텍처에서 자체 관리형 벡터 스토어, 임베딩 및 재순위화(re-ranking) 모델을 제거합니다. 데이터 소스를 구성하면 Amazon Bedrock Managed Knowledge Bases가 청킹, 임베딩, 스토리지 및 검색을 처리합니다. 이 실습에서는 Amazon Simple Storage Service(Amazon S3).
Amazon Bedrock Managed Knowledge Bases는 두 가지 API를 제공합니다. 이 게시물에서 이러한 차이점을 간략히 설명합니다. Retrieve API는 단일 하이브리드 검색을 실행하고 점수가 매겨진 청크를 반환합니다. AgenticRetrieveStream API는 계획 루프를 실행하고 그 단계를 트레이스 이벤트 형태로 스트리밍하여 반환합니다. 이 langchain-aws 패키지에서 첫 번째는 체인에 바로 넣을 수 있는 표준 LangChain 리트리버이고, 두 번째는 지식 베이스에서 직접 검색하는 함수입니다.
다음 다이어그램은 솔루션 아키텍처를 보여줍니다. 애플리케이션은 Retrieve API(표준, 단일 샷) 또는 AgenticRetrieveStream API(다중 단계 계획 루프)를 사용하여 Amazon Bedrock Knowledge Bases에 쿼리를 수행합니다. 두 경로 모두 지식 베이스에서 문서 청크를 반환하며, 애플리케이션은 이를 사용하여 근거 기반 응답을 생성합니다.
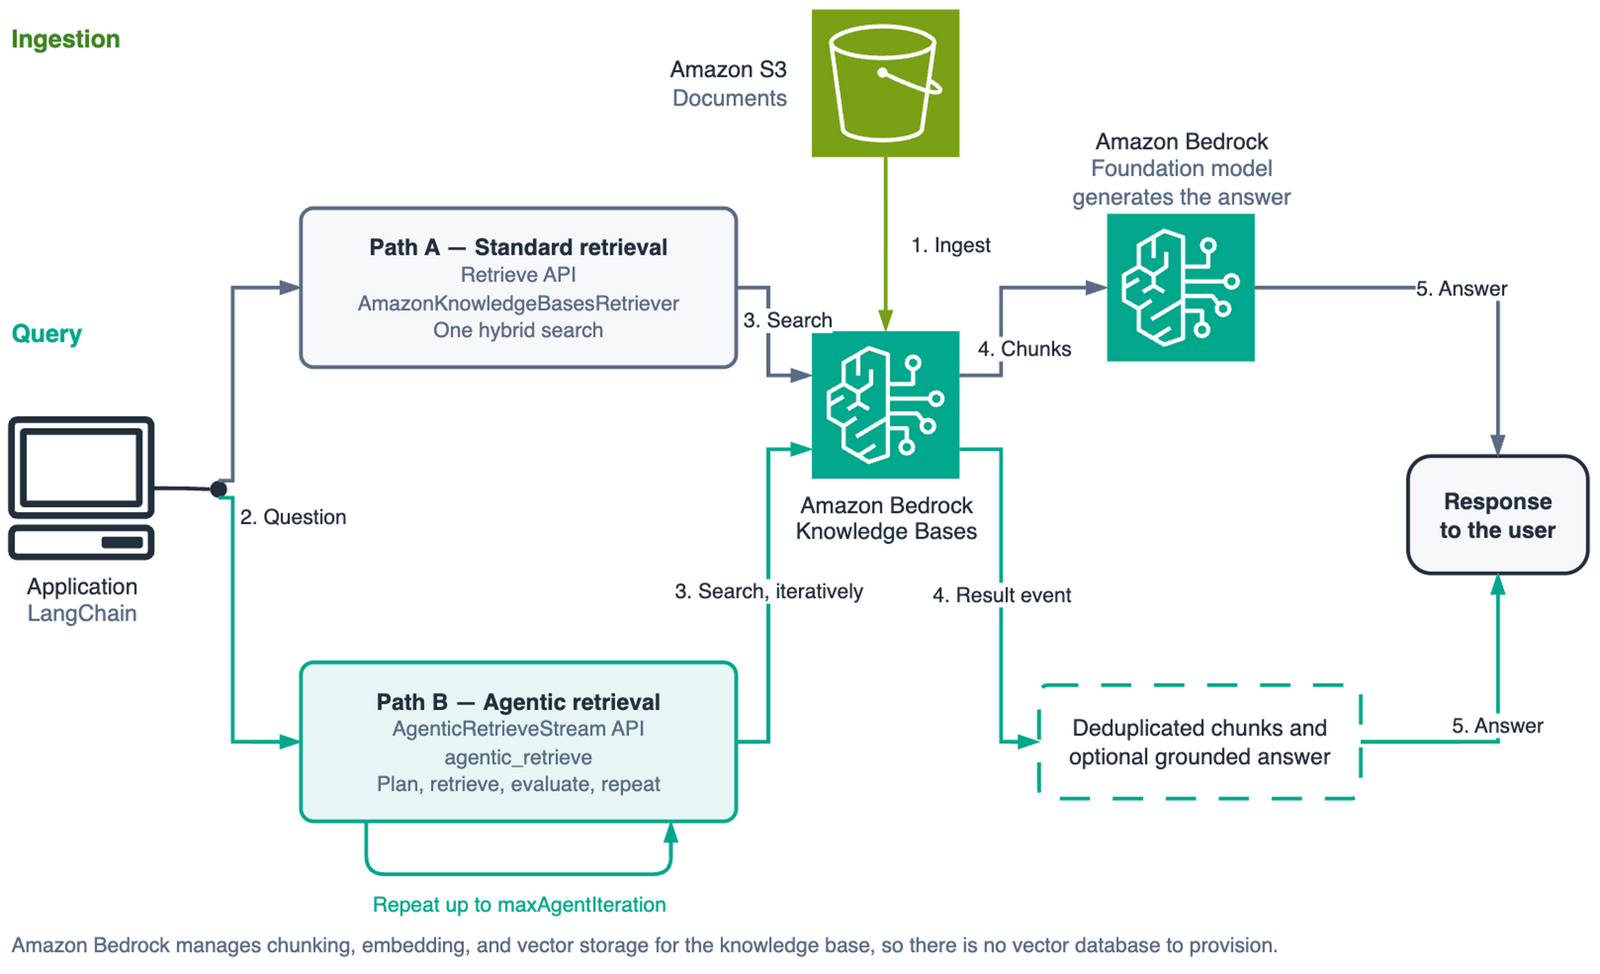
그림 1: Retrieve 및 AgenticRetrieveStream API를 사용하여 Amazon Bedrock Knowledge Bases를 쿼리하기 위한 솔루션 아키텍처
구현 실습
다음 섹션에서는 지식 베이스를 생성하고, 두 가지 검색 방식으로 쿼리하고, 에이전틱 플래너가 생성하는 트레이스 이벤트를 읽는 과정을 안내합니다.
사전 조건
따라 하려면 다음이 필요합니다:
- Amazon Bedrock Managed Knowledge Bases 및 에이전틱 검색을 사용할 수 있는 리전에서 Amazon Bedrock에 액세스할 수 있는 AWS 계정. 이 실습에서는 미국 동부(버지니아 북부) 리전(
us-east-1)을 사용하며, 코드 전체에서 이를 가정합니다. 다른 리전 가용성 및 지원에 대해서는 AWS 문서 를 확인하세요. - 다음 섹션에 설명된 두 가지 AWS Identity and Access Management(IAM) 자격 증명: 지식 베이스가 수임하는 서비스 역할, 그리고 API를 호출하는 자격 증명에 대한 권한.
- Python 3.12 이상.
- 샘플 문서를 보관하는 S3 버킷입니다. 코퍼스는 서로 겹치는 주제를 다루는 여러 문서를 필요로 하며, 그래야 비교 질문이 참조할 대상이 생깁니다. 단일한 평면적인 문서로는 쿼리 계획(query planning)을 시연할 수 없습니다.
패키지를 설치합니다. 그 다음 Boto3 버전이 중요합니다: agentic_retrieve_stream 1.43.32 이전에는 존재하지 않았습니다.
langchain-aws>=1.6.3
langchain>=1.0
boto3>=1.43.32
권한
두 개의 아이덴티티가 관여하며, 이를 의도적으로 분리하는 것이 좋습니다. 지식 베이스는 문서를 읽고 임베딩 모델을 호출하기 위해 서비스 역할을 가정합니다. 애플리케이션은 AWS Security Token Service(AWS STS) 호출자 아이덴티티를 사용하여 쿼리합니다. 어느 쪽도 서로의 권한이 필요하지 않습니다.
사용자가 허용하면 Amazon Bedrock이 서비스 역할을 대신 생성해 줍니다. 직접 역할을 제공하려면 Amazon Bedrock이 해당 역할을 수임(assume)할 수 있도록 허용하는 신뢰 정책을 지정하세요. 다음과 같이 범위를 지정합니다. aws:SourceAccount 그리고 aws:SourceArn 다른 계정이 이를 혼동된 대리자(confused deputy)로 사용하지 못하도록:
{
    "Version": "2012-10-17",
    "Statement": [{
        "Effect": "Allow",
        "Principal": {"Service": "bedrock.amazonaws.com"},
        "Action": "sts:AssumeRole",
        "Condition": {
            "StringEquals": {"aws:SourceAccount": "111122223333"},
            "ArnLike": {
                "aws:SourceArn": "arn:aws:bedrock:us-east-1:111122223333:knowledge-base/*"
            }
        }
    }]
}
서비스 역할 역시 필요합니다 s3:ListBucket 버킷과 s3:GetObject 그 내용에 대해, 둘 다 다음 조건에 따릅니다: aws:ResourceAccount범위를 정합니다 knowledge-base/* 와일드카드 문자 대신 생성한 후에는 특정 지식 베이스 ID까지 지정할 수 있습니다.
AWS STS 호출자 신원에는 다른 세트가 필요합니다. bedrock:AgenticRetrieveStream 그리고 bedrock:InvokeModelWithResponseStream 지식 베이스 Amazon Resource Name(ARN)으로 범위가 지정될 수 없습니다. bedrock:Retrieve 그리고 bedrock:GetDocumentContent 가능합니다:
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Sid": "AgenticRetrievalAndPlannerModel",
            "Effect": "Allow",
            "Action": [
                "bedrock:AgenticRetrieveStream",
                "bedrock:InvokeModelWithResponseStream"
            ],
            "Resource": "*"
        },
        {
            "Sid": "RetrieveAndFullDocumentExpansion",
            "Effect": "Allow",
            "Action": ["bedrock:Retrieve", "bedrock:GetDocumentContent"],
            "Resource": "arn:aws:bedrock:<region>:111122223333:knowledge-base/<knowledge-base-id>"
        },
        {
            "Sid": "GenerateAnswersInTheChains",
            "Effect": "Allow",
            "Action": ["bedrock:InvokeModel", "bedrock:Converse", "bedrock:ConverseStream"],
            "Resource": "*"
        }
    ]
}
bedrock:GetDocumentContent 종종 간과됩니다. 에이전트형 검색은 다음과 같은 경우에 이를 호출합니다. FullDocumentExpansion "step decides a passage lacks the context to answer. A policy with only" → 변환: 단계에서 해당 구간(passage)이 답변하기에 충분한 맥락이 없다고 판단합니다. 다음 정책 중 하나만 있는 경우 bedrock:Retrieve 계획자(planner)가 문서 전체를 가져오려다가 쿼리 도중에 실패할 때까지 작동한다.
지식 베이스 자체를 생성하고 관리하려면 호출 역할에 추가로 다음 권한이 필요합니다 bedrock:CreateKnowledgeBase 켜기 *, 그리고 GetKnowledgeBase, UpdateKnowledgeBase, DeleteKnowledgeBase, StartIngestionJob, GetIngestionJob, 그리고 ListIngestionJobs 에 대한 조치 knowledge-base/*. 가드레일을 사용 중이라면 추가하십시오 bedrock:GetGuardrail 그리고 bedrock:ApplyGuardrail.
이 실습을 진행하면 지식 베이스의 문서 저장 및 수집, 검색 호출, 파운데이션 모델(FM) 추론에 비용이 발생할 수 있습니다.
가격에 대한 자세한 내용은 다음의 Knowledge Bases 섹션을 참조하십시오. Amazon Bedrock 요금.
이 실습을 완료하면 리소스를 삭제하세요.
지식 베이스 생성 및 채우기
지식 베이스를 다음으로 생성합니다: managedKnowledgeBaseConfiguration. 설정 embeddingModelType 에 MANAGED 서비스 관리형 임베딩 모델을 사용합니다.
import boto3
import os

REGION = os.environ["AWS_REGION"]
bedrock_agent = boto3.client("bedrock-agent", region_name=REGION)

response = bedrock_agent.create_knowledge_base(
    name=KB_NAME,
    roleArn=KB_ROLE_ARN,
    knowledgeBaseConfiguration={
        "type": "MANAGED",
        "managedKnowledgeBaseConfiguration": {
            "embeddingModelType": "MANAGED",
        },
    },
)
KB_ID = response["knowledgeBase"]["knowledgeBaseId"]
그런 건 없습니다. storageConfiguration 해당 요청에 포함됩니다. 자체 관리형 지식 베이스의 경우 벡터 스토어를 설명하는 것을 전달하게 됩니다. Amazon Bedrock Managed Knowledge Base는 이를 받지 않는데, 이것이 Amazon Bedrock이 스토리지 계층을 소유하고 있음을 보여주는 API상의 가장 명확한 신호입니다.
S3 버킷을 데이터 소스로 연결한 다음 수집 작업을 시작하세요. 수집은 비동기식이므로 고정된 간격으로 잠자며 기다리기를 바라는 대신, 작업이 최종 상태에 도달할 때까지 폴링(polling)하세요.
import time

SUCCESS_STATES = frozenset({"COMPLETE"})
FAILURE_STATES = frozenset({"FAILED", "STOPPED"})

def wait_for_ingestion(kb_id, ds_id, job_id, timeout_s=1800):
    """Poll an ingestion job until it reaches a terminal state."""
    deadline = time.time() + timeout_s
    while time.time() < deadline:
        job = bedrock_agent.get_ingestion_job(
            knowledgeBaseId=kb_id,
            dataSourceId=ds_id,
            ingestionJobId=job_id,
        )["ingestionJob"]
        status = job["status"]
        if status in SUCCESS_STATES:
            return job
        if status in FAILURE_STATES:
            reasons = job.get("failureReasons") or ["no reason reported"]
            raise RuntimeError(f"Ingestion job {job_id} finished as {status}: " + "; ".join(reasons))
        time.sleep(15)
    raise TimeoutError(f"Ingestion job {job_id} did not finish in {timeout_s}s")
전체 데이터 소스 구성 및 오류 처리는 다음에 있습니다: 샘플 저장소.
LangChain 검색기(retriever)를 사용한 쿼리
AmazonKnowledgeBasesRetriever Retrieve API를 감싸며 다른 LangChain 리트리버와 동일하게 작동합니다. Amazon Bedrock Managed Knowledge Bases의 경우 다음을 전달합니다 managedSearchConfiguration. 이 부분에서 사람들이 헷갈리곤 합니다: vectorSearchConfiguration 지식 베이스를 위해 자체 벡터 스토어를 운영하는 이전 방식입니다. 기존 대부분의 예제가 보여주는 방식이기도 합니다.
from langchain_aws.retrievers import AmazonKnowledgeBasesRetriever

SIMPLE_QUERY = "What is the restore time objective for the checkout service?"

retriever = AmazonKnowledgeBasesRetriever(
    knowledge_base_id=KB_ID,
    region_name=REGION,
    retrieval_config={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
        }
    },
)
docs = retriever.invoke(SIMPLE_QUERY)
각 결과는 LangChain Document입니다. 관련성 점수는 metadata["score"], 그리고 해당 원본 문서 자체의 메타데이터는 다음 위치에 있습니다. metadata["source_metadata"], 충돌하지 않도록 이름이 변경되었습니다. 신뢰도가 낮은 결과를 제거하려면 min_score_confidence 필터링을 사후에 수행하는 대신 리트리버에서 수행하는 방식입니다.
하나의 명확한 의도를 가진 질문에는 이것이 적합한 도구입니다. 호출이 한 번입니다. 지연 시간은 두 옵션 중 가장 낮으며, 답변이 생성되는 방식을 완전히 통제할 수 있습니다. 프로덕션 어시스턴트가 접하는 대부분의 쿼리는 이러한 형태이며, 이를 처리하는 데 계획 루프를 사용하는 것은 돈과 시간의 낭비입니다.
단일 샷 검색이 한계에 부딪히는 지점
이번에는 동일한 검색기에 여러 부분으로 구성된 질문을 제시해 보겠습니다:
COMPLEX_QUERY = (
    "Compare the checkout and inventory services across on-call escalation, backup and "
    "restore targets, and deployment rollback procedure. Where do they differ?"
)

docs = retriever.invoke(COMPLEX_QUERY)
그 전체 질문에 대한 하나의 임베딩과의 하이브리드 점수에 따라 순위가 매겨진 5개의 청크가 돌아옵니다.
이 질문에는 여섯 가지 의도가 담겨 있습니다: 세 가지 차원에 걸친 두 가지 서비스입니다. 검색된 텍스트를 각 의도의 증거 여부로 채점하면 단일 임베딩이 무엇을 회복하는지에 대한 구체적인 척도를 얻을 수 있습니다.
| numberOfResults | 청크 | 코퍼스 내 비중 | 세부 의도 포함 범위 | 누락됨 |
| 5 | 5 | 10% | 6개 중 4번째 | 체크아웃 온콜, 재고 복원 |
| 10 | 10 | 19% | 6/6 | 없음 |
결과가 다섯 개일 때는 여섯 개의 의도를 대표하는 하나의 임베딩이 그중 두 개를 놓치게 됩니다. 열 개일 때는 여섯 개 모두를 커버하지만 눈에 띄는 낭비가 있습니다. 두 개의 하위 의도는 두 번씩 커버되고 하나의 청크는 아무것도 담당하지 않습니다.
리트리버는 제 역할을 했습니다. 한계는 구조적인 것입니다. 하나의 벡터로는 여섯 가지 의도를 표현할 수 없으며, 반환된 근거가 질문에 답하기에 충분한지를 묻는 단계가 이 과정 어디에도 없습니다.
에이전틱 검색 실행하기
에이전틱 검색(agentic retrieval)은 LangChain 리트리버가 아니라 Amazon Bedrock Managed Knowledge Bases의 기능입니다. 이 langchain-aws 패키지는 이를 독립형 함수인 agentic_retrieve로 노출하는데, 그 이유는 기반 API가 결과를 스트리밍하기 때문에 동기식 BaseRetriever 인터페이스에 맞지 않기 때문입니다. 이를 켜는 플래그는 AmazonKnowledgeBasesRetriever 에 없습니다.
from langchain_aws.retrievers.bedrock import agentic_retrieve

result = agentic_retrieve(
    knowledge_base_id=KB_ID,
    query=COMPLEX_QUERY,
    region_name=REGION,
    generate_response=True,
    number_of_results=10,
)
print(result["generatedResponse"]["answer"])
를 사용하면 generate_response=True서비스는 검색된 청크와 함께 근거 기반 답변과 인용을 반환하므로, 별도의 모델 호출을 연결하지 않고도 답변을 얻을 수 있습니다. 이 함수는 Amazon Bedrock Managed Knowledge Base에 대해서만 작동합니다.
내부적으로 이 서비스는 계획을 세우고, 검색하고, 근거가 충분한지 평가하며, 충분하지 않으면 반복합니다. 헬퍼는 이 모든 과정을 숨기고 최종 청크만 돌려주는데, 편리하지만 계획을 볼 수 없다는 뜻이기도 합니다.
트레이스 이벤트 읽기
모델이 질문을 분해하는 과정을 보려면 bedrock-agent-runtime 클라이언트에서 agentic_retrieve_stream 을 직접 호출하십시오. 헬퍼가 트레이스 이벤트를 버리고 langchain-aws나 사용자 지정 플래너 모델을 노출하지 않기 때문에, 이 것이 이 walkthrough에서 유일하게 maxAgentIteration 을 우회하는 지점입니다.
runtime = boto3.client("bedrock-agent-runtime", region_name=REGION)

response = runtime.agentic_retrieve_stream(
    messages=[{"role": "user", "content": {"text": COMPLEX_QUERY}}],
    retrievers=[{
        "configuration": {
            "knowledgeBase": {
                "knowledgeBaseId": KB_ID,
                "retrievalOverrides": {"maxNumberOfResults": 10},
            }
        }
    }],
    agenticRetrieveConfiguration={
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        # 5 is the API default. Below 4 the planner stops decomposing entirely.
        "maxAgentIteration": 5,
    },
    generateResponse=False,
)

for event in response["stream"]:
    if "traceEvent" in event:
        attrs = event["traceEvent"]["attributes"]
        print(f"{attrs.get('step')}: {attrs.get('status')}")
        for action in attrs.get("actions", []) or []:
            if "retrieve" in action:
                query = action["retrieve"].get("inputQuery", {}).get("text", "")
                print(f" sub-query: {query}")
    elif "result" in event:
        for chunk in event["result"].get("results", []):
            print(chunk.get("content", {}).get("text", "")[:120])
검색 동작만 원한다면 generateResponse 를 False (으)로 설정하십시오. 기본적으로 API는 근거 기반 답변을 생성하는데, 계획을 검토하는 동안에는 필요 없을 수 있는 추가 모델 호출 비용이 듭니다.
트레이스 이벤트의 step 값은 플래너가 어디에 있는지 알려줍니다. SpeculativeRetrieval 은 첫 계획 전에 실행되어 지연 시간을 줄이며 반복 예산에는 포함되지 않습니다. Planning 은 모델이 질문과 이전 결과를 읽고 하위 쿼리를 생성하는 단계입니다. Retrieval 은 하위 쿼리당 한 번씩 발생합니다. FullDocumentExpansion 은 모델이 어떤 구절이 답변에 필요한 맥락을 갖고 있지 않다고 판단하여 전체 문서를 대신 가져올 때 나타납니다. 각각에는 IN_PROGRESS, SUCCEEDED또는 FAILED상태와 사람이 읽을 수 있는 메시지가 함께 전달됩니다.
최종 청크는 별도로 도착합니다. result 은 다섯 번째 단계가 아니라 별도의 이벤트 유형이며, 응답 생성이 켜져 있을 때 모든 반복에서 중복 제거된 청크와 근거 기반 답변을 담고 있습니다. 앞의 루프가 보여주듯 종료 단계 값을 기대하기보다 이벤트 키로 분기하십시오.
서브 쿼리 텍스트는 로깅할 가치가 있는 부분입니다. 이것은 다음 위치에 있습니다. attributes.actions[].retrieve.inputQuery.text, 는 최상위 트레이스 필드가 아니므로, 다음만 읽는 핸들러는 step 그리고 status 계획이 수립되었음은 보여주지만 무엇을 결정했는지는 보여주지 않습니다.
다음 다이어그램은 추측 검색, 계획, 하위 질의 검색, 평가 및 선택적 재계획 단계를 포함하는 에이전틱 검색 계획 루프를 보여줍니다.
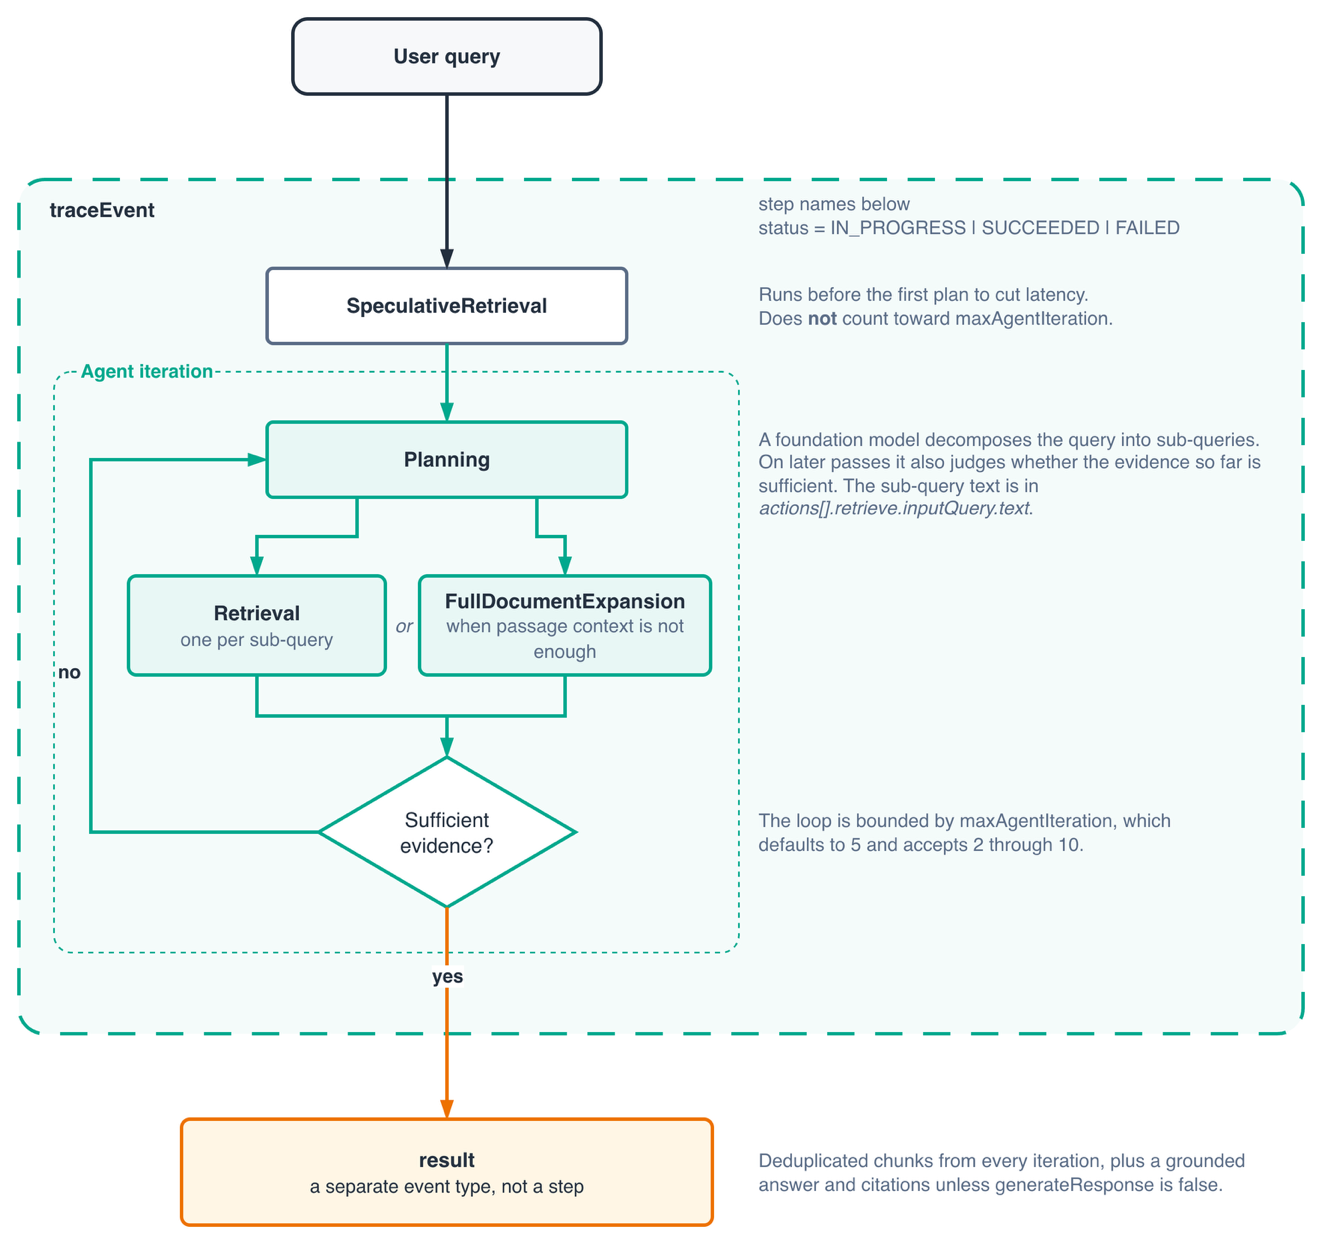
그림 2: 에이전틱 검색 계획 루프의 단계
이를 바탕으로 구축하기 전에 알아두어야 할 두 가지 세부 사항이 있습니다. 중복 제거는 다음에만 적용됩니다. result 이벤트이므로 세 개의 하위 질의로 검색된 청크는 마지막에 한 번 나타나지만 전체 추적에서는 세 번 나타납니다.
두 번째는 점수에 관한 것입니다. Retrieve 응답은 각 청크에 타입이 지정된 score 쿼리와의 관련성을 유지하는 필드입니다. Agentic 검색 결과에는 다음이 포함됩니다. content, metadata, 그리고 sourceRetriever, 동등한 타입 필드가 없습니다. 다음을 읽는 코드는 result["score"] API를 전환한 후 아무것도 얻지 못합니다. 관련성을 기준으로 순위를 매기거나 필터링한다면 이 차이를 계획에 반영하세요.
프로덕션 환경에서는 Amazon Bedrock Guardrails를 사용하여 생성된 응답에 콘텐츠 정책 및 그라운딩 검사를 적용하세요. 두 검색 경로 모두 guardrails를 지원합니다. 에이전틱 검색은 policyConfiguration.bedrockGuardrailConfiguration 가 아닌 guardrail_config 인수를 통해 guardrails를 지원하며, BLOCK 모드만 지원합니다. MASK 모드에 의존한다면 Retrieve API에 머물 이유가 됩니다.
maxAgentIteration 은(는) 2에서 10까지 허용하며 기본값은 5입니다. 기본값으로 두세요. 2 또는 3에서는 플래너가 한 주기를 실행하고, 하위 쿼리를 생성하지 않으며, 추(speculative) 검색 단계에서 이미 찾은 결과를 반환합니다. 이는 에이전틱 가격으로 단일 샷(single-shot) 동작을 하는 것입니다. 분해는 4부터 시작됩니다. 플래너는 증거가 충분하다고 판단하면 종종 일찍 중단하므로, 상한은 목표가 아니라 한계입니다.
두 검색 경로 비교
대규모에서 이것이 어떻게 동작하는지에 대한 맥락으로, AWS는 공개 멀티홉(multi-hop) 벤치마크인 MuSiQue에서 에이전틱 검색을 평가했습니다. 평가 결과 단일 샷 검색보다 리콜이 향상되었으며, 가장 어려운 질문에서 가장 큰 개선을 보였습니다. 단일 홉 질문의 개선은 5포인트 미만이었습니다. 이 마지막 수치는 트레이드오프의 형태와 일치합니다: 분해할 것이 있을 때 분해가 도움이 됩니다.
RAG 체인 구축
표준 리트리버의 경우 일반적인 LangChain Expression Language (LCEL) 구성이 바로 작동합니다:
from langchain_aws import ChatBedrockConverse
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.runnables import RunnablePassthrough

def format_docs(docs):
    return "\n\n".join(doc.page_content for doc in docs)

llm = ChatBedrockConverse(model=MODEL_ID, region_name=REGION)
prompt = ChatPromptTemplate.from_template(PROMPT_TEMPLATE)

chain = (
    {"context": retriever | format_docs, "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
format_docs 실제로 보이는 것보다 더 중요합니다. Passing Document 객체를 프롬프트에 그대로 전달하면 그 repr이 렌더링되고, 모델의 컨텍스트에 메타데이터 노이즈가 섞이게 됩니다.
에이전틱 검색을 같은 위치에 놓으려면, 이는 retriever가 아닌 함수이므로 다음과 같이 RunnableLambda으로 감싸십시오:
from langchain_core.runnables import RunnableLambda

def agentic_context(question: str) -> str:
    result = agentic_retrieve(
        knowledge_base_id=KB_ID,
        query=question,
        region_name=REGION,
        number_of_results=10,
    )
    return "\n\n".join(
        item.get("content", {}).get("text", "")
        for item in result.get("results", [])
    )

agentic_chain = (
    {"context": RunnableLambda(agentic_context), "question": RunnablePassthrough()}
    | prompt
    | llm
    | StrOutputParser()
)
여기서는 generate_response 이 꺼져 있음에 유의하십시오. 이 서비스는 스스로 답변을 생성할 수 있지만, 체인 안에서는 보통 자신만의 프롬프트와 모델을 사용하고자 하므로 청크를 가져와 다운스트림에서 생성하게 됩니다. 한 번의 호출과 적은 코드를 원한다면 서비스 생성을 사용하고, 프롬프트를 직접 제어하고 싶다면 감싼 버전을 사용하십시오.
표준 검색과 에이전틱 검색 중 선택하기
짧고 범위가 명확한 질문에는 Retrieve를 사용하십시오. 더 저렴하고 빠르며, 직접 관리하는 지식 베이스에 대해 작동하고, 결과에 점수를 반환합니다. 대부분의 프로덕션 트래픽이 이러한 유형입니다.
질문이 다중 파트이거나, 비교형이거나, 탐색적인 경우, 또는 근거가 두 개 이상의 지식 베이스에 걸쳐 있는 경우에는 AgenticRetrieveStream을 사용하십시오. 이 API는 하나의 요청에 최대 five 개의 지식 베이스를 등록하고, 각 지식 베이스에 첨부한 자연어 설명을 사용하여 하위 쿼리를 라우팅합니다. 다른 API는 이를 전혀 수행할 수 없습니다. 호출당 비용이 더 많이 들고, 여러 번의 모델 호출을 수행하며, 두 API 중 지연 시간이 더 깁니다.
모든 것에 하나를 선택하기보다는 쿼리 형태에 따라 라우팅하는 것이 우리가 권장하는 패턴입니다. 질문에 대한 분류기나 휴리스틱을 통해 대부분의 트래픽을 저렴한 경로로 보내고, 필요한 질문에만 플래너를 사용하도록 할 수 있습니다.
리소스 정리
지식 베이스, 해당 데이터 소스, S3 객체와 버킷, 그리고 생성한 IAM 역할을 삭제하십시오. 문서가 포함된 지식 베이스는 계속해서 스토리지 요금이 발생합니다.
bedrock_agent.delete_data_source(knowledgeBaseId=KB_ID, dataSourceId=DS_ID)
bedrock_agent.delete_knowledge_base(knowledgeBaseId=KB_ID)
이 리포지토리 에는 버킷을 비우고 역할을 제거하는 정리(cleanup) 스크립트가 포함되어 있습니다.
결론
우리는 LangChain과 함께 Amazon Bedrock Knowledge Bases에서 RAG 애플리케이션을 구축하는 방법과, 에이전틱 검색이 단일 샷 검색이 제대로 답하지 못하는 다중 파트 질문을 처리하는 방법을 보여주었습니다. 또한 현재 통합의 마찰 지점도 보여주었습니다. 에이전틱 검색은 LangChain retriever가 아닌 함수이므로, 체인에 들어가려면 RunnableLambda 이 필요합니다. 쿼리 플랜을 보여주는 트레이스 이벤트는 직접적인 boto3 호출이 필요합니다.
에이전틱 검색은 내장 모델을 사용한 쿼리 플래닝을 통해 호출당 더 높은 비용을 지불하는 대신 다중 홉 질문에 대한 리콜(recall)을 개선합니다. 다음으로 유용한 단계는 모든 것을 플래너를 통해 라우팅하기 전에 자신의 쿼리 분포를 측정하는 것입니다.
시작하려면 Amazon Bedrock Knowledge Bases 문서 와 함께 제공되는 샘플 코드를 참조하십시오. 자신의 워크로드에 이를 적용하는 데 도움이 필요하면 AWS 계정 팀에 문의하십시오.