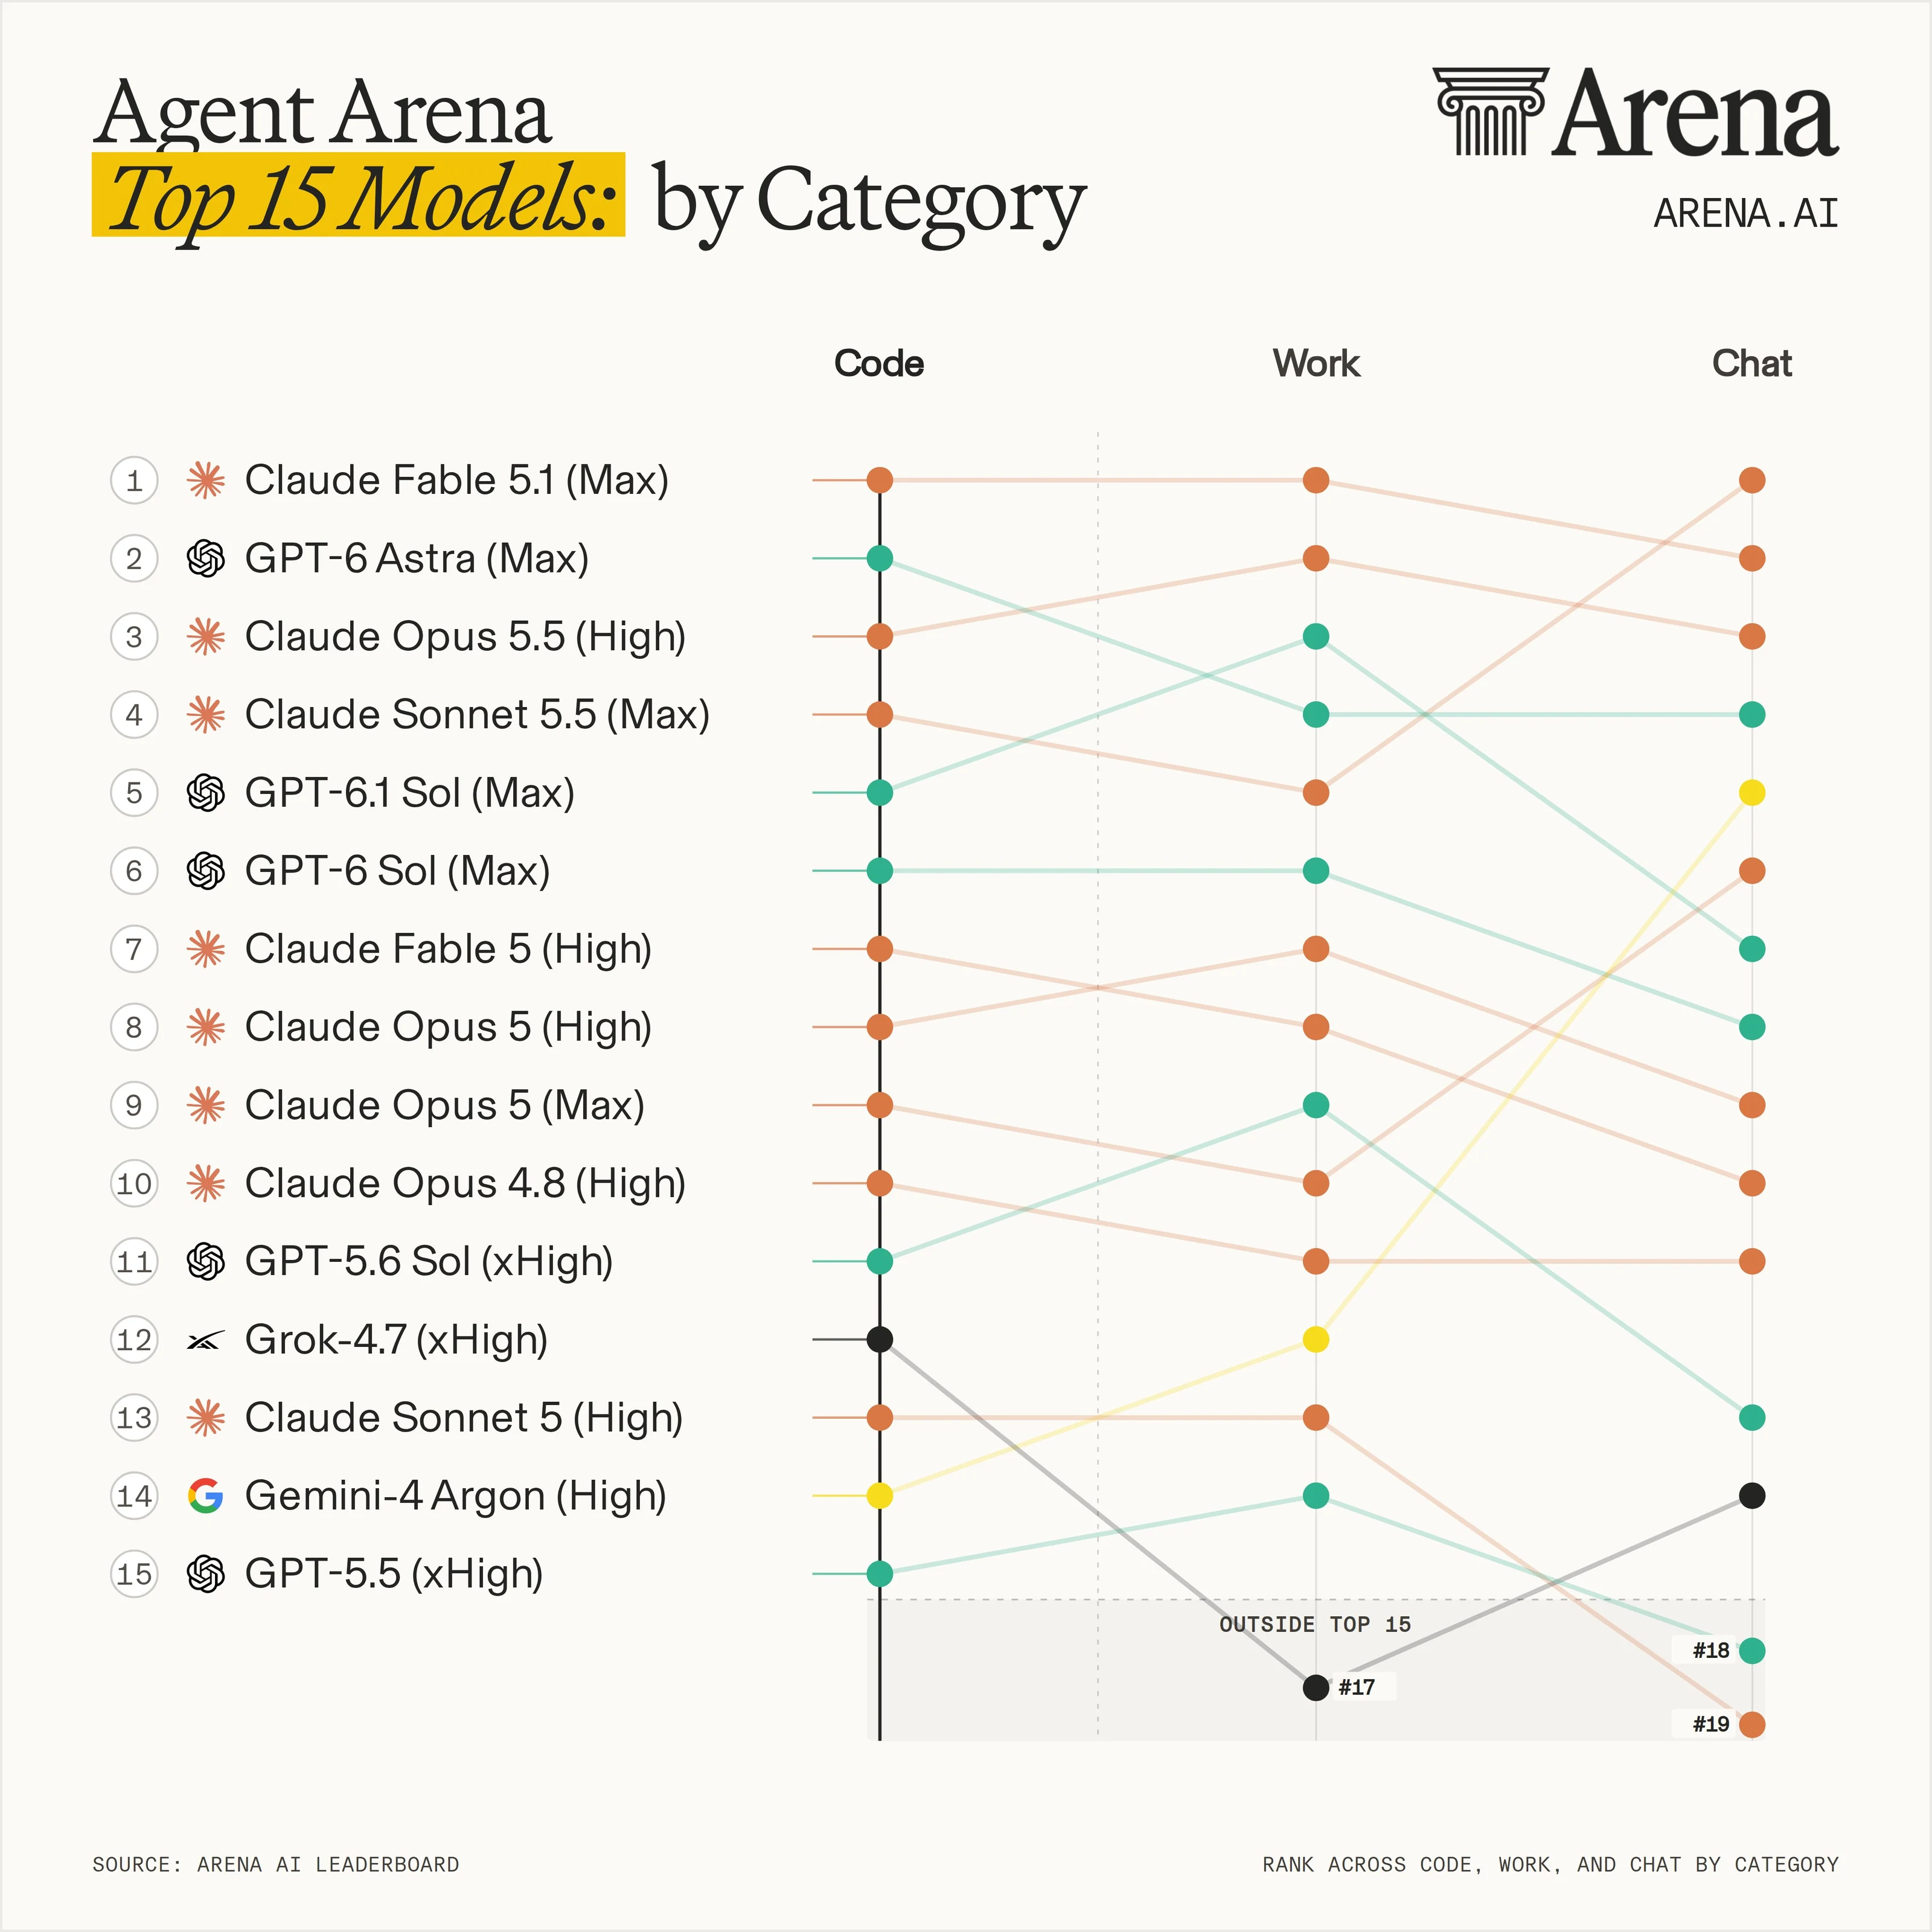
Agent Arena는 다양한 분야에서 문제를 해결하는 에이전트의 능력을 평가합니다.
미국 연구소들은 모든 분야에서 선두를 달리고 있습니다:
- @AnthropicAI 모델은 코드, 작업, 채팅 부문에서 1위를 차지합니다
- @OpenAI의 GPT 6 Astra (Max)는 세 부문 모두에서 상위 4위에 머물고 있으며, 코드 부문에서는 2위, 작업 및 채팅 부문에서는 4위입니다
최상위 모델들은 모든 카테고리에서 강세를 유지하지만, 순위는 변합니다:
- Claude Fable 5.1 (Max)는 Code와 Work 모두에서 1위를 차지하며 Chat에서는 2위입니다
- Claude Sonnet 5.5 (Max)는 Chat에서 1위이며, Code에서는 4위, Work에서는 5위입니다
코드 및 작업 순위는 채팅보다 더 밀접하게 함께 움직입니다:
- 예를 들어, Gemini 4 Argon은 코드에서 #14, 작업에서 #12로 순위를 매겼지만 채팅에서는 #5로 순위를 매기며 대화형 에이전트 작업에서의 뚜렷한 강점을 보여줍니다.
Agent Arena는 현재 최신 기준에 비해 모델의 전반적인 향상도와 특정 에이전트 작업 범주에서의 성능을 기준으로 모델을 순위화합니다. 이러한 순위는 전 세계 사람들이 제출한 실제 세계 작업을 해결하려는 에이전트로부터 수집된 실시간 기록에 기반을 두고 있습니다.
- 코드: 코드 작성 및 디버깅, 워크플로우 자동화, 데이터 분석
- 채팅: 창의적 글쓰기, 학습, 개인적인 질문, 일상적인 연구, 미디어 생성
- 업무: 문서 작성, 전문적인 연구, 계획 수립, 전문적인 글쓰기
이 시각적 표는 2026년 10월 5일 기준으로 에이전트 아레나의 각 카테고리 내에서 선택된 모델들이 어떻게 비교되는지를 보여줍니다.