
시중에서 구입할 수 있는 AI 도우미는 개별 질문에 잘 대답하지만, 다른 측면에서는 지속성 면에서 부족합니다. 오늘 상태 없는 도우미에게 정원에 대해 물어보면, 3주 전에 빠르게 물이 빠지는 높은 구덩이를 사용한다는 것, 유기 비료만 사용한다는 것, 그리고 고온에 시달리는 루트비아를 심었다는 사실을 전혀 모릅니다. 모든 대화는 처음부터 시작되며, 맥락을 다시 설명하는 책임은 사용자에게 돌아갑니다.
문제는 답변의 품질이 아니라, 어시스턴트가 당신을 기억하지 못하는 것입니다. 이 글에서는 OpenClaw라는 오픈소스 에이전트 시스템을 사용하여 맥락을 축적하는 개인 어시스턴트를 구축하는 방법을 보여줍니다. OpenClaw는 Amazon Bedrock AgentCore의 기능인 AgentCore 메모리에 의해 실행됩니다. AgentCore 메모리는 일회용 채팅을 지속적인 지식으로 변환합니다. 또한, 해당 질문에 중요한 정보를 검색하기 위해 그 기억들을 구조화된 메타데이터로 태그하는 방법도 알아볼 것입니다.
우리의 실제 예시는 원예 도우미인 Sprout입니다. 하지만 이 아키텍처는 도메인에 관계없습니다. 캐릭터와 기술 목록을 바꾸면 같은 파이프라인을 이용하여 지원봇, 피트니스 코치 또는 내부 help desk도 운영할 수 있습니다. 전체 시스템은 단일 AWS CloudFormation 템플릿에 저장되며, 하나의 명령어로 배포되고, 가벼운 개인 사용을 위해 한 달에 몇 달러의 비용만 지불하는 소비 모델로 실행됩니다. 이 과정에서, 이 스택에 구축된 도우미에 적용할 수 있는 디자인 지침을 공유합니다.
해결 방안 개요
AgentCore는 어떤 프레임워크나 모델을 사용하든 에이전트를 구축, 연결, 최적화할 수 있는 대규모 플랫폼입니다. 다음 다이어그램은 인바운드 Telegram 웹호크부터 AgentCore 런타임 및 관련 AWS 서비스까지의 전체 요청 흐름을 보여줍니다.
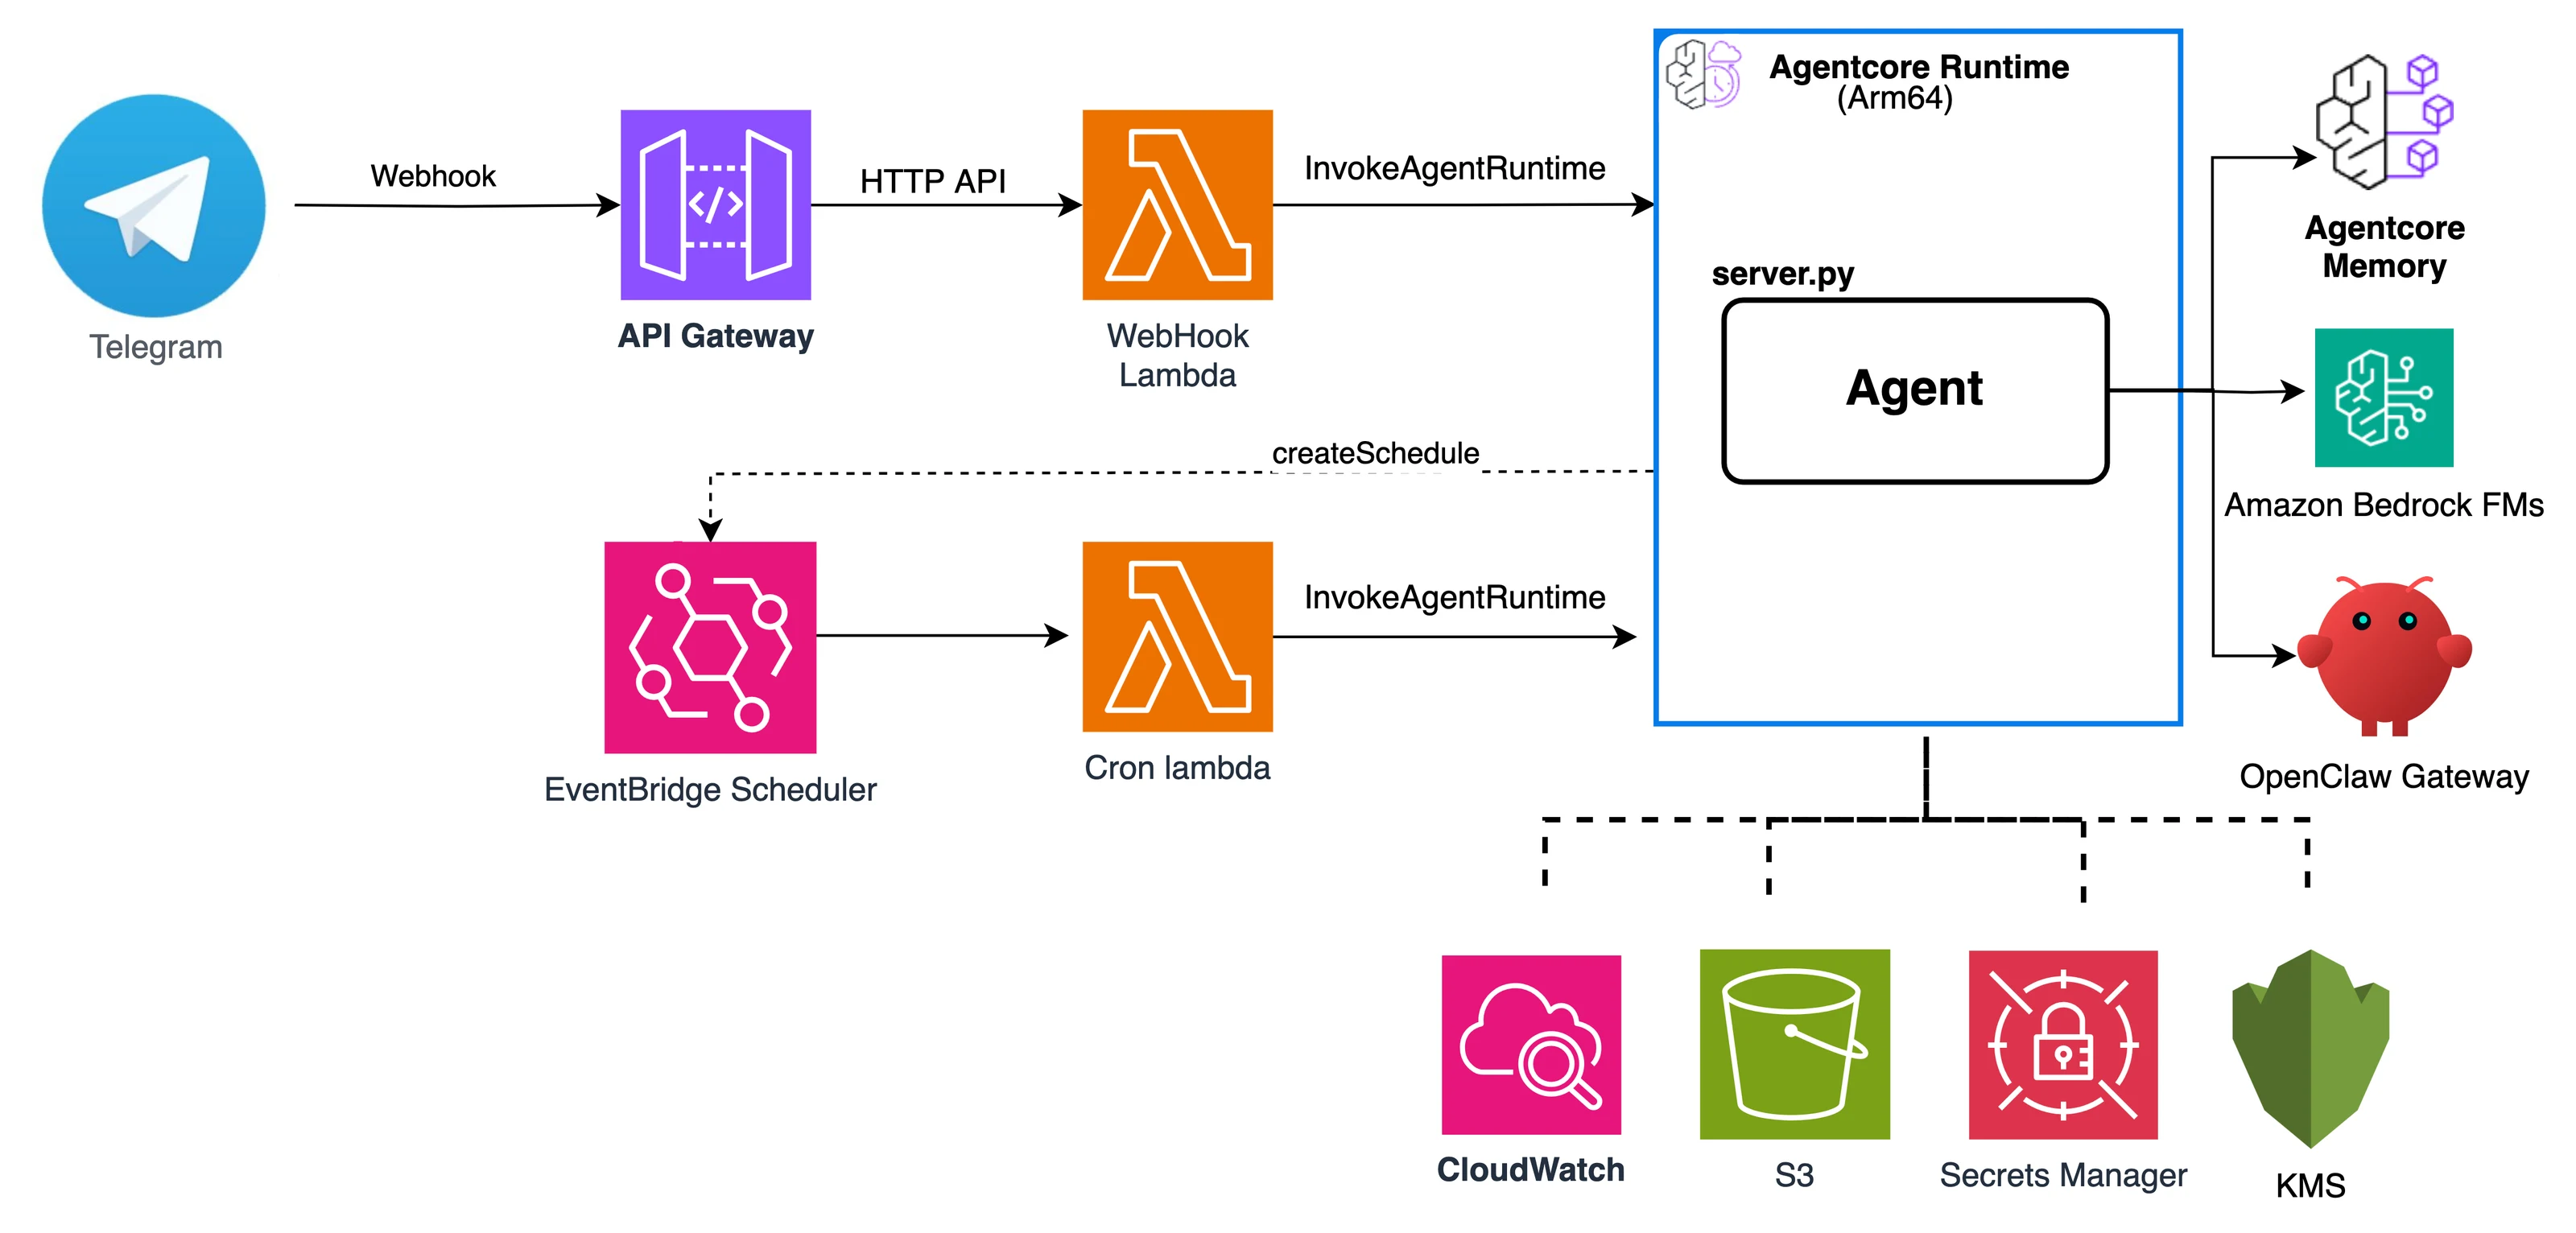
그림 1: Telegram 웹호크와 Amazon EventBridge 일정 모두 동일한 AgentCore 런타임 에이전트를 호출하며, 이 에이전트는 OpenClaw 게이트웨이, AgentCore 메모리, Amazon Bedrock을 조정합니다.
두 입장 지점이 하나의 에이전트로 집중된다. 텔레그램 메시지는 Amazon API Gateway와 AWS Lambda 함수의 웹호크를 통해 도착하며, 아침 물주기 알림과 같은 예약 작업은 Amazon EventBridge Scheduler와 cronjob Lambda 함수를 통해 도착한다. 둘 다 에이전트Core 런타임에서 InvokeAgentRuntime API를 호출하는데, 이때 얇은 server.py 프로세스가 OpenClaw 게이트웨이, 에이전트Core 메모리, Amazon Bedrock Converse API를 조정한다. Amazon Simple Storage Service(Amazon S3)는 작업 공간 저장을 제공하고, AWS Key Management Service(AWS KMS)는 암호화를 처리하며, AWS Secrets Manager는 봇 토큰을 보관하고, Amazon CloudWatch는 로그와 메트릭을 수집한다.
전제 조건
Launch Stack 버튼이나 scripts/deploy.sh를 사용하여 자신의 버전을 배포하려면, Grow your own 섹션에 설명된 대로 다음 사항이 필요합니다:
- 아마존 Bedrock AgentCore 접근 권한, AgentCore 런타임 및 AgentCore 메모리 포함.
- 로드할 계획인 모델에 대한 접근 권한이 부여되었습니다: 텍스트용 Claude Haiku 4.5와 비전용 Claude Sonnet 4.5 또는 귀하의 계정에서 사용 가능한 동급 모델들입니다.
- Docker가
linux/arm64빌드 지원을 제공하며, AWS 명령줄 인터페이스(AWS CLI)도 설정되어 있습니다. 이는 자신만의 이미지를 빌드하고 배포할 계획이 있는 경우에만 필요합니다. - 봇파터에서 받은 텔레그램 봇 토큰은 조수의 프런트 데스크 역할을 합니다.
- 에이전트 오케스트레이션 개념과 클라우드포멘트에 대한 기본적인 이해.
아키텍처: AgentCore 런타임에서 실행되는 서버리스 에이전트
각 구성 요소는 단일 클라우드포메이션 템플릿에 존재하며, 실행하기 위해 어떤 빌드 도구도 필요하지 않습니다. 다음 섹션에서는 하중을 견디는 결정 사항들을 설명합니다.
AgentCore 런타임: 활성 컴퓨팅에만 비용을 지불하세요
엔티티는 AgentCore 런타임 환경의 컨테이너에 존재하며, 이 컨테이너는 소비 기반 가격 정책을 사용합니다. 엔티티가 실제로 사용하는 연산량에 대해 요금이 부과되며, 월령 유지 시간이나 모델 응답과 같은 I/O 작업을 기다리는 시간에는 요금이 부과되지 않습니다. 짧은 시간 동안만 사용되는 개인 비서의 경우, 약 $1–2/월의 기본 요금과 항상 켜져 있는 Amazon Elastic Compute Cloud(Amazon EC2) 인스턴스의 약 $35/월의 요금 사이의 차이가 있습니다. 이 수치는 2026년 7월 기준으로 가벼운 개인 사용을 위한 추정치입니다. 현재 요금은 AgentCore 가격 정책을 참조하세요.
실행 시간은 최소한의 컨테이너 계약을 적용합니다: 8080번 포트에서 리스닝하며, 건강 상태를 확인하기 위해 GET /ping를, 에이전트의 엔트리 포인트로 POST /invocations를 노출합니다. 우리의 컨테이너는 linux/arm64이며, 공식 OpenClaw 이미지와 Python 계층을 이용하여 다단계로 빌드됩니다.
OpenClaw를 에이전트 서브스트레이트로 사용
OpenClaw는 에이전트 루프, 도구 사용, 그리고 스킬 시스템을 제공합니다. 이는 server.py라는 래퍼를 실행하여 AgentCore HTTP 프로토콜 계약에 적합하게 변형시킵니다.
- 컨테이너가 시작될 때,
server.py는openclaw gateway run을 프로세스로 실행하여 상태 검사를 수행합니다. GET /ping는 빠르게 건강한 상태를 반환하므로, AgentCore 준비성 프로브가 통과됩니다.POST /invocations이 실제 작업을 수행합니다: 페이로드를 파싱하고, 메모리를 조회하며, 컨텍스트를 조립한 후 게이트웨이로 전달하고, 결과를 저장합니다. 한 가지 주의점은 AgentCore가 종료된 하위 프로세스를 가진 동결된 컨테이너를 해동할 수 있다는 것입니다. 따라서 호출 경로는 게이트웨이가 정상적으로 작동하는 것을 전제하지 않으며,ensure_openclaw_ready()도우미를 호출하여 상태를 다시 확인하고(필요한 경우 게이트웨이를 재시작함) 전달을 진행합니다.
이 래퍼러 패턴은 다른 사용 사례에도 일반화됩니다. 로컬 프로세스로 실행되는 어떤 에이전트 프레임워크도 프레임워크 자체를 수정하지 않고, 같은 방식으로 AgentCore 런타임에 적용될 수 있습니다.
두 가지 모델, 작업에 따라 라우팅됨
텍스트 채팅과 이미지 이해의 비용과 품질의Trade-off가 다르기 때문에, 어시스턴트는它们을 Bedrock에서 다른 Claude 모델로 라우팅합니다:
- Claude Haiku 4.5 for text: 일상적인 사용에서 흔히 발생하는 많은 대화가가 있는 경우에 빠르고 저렴하게 작동합니다.
- Claude Sonnet 4.5 for vision: 사진으로 식물을 진단하는 덜 자주 발생하지만 더 어려운 작업에 대한 더 강력한 다중 모드 추론.
텍스트는 OpenClaw 게이트웨이를 통과하여 기술과 세션 상태가 전달됩니다. 이미지는 server.py에서 Bedrock의 대규모 언어 모델(LLM)에 직접 호출되며, 이미지 바이트를 다중 모드 콘텐츠 블록으로 전달합니다. 이미지가 게이트웨이를 통과하는 방식을 의도적으로 설정했습니다: 컨테이너 내부의 OpenClaw 빌드는 image_url 콘텐츠 부분이 Bedrock에 도달하기 전에 삭제하므로, server.py에서 Converse API를 직접 호출하면 모델이 실제 픽셀을 볼 수 있도록 합니다. 두 경로는 동일한 시스템 프롬프트(페르소나와 메모리)를 공유하므로 경험이 일관되게 유지됩니다.
모델 ID는 환경 변수(MODEL_ID, VISION_MODEL_ID)이므로, 이미지를 재구축하지 않고 배포마다 모델을 교체할 수 있습니다.
기술은 재사용 가능한 기능 단위입니다
capability들은 community-skills.json 마이너스페이지에서 스킬로 선언됩니다. 배포 시점 스크립트가 이를 컨테이너에 구현하고 이미지가 생성되기 전에 OpenClaw 설정에 등록합니다. Sprout는 이 글을 게시할 때 날씨, 알림, 식물 노트 관련 스킬들을 제공합니다. 마이너스페이지를 바꾸면 동일한 파이프라인이 다른 도메인을 처리합니다. 이것이 전체를 재사용 가능한 패턴으로 만드는 이유이며, 단순한 봇이 아닙니다.
텔레그램은 서버리스 전면 문과 같습니다
Telegram은 웹호크 기반이기 때문에 개인 비서로서 실용적인 채널이며, 모든 것을 서버리스로 처리합니다. 클라이언트 개발이 필요 없으며, 사용자가 이미 보유한 모든 기기에서 작동하고, 간단한 봇 API를 통해 텍스트, 이미지, 풍부한 형식화도 지원합니다. BotFather는 봇 토큰을 발급하며, 이 토큰은 Secrets Manager에 저장됩니다. 배포 시 웹호크가 Telegram의 API 게이트웨이 엔드포인트로 연결됩니다. 사용자가 메시지를 보내면, Telegram은 웹호크 Lambda 함수로 전달하여 페이로드를 검증하고 InvokeAgentRuntime를 호출합니다. 응답은 다시 Telegram 봇 API를 통해 반환됩니다.
주목해야 할 포맷팅 교훈: 텔레그램의 레거시 마크다운 모델은 제외된 문자에 대해 엄격합니다. 모델 응답에 단 하나의 구분기호가 빠지면 전체 메시지가 전송되지 않을 수 있습니다. 답장을 HTML로 렌더링하는 것이 안정적이므로, 어시스턴트는 보내기 전에 모델 출력 결과를 텔레그램에서 안전한 HTML로 변환합니다.
기억: 일회용 채팅을 지속 가능한 지식으로 전환하기
지금까지 설명된 아키텍처는 유능하고 저비용의 서버리스 에이전트이지만, 단독으로서는 대화 사이에 사용자를 잊어버린다. 메모리가 그 문제를 해결한다. 몇 주 전에 유기농 방식으로 정원을 가꾼다고 말했는데, 오늘 조수가 치료법을 추천하고, 합성 비료를 사용하지 않기 때문에 유기농 옵션을 선택했다고 단독으로 추가한다고 상상해 보라. 상태 없는 모델은 그렇게 할 수 없다.
정신 모델: 단기적 사건, 장기적 추출
AgentCore 메모리에는 두 가지 레이어가 있습니다. 단기 기억은 모든 대화 턴을 CreateEvent를 통해 이벤트로 저장하며, actorId(Telegram 채팅 ID)와 sessionId로 키가 지정됩니다. 이는 원시 녹취입니다. 장기 기억은 관리된 추출 전략을 통해 비동기적으로 구조화된 기록으로 생성됩니다. 우리는 세 가지 전략을 설정했습니다:
USER_PREFERENCE: 정원사가 명시한 명확한 선택 사항 (“저는 유기농 비료만 사용합니다”).SEMANTIC: 추론된 사실 (“코르텐 강철로 만든 화단에서 멕시코식 파초를 재배함”).SUMMARIZATION: 에피소드별 세션 요약 (“열파 동안 아래 잎이 노랗게 변하는 문제에 대해 논의함”).
명명 공간: 정원마다 한 명의 정원사
스프라우트 파일은 각 사용자 네임스페이스에 기록되므로, 두 번의 채팅이 결코 섞이지 않습니다.
sprout/{chat_id}/long_term: 선호도 및 의미론적 사실들.sprout/{chat_id}/episodic/{session_id}: 세션 요약 정보.
채팅 ID는 유일한 변수 부분이므로 격리를 논리적으로 이해하고 테스트하기 쉽습니다: 각 고유한 정원사는 정확히 하나의 네임스페이스에 해당하며, 두 정원사는 충돌하지 않습니다.
검색, 조립, 주입 파이프라인
각 턴마다 에이전트는 관련된 장기적 기록을 가져와서 순위를 매고, 그것들을 시스템 프롬프트에 삽입합니다. server.py 내의 모든 메시지에서 이런 일이 발생합니다.
- 조회하기. 전화
RetrieveMemoryRecords반대에sprout/{chat_id}/long_term사용자의 메시지를 검색 쿼리로 사용하여 50개의 결과까지 얻고, 3초 이내에 처리해야 합니다. 검색 시간이 초과되거나 오류가 발생하면, 성공하지 않고 메모리를 사용하지 않고도 우아하게 대처합니다.
try:
    records = memory_client.retrieve_memory_records(
        memoryId=MEMORY_ID,
        namespace=f'sprout/{chat_id}/long_term',
        searchCriteria={
            'searchQuery': user_message,
            'topK': 50,
            'metadataFilters': []
        },
    )  # 3s timeout
except Exception:
    records = []  # fall back to answering without memory
예시 1: 현재 턴에 대한 장기 기록을 조회하는 것 (대표적 예시입니다. 전체 소스는 리포지토리를 참조하세요).
Assemble 함수는 추가적인 커스터마이즈 로직을 추가합니다. 우리는 명시적인 선호도가 추론된 사실보다 우선되기를 원하며, 각 클래스 내에서는 순서가 안정적이어야 하며, 인젝션 전에 결과가 제한되기를 원합니다:
def assemble(records, cap=50):
    explicit = [r for r in records if r.type == 'USER_PREFERENCE']
    inferred = [r for r in records if r.type != 'USER_PREFERENCE']
    # explicit beats inferred; stable order within each class
    ordered = explicit + inferred
    return ordered[:cap]
단락 2: 조립 단계는 추론된 사실보다 명시적인 선호도를 우선적으로 평가합니다.
메타데이터: 네임스페이스 내의 메모리 분류
명명 공간은 기록이 속한 메모리에 대한 정보를 제공하지만, 메타데이터는 그 기록이 무엇에 관한 것인지를 제시합니다. sprout/{chat_id}/long_term 내에서는 “내 petunias가 시들고 있다”라는 문장에 대한 의미적 검색 결과로, 의미상 유사한 모든 내용이 반환됩니다. 정원사에게 이는 3월에 사용할 비료 선호도와 무화과 나무 가지치기 지침과 같은 중요한 기록들이 함께 등장한다는 것을 의미합니다. 그리고 구조화된 메타데이터는 프롬프트에 도달하기 전에 메모의 범위를 좁히는 데 도움이 됩니다.
한 가지 규칙이 여기서 모든 결정을 지배합니다. 메타데이터 키는 인덱스 키로 선언해야만 서버 측에서 필터링할 수 있습니다. 더 자세한 내용은 Amazon Bedrock AgentCore Memory의 메타데이터를 활용한 구조화된 메모리 필터링를 참조하세요. 이 경우, sprout는 세 개의 인덱스 키를 사용합니다.
IndexedKeys:  # on the AWS::BedrockAgentCore::Memory resource
  - Key: type  # seperate the kinds of records
    Type: STRING
  - Key: section  # which bed or area it describes
    Type: STRING
  - Key: plants  # what is growing there
    Type: STRINGLIST
각 항목은 필터링이 가능하도록 인덱싱된 키와 일치해야 하는 키를 지정하며, extractionType는 이벤트로 전달된 STRICTLY_CONSISTENT 또는 대화에서 추출된 LLM_INFERRED 중 하나로 설정됩니다. 추론된 키의 경우, 추출 설정이 값을 고정된 목록으로 제한할 수 있습니다. Sprout는 이를 정확히 처리하므로 두 가지 저장 경로 모두 동일한 어휘를 생성하며, 필터는 기록을 생성한 부분과 관계없이 같은 의미를 가집니다.
턴을 유지하고 루프를 종료하기
모델이 응답한 후, server.py는 사용자와 어시스턴트의 대화를 포함한 CreateEvent를 호출합니다. 이 새로운 이벤트는 추출 전략에 전달되어, 다음번에 긴 기간 동안의 저장소가 보완됩니다.
memory.create_event(
    memoryId=MEMORY_ID,
    actorId=chat_id,
    sessionId=session_id,
    payload=[
        {'role': 'user', 'content': user_message},
        {'role': 'assistant', 'content': reply},
    ],
)  # feeds USER_PREFERENCE / SEMANTIC / SUMMARIZATION extraction; errors are logged, never fatal
예시 3: 턴을 지속적으로 저장하여 추출 전략이 비동기적으로 장기 기억을 풍부하게 만들 수 있도록 합니다.
추출은 비동기적이므로, 이 세션에서 언급된 사실은 나중의 세션에서 다시 검색할 수 있게 됩니다. 이러한 지연을 고려하여 설계하세요: 단기 세션 이벤트는 현재 대화를 다루고, 장기 기록은 그 이전의 모든 내용을 담습니다.
조합된 결과: 개인화된 물주기 계획
이곳에서 전체 파이프라인이 엔드투엔드로 작동합니다. 몇 번의 대화를 통해 당신은 아름다운 정원의 모든 식물을 한 개씩, 쉬운 언어로 카탈로그로 만듭니다. 각 언급은 하나의 이벤트가 됩니다. 추출 전략은 식물, 그 위치, 일광 노출에 대한 정보를 sprout/{chat_id}/long_term에 추출합니다. 오늘 아침 사용자가 “정원에 있는 다른 식물들을 기억하나요?”라는 질문을 합니다. 검색 과정에서 기록이 다시 불러와지고, 순서가 정렬된 후 시스템 프롬프트로 전달됩니다. 어시스턴트는 사용자의 위치, 일광 노출, 심기 방식, 토양 특성, 식물 목록 등 메시지 자체에 나타나지 않은 정보를 제공합니다.
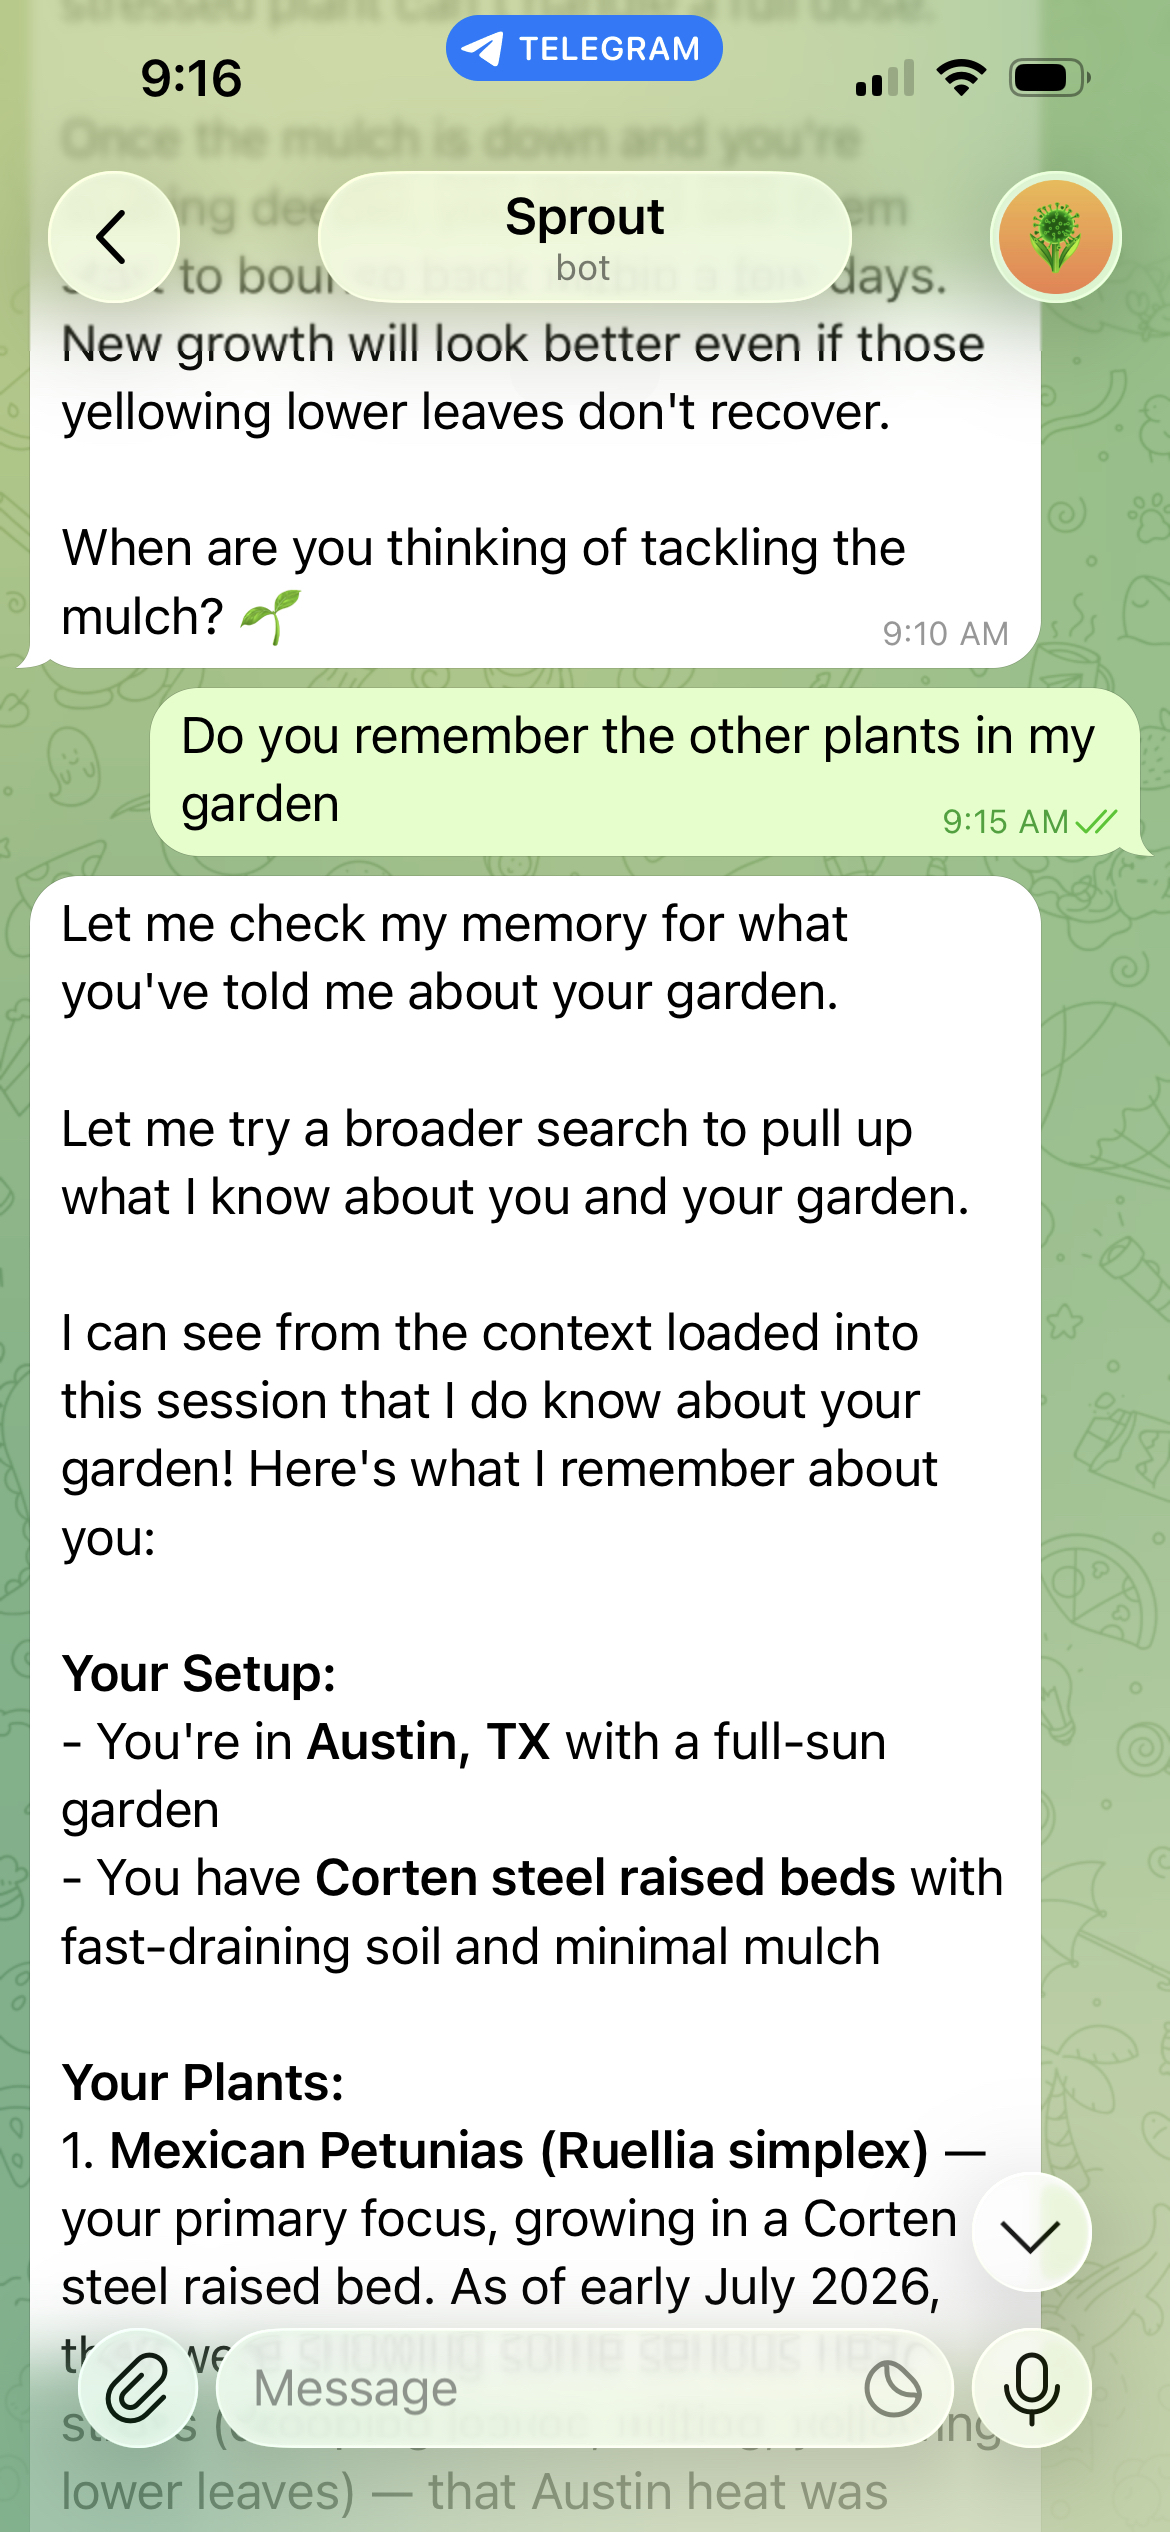
그림 2: 스프라우트는 저장된 식물 재고와 재배 조건을 회상하여 정원에 관한 질문에 답합니다.
Amazon EventBridge → Cron 경로의 스케줄러 기술을 사용하여 Sprout는 그 계획을 예방적인 알림으로 변환할 수 있으며(“채소를 건너뛰세요, 흙이 어제부터 여전히 습하다”), 또한 비가 오거나 열파가 올 때 기상 기술을 활용해 조정할 수 있습니다.
기억과 시각도 서로 결합된다. 사용자가 시들어가는 식물의 사진을 보내면, 그 이미지는 Claude Sonnet 4.5로 전송되며, 시스템 프롬프트에는 기억 레이어가 알고 있는 모든 정보가 남아 있다. 어시스턴트는 사용자에 저장된 멕시코 푸들리아 식물들과 사진을 일치시키고, 익명의 식물 사진을 분석하는 대신 맥락상의 시들음 스트레스를 진단한다.
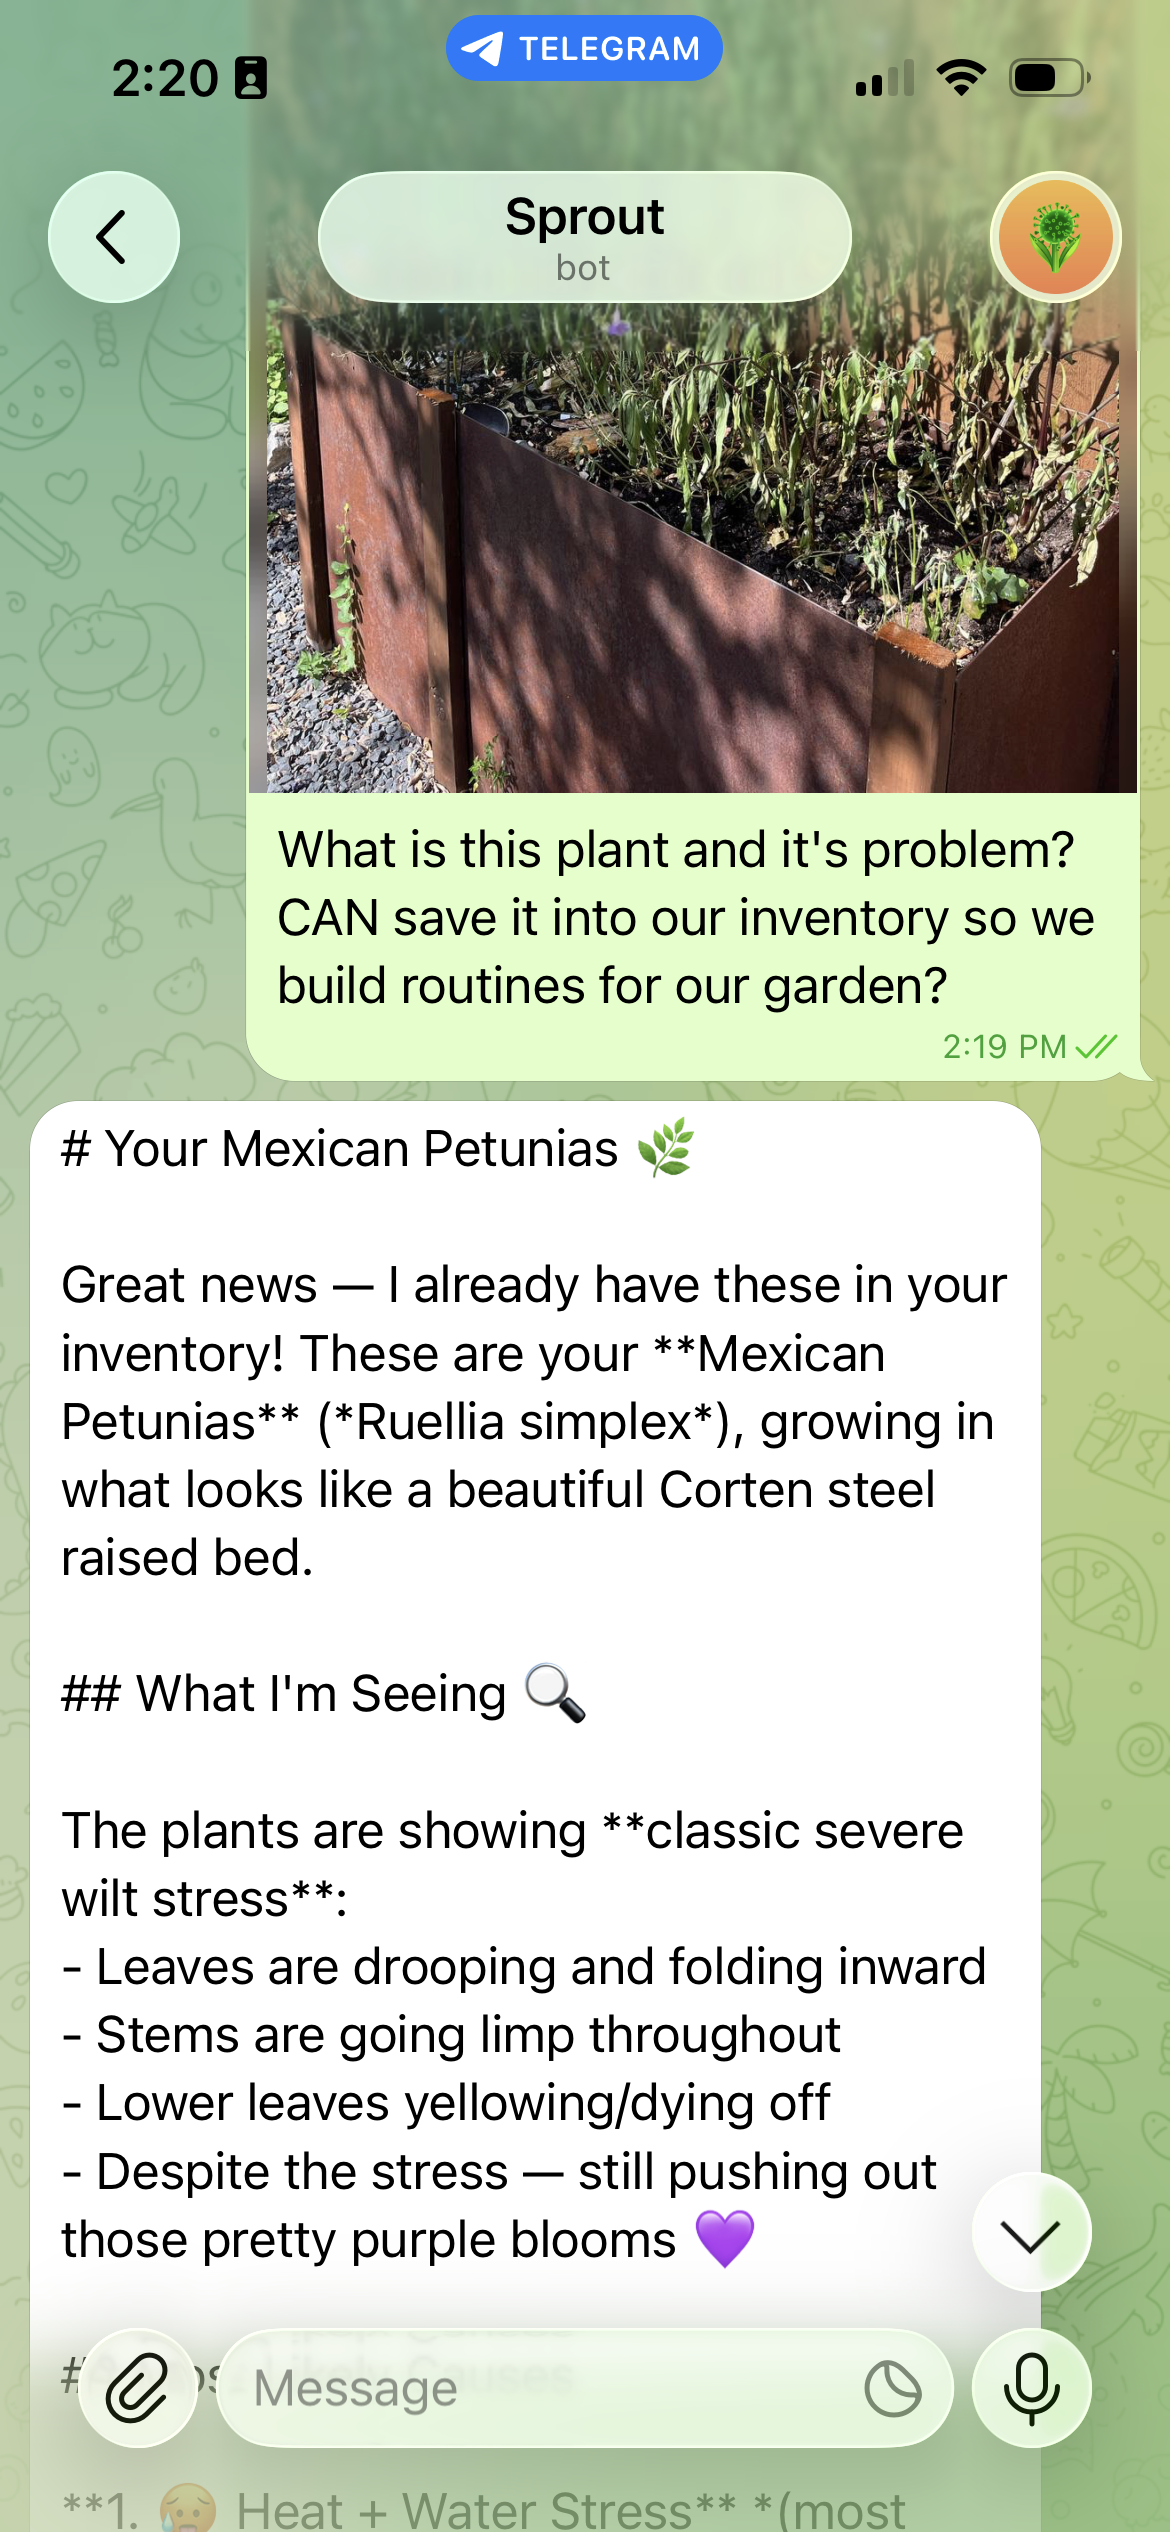
그림 3: 시각과 기억이 함께 작동하는 모습. 사진은 시각 모델에 속하고, 시스템 프롬프트는 사용자의 저장된 정원 컨텍스트를 나타냅니다.
비전 모델은 완벽하지 않습니다. 이전에 재고 상황이 없는 대화에서, 같은 식물이 아침의 기쁨이라고 확신에 찬 것으로 식별되었는데, 이는 종려꽃 모양의 보라색 꽃을 가진 종입니다. 사용자의 저장된 재고 정보와 비전 모델을 연동함으로써, 설득력 있는 추측이 정확한 개인화된 진단으로 변했으며, 이는 기억이 정확성을 향상시키는 이유를 잘 보여줍니다.
프롬프트 캐싱을 통해 추론 비용을 낮추기
각 턴에 메모리를 주입하면 시스템 프롬프트가 커지고, 순진한 구현 방식으로는 모든 요청에서 그 토큰을 지불해야 합니다. Amazon Bedrock의 프롬프트 캐싱이 이 문제를 해결합니다. 어시스턴트는 프롬프트를 구성하여 안정적인 프리픽스, 인물, 그리고 조합된 메모리 블록이 먼저 오고 변동적인 사용자 메시지가 마지막으로 오도록 합니다. Bedrock은 처리된 프리픽스를 요청 간에 캐싱하므로, 대화 내에서 반복되는 턴에서는 변하지 않는 부분을 다시 계산할 필요가 없습니다. 프롬프트 캐싱은 지원되는 모델의 경우 비용을 최대 90퍼센트, 지연 시간을 최대 85퍼센트까지 줄일 수 있습니다.
순서 규칙은 단일 설정보다 더 중요합니다: 안정적인 콘텐츠를 먼저, 불안정한 콘텐츠를 마지막에 배치하고, 메모리 블록의 내부 순서가 결정적이 되도록 하세요(이는 앞선 어셈블리 함수가 도와줍니다). 그래야 요청들 사이에서 접두사가 정확하게 일치합니다.
AgentCore와 OpenClaw를 기반으로 구축하는 디자인 가이드라인
스프라우트는 하나의 보조 도구이지만, 그 뒤에 있는 결정들은 일반화될 수 있습니다. 이 스택을 기반으로 자신만의 보조 도구를 만들고 있다면, 다음 지침들이 모든 분야에 적용될 것입니다.
- 포워드하세요, 포크하지 마세요. 프레임워크를 수정하는 대신, 얇은 HTTP 래퍼를 사용하여 AgentCore 컨테이너 계약에 맞게 에이전트 프레임워크를 적용하세요. 이 계약은 작고, 포트는 8080이며
/ping와/invocations가 있습니다. 래퍼를 사용하면 프레임워크 업그레이드 과정을 유지할 수 있습니다. - 무엇이든 저장하기 전에 디자인 네임스페이스를 만들어야 합니다. 메모리 네임스페이스는 귀하의 격리 경계입니다. 사용자 ID만을 유일한 변수로 설정하고, 채팅 ID와 같은 신뢰할 수 있는 채널 기본 ID를 선택하세요. 다중 테넌트 디자인은 결국 감사 및 삭제 요청을 받게 됩니다. 깨끗한 네임스페이스 체계는 둘 다 간단하게 만듭니다.
- 메모리를 향상된 기능으로 대하되, 의존성으로 여기지 마세요. 모든 메모리 작업은 원활하게 실패할 수 있도록 허용되어야 합니다. 검색 실패는 응답을 차단하지 않고 메모리와 무관한 답변을 제공해야 합니다. 사용자들은 실패한 경우보다 부주의한 행동을 더 쉽게 용서합니다.
- 작업에 따라 라우팅 모델을 선택하세요. 대량의 텍스트에 대해서는 빠르고 비용 효율적인 모델을 사용하고, 필요한 경우에는 더 강력한 다모달 모델을 사용하세요. 모델 ID는 환경 변수에 저장하여 라우팅 변경이 코드가 아닌 설정으로 이루어지도록 하세요.
- 캐시에 대한 주문 프롬프트입니다. 안정적인 인격과 기억을 먼저, 불안정한 사용자 입력을 마지막으로 처리하며, 전체적으로 결정론적 순서를 유지합니다. 이러한 구조적 습관이 대부분의 추론 비용 절감의 원인입니다.
- 추출 지연 시간 계획. 장기 기억은 비동기적으로 추출되므로, 새로운 사실을 같은 세션에서 다시 인식할 수 있다고 약속하지 마세요. 단기 세션 이벤트가 현재 대화를 담당하고, 장기 기록이 이전 대화를 담당하도록 하세요.
- 처음부터 예산을 설정하세요. 소비 기반 에이전트는 재시도 루프나 대화형 사용자가 그렇게 하지 않을 때까지 비용이 들지 않습니다. AWS Budgets 알림이 월간 한도의 80퍼센트와 100퍼센트에 도달하면 아무런 비용도 들지 않으며 예상치 못한 상황을 조기에 파악할 수 있습니다.
- 기술을 작고 단일 목적으로 유지하세요. 기술은 사용자가 한 문장으로 설명할 수 있는 하나의 기능만을 수행해야 합니다. 예를 들어 날씨 확인이나 알림 설정과 같습니다. 작은 기술은 독립적으로 테스트될 수 있고, 독립적으로 교체될 수 있으며, 모델이 올바르게 선택하기 쉽습니다. 모든 일을 하는 기술은 모델이 사용자의 의도를 어떻게 행동으로 표현하는지 추측하도록 강요합니다.
자신만의 것을 키우세요
같은 정원에 심는 두 가지 방법:
- 단계별 런치 스택: CloudFormation 템플릿은 공개된 Amazon Elastic Container Registry(Amazon ECR) 이미지를 지정하므로, Telegram 봇 토큰만 배포됩니다.
- 자신만의 빌드를 만들기: scripts/
deploy.sh스크립트는 템플릿을 검증하고, 자신만의 ARM64 이미지를 빌드하여 개인용 Amazon ECR 저장소에 푸시하며, 스택을 배포하고 Telegram 웹호킹을 등록하여 완전히 커스터마이징 가능한 빌드를 제공합니다.
2026년 7월 기준으로 개인적인 사용을 위한 비용은 월 약 5~9달러입니다(약 2달러는 인프라, 1~3달러는 하이ку 텍스트, 2달러는 소네트 비전에 따른 비용). 내장된 AWS 예산 기능은 설정한 한도의 80%와 100%에 도달할 때 알림을 보냅니다.
전체 소스 코드는 sample-agentcore-memory-openclaw GitHub 저장소에서 확인할 수 있습니다.
정리하기
실험이 끝난 후에는 지속적인 비용을 피하기 위해 모든 것을 철거해야 합니다. 전체 시스템이 하나의 CloudFormation 스택이기 때문에, 정리 작업은 단순히 삭제하는 것만으로 해결됩니다.
- CloudFormation 스택을 삭제하세요. 이로써 AgentCore 런타임 에이전트, API Gateway, Lambda 함수, Amazon EventBridge 일정, 그리고 관련 AWS Identity and Access Management(IAM) 역할이 제거됩니다.
- AgentCore 메모리 저장소(그리고 그 명명空间들)를 삭제하여 사용자 기록이 남지 않도록 합니다.
- 개인적인 ECR 저장소에 업로드한 모든 이미지를 삭제하세요. 필요하지 않은 경우 저장소 자체도 삭제하세요.
- 스택 외부에서 생성한 경우 AWS 예산 알림을 제거하세요.
- Telegram의 웹호크를 취소하거나 BotFather를 통해 봇을 삭제하고, 더 이상 필요하지 않다면 Bedrock 모델에 대한 접근도 취소해야 합니다.
결론
이 솔루션의 재사용 가능한 핵심은 Amazon Bedrock AgentCore에 있는 서버리스 에이전트로, 스킬 시스템과 관리되는 메모리가 포함되어 있습니다. AgentCore 메모리는 맞춤형 벡터 저장소와 추출 파이프라인을 구축할 필요를 없애주며, 에이전트가 기억하고 잊는 내용에 대한 완전한 제어권을 제공합니다. 소비 기반 컴퓨팅과 프롬프트 캐싱은 한 달 몇 달러로 진정으로 개인화된 도우미를 구현할 수 있게 해주며, OpenClaw 스킬 매니페이스는 이 패턴을 다양한 분야로 이동시킬 수 있게 합니다. 개인화도 더욱 강화됩니다: 사용자가 더 많이 상호작용할수록 도우미가 더 유용해집니다.
더 나아가, ‘물 주기 알림’과 같은 단일 도메인부터 시작하여 메모리 범위를 점진적으로 확장하세요. 에이전트가 과거의 대화를 참조할 수 있도록 에피소드 기반의 기억을 탐구하거나, 저장소를 fork하여 자신만의 인격과 기술을 추가하고 필요한 도우미를 성장시켜 보세요.
더 자세한 내용은 AgentCore 문서를 참조하세요. 다음 관련 게시물들은 구성 요소에 대해 더 깊이 있게 설명합니다:
- 아마존 Bedrock AgentCore 메모리: 컨텍스트 인지형 에이전트 구축
- 더 똑똑한 AI 에이전트를 만들기: AgentCore 장기 기억 심층 분석
- Amazon Bedrock에서 프롬프트 캐싱을 효과적으로 활용하기
- Amazon Bedrock AgentCore 런타임에서 당신의 에이전트와 도구를 안전하게 실행하고 확장하세요