
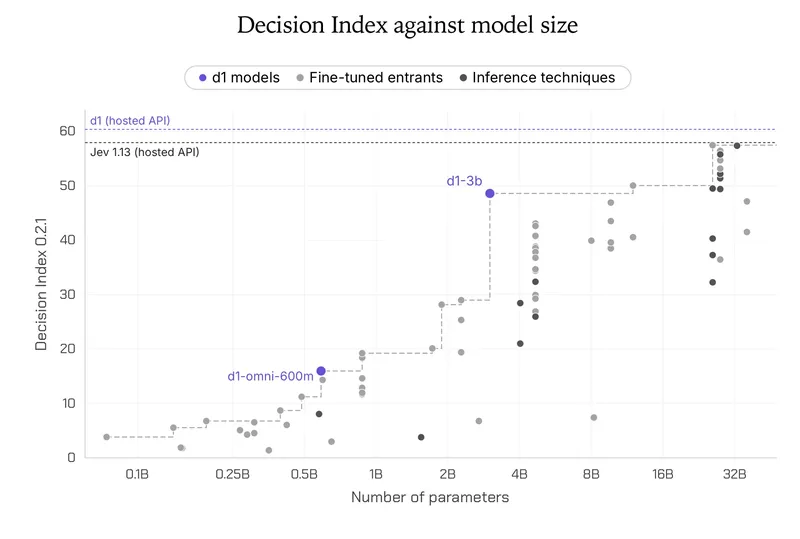
오늘 우리는 다음 제품군에서 두 개의 오픈 결정 모델을 공개합니다: d1 결정 모델 계열: d1-3B 그리고 d1-omni-600M (실험적).
- Decision Index 0.2.1에서 10B 미만 최고의 결정 모델: d1-3B는 48.57점을 기록하며 모든 4B 및 9B 모델과 Decider 35B-A3B (47.11)를 앞섭니다.
- 멀티모달: d1-3B는 텍스트와 이미지를 지원하며, d1-omni-600M은 텍스트와 이미지 또는 텍스트와 오디오를 지원합니다
- 빠른 속도: d1-3B는 NVIDIA Jetson AGX Thor에서 16 ms, Jetson AGX Orin에서 26 ms, Jetson Orin Nano에서 50ms 만에 질문에 답변합니다
엣지용 결정 모델을 만든 방법
이 오픈 d1 결정 모델들은 우리의 Liquid Foundation Models(LFMs)를 기반으로 구축되었습니다. 생성 모델과 달리, 결정 모델은 토큰을 생성하지 않고 단일 포워드 패스로 답변합니다.
d1-3B와 d1-omni-600M은 매우 다른 두 백본에서 학습되었습니다:
- d1-3B 는 다음으로부터 학습되었습니다: LFM2.5-VL-3B, 디코더 전용인 우리의 최신 VLM입니다. 텍스트와 이미지를 입력으로 받아들입니다.
- d1-omni-600M 은 다음으로부터 학습되었습니다: LFM2.5-Encoder-350M, 양방향 인코더입니다. 세 가지 모달리티를 모두 처리하기 위해 비전 및 오디오 인코더를 추가합니다. 텍스트와 이미지, 또는 텍스트와 오디오를 입력으로 받아들입니다. 이 모델은 현재 초기 연구 릴리스 단계에 있으며 추가 개발이 진행 중입니다.
벤치마크 결과
우리는 읽기 이해, 독성 탐지, 의도 분류, 의료 QA, 그리고 교차 언어 이해에 걸친 일곱 개의 공개 데이터셋에서 d1-3B와 d1-omni-600M을 벤치마크했습니다. d1-3B는 평균 82.9점을 달성하여 표에서 가장 높은 점수이며 Decider 4B를 넘어섰습니다. d1-omni-600M은 78.4점을 기록하여, 4분의 1 수준의 파라미터만으로 Decider 2B (77.1)를 넘어섰습니다.
| 벤치마크 | d1-omni-600M | d1-3B | Decider 2B | Decider 4B |
|---|---|---|---|---|
| SQuAD 2.0 | 74.0 | 83.3 | 67.7 | 76.0 |
| Civil Comments | 95.8 | 93.3 | 93.6 | 92.8 |
| MASSIVE intent | 86.1 | 86.9 | 81.1 | 88.3 |
| PubMedQA | 61.3 | 68.3 | 65.7 | 63.3 |
| BoolQ | 77.7 | 86.3 | 87.3 | 89.0 |
| XNLI | 74.7 | 85.6 | 85.0 | 88.6 |
| PAWS-X | 79.5 | 76.4 | 59.5 | 69.8 |
| 평균 | 78.4 | 82.9 | 77.1 | 81.1 |
우리는 d1-3B가 표준 비전 벤치마크에서 LFM2.5-VL-3B 백본의 비전 능력을 유지하고, d1-omni-600M이 세 가지 모달리티를 모두 처리함을 검증했습니다. Decision Index v0.3에는 비공개 비전 분할만 포함되어 있고 오디오 결정 벤치마크는 현재 미해결 과제이므로, 어떠한 비전 또는 오디오 벤치마크 결과도 보고하지 않습니다.
속도
NVIDIA와의 협력을 통해 d1-3B를 NVIDIA GeForce RTX 4090, NVIDIA Jetson AGX Thor, Jetson AGX Orin 64 GB, Jetson Orin Nano의 NVIDIA 스택에서 평가했습니다. d1-omni-600M은 초기 연구 릴리스이므로 이번 릴리스에서는 이에 대한 속도 수치를 보고하지 않습니다.
엣지 추론. d1-3B는 측정된 모든 기기에서 하나의 질문에 50 ms 미만으로 답변합니다. 세 개의 질문은 하나의 질문에 비해 1.3배의 시간만 소요되며, AGX Thor의 경우 16 ms에서 20 ms로 증가합니다.
| 1개 질문 | 3개 질문 | 3.4K 토큰 상태 | 384px 이미지 | 64개 상태, 압축됨 | |
|---|---|---|---|---|---|
| Apple M5 Pro | 30 ms | 41 ms | 640 ms | 62 ms | 78 / s |
| Jetson AGX Thor | 16 ms | 20 ms | 220 ms | 35 ms | 262 / s |
| Jetson AGX Orin 64 GB | 26 ms | 35 ms | 560 ms | 83 ms | 110 / s |
| Jetson Orin Nano | 50 ms | 73 ms | 1,640 ms | 202 ms | 38 / s |
GPU 추론. GPU에서 d1-3B는 두 플랫폼 모두에서 1개의 질문에 10 ms 미만으로 답변하고 384px 이미지를 18 ms 미만으로 처리합니다.
| 질문 1개 | 질문 3개 | 3.4K 토큰 상태 | 384px 이미지 | 64개 주, 압축됨 | |
|---|---|---|---|---|---|
| NVIDIA RTX 4090 | 8 ms | 21 ms | 102 ms | 17 ms | 475 / s |
| AMD MI325X | 9 ms | 14 ms | 44 ms | 18 ms | 1,106 / s |
오픈 d1 decision models 사용 방법
빠르고 구조화된 결정, 멀티모달 입력까지 필요할 때 d1 decision models를 활용하세요. d1-3B는 동일 크기 대비 최고 수준의 결정 품질을 제공하며, d1-omni-600M은 설치 공간(footprint)이 중요한 환경에 적합합니다.
의존성을 설치하세요 (필요: transformers>=5.14):
pip install "transformers>=5.14" torch torchvision pillow
이 모델들은 자체 코드를 포함하고 있으므로 다음과 같이 로드합니다 trust_remote_code=True:
import io
import urllib.request

import torch
from PIL import Image
from transformers import AutoModel

device = "cuda" if torch.cuda.is_available() else "mps" if torch.backends.mps.is_available() else "cpu"
model = AutoModel.from_pretrained("LiquidAI/d1-3B", trust_remote_code=True,
                                  dtype=torch.float32 if device == "cpu" else torch.bfloat16).to(device)

# Several named questions over one text state, answered in one pass
questions = {
    "refund": {"type": "noul", "instructions": "Is the customer asking for a refund?"},
    "team": {"type": "choice", "instructions": "Which team should handle this?",
             "criteria": {"billing": "Charges, refunds, invoices", "technical": "App or site faults",
                          "fraud": "Suspected unauthorised use"}},
    "urgency": {"type": "score", "instructions": "How urgent is this?",
                "criteria": ["Can wait", "Today", "Blocking the customer now"]},
}
print(model.system_one("I was charged twice this month, please refund one of them.", questions))

# An image as the whole state
url = "http://images.cocodataset.org/val2017/000000039769.jpg"  # two cats on a sofa
photo = Image.open(io.BytesIO(urllib.request.urlopen(url).read()))
print(model.system_one(None, {"cats": {"type": "choice", "instructions": "How many cats are there?",
                                       "criteria": {"one": "One", "two": "Two", "more": "Three or more"}}},
                       images=[photo]))

# Many requests, packed together with no padding
tickets = ["Where is my parcel? It was due Monday.", "The app crashes when I open settings."]
print(model.system_one_batch([(t, {"team": questions["team"]}) for t in tickets]))
간결함을 위해 d1-3B 예제만 포함했습니다. d1-omni-600M 모델 카드 에서 실행 방법을 확인하세요.
오픈 d1 decision models 시작하기
두 decision models는 모두 오픈 웨이트로 제공되며 오늘 Hugging Face에서 이용할 수 있습니다:
- 다운로드: d1-3B 및 d1-omni-600M 을 Hugging Face에서 내려받으세요.
- 사용해 보기: 저희의 System One Arcade Hugging Face Space에서 데모를 실행해 보세요.
여러분이 만들어낼 결과물을 기대합니다.
인용
이 저작물을 사용하신다면 릴리스 블로그를 인용해 주세요:
@article{liquidAI2026opend1,
  author  = {Liquid AI},
  title   = {Open d1: Edge decision models for text, vision, and audio},
  journal = {Liquid AI Blog},
  year    = {2026},
  note    = {www.liquid.ai/blog/open-d1},
}