
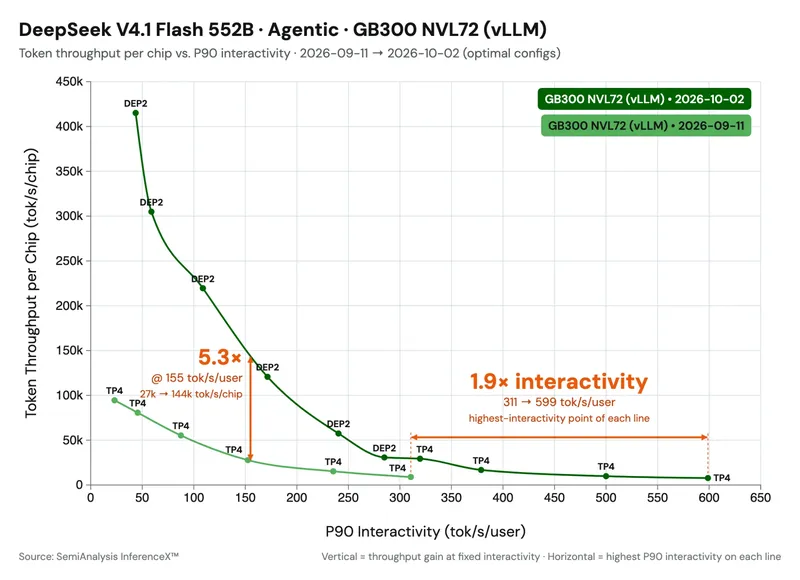
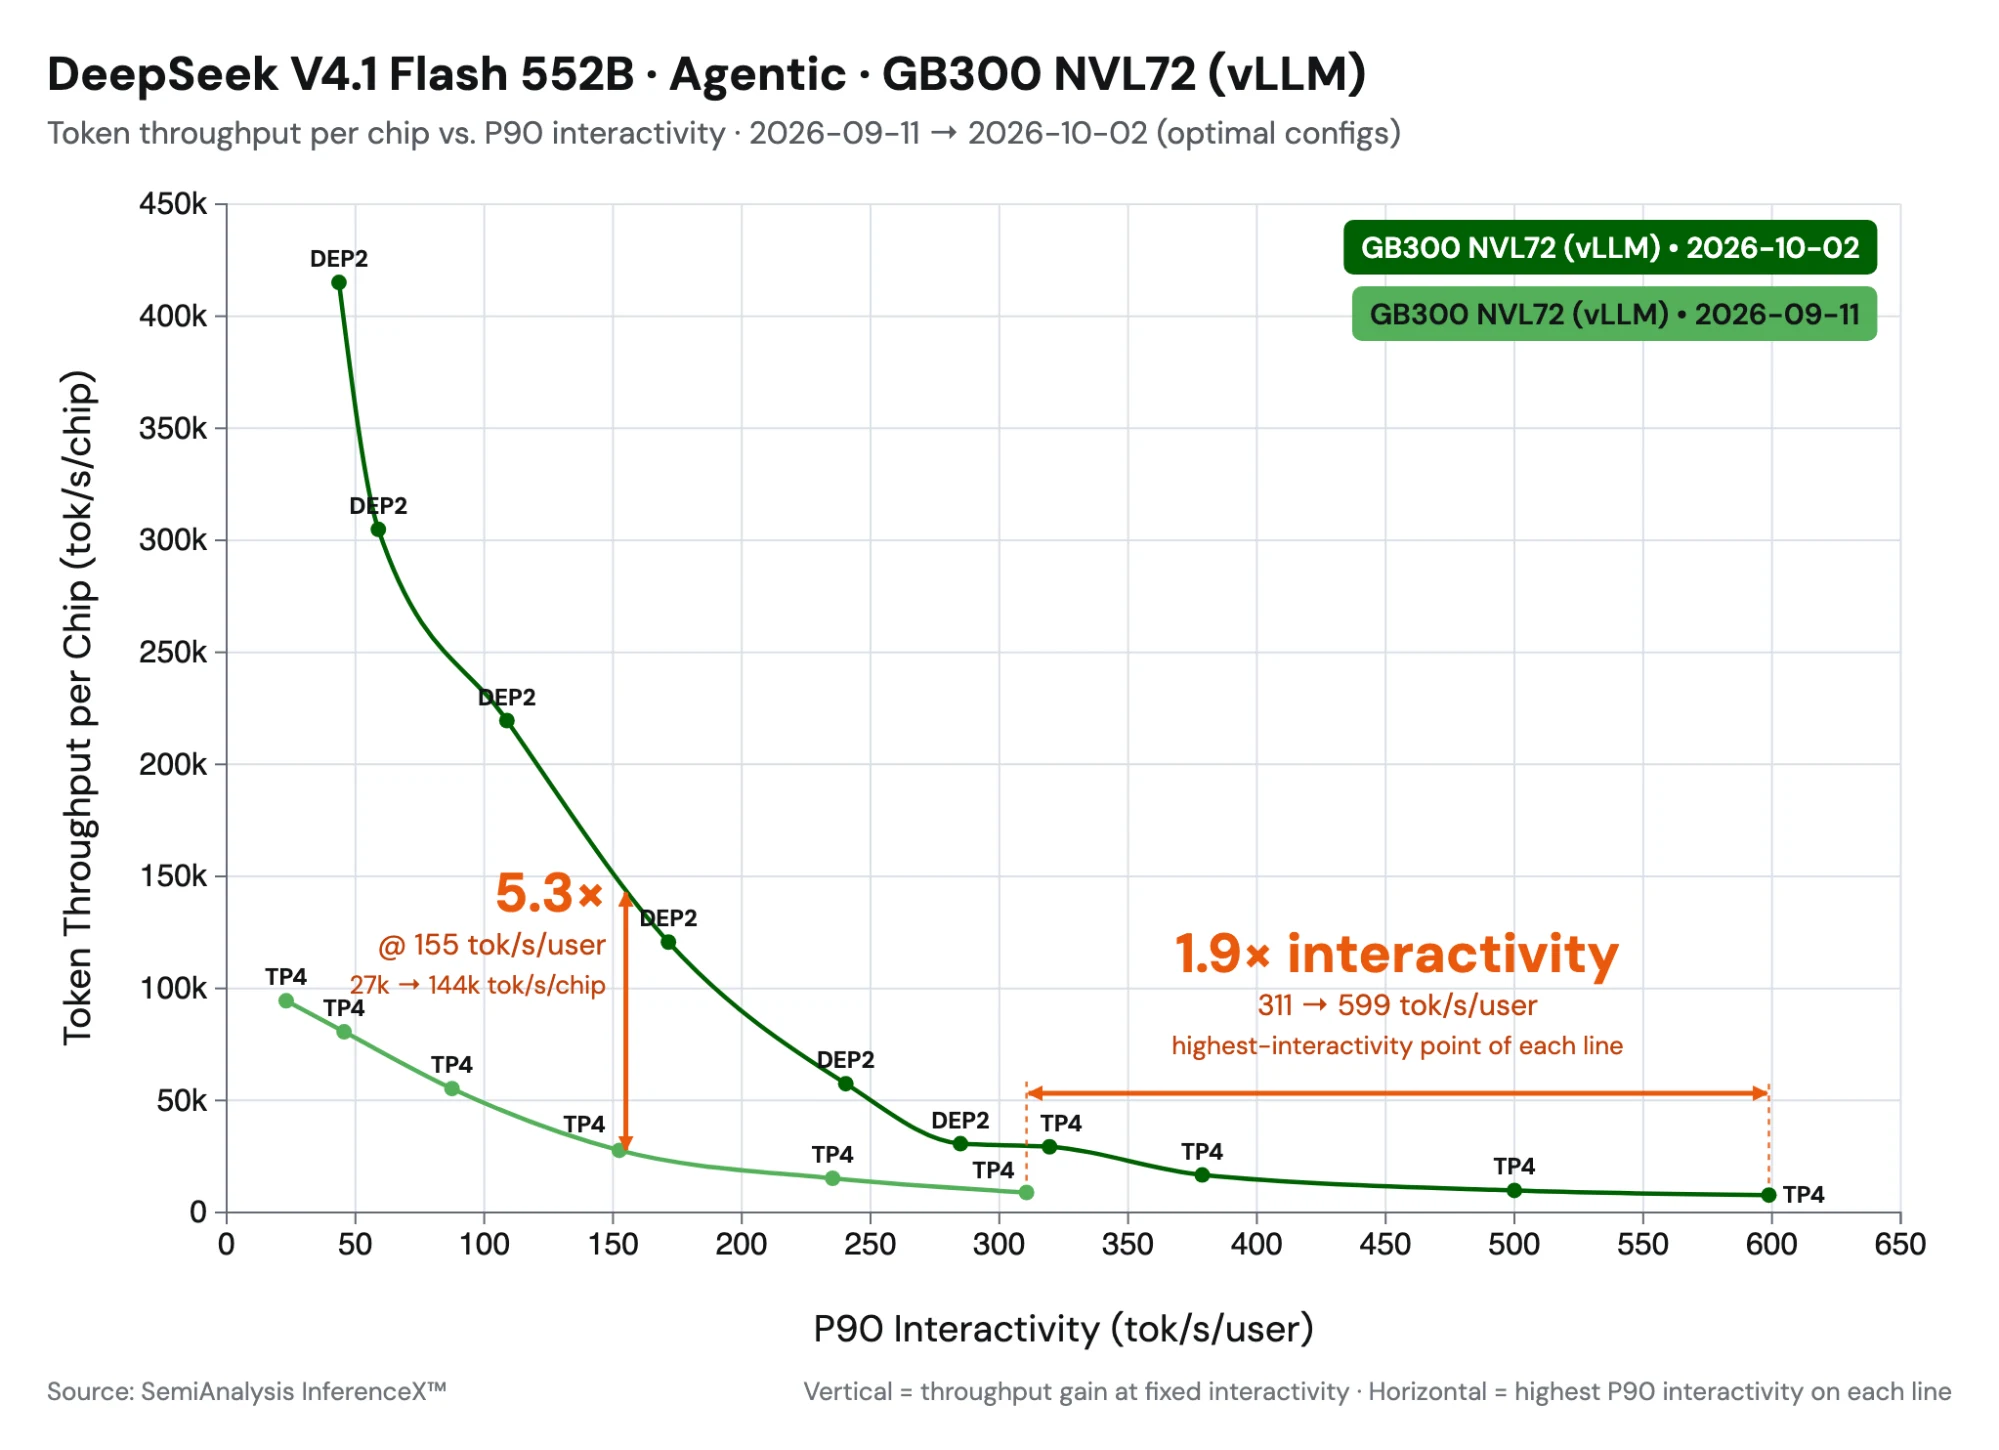
요약: DeepSeek-V4.1-Flash 출시 후 3주 동안 Inferact와 vLLM 커뮤니티는 이 모델을 최적화하여 낮은 동시성에서 1.9배 속도 향상과 150 TPS 제약 조건에서 5.3배 처리량 개선을 달성했습니다. 이 성능 개선은 다음에서 비롯됩니다:
-
CUDA graphs와 함께 SWA bounded replay를 구현하여 TTFT를 약 30% 줄였습니다.
-
MegaAttention, Mega-mHC, Mega-Gate, DeepSelect을 포함한 DeepSeek의 최신 출시 커널을 통합했습니다.
-
mHC 사이드 스트림을 포함한 나머지 커널을 공격적으로 융합 및 병렬화하고, all-reduce를 앞뒤 연산과 하나의 커널로 융합했습니다.
DeepSeek V4.1은 장기 에이전틱 서빙 작업을 위한 매우 효율적인 아키텍처를 도입합니다: 인과적 인코더-디코더(CED) 아키텍처를 통해 디코드 시 토큰당 16B 파라미터를 활성화하지만 프리필 시에는 8B 파라미터만 활성화합니다. 이 모델은 또한 극도로 메모리 효율적입니다. Compressed Sparse Attention 2(CSA2), FP4 KV 캐시, 그리고 계층 간 KV 캐시 공유 등 여러 기법을 결합하여 KV 캐시 크기를 줄이고, 글로벌 KV 사용량을 토큰당 890바이트로 낮춥니다. 이 글에서는 DeepSeek의 이러한 모델 수준 최적화와 vLLM 측 시스템 최적화를 결합하여 SemiAnalysis AgentX 에이전틱 서빙 벤치마크에서 5배 처리량을 달성한 방법을 보여줍니다. 우리는 최적화를 SWA bounded replay와 커널 관련 최적화라는 두 가지 범주로 강조합니다.
SWA bounded replay
DeepSeek-V4.1-Flash는 두 종류의 KV 캐시를 유지합니다. 글로벌 KV는 압축되어 계층 간에 공유되며 FP4로 저장되어 토큰당 약 890바이트입니다(V4.1 보고서). 슬라이딩 윈도우(SWA) KV는 FP8로 압축되지 않은 상태로, 40개 계층 각각의 마지막 128개 위치를 커버합니다.
SWA KV는 두 가지 비용을 만듭니다:
-
프리픽스 캐싱은 가능한 모든 히트 경계에서 이를 저장해야 하므로 글로벌 KV보다 10배 이상 많은 저장 공간이 필요합니다.
-
프리필은 모든 프롬프트 토큰에 대해 계층 21–39를 실행하지만, 디코드는 마지막 128개 위치만 읽습니다.
한 가지 간단한 접근법은 SWA KV를 캐싱하는 대신 재계산하는 것입니다. 그러나 정확한 재계산은 비용이 많이 듭니다. 각 계층의 128토큰 윈도우는 아래 계층의 이전 위치에 의존하기 때문에, L개 계층에 걸쳐 이를 재구축하려면 대략 L × 128개 토큰을 재생해야 합니다.
DeepSeek V4.1은 정확성을 효율성으로 교환하는 SWA bounded replay를 도입합니다. 이는 마지막 128개 토큰만 다시 실행하고 재생 시작 지점에서 SWA 윈도우를 잘라냅니다. 그 결과는 비트 단위로 정확하지는 않지만, DeepSeek는 무시할 수 있는 수준의 품질 손실을 보고했습니다(자세한 내용은 아래). vLLM은 이를 두 곳, 즉 각 비용마다 한 곳씩 적용합니다.
인코더 측: 캐시 히트 시 윈도우 재구축
인코더 측 재생을 통해 vLLM은 글로벌 KV만 캐시하고 SWA KV는 건너뜁니다. 길이 H의 프리픽스 히트가 발생하면 [H − 128, H) 토큰을 다시 실행하여 SWA KV를 재구축하며, 윈도우는 s = H − 128에서 잘라냅니다.
디코더 측: 프롬프트 프리필 대부분 건너뛰기
DeepSeek V4.1의 CED 아키텍처에서 계층 20은 디코더의 글로벌 KV를 계산하고 계층 21–39는 이를 재사용합니다. 따라서 vLLM은 글로벌 KV를 생성하기 위해 모든 토큰에 대해 계층 20을 실행하고, 각 요청의 마지막 128개 토큰에 대해서만 계층 21–39를 실행합니다. 긴 프롬프트의 경우 모델의 거의 절반을 건너뛰게 됩니다.
절제된 계층을 위한 CUDA graphs
절제 후 계층 21–39는 GPU 작업이 매우 적어 즉시(eager) 실행 시 커널 실행 오버헤드가 지배적이 되고 GPU는 유휴 상태가 됩니다. 이들의 입력 형태도 계층 0–20과 다르기 때문에 두 부분을 하나의 CUDA 그래프로 캡처할 수 없습니다. vLLM의 중단 가능한 PIECEWISE 그래프는 이미 모델 중간에서 중단되므로 자연스러운 분할점을 제공합니다: 계층 0–20은 전체 배치로 캡처하고, 계층 21–39는 절제된 배치로 별도로 캡처합니다. 이를 통해 CUDA 그래프를 절제된 프리필에 사용할 수 있게 되고, 계층 21–39가 자체 캡처 크기를 사용하여 더 나은 그래프 커버리지를 얻을 수 있습니다.
SWA bounded replay는 DeepSeek-V4.1에 대해 기본적으로 활성화되어 있으며 다음에 의해 제어됩니다 --[no-]swa-bounded-replay.
정확도 및 성능 결과
SWA bounded replay는 정확하지는 않지만, DeepSeek는 무시할 수 있는 수준의 품질 손실만 보고했습니다. 우리는 GSM8K 및 GPQA를 포함한 벤치마크에서 vLLM으로 이를 확인했으며 의미 있는 정확도 차이를 관찰하지 못했습니다(약 1.5 표준오차 이내의 차이).
성능 측면에서 인코더 측은 캐시 공간을 위해 히트당 한 번의 프리필 윈도우를 교환하므로, 속도 향상은 디코더 측에서 나옵니다. 우리는 세 가지 설정에서 단일 요청 프리필 TTFT를 측정했습니다: 재생 끄기; 디코더 CUDA 그래프 없이 재생 켜기(계층 21–39를 즉시 실행하며 eager 단계만 절제); 그리고 디코더 CUDA 그래프와 함께 재생 켜기.
CUDA 그래프를 사용한 디코더 재생은 프리필 계산 시간을 30–40% 줄입니다. CUDA 그래프는 커널 실행이 병목인 짧은 프롬프트에서 가장 중요합니다: 그래프가 없으면 실행 오버헤드가 GPU 절감 효과를 능가하여 재생이 기준선보다 느려집니다(DEP2에서 1K에서 최대 +12%). 긴 프롬프트의 경우 GPU 작업이 충분히 커서 실행 오버헤드를 숨길 수 있으므로, eager 재생만으로도 대부분의 이득을 얻으며 CUDA 그래프는 몇 포인트를 더 추가합니다.
커널
DeepSeek는 DeepSeek-V4.1-Flash를 세 개의 저장소에 있는 새로운 커널과 함께 출시했습니다. DeepSelect는 DeepSeek Sparse Attention을 위한 새로운 top-k 라이브러리입니다. DeepGEMM은 sparse indexer 커널과 여러 GEMM 관련 융합 커널을 추가했습니다. FlashMLA는 NVFP4 KV 캐시 지원과 융합 어텐션 커널인 MegaAttention을 추가했습니다. 우리는 이러한 오픈소스 커널 중 일부를 vLLM에 통합했으며 진행 상황을 다음에서 추적합니다: #57448.
Mega-mHC (#56962). Mega-mHC는 mHC 체인을 하나의 커널로 융합합니다: post 스텝, delayed-pre 스텝, 그리고 RMSNorm입니다. 이는 현재 DeepGEMM 구현이 더 나은 성능을 보이는 기존 TileLang 융합 경로를 대체합니다. 이 커널은 NVIDIA GB200에서 TileLang 버전보다 1.14–1.51× 빠릅니다.
Mega-Gate (#56266). Mega-Gate는 MoE 라우터(게이트 GEMM, 전문가 스코어링, 바이어스, top-k 선택)를 하나의 커널로 융합합니다. 이전에는 이 연산들이 하나의 GEMM과 별도의 top-k 커널로 실행되어, 추가 커널 실행과 스코어의 메모리 왕복이 필요했습니다. 이 융합을 통해 중간 배치 크기에서 1.18–1.31×의 커널 속도 향상을 얻습니다.
mHC multistream overlap (#57603). V4.1에서는 mHC 계수가 한 서브레이어만큼 시프트되어, 다음 seam의 계수 GEMM이 attention이나 FFN이 실행되기 전에 이미 존재하는 residual 스트림만 읽습니다. 다음 post/pre 스텝이 이들을 결합할 때까지 어느 쪽도 상대방의 출력을 필요로 하지 않습니다. 작은 배치 크기에서 vLLM은 이제 다음 mHC 블록의 계수를 사이드 CUDA 스트림에서 attention 및 FFN과 병렬로 계산합니다. 이는 그렇지 않으면 지연시간 제약 디코드의 임계 경로에 남게 될 작업을 숨깁니다. TP4 저지연 시나리오에서 이는 지연시간을 약 4% 줄입니다.
Sparse MQA logits (#56254). V4.1에서 후기 인덱서 레이어들은 16K 고정 후보 위치 집합에서 top-k를 선택합니다. 이전 구현들은 전체 컨텍스트에 대한 스코어를 계산하고 스코어링 전에 모든 비후보 블록을 마스킹했습니다. DeepGEMM의 sparse 커널은 후보만 스코어링하므로 비용이 더 이상 컨텍스트에 따라 증가하지 않습니다. NVIDIA GB300에서 레이어당 8K 토큰에서 1.2× 빠르고, 512K에서 14–23× 빠릅니다. 4× NVIDIA GB300에서 엔드투엔드로 디코드가 3–6% 향상됩니다. 프리필은 512K 컨텍스트에서 1.43× 빠르고, 1M 컨텍스트에서 2× 빠릅니다.
MegaAttention with NVFP4 compressed KV (#56935). FlashMLA의 MegaAttention 커널은 쿼리 RoPE, sparse attention, 출력에 대한 역방향 RoPE, 그리고 FP8 캐스트를 단일 실행에서 수행하며, 출력 프로젝션이 읽는 버퍼에 바로 씁니다. 이는 attention과 다음 레이어 사이의 별도 커널과 메모리 왕복을 제거합니다. 또한 이전 FP8 KV 캐시보다 45% 작은 새로운 NVFP4 압축 KV 포맷을 읽습니다. MegaAttention은 또한 연산 간 HBM 쓰기를 제거하는 공격적인 융합을 통해 커널 효율을 1.45× 향상시킵니다.
Low-latency fused WO-A kernel (#58634). Blackwell에서의 소규모 디코드 배치를 위해, 역방향 RoPE, FP8 양자화, WO-A 배치 GEMM, 그리고 MXFP8 재양자화를 단일 CuTe-DSL 커널로 융합하여 pre-WO-B 체인을 세 개의 커널에서 하나로 줄였습니다. 핵심 아이디어는 중간 활성화를 온칩에 유지하고 데이터 이동을 연산과 파이프라인화하여, 작은 배치 크기에서 지배적인 추가 커널 실행과 글로벌 메모리 왕복을 피하는 것입니다. 이는 융합된 WO-A 경로를 최대 ~2.1× 향상시키고, 낮은 동시성에서 토큰 간 지연시간을 최대 ~6–7% 낮춥니다.
Engram. V4.1의 Engram 레이어는 해시된 토큰 n-그램으로 키가 지정된 두 개의 큰 FP8 테이블에서 행을 조회합니다. 각 스텝은 몇 개의 행만 읽으므로, 테이블 배치와 조회 지연시간이 연산보다 더 중요합니다. 우리는 CPU로 오프로드된 Engram 조회를 비동기적으로 프리페치하여 호스트 메모리 접근을 디코더 연산과 겹치게 함으로써 저배치 디코드를 가속합니다 (#56512). Engram 헤드는 통합 TP/DP 스킴으로 샤딩되며, 동일 위치에 배치된 DP 레플리카들은 동일한 호스트 테이블을 공유하여 조회 경로에서 중복 복사와 모든 DP 통신을 피합니다 (#57651). 이러한 큰 호스트 상주 테이블을 위해, 우리는 페이지 폴트 오버헤드를 줄이기 위해 투명한 거대 페이지(THP)도 지원하여 프리필에 대해 최대 10× 빠른 조회 커널을 제공합니다 (#56926). 또한 충분한 거대 페이지를 사용할 수 없는 경우를 위한 최적화도 추가했습니다 (#59327).
Agentic 성능
우리는 대표적인 에이전틱 서빙 워크로드로 SemiAnalysis AgentX 벤치마크로 성능을 측정합니다 (자세한 내용은 우리의 이전 포스트참조). 이러한 최적화들을 결합하면 vLLM은 day-0 구현 대비 상당한 성능 향상을 얻습니다. 그림 6에서 볼 수 있듯이, 저지연 결과는 day-0 결과 대비 1.9× 향상되었고, 고처리량 결과는 약 5× 향상되었습니다.
저지연 서빙을 위해, 우리는 FlashInfer attention과 함께 TP4를 사용합니다. 소규모 배치 디코드는 대체로 메모리 대역폭 제약이므로, 모델 가중치를 네 개의 GPU에 샤딩하는 것이 적합합니다. 우리는 MegaAttention도 시도했지만, 그 주요 이점은 융합이 더 큰 도움을 줄 수 있는 더 높은 처리량 설정에 있습니다. TP4에서는 그 이점이 훨씬 작았고, 우리의 실행에서 FlashInfer가 결국 더 빠릈습니다.
높은 처리량을 위해 DEP2로 전환하여 DP 어텐션을 사용하고 전문가(experts)를 GPU들에 분산 배치했습니다. V4.1은 모든 헤드에서 공유 KV 잠재 표현을 사용하므로 TP는 KV 캐시를 GPU들에 걸쳐 중복 저장하게 됩니다. DP는 이러한 중복을 피합니다. 각 GPU는 자신이 처리하는 요청의 KV만 저장하며, 세션 어피니티가 턴 간 접두사 캐시 지역성을 유지합니다. MegaAttention은 NVFP4로 요청당 KV 사용량을 더 줄여 FP8 대비 거의 절반으로 줄이고 GPU당 동시 처리량을 높입니다.
주목할 점은 V4.1이 메모리 효율이 매우 높아 벤치마크 전반에서 KV 캐시 오프로딩이 필요하지 않았다는 것입니다. P/D 분리(disaggregation)와 함께 더 높은 동시성에서는 KV 캐시 오프로딩이 도움이 되기 시작할 것으로 예상합니다.
SWA bounded replay는 프리필 측 커널 최적화와 함께 TTFT도 크게 개선했습니다.
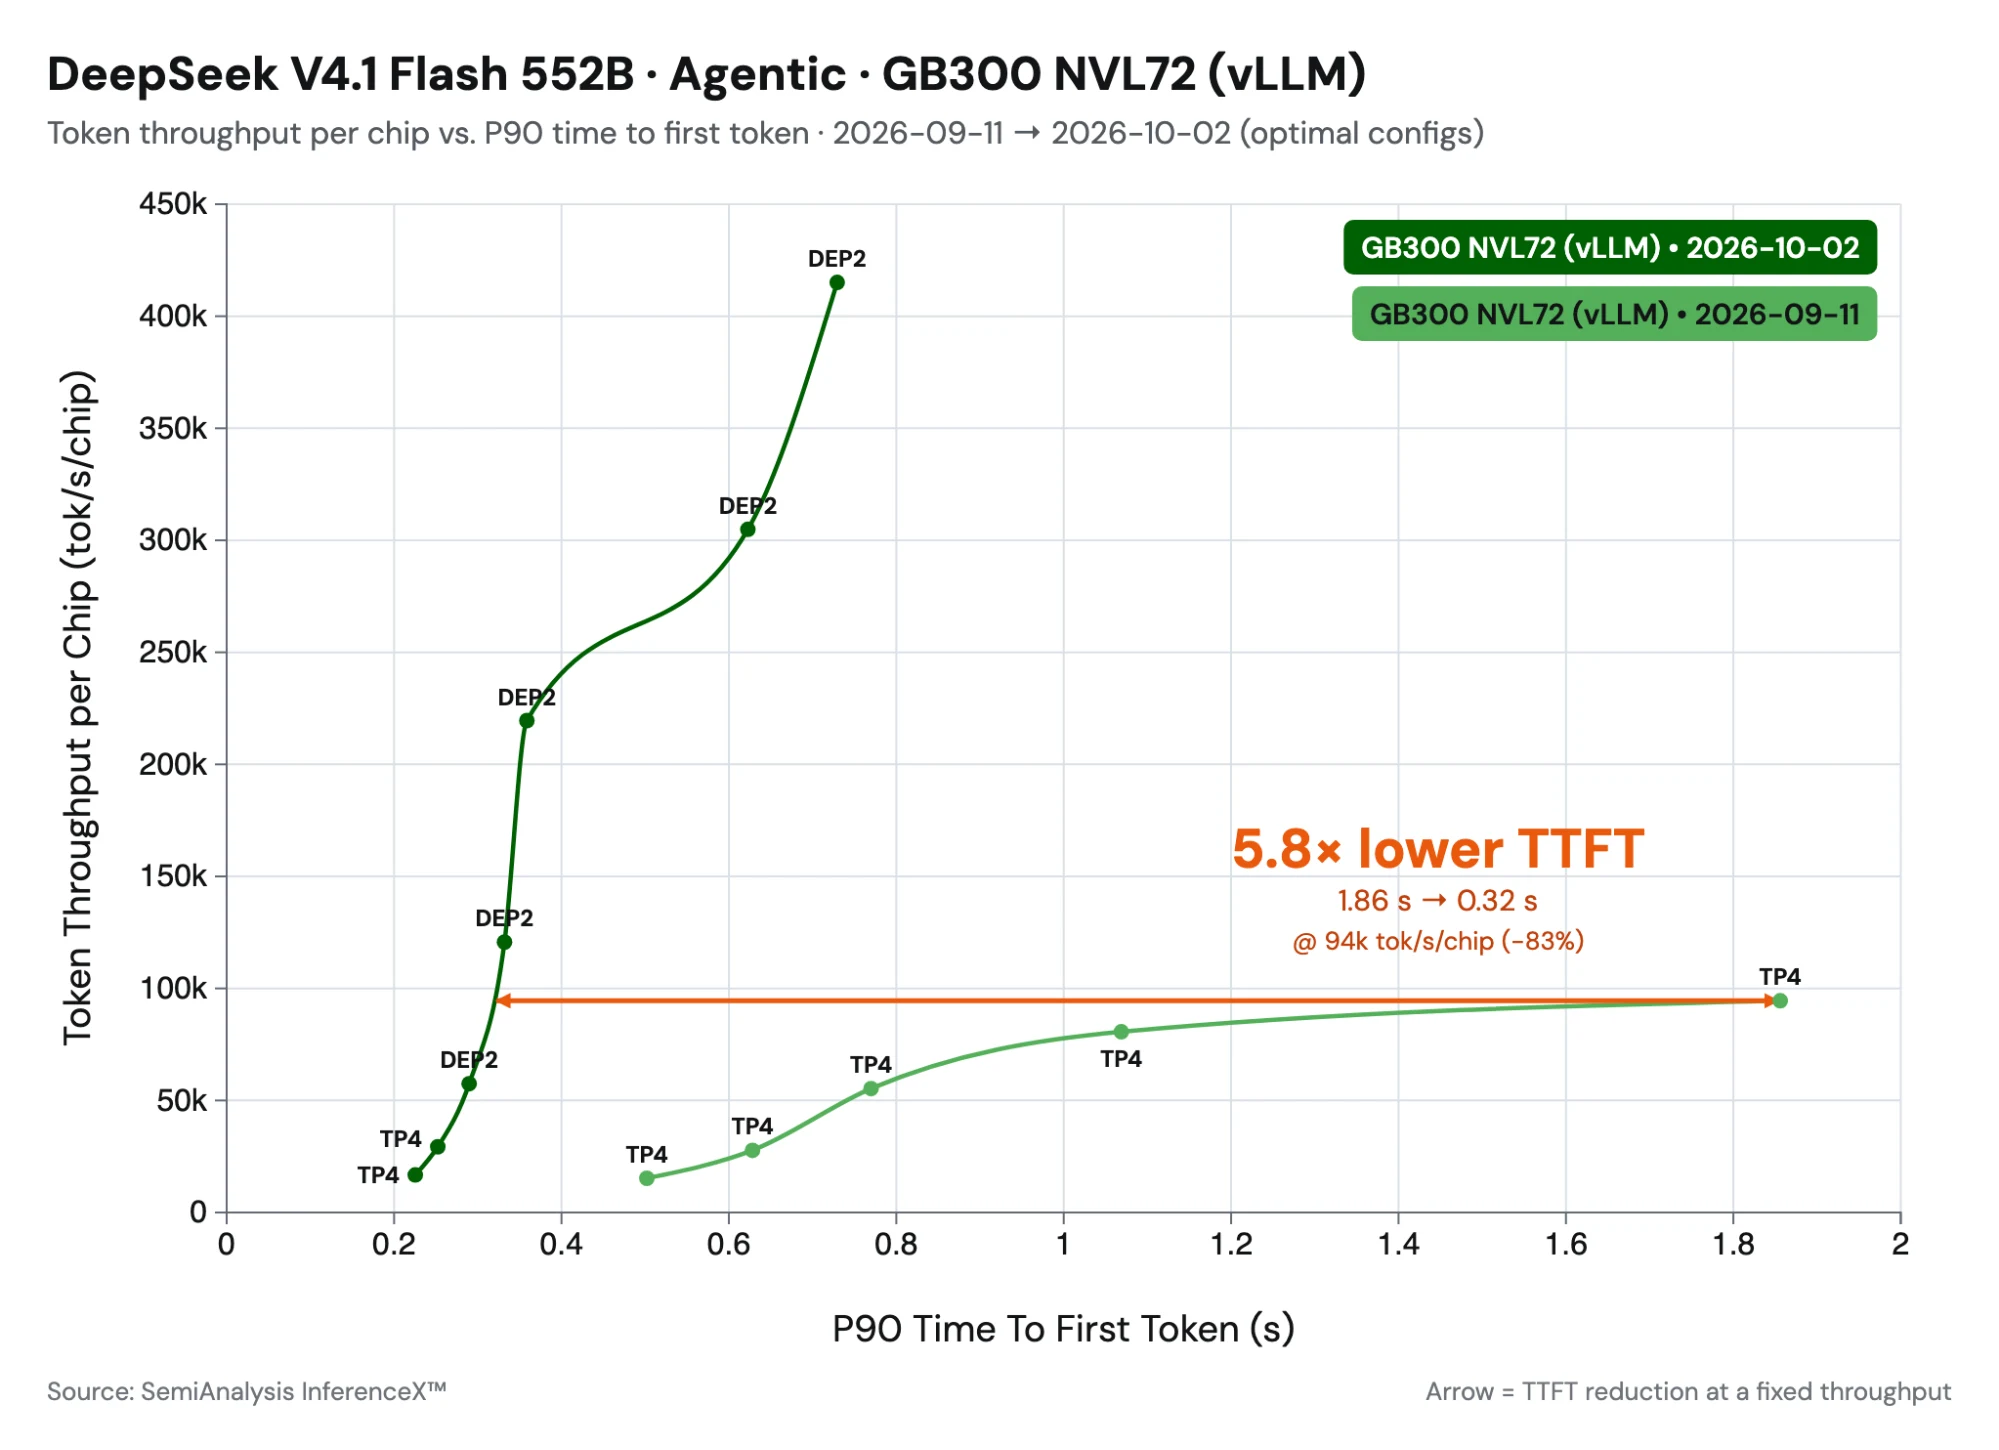
그림 7은 최적화된 TTFT–처리량 트레이드오프를 보여줍니다. 약 100K 처리량에서 TTFT는 세 가지 최적화를 결합하여 거의 70% 감소했습니다:
-
SWA bounded replay는 모델의 상단 절반이 마지막 128개 토큰만 처리하도록 하여 프리필 연산을 대략 절반으로 줄입니다.
-
CUDA 그래프는 잘려나간 작은 리플레이를 CPU 커널 실행 병목 대신 GPU에서 빠르게 유지하여, 전체 속도 향상을 실현합니다.
-
커널 개선은 모델 연산을 가속화합니다.
감사의 글
DeepSeek에게 DeepSeek-V4.1-Flash와 관련 커널을 오픈소스로 공개해 준 것에, Inferact 팀에게 초기 모델 구동과 최적화에, NVIDIA에게 협력과 지원에, 그리고 SemiAnalysis에게 AgentX 벤치마크에 감사드립니다.