IT之家 10월 8일 소식, 태평양 표준시 10월 7일 오전 10시(베이징 시간 10월 8일 새벽 1시)에 미국 샌프란시스코에서 개최된 발표회에서 마이크로소프트는 GitHub Copilot이 이번 달 말까지 로컬 AI 모델 추론을 지원할 것이라고 발표했습니다.개발자는 클라우드 모델과 디바이스 측 모델 간에 자동 또는 수동으로 전환할 수 있습니다.
GitHub Copilot은 마이크로소프트가 출시한 AI 코딩 어시스턴트로, Visual Studio Code, CLI 등의 도구에 통합되어 코드 컨텍스트에 따라 완성, 설명 또는 리팩터링 제안을 생성할 수 있습니다.
GitHub Copilot은 현재 클라우드 호스팅 모델에 의존하며, 오케스트레이터가 성능, 비용 및 정확성에 따라 요청을 라우팅합니다. 마이크로소프트는 이번 달 말까지 이 메커니즘을 확장하여 Copilot이 클라우드 모델과 로컬 AI 모델을 자동으로 선택하고 백그라운드에서 추론 작업을 조율하도록 할 계획입니다.
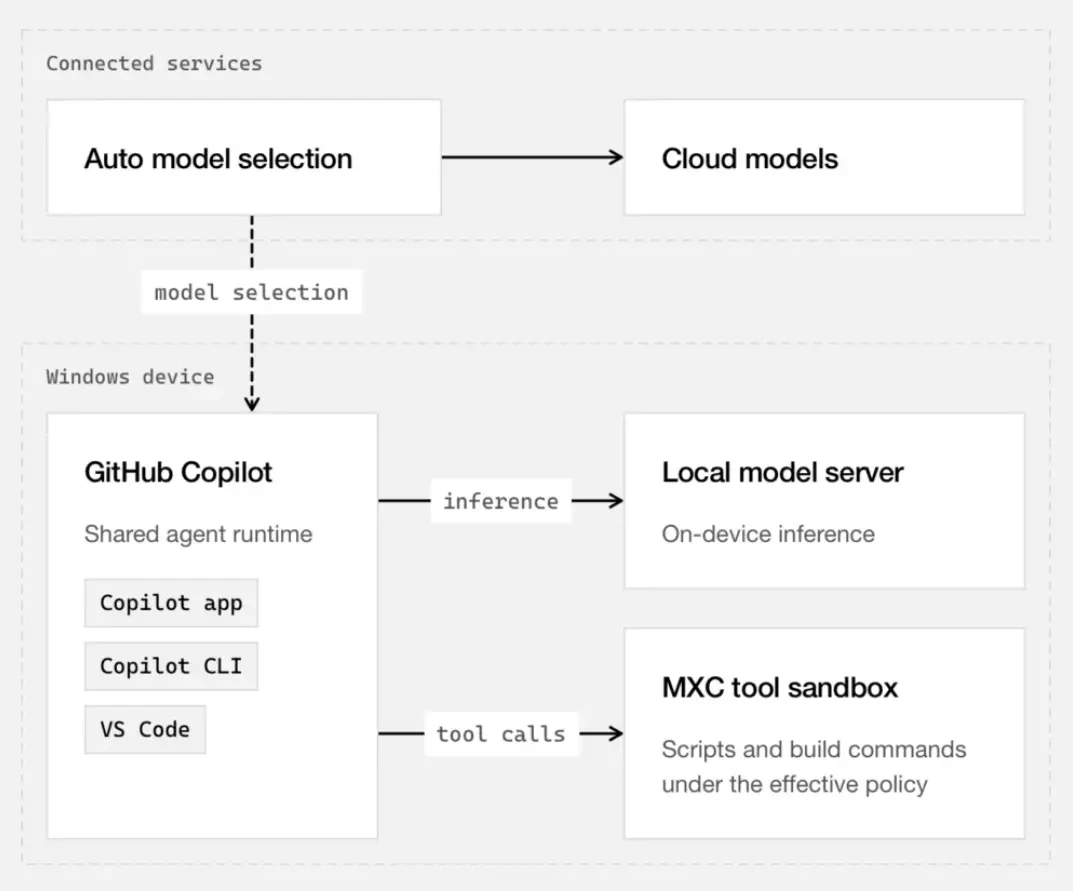
마이크로소프트는 GitHub Copilot 사용자에게 자동 오케스트레이션 또는 디바이스 측 모델 강제 사용의 두 가지 모드를 제공합니다. 사용자는 GitHub Copilot CLI, Copilot 앱 및 Visual Studio Code에서 기본 설정을 지정할 수 있습니다.
로컬 모델 선택은 공급자, 모델 또는 엔드포인트 지정을 지원하며, 개발자는 Windows ML을 통해 MAI Code 1.1 Flash를 선택하거나 OpenAI 호환 로컬 엔드포인트에 연결하여 해당 엔드포인트가 노출하는 모델을 선택할 수 있습니다.
마이크로소프트는 총 파라미터 1370억, 활성 파라미터 68억의 'Mixture of Experts' 모델인 MAI Code 1.1 Flash를 출시했으며, 양화 및 추측 디코딩 기술을 활용해 응답 속도와 메모리 사용량을 최적화했습니다.
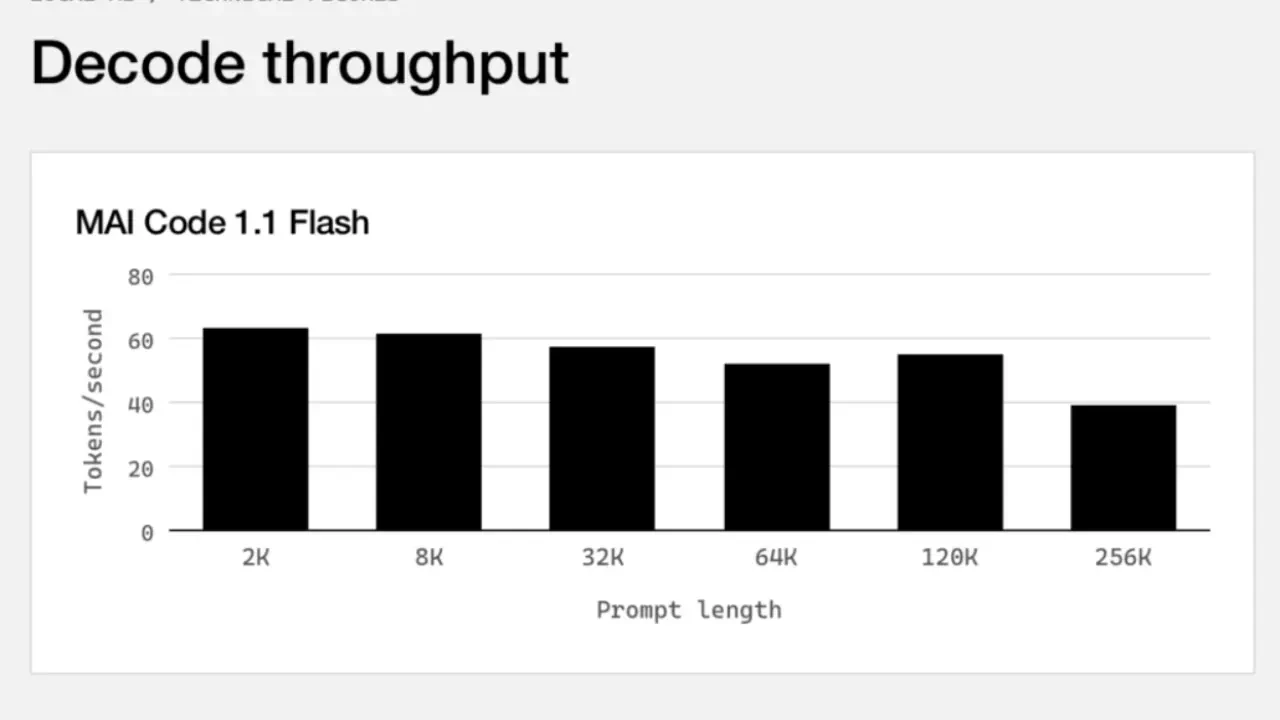
이 모델은 Surface Laptop Ultra에서의 실측 결과, 복잡한 작업에서의 피크 메모리 사용률, 토큰 활용률 및 처리 속도가 모두 크게 향상된 것으로 나타났습니다. 디코딩 처리량 테스트에서는 프롬프트 길이가 2K에서 256K 토큰일 때 처리량이 초당 40~63 토큰 사이를 기록했습니다. IT之家가 관련 이미지를 아래에 첨부합니다: