
AI에게 ARC 추상화 추론 문제를 가르친 것이 바로 고양이였다?
何恺明 팀의 최신 논문은NAT-ARC, 순수 시각 기반 ARC 문제 풀이 방식을 제안했습니다.
이 방식은 LLM에 의존하지 않고, ImageNet의 고양이·개·꽃·풀 이미지로 사전 학습시켜 모델이 '보는 법'을 배우게 한 뒤, 이를 추상적인 격자 추론으로 전이시킵니다.
그 결과, NAT-ARC에서 가장 좋은 성적을 낸 단일 모델이 ARC-1에서 63.4%의 pass@2 점수를 기록했고, 앙상블 후에는 70.2%에 도달했습니다.
이것은 순수 시각 방식이 처음으로전용 LLM 시스템의 수준에근접한 사례입니다.
ARC는 공인된 가장 어려운 AI 시각 지능 테스트 중 하나로, 몇 가지 컬러 격자의 입력·출력 예시를 주고 그 이면에 숨겨진 변환 규칙을 추론하게 한 뒤, 이를 새로운 격자에 적용하게 합니다.
과거의 주류 해법은 모두 격자를 텍스트나 기호로 번역해 LLM에게 추론을 맡기는 것이었습니다.
그러나 이 논문은 그렇지 않았고, 심지어 사전 학습 단계에서 ARC 격자조차 사용하지 않았습니다.
모델이 실제 세계를 보며 배운 시각 능력이 완전히 추상적인 컬러 격자 추론으로 그대로 전이된 것입니다.
ARC 트랙, 시각 방식의 부상
ARC는 Abstraction and Reasoning Corpus의 약자로, Keras의 아버지 François Chollet이 2019년에 제안했습니다.
ARC의 각 문제는 형식이 매우 통일되어 있습니다. 최대 30×30 크기의 2차원 격자 한 블록, 최대 10가지 색상으로 구성되며, 문제는 2개에서 5개 조의 입력·출력 예시를 제공합니다. 도전자는 예시로부터 숨겨진 변환 규칙을 추론한 뒤, 이 규칙을 완전히 새로운 입력 격자에 적용하여 그 출력을 예측해야 합니다.
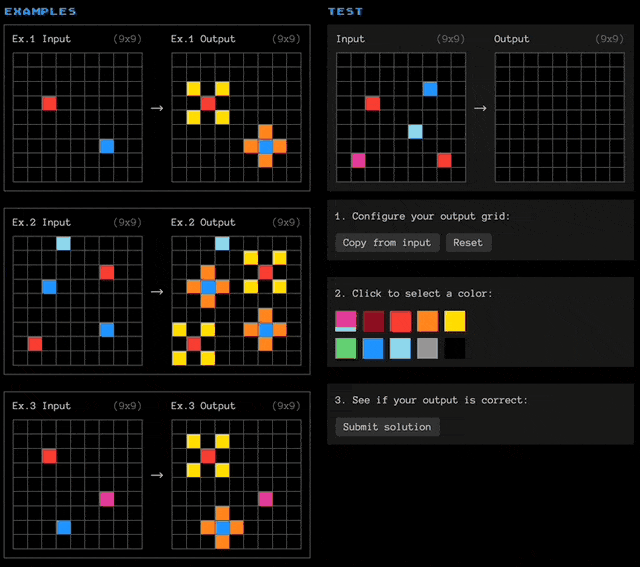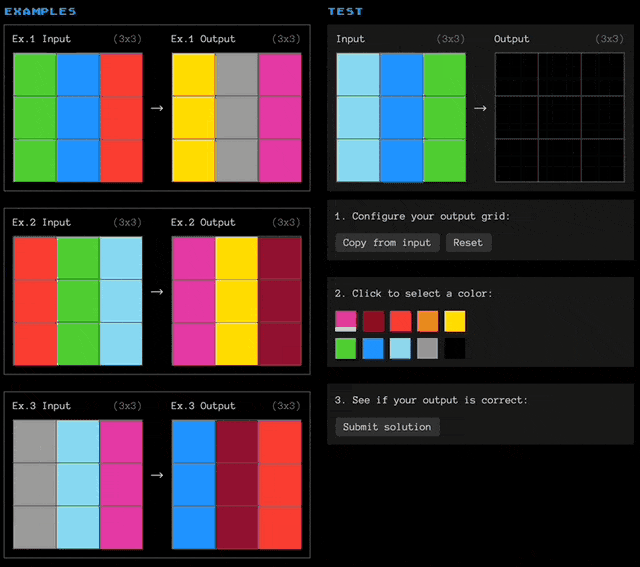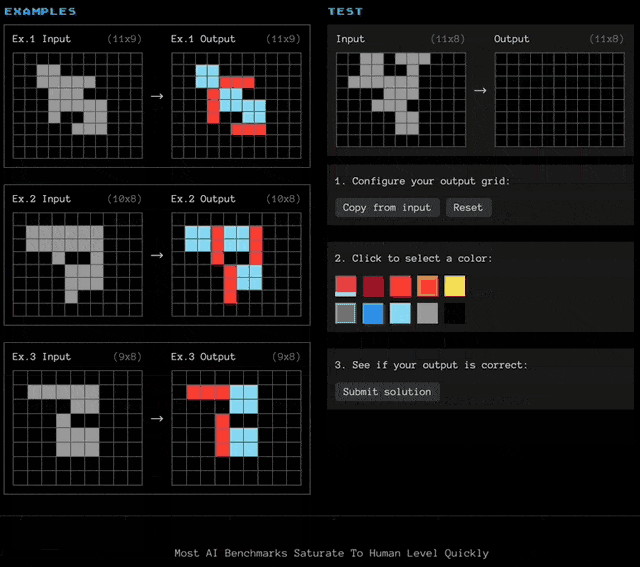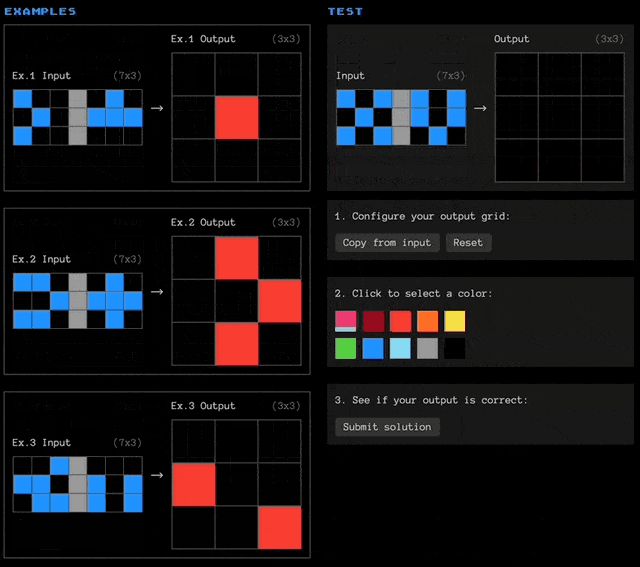
이 문제들은 들어보면 그림으로 규칙을 찾는 아동용 지능 퍼즐 같지만, AI에게 ARC는 극히 어렵습니다.
한편으로 각 문제의 변환 규칙이 모두 달라 외울 고정 템플릿이 없습니다.
또한 데이터량이 극히 적어, 두세 개의 예시만으로 추상적 규칙을归纳해 정확히 실행해야 합니다.
이러한 조합 때문에 ARC는AI 추상화 추론 능력을 측정하는 벤치마크로。
자리잡았습니다. 현재 ARC 트랙에서 지배적인 위치를 차지하는 것은 거의 모두 대규모 언어 모델 방식이며, 이 방식들의 공통 아이디어는 격자를 텍스트나 기호 시퀀스로 번역해 언어 모델이 처리하도록 하는 것입니다.
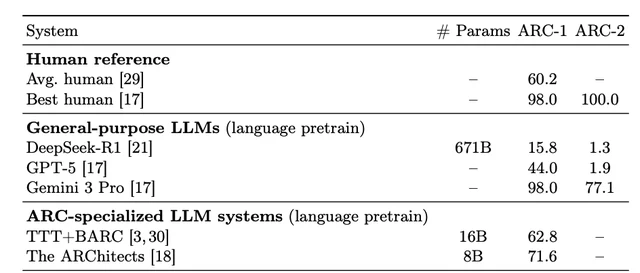
시각 기반 노선은 그 후에야 부상하기 시작했습니다.
한 그룹의 연구자들은 완전히 다른 길을 걸었는데, 격자를 텍스트로 번역하지 않고 시각 모델로 격자 이미지를 직접 처리하는 방식으로 바꾼 것입니다.
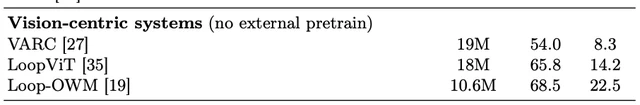
그중 가장 중요한 한 걸음은 같은 MIT 팀이 제안한VARC에서 나왔습니다. 이 방법은 ARC를 조건부 이미지-이미지 번역 태스크로 재정의하고, 19M 파라미터의 시각 모델로 54%를 기록했습니다.
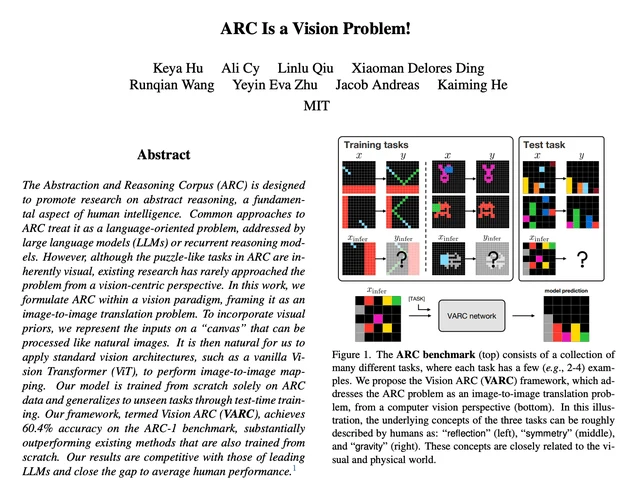
LoopViT은 이 프레임워크에 순환 추론 메커니즘을 추가해, 18M 파라미터로 65.8%에 도달했습니다.
Loop-OWM은 비디오 사전 학습 모델로 few-shot을 수행해, 10.6M 파라미터로 68.5%에 도달했습니다.
이 모델들의 파라미터 수는 LLM 방식보다 몇 자릿수 작지만, 성능은 이미 따라잡기 시작했습니다.
그러나 시각 노선에도 여전히 구조적인 약점이 하나 있습니다.
LLM이 ARC에서 점점 더 좋은 성과를 내는 핵심 원인 중 하나는 방대한 말뭉치로 사전학습을 수행하여 범용 능력을 축적했기 때문이며, 모델이 클수록 사전학습이 충분할수록 다운스트림 작업에서의 scaling 효과가 더 뚜렷하다.
반면 대부분의 시각 ARC 방식의 모델은 무작위 초기화부터 학습을 시작하여 사전학습의 이점을 누리지 못했다.
이를 바탕으로 NAT-ARC의 목표는 시각 방식에 사전학습이라는 단계를 보완하여 그 scaling 병목을 뚫어보는 것이다.
고양이 보고 나서, ARC에 도전하다
NAT-ARC의 핵심 아이디어는VARC의 시각 파이프라인 앞에 ImageNet MAE 사전학습 단계를 삽입하는 것이다。
MAE, Masked Autoencoder는 카이밍 허(何恺明)가 FAIR 재직 시절이던 2022년에 제안한 자기지도 시각 사전학습 방법이다.
이 학습 과정은 이미지의 대부분 영역을 가리고, 모델이 남은 조각들로부터 원본 이미지를 복원하도록 하는 것이다.
이 작업을 통해 모델은 사물의 형태, 구조, 공간적 관계를 이해할 수 있게 된다.
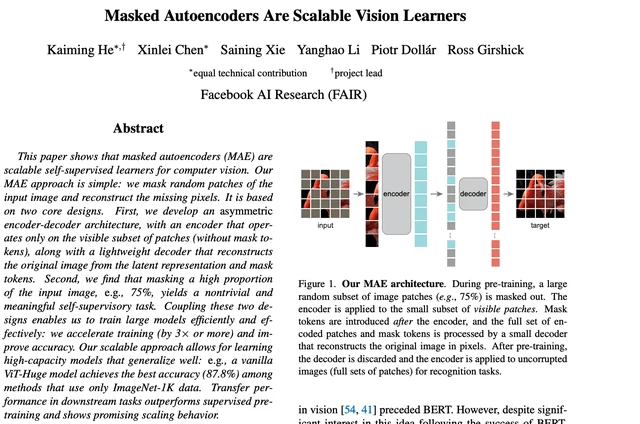
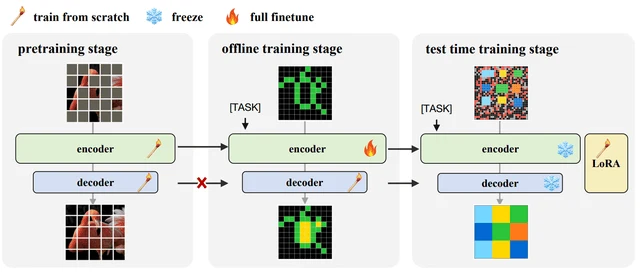
NAT-ARC의 방식은 MAE를 ImageNet(약 130만 장의 고양이·개·꽃·풀 등 자연 이미지를 포함한 데이터셋)에서 학습시켜 얻은 encoder 가중치를 그대로 가져와 시각 인코더를 초기화하고, decoder는 랜덤 초기화부터 학습을 시작하는 것이다.
전체 과정은 3단계로 나뉜다.
- 첫째 단계는 ImageNet에서 MAE로 encoder를 사전학습하는 것이다.
- 둘째 단계는 ARC 학습 집합에서 전체 인코더·디코더를 오프라인으로 학습하는 것이다.
- 셋째 단계는 테스트 시 각 문제별로 개별적으로 LoRA 미세조정을 수행하는 것이다.
미세조정 단계에서 각 문제에는 단 2~5쌍의 시범 쌍만 주어지며, 모델은 이 몇 쌍의 시범을 통해 해당 문제의 규칙을 '학습'하려 한다.
주목할 만한 세부 사항이 하나 있다. NAT-ARC는 MAE의 공개 checkpoint를 그대로 사용했으며, 사전학습에 추가로 한 푼도 쓰지 않았다.
다만 이 checkpoint는 원래 더 큰 크기의 ImageNet 이미지를 위해 설계된 것이었고, ARC 격자는 64×64 픽셀에 불과해 크기 차이가 매우 컸다.
이를 맞추기 위해 NAT-ARC는 원래의 patch embedding과 위치 인코딩을 버리고 backbone 가중치만 유지한 채, 2D RoPE를 위치 인코딩으로 교체했다.
간단히 말해, NAT-ARC는 MAE가 ImageNet에서 학습한 시각 특징 추출 능력만 유지하고, ImageNet 이미지 크기에 묶여 있던 공간 지각 부분은 모두 버린 뒤 더 유연한 방식으로 다시 학습시킨 것이다.
그런데 고양이·개 사진을 보며 학습한 것이 어떻게 추상 격자 추론에 도움이 될 수 있을까?
논문은 어텐션 시각화를 통해 한 가지 단서를 제시한다.
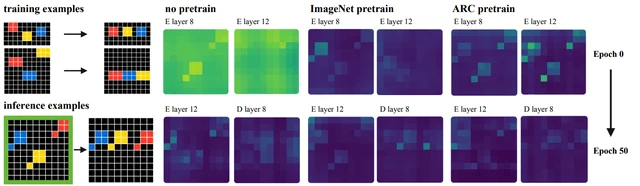
연구진은 세 가지 초기화 방식(사전학습 없음, ImageNet MAE 사전학습, ARC 스타일 격자 MAE 사전학습)의 모델을 동일한 ARC 문제 앞에 놓고, ARC 학습을 시작하기 전 상태에서의 어텐션 분포를 관찰했다.
결과는 뚜렷했다. 랜덤 초기화 모델의 어텐션은 균일하게 흩어져 아무런 초점이 없었지만, ImageNet 사전학습을 거친 모델은 이미 전경과 배경을 구분할 수 있었고, 어텐션이 격자 속 의미 있는 패턴 영역에 자동으로 집중되었다.
이 모델은 ARC 격자를 한 번도 본 적이 없지만, ImageNet에서 학습한 '물체를 배경으로부터 인식하는' 능력이 ARC 격자에서도 자연스럽게 발휘된 것이다.
연구진은 나아가 과제 수준의 분해도 수행했다.
그들은 사전학습 후 유의미하게 향상된 15개의 ARC 문제를 선별했고, 수동으로 라벨링한 결과 이 문제들이 두 가지 유형의 과제에 집중되어 있음을 발견했다.
이 중 6개는 match-and-copy에 속하며, 모델은 일치하는 객체, 색상 또는 패턴을 식별한 뒤 해당 구조를 출력에 복사해야 한다.
또 다른 6개는 connected-component reasoning에 속하며, 모델은 공간적으로 연결된 영역을 식별, 채우기 또는 재색칠해야 한다.
이 두 가지 능력은 정확히 자연 이미지 속 시각 선험(prior)에 대응한다.
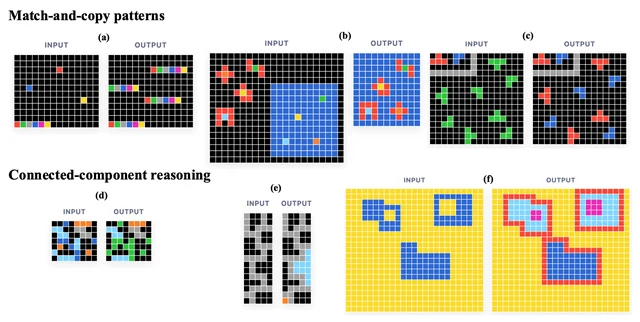
ImageNet에서 고양이를 보며 학습한 '고양이를 잔디 배경에서 분리하기'는 ARC에서는 '이 연결된 색상 영역을 격자에서 인식하기'로 바뀐 것이다.
시각 세계와 추상 세계의 저변 논리는 물체 그룹화, 패턴 매칭, 영역 분할 같은 연산에서 본래 같은 표현 체계를 공유하고 있었던 것이다.
고양이에서 와서 고양이로
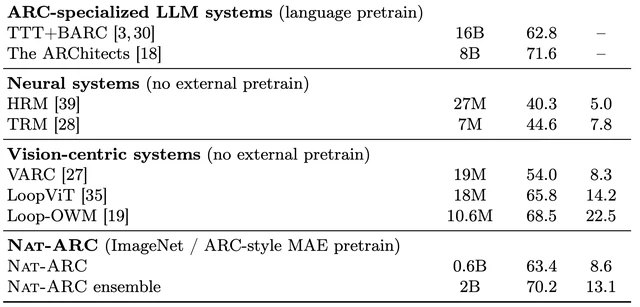
NAT-ARC의 최종 ARC-1 성적은 다음과 같다.
가장 좋은 성능을 낸 단일 모델은 huge 스케일을 채택했으며, 파라미터 수는 0.6B이고, pass@2 성적은 63.4±0.7%에 달했다.
앙상블 시 연구진은 세 가지 서로 다른 사전학습 전략(사전학습 없음, ImageNet MAE 사전학습, ARC 스타일 격자 MAE 사전학습)으로 각각 학습시킨 모델들을 풀링하여 다수결 투표를 수행해 70.2±0.6% pass@2를 기록했으며, 총 파라미터 수는 약 2B였다.
참고로 ARC 전용으로 미세조정된 The ARChitects는 8B 언어 모델을 사용해 71.6%를 기록했다.
시각 방식은 4분의 1의 파라미터 양으로 전용 LLM 시스템의 성 앞까지 도달한 것이다.
숫자 이외에 이 논문에서 가장 중요한 발견은 사전학습이 시각 방식의 scaling 병목을 해소했다는 점이다.
사전학습이 없을 때는 모델이 커질수록 오히려 성능이 나빠졌지만, 사전학습을 더하자 비로소 scaling이 정(+)의 수익을 내기 시작했다.
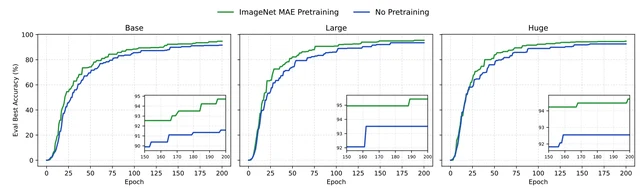
먼저 학습 곡선을 보자. 오프라인 학습 단계에서 ImageNet 사전 학습된 모델을 사용한 경우 수렴 속도가 훨씬 빨랐으며, base, large, huge 세 가지 스케일 모두에서 그러했고, 최종 정확도도 더 높았다.
하지만 가장 흥미로운 발견은 scaling 곡선 속에 숨어 있었습니다.
사전 학습이 없을 경우, 모델 성능은 base에서 large로 갈 때는 여전히 향상되지만, large에서 huge로 갈 때는 오히려 하락한다.
모델이 커질수록 성능이 나빠지는 것은 딥러닝에서 흔치 않은 현상으로, ARC라는 과제의 데이터량이 너무 적어 모델 용량 증가가 더 강한 일반화가 아니라 과적합으로 이어졌음을 보여줍니다.
ImageNet 사전 학습을 추가하자 scaling 곡선이 건강해졌고, base, large, huge 세 가지 규모 모두 계속 상승하며, 모델이 클수록 성능이 좋아졌다.
논문에서 가장 멋진 실험 중 하나는 시각화 검증이었다.
연구원들은 ImageNet 이미지를 60×60 크기, 10가지 색상의 이산 격자 표현으로 매핑하는 오토인코더(autoencoder)를 학습시켰는데, 이는 고양이 이미지 한 장을 ARC 격자로 「번역」한 것에 해당합니다.
그런 다음 그들은 NAT-ARC를 사용해 이 격자에 ARC 변환을 수행하여 180° 회전시키고, 파란색 테두리를 한 바퀴 추가한 뒤, 다시 픽셀로 디코딩했다.
결국 고양이는 실제로 전환되었고, 테두리도 실제로 추가되었습니다. 고양이로 학습된 이 모델이, 다시 과제 속에서 고양이에게로 돌아간 것입니다.
이 실험은 '자연 이미지와 ARC 격자가 동일한 표현 공간을 공유한다'는 것을 통계적 수치에서 시각적 증거로 바꾸어 놓았다.
ARC 격자에서 학습한 변환 규칙은 자연 이미지의 잠재 표현에 직접 적용할 수 있으며, 그 반대도 마찬가지다.
추상적 규칙과 시각적 표현 사이의 연결은, 이 두 세계가 원래부터 가지고 있던 것이다.
저자 소개
논문 제1저자는 Xiaoman Delores Ding으로, MIT CSAIL 소속이며 He Kaiming(何恺明) 연구실 출신입니다.
그녀는 동시에 VARC의 제1저자이기도 하며, 이번 NAT-ARC는 사실상 자신의 이전 연구를 기반으로 한 걸음 더 나아간 것이다.
그 외 저자로는 후커야(Keya Hu)가 있으며, 그녀는 허카이밍(He Kaiming)의 첫 여성 제자 중 한 명으로, 학부를상하이교통대학교。
또한 Katelyn Gan과 Victor Yin은 마찬가지로 MIT 출신으로, 두 사람 모두 학부생이며 CSAIL에서 student researcher로 활동하고 있습니다.
교신저자 Kaiming He(何恺明)에 대해 굳이 말할 것도 없다. 그는 ResNet과 MAE의 저자로, 이 두 연구만으로도 거의 최근 10년간 비전 AI의 주요 흐름을 엮어낼 수 있다.
그는 MIT에 입학한 이후 비전 기초 분야의 연구 성과를 꾸준히 내왔으며, 이 논문은 바로 그가 4년 전에 제안한 MAE를 사전 학습 도구로 사용한 것으로, 자신의 옛 무기로 새로운 길을 개척한 셈이다.
VARC는 CVPR 2026에 채택되었으며, NAT-ARC는 이의 직접적인 후속 연구이다.
이 팀은 두 편의 연속 논문에서 순수 비전 라인으로 ARC 해결에 매진하고 있으며, LLM이 대세인 이 분야에서 실험 데이터를 통해 비전 라인의 한계를 끊임없이 뛰어넘고 있다.
논문 주소:
https://eccv.ecva.net/virtual/2026/poster/5527