
원러(闻乐), 아페이쓰(凹非寺) 발
양자웨이(量子位) | 위챗 공식계정 QbitAI
DeepSeek의 신귀 이중성이 바이트 Seed 팀에게 붙잡혔다.
같은 문제인데 아무것도 바꾸지 않고 앞에 하찮은 문자 몇 개만 추가했더니, 모델이 갑자기 문제를 못 풀게 된다???
게다가 가끔씩 삐걱거리는 수준이 아니다.
Seed 연구진은 DeepSeek-V4의 성능이 정보의 입력 위치에 따라4개의 Token마다 주기적으로 변한다는 것을 발견했다。
무슨 말이냐 하면, 모델이 어떤 일을 기억하고 있느냐가 그 일이 입력 안에서 어느 위치에 서 있느냐에 달려 있다는 것이다??
앞에 Token 두 개를 더 추가하면 답이 틀렸다 맞을 수 있고, 또 두 개를 더하면 다시 틀리게 바뀐다.
이제 모델도 문제를 풀 때 자리 배치를 따지기 시작한 것이다.
128K 긴 컨텍스트 검색 테스트에서 연구진은 동일한 정보가 위치만 바뀌었을 뿐인데도 DeepSeek-V4 시리즈 모델의 검색 정확도가최대 40.2퍼센트포인트까지 벌어진다는 것을 발견했다。
팀은 나아가 이 문제가 DeepSeek-V4가 채택한 긴 컨텍스트 최적화 기술과 관련이 있다는 것을 발견했다——
분할 KV Cache 압축。
이 기술은 원래 모델이 긴 텍스트를 처리할 때 메모리를 더 절약하고 더 효율적으로 작동하도록 하기 위한 것이었다.
그런데 압축하고 나서 도리어 모델이 신출귀몰하게 되었다(doge).
Token 두 개만 더해지면 DeepSeek가 갑자기 정답을 맞힌다
바이트 Seed 연구진이 처음 실험한 것은 DeepSeek 자신의 코드를 가지고였다.
테스트 대상은DeepSeek-V4-Flash-Base。
그들은 DeepSeek-V4의 공식 추론 코드에서 FP8 양자화 함수를 잘라내어 모델이 마지막 Token을 완성하도록 했다.
이 작업의 정답은 8이어야 한다. 이 코드가 FP8 관련 타입 변환을 수행해야 하기 때문이다.
그러나 모델은 가끔 32로 완성해야 한다고 주장했다.
무슨 일인지 알아보기 위해 연구진은 코드 앞에 순수하게 장식적인 문서 문자열을 추가했는데, 그 안에 반복되는 등호를 넣었다.
그런 다음 등호의 개수를 조정하기 시작했다.
코드 자체는 바뀌지 않았고, 완성해야 할 위치도 바뀌지 않았으며, 물론 정답도 바뀌지 않았다…… 유일한 변화는 앞에 실질적인 의미가 없는 이 Token들이 추가된 것뿐이었다.
그 결과 DeepSeek의 답이 부침을 거듭하기 시작했다.
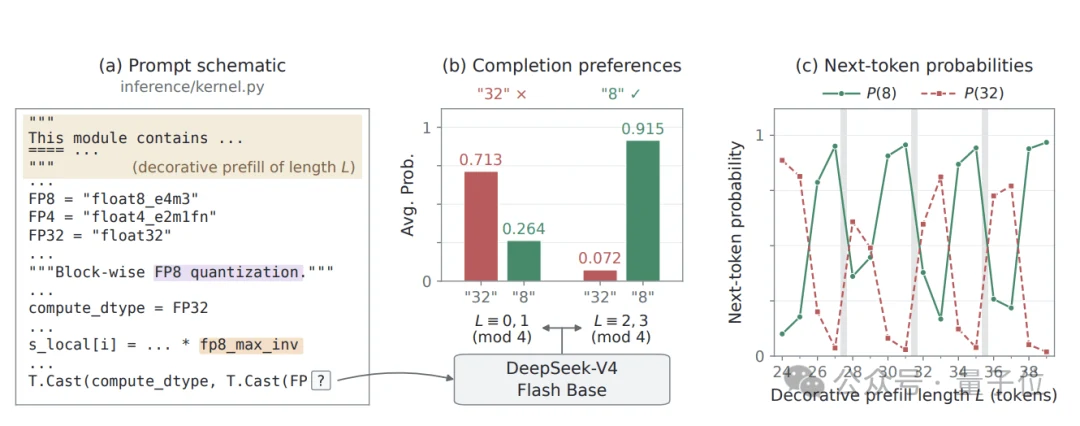
패딩 길이가 특정 위치에 놓일 때, 모델은 틀린 32를 답하는 쪽으로 기울었다.
Token 한두 개를 앞으로 옮기자 다시 정답인 8 쪽으로 기울기 시작했다.
계속 옮기면 잘못된 답이 다시 돌아온다——
전체 과정은 4개의 Token을 주기로 반복된다.。
더 구체적으로 말하면, 논문에서 테스트한 16가지 채움 길이 중 길이를 4로 나눈 나머지가 0 또는 1일 때 모델은 오답 32를 선호하는 경향을 보이고, 나머지가 2 또는 3일 때는 정답 8을 선호하는 경향을 보인다.
연구진은 또한 모델이 두 후보 답변에 할당한 확률도 통계했다.
일련의 위치에서 오답 32의 평균 확률은 71.3%에 달한 반면, 정답 8은 26.4%에 불과했다.
다른 조합의 위치로 바꾸면 상황이 정반대로 바뀝니다:
정답 8의 평균 확률은 91.5%로 올라갔고, 오답 32는 7.2%만 남았습니다.
즉, 앞에 있는 무관한 문자들 몇 개의 길이 변화만으로도 모델이 동일한 문제에 대해 전혀 다른 판단을 내리게 됩니다.
이건 좀 평가하기 어렵네요.
프로그래머가 코드를 디버깅할 때는 보통 먼저 로직, 변수, 의존성을 검토한다.
지금 와서 보니, 앞둔 곳에 등호를 두 개 더 잘못 입력했는지도 덤으로 확인해 봐야 할지도 모르겠다.
하지만 코드 자동 완성 사례 하나만으로 이 문제가 얼마나 만연한지 설명하기에는 부족하다.
그리하여 Seed 팀은 테스트를 계속 확대했다.
그들은 대규모 모델의 긴 컨텍스트 능력에서 매우 고전적인 하나의 과제에 주목을 돌렸는데, 바로바다에서 바늘 찾기。
연구원들은 약 128K 토큰 길이의 컨텍스트를 구성했으며, 그 안에는 약1.6만 개의 키-값 쌍。
예를 들어 K1은 V1에 대응하고, K2는 V2에 대응하는 식입니다……
그런 다음 모델이 그중에서 지정된 Key에 해당하는 Value를 찾도록 합니다.
테스트 과정에서 키-값 관계는 변하지 않고, 문제도 변하지 않으며, 컨텍스트 전체 길이도 동일하게 유지됩니다.
연구진은 중점적으로 조정했다압축 창 경계를 기준으로 한 목표 정보의 위치。
그 결과 DeepSeek-V4 시리즈의 정확도 곡선이 매우 뚜렷한 주기적인 등락을 보이는 것으로 나타났다.
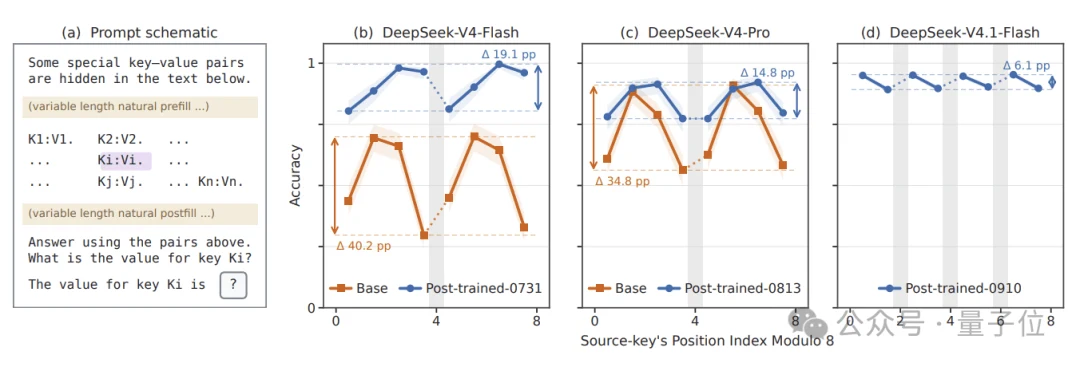
이중 DeepSeek-V4-Flash-Base는 서로 다른 위치 간 최대 정확도 격차가 40.2퍼센트포인트에 달했다
DeepSeek-V4-Pro-Base도 34.8퍼센트포인트에 달했다.
거쳐서포스트 트레이닝그 후 상황이 다소 개선되었다.
DeepSeek-V4-Flash-0731과의 격차는 19.1퍼센트 포인트로 축소되었고, DeepSeek-V4-Pro-0813과는 14.8퍼센트 포인트로 축소되었다.
더 최신 버전인 DeepSeek-V4.1-Flash-0910의 경우 격차가 6.1%포인트까지 좁혀졌다.
하지만 주기적 차이는 여전히 존재합니다.
이러한 차이는 어디서 비롯된 것일까요?
더 자세히 보면, DeepSeek-V4의 변동 주기는 4개 Token이었지만, DeepSeek-V4.1은 2개 Token으로 바뀌었습니다.
연구진은 이정확히 두 세대 모델이 각각 채택한 KV Cache 압축 스텝 크기와 일치한다。
그렇군, 문제 풀이 성능의 변동 주기조차 저층 압축 설정과 일치하네.
문제는 KV Cache 압축에 있다는 건가?
그럼 KV Cache 압축에 대해 이야기해 보자.
대규모 모델이 긴 컨텍스트를 처리할 때는 이후 어텐션 계산에 사용하기 위해 수많은 과거 토큰에 해당하는 Key와 Value 정보를 저장해야 한다.
컨텍스트가 길어질수록 이 캐시가 차지하는 메모리와 계산 비용이 커진다.
특히 수십만, 수백만 토큰에 달하는 긴 작업에서는 KV Cache가 추론 효율의 병목이 되기 쉽다.
따라서 DeepSeek-V4는청크 단위 KV Cache 압축。
핵심 아이디어는 연속된 토큰들을 하나하나의 창(window)으로 나눈 뒤, 창 내부의 정보를 더 적은 수의 캐시 항목으로 압축하는 것입니다.
이렇게 하면 모델이 각 과거 Token마다 동일한 규모의 캐시를 유지할 필요가 없습니다.
메모리를 절약할 수 있을 뿐만 아니라 긴 컨텍스트 어텐션 계산 비용도 낮출 수 있습니다.
하지만 Seed 팀은 DeepSeek에 신귀(神鬼) 이중성이 나타나는 원인이 바로 이 청크 분할 과정 속에 숨어 있을 가능성을 발견했습니다.
각 4개의 토큰이 하나의 압축 스텝을 구성한다고 가정합니다.
그러면 같은 정보가 창에서 1번째, 2번째, 3번째 또는 4번째 위치에 나타날 때, 압축 시의 조건이 달라질 수 있습니다.
이 논문은 압축 윈도우 경계에 대한 이러한 상대적 위치를 다음과 같이 부른다.Phase(위상)。
연구진은 발견했다.모델은 서로 다른 위상의 정보에 대해 검색 능력에 체계적인 차이를 보인다.。
그들은 이 현상을 다음과 같이 명명했다Phase Sensitivity(위상 민감도)。
예를 들어, 같은 자료를 모델에 맡긴다고 해봅시다:
첫 번째 타이포그래피에서는 핵심 숫자가 모델이 쉽게 보존하는 위치에 정확히 자리잡는다;
두 번째 조판은 앞에 몇 글자만 더 추가되었을 뿐인데, 핵심 숫자의 압축 창 기준 위치가 달라졌다.
자료는 그대로 그 자료이지만, 모델이 이후 그 숫자를 찾아낼 수 있을지는 뚜렷한 차이가 있을 수 있다.
게다가 이러한 문제를 ‘정보가 마침 두 창 사이에 갈려 잘렸다’고 단순히 돌릴 수도 없다.
연구진은 Key와 Value가 모두 동일한 압축 창 안에 속하더라도 위치에 따라 검색 정확도가 크게 달라질 수 있음을 발견했다.
이는 문제가 모델이 정보를 압축 캐시에 어떻게 기록하는지, 그리고 이후 캐시에서 어떻게 읽어오는지와도 관련이 있음을 보여준다.
확인을 더욱 확실히 하기 위해 Seed 팀은 아예 직접 모델 여러 개를 처음부터 새로 학습시켰습니다.
그들은Qwen3-0.6B 아키텍처을 기반으로 다양한 KV Cache 압축 방안을 구성하고, 블록 압축이 없는 전체 어텐션 모델을 대조군으로 설정했다.
초점은 압축 메커니즘만 바꾸고, 주기적 변동이 함께 나타나는지 살펴본다.
결과,테스트를 받은 모든 분할 압축 모델에서 압축 단계 크기에 대응하는 주기적 변화가 나타났다。
반대로, 전체 어텐션 기준 모델에서는 동일한 수준의 주기성이 나타나지 않았다.
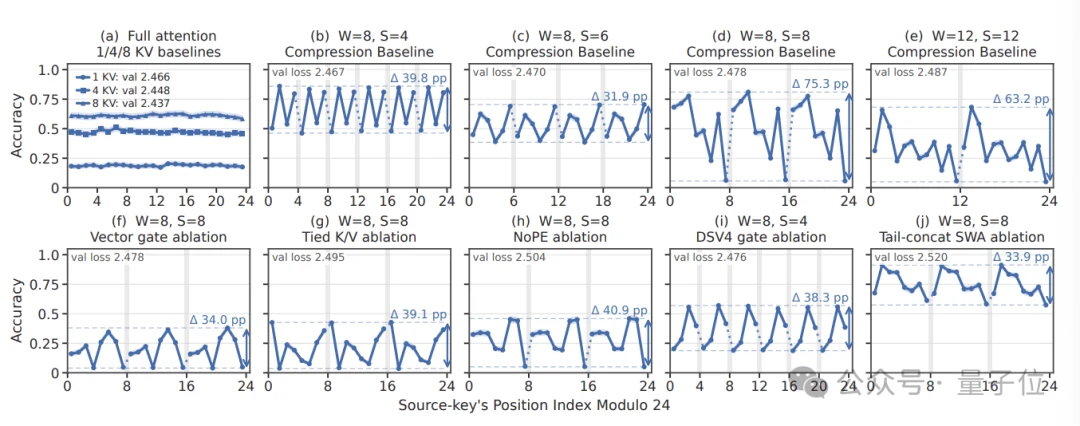
연구진은 창 크기와 압축 단계를 각각 조정해 보았고, 주기가 주로 압축 단계에 따라 변한다는 것을 발견했다.
스트라이드가 4이면 성능이 약 4개의 토큰을 주기로 오르내립니다;
걸음 크기가 6이면 주기도 약 6개 토큰으로 변합니다;
스트라이드가 8인 경우에도 마찬가지입니다.
……
심지어 RoPE 위치 인코딩을 사용하지 않거나, 학습 가능한 압축 가중치를 단순 평균으로 바꾸어도 이 현상은 여전히 존재합니다.
다시 말해, 문제는 특정 위치 인코딩이나 특정 특수 모듈 하나 때문에 발생하는 것이 아닙니다.
블록 단위 압충이라는 설계 자체가 주기적인 검색 약점을 초래할 수 있습니다.
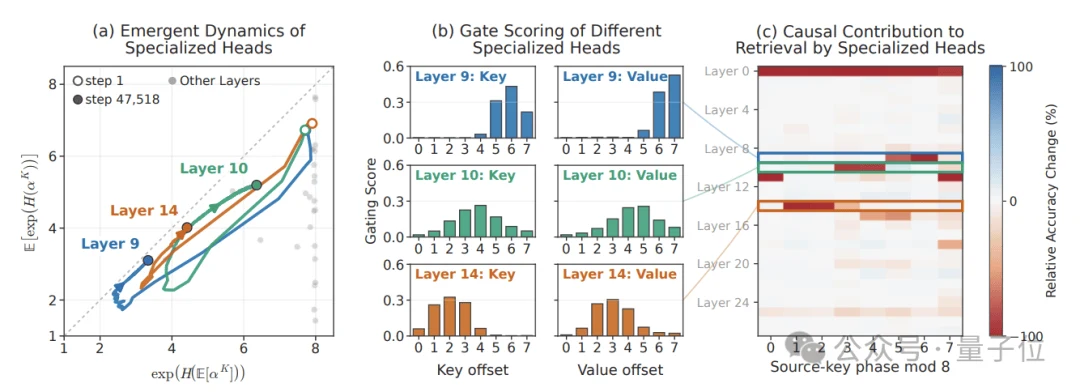
Seed 팀은进一步 주의 헤드(attention head)에 개입하여, 서로 다른 구성 요소를 제거한 후 모델이 각 위상에서 검색 능력이 어떻게 변화하는지 관찰했습니다.
그 결과, 서로 다른 주의 헤드가 서로 다른 위상에 기여하는 정도가 같지 않다는 것을 발견했습니다.
일부 헤드는 특정 위치의 정보를 처리하는 데 더 능숙하고, 다른 헤드는 다른 위치에서 더 큰 역할을 합니다.
연구진은 이를 Phase Specialization, 즉 위상 전문화라고 부른다.
즉, 모델 내부에서 일종의 분업이 형성된 것으로 보인다. 서로 다른 어텐션 컴포넌트가 압축 윈도우 안의 서로 다른 위치에 대한 선호를 보이게 된 것이다.
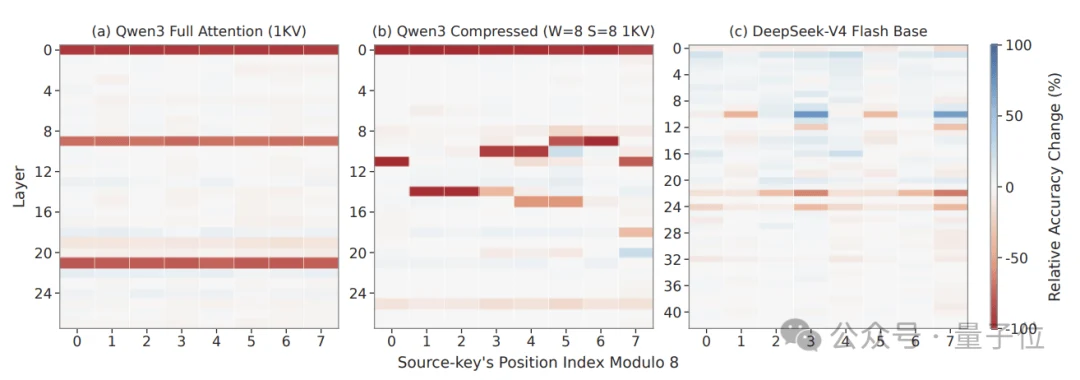
이러한 분업은 모델이 정보 검색을 수행하는 데 도움이 될 수 있지만, 특정 위치가 상대적으로 취약한 지점이 되게 할 수도 있다.
논문은 또한 단순화된 이론 모델을 통해 학습 과정을 분석했으며, 그레이디언트 흐름이 압축 모듈이 안정적인 위치 선호를 형성하도록 이끌 수 있음을 발견했다.
이는 이러한 주기성이 단순한 무작위 잡음이 아닌 이유도 설명해 준다. 이는 모델이 정보를 압축하는 방법을 학습하는 과정에서 자연스럽게 형성된 결과일 수 있다.
하지만 이런 문제는 일반적인 Benchmark에서 바로 드러나지 않을 수 있는데, 일반적인 평가는 보통 대량의 테스트 결과를 하나의 평균 점수로 집계하기 때문이다.
모델이 어떤 위치에서는 매우 좋은 성능을 보이고 다른 위치에서는 뚜렷하게 뒤처진다고 가정하더라도, 최종적으로 계산된 평균 성적은 여전히 좋아 보일 수 있다.
그래서 Seed 팀은 블록 단위 KV Cache 압축을 채택한 모델을 평가할 때 전체 검색 정확도만 볼 것이 아니라, 동일한 정보를 서로 다른 압축 위상에 배치하여 각각 한 번씩 측정해야 한다고 제안했다.
하지만 이러한 위치로 인한 성능 편차가 존재하더라도, 긴 컨텍스트 추론의 메모리 및 연산 비용을 고려하면 압축은 여전히 매우 현실적인 가치가 있다.
다만 캐시를 절약한 후에는 모델이 서로 다른 위치의 정보를 더 이상 똑같이 대우하지 않을 수 있다.
물론 이번 실험 결과를 보면, 후속 학습과 아키텍처 개선이 이러한 격차를 확실히 상당히 줄일 수 있음을 알 수 있다.
논문 주소: https://arxiv.org/pdf/2609.36322